对应 Maps to:Stanford CS230 Fall 2025 Lecture 4(10/14,“Adversarial Robustness and Generative Models”);Autumn 2018 Lecture 4 “Adversarial Attacks / GANs”(Kian Katanforoosh 主讲,YouTube 公开录像);CS230 Section 8(Advanced Evaluation Metrics,公开网页)里关于 GAN 评估指标(Inception Score、Wasserstein 距离、FID)的部分。这一讲的内容不在 Coursera 的 C1–C5 里——2018 年那次课一开头就说,今天讲的两个话题 Coursera 视频里没有。在 Fall 2025 的课表里,它和 C2M1、C2M2(第 6–8 讲)排在同一周。 依据说明:两次课堂讲座都没有公开的 slides 或讲稿,只有 2018 年的录像。本讲的课堂部分依据公开录像的内容概要(对抗攻击 → 防御 → GAN 的动机、博弈、损失函数与训练技巧 → 应用)来写,具体例子和数字可能和录像有出入;没把握的细节就不写。Fall 2025 那次课加入了扩散模型(2018 年时还没有 DDPM),这一部分完全依据原始论文。技术内容一律以原始论文为准:Szegedy et al. 2014;Goodfellow, Shlens & Szegedy 2015;Kurakin et al. 2017;Madry et al. 2018;Athalye, Carlini & Wagner 2018;Tsipras et al. 2019;Ilyas et al. 2019;Goodfellow et al. 2014;Radford et al. 2016;Salimans et al. 2016;Heusel et al. 2017;Sohl-Dickstein et al. 2015;Ho, Jain & Abbeel 2020;Song, Meng & Ermon 2021;Ho & Salimans 2022;Rombach et al. 2022(见 §12)。 配套代码 Code:
code/lecture18/(numpy + PyTorch;3 个脚本 + 1 个模块:01_adversarial_examples.py约 70 秒,02_gan_2d.py约 45 秒,03_diffusion_2d.py约 60 秒,都有--quick) 预计阅读时间:3–3.5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说清楚对抗样本是什么、为什么它让人不安;用”高维空间里线性的累积”解释它为什么存在:每一维只改 ,沿 改时输出变化 ,随维度增长,而同样大小的随机噪声几乎无害。
- 写出 FGSM 和 PGD 的公式,知道 FGSM 是”把损失看成线性函数”时的一步最优解;能描述一个威胁模型(白盒 / 黑盒、 预算、有目标 / 无目标、数字世界 / 物理世界),知道可迁移性为什么让黑盒攻击成为可能。
- 写出对抗训练的 min-max 目标,说出它的三个代价(干净准确率下降、训练贵很多倍、只在预算内有效);能识别 gradient masking:一个”防御”在梯度攻击下比随机噪声还强,本身就是危险信号。
- 区分判别模型 和生成模型 ;说出生成模型的几大家族(自回归、VAE、GAN、flow、扩散)各自的取舍。
- 写出 GAN 的 minimax 目标,推导最优判别器 ,解释原始生成器损失 为什么会饱和、换成 之后为什么不会;知道 GAN 的损失为什么不是”进度条”、什么是 mode collapse、有哪些常用技巧、为什么 GAN 很难评估(IS、FID 和它们的盲点)。
- 写出 DDPM 的前向闭式解 ,说出训练(预测噪声的回归)和采样(一步步去噪)各自在做什么,解释扩散模型为什么比 GAN 稳定、覆盖模式更全,代价是什么(采样步数多),以及 DDIM、classifier-free guidance、latent diffusion 各解决了什么问题。
- 想清楚这两类技术带来的安全与伦理问题:部署的模型会被攻击;生成模型会被用来造假。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开(或不展开) Previewed only |
|---|---|
| 第 5 讲 §4:风格迁移与对抗样本预告——“固定参数、对输入求梯度、改输入” | 认证防御(randomized smoothing 等)的证明(§4.4 只点名) |
| 第 2、9 讲:逻辑回归、softmax、交叉熵;第 7 讲:方差保持的初始化 | VAE 的推导(ELBO、重参数化),normalizing flow(§5.1 只放进对比表) |
| 第 8 讲:Adam、“Adam 部分掩盖梯度消失”(§9.4) | 扩散模型的变分下界推导、score matching / SDE 视角(§7.3 只给结论) |
| 第 12–14 讲:CNN、转置卷积与 U-Net(第 14 讲 §9) | 文生图大模型的完整训练流程(§8.5 只讲结构上的想法) |
| 第 17 讲:Transformer、正弦位置编码(§6.2) | LLM 的越狱攻击与对齐(§4.4 点名,第 20 讲再谈应用层面的防护) |
第 9 讲 torch_utils、第 12 讲 SmallCNN、第 9 讲的合成手势 | 强化学习(第 19 讲) |
第 5 讲 §4.5 已经用”白天 / 黑夜”分类器演示过对抗样本:每个像素沿梯度符号改 0.02,62.8% 的白天照片就被判成夜晚。本讲不重复那个实验,而是回答它留下的问题:为什么(§2)、能有多狠(§3)、怎样防(§4)、防御怎样自欺欺人(§4.3)。后半讲换一个方向:同样是”神经网络 + 梯度”,怎样让网络生成数据(§5–§8)。
0.3 本讲地图 Map
Part A  对抗鲁棒性
§1  对抗样本:一个让人不安的发现;2018 年课堂上的"把猫变成鬣蜥";威胁模型
§2  为什么存在:高维空间里线性的累积;网络在局部有多线性;"特征不是 bug"   ← 代码 01 演示 1、演示 2(b)
§3  攻击:FGSM、PGD、迁移与黑盒、物理世界                                     ← 代码 01 演示 2(a)(c)(d)
§4  防御:对抗训练(min-max);陷阱:gradient masking;现状                    ← 代码 01 演示 3、4
Part B  生成模型
§5  从 p(y|x) 到 p(x);GAN 的博弈;最优判别器;生成器损失的饱和                ← 代码 02 演示 1
§6  训练 GAN:损失不是进度条、振荡、mode collapse、技巧、评估、应用与伦理       ← 代码 02 演示 2、3
§7  扩散模型:前向加噪的闭式解;训练 = 预测噪声;采样 = 一步步去噪;U-Net / DiT  ← 代码 03 演示 1–3
§8  扩散 vs GAN:为什么更稳定、覆盖更全;采样慢与 DDIM;并排实验;条件生成与 latent diffusion
                                                                               ← 代码 03 演示 3、4
§9–13  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 | 出现在 |
|---|---|---|
| (或 ) | 加在输入上的扰动;对抗样本 | §1–§4 |
| 扰动预算:,即每个像素最多改 (像素值在 ) | §1–§4 | |
| ,, | 三种范数 | §2 |
| 损失对输入的梯度(不是对参数) | §3 | |
| (§3) | PGD 每一步的步长(和学习率无关) | §3.2 |
| ,; | 生成器、判别器;噪声(“潜变量”), | §5、§6 |
| , | 真实数据的分布;生成器”推出来”的分布 | §5.3 |
| 判别器输出的 logit, | §5.4 | |
| ; | 扩散的总步数(本讲和 DDPM 一样取 1000);第几步 | §7 |
| ;; | 第 步加的噪声方差;“还剩多少原始信号”的平方 | §7.2 |
| 噪声预测网络(注意和扰动预算 是两个字) | §7.3 |
两个字母撞名: 在 §3 是 PGD 的步长,在 §7 是 ; 是扰动预算, 是高斯噪声。看上下文。PyTorch 代码按第 9 讲的习惯”每一行一个样本”;图像是 ,二维点是 。
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出(PyTorch 单线程、固定种子,同一台机器上重复运行逐字相同;本讲没有引用任何计时数字)。数据全是合成的:对抗样本用第 9 讲的 16×16 合成手势(6 类),GAN 和扩散模型用”圆环上 8 个高斯”的二维点(ring_world.py)。模型很小、训练很短,数字只说明机制,不代表 ImageNet 或真实图像生成上的大小。好几处结果和我写代码前的预想不一样——最重要的三处:用 Adam 时”饱和”的 GAN 损失也能训练;二维玩具上的 GAN 没有彻底坍缩,只是暂时丢掉一个模式;扩散模型的样本比 GAN 最好的时候更”糊”。讲义按实际结果写,这些情况都列在代码 README 的”关于实验结果”里。
Part A · 对抗鲁棒性 Adversarial robustness
1. 对抗样本:一个让人不安的发现 · Adversarial examples
1.1 从第 5 讲的一个实验说起
第 5 讲 §4.5 里,我们训练了一个白天 / 黑夜分类器(验证准确率 0.844),然后对 473 张被正确判为”白天”的照片,每个像素沿 改 :
| ≈ 0–255 里的 | 被翻成”夜晚”的比例 | |
|---|---|---|
| 0.01 | 2.6 | 33.0% |
| 0.02 | 5.1 | 62.8% |
| 0.05 | 12.8 | 95.6% |
每个像素改 5 个灰度级,人眼看不出来,网络的答案却翻了。第 5 讲把它和风格迁移放在一起:三者的数学是同一个——固定参数,对输入求梯度,改输入。只是风格迁移想”画一张好看的图”,对抗样本想”找一张让网络犯错的图”。
先停下来想一想:这件事到底哪里让人不安?
- 网络在测试集上表现很好。对抗样本不是”难样本”,它离一张分对的图近得肉眼分辨不出——网络的决策边界离几乎每一张正常图片都近得离谱。
- 改动不是随机的。后面会看到,同样大小的随机噪声几乎无害(§3.3)。问题出在”方向”上。
- 它可以被故意利用:自动驾驶看路牌、人脸识别门禁、内容审核、恶意软件检测……只要输入可以被别人碰到,就有人会去找这样的方向。
1.2 Szegedy 的发现,Goodfellow 的熊猫
对抗样本最早被系统地报告是在 Szegedy et al. (2014) 的 Intriguing properties of neural networks 里。他们用一个带约束的优化(box-constrained L-BFGS)为 MNIST 和 ImageNet 上的图片找”最小的、能让网络认错的扰动”,发现两件当时很让人意外的事:这样的扰动小到看不出来;而且在一个网络上找到的对抗样本,常常也能骗过结构不同、用不同数据子集训练的另一个网络(可迁移性,§3.4)。
一年后,Goodfellow, Shlens & Szegedy (2015) 的 Explaining and Harnessing Adversarial Examples 给出了一个简单得多的解释(“线性”,§2)和一个简单得多的攻击(FGSM,§3.1)。论文第一张图成了这个领域的标志:一张熊猫图,GoogLeNet 以 57.7% 的置信度认出是熊猫;加上 之后,它以 99.3% 的置信度说这是长臂猿。0.007 大约是 8 位图像里最小的一档亮度。
1.3 2018 年课堂上的版本:把一只猫”伪造”成鬣蜥
2018 年的课(Kian Katanforoosh 主讲)是从一个”攻击者的设计问题”开始的(下面按录像的内容概要复述,细节可能和录像有出入):给你一个训练好的 ImageNet 分类器,怎样造一张图,让它被分成”鬣蜥”(iguana)?
用第 5 讲的五问来想:参数固定,要优化的是输入 ;损失定义”我想要什么”:
直接这样做,得到的图确实被分成鬣蜥,但看起来像一团噪声——这和第 5 讲 §4.5(a) “网络心中的夜晚”是同一个现象:分类器只学会了”往哪边推概率”,没学会”一张真实的图长什么样”,所以满足它的输入大多不像任何东西。如果要求它看起来还是那只猫,就在损失里加一项,把它拴在原图 附近:
结果是一张人看来就是那只猫、网络却坚信是鬣蜥的图。这叫有目标攻击(targeted attack):指定要被认成哪一类;只要求”认错就行”的叫无目标攻击(untargeted)。本讲的代码做的都是无目标攻击。
1.4 威胁模型 · Threat models
“模型鲁不鲁棒”这个问题,离开威胁模型就没有意义。威胁模型回答三件事:
| 维度 | 选项 | 例子 |
|---|---|---|
| 攻击者知道什么 | 白盒(white-box):结构、参数、梯度全知道 | 开源模型;本讲代码 01 演示 2(a) |
| 黑盒(black-box):只能查询输出,甚至只能看到最终类别 | 线上 API;靠迁移(§3.4)或大量查询 | |
| 攻击者能改什么 | 球:每个像素最多改 (最常用) | 本讲全部实验 |
| 球、(只改少数像素)、贴纸 / 补丁、旋转平移 | “对抗补丁”(Brown et al. 2017) | |
| 物理世界:打印出来再拍照、贴在路牌上 | Kurakin et al. 2017;Eykholt et al. 2018 | |
| 攻击者想要什么 | 无目标:认错就行;有目标:认成指定的类 | §1.3 的鬣蜥 |
本讲默认最常见的设定:白盒、 预算 、无目标。像素值在 ,对抗样本必须还是一张合法的图:。
2. 为什么会存在:高维空间里线性的累积 · Why do adversarial examples exist?
2.1 一个线性模型的思想实验
最早的猜测是:深度网络是高度非线性的复杂函数,输入空间里布满了”口袋”,对抗样本就藏在里面。Goodfellow et al. (2015) 提出的解释正好相反:问题出在网络太线性了。
先看一个最简单的线性模型 ,输入 维。把输入改成 ,每一维最多改 (),输出变化
先让你想一想:在”每一维最多改 “的约束下, 最大能有多大?答案是让每一维都朝 的符号改满:
如果 的每一维平均大小是 ,这就是 ——随维度 线性增长。每一维的改动小到可以忽略,但 个小改动全部同号,加在一起就很大。相比之下,同样大小的随机符号噪声 , 的各项有正有负,互相抵消,典型大小只有 ,量级是 。两者之比约为 。
代码 01 演示 1 把这个思想实验做成数字。;权重按第 7 讲的方差保持初始化 ,这样 对正常输入的尺度始终在 1 左右,不随 变:
| 维度 | 图像 | 对抗: | 随机: 平均 | 之比 | ||||
|---|---|---|---|---|---|---|---|---|
| 16 | 4×4 灰度 | 3.0 | 3.2 | 0.0118 | 0.00276 | 4.3 | 4.0 | 0.016 |
| 256 | 16×16 灰度 | 12.8 | 12.8 | 0.0502 | 0.00321 | 15.7 | 16.0 | 0.063 |
| 3072 | 32×32×3 | 44.5 | 44.2 | 0.1744 | 0.00323 | 54.0 | 55.4 | 0.217 |
| 150528 | 224×224×3 | 309.7 | 309.6 | 1.2144 | 0.00311 | 390.6 | 388.0 | 1.521 |
- 在 ImageNet 的输入尺寸上,每个像素只改 1/255,沿 改能让输出变化 1.21——和正常输入下输出的尺度一样大,足以把一个 logit 推过决策边界。随机噪声只让它变化 0.003。
- “对抗 / 随机”之比和 几乎完全一样:维度越高,“方向”越占便宜。图像是很高维的输入,所以图像分类器格外容易受影响。
- 最后一列是一个常见的混淆: 范数小(每个像素改得少)不等于扰动向量短,它的 长度是 。“人眼看不出”说的是前者。
所以,一个线性模型,只要输入维度足够高,就一定有对抗样本。Goodfellow 的论文里,一个浅层的 softmax 回归在 MNIST 上、 时错误率 99.9%,平均置信度 79.3%——不需要任何深度。
2.2 神经网络在局部有多线性?
神经网络不是线性模型。但我们为了让它好训练,刻意把它设计得”很线性”:ReLU 是分段线性的(第 3 讲 §4.4);LSTM 的记忆单元是一条加法的高速公路(第 15 讲 §10.2);残差连接让每一层接近恒等映射(第 13 讲 §3.4)。Goodfellow 的说法是:让网络容易用梯度下降优化的那些设计,恰恰也让它在输入空间里”太线性”,从而容易被攻击。
这个说法可以直接检查。代码 01 演示 2(b) 在一个训练好的小 CNN(第 12 讲的 SmallCNN,38,022 个参数,干净准确率 0.941)上,看”正确类别领先第二名多少”这个间隔 。如果网络在局部是线性的,沿 改, 应该恰好下降 。对 941 张分对的测试图:
| 一阶预测的下降(中位数) | 实际的下降(中位数) | 实际 / 预测(中位数) | |
|---|---|---|---|
| 0.005 | 0.659 | 0.656 | 0.998 |
| 0.02 | 2.634 | 2.635 | 0.990 |
| 0.05 | 6.586 | 6.435 | 0.970 |
| 0.1 | 13.172 | 12.068 | 0.913 |
在 的尺度上,这个 CNN 和一个线性函数几乎没有区别; 时有一部分 ReLU 的开关状态变了,实际下降比线性预测小 9%,但仍是同一个量级。再把数字拆开: 的中位数 131.7 = 256 个像素 × 平均每个像素 ;干净图的间隔中位数只有 4.04。按线性近似,把一半的图推过边界只需要 的中位数 = 0.0293——不到 0–255 里的 8 个灰度级。下一节的攻击实验会印证这个估计。
2.3 另一种看法:“特征,不是 bug”
线性解释回答了”为什么扰动能累积”,但没有回答”为什么网络会依赖这些方向”。Ilyas et al. (2019) 的 Adversarial Examples Are Not Bugs, They Are Features 给了一个更深的视角:数据里存在非鲁棒特征(non-robust features)——对预测真的有用、在测试集上也成立,但人类看不见、而且很容易被小扰动改变的统计规律。标准训练只追求准确率,自然会用上所有有用的特征,包括这些非鲁棒的。他们做了一个很有说服力的实验:把训练集的每张图都改成对抗样本、标签换成被攻击后的错误类别,在这个”看起来全是错标签”的数据集上训练,得到的模型在原始的、正确标注的测试集上居然有不错的准确率——说明那些人眼看不见的扰动里,确实带着能泛化的”特征”。
这个视角有两个推论:
- 对抗脆弱性不是某个架构的 bug,而是”只用准确率当目标”的自然结果。想要鲁棒,就得在目标里明说(§4.1 的对抗训练)。
- 鲁棒性和准确率之间可能有真正的取舍:放弃非鲁棒特征,就放弃了一部分预测能力(Tsipras et al. 2019,Robustness May Be at Odds with Accuracy)。§4.2 的实验会看到这个代价。
3. 攻击:FGSM 与 PGD · Attacks
3.1 FGSM:一步线性近似
攻击者想在预算内让损失尽量大:
这是一个对输入的优化问题。把损失在 附近做一阶展开:。线性函数在 球上的最大值,§2.1 已经算过了:
这就是 FGSM(fast gradient sign method)。它只要一次前向、一次反向——和训练时算梯度一模一样,只是梯度停在输入上(第 5 讲 §4.3:反向传播”多走一步”)。“sign”不是随便加的:它正是 约束下的最优方向。如果约束换成 ,最优方向就变成 (练习 2)。
3.2 PGD:多走几步,再投影回来
FGSM 相信”损失是线性的”。如果不完全是,可以走小步、多走几步,每走一步就把 拉回预算内:
“投影”在 球上就是逐元素裁剪到 (再保证 )。这是投影梯度上升——和你熟悉的梯度下降一样,只是方向反过来、外加一个”不许出界”。Kurakin, Goodfellow & Bengio (2017) 先提出了不带随机起点的迭代版本(他们叫 basic iterative method);Madry et al. (2018) 加上从球内随机一点出发,命名为 PGD(projected gradient descent),并把它当作”一阶攻击者能做到的最好”的代表。代码 01 的 pgd_attack 用 20 步、步长 ;FGSM 就是它的特例(1 步、步长 、不随机起点)。
3.3 实验:决定伤害的是方向,不是大小
代码 01 演示 2(a):同一个 CNN,测试集 1000 张,对比三种同样 大小的扰动;再加一个线性的 softmax 回归(1,542 个参数,干净准确率 0.622)作对照:
| ≈ /255 | CNN:随机噪声 | CNN:FGSM | CNN:PGD | 线性:随机噪声 | 线性:FGSM | |
|---|---|---|---|---|---|---|
| 0(干净) | — | 0.941 | 0.941 | 0.941 | 0.622 | 0.622 |
| 0.01 | 2.6 | 0.941 | 0.858 | 0.854 | 0.627 | 0.487 |
| 0.02 | 5.1 | 0.942 | 0.731 | 0.718 | 0.620 | 0.371 |
| 0.03 | 7.6 | 0.943 | 0.561 | 0.539 | 0.625 | 0.259 |
| 0.05 | 12.8 | 0.938 | 0.288 | 0.231 | 0.614 | 0.119 |
| 0.1 | 25.5 | 0.917 | 0.042 | 0.016 | 0.614 | 0.006 |
- 随机噪声几乎无害: 时 CNN 还有 0.917。这组手势图本来就带着每像素标准差 0.15 的噪声,网络早就习惯了。同样大小、但沿梯度符号方向的扰动,在 时把准确率打到 0.042(FGSM)和 0.016(PGD)。
- §2.2 的线性估计说” 时大约一半被推过边界”:实测 时 FGSM 后还有 0.561,相当于原来分对的图里约 40% 被翻转;0.05 时约 70%。量级对得上。
- PGD 只比 FGSM 强一点。这本身就是”网络在局部很线性”的又一个证据:一步线性近似已经找到了大部分的坏方向。
- 线性模型一样被攻破( 时 0.622 → 0.119)。对抗样本不是”深度网络的怪病”。
代码 01 演示 2(c) 打印了一张对抗样本的字符画:测试集第 0 张(“1 食指”),PGD、 之后,网络以 0.94 的概率认成”2 两指”(干净时以 0.98 认对)。扰动是满屏均匀的 ±0.05 斑点,它的 长度 0.757,原图的 长度 7.05;字符画里两张图几乎看不出区别。
3.4 迁移、黑盒与物理世界
白盒攻击需要模型的梯度。线上服务的攻击者通常拿不到,那是不是就安全了?Szegedy 当年发现的可迁移性说:不一定。代码 01 演示 2(d) 只用 CNN-A 的梯度造对抗样本,再拿去攻击三个攻击者完全不知道参数的模型:
| 被攻击的模型 | 干净 | FGSM =0.05 | PGD =0.05 | FGSM =0.1 | PGD =0.1 |
|---|---|---|---|---|---|
| CNN-A 自己(白盒) | 0.941 | 0.288 | 0.229 | 0.042 | 0.018 |
| CNN-B(同结构、另一个种子) | 0.950 | 0.489 | 0.465 | 0.113 | 0.076 |
| MLP(不同结构) | 0.896 | 0.477 | 0.454 | 0.099 | 0.070 |
| softmax 回归(线性) | 0.622 | 0.343 | 0.335 | 0.142 | 0.125 |
迁移攻击比白盒弱一些( 的 PGD:白盒 0.229,迁移到 CNN-B 0.465),但在 时几乎一样致命,而且对不同结构的 MLP、线性模型同样有效。为什么能迁移?§2 的两个解释都给出了答案:不同的模型在同样的数据上学到了相似的线性方向、依赖相同的非鲁棒特征。于是黑盒攻击有了一个简单的配方(Papernot et al. 2017):自己训练一个替身模型(substitute),在替身上做白盒攻击,再把样本拿去攻击目标。
数字世界之外:Kurakin et al. (2017) 把对抗样本打印出来、用手机拍照再喂给分类器,相当一部分仍然有效;后来有人在停车标志上贴几块贴纸让分类器认错(Eykholt et al. 2018),用 3D 打印做出从各个角度看都被认成”步枪”的乌龟(Athalye et al. 2018 的 Synthesizing Robust Adversarial Examples),或者做一块能贴在任何场景里的”对抗补丁”(Brown et al. 2017)。物理攻击要对付拍摄角度、光照、相机噪声,所以通常优化的是”在一族随机变换下的平均损失”——这个技巧叫 EOT(expectation over transformation),§4.3 还会遇到它。
4. 防御 · Defenses
4.1 对抗训练:把攻击写进目标
最直接的想法:既然知道攻击者会怎样改输入,就在训练时替他改,让网络在被改过的输入上也答对。Goodfellow et al. (2015) 用 FGSM 造样本、和干净样本各占一半地训练,MNIST 上一个 maxout 网络对 FGSM 样本的错误率从 89.4% 降到 17.9%。Madry et al. (2018) 把这件事写成一个干净的鲁棒优化(robust optimization)问题:
读法:外层和平时一样,用梯度下降最小化平均损失;但每个样本的损失换成”在预算内最坏情况下的损失”。内层的 max 没有闭式解,用 PGD 近似;外层对 求梯度时,按 Danskin 定理,只要在内层找到的最坏 处求梯度即可——代码里就是”先用 PGD 把这一批改坏,再正常训练一步”,train 函数里只多了一行。
这个视角把对抗训练和第 6 讲 §6.1 的数据增强放在了一起:数据增强是”在一族随机的、不改变标签的变换上平均”;对抗训练是”在一族小扰动里取最坏的那个”。两者都是对”什么变化不该改变答案”的断言(第 13 讲 §8),区别在于平均还是最坏。Madry 等人在 CIFAR-10 上(,训练时 PGD 7 步、步长 2/255)得到的模型,干净准确率 87.3%,在 20 步 PGD 白盒攻击下 45.8%——而普通训练的模型在同样的攻击下几乎是 0。
4.2 实验:鲁棒性是买来的
代码 01 演示 3:同样的 CNN、同样的数据、同样的 10 个 epoch,只改训练方式。“强攻击”= PGD 50 步(步长 )× 2 次随机重启,任何一次攻破就算错,用来检查鲁棒性是不是”攻击太弱”造成的假象:
| 训练方式 | 每步前向+反向 | 干净 | =0.05:FGSM / PGD | =0.1:FGSM / PGD / 强 |
|---|---|---|---|---|
| 普通训练 | 1 | 0.941 | 0.288 / 0.231 | 0.042 / 0.017 / 0.014 |
| FGSM 对抗训练 =0.1 | 2 | 0.801 | 0.675 / 0.627 | 0.515 / 0.397 / 0.381 |
| PGD-7 对抗训练 =0.05 | 8 | 0.910 | 0.748 / 0.709 | 0.483 / 0.358 / 0.339 |
| PGD-7 对抗训练 =0.1 | 8 | 0.792 | 0.699 / 0.669 | 0.574 / 0.480 / 0.460 |
逐行读:
- 鲁棒性确实买到了: 的强攻击下,从 0.014 到 0.460。PGD-20 和强攻击的结果很接近(0.480 vs 0.460),说明这份鲁棒性不是评估太弱的假象。
- 代价一:干净准确率。0.941 → 0.792( 训练时 0.910)。预算越大,干净准确率掉得越多——§2.3 说的取舍。这么小的模型、只训练 10 个 epoch,代价可能被放大了(没有专门验证);文献里的经验是更大的模型和更长的训练能缩小但消除不了这个差距。
- 代价二:训练成本。PGD-7 每一步要额外做 7 次前向 + 反向,贵 8 倍。FGSM 对抗训练只贵 2 倍,鲁棒性介于两者之间(强攻击下 0.381)。文献里报告过 FGSM 对抗训练的”灾难性过拟合”(catastrophic overfitting)——训练到某个时刻,模型对 FGSM 很鲁棒、对 PGD 却突然几乎为 0。Wong, Rice & Kolter (2020) 发现,给 FGSM 加上随机起点、选合适的步长并配合早停,“快速”的 FGSM 对抗训练也能接近 PGD 对抗训练的效果。在我们这个设置里没有出现灾难性过拟合,它对 PGD 仍有 0.397。
- 代价三:只在预算内有效。用 训练的模型面对 的强攻击只剩 0.339。鲁棒性是相对一个事先定好的威胁模型说的,换一种攻击(更大的 、、旋转、补丁)就要重新评估。
4.3 陷阱:gradient masking
对抗训练又慢又伤准确率,于是 2017–2018 年出现了大量”更便宜”的防御:对输入做某种变换(压缩、去噪、量化、随机缩放),或者在网络里加不可导、带随机性的组件。很多论文报告了接近 100% 的鲁棒准确率。
代码 01 演示 4 做了一个这类防御的最小版本:在网络前面加一个把像素量化成 8 档的预处理。直觉很有道理——小于半档(约 0.071)的扰动会被四舍五入掉。
| 攻击方式 | = 0.05 | = 0.1 |
|---|---|---|
| 原模型(不防御):PGD-20 | 0.230 | 0.020 |
| 量化防御:FGSM(autograd 梯度) | 0.939 | 0.939 |
| 量化防御:PGD-20(autograd 梯度) | 0.938 | 0.932 |
| 量化防御:随机符号噪声 | 0.939 | 0.910 |
| 量化防御:PGD-20 + BPDA | 0.357 | 0.010 |
| 量化防御:从原模型迁移来的 PGD-20 样本 | 0.359 | 0.011 |
只看第 2、3 行,你会以为这个防御近乎完美,而且干净准确率几乎不掉(0.939 vs 0.941),比对抗训练好太多了。但原因很简单:round() 的导数处处为 0,攻击者用 autograd 拿到的梯度全是 0(代码打印出的最大绝对值就是 0.0),,攻击根本没动。模型一点也没变鲁棒,只是梯度失灵了。
两种绕过的办法都很便宜:
- BPDA(backward pass differentiable approximation):前向照常量化,反向时把量化当成恒等函数,让梯度”穿过去”。准确率立刻掉到 0.357 / 0.010,和不防御差不多。
- 迁移攻击:根本不用这个模型的梯度,直接用原模型上造的样本——0.359 / 0.011。
这正是 Athalye, Carlini & Wagner (2018) Obfuscated Gradients Give a False Sense of Security(ICML 2018 最佳论文之一)的发现:他们检查了 ICLR 2018 上 9 个非认证的白盒防御,其中 7 个依赖”混淆的梯度”(obfuscated gradients),他们的攻击完全攻破了其中 6 个、部分攻破了 1 个。他们归纳了三类:破碎的梯度(shattered:不可导、数值不稳定,比如量化)→ 用 BPDA;随机的梯度(stochastic:随机变换)→ 用 EOT(§3.4)对随机性取平均;爆炸 / 消失的梯度(很深的迭代计算)→ 重新参数化。
一张评估防御的”体检单”(参考 Carlini et al. 2019 On Evaluating Adversarial Robustness):
- 假设攻击者知道你的防御(Kerckhoffs 原则),并且会专门针对它设计攻击(adaptive attack)。
- 防御在梯度攻击下比随机噪声还鲁棒(上表第 2、3 行 vs 第 4 行)→ 几乎一定是梯度失灵。
- 增大 ,准确率应该最终降到 0;多走几步、多重启几次,攻击应该更强(演示 3 的”强攻击”一列)。做不到就说明攻击有问题。
- 迁移攻击(黑盒)不应该比白盒攻击更成功;如果更成功,白盒攻击的梯度一定出了问题(上表最后一行 vs 第 3 行)。
4.4 现状,以及部署时要想的事
- 对抗训练仍然是最可靠的经验性防御,后来有许多改进(例如 TRADES,Zhang et al. 2019,显式权衡干净损失和鲁棒损失),统一的强攻击评估(AutoAttack,Croce & Hein 2020)和排行榜(RobustBench)让”报告的鲁棒性”更可信。但即使在 CIFAR-10 这样的小图上, 下的鲁棒准确率和干净准确率之间仍有很大差距。
- 认证防御(certified defenses)给出数学保证:“这张图在半径 内一定不会被改判”。例如 randomized smoothing(Cohen, Rosenfeld & Kolter 2019)。代价是能认证的半径通常不大、准确率更低。
- 同样的问题在大语言模型上换了个样子:精心构造的、看似无意义的后缀能让对齐过的模型绕开安全限制,而且能在模型之间迁移(Zou et al. 2023 的 GCG 攻击);“提示注入”(prompt injection)则是另一类威胁模型下的攻击。第 20 讲讲 LLM 应用时会碰到防护问题。
- 做项目时(第 11 讲):如果你的模型的输入可能被别人操纵(内容审核、欺诈检测、生物识别、自动驾驶感知),就把”威胁模型”写进需求里:谁会攻击、能改什么、错了代价多大。鲁棒性要用和准确率一样严肃的方式评估,而且要在部署后持续监控。
Part B · 生成模型 Generative models
5. 从 p(y|x) 到 p(x):GAN 的博弈 · Generative models & the GAN game
5.1 为什么要”生成”,为什么难
到目前为止,本讲义的模型几乎都在学一个条件分布 :给一张图,输出各个类别的概率。这叫判别模型(discriminative model)。生成模型(generative model)要学的是数据本身的分布 ,并且能从中采样:生成一张以前没见过、但看起来像是来自同一个分布的新图。
为什么值得做?能生成,说明模型在某种意义上”理解”了数据长什么样;它能用来合成训练数据(第 5 讲 §5.3 的触发词数据合成是手工版本)、补全和修复图像、超分辨率、风格转换、文生图……2022 年以后的”生成式 AI”指的就是这类模型。
为什么难?一张 64×64×3 的图是 12,288 维空间里的一个点。真实照片只占这个空间里极小、形状极复杂的一块(“流形”)——随机撒一个点,几乎一定是噪声。我们要学的是这一小块的形状,而且只能从有限的样本里学;评估”学得好不好”本身也很难(§6.5)。
几大家族用不同的办法绕开这个难题:
| 家族 | 想法 | 能算 吗 | 采样 | 典型代表 |
|---|---|---|---|---|
| 自回归 autoregressive | ,一个一个生成 | 能(精确) | 慢(逐个) | PixelCNN(van den Oord et al. 2016)、GPT(第 15–17 讲的语言模型) |
| VAE | 编码器把 压成潜变量 ,解码器从 还原;最大化似然的下界 | 下界 | 快(一次) | Kingma & Welling 2014 |
| Normalizing flow | 可逆网络把简单分布”变形”成数据分布 | 能(精确) | 快 | RealNVP、Glow |
| GAN | 生成器和判别器博弈,不写出 | 不能 | 快(一次前向) | Goodfellow et al. 2014;DCGAN、StyleGAN |
| 扩散模型 | 学会一步步去噪,把噪声变成数据 | 下界 | 慢(几十到上千步) | DDPM(Ho et al. 2020)、Stable Diffusion |
本讲讲最后两个:GAN 是 2014–2020 年图像生成的主角,也是 2018 年那次课的主题;扩散模型是今天文生图、视频生成的主流。
5.2 GAN 的想法:两个网络的博弈
Goodfellow et al. (2014) 的比喻是造假币的人和警察。造假币的人(生成器 )想造出警察分辨不出的假币;警察(判别器 )想分辨真假。两边在较量中都越来越强,直到假币和真币无法区分。
- 生成器 :输入一个随机噪声 ,输出一个样本 。 本身就是一个普通的网络——它”会生成”,是因为输入是随机的:每抽一个新的 就得到一个新的样本。整个分布 就是”标准正态被 推过去之后的样子”。
- 判别器 :输入一个样本,输出”它是真样本”的概率 。就是一个二分类器(第 2 讲的逻辑回归加上隐藏层)。
- 训练:交替更新。更新 时,真样本标 1、假样本标 0,做普通的二分类;更新 时,梯度从 的输出一路穿过 ( 的参数不动,只是”借道”)传回 ,让 往”更能骗过 “的方向改。
注意这里没有任何”标签”告诉 一张好图应该长什么样。 就是 的损失函数——一个学出来的、会随训练变化的损失函数。这是 GAN 最聪明的地方,也是它难训练的根源。
用第 14 讲的话说,图像 GAN 的生成器像一个”倒过来的分类网络”:DCGAN(Radford, Metz & Chintala 2016)把 100 维的 先变成 4×4×1024 的小特征图,再用 4 层转置卷积(第 14 讲 §9.2,步长 2,每层放大一倍)一路放大到 64×64×3。原论文的核是 5×5;常见的 PyTorch 实现用 、、——第 14 讲练习 6 算过,核是步长的整数倍时不容易出现棋盘格伪影;判别器则是普通的步长卷积网络。本讲的代码是二维玩具, 和 都是三层隐藏层的小 MLP(02_gan_2d.py)。
5.3 minimax 目标与最优判别器
写成公式,GAN 是一个两人零和博弈:
想让 大:真样本上 ,假样本上 ——这正是二分类交叉熵取负号。 只出现在第二项里,它想让 小:让 。
先固定 ,最好的 是什么? 把期望写成积分,。对每个 分别最大化 (,),求导令其为 0 得 :
很直观:在 处真样本和假样本各占多少, 就输出真样本的比例。把 代回去,经过几步整理(练习 4):
JSD 是 Jensen–Shannon 散度,非负,当且仅当两个分布相同时为 0。所以:如果每一步都能把 训练到最优, 就是在最小化 和 之间的 JS 散度;全局最优是 ,此时 ,。按代码里的损失写法(都取正号的交叉熵),均衡点上 的损失是 , 的损失(下一节的 non-saturating 写法)是 。§6.1 会看到实际训练是怎样靠近这两个数的。
这个漂亮的结论有两个重要的”如果”: 每一步都最优(实践中每方只走一小步),以及 、 有无限的容量、在函数空间里优化(实践中是有限参数的网络)。两个”如果”都不成立,正是 GAN 训练各种毛病的来源。
5.4 生成器损失为什么要换一个写法
原始目标里, 要最小化 。Goodfellow 的论文自己就指出:训练初期 很差, 能轻松以很高的置信度拒绝假样本,这时 饱和了。看梯度最清楚:设 , 是判别器的 logit,
第二个是论文建议的替代:让 最大化 (即最小化 ),叫 non-saturating 损失。两者推动 的方向相同、不动点相同,但推力的大小相反地依赖 :
代码 02 演示 1(a):
| 饱和写法 | non-saturating | 两者之比 | |
|---|---|---|---|
| 0.5 | 0.5 | 0.5000 | 1 |
| 0.1 | 0.1 | 0.9000 | 9 |
| 0.01 | 0.01 | 0.9900 | 99 |
| 0.001 | 0.001 | 0.9990 | 999 |
| 0.0001 | 0.0001 | 0.9999 | 9999 |
越差、 越自信,饱和写法给 的推力就越小——偏偏这是 最需要推力的时候。
演示 1(b) 制造了这种局面:生成器刚初始化(样本离 8 个模式都很远,到最近模式中心的平均距离 1.91),先只训练 300 步。此时 对 2000 个假样本的输出平均只有 。两种损失给 的参数梯度的总范数:饱和写法 ,non-saturating ,相差 11,894 倍——和表里 的量级一致。
演示 1(c) 从这个局面出发继续交替训练 3000 步( 一律用 Adam; 用 SGD 或 Adam)。每格是”这 100 步里 的平均 / 样本到最近模式中心的平均距离”(起点 1.91):
| 的优化器 + 损失 | 第 100 步 | 第 300 步 | 第 1000 步 | 第 3000 步 | 最后一步的样本 |
|---|---|---|---|---|---|
| SGD lr 0.01 + 饱和写法 | 0.000 / 1.91 | 0.000 / 1.91 | 0.000 / 1.91 | 0.000 / 1.91 | 0 个模式 |
| SGD lr 0.01 + non-saturating | 0.199 / 29.30 | 0.539 / 1.12 | 0.448 / 0.53 | 0.406 / 0.69 | 0 个模式 |
| SGD lr 0.05 + 饱和写法 | 0.000 / 1.91 | 0.000 / 1.91 | 0.000 / 1.91 | 0.000 / 1.91 | 0 个模式 |
| SGD lr 0.05 + non-saturating | — | — | — | — | 第 44 步发散 |
| Adam lr 1e-3 + 饱和写法 | 0.077 / 12.21 | 0.403 / 0.94 | 0.386 / 0.28 | 0.476 / 0.09 | 8 个模式,高质量 0.899 |
| Adam lr 1e-3 + non-saturating | 0.146 / 0.70 | 0.262 / 0.79 | 0.290 / 0.55 | 0.439 / 0.13 | 7 个模式,高质量 0.793 |
这张表比我预想的复杂,值得逐行读:
- SGD + 饱和写法: 一步都没动(两个学习率下都是 0.000 / 1.91)。SGD 的步长 = 学习率 × 梯度,梯度只有 量级,步长几乎为 0。这正是原论文换掉这个损失的原因(论文用的就是带动量的 SGD)。
- SGD + non-saturating: 动起来了,但 SGD 训练 GAN 本身就很不顺。lr 0.01 时,第 100 步样本一度被甩到平均 29 个单位以外,之后被拉回来,3000 步后离数据平均 0.69,还没有落到任何一个模式上;lr 0.05 时梯度大、又有动量,44 步就发散了。
- Adam:两种写法都爬出来了,而且这一次运行里饱和写法最后反而更好(8 个模式、高质量 0.899,vs 7 个模式、0.793)。原因是 Adam 按每个参数梯度的大小做归一化(第 8 讲 §6):梯度整体小一万倍,归一化以后的步长差不多——这和第 8 讲 §9.4 “Adam 部分掩盖了梯度消失”是同一个现象。单次运行谁好谁坏,多半是 GAN 训练本身的振荡(§6.1),不说明饱和写法更好。
结论要说得准确:饱和是真实存在的(梯度小一万倍、SGD 完全卡住),但现代优化器会部分替你补救。non-saturating 损失是一份不依赖优化器的”便宜保险”,几乎所有 GAN 实现默认都用它。我还发现,从头开始同时训练 和 时( 没有先被训练得很自信),用 Adam 的饱和写法在 3 个种子上都能正常训练——这是写代码前的原型实验里看到的,记录在代码 README 里。
6. 训练 GAN:振荡、mode collapse、技巧与评估 · Training GANs in practice
6.1 一次训练的样子:损失不是进度条
代码 02 演示 2 用默认配置(non-saturating 损失、Adam lr 1e-3、)从头训练 5000 步,每 250 步记录一次。节选(完整的 20 行见脚本输出):
| 步数 | 损失 | 损失 | (真) | (假) | 覆盖 | 高质量 | 最少模式 |
|---|---|---|---|---|---|---|---|
| 250 | 1.165 | 1.160 | 0.603 | 0.338 | 1 | 0.026 | 0.00 |
| 1000 | 1.209 | 0.926 | 0.559 | 0.420 | 4 | 0.260 | 0.00 |
| 2000 | 1.279 | 0.885 | 0.547 | 0.445 | 7 | 0.895 | 0.02 |
| 3750 | 1.302 | 0.805 | 0.536 | 0.460 | 7 | 0.950 | 0.00 |
| 4000 | 1.302 | 0.799 | 0.535 | 0.461 | 7 | 0.656 | 0.00 |
| 4250 | 1.323 | 0.803 | 0.529 | 0.462 | 8 | 0.944 | 0.13 |
| 5000 | 1.374 | 0.744 | 0.508 | 0.485 | 8 | 0.959 | 0.70 |
(“覆盖”= 分到至少 1% 高质量样本的模式数;“高质量”= 离最近模式中心不超过 的样本比例,真实数据本身是 0.989;“最少模式”= 分到样本最少的那个模式占公平份额(1/8)的比例。定义见 ring_world.py。)
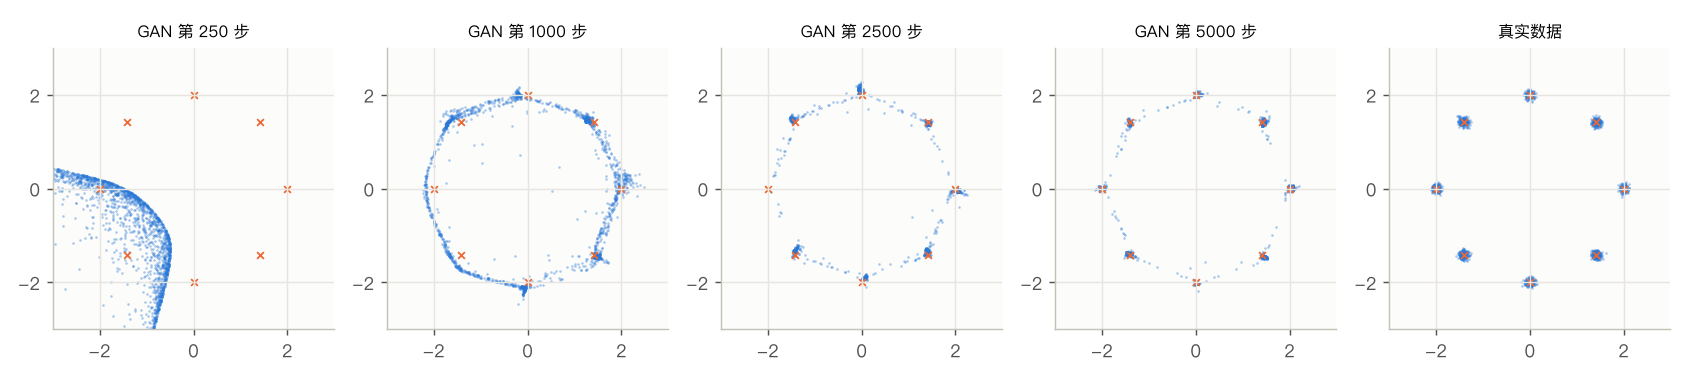
三件事:
- 损失不是进度条。 的损失一直在 1.17–1.37、 的损失在 0.74–1.16 之间,最后慢慢靠近 §5.3 的均衡值(1.386、0.693;(真)、(假)都靠近 0.5)。整体趋势上 损失越低、质量越高(相关系数 −0.64),但逐点看很不可靠:第 4000 步高质量比例从 0.950 掉到 0.656, 损失却只从 0.805 变到 0.799。这是博弈而不是下山: 变好, 的任务就变难,“损失”衡量的是两者的相对强弱,不是 的绝对水平。和第 10 讲反复强调的一样:没有一个可靠的单一数字指标,迭代就会很慢。
- 质量会振荡。后一半训练里高质量比例在 0.656–0.959 之间来回。什么时候停、存哪个检查点,本身就是 GAN 训练的难题。
- 模式会被丢掉很久再找回来。第 4 号模式从第 1000 步到第 4000 步(连续 13 个记录点)几乎没有样本,第 4250 步才回来。这段时间里,其余几团的质量在稳步变好——只看”高质量比例”,你不会发现少了一团。(第 4 号模式就是 那一团,上图第 2500 步那一格里它是空的。)
散点图里还能看到 GAN 的另一个典型现象:团与团之间连着细细的”桥”。 是一个连续函数,它把连通的 空间整块映射过去,要从一团”跳”到另一团,中间总会留下一些样本。这些桥上的样本就是”高质量比例”到不了真实数据 0.989 的主要原因。
6.2 为什么博弈比下山难
第 2–8 讲的优化都是最小化一个固定的函数:每一步都让它变小一点,最终停在某个(局部)最小值。GAN 是两个玩家同时做梯度下降,各自最小化自己的目标,而每个人的目标都取决于对方。这种”同时梯度下降”在博弈里不保证收敛,最简单的反例是 :均衡点是 ,但 、 同时沿各自的梯度走,会绕着原点转圈、而且越转越远;改成交替更新,也只是一直转圈(练习 5)。GAN 训练里的振荡、模式时有时无,都是这种”转圈”的高维版本。很多改进(更小的学习率、给 和 不同的学习率 TTUR、对 加梯度惩罚)都可以理解为让这个动力系统更”阻尼”。
6.3 Mode collapse
Mode collapse(模式坍缩):生成器只生成数据分布里的少数几种样本(极端时只有一种),每一个都很逼真,但多样性没了。用人脸举例:生成器只会画同一张脸。
为什么会这样?想象 暂时固定。对 来说,最好的回应是什么?是把所有样本都放到 最认为”真”的那一个点上——这个点上 最大,而 的损失只关心每个样本”像不像真的”,不关心样本之间是否不同。等 反应过来、开始拒绝那个点, 又整体搬到下一个 喜欢的地方——于是在模式之间跳来跳去(mode hopping)。§5.3 的分析之所以没有这个问题,是因为它假设 每一步都是最优的;交替的小步更新离这个假设很远。
代码 02 的二维玩具上,我们看到的是温和版本:一个模式被丢了 3000 步再找回来(§6.1),而不是彻底坍缩到一两团。我原本预计在这个经典的”8 个高斯”数据上会看到明显的坍缩;实际上默认配置下 6 次训练里有 5 次在后一半始终覆盖全部 8 个模式(§8.4 的表)。这和网络大小、学习率、 都有关系,文献里用更小的网络、不同的设置在同样的数据上报告过严重的坍缩(例如 Metz et al. 2017 的 Unrolled GAN 用它展示标准 GAN 在模式之间轮流跳)。我没有为了”看到坍缩”去调这些参数。
对付 mode collapse 的思路大致有三类:让 看到一批样本而不是一个(minibatch discrimination,Salimans et al. 2016;PacGAN);让 “预判” 的反应(Unrolled GAN);换一个更平滑的距离——Wasserstein 距离在两个分布几乎不重叠时也能给 有用的梯度(WGAN,Arjovsky et al. 2017,论文报告在他们的实验里没有观察到 mode collapse)。§8.2 会看到,扩散模型从目标函数上就更不容易漏模式。
6.4 训练技巧 · Tips and tricks
2016 年前后,让 GAN 训得动主要靠一批经验技巧。最有影响的两篇:
| 来源 | 技巧 | 为什么 |
|---|---|---|
| DCGAN(Radford et al. 2016) | 用步长卷积()和转置卷积()代替池化 | 让网络自己学怎样下采样 / 上采样 |
| 和 都用 BatchNorm( 的输出层、 的输入层除外) | 稳定训练、缓解坍缩 | |
| 去掉全连接隐藏层 | 更深的卷积结构 | |
| 用 ReLU(输出层用 tanh), 用 LeakyReLU | 让梯度在 的负区也能传回 | |
| Adam,lr 0.0002, | 默认的 0.9 动量太大、容易振荡(代码 02 也用 ) | |
| Salimans et al. 2016 | one-sided label smoothing:真样本的目标从 1 改成 0.9,假样本仍是 0 | 防止 过度自信、给 的梯度更平滑;只平滑真样本一侧,避免在没有数据的地方鼓励 |
| feature matching:让 匹配 中间层特征的统计量 | 给 一个更稳定的目标 | |
| minibatch discrimination | 让 能发现”这一批样本都一样”,对付坍缩 | |
| historical averaging、virtual batch normalization | 进一步稳定训练 | |
| 之后 | WGAN / WGAN-GP(Arjovsky et al. 2017;Gulrajani et al. 2017)、spectral normalization(Miyato et al. 2018)、TTUR(Heusel et al. 2017) | 从理论上改目标或约束 的光滑程度 |
2018 年那次课也讲到了让 GAN 训得动的技巧,饱和与 non-saturating 两种生成器损失的对比是其中的重点(按录像概要;具体讲了哪几条技巧,以录像为准)。一个朴素但重要的经验:GAN 的超参数比普通分类网络敏感得多,复现论文时最好从作者的代码和超参数出发(第 11 讲 §4.1)。
6.5 怎样评估一个 GAN?
分类器有准确率,GAN 有什么?GAN 不给出 ,所以连”测试集似然”都算不了。实践中常用两类自动指标(CS230 Section 8 的公开页面也列了它们):
- Inception Score(IS,Salimans et al. 2016):把生成的图喂给一个预训练的 Inception 分类器。好的生成器应该让每张图的类别很确定( 尖),而所有图的类别很分散(边缘分布 平):,越大越好。它完全不看真实数据。
- FID(Fréchet Inception Distance,Heusel et al. 2017):把真实图和生成图都喂给 Inception,取倒数第二层的 2048 维特征,各自拟合一个高斯,算两个高斯之间的距离:
越小越好。它同时惩罚”不像”和”不够多样”,是今天最常用的指标。
但任何一个数字都是一个”透镜”,有它看不见的东西。代码 02 演示 3(a) 把 FID 的公式直接用在二维坐标上(我们的玩具没有 Inception 网络),和一批真实数据比较五组样本:
| 样本 | Fréchet 距离 | 覆盖 | 高质量 | 最少模式 |
|---|---|---|---|---|
| 真实数据(另一批) | 0.002 | 8 | 0.990 | 0.92 |
| GAN 最后一步(演示 2) | 0.038 | 8 | 0.959 | 0.70 |
| 同均值、同协方差的高斯 | 0.003 | 0 | 0.021 | 0.01 |
| 均匀的圆环(没有模式) | 0.001 | 8 | 0.172 | 0.12 |
| 只有第 0 团(完全坍缩) | 7.628 | 1 | 0.988 | 0.00 |
一个形状完全不对的高斯团、一个没有任何”团”的均匀圆环,Fréchet 距离都比 GAN 还小;而完全坍缩的生成器,“高质量比例”几乎和真实数据一样。每一个指标单独看都会被骗:Fréchet 距离只比较均值和协方差,看不见”有没有 8 团”;高质量比例只看”像不像”,看不见”全不全”;覆盖数对均匀圆环也报 8。FID 之所以在 Inception 特征上算,是指望深层特征把”像不像一张真实的图”变成均值和协方差能捕捉的差别——这个指望大体成立,但不总是成立。所以实践中总是几个指标一起看,再加上人看(人工评估、并排比较),还有专门把”质量”和”覆盖”分开测的 precision / recall 指标(Kynkäänniemi et al. 2019)。这和第 10 讲 §2 的道理一样:一个单一数字指标能加快决策,但要知道它在衡量什么。
6.6 应用与伦理
GAN 时代的代表性成果:DCGAN 在潜空间里做”向量算术”(“戴眼镜的男人 − 男人 + 女人 ≈ 戴眼镜的女人”,和第 16 讲的词向量类比是同一种直觉);pix2pix(Isola et al. 2017,有成对数据的图到图翻译)和 CycleGAN(Zhu et al. 2017,用”循环一致性”在没有成对数据时把马变成斑马);超分辨率 SRGAN(Ledig et al. 2017);StyleGAN(Karras et al. 2019)生成的高分辨率人脸几乎无法和照片区分。
能以假乱真,就能被用来造假。Deepfake(伪造的人脸、声音、视频)带来了真实的伤害:未经同意的合成色情内容、冒充他人的诈骗、政治虚假信息,以及”反正什么都可能是假的”带来的信任侵蚀。技术上的应对包括检测模型(和生成模型是一场军备竞赛,§4 的”攻防”在这里换了个方向)、生成时嵌入水印、给内容附加可验证的来源信息(如 C2PA 内容凭证标准)。但技术只是一部分:做生成模型的项目时(第 11 讲),要想清楚数据是否经过同意、输出可能被怎样滥用、是否需要在产品里限制某些用法。
7. 扩散模型 · Diffusion models
7.1 直觉:先学会把图毁掉,再学会倒着走
GAN 一步到位:从噪声直接”变”出一张图,难在没有直接的监督信号,只能靠和 博弈。扩散模型换了一个思路:把”从噪声生成数据”拆成很多个很小的去噪步骤,每一步都是一个有明确答案的监督学习问题。
想象往一滴墨水里不断加清水搅拌,墨迹慢慢扩散,最后整杯水颜色均匀——这个方向很容易。反过来,从一杯均匀的水”复原”出墨迹的形状,单看一大步是不可能的;但如果每次只倒退一小步(“上一刻墨迹比现在稍微集中一点,集中在哪儿?”),每一小步就变得可以学。这个想法来自 Sohl-Dickstein et al. (2015) 借用的非平衡热力学;Ho, Jain & Abbeel (2020) 的 DDPM(denoising diffusion probabilistic models)把它做成了一个简单、好训练、效果惊人的配方:在无条件的 CIFAR-10 上 FID 3.17,是当时最好的成绩。
- 前向过程(固定的,不用学):往数据上一点点加高斯噪声, 步之后变成纯噪声。
- 反向过程(要学的):训练一个网络,看一眼加了噪声的数据,猜出加进去的噪声;生成时从纯噪声出发,一步步把噪声减掉。
7.2 前向过程,以及它的闭式解
第 步:把上一步的结果缩小一点,再加一点噪声:
DDPM 取 , 从 线性增加到 。为什么要先乘 ?如果 的方差是 1,那么 的方差是 ——方差保持(variance preserving),和第 7 讲的初始化是同一种考虑:信号被一点点换成噪声,而不是噪声越堆越多。
关键的一步:高斯加高斯还是高斯,所以连续加 步噪声可以一步算出来。记 ,:
(两步的推导见练习 6,一般情形用归纳法。)代码 03 演示 1 从 出发,让 20,000 条链各自一步步加噪 1000 次,和公式对照:
| 均值(实测) | 公式 | 方差(实测) | 公式 | 信噪比 | ||
|---|---|---|---|---|---|---|
| 1 | 0.9999 | 2.0000 | 1.9999 | 0.00010 | 0.00010 | 9999 |
| 10 | 0.9991 | 1.9984 | 1.9981 | 0.00189 | 0.00189 | 526.8 |
| 100 | 0.9471 | 1.8944 | 1.8942 | 0.10257 | 0.10298 | 8.71 |
| 250 | 0.7239 | 1.4412 | 1.4479 | 0.47849 | 0.47591 | 1.101 |
| 500 | 0.2803 | 0.5414 | 0.5607 | 0.92376 | 0.92141 | 0.08529 |
| 1000 | 0.0064 | 0.0211 | 0.0127 | 0.99215 | 0.99996 | 4.036e-05 |
均值最多差 0.0193、方差的相对误差最多 1.3%,都是 20,000 个样本的随机波动。信噪比从 9999 降到 ,跨了 8 个数量级; 时 只剩 的系数。演示 1(b) 用字符画看整份数据: 时 8 团已经糊开(高质量比例从 0.989 降到 0.289), 时连圆环都看不出来, 就是一团标准正态。
这个闭式解是扩散模型训练快的关键:训练时不需要真的模拟 步,随机抽一个 ,一行公式就造出了 。
7.3 训练:预测噪声,一个回归问题
反向过程要从 走回 。DDPM 的推导(变分下界,这里不展开)最后化简成一个出奇简单的目标——训练一个网络 ,预测加进去的噪声:
训练算法(论文的算法 1)只有四行:抽一个真实样本 ;抽 ;抽噪声 ;对 做一步梯度下降。
回到第 1 讲 §3.6 的那句话:“扩散模型的训练任务是:给一张加了噪声的图,预测噪声,也是 。“现在可以看清楚它为什么是 :输入 ,标签 ,标签是我们自己加的噪声,免费、无限、而且不会变。没有判别器、没有博弈、没有会移动的目标——就是第 1 讲的四步:前向、算 MSE、反向、更新。
代码 03 演示 2 训练一个和代码 02 的生成器一样大的 MLP(3 个 128 单元的隐藏层,SiLU;输入除了 还有 的正弦编码)。每 1000 步的平均损失:
| 训练步数 | 1000 | 2000 | 3000 | 4000 | 5000 | 6000 | 7000 | 8000 | 9000 | 10000 |
|---|---|---|---|---|---|---|---|---|---|---|
| 平均损失 | 0.3387 | 0.2567 | 0.2328 | 0.2161 | 0.2117 | 0.2104 | 0.2078 | 0.2103 | 0.2075 | 0.2070 |
每隔 2000 步用同一组随机数生成样本:
| 训练步数 | 2000 | 4000 | 6000 | 8000 | 10000 |
|---|---|---|---|---|---|
| 覆盖 | 8 | 8 | 8 | 8 | 8 |
| 高质量 | 0.197 | 0.703 | 0.844 | 0.880 | 0.907 |
和 §6.1 的 GAN 对比:损失越低,样本越好,质量单调上升、不振荡。损失终于又是一个可以信赖的进度条了。
损失为什么停在 0.21 而不是 0?按 分段看训练好的网络(每段 4000 个点;基线是”对数据一无所知、假装数据是标准正态 “时的最优猜测——那时 也是标准正态, 和 的协方差是 ,条件期望是 ):
| 区间 | 网络的误差 | 基线:假装数据是 | 猜 |
|---|---|---|---|
| 1–10 | 0.8189 | 1.0038 | 1.0000 |
| 11–50 | 0.2756 | 1.0056 | 1.0000 |
| 51–200 | 0.3564 | 0.9702 | 1.0000 |
| 201–500 | 0.4039 | 0.5047 | 1.0000 |
| 501–1000 | 0.0278 | 0.0268 | 1.0000 |
- 均方误差的最优解是条件期望 ,剩下的误差是条件方差——给定一个带噪的点,“原来的点在哪、加的是哪份噪声”本身就不确定。这部分误差不可避免,不是网络的错。
- 时误差 0.819,几乎和”猜 0”一样:噪声的标准差不到 0.03,比每团数据本身的宽度()还小,分不清哪部分是噪声、哪部分是数据自己的随机性。好在这时噪声本来就小,猜不准也几乎不影响生成。
- 真正需要”懂数据”的是中间那段(51–500):网络知道数据集中在 8 团上,比基线准得多; 越大,“这个点原来属于哪一团”越不确定。
- 时题目很简单: 几乎就是噪声本身,“假装数据是 “已经差不多是最优解,网络并没有比它更好(0.0278 vs 0.0268)。
一个更深的联系(只给结论):最优的噪声预测和数据分布的得分函数(score,,“往哪个方向走,概率密度上升最快”)只差一个系数:。所以去噪网络学的其实是”每个噪声水平下,指向数据的方向”。Song & Ermon (2019) 的 score matching 和 Song et al. (2021) 的随机微分方程视角,把 DDPM 和这条线统一了起来。
7.4 采样:一步步去噪
有了 ,生成就是把前向过程倒着走(论文的算法 2):从 出发,对 :
括号里:从 里减掉”网络猜的噪声”的一部分,再除以 放大回来(前向时缩小过);最后再加一点新的随机噪声 。所以生成过程本身是随机的。
代码 03 演示 3 打印了去噪过程的字符画(下图是同样内容的散点图): 是一团标准正态; 还是一团; 已经是一个疙疙瘩瘩的圆环; 时 8 团已经分开;最后几十步只是把每团”收紧”。先定大结构、再补细节——生成图像时也是这样:先出构图和大块颜色,最后出纹理。
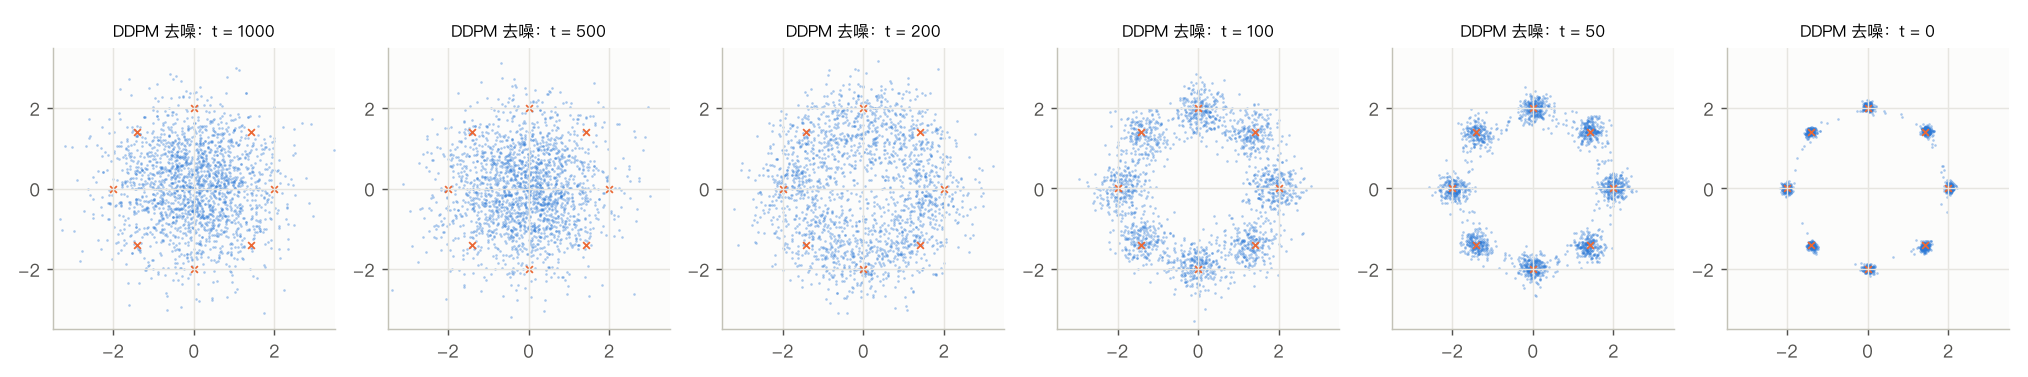
最后的样本:8 个模式全部覆盖,高质量 0.907,最少模式 0.79(各模式的高质量样本数 245、206、252、197、216、217、269、213)。高质量比例比真实数据(0.989)和 GAN 最好的时候(0.959)都低:有一部分样本落在团与团之间的”过渡带”上。在这个小网络、这点训练量下,DDPM 的主要毛病是样本偏糊,而不是丢模式——这一点和我写代码前的预想不一样(我原以为它在质量上也会更好),记在代码 README 里。
7.5 去噪网络:U-Net 与 Transformer
的输入和输出一样大(一张带噪的图 → 一张”噪声图”),这正是第 14 讲 §9.3 U-Net 的形状:编码器把图逐级缩小、看全局;解码器用转置卷积(或上采样 + 卷积)逐级放大;跳跃连接把每个分辨率的细节直接送到输出端——去噪既需要”这里大概是什么”的全局信息,也需要像素级的细节。DDPM 的 U-Net 还在低分辨率处加了自注意力层。
时间步 要告诉网络”现在噪声有多大”。DDPM 用的编码和第 17 讲 §6.2 的 Transformer 位置编码是同一个公式:一组不同频率的正弦和余弦(那里编码”第几个词”,这里编码”第几步”),再通过一个小 MLP 加到每一层上。代码 03 的 time_embedding 就是这样写的(只是正弦、余弦分成前后两半,而不是交替排列)。
后来的工作发现,U-Net 并不是必需的:DiT(Peebles & Xie 2023)把图像(或它的潜表示,§8.5)切成小块当 token,直接用 Transformer 做去噪网络,并且随规模增长效果稳定变好——这就是第 17 讲预告里说的”它的去噪网络在大模型里常常正是一个 Transformer”。
8. 扩散 vs GAN;更快、可控 · Diffusion vs GAN, speed & control
8.1 为什么扩散模型更稳定
把前两节放在一起看:
| GAN | 扩散模型 | |
|---|---|---|
| 训练目标 | 两个网络的 minimax 博弈 | 一个网络的回归(MSE) |
| 目标会不会动 | 会: 的”损失函数”就是正在训练的 | 不会:标签是自己加的噪声 |
| 损失能不能当进度条 | 不能(§6.1) | 能(§7.3) |
| 典型的失败方式 | 振荡、发散、mode collapse | 训练不够时样本偏糊;采样太快时质量下降 |
| 对超参数 | 很敏感(一般经验;§8.4 的二维玩具上差别没有那么大) | 相对不敏感 |
| 生成一个样本 | 1 次前向 | 几十到上千次前向 |
稳定的根本原因是:扩散模型把一个难的问题(一步生成)拆成了很多个简单的、有固定答案的监督学习问题,而且每个问题都用最朴素的 MSE 来学。第 1–17 讲积累的所有关于”怎样把一个回归训练好”的经验,在这里都直接适用。
8.2 为什么覆盖模式更全
另一个差别来自”目标在衡量什么距离”。扩散模型的目标是数据似然的一个下界(变分下界, 是它的简化加权版本)。最大化似然等价于最小化 :如果数据里有一个模式,而模型在那里的概率接近 0,这一项就会趋于无穷大——漏掉模式的代价极高,所以似然类模型倾向于”每个地方都盖一点”(mode covering),代价是可能在数据之间也放一些概率,样本偏糊。
GAN 的目标(§5.3 的 JS 散度;Goodfellow 2016 的教程讨论过,实际训练中 GAN 的行为更接近”反向”的 )则对”把概率放在没有数据的地方”惩罚很重,对”漏掉一个模式”惩罚很轻:一个只生成 7 团、每团都很逼真的生成器, 很难抓住它(§6.1 里第 4 号模式丢了 3000 步)。这叫 mode seeking。
我们的两个实验正好对应这两种倾向:GAN 样本更”尖”但会丢模式(最好时高质量 0.959,但第 4 号模式丢了很久);DDPM 样本覆盖全部 8 个模式,但更”糊”(0.907)。
8.3 代价:采样慢,以及怎样快起来
DDPM 生成一个样本要调用网络 次,GAN 只要 1 次。这是扩散模型最主要的代价,也是 2020 年以后大量工作的焦点。
DDIM(Song, Meng & Ermon 2021)的发现是:同一个训练好的 ,可以换一种确定性的走法,只在 1000 步里挑一个子序列走。每到一个时刻 ,先用 反推出”干净的样本”,再直接”跳”到下一个时刻 :。不需要重新训练。
代码 03 演示 4,同一个网络:
| 采样方法 | 网络调用次数 | 覆盖 | 高质量 | 最少模式 | 到最近中心的平均距离 |
|---|---|---|---|---|---|
| DDPM 祖先采样 | 1000 | 8 | 0.907 | 0.79 | 0.088 |
| DDIM 1000 步 | 1000 | 8 | 0.876 | 0.72 | 0.096 |
| DDIM 100 步 | 100 | 8 | 0.878 | 0.70 | 0.098 |
| DDIM 20 步 | 20 | 8 | 0.821 | 0.58 | 0.114 |
| DDIM 10 步 | 10 | 8 | 0.613 | 0.37 | 0.199 |
| DDIM 5 步 | 5 | 1 | 0.028 | 0.00 | 0.667 |
| DDIM 2 步 | 2 | 0 | 0.001 | 0.00 | 5.574 |
- 快 10 倍(100 步)几乎没有代价,快 50 倍(20 步)代价不大——和 DDIM 论文报告的”快 10–50 倍、质量相近”一致。
- 再往下就崩了。原因藏在 的公式里:在 时要除以 ,把 的一点点误差放大约 157 倍;步数很少时后面来不及修正(2 步时样本离最近中心平均 5.57,远在数据之外)。很多实现会把 裁剪到数据的范围里,代码里为了看清原始行为没有裁剪。
后来的加速方法大致有三类:更好的数值求解器(把采样看成解一个常微分方程);蒸馏(训练一个学生网络一步走老师的好几步);以及从目标上就为少步数设计的 consistency models(Song et al. 2023)、flow matching / rectified flow(Lipman et al. 2023;Liu et al. 2023)。今天的图像模型通常只需要几步到几十步。
8.4 并排看一看:同一个网格上的 GAN 与 DDPM
“稳定”不能只看一次运行。代码 02 演示 3(b) 和代码 03 演示 3 用完全相同的网格各训练 6 次:学习率 {3e-4, 1e-3, 3e-3} × 种子 {0, 1},网络大小相同,其余设置都是各自的默认值(GAN 5000 步,每步更新 、 各一次;DDPM 10000 步)。“后一半”指训练后一半里的记录点:GAN 每 250 步一个(10 个),DDPM 是第 6000、8000、10000 步(每次生成都要走 1000 步,只看 3 个)。
GAN(代码 02 演示 3(b)):
| 学习率 | 种子 | 最后:覆盖 / 高质量 / 最少模式 | 后一半:最少覆盖 | 后一半:高质量范围 |
|---|---|---|---|---|
| 3e-4 | 0 | 8 / 0.932 / 0.62 | 8 | 0.858 – 0.933 |
| 3e-4 | 1 | 8 / 0.938 / 0.78 | 8 | 0.854 – 0.938 |
| 1e-3 | 0 | 8 / 0.959 / 0.70 | 7 | 0.656 – 0.959 |
| 1e-3 | 1 | 8 / 0.973 / 0.84 | 8 | 0.927 – 0.973 |
| 3e-3 | 0 | 8 / 0.944 / 0.75 | 8 | 0.894 – 0.967 |
| 3e-3 | 1 | 8 / 0.965 / 0.80 | 8 | 0.726 – 0.968 |
DDPM(代码 03 演示 3):
| 学习率 | 种子 | 最后:覆盖 / 高质量 / 最少模式 | 后一半:最少覆盖 | 后一半:高质量(第 6000 → 8000 → 10000 步) |
|---|---|---|---|---|
| 3e-4 | 0 | 8 / 0.731 / 0.57 | 8 | 0.305 → 0.571 → 0.731 |
| 3e-4 | 1 | 8 / 0.755 / 0.61 | 8 | 0.360 → 0.640 → 0.755 |
| 1e-3 | 0 | 8 / 0.907 / 0.79 | 8 | 0.844 → 0.880 → 0.907 |
| 1e-3 | 1 | 8 / 0.876 / 0.79 | 8 | 0.823 → 0.827 → 0.876 |
| 3e-3 | 0 | 8 / 0.885 / 0.60 | 8 | 0.816 → 0.872 → 0.885 |
| 3e-3 | 1 | 8 / 0.871 / 0.71 | 8 | 0.797 → 0.811 → 0.871 |
(6 次的最后训练损失都在 0.2070–0.2130 之间。)
读这两张表要诚实:
- 在这个玩具上,GAN 并没有失败。 6 次全部以 8 个模式结束,最后的高质量比例(0.932–0.973)普遍高于 DDPM。GAN 的问题是过程:两次运行的质量在后一半掉到过 0.656 和 0.726,一次丢过模式——如果恰好在那个时刻存模型,结果就很差,而你从损失曲线上看不出来(§6.1)。
- DDPM 的问题是”慢”和”糊”,不是”不稳”。 所有运行始终覆盖 8 个模式,质量随训练单调上升;学习率 3e-4 的两次质量较低,但看上去是还没训练完,而不是振荡(没有验证更长的训练)。它的损失可以直接用来比较这 6 次运行。
- 这只是一个二维玩具、每种配置 2 个种子。在真实的高分辨率图像上,GAN 的不稳定和 mode collapse 要严重得多,这正是扩散模型取代 GAN 的主要原因之一(Dhariwal & Nichol 2021 的 Diffusion Models Beat GANs on Image Synthesis 是一个转折点)。
8.5 条件生成、classifier-free guidance 与 latent diffusion
到目前为止生成的是”随便哪一团”。实际应用要的是条件生成:给一个类别、一句话,生成对应的图。扩散模型做条件生成很自然:把条件 (类别的嵌入、文本编码器的输出)也喂给去噪网络,。
Classifier-free guidance(Ho & Salimans 2022)是让条件生成”更听话”的关键技巧:训练时随机丢掉一部分条件(比如 10% 的样本把 换成”空”),让同一个网络既会有条件地去噪、也会无条件地去噪。采样时把两者外推:
方括号里是”条件 让去噪方向偏了多少”, 时沿这个方向多走一点。按 §7.3 的 score 视角,这相当于给 加权:样本更符合条件、更”典型”,代价是多样性下降——又是一个质量与覆盖之间的旋钮(练习 9)。
Latent diffusion(Rombach et al. 2022,Stable Diffusion 的基础)解决的是”高分辨率太贵”:先训练一个自编码器,把 512×512×3 的图压成一个小得多的潜表示(例如 64×64×4),在潜空间里做扩散,最后再解码回像素。去噪网络的计算量随之大幅下降;文本条件通过交叉注意力(第 16、17 讲的注意力,Q 来自图像特征,K / V 来自文本编码)注入。DALL·E 2、Imagen、Stable Diffusion 这一代文生图模型,以及之后的视频生成模型,都是扩散(或与之密切相关的 flow matching)+ 大规模条件编码器 + U-Net 或 Transformer 的组合。
9. 小结 · Summary
- 对抗样本:每个像素改一点点( 预算 ),网络就以高置信度认错;它们能在模型之间迁移,也能在物理世界里起作用。讨论鲁棒性要先定威胁模型。
- 为什么存在:高维 + 线性。 在 时等于 ,随维度增长;随机噪声只有 分之一(代码 01:224×224×3 时 1/255 的扰动让输出变化 1.21,随机只有 0.003)。训练好的 CNN 在 的尺度上和线性函数几乎没有区别(实际 / 预测 0.998、0.990)。另一种视角:网络用上了人看不见的非鲁棒特征。
- 攻击:FGSM 是一步线性近似;PGD 多走几步再投影。随机噪声 时准确率 0.917,FGSM 0.042,PGD 0.016——决定伤害的是方向,不是大小。迁移到另一个种子的 CNN 仍掉到 0.076。
- 防御:对抗训练 = ,是”取最坏情况”的数据增强。代码 01:强攻击下 0.014 → 0.460,代价是干净准确率 0.941 → 0.792、训练贵 8 倍、只在预算内有效。Gradient masking:量化防御在梯度攻击下”0.939”,BPDA 或迁移攻击一用就掉到 0.01;比随机噪声还鲁棒,就是危险信号。
- 生成模型学 并能采样;几大家族:自回归、VAE、flow、GAN、扩散。
- GAN:;最优判别器 ,代回去是 JS 散度。原始生成器损失在 自信时饱和(梯度小 11,894 倍,SGD 完全卡住),换成 ;Adam 能部分补救。损失不是进度条,质量会振荡,模式会被丢掉(代码 02:一个模式丢了 3000 步);技巧有 DCGAN 的架构建议、one-sided label smoothing 等。
- 评估生成模型很难:IS、FID 各有盲点——同均值同协方差的高斯团,Fréchet 距离 0.003,却一个模式都没有。几个指标 + 人看。
- 扩散模型:前向 (实测和逐步加噪一致);训练 = 预测噪声的 MSE 回归(第 1 讲 §3.6 的 );采样 = 1000 步去噪。损失是可靠的进度条,质量单调上升,覆盖全部 8 个模式(0.907),但比 GAN 最好时更糊。
- 扩散 vs GAN:回归 vs 博弈 → 稳定;似然 vs JS → 覆盖模式 vs 追求逼真;代价是采样慢(DDIM 100 步几乎无损、5 步崩溃)。Classifier-free guidance 让条件生成更听话;latent diffusion 让高分辨率可负担。
- 伦理:部署的模型会被攻击;生成模型会被用来造假。把威胁和滥用写进项目的需求里。
10. 常见误区 · Common pitfalls
- “对抗样本说明深度网络太复杂、太非线性。” 正好相反:线性模型就足以产生对抗样本(代码 01:softmax 回归 时 0.622 → 0.119),网络在局部恰恰是”太线性”了(§2.2)。
- “扰动很小,所以它离原图很近。” 小不等于 小: 随维度增长(§2.1)。“近”要说清楚用哪种距离。
- “加点随机噪声测试一下,模型扛得住就说明鲁棒。” 随机噪声几乎无害( 时 0.917),同样大小的对抗扰动是 0.016(§3.3)。鲁棒性要用最坏情况来测。
- “攻击者拿不到我的模型,所以安全。” 迁移攻击不需要你的梯度(§3.4);线上 API 还可以被大量查询。
- “我的防御让 PGD 失效了,准确率 94%。” 先检查是不是梯度失灵:和随机噪声比、试 BPDA、试迁移、加大 看能否降到 0(§4.3)。
- “对抗训练是免费的数据增强。” 它贵 倍、会降低干净准确率、只在训练时的预算内有效(§4.2)。
- “GAN 的生成器损失在下降,说明它在变好。” GAN 的损失衡量的是 和 的相对强弱;质量可能在损失几乎不变时大幅下跌(§6.1:0.950 → 0.656)。存多个检查点、用指标和眼睛挑。
- “原始的 minimax 生成器损失和 non-saturating 损失是一回事。” 不动点相同,梯度大小完全不同(§5.4);用 SGD 时前者会卡死。
- “FID 低就说明生成得好。” FID 只比较特征的均值和协方差;在二维玩具上,一个没有任何模式的高斯团的 Fréchet 距离比 GAN 还低(§6.5)。
- “扩散模型就是比 GAN 好。” 它更稳定、覆盖更全,但采样慢得多;在我们的玩具上,它的样本甚至比 GAN 最好时更糊(§8.4)。选哪个取决于你更在乎什么。
- “扩散模型的损失降不到 0,说明网络没学好。” 有相当一部分是不可避免的条件方差(§7.3);比较不同模型时看损失的相对大小,并配合生成样本的指标。
11. 练习 · Exercises
练习 1(手算 FGSM)。一个逻辑回归 ,,,输入 (像素在 ),真实标签 。 (a) 算出 和 ,模型判对了吗(阈值 0.5)? (b) 交叉熵对 的梯度是 。写出 的 FGSM 扰动 和 ,它还在 里吗? (c) 算出新的 和 。 变了多少?和 比较。 (d) 如果 的 4 个符号是随机的(16 种组合等可能), 的平均是多少?和 (c) 比,比值是多少?为什么这个比值远小于 §2.1 表里 ImageNet 那一行的?
参考答案
(a) ,,判为 0,判对了。 (b) ,所以 ,,,都在 里(最后一维正好到 0)。 (c) 增加 ,新的 ,,被翻成 1。 (d) 对 16 种符号组合求平均, 的平均是 0.3125(用 Python 枚举验证),比值 。只有 4 维,“同号累加”相对”随机抵消”的优势只有 倍的量级;ImageNet 输入有 150,528 维,优势约 倍。对抗样本之所以在图像上这么容易,维度是关键。
练习 2(为什么是 sign)。(a) 证明:,最大值在 处取到。(b) 如果约束换成 ,最优的 和最大值是什么?(c) 两种约束下的最大值之比最大能有多大?什么样的 让它达到?
参考答案
(a) ,第一个不等号在 和 同号时取等,第二个在 时取等,所以 。 (b) Cauchy–Schwarz:,在 时取等。这是 版本的”快速梯度法”。 (c) ,在 的各分量绝对值相等时取等。也就是说, 攻击能”多拿”的最多是 倍——这和 §2.1 表里”对抗 / 随机 ≈ “是同一个 。( 球的”角”离中心 远,攻击正是把扰动推到这些角上。)
练习 3(用线性近似预测攻击强度)。§2.2 说,这个 CNN 的间隔中位数约 4.04, 的中位数约 131.7。(a) 用”中位数之比”估计一下, 多大时大约一半分对的图会被翻转?(代码打印的是”每张图的比值”的中位数 0.0293,两者为什么不完全相同?)(b) 对照 §3.3 的表,FGSM 在 和 0.05 时分别翻转了原来分对的图的百分之多少?(c) 为什么实际需要的 略大于线性估计?
参考答案
(a) 。“中位数之比”不等于”比值的中位数”:间隔大的图往往梯度也大,两者相关,所以逐张算比值再取中位数(0.0293)和先分别取中位数再相除(0.0307)会略有不同。两者都说明:约 0.03,即 0–255 里不到 8 个灰度级。 (b) :;:。一半的图在 0.03 和 0.05 之间被翻转,比线性估计稍晚。 (c) 两个原因:§2.2 的表显示, 变大后实际下降比线性预测小(0.05 时是 97%,0.1 时 91%),ReLU 的开关在变;而且 FGSM 沿的是交叉熵梯度的符号,而不是间隔 梯度的符号,方向不完全一样。另外像素裁剪到 也会削掉一部分扰动(背景很暗的像素没法再往下改)。
练习 4(最优判别器与 JS 散度)。(a) 对固定的 ,求 在 上的最大值点。(b) 把 代回 ,证明 ,也就是 。(c) 时, 和 等于多少?换成代码里的损失写法( 的损失是两项交叉熵之和, 的损失是 ),均衡值是多少?
参考答案
(a) ;,是最大值。 (b) 记 。。JSD 的定义是两个 KL 的平均,所以 。 (c) ,。 的损失 ; 的 non-saturating 损失 。§6.1 的表里,训练到第 5000 步时是 1.374 和 0.744,(真)、(假) 是 0.508、0.485——正在靠近这个均衡。
练习 5(同时梯度下降为什么会转圈)。考虑博弈 ,唯一的均衡点是 。两个玩家同时做一步梯度更新:,。(a) 写成矩阵形式 ,求 。(b) 证明 每一步都乘以 。这说明什么?(c) 这和 GAN 训练有什么关系?
参考答案
(a) 。 (b) 新的 (交叉项抵消)。所以点绕着原点转、而且越转越远——同时梯度下降不但不收敛到均衡,还会发散。(如果改成交替更新:先更新 ,再用新的 更新 ,,点在一个椭圆上转圈,既不发散也不收敛。) (c) GAN 的 和 就是这样的两个玩家,只是维度高得多、函数非线性。§6.1 里质量的振荡、模式时有时无,可以看作这种”转圈”的高维版本;更小的学习率、给两边不同的学习率、对 的梯度加惩罚等技巧,都是在给这个动力系统加”阻尼”。
练习 6(前向过程的闭式解)。(a) 设 ,, 独立标准正态。证明 ( 标准正态)。(b) 若 、,, 的均值和方差是多少?
参考答案
(a) 代入得 。后两项是独立高斯之和,均值 0,方差 ,所以可以写成 。对 步用归纳法就得到 §7.2 的公式。 (b) 。均值 ,方差 (也可以直接验证:)。
练习 7(噪声表与步数,先预测再运行)。DDPM 的 从 线性增加到 。(a) 用 估算 时的 ,和代码打印的 比较,为什么估计略大?(b) 如果把代码 03 的 T 改成 100( 的两个端点不变), 大约是多少? 里还剩多少原始信号?(c) 先预测:采样时仍然从 出发,生成的样本会怎样?然后改代码运行验证。
参考答案
(a) ,。实际值 略小,因为 ,每一步实际衰减得比估计多一点。 (b) ,(精确的乘积是 0.364)。: 里还有 60% 的原始信号,根本不是纯噪声。 (c) 预期:训练时网络见过的 是”8 团缩小到 0.6 倍、再加上方差约 0.64 的噪声”,而采样时我们给它的是标准正态——起点的分布和训练时不一致,生成的样本会偏离(多半是各团的比例和位置不对、质量明显下降)。这说明噪声表必须让 ,前向过程的终点才真的是我们采样时用的 。具体数字以你运行的结果为准。
练习 8(改代码:饱和写法 + 网格,先预测再运行)。把 02_gan_2d.py 里 run_gan 的 g_kind="ns" 改成 "sat",重跑演示 3(b) 的网格。先预测:6 次训练的结果会怎样?和演示 1(c) 的哪一行有关?
参考答案
预期:run_gan 用的是 Adam,而且 和 从头一起训练, 一开始并不自信。演示 1(c) 的 Adam 一行显示,即使从” 非常自信”的局面出发,Adam + 饱和写法也能爬出来;写代码前的原型实验里,Adam + 饱和写法从头训练 3 个种子也都正常。所以多半看不出明显差别,个别运行的好坏会因为 GAN 本身的振荡而不同。如果把 run_gan 里 的优化器换成 SGD,饱和写法就很可能卡住。具体数字以你运行的结果为准。这个练习的教训:一个技巧”必要不必要”,取决于其余的设置——在别人的代码里删掉一个技巧发现”没影响”,不代表它在你的设置里也没影响。
练习 9(classifier-free guidance)。(a) 在 §8.5 的公式里, 和 分别对应什么?(b) 利用 (§7.3)和贝叶斯公式 ,说明 对应的”得分”是 。(c) 很大时样本会怎样?这和 §6.5、§8.2 里”质量 vs 覆盖”的取舍有什么关系?
参考答案
(a) :,普通的条件模型。:,无条件模型。 (b) 把 换成 (),。由贝叶斯公式,( 不依赖 ),所以方括号 。也就是在条件得分上,再额外加 倍”让一个隐含的分类器更确信是 “的方向——所以叫”无分类器”的引导:不需要单独训练一个分类器。 (c) 很大时,样本被推向”最像 “的少数典型区域:更清晰、更符合条件,但多样性下降,极端时颜色过饱和、样子单一。和 GAN 的 mode seeking、似然模型的 mode covering 是同一条”质量 vs 覆盖”的轴,CFG 把它变成了一个采样时可以调的旋钮。
12. 延伸阅读 · Further reading
课程材料
- CS230 Autumn 2018 Lecture 4 “Adversarial Attacks / GANs”(YouTube,Stanford Online 频道)。
- CS230 Section 8 “Advanced Evaluation Metrics”(公开网页,cs230.stanford.edu/section/8)——GAN 的评估指标。
- Goodfellow (2016). NIPS 2016 Tutorial: Generative Adversarial Networks. ——GAN 作者本人写的长篇教程,§5–§6 的很多直觉出自这里。
对抗样本
- Szegedy et al. (2014). Intriguing properties of neural networks. ICLR.
- Goodfellow, Shlens & Szegedy (2015). Explaining and harnessing adversarial examples. ICLR. ——线性解释、FGSM、熊猫。
- Kurakin, Goodfellow & Bengio (2017). Adversarial examples in the physical world. ICLR Workshop.
- Papernot et al. (2017). Practical black-box attacks against machine learning. AsiaCCS.
- Madry et al. (2018). Towards deep learning models resistant to adversarial attacks. ICLR. ——PGD 与鲁棒优化。
- Athalye, Carlini & Wagner (2018). Obfuscated gradients give a false sense of security. ICML.
- Carlini et al. (2019). On evaluating adversarial robustness. arXiv. ——评估防御的清单。
- Tsipras et al. (2019). Robustness may be at odds with accuracy. ICLR.
- Ilyas et al. (2019). Adversarial examples are not bugs, they are features. NeurIPS.
- Cohen, Rosenfeld & Kolter (2019). Certified adversarial robustness via randomized smoothing. ICML.
- Wong, Rice & Kolter (2020). Fast is better than free: Revisiting adversarial training. ICLR.
- Zou et al. (2023). Universal and transferable adversarial attacks on aligned language models. arXiv.
GAN
- Goodfellow et al. (2014). Generative adversarial nets. NeurIPS.
- Radford, Metz & Chintala (2016). Unsupervised representation learning with deep convolutional generative adversarial networks. ICLR. ——DCGAN。
- Salimans et al. (2016). Improved techniques for training GANs. NeurIPS. ——训练技巧、Inception Score。
- Metz et al. (2017). Unrolled generative adversarial networks. ICLR.
- Arjovsky, Chintala & Bottou (2017). Wasserstein GAN. ICML;Gulrajani et al. (2017). Improved training of Wasserstein GANs. NeurIPS.
- Heusel et al. (2017). GANs trained by a two time-scale update rule converge to a local Nash equilibrium. NeurIPS. ——TTUR 与 FID。
- Isola et al. (2017). Image-to-image translation with conditional adversarial networks.(pix2pix);Zhu et al. (2017). Unpaired image-to-image translation using cycle-consistent adversarial networks.(CycleGAN)
- Karras, Laine & Aila (2019). A style-based generator architecture for generative adversarial networks. CVPR. ——StyleGAN。
扩散模型
- Sohl-Dickstein et al. (2015). Deep unsupervised learning using nonequilibrium thermodynamics. ICML.
- Ho, Jain & Abbeel (2020). Denoising diffusion probabilistic models. NeurIPS. ——DDPM。
- Song & Ermon (2019). Generative modeling by estimating gradients of the data distribution. NeurIPS;Song et al. (2021). Score-based generative modeling through stochastic differential equations. ICLR.
- Song, Meng & Ermon (2021). Denoising diffusion implicit models. ICLR. ——DDIM。
- Dhariwal & Nichol (2021). Diffusion models beat GANs on image synthesis. NeurIPS.
- Ho & Salimans (2022). Classifier-free diffusion guidance. arXiv(NeurIPS 2021 Workshop).
- Rombach et al. (2022). High-resolution image synthesis with latent diffusion models. CVPR. ——Stable Diffusion 的基础。
- Peebles & Xie (2023). Scalable diffusion models with Transformers. ICCV. ——DiT。
- Kingma & Welling (2014). Auto-encoding variational Bayes. ICLR. ——VAE,生成模型的另一大家族。
13. 下一讲预告 · Next lecture
这一讲的两半有一个共同点:目标函数不再是”在固定数据上的平均损失”。对抗训练里,数据是一个对手在最坏情况下挑出来的;GAN 里,损失函数本身是另一个正在学习的网络。
第 19 讲:深度强化学习(对应 Fall 2025 Lecture 5、Autumn 2018 Lecture 9)把这一步走得更远:连”数据”都不是事先给好的,而是智能体自己和环境交互产生的;没有标签,只有延迟的奖励。你会看到:
- 强化学习和监督学习的区别:没有 ,只有奖励,而且好坏要过很久才知道;
- Q-learning 与 Bellman 方程;DQN 怎样用经验回放和目标网络让”追逐自己的目标”变得稳定——这和本讲 GAN”目标会移动”的问题是同一类难题;
- policy gradient,AlphaGo 怎样把搜索和学习结合起来;探索与利用;
- RLHF:大语言模型怎样用人类偏好做强化学习。