对应 Maps to:Coursera Deep Learning Specialization C5M4 “Transformer Network”(Transformer Network Intuition、Self-Attention、Multi-Head Attention、Transformer Network);编程作业 “Transformer Network”(位置编码、缩放点积注意力、padding mask 与 look-ahead mask、编码器层与解码器层、完整的 Transformer),以及几个可选实验(Transformer Pre-processing、命名实体识别、问答);Stanford CS230 Fall 2025 第 10 周(这一周学 C5M4,课堂讲座是 Lecture 10 “What’s Going On Inside My Model? / Class Wrap”)。 依据说明:Coursera 的视频和编程作业不公开。本讲按 Ng 课程里广为人知的内容来写(“Jane visite l’Afrique en septembre” 的自注意力例子、“问题 / 标签 / 内容”的 Q、K、V 类比、“每个头问一个不同的问题”),细节可能和视频有出入;技术细节一律以原始论文为准(Vaswani et al. 2017,以及 §14 列出的 LayerNorm、残差、BERT、GPT、T5、ViT、Pre-LN 等论文)。CS230 Fall 2017 的公开课件 Handout 8 “Attention Models” 讲的是词向量和 RNN + 注意力,没有涉及 Transformer,对应第 16 讲。 配套代码 Code:
code/lecture17/(numpy 从零实现每一块积木,再和 PyTorch 逐数字对照;用 PyTorch 从零搭一个小 Transformer,和 GRU seq2seq 比较;5 个脚本 + 2 个模块,最慢的05_transformer_vs_rnn.py约 105 秒,其余几秒到半分钟) 预计阅读时间:3–3.5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说清楚 RNN 的两个结构性瓶颈——顺序计算无法并行、信息要走 O(n) 步——以及”把循环去掉、只留注意力”为什么能同时解决它们,代价是什么(计算量随序列长度平方增长)。
- 用”问题 / 标签 / 内容”的类比解释自注意力:每个词的 、、 从哪里来, 的每一步在做什么;能手算一个 5 个词的例子;知道自注意力对词序是置换等变的。
- 推导为什么要除以 :点积的方差随 线性增长 → softmax 饱和 → 梯度消失;把它和第 7 讲”方差保持的初始化”联系起来。
- 解释多头注意力:每个头在自己的子空间里”问一个问题”,拼接后再投影;参数个数和头数无关。
- 写出正弦位置编码的公式,解释”不同频率”的设计和 是 的线性函数这一性质;知道可学习的位置编码。
- 画出编码器层和解码器层:残差 + LayerNorm、前馈网络、look-ahead mask、padding mask、编码器-解码器注意力(Q 来自解码器,K / V 来自编码器);说出 LayerNorm 和 BatchNorm 的区别、Post-LN 和 Pre-LN 的区别。
- 理解”训练时 teacher forcing 并行、推理时自回归逐步生成”;知道 encoder-only / decoder-only / encoder-decoder 三类 Transformer(BERT / GPT / T5)和 ViT,以及”预训练”这个想法。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉、后面再展开 Previewed only |
|---|---|
| softmax 与它的数值稳定写法(第 9 讲 §3.7) | 用预训练的大语言模型做应用:prompting、RAG、agents、微调(第 20 讲) |
| Batch Normalization(第 9 讲 §2),残差连接(第 13 讲 §3) | 注意力图能不能当”解释”、探针与机制可解释性(第 21 讲) |
| 方差保持的初始化(第 7 讲 §3) | 长上下文的高效注意力(FlashAttention、稀疏 / 线性注意力),只在 §10 提一句 |
| RNN、GRU / LSTM、梯度消失与长程依赖(第 15 讲) | 视觉 Transformer 的细节(只在 §10 介绍思想) |
| 词嵌入、seq2seq、beam search、BLEU、RNN 上的注意力(第 16 讲) | |
PyTorch 的 nn.Module、训练循环、形状约定(第 9 讲 §4) |
本讲是序列模型部分(第 15–17 讲)的最后一讲。第 16 讲在 RNN 上加了注意力;这一讲把 RNN 整个拿掉,只留注意力——这就是 2017 年的 Transformer,今天几乎所有大模型的骨架。
0.3 本讲地图 Map
§1  从 RNN + 注意力到"只用注意力":并行与路径长度                    ← 代码 01 演示 4
§2  自注意力:每个词问一个问题(Jane visite l'Afrique en septembre)  ← 代码 01 演示 1
§3  矩阵形式、置换等变与计算量                                       ← 代码 01 演示 2、3、5
§4  为什么除以 √d_k                                                 ← 代码 02 演示 1–3
§5  多头注意力                                                      ← 代码 02 演示 4、5
§6  位置编码                                                        ← 代码 03
§7  编码器层:残差 + LayerNorm + 前馈;Post-LN vs Pre-LN             ← 代码 04 演示 1–3
§8  解码器与掩码:look-ahead、编码器-解码器注意力、padding、teacher forcing ← 代码 04 演示 4–6
§9  实验:一个小 Transformer vs GRU seq2seq                          ← 代码 05
§10 Transformer 的影响:BERT / GPT / T5、ViT、预训练
§11–15 小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 | 论文 base 模型的取值 |
|---|---|---|
| 序列长度(一句话有几个词 / token) | — | |
| 每个词的向量维度(嵌入、各层输出都是这个维度) | 512 | |
| 头数(number of heads) | 8 | |
| 每个头的 query / key 维度、value 维度,通常 | 64 | |
| 前馈网络中间层的宽度 | 2048 | |
| 编码器、解码器各堆几层 | 6 | |
| 一个句子:每一行是一个词的向量 | ||
| , | 把每个词投影成 query、key、value 的矩阵 | |
| 所有词的 query / key / value,各占一行 | ||
| 第 个位置的位置编码的第 维 |
关于”按行”:第 1–8 讲的 numpy 代码用 Ng 的约定,样本按列堆。注意力的论文、Coursera 的 Transformer 作业和 PyTorch 都按行放词: 的第 行是第 个词,。本讲的公式和代码(包括 numpy 部分)都按行写,这和第 9 讲 §4.3 起 PyTorch 的”每一行一个样本”一致。Ng 的视频里写的是列向量形式 ,和这里只差一个转置。上标 表示第 个词(Ng 在序列模型里的记号),本讲在不引起混淆时直接写下标 。
0.5 关于数字 · About the numbers
讲义里的实验数字都来自配套代码的实际输出(固定随机种子,PyTorch 单线程;同一台机器上重复运行,除了计时以外逐字相同)。计时数字(代码 01 演示 5、代码 05 的 ms/步)每次运行都不同,讲义只引用它们的量级和趋势。序列任务全部是合成的(随机符号序列的反转、“查字典”),只用来说明机制,不代表任何真实任务上的表现。有几处结果和我写代码前的预想不一样,讲义按实际结果写,并列在代码 README 的”关于实验结果”里。
1. 从 RNN + 注意力到”只用注意力” · Why “attention is all you need”
1.1 先回顾第 16 讲
第 16 讲把机器翻译做成了一个条件语言模型:编码器 RNN 读完源句子,解码器 RNN 一个词一个词地生成译文(用 greedy 或 beam search 挑最可能的句子,用 BLEU 评估)。最朴素的 seq2seq 要把整句源语言压进一个固定大小的向量,句子一长就力不从心。注意力的直觉是”翻译长句时回头看”:解码器每生成一个词,都对源句子的每个位置打一个分,softmax 成权重,取加权平均作为这一步的上下文——第 16 讲在日期翻译任务上把这些权重画了出来,看到了输出和输入之间的”对齐”。
注意力解决了”压缩成一个向量”的瓶颈。但编码器和解码器仍然是 RNN。Ng 在 C5M4 的第一个视频(Transformer Network Intuition)里说得很直接:从 RNN 到 GRU 到 LSTM,模型越来越复杂,但它们都是顺序的——要处理第 个词,必须先处理完前 个。
1.2 RNN 的两个结构性瓶颈
瓶颈一:不能并行。 第 15 讲的 RNN 是 : 要等 算完。一句 50 个词的话,前向传播就是 50 个必须排队的小步骤,GPU 上几千个计算核心大多在等。训练数据越多、句子越长,这个问题越要命——而第 1 讲说过,规模是这一波深度学习的主要驱动力。
瓶颈二:信息要走 步。 第 1 个词的信息要传到第 个位置,必须穿过 次”乘 、过激活函数”。反向传播时梯度也要原路返回,每一步都可能被打折或放大——这就是第 15 讲的梯度消失和长程依赖问题。GRU / LSTM 的门控让衰减慢得多,但路径长度仍然是 。
代码 01 演示 4 直接测了”路径长度”:一个随机初始化的 RNN 和一个随机初始化的自注意力层,序列长度 64,看最后一个位置的输出对第 个输入有多敏感(雅可比矩阵的范数,5 条随机序列平均):
| 距离 | 0 | 1 | 2 | 4 | 8 | 16 | 32 | 63 |
|---|---|---|---|---|---|---|---|---|
| RNN | 3.8e+00 | 2.3e+00 | 1.4e+00 | 5.9e−01 | 7.9e−02 | 1.9e−03 | 5.3e−07 | 9.2e−14 |
| 自注意力 | 1.7e+00 | 1.6e−01 | 1.3e−01 | 6.3e−02 | 9.0e−02 | 2.0e−01 | 5.9e−02 | 9.6e−02 |
RNN 的敏感度几乎按指数衰减:距离 32 时只剩 5.3e−07,距离 63 时 9.2e−14——远处的词对输出几乎没有影响,梯度也几乎传不回去。自注意力在 3.8e−02 到 5.1e−01 之间上下波动,和距离没有关系(距离 1–8 的平均 1.1e−01,距离 32–63 的平均 1.3e−01):任何两个位置之间只隔一层。(距离 0 是最后一个词自己,它还多一条经过 query 的路径,所以大一些。)
1.3 想法:把循环去掉
2017 年,Google 的 Vaswani 等人发表了 Attention Is All You Need。标题就是想法本身:既然注意力能让任何两个位置直接交流,那还要循环做什么? 他们提出的 Transformer 完全没有 RNN,也没有卷积:
- 每一层里,每个词同时对所有词做注意力(自注意力,self-attention),得到一个”看过上下文”的新表示—— 个位置的计算互不依赖,可以并行;
- 顺序信息不再来自”按顺序计算”,而是直接加到输入上(位置编码,§6);
- 堆很多层,每层之间用残差连接和 LayerNorm 保证训练稳定(§7)。
Ng 把它概括成:Transformer 把基于注意力的表示和 CNN 式的并行处理结合了起来——像卷积层一次处理整张图一样,一层自注意力一次处理整个序列。
效果是立竿见影的。论文在 WMT 2014 英德翻译上达到 28.4 BLEU、英法翻译上 41.8 BLEU,都超过了此前包括集成模型在内的最好结果;base 模型在 8 块 P100 GPU 上只训练了 12 小时,训练成本只是之前那些模型的一小部分。此后几年里,BERT、GPT、T5、ViT……几乎所有大模型都建在它上面(§10)。
1.4 代价是什么?
天下没有免费的午餐。每个词都和每个词打分,一层就要算 个分数:计算量和内存随序列长度平方增长(§3.4)。RNN 是 。这个代价在句子长度几十到几百时不算什么,在几万到几十万个 token 的长上下文里就成了主要瓶颈(§10.4)。
另一个代价不那么显眼:自注意力不知道词的顺序(§3.2)。RNN”白送”的顺序信息,Transformer 要专门加回来。
2. 自注意力:每个词问一个问题 · Self-attention
2.1 Ng 的例子:Jane visite l’Afrique en septembre
Ng 讲自注意力用的是一句法语:“Jane visite l’Afrique en septembre”(Jane 九月去非洲)。目标是给每个词算一个新的表示 ,它取决于上下文。
为什么需要”取决于上下文”?第 16 讲的词嵌入给每个词一个固定的向量:不管在什么句子里,“l’Afrique”都是同一个向量。但同一个词在不同句子里的意思可以很不一样——这里的 l’Afrique 是”旅行的目的地”,在另一句话里它可能是”一段历史”或”一个大陆的地理”。自注意力让 l’Afrique 的表示参考句子里其他的词:既然句子里有”visite”,它就应该带上”被访问的地方”这层意思。
2.2 Query、key、value:问题、标签、内容
自注意力给每个词准备三个向量,都由这个词自己的嵌入 线性变换得到:
Ng 用的类比来自数据库查询,可以这样记:
| 向量 | 类比 | 在 l’Afrique 这一步里 |
|---|---|---|
| query | 问题:第 个词想知道什么 | :“这里发生了什么事?” |
| key | 标签:第 个词能回答什么样的问题 | (visite):“我是一个动作” |
| value | 内容:第 个词真正提供的信息 | :visite 的具体内容 |
计算分三步。第 3 个词 l’Afrique 用它的问题 去和每个词的标签比较(点积:越匹配越大),softmax 成权重,再用权重把每个词的内容加起来:
这就是 Ng 视频里的公式(真正实现时点积还要除以 ,§4)。如果 最大,visite 的内容 在 里占的比重就最大。
为什么要分成三个向量,而不是直接拿 打分、拿 求和?因为”想问什么""能回答什么""实际提供什么”是三件不同的事。一个动词想找”谁做的”,而它自己能回答的是”做了什么”——如果 query 和 key 是同一个向量,一个词就只能找”和自己相似的词”。三个独立的投影矩阵让模型自己学这三种角色(它们和第 3 讲 §5.3 提到的”线性投影”一样不带激活函数,非线性来自 softmax 和后面的前馈网络)。
2.3 手算一遍
代码 01 演示 1 把这个类比变成了能手算的数字。我们故意让每一维有含义:4 维分别表示”人物 / 动作 / 地点 / 时间”;(每个词的标签和内容就是它自己的类型); 让人物、地点、时间都去问”动作?“,动作去问”人物?地点?“(再乘一个强度 4,让偏好明显一点)。真实模型里这些矩阵是学出来的、几百维、没人能直接读懂——这里只是把类比摆成数字。
l’Afrique 的 query 是 :“这里发生了什么动作?“。它和 5 个 key 的点积除以 后是 ,softmax 之后:
| 权重 | Jane | visite | l’Afrique | en | septembre |
|---|---|---|---|---|---|
| l’Afrique 这一行 | 0.083 | 0.614 | 0.083 | 0.137 | 0.083 |
| visite 这一行 | 0.379 | 0.051 | 0.379 | 0.139 | 0.051 |
l’Afrique 把 0.614 的注意力给了 visite,它的新表示 主要由”动作”的内容构成:它不再只是一个孤立的地名,而是”被访问的地方”。visite 问”谁、在哪儿”,把权重平分给 Jane 和 l’Afrique(各 0.379)。
你可能注意到: 里”地点”那一维只有 0.117——l’Afrique 自己是什么,好像被冲淡了。这正是下一步残差连接要解决的:编码器层的输出是 ,原来的 会被加回来(§7.1)。
2.4 和第 16 讲的注意力有什么不同
| 第 16 讲:RNN 上的注意力 | 本讲:自注意力 | |
|---|---|---|
| query 来自 | 解码器的隐藏状态 | 同一个序列里的每个词 |
| key、value 来自 | 编码器每个位置的隐藏状态 | 同一个序列里的每个词 |
| 打分 | 一个小网络(Bahdanau 的加法注意力),或点积 | 投影后的点积,除以 |
| 一次算几行 | 解码器每步一行(顺序的) | 所有 行同时算 |
| 作用 | 解码器”回头看”源句子 | 每个词”看”整个句子,更新自己的表示 |
两者的核心是同一个操作:用 query 对一组 key 打分,softmax,再对 value 加权平均。Transformer 的解码器里也保留了第 16 讲那种”回头看源句子”的注意力,只是叫编码器-解码器注意力(cross-attention,§8.2)。
3. 矩阵形式、置换等变与计算量 · Scaled dot-product attention
3.1 一次算出所有词
对每个词各写一遍 §2.2 的公式太慢。把所有 query 叠成矩阵 (每行一个),key 叠成 ,value 叠成 :
| 量 | 形状 | 含义 |
|---|---|---|
| , | 每行一个词的 query / key | |
| 每行一个词的 value | ||
| 第 个数 = 第 个词的问题和第 个词的标签的匹配度 | ||
| softmax(每一行) | 第 行 = 第 个词分给所有词的注意力,加起来等于 1 | |
| 输出 | 第 行 = 第 个词的新表示 |
的第 个元素正是 ,所以矩阵写法和逐词循环做的是完全相同的事。代码 01 演示 2 验证:逐词循环 vs 矩阵写法最大差 4.4e−16,和 PyTorch 2.x 自带的 F.scaled_dot_product_attention 差 2.2e−16(float64)。这和第 1 讲 §4.4、第 2 讲讲的向量化是同一个道理:把循环交给矩阵乘法。
3.2 自注意力不知道词的顺序
先让你想一个问题:如果把输入句子的词打乱顺序,自注意力的输出会怎样?
看公式:打分 只取决于两个词的内容,和它们在第几个位置无关。把输入的行打乱(左乘一个置换矩阵 ), 的行跟着打乱, 的行和列同时被打乱,softmax 逐行做,结果是:
输出只是跟着打乱,每个词得到的新表示完全不变。这叫置换等变(permutation equivariance)。
代码 01 演示 3 用随机嵌入算了 “Jane visite Marie” 和 “Marie visite Jane”:
| 同一个词在两句话里的输出差 | 不加位置编码 | 加了位置编码 |
|---|---|---|
| Jane | 2.2e−16 | 2.7e−01 |
| visite | 2.8e−16 | 1.5e−01 |
| Marie | 1.7e−16 | 8.2e−02 |
不加位置编码时,visite 在两句话里的输出一模一样——自注意力分不清谁访问了谁。随机的 6 个词、随机置换时, 2.2e−16;加上位置编码后变成 1.29。
和第 12 讲 §9.2 对比很有意思:卷积对平移等变(图案挪一挪,特征图跟着挪),自注意力对任意置换等变——它的先验比卷积弱得多,几乎不对数据的结构做假设。这既是它通用的原因,也是它需要更多数据的原因(§10.3)。顺序信息必须另外加进去:这就是 §6 的位置编码。
3.3 并行与路径长度
回到 §1.2 的两个瓶颈。矩阵写法里, 个位置的输出由同一次矩阵乘法算出,没有任何必须顺序执行的步骤;任何两个位置之间只隔一次注意力,路径长度 。论文的表 1 把三种层放在一起比较(代码 01 演示 5 打印了这张表):
| 层类型 | 每层计算量 | 必须顺序执行的步数 | 任意两个位置之间的最长路径 |
|---|---|---|---|
| 自注意力 | |||
| RNN | |||
| 卷积(核宽 ) | ,空洞卷积 |
卷积也能并行,但它是局部的(第 12 讲:一个 3×3 的核只看邻居),要让相距很远的两个位置交流,得叠很多层。自注意力一层就是全局的。
3.4 计算量:平方增长
是 ,约 次乘加;权重乘 又是 。所以自注意力的主项是 ,而 RNN 每步做一次 的矩阵乘向量,共 。代码 01 演示 5 按 算了乘加次数:
| 自注意力 | RNN | 自注意力 / RNN | |
|---|---|---|---|
| 16 | 1.31e+05 | 4.19e+06 | 0.03 |
| 256 | 3.36e+07 | 6.71e+07 | 0.50 |
| 512 | 1.34e+08 | 1.34e+08 | 1.00 |
| 4096 | 8.59e+09 | 1.07e+09 | 8.00 |
比值就是 。论文的论点是:翻译里的句子通常比 短,所以自注意力”每层还更便宜”。但 一旦远大于 ,平方项就占了上风。实测(numpy,;计时每次不同)也能看到这一点: 每翻一倍,自注意力的耗时大致变成 3–4 倍(平方增长对应 4 倍, 小时固定开销占比大);一个 的 float64 权重矩阵在 时就占 33.6 MB——每个头、每一层各一个。长上下文模型为此发明了 FlashAttention(不把 矩阵完整存下来)、稀疏注意力、线性注意力等技巧(§10.4)。
还要说清楚一点:在单个 CPU 进程上看不出”并行”的好处。演示 5 里短序列时 RNN 的 Python 循环反而更慢(循环开销),长序列时自注意力更慢(平方项)。Transformer 训练快,靠的是 GPU 上把一层里所有位置的计算一次铺开,而 RNN 的第 步无论如何要等第 步。
4. 为什么除以 · Why scale by
4.1 先想一想
§3.1 的公式里有一个看起来不起眼的 。如果去掉它, 时会发生什么? 呢?先想一想: 是 个数的和,它的大小会怎样随 变化?
4.2 点积的方差随 线性增长
论文脚注里的论证是这样的:假设 和 的每个分量都是独立的、均值 0、方差 1 的随机变量。那么
个独立项相加,方差相加:,标准差 。除以 正好把方差拉回 1。
这和第 7 讲 §3.1 的 是同一个推导:一个和里的项越多,每一项就要越小,结果的尺度才不会随维度变化。第 7 讲把补偿放在权重的初始化里(),这里把它放在打分公式里。
代码 02 演示 1(每个 抽 20,000 对随机向量):
| 4 | 16 | 64 | 256 | 1024 | |
|---|---|---|---|---|---|
| 的方差 | 4.0 | 15.9 | 63.1 | 254.8 | 1011.4 |
| 的方差 | 1.005 | 0.992 | 0.986 | 0.995 | 0.988 |
时打分的标准差约 32:随便两个 key 的打分就能差几十。
4.3 打分太大 → softmax 饱和 → 梯度消失
打分差几十会怎样?softmax 对差值做指数:两个打分差 30,权重就差 倍——softmax 几乎变成了 argmax,所有权重压在一个 key 上。
更要命的是梯度。设 ,它对打分的导数(雅可比矩阵)是
接近 one-hot(比如 )时, 的每个元素都接近 0:损失对打分的梯度 几乎为 0,、 就学不动了。初始化时这个”几乎 one-hot”的选择是随机的,模型却几乎得不到”换一个 key 试试”的信号。
代码 02 演示 2:一个 query 对 16 个 key 打分(均匀分布的熵是 ),2000 次平均:
| 最大权重 | 熵 | 最大权重 > 0.99 的比例 | |||
|---|---|---|---|---|---|
| 4 | 不缩放 | 0.423 | 1.771 | 0.3245 | 0.2% |
| 4 | 0.233 | 2.382 | 0.2976 | 0.0% | |
| 64 | 不缩放 | 0.835 | 0.429 | 0.1824 | 27.5% |
| 64 | 0.244 | 2.360 | 0.3043 | 0.0% | |
| 1024 | 不缩放 | 0.959 | 0.097 | 0.0543 | 76.1% |
| 1024 | 0.245 | 2.358 | 0.3050 | 0.0% |
缩放后各行几乎一样(最大权重约 0.25、熵约 2.36、 约 0.30),不管 多大,起点都相同。不缩放时 有 76% 的 query 把 99% 以上的权重给了同一个 key, 掉到 0.0543。
注意第一行: 时不缩放的 反而略大(0.3245 vs 0.2976)——打分的标准差只有 2,softmax 还没饱和。问题是 变大以后才出现的。论文也是这么说的: 小的时候,点积注意力和加法注意力(第 16 讲的 Bahdanau 式)表现差不多; 大了,不缩放的点积注意力就落后了。
4.4 训练时会怎样?一个”查字典”实验
方差和梯度只说明了初始化时的情况。训练起来到底差多少?代码 02 演示 3 设计了一个字面意义上的 Q / K / V 任务:每个样本有 16 对 (key, value),再给一个 key,要输出它对应的 value(瞎猜 1/16)。模型就是一层单头注意力:query 和每一对的 key 比较,取匹配那一对的 value。、 用方差 初始化,于是 、 的分量方差约为 1,正好是 §4.2 的假设。 取 16、64、256,缩放 / 不缩放,Adam 扫 4 个学习率、SGD 扫 5 个,每个训练 600 步,记”第一次达到 90% 准确率的步数”。扫过的学习率里最快的结果:
| Adam:缩放 | Adam:不缩放 | SGD:缩放 | SGD:不缩放 | |
|---|---|---|---|---|
| 16 | 50 步 | 275 步 | 50 步 | 225 步 |
| 64 | 50 步 | 450 步 | 25 步 | 300 步 |
| 256 | 75 步 | 600 步 | 25 步 | 没达到 |
再看”有多少个学习率能在 600 步内达到 90%“:缩放时 Adam 在三个 下 4 个学习率全部达到;不缩放时只剩 3 个、2 个、1 个。SGD 不缩放、 时,5 个学习率一个都没达到。
三点读法:
- 缩放让训练对 不敏感:最快的步数在 25–75 之间,几乎不随 变。
- 不缩放时慢好几倍,而且能用的学习率范围变窄, 越大越难。
- Adam 会部分”补救”(它按梯度大小归一化步长,第 8 讲 §9.4 见过它掩盖梯度消失),所以不缩放 + Adam 总能在某个学习率下学会,但仍然慢得多。
这是一个单层、单种子的小实验,说明的是机制。你可能会问:不缩放,等价于把 的初始化放大 倍,那把初始化缩小一点不就行了?初始化时确实等价,但训练中 、 会变,打分的尺度也会跟着变;把 写进公式,等于让”温度”在整个训练过程中都保持在一个和维度无关的合理范围——对超参数的选择也就更宽容。
5. 多头注意力 · Multi-head attention
5.1 一个头只能给出一个”平均”的答案
回到 Jane 的句子。visite 想同时知道三件事:谁去的、去了哪儿、什么时候去的。如果只有一个头,它只能用一个 query 同时问这三个问题。代码 02 演示 5:visite 的 query 同时指向”人物 + 地点 + 时间”,权重分给 Jane、l’Afrique、septembre 各 0.284,输出是它们的平均——“谁""哪儿""何时”混在一个向量里,后面的层分不清哪部分来自哪个词。
换成三个头,每个头有自己的 ,各问一个问题:头 1 问”谁?“(0.797 的权重给 Jane),头 2 问”在哪儿?“(0.797 给 l’Afrique),头 3 问”什么时候?“(0.797 给 septembre)。三个答案拼接起来,放在 12 维向量的不同位置,互不干扰。这就是 Ng 在 Multi-Head Attention 视频里的说法:每个头问一个不同的问题(大意是”发生了什么""什么时候""谁”)。论文的原话是,单个头里 “averaging inhibits this”——平均会抑制”同时关注几个地方”。
5.2 公式与参数
每个头的 、,。论文取 、。
一个容易误解的地方:多头并不增加参数。8 个头、每个 64 维的 横着拼起来,正好是一个 的矩阵——和 1 个头、 的 一样大。代码 02 演示 4 数了 nn.MultiheadAttention(512, h) 的参数:、8、16 都是 1,050,624 (4 个矩阵加 4 个偏置)。计算量也差不多。多头改变的只是:把同样的维度切成几个独立的子空间,各算各的 softmax。
头数也不是越多越好。论文表 3 的消融实验里,单头比最好的设置差 0.9 BLEU,头太多(每个头的 太小)质量也会下降。
5.3 实现:切分,而不是 套独立的矩阵
Ng 的视频把每个头画成一套独立的 。实现时几乎都是先用一个大矩阵投影,再把 维切成 段(attention_numpy.split_heads:),一次性对所有头做注意力,最后拼回来(combine_heads)再乘 。两种说法数学上完全等价,后者快得多。
5.4 和 PyTorch 对照,以及一个掩码约定的坑
代码 02 演示 4 把同一组参数分别交给 numpy 版、本讲用 PyTorch 从零搭的 MultiHeadAttention、PyTorch 自带的 nn.MultiheadAttention,三者的输出最大差 1.3e−15、8.9e−16,每个头的权重差 2.2e−16,Q 来自另一个序列(cross-attention)时差 6.7e−16。拷参数时要注意 PyTorch 的布局:nn.Linear 的权重是 (out, in),算的是 ;nn.MultiheadAttention 还把 竖着叠成一个 的 in_proj_weight。
掩码的约定是一个真实的坑。 Coursera 作业(据我所知的新版本)和本讲的 numpy 代码用 1 表示”可以看”、0 表示”不许看”;TensorFlow 官方的 Transformer 教程和这个作业的早期版本正好相反,用 1 表示”遮住”。PyTorch 的 nn.MultiheadAttention 的布尔掩码正好相反:True 表示”忽略”;而 F.scaled_dot_product_attention 的布尔 attn_mask 又是 True 表示”可以看”。传反了不会报错。演示 4 故意传反:每个 query 放在两个填充位置上的权重之和变成了 1.000——注意力只看填充、完全不看真实的词。用任何一个框架的注意力之前,都要查文档,并打印几行权重检查一下。
6. 位置编码 · Positional encoding
6.1 为什么必须有
§3.2 说过:自注意力对置换等变,“Jane visite Marie” 和 “Marie visite Jane” 在它眼里一样。RNN 按顺序读词,顺序本身写在计算过程里;Transformer 把所有词同时处理,顺序信息必须写进输入。最直接的办法:给每个位置一个向量 ,加到这个位置的词嵌入上:
同一个词出现在不同位置,输入向量就不同了,自注意力的打分也跟着不同。
为什么不直接把位置编号 0, 1, 2, … 当成一个额外的特征?因为它没有上界:长句子里的位置编号会变得很大,和词嵌入的尺度完全不匹配;把它除以句子长度又会让”相邻两个位置的差”随句子长度变化。我们想要一个有界、对每个位置唯一、能表达相对距离的编码。
6.2 正弦 / 余弦位置编码
论文的选择是:
第 维和第 维是一对,共用频率 。代码 03 演示 1 列出了 时几对维度的波长(,单位是”位置”):
| 第几对 | 0 | 1 | 2 | 4 | 8 | 16 | 24 | 31 |
|---|---|---|---|---|---|---|---|---|
| 波长 | 6.3 | 8.4 | 11.2 | 19.9 | 62.8 | 628.3 | 6,283.2 | 47,117.2 |
可以把它想成一排转速不同的指针:第 0 对像秒针,每 6.3 个位置转一圈,能区分挨着的位置;最后一对每 47,117 个位置才转一圈,在几百个位置内几乎不动。所有指针的读数合起来,每个位置得到一个独一无二的”时间戳”。
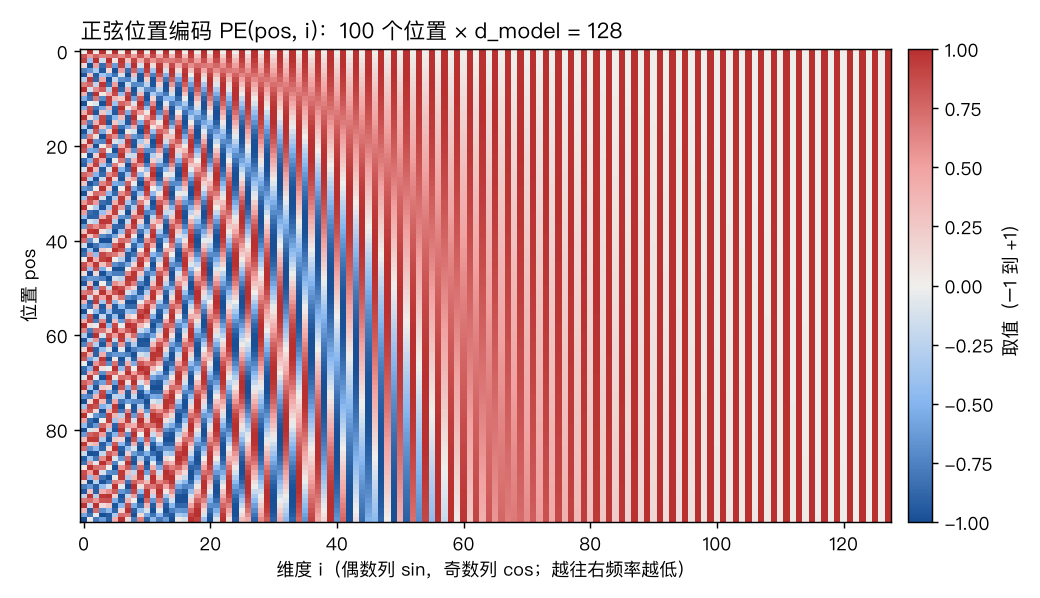
(这张图由 03_positional_encoding.py 生成:左边高频的列变化很快,右边低频的列几乎不变。没装 matplotlib 时脚本只打印字符版。)
两个性质:所有值都在 ;每个位置向量的长度都相同,(演示 1: 时 200 个位置全是 5.6569)——位置靠后不会让向量变大。
6.3 相对位置是一个线性变换
论文说选正弦函数,是因为”对任意固定的偏移 , 可以表示成 的线性函数”。这句话怎么来的?看一对维度 ,用和角公式:
右边是一个旋转,旋转角 只取决于位移 ,和 无关。把 个这样的 2×2 块放在对角线上,得到矩阵 ,使得对所有位置 。
代码 03 演示 2 验证:对 0..299 的每个位置, 时误差都不超过 2.8e−14;往前挪()也成立; 是正交矩阵,(误差 8.3e−16)。
演示 3 看位置编码之间的点积。因为 ,
被消掉了:点积只取决于距离 ,而且对 和 对称。 时:
| 距离 | 0 | 1 | 2 | 3 | 5 | 10 | 20 | 50 | 100 |
|---|---|---|---|---|---|---|---|---|---|
| 32.00 | 30.92 | 28.30 | 25.59 | 23.50 | 21.05 | 18.88 | 15.67 | 17.87 |
从 、37、150、280 起算,四行完全一样(差 2.1e−14)。点积随距离大致变小,但不是单调的( 比 还大; 里有 22 处”往回涨”),因为高频分量在来回振荡。
6.4 一个线性的 就能”看前一个词”
这些性质有什么用?代码 03 演示 4 构造了一个例子:输入只有位置编码(没有任何词的内容),取 、。于是第 个位置的 query 是 ,它和 key 的点积在 时最大(上表:距离 0 时点积最大)。结果:19 个有前驱的位置,argmax 全部落在前一个位置上;放在目标上的平均权重随 变”硬”:
| 3 | 10 | 20 | 30 | |
|---|---|---|---|---|
| 看前一个:目标位置上的平均权重 | 0.306 | 0.658 | 0.885 | 0.968 |
| 看前两个():同上 | 0.304 | 0.659 | 0.885 | 0.968 |
关键在于同一个 对所有位置都管用——“往回挪一位”对位置编码是同一个线性变换。这类”看前一个词”的头在训练好的语言模型里真的存在(比如 induction head 电路里的 previous-token head,Olsson et al. 2022)。对照:没有位置编码、20 个相同的词时,任何 得到的权重都是均匀的 0.050。
6.5 可学习的位置编码
另一种做法是不设计公式,直接把位置编码当参数学:一个 的矩阵,和词嵌入一样从数据里学。论文试过,两者在翻译任务上的结果几乎一样(表 3 第 E 行);BERT、GPT-2 用的是可学习的版本。它的缺点是只能表示训练时见过的最大长度;正弦编码可以写出任意位置,但”写得出”不等于模型能泛化到比训练时更长的序列。后来的工作提出了更多方案:直接在注意力打分里加入相对位置(Shaw et al. 2018)、把 §6.3 的旋转直接作用在 、 上的 RoPE(Su et al. 2021)、按距离给打分加线性惩罚的 ALiBi(Press et al. 2022)。今天的很多大语言模型用的是 RoPE。
6.6 实验:位置编码有多重要?加到嵌入上时尺度很重要
代码 03 演示 5 用序列反转任务(§9.1,)训练一个 1 层编码器 + 1 层解码器的小 Transformer,400 步,两个种子,推理时逐步生成:
| 设置 | 种子 0:逐词 / 整句 | 种子 1:逐词 / 整句 |
|---|---|---|
| 正弦位置编码(默认) | 0.999 / 0.994 | 1.000 / 1.000 |
| 可学习的位置编码 | 1.000 / 1.000 | 1.000 / 1.000 |
| 不用位置编码 | 0.202 / 0.000 | 0.202 / 0.000 |
| 正弦位置编码 + 嵌入乘 | 0.261 / 0.000 | 0.281 / 0.000 |
- 不用位置编码只比瞎猜(0.153)好一点:编码器置换等变,它的输出里没有”谁在第几个位置”的信息,解码器无从知道该输出哪个词。
- 可学习的位置编码在这个任务上和正弦编码一样好。
- 最后一行是我写原型时真的踩到的坑。 论文说”在嵌入层里把权重乘以 “。论文没写嵌入怎样初始化;乘 只有在嵌入本身尺度很小(每个分量约 )时,才让它和位置编码处在同一量级。PyTorch 的
nn.Embedding默认用 初始化:嵌入的平均长度 8.21,乘 8 以后 65.7,而位置编码的长度只有 5.66——位置信号被淹没在词的内容里,同样的 400 步几乎什么也没学会。教训:两个信号相加之前,先看看它们的尺度。 本讲的代码默认不乘这个系数(emb_scale = 1.0)。
7. 编码器层 · The encoder layer
7.1 结构
一个编码器层由两个子层(sublayer)组成,每个子层都包着残差连接和 LayerNorm:
        输入 X(n × d_model)
          │
          ├──────────────┐
          ↓              │ 残差
   多头自注意力           │
          ↓              │
        (+) ←────────────┘
          ↓
      LayerNorm                    X1 = LN(X + MultiHeadSelfAttention(X))
          │
          ├──────────────┐
          ↓              │ 残差
   前馈网络(逐位置)      │
          ↓              │
        (+) ←────────────┘
          ↓
      LayerNorm                    输出 = LN(X1 + FFN(X1))
          ↓
        输出(n × d_model)   → 送进下一层,共 N = 6 层
每个子层的输入、输出都是 ,所以层可以随便叠。残差连接就是第 13 讲 §3.4 的 :子层只需要学”在原来的表示上改一点”(§2.3 里 l’Afrique 被冲淡的”地点”信息就是这样加回来的),而且梯度有一条直通的路。
7.2 逐位置的前馈网络
它就是第 3–4 讲的两层全连接网络,对每个位置单独、用同一组参数做一遍。词与词之间的交流全靠注意力;前馈网络负责每个词”自己加工”。分工可以记成:注意力负责交流,前馈网络负责思考。
7.3 LayerNorm vs BatchNorm
第 9 讲 §2.7 预告过:Transformer 不用 BatchNorm,用 LayerNorm(Ba et al. 2016)。两者的公式几乎一样,,,区别只在沿哪一维求 和 :
| BatchNorm(第 9 讲) | LayerNorm | |
|---|---|---|
| 统计量 | 对同一个特征,在一批里所有样本(所有词)上求 | 对同一个词,在它自己的 个特征上求 |
| 依赖同一批里的其他样本? | 是 | 否 |
| 训练和测试时的行为 | 不同(running mean / var) | 完全相同 |
| 受 padding 影响? | 是(填充位置也参与统计) | 否 |
代码 04 演示 2 把同一个 4 个词的句子放进两个不同的 batch、在后面补不同内容的 padding,看它自己 4 个词的输出变了多少:
| 情况 | LayerNorm | BatchNorm |
|---|---|---|
| 放进两个不同的 batch | 0.0e+00 | 2.08 |
| 后面补 3 个不同的 padding | 0.0e+00 | 1.59 |
序列长短不一、要补 padding,batch 往往很小,推理时一次只生成一个词——BN 的统计量在这些情况下都不可靠,LN 则完全不受影响。numpy 的 layer_norm 和 nn.LayerNorm 差 4.4e−16。
7.4 numpy = PyTorch,以及参数都在哪
代码 04 演示 1 用 numpy 从零写的编码器层(attention_numpy.encoder_layer_forward)和 nn.TransformerEncoderLayer 拷入同样的参数,在 float64 下对照:Post-LN 差 1.1e−15,Pre-LN 差 8.9e−16。PyTorch 这个类做的就是 §7.1 图里那几行。
论文 base 模型(、、)每部分的参数:
| 部分 | 参数个数 |
|---|---|
| 一个多头注意力 | 1,050,624 |
| 一个前馈网络 | 2,099,712 |
| 一个编码器层(加上两个 LayerNorm) | 3,152,384 |
| 一个解码器层(多一个编码器-解码器注意力和一个 LayerNorm) | 4,204,032 |
| 6 个编码器层 + 6 个解码器层 | 44,138,496 |
| 共享的词嵌入(词表约 37,000 × 512) | 18,944,000 |
| 合计(估算) | 63,082,496 |
和论文表 3 写的 65M 接近(论文只说词表”约 37000”,所以这只是估算)。一个有意思的事实:前馈网络的参数是注意力的两倍——“思考”比”交流”占的参数多。
7.5 Post-LN vs Pre-LN,以及 warmup
§7.1 的写法(先加残差、再 LayerNorm)叫 Post-LN,是原论文、Coursera 作业和 PyTorch 默认(norm_first=False)的写法。GPT-2 以后的大多数大模型改成了 Pre-LN:把 LayerNorm 挪到子层的输入处,残差通路上不再有任何归一化:
(Pre-LN 在最后一层之后再加一个 LayerNorm。)Xiong et al. (2020) 证明,Post-LN 在初始化时靠近输出的那几层参数梯度很大,所以必须先用很小的学习率”热身”(warmup);Pre-LN 的梯度在各层之间更均匀,可以不用 warmup、用更大的学习率。
代码 04 演示 3 训练一个 6 层的小编码器做”原地反转”(第 个位置输出第 个输入,),Adam,不用 warmup,单种子,每格是该步数时的逐位置准确率(瞎猜 0.1):
| 设置 | lr | 第 50 步 | 第 100 步 | 第 200 步 | 第 300 步 |
|---|---|---|---|---|---|
| Post-LN | 1e−3 | 0.234 | 0.311 | 1.000 | 1.000 |
| Pre-LN | 1e−3 | 0.240 | 0.719 | 1.000 | 1.000 |
| Post-LN | 3e−3 | 0.098 | 0.179 | 0.999 | 1.000 |
| Pre-LN | 3e−3 | 0.280 | 0.953 | 0.999 | 0.999 |
| Post-LN | 1e−2 | 0.099 | 0.100 | 0.097 | 0.107 |
| Pre-LN | 1e−2 | 0.327 | 0.997 | 1.000 | 1.000 |
| Post-LN + 100 步 warmup | 1e−2 | 0.226 | 0.893 | 0.999 | 0.998 |
学习率 1e−2 时 Post-LN 一直停在瞎猜的水平,Pre-LN 第 100 步就到了 0.997;给 Post-LN 加上 100 步 warmup,同样的学习率也能训练。学习率小一些时两种最后都能学会,但 Pre-LN 起步快(第 100 步:lr 1e−3 时 0.719 vs 0.311)。这解释了原论文那个看起来很奇怪的学习率公式:
前 4000 步线性升高(warmup,第 8 讲 §8.3),之后按 衰减。论文还用了 Adam(、)、dropout 0.1 和 label smoothing 0.1。
8. 解码器与掩码 · The decoder and masking
8.1 Look-ahead mask:不许偷看答案
解码器要生成译文。训练时,我们手里有完整的目标句子,于是用 teacher forcing(训练时喂给解码器的是正确答案,而不是它自己的预测):把”右移一位”的目标句子(开头加 BOS)一次性喂给解码器,让第 个位置预测第 个词。可是自注意力能看到所有位置——第 个位置会直接看到它要预测的那个词,训练损失会很低,推理时(没有答案可看)就全错了。
解决办法是 look-ahead mask(也叫 causal mask,因果掩码):第 个位置只许看 。实现上,在 softmax 之前给”不许看”的打分加上一个很大的负数:
在浮点数里下溢成精确的 0,所以被遮住的权重严格等于 0。Coursera 作业(新版)的 create_look_ahead_mask 返回一个下三角为 1 的矩阵(1 = 可以看),scaled_dot_product_attention 里把 加到打分上——本讲的 numpy 版完全照这个约定。
代码 04 演示 4 从三个角度验证:注意力权重是下三角的;把第 3..5 个位置的输入换成完全不同的向量,第 0..2 个位置的输出一个比特都不变(差 0.0e+00;没有掩码时差 2.74);用 PyTorch 的 autograd 算整个解码器层的雅可比矩阵 , 的部分严格为 0(没有掩码时最小也有 0.147)。
8.2 编码器-解码器注意力:Q 来自解码器,K / V 来自编码器
解码器层有三个子层(每个都带残差 + LayerNorm):
- 带 look-ahead mask 的多头自注意力:目标句子内部的交流,只看已经生成的部分;
- 编码器-解码器注意力(cross-attention):Q 来自解码器(“我现在要生成什么?”),K、V 来自编码器的输出(“源句子里的每个词是什么”)——这就是第 16 讲的”回头看源句子”,只是换成了多头的缩放点积;
- 前馈网络。
编码器跑一次,得到源句子的表示(memory);解码器的每一层都用它做 K、V。代码 04 演示 5 把 numpy 的解码器层和 nn.TransformerDecoderLayer 对照:Post-LN 差 1.3e−15,Pre-LN 差 1.2e−15。
8.3 Padding mask
一个 batch 里的句子长短不一,短的要在后面补填充符号(通常编号 0)凑成同样长度。注意力不应该看这些位置,于是再加一个 padding mask:标出哪些 key 是真实的词。Coursera 作业的 create_padding_mask 返回形状 (batch, 1, n) 的 0/1 数组,中间那个长度为 1 的维度让它广播到每一个 query。解码器的自注意力要同时用两种掩码(逐元素取”与”);编码器-解码器注意力用源句子的 padding mask。
代码 04 演示 6:第一句只有 3 个词、补了 3 个填充。每一行(包括填充位置自己那几行)在填充的 key 上的权重严格为 0;补 padding 再加 mask,和”单独处理这个 3 个词的句子”完全一样(差 8.9e−16);换掉填充位置的向量,真实词的输出不变(差 0)。没有 mask 时,换填充会让真实词的输出变 1.73,和单独处理差 1.46。padding mask 只遮 key(列),填充位置自己那几行照样算出一些没有意义的数,计算损失时把它们忽略掉即可。编码器层里只有注意力会让位置之间”串门”(前馈、LayerNorm、残差都是逐位置的),所以只有它需要 mask。
8.4 训练并行,推理逐步
有了 look-ahead mask,第 个位置的输出只依赖前 个输入。代码 04 演示 5 用一个 2 层解码器、长度 8 的目标序列验证:一次并行算完全部 8 个位置(训练时的 teacher forcing),和用前缀 1..8 一步一步算(推理时的方式),结果的最大差 1.0e−15——完全相同。
于是:
- 训练时:目标句子已知,一次前向传播并行算出所有位置的预测和损失。这是 Transformer 比 RNN 训练快的主要原因——RNN 的解码器即使用 teacher forcing,也得一步一步算。
- 推理时:下一步的输入是模型自己上一步的输出,事先不知道,只能自回归(autoregressive)地一步一步来:从 BOS 开始,每步取概率最大的词(或用第 16 讲的 beam search),接到前缀后面,直到生成 EOS。不缓存时总计算量是 (演示 5:36 而不是 8);实际系统会把每层前面位置的 K、V 存下来(KV cache),每步只算新位置那一行。
还有一个训练和推理之间的落差:训练时解码器总是看到正确的前缀,推理时看到的是自己生成的前缀,前面错一个,后面的输入就和训练时不一样了。这叫 exposure bias。代码 05 的评估一律用推理时的逐步生成,不是 teacher forcing 下的准确率。
8.5 完整的 Transformer
   源句子 token                                 目标句子 token(右移一位,开头是 BOS)
        ↓                                                 ↓
   词嵌入 + 位置编码                                 词嵌入 + 位置编码
        ↓                                                 ↓
 ┌─────────────────────┐                         ┌──────────────────────────────┐
 │ 多头自注意力         │                         │ 带 look-ahead mask 的        │
 │ + 残差 + LayerNorm   │                         │ 多头自注意力 + 残差 + LN      │
 │ 前馈网络             │      memory(K、V)      │ 编码器-解码器注意力           │
 │ + 残差 + LayerNorm   │ ─────────────────────→ │ (Q 来自这里)+ 残差 + LN     │
 └─────────────────────┘                         │ 前馈网络 + 残差 + LN          │
        × N                                      └──────────────────────────────┘
                                                          × N
                                                          ↓
                                                 线性层 → softmax → 下一个词的概率
最后的线性层把 维映射到词表大小,softmax 得到下一个词的概率,损失是第 9 讲 §3.5 的多分类交叉熵。论文让源、目标的词嵌入和这个输出线性层共用同一个矩阵(weight tying),省下不少参数。Coursera 作业最后把这些积木拼成 Transformer 类,做的正是这件事。
9. 实验:一个小 Transformer vs RNN · Experiment: Transformer vs GRU seq2seq
9.1 任务与设置
任务:序列反转。 输入 个随机符号(10 种),输出它的倒序。它看起来简单,却是”长程依赖”的极端:输出的第一个词是输入的最后一个,输出的最后一个词是输入的第一个——模型必须记住整个序列,并且能按位置取回任何一个。数据每一步现场生成,测试用 500 条新序列。
三个模型,训练设置完全相同(Adam lr 1e−3、前 50 步 warmup、batch 64、500 步、teacher forcing;推理时逐步生成):
| 模型 | 结构 | 参数个数 |
|---|---|---|
| Transformer | 1 层编码器 + 1 层解码器,,4 个头,,正弦位置编码,Post-LN | 86,221 |
| GRU | GRU 编码器-解码器,隐藏 128,不带注意力 | 126,925 |
| GRU + 注意力 | 同上,加上第 16 讲的注意力(这里用 Luong et al. 2015 的写法:用解码器状态当 query) | 176,205 |
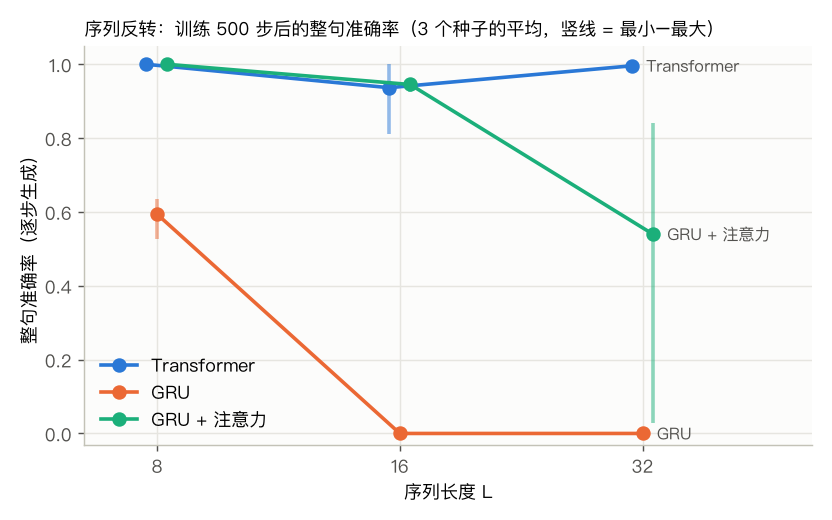
Transformer 的参数最少。每个设置跑 3 个种子, 取 8、16、32。这个实验比较的是”同样的训练预算下谁学得快、学得稳”,不是”谁最终能学会”。
9.2 结果
代码 05 演示 1(每格是 3 个种子的平均,括号里是最小–最大):
| 模型 | 逐词准确率 | 整句准确率 | |
|---|---|---|---|
| 8 | Transformer | 1.000 (1.000–1.000) | 1.000 (1.000–1.000) |
| 8 | GRU | 0.875 (0.853–0.896) | 0.594 (0.526–0.636) |
| 8 | GRU + 注意力 | 1.000 (1.000–1.000) | 1.000 (1.000–1.000) |
| 16 | Transformer | 0.993 (0.979–1.000) | 0.937 (0.810–1.000) |
| 16 | GRU | 0.398 (0.387–0.405) | 0.000 (0.000–0.000) |
| 16 | GRU + 注意力 | 0.980 (0.969–0.987) | 0.945 (0.924–0.956) |
| 32 | Transformer | 1.000 (1.000–1.000) | 0.996 (0.994–0.998) |
| 32 | GRU | 0.218 (0.212–0.222) | 0.000 (0.000–0.000) |
| 32 | GRU + 注意力 | 0.732 (0.392–0.922) | 0.540 (0.028–0.840) |
三点读法:
- 不带注意力的 GRU 对长度最敏感:整句准确率 时 0.594, 和 32 时都是 0。整个序列只能通过一个 128 维的隐藏状态交给解码器——第 16 讲引入注意力的动机,在这里一目了然。
- 和 16 时,GRU + 注意力和 Transformer 不相上下。 我原以为 Transformer 会在每个长度上都明显领先,实际上 时 GRU + 注意力的整句准确率(0.945)甚至略高于 Transformer(0.937),Transformer 有一个种子只有 0.810——种子之间的波动和两个模型之间的差距一样大。注意力本身就解决了大部分问题。
- 时差距拉开:Transformer 0.996,GRU + 注意力 0.540,而且后者三个种子的逐词准确率从 0.392 到 0.922,很不稳定。它不是”学不会”,而是在 500 步里还没稳定地学好(训练更久、用双向编码器都可能改善)。
9.3 错误出现在哪里
代码 05 演示 2 看 时每个输出位置的准确率(3 个种子平均)。输出位置 要复制的是输入的第 个词, 越大,这个词离解码器越远:
| 输出位置 | 1 | 2 | 4 | 8 | 12 | 16 | 20 | 24 | 28 | 32 |
|---|---|---|---|---|---|---|---|---|---|---|
| Transformer | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 |
| GRU | 0.88 | 0.53 | 0.27 | 0.16 | 0.15 | 0.14 | 0.14 | 0.15 | 0.14 | 0.09 |
| GRU + 注意力 | 0.99 | 0.99 | 0.95 | 0.78 | 0.69 | 0.66 | 0.64 | 0.65 | 0.67 | 0.66 |
不带注意力的 GRU 只能可靠地复制最后读到的一两个词(0.88、0.53),到 就接近瞎猜——这就是第 15 讲的长程依赖问题在这个任务上的样子,和 §1.2 里梯度随距离衰减的那张表是同一件事。GRU + 注意力前几个位置几乎全对,往后降到 0.64–0.78,这是好种子和差种子的平均。Transformer 每个位置都是 1.00:位置编码直接告诉它”我在输出第几个”和”源序列里谁在第几个”。
9.4 注意力学到了什么
代码 05 演示 3 打开 、种子 0 的 Transformer 看注意力权重(200 个测试样本)。反转任务里,输出第 步应该去取源序列第 个词,我们叫它”镜像位置”。
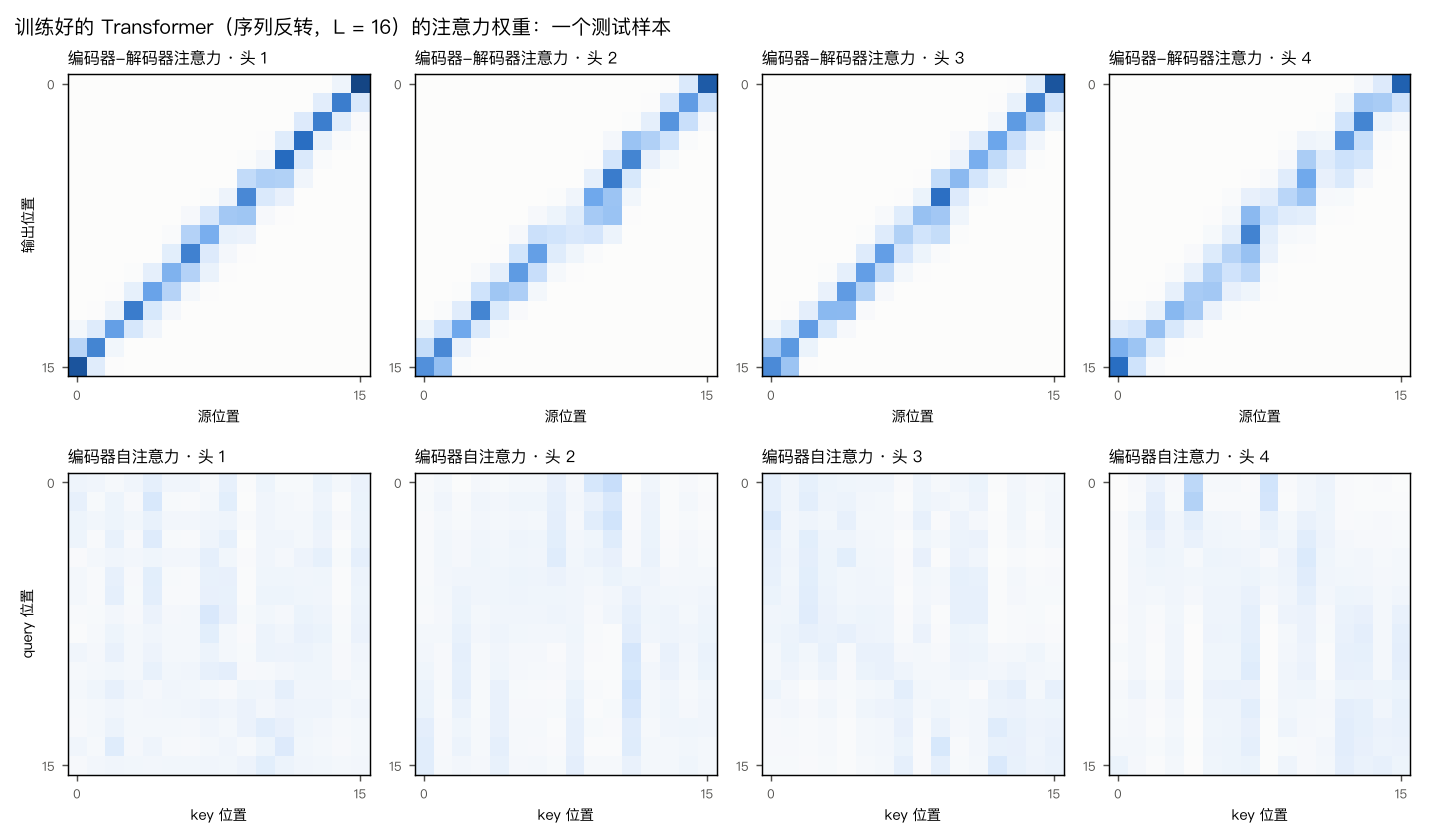
| 编码器-解码器注意力 | 头 1 | 头 2 | 头 3 | 头 4 |
|---|---|---|---|---|
| 镜像位置上的平均权重 | 0.549 | 0.514 | 0.517 | 0.438 |
| argmax 恰好在镜像位置的比例 | 0.87 | 0.81 | 0.81 | 0.70 |
| argmax 在镜像位置或它的左右邻居 | 1.00 | 0.98 | 1.00 | 0.98 |
几个观察,有的和我预想的不一样:
- 4 个头都学到了同一条反对角线——这正是反转任务需要的”对齐”,和第 16 讲可视化的注意力对齐是同一类东西。但 4 个头做的几乎是同一件事:多头并不保证每个头”各问一个问题”(§5.1 的理想图景),这里它们是冗余的。每个头也不是完全”硬”的,镜像位置拿到约一半的权重,其余大多分给左右邻居。
- 解码器自注意力里,头 4 把 0.900 的权重放在开头的 BOS 上(平均熵只有 0.26)。一个”没事可做”的头常常这样把注意力停在一个固定的位置,相当于什么都不读;Clark et al. (2019) 在 BERT 里也看到很多头停在 [SEP] 上。
- 编码器自注意力几乎是均匀的(平均熵 2.49–2.62,均匀分布是 2.77):这个任务里编码器只需要把”词 + 位置”原样交给解码器,它的自注意力基本没被用上。可解释的模式出现在任务真正需要它的地方。
- 对照:GRU + 注意力的注意力更”尖”(平均熵 0.11),但 93% 的时候它看的是镜像位置的下一个编码器状态,而不是镜像位置本身。单向 GRU 的第 个状态刚读过 、也还记着 ,所以从那里也能取出要复制的词。这提醒我们:注意力权重告诉我们”看了哪里”,不直接告诉我们”取了什么”——把注意力图当解释要很小心(第 21 讲)。
9.5 训练速度
演示 1 顺便记下了每一步训练的耗时,演示 4 把 一直加到 128(batch 64,CPU 单线程;计时每次运行都不同)。在我的一次运行里,三个模型在 时每步都是几到二十几毫秒、同一个量级; 时 Transformer 反而最慢。这不奇怪:CPU 单线程上没有”并行”可言,Transformer 的 打分又随 增长,而 nn.GRU 有优化过的 C++ 循环。Transformer 的速度优势要在 GPU 上才显现:一层里所有位置的矩阵乘法可以同时铺满几千个核,而 RNN 的第 步必须等第 步。论文报告 base 模型在 8 块 P100 上训练 12 小时,英德翻译就超过了此前所有发表过的模型(包括集成模型)。
9.6 诚实的说明
- 序列反转对 Transformer 很”友好”:它几乎只需要”按位置取词”,位置编码 + 一层编码器-解码器注意力就够了。换成需要更多内容推理的任务,差别会不一样。
- 只训练了 500 步、每个设置 3 个种子;GRU 用的是单向编码器。这些设定是在原型(两个种子、600 步)看过大致趋势之后、正式运行之前定下的(训练步数是为了让整个脚本在 2 分钟内跑完),正式运行以后没有再改,也没有为了让某个模型赢而单独调过任何一个模型。
- 原型阶段我犯过一个错:把嵌入乘了 (§6.6)。那时 Transformer 在 上训练了 1500 步整句仍然几乎全错,而 GRU + 注意力早就学会了,我差点得出”RNN + 注意力完胜”的结论。代码 03 演示 5 的最后一行复现了这个错误(400 步时逐词 0.261 / 0.281)。修正以后才是上面的结果。这个经历本身就是一个调试教训:一个新模型输给老模型时,先查实现,再下结论(第 11 讲 §5.2 的调试清单)。
10. Transformer 的影响 · Why Transformers took over
10.1 三类 Transformer
原论文的 Transformer 是编码器-解码器结构,用来做翻译。之后的发展把它拆成了三类:
| 类型 | 用哪一半 | 注意力的掩码 | 预训练任务 | 代表 | 擅长 |
|---|---|---|---|---|---|
| encoder-only | 只用编码器 | 双向(每个词看全句) | 遮住一些词,让模型猜(masked language modeling) | BERT(Devlin et al. 2019) | 理解:分类、命名实体识别、抽取式问答 |
| decoder-only | 只用解码器(去掉 cross-attention) | look-ahead(只看前面) | 预测下一个词 | GPT(Radford et al. 2018、2019)及之后的大语言模型 | 生成:续写、对话、代码 |
| encoder-decoder | 两个都用 | 编码器双向、解码器 look-ahead | 把各种任务都写成”文本到文本” | 原始 Transformer、T5(Raffel et al. 2020) | 翻译、摘要等”输入一段、输出一段”的任务 |
Coursera C5M4 的两个可选实验(命名实体识别、问答)用的就是第一类:拿一个预训练好的 encoder-only 模型(据我所知是 Hugging Face 的 DistilBERT,细节可能和作业版本有出入),在小数据集上微调。
10.2 预训练:先在海量文本上学,再适配具体任务
BERT 和 GPT 带来的最大变化不是结构,而是用法:先在海量的无标注文本上做自监督预训练(第 1 讲 §3.6:标签来自文本本身——下一个词,或者被遮住的词),再用少量有标注的数据微调(fine-tune)到具体任务上。这和第 13 讲的迁移学习是同一个思路,只是规模大得多:预训练的数据从 ImageNet 的一百多万张图变成了几十亿到几万亿个词。GPT 系列进一步发现,模型足够大时,很多任务连微调都不需要,只要在输入里写清楚要做什么(prompting)。怎样用好这些预训练的大模型——prompting、检索增强(RAG)、agents、微调——是第 20 讲的主题。
为什么是 Transformer 撑起了这一切?§1–§8 已经给出了答案:训练时完全并行,能把海量数据和 GPU 算力真正用起来;任何两个位置之间路径长度 ,长程依赖不再困难;结构简单统一(就是注意力 + 前馈 + 残差 + LayerNorm 一层层叠),容易做大。第 1 讲 §4.6 的 scaling laws 就是在 Transformer 语言模型上测出来的。
10.3 几乎所有模态的通用架构
Transformer 的输入只是”一串向量”。只要能把数据切成一串 token,就能用它:
- 图像:ViT(Dosovitskiy et al. 2021,“An Image is Worth 16x16 Words”)把图像切成 16×16 的小块,每块拉平、线性投影成一个 token,加上可学习的位置编码,直接送进标准的 Transformer 编码器。
- 语音、视频、蛋白质序列、表格、强化学习的轨迹……都有对应的 Transformer 版本;多模态大模型把文字、图像、音频的 token 放进同一个序列里。
但”通用”有代价。§3.2 说过,自注意力的归纳偏置比卷积弱得多(第 12 讲 §9.6、第 1 讲 §3.3)。ViT 的论文自己就报告了:只在 ImageNet(约 130 万张图)这样中等规模的数据上训练时,ViT 比同样大小的 ResNet 低几个百分点;要在 ImageNet-21k(约 1400 万张)或 JFT-300M(约 3 亿张)这样大得多的数据上预训练,它才追上或超过最好的 CNN。数据少时,先验值钱;数据多时,通用的结构 + 规模胜出——这正是第 1 讲”规模”那张图和 Sutton 的 The Bitter Lesson 讲的事。
10.4 平方代价与之后的发展
§3.4 的 在长上下文里成了真正的瓶颈。几条主要的应对路线(这里只列名字,不展开):FlashAttention(Dao et al. 2022,计算不变,靠分块和不存完整的 矩阵大幅省内存、提速度);稀疏 / 局部注意力(只对一部分位置打分);线性注意力和状态空间模型(把计算降到 ,有的又重新引入了某种”循环”)。另外,推理时的 KV cache(§8.4)的内存随上下文长度线性增长,也是长上下文系统要精打细算的地方。
11. 小结 · Summary
- RNN 的两个瓶颈:顺序计算无法并行;信息和梯度要走 步。代码 01:随机 RNN 的敏感度从距离 1 的 2.3 掉到距离 32 的 5.3e−07,自注意力和距离无关。Transformer 去掉循环、只留注意力,代价是计算量随 平方增长( vs ,比值 )。
- 自注意力 = 每个词用 query(问题)去和每个词的 key(标签)打分,softmax 后对 value(内容)加权平均:, 等。Jane 的例子里 l’Afrique 把 0.614 的权重给了 visite。所有词一次矩阵运算算完。
- 自注意力置换等变:不加位置编码时 “Jane visite Marie” 和 “Marie visite Jane” 里 visite 的输出完全相同(差 2.8e−16)。
- 除以 :随机点积的方差 = (和第 7 讲的方差保持同一个推导);不缩放时 的 softmax 有 76% 的行几乎 one-hot,梯度 从 0.305 掉到 0.0543;查字典任务上不缩放慢好几倍、可用学习率变窄。
- 多头:每个头在自己的子空间里问一个问题,拼接后乘 ;参数个数和头数无关(1,050,624)。实际训练出的头可能是冗余的(代码 05:4 个头学到同一条反对角线)。PyTorch
nn.MultiheadAttention的布尔掩码 True = 忽略,和 Coursera / 本讲相反。 - 位置编码:正弦 / 余弦,不同频率;(分块旋转,误差 ~1e−14),点积只取决于距离;一个线性的 就能”看前一个词”。可学习的位置编码效果相近。不用位置编码时反转任务只有 0.202;嵌入尺度太大会淹没位置编码。
- 编码器层:多头自注意力 + 残差 + LN,前馈 + 残差 + LN;numpy 与
nn.TransformerEncoderLayer差 1e−15。LayerNorm 按词归一化,不受 batch 和 padding 影响(BN 会变 2.08 / 1.59)。Pre-LN 比 Post-LN 好训练(lr 1e−2 时 Post-LN 停在 0.107,加 warmup 才能训练)。前馈网络的参数是注意力的两倍;base 模型约 63M 参数。 - 解码器:look-ahead mask 让第 个位置看不到未来(改变未来的输入,输出差 0;雅可比严格为 0);编码器-解码器注意力 Q 来自解码器、K / V 来自编码器;padding mask 让补了填充的句子和单独处理完全一样。训练时 teacher forcing 并行,推理时自回归逐步生成,两者在因果掩码下给出相同结果。
- 实验(序列反转,500 步,3 个种子):不带注意力的 GRU 在 时整句全错;GRU + 注意力在 时和 Transformer 不相上下, 时 0.540 且不稳定;Transformer 0.996,参数最少。
- 影响:encoder-only(BERT)、decoder-only(GPT)、encoder-decoder(T5);先预训练、再微调或提示;ViT 把图像切成 token——在足够多的数据上,通用的 Transformer 几乎统一了所有模态。
12. 常见误区 · Common pitfalls
- “Transformer 里每个词只看自己附近的词。” 不对。自注意力一层就是全局的,每个词和每个词打分;“看附近”是训练学出来的(§6.4),不是结构规定的。和卷积的局部性正好相反(§3.3)。
- “自注意力天然知道词序。” 不知道。没有位置编码时它对置换等变(§3.2),反转任务只能到 0.202(§6.6)。
- ” 只是一个无关紧要的常数。” 大时它决定了 softmax 会不会一开始就饱和(§4.3);去掉它,训练会慢好几倍、对学习率更挑剔(§4.4)。
- “多头 = 更多参数 = 更强。” 参数个数和头数无关(§5.2);头太多、每个头太窄反而变差;训练出的头也可能是冗余的(§9.4)。
- “注意力权重就是模型的解释。” 权重告诉你”看了哪里”,不告诉你”取了什么、怎么用”。GRU + 注意力 93% 的时候看的是镜像位置的下一个状态,却照样答对(§9.4);有的头只是把注意力停在 BOS 上”什么都不读”。
- “Transformer 用 BatchNorm。” 用的是 LayerNorm,按词归一化,不依赖 batch,训练和测试行为相同(§7.3)。
- “掩码的 True 就是’保留’。” 看框架:Coursera / 本讲 1 = 可以看;
nn.MultiheadAttention的布尔掩码 True = 忽略;F.scaled_dot_product_attention的布尔掩码 True = 可以看;nn.Transformer的tgt_mask常用上三角为 的浮点掩码(§5.4、§8.1)。传反了不报错,只会悄悄学坏。 - “训练时解码器也要一步一步生成。” 训练时有完整的目标句子,加上 look-ahead mask 就能一次并行算完;只有推理时才必须逐步生成(§8.4)。
- “Transformer 一定比 RNN 快、一定比 RNN 准。” 在 CPU 单线程上未必更快(§9.5);短序列、小预算时 RNN + 注意力可以一样好(§9.2);数据少时 CNN / RNN 的归纳偏置可能更值钱(§10.3)。
- “论文说嵌入要乘 ,照抄就行。” 要看嵌入是怎么初始化的;用
nn.Embedding的默认初始化再乘 ,位置编码会被淹没(§6.6)。
13. 练习 · Exercises
练习 1(手算注意力)。三个词,:
(a) 算出 。(b) 算出 softmax 后的权重矩阵(保留 4 位小数)。(c) 算出输出。(d) 第 3 个词的权重有什么特点?为什么?
参考答案
(a) 。。
(b) 第 1 行:;第 2 行:;第 3 行:。
(c) 第 1 行:;第 2 行:;第 3 行:。可以用 attention_numpy.scaled_dot_product_attention(Q, K, V) 验证。
(d) 第 3 个词的 query 和三个 key 都正交,打分全是 0,softmax 得到均匀分布,输出是三个 value 的平均。“问题和谁都不匹配”时,注意力退化成平均——这也是随机初始化时注意力几乎均匀的原因(代码 01 演示 4)。
练习 2(推导:方差与缩放)。(a) 证明:若 的分量独立、均值 0、方差 ,则 。(b) 这时要让打分的方差为 1,应该除以多少?(c) 为什么实践中直接除以 就够了?
参考答案
(a) 。每一项 ,。 项独立,方差相加:。
(b) 除以 。
(c) 由 、 的初始化(以及 LayerNorm 后输入的尺度)决定。按第 7 讲的方差保持初始化, 的分量方差约 1、 的方差约 ,于是 、 的分量方差约 1(代码 02 演示 3 正是这样初始化的)。 负责和维度有关的那部分,剩下的常数尺度由训练调整。
练习 3(数参数)。论文的 big 模型:、、。(a) 一个编码器层有多少参数?(b) 一个解码器层呢?(c) 头数从 8 改成 16,参数变吗?
参考答案
(a) 多头注意力 ;前馈 ;两个 LayerNorm 。合计 12,596,224。
(b) 再加一个多头注意力和一个 LayerNorm: 16,796,672。可以用 attention_numpy.count_encoder_layer_params(1024, 4096) 和 count_decoder_layer_params 验证。
(c) 不变。头数只决定怎样切分 (§5.2)。
练习 4(掩码)。一个 batch 里有一句目标句子,token 编号是 [1, 7, 3, 0](1 = BOS,0 = 填充)。(a) 写出 4×4 的 look-ahead mask 和 padding mask(1 = 可以看)。(b) 解码器自注意力实际用的掩码是什么?(c) 第 3 行(填充位置自己)的权重会是什么?要不要担心?
参考答案
(a) look-ahead:下三角全 1,即第 行前 个是 1。padding:[1, 1, 1, 0],广播到每一行。
(b) 两者逐元素相乘:第 0 行 [1,0,0,0],第 1 行 [1,1,0,0],第 2 行 [1,1,1,0],第 3 行 [1,1,1,0]。
(c) 第 3 行(填充位置)照样能看前三个真实的词,会算出一个没有意义的输出。不用担心:计算损失时把填充位置的预测忽略掉(比如 nn.CrossEntropyLoss(ignore_index=0)),它就不影响训练。如果某一行被全部遮住,用 时 softmax 会退化成均匀分布,用 时会得到 nan——这是有些实现选 的原因之一。
练习 5(证明置换等变)。设 是一个 的置换矩阵(每行每列恰有一个 1),。证明:(不加位置编码)。提示:对矩阵逐行做 softmax,满足 。
参考答案
输入换成 后,,同理 、。打分 :行和列被同一个置换打乱。逐行 softmax 只对每一行内部归一化,打乱行的顺序不影响每行的结果,打乱列的顺序只是把每行的元素换了位置,所以 。于是输出 。代码 01 演示 3 数值验证了这一点(差 2.2e−16)。
练习 6(位置编码的点积)。(a) 证明 。(b) 时它等于多少?(c) 这个点积能区分” 个位置之前”和” 个位置之后”吗?模型要区分前后,靠的是什么?
参考答案
(a) 第 对维度贡献 (余弦的差角公式), 对加起来。
(b) (代码 03 演示 3: 时 32.00)。
(c) 不能: 是偶函数, 和 的点积相同。但注意力打分不是 之间的直接点积,而是先乘 、:。中间的矩阵不必对称,比如 §6.4 的 ,就能让第 个位置只看前一个、不看后一个。
练习 7(计算量)。一个长上下文模型: 个 token,,。只看一层、只算主项乘加次数:(a) 和”权重乘 “一共多少?(b) 四个投影矩阵和前馈网络一共多少?(c) 多大时两者相等?(d) 如果把一个头的 权重矩阵完整存成 16 位浮点数,要多少内存?
参考答案
(a) 。
(b) 投影 ,前馈 ,合计 。注意力部分是它的约 4 倍。
(c) 。比这短时,大头是投影和前馈(和 成正比);比这长时,平方项占上风。
(d) 字节 字节 = 20 GB,而且每个头、每一层各一个。这就是 FlashAttention 这类方法”不存完整的 矩阵”的意义。
练习 8(改代码,先预测再运行)。在 05_transformer_vs_rnn.py 里把 STEPS 从 500 改成 1500,只跑 (把 LENGTHS 改成 [32])。先预测:三个模型的整句准确率各会怎样变化?GRU + 注意力的种子间波动呢?然后运行验证(约 2–3 分钟)。
参考答案
预期趋势(具体数字以你运行的结果为准):Transformer 已经接近 1,不会有太大变化;不带注意力的 GRU 逐词准确率会上升一些,但整个序列压进一个 128 维的状态,整句准确率大概仍然很低;GRU + 注意力最可能明显变好,种子之间的差距缩小——§9.2 说它”不是学不会,而是还没学稳”,这个练习就是在检验这句话。如果结果和预测不一样,想想是训练步数、学习率还是模型结构(单向编码器)在限制它。
练习 9(改代码,先预测再运行)。在 tiny_transformer.py 的 MultiHeadAttention 里把默认的 scale=True 改成 False,然后运行 03_positional_encoding.py(看演示 5 的第一行)。先预测:、4 个头时,去掉缩放影响大吗?为什么?运行完记得改回来。
参考答案
这里每个头的 ,不缩放时打分的标准差只放大 4 倍。代码 02 演示 2 显示 时 softmax 还远没有饱和(最大权重 0.684、 0.2805,和缩放后的 0.3030 差不多),演示 3 里 、Adam lr 1e−3 不缩放也能达到 90%(425 步 vs 175 步)。所以预期影响不大,可能只是学得稍慢一些(具体数字以你运行的结果为准)。如果把 d_model 改成 256、头数改成 1(),影响应该明显得多。这个练习说明: 的重要性随 增长,论文的 正处在”开始要紧”的区间。
练习 10(三类 Transformer)。下面每个任务,你会选 encoder-only、decoder-only 还是 encoder-decoder?注意力用什么掩码?(a) 判断一条评论是正面还是负面;(b) 写一个聊天机器人;(c) 把英文新闻翻译成中文;(d) 从一份简历里标出人名、公司名、日期。
参考答案
(a) encoder-only(如 BERT),双向注意力,取一个汇总的表示接分类头。(b) decoder-only(GPT 类),look-ahead mask,自回归生成。(c) 经典选择是 encoder-decoder:编码器双向读英文,解码器 look-ahead 生成中文,中间用编码器-解码器注意力;今天用一个足够大的 decoder-only 模型、把原文放在提示里也能做得很好。(d) encoder-only,每个 token 一个标签(命名实体识别,Coursera 的可选实验之一)。实际中,大型 decoder-only 模型配合提示几乎能做所有这些任务(第 20 讲),但在数据和算力有限时,针对任务选结构仍然有意义。
14. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C5M4 “Transformer Network”(Andrew Ng):Transformer Network Intuition、Self-Attention、Multi-Head Attention、Transformer Network 四个视频和编程作业。
- Rush (2018). The Annotated Transformer. Harvard NLP ——把论文逐段配上可运行的 PyTorch 代码,非常适合在本讲之后读。
- Alammar (2018). The Illustrated Transformer.(博客)——大量图示,适合复习结构。
原始论文
- Vaswani et al. (2017). Attention is all you need. NeurIPS. ——本讲的主线,§3.2 的缩放、§3.5 的位置编码、表 1 的复杂度比较、表 3 的消融实验都值得读原文。
- Bahdanau, Cho & Bengio (2015). Neural machine translation by jointly learning to align and translate. ICLR. ——第 16 讲的注意力。
- Luong, Pham & Manning (2015). Effective approaches to attention-based neural machine translation. EMNLP. ——代码 05 的 GRU + 注意力用的写法。
- Ba, Kiros & Hinton (2016). Layer normalization. arXiv.
- He, Zhang, Ren & Sun (2016). Deep residual learning for image recognition. CVPR. ——残差连接(第 13 讲)。
- Xiong et al. (2020). On layer normalization in the Transformer architecture. ICML. ——Post-LN vs Pre-LN。
Transformer 之后
- Devlin et al. (2019). BERT: Pre-training of deep bidirectional Transformers for language understanding. NAACL.
- Radford et al. (2018). Improving language understanding by generative pre-training.(GPT);Radford et al. (2019). Language models are unsupervised multitask learners.(GPT-2,改用 Pre-LN)
- Raffel et al. (2020). Exploring the limits of transfer learning with a unified text-to-text Transformer. JMLR. ——T5。
- Dosovitskiy et al. (2021). An image is worth 16x16 words: Transformers for image recognition at scale. ICLR. ——ViT。
- Su et al. (2021). RoFormer: Enhanced Transformer with rotary position embedding. ——RoPE;Press, Smith & Lewis (2022). Train short, test long: Attention with linear biases enables input length extrapolation. ICLR. ——ALiBi。
- Dao et al. (2022). FlashAttention: Fast and memory-efficient exact attention with IO-awareness. NeurIPS.
看懂注意力在做什么
- Clark, Khandelwal, Levy & Manning (2019). What does BERT look at? An analysis of BERT’s attention. BlackboxNLP. ——很多头停在 [SEP] 上(§9.4)。
- Olsson et al. (2022). In-context learning and induction heads.(Anthropic)——previous-token head 与 induction head(§6.4)。
15. 下一讲预告 · Next lecture
序列模型部分到这里结束:第 15 讲的 RNN 按顺序处理序列,第 16 讲给它加上了”回头看”的注意力,这一讲把循环拿掉、只留注意力,得到了今天几乎所有大模型的骨架。
第 18 讲:对抗鲁棒性与生成模型——对抗样本、GAN 与扩散模型,进入课程的前沿专题部分(对应 Fall 2025 Lecture 4)。你会看到:
- 为什么一张图片加上人眼看不出的扰动,就能让分类器以很高的置信度认错(高维空间里线性的累积),以及 FGSM / PGD 攻击和对抗训练;
- GAN:生成器和判别器的 minimax 博弈,为什么难训练、什么是 mode collapse;
- 扩散模型:一步步加噪声、再学会一步步去噪声,为什么它比 GAN 更稳定——它的去噪网络在大模型里常常正是一个 Transformer。
第 5 讲”优化输入而不是参数”的那个反转,会在对抗样本里再次出现。