对应 Maps to:Stanford CS230 Fall 2025 Lecture 5(10/21,Deep Reinforcement Learning);Autumn 2018 Lecture 9 “Deep Reinforcement Learning”(Kian Katanforoosh,YouTube 公开录像;后半段有一位客座的博士生讲 AlphaGo、策略梯度等)。Coursera 的 Deep Learning Specialization 没有强化学习的模块,本讲是课堂讲座专属的内容。 依据说明:两次课堂讲座都没有公开的 slides 或讲稿。本讲的结构依据 2018 年录像的内容概要(为什么需要强化学习 → 一维”回收机器人”的 Q-table 与 Bellman 方程 → DQN 玩 Breakout → 探索与 Montezuma’s Revenge → AlphaGo、策略梯度等),录像里的具体例子和数字我只在 §2.1 转述了一处,细节可能和录像有出入;本讲的走廊例子是我自己设定的简化版本。技术内容以原始论文和 Sutton & Barto 的教材为准(Watkins 1989;Williams 1992;Mnih et al. 2013、2015;Silver et al. 2016、2017;Schulman et al. 2017;Christiano et al. 2017;Ouyang et al. 2022;Rafailov et al. 2023;Gao, Schulman & Hilton 2023,见 §13)。 配套代码 Code:
code/lecture19/(3 个脚本:numpy 的表格 Q-learning;PyTorch 的 DQN 玩一个”迷你 Breakout”;numpy 的 REINFORCE 与玩具 RLHF。最慢的02_dqn.py约 36 秒,其余几秒) 预计阅读时间:3–3.5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说清楚强化学习(reinforcement learning, RL)和监督学习的区别:没有标签、只有延迟的奖励;数据由策略自己收集、不是 i.i.d.;因此有信用分配和探索两个监督学习里没有的问题。
- 写出回报、Q 函数和 Bellman 最优方程,在一个小例子上手算 Q-table;解释值迭代为什么让”奖励的消息”一轮往回传一步,以及折扣因子 γ 为什么是任务定义的一部分。
- 写出 Q-learning 的更新规则,解释它为什么只需要采样、不需要环境的模型,为什么是 off-policy 的;用 ε-greedy 解释探索与利用的权衡。
- 解释 DQN 的每一个设计:用神经网络近似 Q、TD 目标当”标签”、叠帧、经验回放、目标网络、Huber 损失,以及函数近似 + bootstrapping + off-policy 为什么会不稳定。
- 推导 REINFORCE 的 log-derivative trick,说出它和”交叉熵乘以回报”的关系;解释 baseline 为什么不改变期望、却能大幅降低方差;知道 actor-critic 和 PPO 的直觉。
- 说出 AlphaGo 由哪几块组成(监督学习的策略网络、自我对弈的强化学习、价值网络、蒙特卡洛树搜索),以及 AlphaGo Zero 去掉了什么。
- 讲清楚 RLHF 的三步(SFT → Bradley–Terry 奖励模型 → 带 KL 惩罚的 RL),解释奖励模型的过度优化,以及 DPO 为什么不需要显式的 RL。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉、不展开 Previewed only |
|---|---|
| 逻辑回归与交叉熵(第 2 讲),softmax 与 (第 9 讲 §3.6) | 带模型的强化学习(model-based RL)、MuZero,只提一句 |
| 指数加权平均(第 8 讲 §3)、学习率衰减与”噪声球”(第 8 讲 §8.1) | Actor-critic、TRPO / PPO 的完整推导(§6.4 只讲直觉) |
| 单一数字评估指标、“为什么不能拿 F1 当损失”(第 10 讲 §2) | 蒙特卡洛树搜索的细节(§7 只讲它在 AlphaGo 里的角色) |
| CNN(第 12 讲)、PyTorch 训练循环(第 9 讲 §4)、梯度裁剪(第 15 讲 §8.3) | 连续动作的控制(DDPG、SAC)、多智能体、离线 RL |
| 预测下一个 token 的语言模型(第 1 讲 §3.6、第 17 讲) | 怎样用大语言模型搭应用(第 20 讲) |
强化学习本身是一门很大的课(Stanford 有专门的 CS234)。这一讲的目标是:把强化学习的核心想法讲透,看清楚”深度”是在哪一步加进来的,以及它今天和大语言模型的关系。
0.3 本讲地图 Map
§1  为什么需要强化学习:没有标签,只有延迟的奖励
§2  Q 函数与 Bellman 方程:回收机器人的走廊;值迭代;γ 改变最优策略   ← 代码 01 演示 1、3
§3  Q-learning:不知道规则,只靠采样                                 ← 代码 01 演示 2
§4  探索 vs 利用:ε-greedy;困在近处的小奖励;Montezuma's Revenge     ← 代码 01 演示 4
§5  Deep Q-Network:函数近似、叠帧、经验回放、目标网络                ← 代码 02
§6  策略梯度:REINFORCE、baseline、actor-critic 与 PPO               ← 代码 03 演示 1、2
§7  AlphaGo:监督学习 + 自我对弈 + 价值网络 + 树搜索
§8  RLHF:奖励模型、KL 惩罚、过度优化、DPO、可验证奖励               ← 代码 03 演示 3、4
§9  强化学习的实际难点
§10–14  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 |
|---|---|
| 第 步的状态(state)、动作(action)、做完动作后拿到的奖励(reward) | |
| , | 策略(policy):在状态 下选动作 的概率;下标 表示由参数 决定 |
| 折扣因子(discount factor) | |
| 从第 步开始的(折扣)回报(return) | |
| , | 按策略 走下去的期望回报:从状态 出发;从 出发、第一步先做 |
| , | 最优策略的 和 |
| 学习率(Q-learning 的步长,和前面各讲的 是同一个意思) | |
| ε-greedy 里随机探索的概率 | |
| DQN 的目标网络(target network)的参数 | |
| ,(或 ) | RLHF 里的参考策略(通常是 SFT 之后的模型)、学出来的奖励模型 |
| RLHF 里 KL 惩罚的系数(不是第 8 讲 momentum 的 β) |
0.5 关于数字 · About the numbers
讲义里的实验数字都来自配套代码的实际输出(固定随机种子,PyTorch 单线程;同一台机器上重复运行逐字相同)。环境全部是合成的:一条 5 格的走廊、一个 10 × 5 的接球小游戏、一个 5 臂老虎机、一组带”隐藏真实质量”的候选回答。强化学习的结果对随机种子很敏感,所以凡是训练出来的数字,我都报告多个种子的中位数和范围。有几处结果和我写代码前的预想不一样(比如 DQN 的目标网络在小游戏上看不出作用),讲义按实际结果写,并列在代码 README 的”关于实验结果”里。论文里的数字(Atari 分数、AlphaGo 的胜率等)引自原文,见 §13。
1. 为什么需要强化学习 · Why reinforcement learning?
1.1 从围棋说起:监督学习哪里不够
第 1 讲 §1.3 的历史表里有一行:“2016,AlphaGo 击败李世石”。先想一想:如果只会监督学习,你会怎样做一个下围棋的程序?
最自然的想法是把它写成 : 是棋盘局面(19 × 19 的格子,每格黑 / 白 / 空), 是”这一步该下在哪”(361 个位置之一,一个 softmax 分类问题)。标签从哪来?找职业棋手的棋谱。AlphaGo 的第一步确实就是这样做的(§7)。但这条路有三个根本的问题:
- 标签不一定对。职业棋手的每一步都是”最好的一步”吗?没人知道。你最多学到”像人一样下”,很难超过人。
- 真正的反馈来得很晚。一盘棋下一两百步,最后只有一个结果:赢或输。中间哪一步是好棋、哪一步是败招,没有人告诉你。
- 你的决定会改变你看到的数据。你下了一步棋,对手的应对、后面出现的局面都跟着变;你从来没下过的走法,就永远看不到它会导向什么。
这三点正是强化学习要处理的:没有”正确答案”,只有一个延迟的、评价性的分数(赢了 +1、输了 −1),模型要自己去试、自己从结果里学。
1.2 问题设定:智能体与环境
强化学习把问题写成一个循环:
         ┌──────────── 动作 a_t ────────────┐
         │                                   ↓
   ┌───────────┐                       ┌───────────┐
   │  智能体     │                       │   环境      │
   │  agent    │ ←── 状态 s_{t+1}、奖励 r_t ──│ environment│
└───────────┘ └───────────┘- 状态 :智能体此刻看到的东西(棋盘、游戏画面、机器人的位置)。
- 动作 :它能做的选择(落子的位置、手柄的按键、往左还是往右)。
- 奖励 :做完动作后环境给的一个数(得分、赢 / 输、“走一步扣一点电”)。
- 策略 :智能体的”大脑”:看到状态,决定动作(可以是确定的,也可以是一个概率分布)。
- 回合(episode):从开始到结束的一段经历(一盘棋、一局游戏)。
目标是找一个策略,让一整个回合加起来的奖励(回报)尽可能大。注意是”加起来”:为了最后的大奖励,可以(也常常必须)先忍受一些没有奖励甚至负奖励的步骤。
1.3 和监督学习的五个区别
| 监督学习(第 1–17 讲) | 强化学习 | |
|---|---|---|
| 反馈 | 每个样本都有标签 :告诉你正确答案是什么(指导性 instructive) | 只有奖励:告诉你做得有多好,不告诉你该怎么做(评价性 evaluative) |
| 反馈的时间 | 立刻 | 常常是延迟的:一盘棋最后才知道输赢 |
| 信用分配 | 每个输出的错误直接对应一个损失 | 最后的输赢要”分摊”给前面的几百个决定:哪一步该负责?(credit assignment) |
| 数据 | 固定的数据集,样本独立同分布(i.i.d.) | 由策略自己收集:策略变了,看到的数据也变了;同一回合里相邻的样本高度相关 |
| 探索 | 不需要 | 必须:没试过的动作,永远不知道它好不好(exploration vs exploitation) |
最后两行是强化学习特有的难点,后面会反复出现:代码 01 里从不探索的机器人困在近处的小奖励(§4),DQN 用经验回放来对付”相邻样本高度相关”(§5.4),RLHF 里奖励模型在策略”走到的新地方”失效(§8.4)——都是”数据是策略自己收集的”这一件事的不同侧面。
1.4 奖励就是那个”单一数字指标”——但设计它很难
第 10 讲 §2 说,做项目要先定一个单一数字的评估指标。强化学习把这件事推到了极致:奖励就是指标,而且模型直接去优化它。第 10 讲 §2.5 还说过,F1 这种”数个数”的指标导数几乎处处为 0,没法直接当损失做梯度下降;强化学习的策略梯度(§6)恰好绕开了这个限制——奖励不需要可导,只需要能打分。
代价是:模型会不折不扣地优化你写下的奖励,而不是你心里想要的东西。OpenAI 2016 年的博客 Faulty reward functions in the wild 记录了一个例子:赛艇游戏 CoastRunners 里,奖励是”撞到赛道上的得分目标”。智能体发现在一个小湖湾里兜圈子、反复撞同样的三个目标,比跑完比赛得分更高——平均分数比人类玩家还高约 20%,却从来不去终点。这类现象叫 reward hacking(钻奖励的空子),§8.4 会在一个玩具 RLHF 里亲眼看到它。
2. Q 函数与 Bellman 方程 · Q-tables & the Bellman equation
2.1 回收机器人的走廊
Kian 在 2018 年的课上用一个一维的小世界讲 Q-table。据录像字幕,他的例子是一排 5 个状态:机器人从第 2 格出发,手里拿着一个塑料瓶;最左边是普通垃圾桶(+2),第 4 格有一块巧克力(+1),最右边是回收站(+10),折扣 0.9(我是根据字幕整理的,细节可能有出入)。这一讲用一个简化的版本,只在两端有奖励,好让每个数都能心算:
    格子:    0          1          2          3          4
           [垃圾桶]   [机器人]      ·          ·       [回收站]
    奖励:    +1                                         +10        (走到两端,这一回合结束)
机器人手里拿着一个塑料瓶,从格子 1 出发,每步往左或往右走一格;把瓶子扔进格子 0 的普通垃圾桶得 +1(近,但小),送到格子 4 的回收站得 +10(远,但大),其余每步奖励 0。
先想一想:在格子 1,机器人应该往哪边走? 往左一步就有 +1;往右要走三步才有 +10。答案取决于”三步之后的 10 分”在机器人眼里值多少——这就是折扣因子 的作用。
2.2 回报与折扣
一个回合里拿到的奖励序列是 。回报(return)把它们加起来,越往后的奖励打越多的折:
在格子 1 一路往右走:,;往左走:。
为什么要打折?三个理由:(1) 不确定性:越远的未来越不可靠;(2) 偏好:“现在的 1 块钱比明年的 1 块钱值钱”;(3) 数学上:没有终点的任务里, 保证这个和是有限的。
决定了智能体”看多远”。 什么时候衰减到不值一提?这和第 8 讲 §3.3 指数加权平均的分析一模一样:,所以 粗略地是有效视野。 大约看 10 步, 大约看 100 步。
2.3 Q 函数与 Bellman 最优方程
Q 函数回答的问题是:“在状态 先做动作 ,之后都按最优的方式走,期望能拿到多少回报?“记作 。有了它,最优策略就是查表:在每个状态选 最大的动作。
满足一个递归的等式,叫 Bellman 最优方程(Bellman optimality equation):
用话说:这一步的价值 = 立刻拿到的奖励 + 打了折的”从下一个状态开始最好能拿到的价值”。 是终点时,后面那一项是 0。在确定的走廊里,期望可以去掉。
在走廊上手算()。从离奖励最近的地方开始:
- (一步到回收站);(一步到垃圾桶)。
- 。
- 。
- 。
- 。
| 状态 | 最优动作 | ||
|---|---|---|---|
| 格子 1 | 1 | 8.1 | → |
| 格子 2 | 7.29 | 9 | → |
| 格子 3 | 8.1 | 10 | → |
最优策略是一路往右:在格子 1,忍住眼前的 +1,去拿打了折的 +10(8.1 > 1)。
2.4 值迭代:奖励的消息一轮往回传一格
上面的手算是”从奖励附近往回推”。值迭代(value iteration)把这个过程机械化:从全 0 的表出发,把 Bellman 方程当成赋值语句,反复执行 ,直到表不再变化。
代码 01 演示 1 打印了前几轮之后的表:
| 格子 1 (←, →) | 格子 2 (←, →) | 格子 3 (←, →) | 贪心策略 | |
|---|---|---|---|---|
| 第 1 轮 | (1, 0) | (0, 0) | (0, 10) | ← = → |
| 第 2 轮 | (1, 0) | (0.9, 9) | (0, 10) | ← → → |
| 第 3 轮 | (1, 8.1) | (0.9, 9) | (8.1, 10) | → → → |
| 收敛(第 5 轮不再变化) | (1, 8.1) | (7.29, 9) | (8.1, 10) | → → → |
收敛后的表和手算的六个数最大相差 1.8e−15。值得盯住的是前三行:第 1 轮只有”一步就能拿到奖励”的格子知道奖励的存在;+10 的消息第 2 轮传到格子 2,第 3 轮才传到格子 1——在第 3 轮之前,格子 1 的贪心策略是往左。奖励是延迟的,Bellman 方程每用一次,就把它往回传一步。这就是 §1.3 说的信用分配:一盘 200 步的棋,“最后赢了”这个消息要传回第一步,需要很多轮这样的回传。
时,值迭代的每一轮都让表和 的最大误差至少缩小到原来的 倍(Bellman 算子是一个压缩映射),所以它一定收敛,而且收敛到唯一的 。
2.5 γ 改变最优策略
代码 01 演示 3 换不同的 重新做值迭代:
| γ | 最优策略(格子 0–4) | ||
|---|---|---|---|
| 0.1 | 1.0000 | 0.1000 | · ← → → · |
| 0.3 | 1.0000 | 0.9000 | · ← → → · |
| 0.31 | 1.0000 | 0.9610 | · ← → → · |
| 0.32 | 1.0000 | 1.0240 | · → → → · |
| 0.5 | 1.0000 | 2.5000 | · → → → · |
| 0.9 | 1.0000 | 8.1000 | · → → → · |
| 0.99 | 1.0000 | 9.8010 | · → → → · |
在格子 1,往左是 1,往右是 ,两者相等时 。 时最优是往左, 时最优是往右。所以 不只是一个”让数学收敛”的技术参数,它是任务定义的一部分:你在定义”什么是好的行为”。还要注意格子 2、3 在 很小时仍然往右——最优策略是”每个状态各自的最优动作”,不同状态可以不一样。
3. Q-learning:不知道规则,只靠采样 · Q-learning
3.1 TD 目标与更新规则
值迭代有一个前提:要知道环境的规则(“往右会到哪一格、拿多少奖励”,代码里的 outcomes())。真实的问题里我们往往不知道——没人能写出”在这个棋盘上下这一步,对手会怎么应”的概率表。
Q-learning(Watkins 1989)只需要和环境交互。每走一步,拿到一个样本 ,就把 往一个”目标”拉一点:
( 是终点时 。)和值迭代对比:值迭代对所有可能的 按概率加权求和;Q-learning 只用这一次真的到达的 ,靠很多次采样的平均来代替那个求和。 叫 TD 误差(temporal-difference error):用”多看了一步之后的估计”去修正”现在的估计”。
用第 2 讲的眼光看,这一行就是一步梯度下降:把 当”标签”、把 当”预测”,平方误差 对 的负梯度正是 。区别是:这个标签是用 自己算出来的(bootstrapping,“自举”), 一变,标签也跟着变。§5 换成神经网络以后,这会成为一个大问题。
3.2 实验:只靠采样学到同一张表
代码 01 演示 2 让机器人在走廊里跑 3000 个回合(ε 从 1 线性降到 0.1,见 §4),每隔一段时间看学到的表和 的最大误差(5 个种子的中位数):
| 环境 | α | 10 回合 | 30 回合 | 100 回合 | 300 回合 | 1000 回合 | 3000 回合 |
|---|---|---|---|---|---|---|---|
| 确定的走廊 | 0.5 | 7.0875 | 0.9196 | 0.0000 | 0.0000 | 0.0000 | 0.0000 |
| 确定的走廊 | 0.1 | 8.8290 | 7.6290 | 2.7222 | 0.1550 | 0.0037 | 0.0000 |
| 打滑的走廊(20% 原地不动) | 0.1 | 8.0979 | 6.1397 | 1.1893 | 0.2789 | 0.5566 | 0.4670 |
| 打滑的走廊(20% 原地不动) | 0.5 | 6.6361 | 0.9629 | 1.1505 | 1.1239 | 1.1295 | 1.1306 |
- 确定的走廊:Q-learning 学到的表和值迭代的 一模一样。它从没看过环境的规则,只是一次次”走一步、看结果”。
- 打滑的走廊:每次移动有 20% 的概率没生效。这时同一个 有时到这里、有时到那里,TD 目标本身是带噪声的。常数学习率下误差停在一个”底”上( 时 0.467, 时 1.131),而且 300 回合时的误差(0.2789)反而比 3000 回合小——这是噪声,不是越学越差。这就是第 8 讲 §8.1 的”噪声球”:每一步都被最新的一个噪声样本拉一下,步子越大晃得越厉害。理论上,要让 逐渐变小(满足 Robbins–Monro 条件:、),并且每个 都被无限次访问,表格 Q-learning 才保证收敛到 (Watkins & Dayan 1992)。
3.3 off-policy:学的是”最优策略”的价值
TD 目标里用的是 ——“假设以后都走最好的那一步”,而不是机器人实际会做的动作。所以不管机器人怎样探索、怎样乱走,Q-learning 学到的都是最优策略的 。这种”行为策略”和”被学习的策略”不同的学习方式叫 off-policy(异策略)。它的好处是可以用任何来源的经验来学,包括很久以前的旧经验——§5.4 的经验回放就靠这一点。代码 01 演示 4 里有一个极端的例子:一个完全随机地走的机器人,在 20 个种子里全都学准了整张 。
4. 探索 vs 利用 · Exploration vs exploitation
4.1 ε-greedy
如果机器人总是选当前 Q 值最大的动作(利用 exploitation),它可能永远不去试那些”看起来不好、其实很好”的动作。最简单的对策是 ε-greedy:以概率 随机选一个动作(探索 exploration),否则选 Q 值最大的。常见的做法是 先大后小:一开始什么都不懂,多探索;学到一些东西以后,多利用。
4.2 实验:困在近处的小奖励
先预测:在我们的走廊上,一个从不探索()的机器人会怎样?
代码 01 演示 4,每个设置 20 个种子 × 300 回合():
| 设置 | 找到 +10 的种子 | Q 表学准的种子 | 训练期间平均每回合的回报(中位数) |
|---|---|---|---|
| ε = 0(从不探索) | 1/20 | 0/20 | 1.000 |
| ε = 0.05 | 9/20 | 1/20 | 1.017 |
| ε = 0.1 | 10/20 | 4/20 | 1.272 |
| ε = 0.3 | 17/20 | 17/20 | 4.901 |
| ε = 1(完全随机地走) | 20/20 | 20/20 | 2.297 |
| ε = 0 + 乐观初始化 Q = 10 | 20/20 | 0/20 | 8.062 |
(“找到 +10”指学完以后起点的贪心动作是往右;最优回报是 8.1,只拿 +1 是 1.0。)
- ε = 0 只有 1/20 个种子找到 +10。第一回合 Q 全是 0,机器人在乱走;如果先撞到左边的 +1, 变成正数,从此它每一回合都往左——右边有 +10 这件事,它永远不会知道。这就是”只利用、不探索”的陷阱,也是 §1.3”数据是策略自己收集的”最直接的后果:没去过的地方,永远没有数据。
- 一条 5 格的走廊,探索就已经不容易:ε = 0.05、0.1 也只有一半左右的种子找到 +10。起点紧挨着一个小奖励,“先尝到甜头”的吸引力很强。
- 探索有代价。ε = 1 学准了全部 (off-policy,§3.3),但训练期间它一直在乱走,平均每回合只拿到 2.297;ε = 0.3 找到了 +10,训练时却有三成的步子在乱走(4.901)。学到正确的知识,和在学的过程中拿到奖励,是两件事——这就是探索与利用的权衡。
- 乐观初始化是另一种探索办法:把所有 Q 值初始化成一个很大的数(10)。试过的动作 Q 值会掉下来,没试过的看起来更好,于是机器人会主动去试。在这里它效果最好(20/20 找到 +10,训练期间回报 8.062),但它的 Q 表 0/20 是准的——不选的动作试一两次就不再碰,Q 值停在半路。控制只需要”最好的动作排在第一”,不需要每个数都准。
4.3 难探索的问题:Montezuma’s Revenge
走廊只有 5 格。在 Atari 游戏 Montezuma’s Revenge 里,要先走过几个房间、躲开骷髅、拿到钥匙才有第一个奖励,随机按手柄几乎永远碰不到它。Mnih et al. (2015) 的 DQN 在这个游戏上的得分是 0(人类测试者 4367 分),而它在 Breakout 这类”随便动一动就有奖励”的游戏上远超人类。2018 年的课上 Kian 也用这个游戏说明探索之难。
后来的方法大多是”对没见过的东西保持乐观”的延伸——乐观初始化在状态多到数不过来时没法直接用,于是改成给”新奇”的状态发额外奖励:按访问次数的计数奖励(Bellemare et al. 2016)、“预测不准就说明没见过”的好奇心类方法(如 Burda et al. 2019 的 Random Network Distillation),以及先记住怎样回到有希望的地方、再从那里探索的 Go-Explore(Ecoffet et al. 2021)。
5. Deep Q-Network
5.1 表格装不下:为什么要函数近似
Q-table 给每个 存一个数。走廊有 3 个非终点状态 × 2 个动作 = 6 个数。Atari 呢?DQN 的输入是 4 帧 84 × 84 的灰度图,每个像素 256 个灰度值——可能的状态数是一个天文数字,绝大多数一辈子也见不到一次。更要紧的是:表格不会泛化,在一个状态上学到的东西,对另一个只差一个像素的状态毫无帮助。
所以用一个神经网络 来近似 Q 函数:输入状态,输出每个动作的 Q 值。相似的画面得到相似的 Q 值——这正是第 12 讲 CNN 擅长的事。Kian 的”五问”(第 5 讲)在这里同样适用:输入是什么(几帧画面)、输出是什么(每个动作一个 Q 值,一次前向传播算出所有动作,不用对每个动作各跑一遍)、损失是什么(下一节)。
5.2 从 Q-learning 到损失函数
把 §3.1 的更新写成一个损失:
( 是终点时 。) 是经验回放池, 是目标网络的参数(§5.4)。 被当作常数,梯度只流过 。这就是一个回归问题——只不过”标签”是网络自己(的旧版本)给的。代码 02 的 dqn_loss 把这三行写了出来:在 torch.no_grad() 里算 ,用 gather 取出实际做了的动作的 Q 值,再算损失。
5.3 DQN 玩 Atari
DeepMind 的 DQN 先在 2013 年的 NIPS 深度学习研讨会上发表(Mnih et al. 2013,7 个 Atari 游戏,6 个超过之前的方法、3 个超过人类专家),2015 年在 Nature 上发表了完整版(Mnih et al. 2015)。2015 年版的要点:
| 设计 | 做法 | 为什么 |
|---|---|---|
| 预处理 | 210 × 160 的彩色帧 → 灰度、缩小到 84 × 84 | 降低输入维度;2018 年课上 Kian 也提醒过,转灰度可能丢掉有用的信息(颜色),这是一个要权衡的设计决定 |
| 叠帧 | 把最近 4 帧叠成 84 × 84 × 4 的输入 | 一帧静止的画面看不出球往哪边飞;叠几帧,速度就”看得见”了 |
| 网络 | 3 个卷积层(32 个 8×8 步长 4;64 个 4×4 步长 2;64 个 3×3 步长 1)+ 512 个单元的全连接层 + 每个动作一个线性输出 | 第 12–13 讲的 CNN;输出 4–18 个 Q 值(游戏不同,动作数不同) |
| 同一套设置 | 49 个游戏用同一个算法、网络结构和超参数 | 说明方法是通用的,不是为某个游戏调出来的 |
| 奖励裁剪 | 正的奖励都记 +1,负的都记 −1 | 各游戏分数的尺度差别很大,裁剪后可以共用一个学习率 |
| 误差裁剪 | TD 误差的梯度裁剪到 [−1, 1] | 等价于 Huber 损失;防止一次大误差把网络推得太远(第 15 讲 §8.3 的梯度裁剪) |
| 探索 | ε 在前 100 万帧从 1 线性降到 0.1 | 先探索后利用(§4.1) |
| 动作重复 | 每个动作重复 4 帧(frame skip) | 省计算;相邻帧几乎一样 |
| 经验回放 | 回放池存最近 100 万个转移,每次随机抽 32 个 | §5.4 |
| 目标网络 | 每 10,000 次参数更新同步一次 | §5.4 |
| 训练量 | 每个游戏 5000 万帧(约 38 天的游戏时间) | 样本效率很低(§9) |
结果:在 49 个游戏中的 29 个(超过一半)达到了人类专业测试者分数的 75% 以上。(2013 年的版本更小:两个卷积层 16、32 个滤波器 + 256 个单元的全连接层,训练 1000 万帧,还没有单独的目标网络。)
5.4 两个零件:经验回放与目标网络
把 Q-learning 直接套上神经网络,训练常常不稳定甚至发散。DQN 用两个零件来对付它。
经验回放(experience replay)。如果每走一步就用刚刚这一步来训练,相邻的样本几乎一模一样(同一局游戏里连续的几帧),一个 mini-batch 里的样本高度相关,梯度被”刚刚发生的事”牵着走;而且每个样本用一次就扔掉。经验回放把所有转移 存进一个大池子,每次随机抽一个 mini-batch:(1) 打破相关性,让 batch 更接近第 8 讲 mini-batch 假设的 i.i.d. 样本;(2) 一个转移可以被用很多次,样本效率更高。能这样做的前提是 Q-learning 是 off-policy 的(§3.3):旧策略收集的经验,照样可以用来学最优的 Q。
目标网络(target network)。TD 目标 里也有 。每做一步梯度下降, 变了,靶子 也跟着动——“追着一个移动的靶子跑”,很容易振荡。DQN 用一份旧的参数 来算 ,每隔 步才把 拷贝给 。这样在 步之内,问题变回了一个普通的、标签固定的回归问题。另一种常见做法是”软更新” ( 很小),也就是对 做第 8 讲 §3 的指数加权平均。
为什么会不稳定:deadly triad。Sutton & Barto 的教材(第 2 版 §11.3)把这个问题总结为”致命三要素”:函数近似(function approximation)、自举(bootstrapping,用自己的估计当目标)、异策略(off-policy)训练。三者同时出现时,训练可能发散;只要去掉其中一个,通常就是稳定的。DQN 三样全占,经验回放和目标网络是让它在实践中”够稳定”的两块补丁,而不是理论上的保证。
Mnih et al. (2015) 做过对照实验(只训练 1000 万帧,下面是 5 个游戏的分数):
| 游戏 | 回放 + 目标网络 | 回放,无目标网络 | 无回放,有目标网络 | 两个都没有 |
|---|---|---|---|---|
| Breakout | 316.8 | 240.7 | 10.2 | 3.2 |
| Enduro | 1006.3 | 831.4 | 141.9 | 29.1 |
| River Raid | 7446.6 | 4102.8 | 2867.7 | 1453.0 |
| Seaquest | 2894.4 | 822.6 | 1003.0 | 275.8 |
| Space Invaders | 1088.9 | 826.3 | 373.2 | 302.0 |
在 Atari 上两个零件都有用;5 个游戏里有 4 个是去掉经验回放损失更大(Seaquest 是例外:去掉目标网络掉得更多)。下面在我们自己的小游戏上看一看。
5.5 实验:迷你 Breakout
Breakout 在 CPU 上要训练很多天。代码 02 用 numpy 写了一个小游戏 Catch 代替它:10 行 × 5 列的画面,球从顶上落下、斜着走、碰墙反弹;最下面一行是挡板,每步左移 / 不动 / 右移。球落到底时接住 +1、没接住 −1,一局 9 步。状态是最近 2 帧画面叠起来再拉平(2 × 10 × 5 = 100 个 0/1),Q 网络是第 9 讲 torch_utils 的 MLP [100, 64, 64, 3](10,819 个参数)。
代码 02 演示 1 先给出两把尺子:随机乱动接住 0.206;一个”预言家”直接算出落点、往那里走,接住 1.000(挡板从中间出发,9 步内总能走到)。演示 1 还摆了两局:在第 2 步,两局的画面一模一样(球都在第 2 列),但一个往右飞、一个往左飞,最后的落点分别是第 1 列和第 3 列。只看一帧,任何策略都分不清这两局——这就是 DQN 要叠帧的原因。
代码 02 演示 2:完整的 DQN(回放池 5000、batch 32、前 500 步只收集、每 100 次更新同步目标网络、Adam 1e−3、Huber 损失、γ = 0.99、ε 在前 3000 步从 1 降到 0.05),训练 6000 步,每 1000 步在同样的 500 局测试游戏上评估(贪心策略):
| 步数 | 种子 0 | 种子 1 | 种子 2 | 种子 3 | 种子 4 | 中位数 |
|---|---|---|---|---|---|---|
| 1000 | 0.474 | 0.432 | 0.328 | 0.374 | 0.272 | 0.374 |
| 2000 | 0.816 | 0.334 | 0.700 | 0.486 | 0.724 | 0.700 |
| 3000 | 1.000 | 0.830 | 1.000 | 0.788 | 0.730 | 0.830 |
| 4000 | 1.000 | 0.938 | 1.000 | 1.000 | 0.848 | 1.000 |
| 5000 | 0.938 | 0.938 | 1.000 | 1.000 | 1.000 | 1.000 |
| 6000 | 1.000 | 0.938 | 1.000 | 0.938 | 1.000 | 1.000 |
网络只看见 100 个 0/1 和一局结束时的 ±1,没人告诉它”挡板要对准球”,几千步之后就学会了。注意种子之间的差别:2000 步时从 0.334 到 0.816。
代码 02 演示 3 把零件一个个拿掉,每个设置 5 个种子:
| 设置 | 6000 步后接住率:中位数(范围) | 学习曲线平均 | Q 估值 − 实际回报 |
|---|---|---|---|
| 完整的 DQN(回放 + 目标网络,2 帧) | 1.000(0.938–1.000) | 0.794 | 0.176 |
| 去掉目标网络 | 1.000(0.950–1.000) | 0.804 | 0.137 |
| 去掉经验回放(只用最近 32 步) | 0.472(0.464–0.760) | 0.391 | 0.409 |
| 两个都去掉 | 0.658(0.464–0.890) | 0.460 | 0.315 |
| 完整的 DQN,但只给 1 帧 | 0.472(0.424–0.616) | 0.445 | 0.295 |
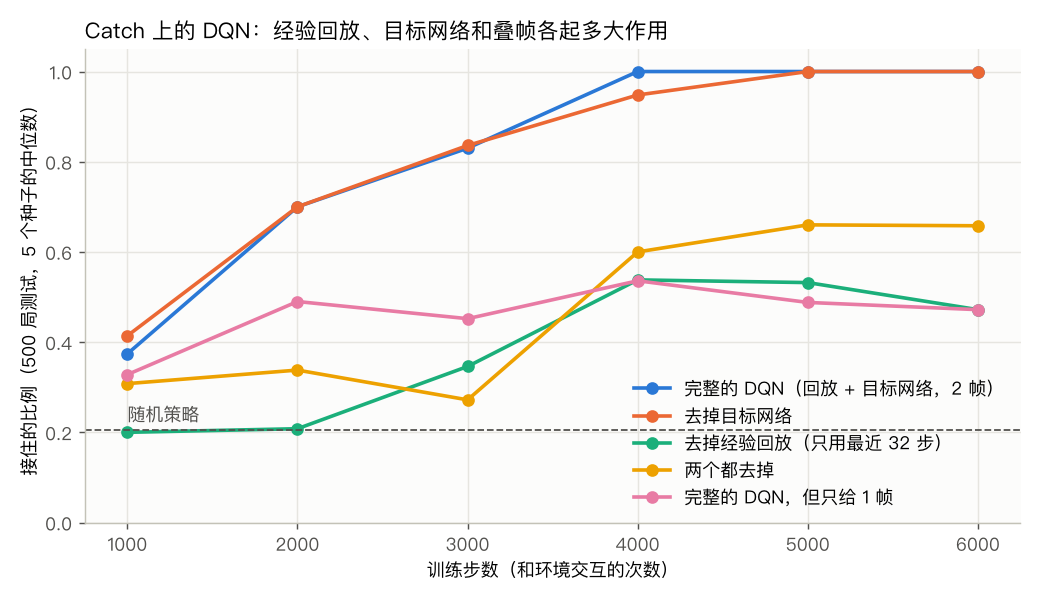
(“学习曲线平均”是 6 个检查点的平均接住率,衡量学得快不快;“去掉经验回放”的实现是回放池只存最近 32 个转移、每步全部用上,batch 大小和更新次数都不变,只改变了数据的相关性。)
- 经验回放是这里最重要的零件:去掉它,中位数从 1.000 掉到 0.472。最近 32 步只是 3–4 局游戏的连续画面,网络学了后面忘了前面。
- 去掉目标网络,看不出影响(1.000 vs 1.000,学习曲线平均 0.804 vs 0.794)。这和 Mnih et al. 在 Atari 上的结论不一样。我的理解是:Catch 每局只有 9 步、奖励只有 ±1,“移动的靶子”带来的不稳定还不明显。在玩具问题上看不出某个技巧的作用,不代表它在大问题上没用——反过来也一样。“两个都去掉”的中位数(0.658)反而比”只去掉回放”高,但两者的范围大幅重叠,5 个种子分不出高下,不要从中读出”去掉目标网络有帮助”。
- 只给 1 帧时停在 0.472。状态里缺了需要的信息(球的速度),再好的算法也补不回来。DQN 论文里叠 4 帧这个看似不起眼的预处理,在这个小游戏里和经验回放一样关键。
5.6 过估计,以及 DQN 之后
演示 2 还记录了 Q 网络对开局局面的估值 :5 个种子的中位数 1.083(1.023–1.124),而实际的平均折扣回报是 0.923(0.808–0.923)。注意,这个游戏里任何策略能拿到的最大折扣回报就是 (9 步之后接住拿 +1),5 个种子的估值全都超过了它。原因在 TD 目标的 :对几个带噪声的估计取最大值,平均起来会偏大——就像从 10 个同样实力的学生里挑”考得最好的”,他下次的分数多半会回落。这种系统性的过估计(overestimation)会通过自举一轮轮传下去。演示 3 的最后一列显示,所有设置的估值都偏高,学得差的设置偏得更多。
估值偏高并不一定妨碍选对动作(选动作只看排序),但它会让学习变慢、变得不稳定。van Hasselt, Guez & Silver (2016) 的 Double DQN 把”选哪个动作”和”估它值多少”分开:用在线网络选 ,用目标网络估值 ,改动只有一行。DQN 之后的几年里出现了一系列改进:优先经验回放(Schaul et al. 2016,多回放 TD 误差大的转移)、Dueling 网络(Wang et al. 2016)、把六种改进合在一起的 Rainbow(Hessel et al. 2018),到 2020 年的 Agent57(Badia et al. 2020)成为第一个在全部 57 个 Atari 游戏上都超过人类基准的深度强化学习智能体——包括 Montezuma’s Revenge。
6. 策略梯度 · Policy gradients
6.1 为什么直接学策略
DQN 先学 Q 函数,再从中”读出”策略(argmax)。另一条路是直接参数化策略 ,比如一个以 softmax 结尾的网络(第 9 讲 §3),然后调 让期望回报变大:
是一条轨迹(一个回合)。这样做的好处:动作是连续的(机器人关节的力矩)时,argmax 不好算,而策略可以直接输出一个连续分布;最优策略本身是随机的时候(石头剪刀布),也能表示;而且语言模型本身就是一个策略——给定前文(状态),输出下一个 token 的概率分布(动作)。§8 的 RLHF 正是用策略梯度来调语言模型。
6.2 log-derivative trick 与 REINFORCE
难点在于: 是对”按 抽样”求期望,抽样这一步没法求导;而且奖励来自环境,我们不知道它的公式,更不会求它的导数。
技巧是 (就是 倒过来写)。于是
而一条轨迹的概率是”环境的转移概率”和”策略的选择概率”的乘积,取 log 以后,环境那部分和 无关、求导消失了:
不需要知道环境的规则,也不需要奖励可导——只要能抽样、能打分。再用”现在的动作影响不了过去的奖励”去掉多余的项,就得到 REINFORCE(Williams 1992)的常见写法:抽一条(或一批)轨迹,然后
和监督学习对照。softmax 策略的 是 ——这正是第 9 讲 §3.6 里 反过来(差一个负号)。所以 REINFORCE 就是:把自己刚才抽到的动作当作”标签”,做一步交叉熵的梯度下降,再乘上这一步之后拿到的回报。回报高,就像监督学习一样往”再做一次这个动作”的方向推;回报低(或为负),就往反方向推。在 PyTorch 里,它写成一个”替代损失” -(G * log_prob).mean(),对它 backward() 就得到 REINFORCE 的梯度(代码 03 演示 1 验证了它和手写公式差 5.6e−17)。
6.3 方差与 baseline
REINFORCE 是无偏的,但方差很大:一条轨迹里有很多随机性(策略的抽样、环境的随机),只看一条就决定往哪边推,很容易推错。
减去 baseline。对任何只依赖状态、不依赖动作的 ,
所以把 换成 ,期望不变,方差却可以小很多。直觉:如果所有的回报都是正数,不减 baseline 时每个样本都在说”把我做的动作推高”,真正的信号——“这个动作比平均好还是比平均差”——被淹没了。最常用的 baseline 是 的估计,这时 叫优势(advantage)。
代码 03 演示 1 在一个 5 臂老虎机(5 个按钮,平均奖励 1.0 到 3.0,每次的奖励再加一个常数 和 N(0, 1) 噪声)上,用 10 万个样本比较两种梯度估计(baseline 取当前策略的期望奖励)。精确梯度是 ,和 无关:
| 常数 c | 估计 | 样本平均 | 方差之和 |
|---|---|---|---|
| 0 | [−0.203, −0.096, −0.001, +0.096, +0.204] | 4.30 | |
| 0 | [−0.202, −0.100, +0.001, +0.099, +0.202] | 1.10 | |
| 10 | [−0.194, −0.110, −0.007, +0.110, +0.201] | 116.18 | |
| 10 | [−0.198, −0.101, +0.001, +0.099, +0.199] | 1.09 | |
| 100 | [−0.215, −0.130, −0.088, +0.130, +0.303] | 8324.67 | |
| 100 | [−0.203, −0.100, −0.001, +0.099, +0.205] | 1.11 |
两种估计的平均都对得上精确梯度(、不减 baseline 时差 0.103,但那个分量的标准误就有 0.130——10 万个样本还平均不掉这么大的噪声)。方差差得惊人: 时不减 baseline 的方差是减了的约 106 倍。
代码 03 演示 2 看这对学习意味着什么:每一步按一次按钮、用这一个样本更新(学习率 0.05,2000 步),baseline 是最近奖励的指数加权平均(第 8 讲 §3,),10 个种子:
| 常数 c | baseline | 最后的期望奖励:中位数(范围) | 最后选中最好按钮的种子 |
|---|---|---|---|
| 0 | 无 | 2.991(2.978–2.995) | 10/10 |
| 0 | 有 | 2.991(2.986–2.994) | 10/10 |
| 10 | 无 | 2.500(1.510–2.999) | 4/10 |
| 10 | 有 | 2.991(2.986–2.994) | 10/10 |
| 100 | 无 | 2.000(1.000–3.000) | 2/10 |
| 100 | 有 | 2.991(2.986–2.994) | 10/10 |
时有没有 baseline 差不多。、100 时,没有 baseline 的 REINFORCE 只有 4/10、2/10 个种子选中最好的按钮:第一次按到哪个,那个按钮的概率就被大幅推高(奖励全是正的大数),之后它被按得最多、被推得最多,很快锁死在一个随机的按钮上——和代码 01 里 ε = 0 困在 +1 是同一类问题。有 baseline 时三种 的结果完全相同:减去”最近的平均”以后,奖励整体平移多少都不影响更新。
(我也在代码 01 的走廊上试过同样的比较:baseline 把梯度的方差降低了几倍,但学习曲线几乎一样——那个问题太小、奖励也没有大的整体偏移。baseline 的价值在奖励尺度大、轨迹长、问题难的时候才明显。)
6.4 Actor-critic 与 PPO(直觉)
Actor-critic:同时训练两个网络(或一个网络的两个头)。actor 是策略 ,critic 估计 ,给 actor 当 baseline;critic 本身用 TD 的方式训练(§3.1)。用 代替 当优势,方差更小(不用等到回合结束),代价是引入了 critic 的偏差。A3C / A2C(Mnih et al. 2016)是这一类的代表。
PPO(Proximal Policy Optimization,Schulman et al. 2017)解决的是另一个问题:策略梯度的一步走多远?步子太大,策略一下子变得面目全非,收集到的数据又变了,很容易崩溃;步子太小又太慢。PPO 用”新策略和收集数据的旧策略的概率比” ,把目标裁剪成
论文里 MuJoCo 实验用 。直觉是:一批数据可以多用几遍,但不许策略离收集这批数据的策略太远——好动作的概率最多提高到原来的 倍,再多就不给奖励了。它实现简单、比较稳,成了很多应用(包括 InstructGPT 的 RLHF,§8)的默认选择。
7. AlphaGo:把这些拼起来 · AlphaGo
7.1 围棋为什么难
Silver et al. (2016) 用两个数描述搜索空间:围棋每步大约有 种合法的下法,一盘棋大约 步(国际象棋大约是 35 和 80)。穷举 是不可能的;19 × 19 棋盘上合法的局面数约为 (Tromp 2016 的精确计数)。而且和国际象棋不同,围棋很难写出一个好的”局面评估函数”——人类高手自己也说不清楚为什么一个局面好。
7.2 AlphaGo 的四个网络 + 树搜索
AlphaGo 几乎用上了本讲的每一个想法:
| 组件 | 怎么训练 | 作用 | 对应本讲 |
|---|---|---|---|
| SL 策略网络 | 监督学习:KGS 围棋服务器上人类棋谱的 3000 万个局面,预测人类的下一步(13 层的卷积网络,准确率 57.0%) | 给出”像人一样”的候选走法 | 第 1 讲 §3 的 、第 12 讲 CNN |
| 快速走子策略 | 监督学习,简单的线性模型(准确率 24.2%,但每步只要约 2 微秒) | 在树搜索里快速把棋下完(rollout) | |
| RL 策略网络 | 从 出发,和自己以前的版本对弈,用策略梯度(REINFORCE)优化胜负 | 下得比 更强:对 胜率超过 80%,不搜索也能赢开源程序 Pachi 85% | §6 |
| 价值网络 | 回归:用 自我对弈产生 3000 万个局面,每盘棋只取一个局面,预测最后的胜负 | 一眼判断局面的好坏 | §2 的 |
| 蒙特卡洛树搜索(MCTS) | 不训练:比赛时实时搜索 | 用策略网络缩小”宽度”、用价值网络(和快速走子)缩小”深度” | 规划 |
几个值得注意的细节:
- 价值网络为什么每盘只取一个局面? 同一盘棋相邻的局面只差一颗子、最后的胜负标签完全相同,用整盘棋训练,网络会记住”这一盘是谁赢的”而不是学会判断局面。这和 DQN 的经验回放要打破相关性(§5.4)是同一个道理。
- 树搜索里叶子节点的评估是价值网络和快速走子的结果各占一半(混合系数 λ = 0.5),论文报告这样比单用任何一个都好。
- 搜索时用来给候选走法排先后的先验,用的是 SL 策略网络而不是更强的 RL 策略网络——论文的解释是人类棋谱给出的候选更多样,而 RL 优化的是”最好的那一步”。强化学习得到的东西主要通过价值网络发挥作用。
- 分布式版本的 AlphaGo 用了 1202 个 CPU 和 176 个 GPU。它在 2015 年 10 月以 5:0 击败欧洲冠军樊麾(论文 2016 年 1 月发表),2016 年 3 月在首尔以 4:1 击败李世石。第 2 局的第 37 手被很多职业棋手认为是人类不会下的一步;李世石唯一赢下的第 4 局,他的第 78 手也同样有名。
7.3 AlphaGo Zero:去掉人类棋谱
一年多以后的 AlphaGo Zero(Silver et al. 2017)把这套系统大大简化:
- 不用人类棋谱,从随机下棋开始,完全靠自我对弈;输入只有棋子的位置,不用人工设计的特征;
- 一个网络两个头:一个残差网络(第 13 讲 §3)同时输出走法的概率(策略头)和胜率(价值头);
- 不用快速走子:树搜索只靠这个网络;
- 把树搜索当作”老师”:搜索给出的走法分布比网络自己的输出更强,于是用交叉熵让策略头去拟合搜索的结果,用均方误差让价值头去拟合最后的胜负。下一轮的搜索又因为网络变强而更强——“策略改进”和”策略评估”交替进行。
训练 3 天(约 490 万盘自我对弈)后,它以 100:0 击败了战胜李世石的那个版本;训练 40 天的更大版本以 89:11 击败了 AlphaGo Master。后来的 AlphaZero 把同一套方法用在国际象棋和日本将棋上,MuZero 进一步连游戏规则都自己学。
7.4 启示
- 监督学习(模仿人类)是一个很好的起点,强化学习让它超越起点——这正是 §8 RLHF 的结构:先 SFT(模仿),再 RL。
- “学出来的直觉”(策略网络、价值网络)和”推理时的计算”(树搜索)互相增强。2024 年以后的”推理模型”让语言模型在回答前”想得更久”(§8.6),可以看作同一个思路在语言上的回响。
- 去掉人类数据之后反而更强:这是第 1 讲 §4.6 The Bitter Lesson 的又一个例子。但要注意它的前提——围棋有完美的模拟器(规则)和完全客观的奖励(输赢),自我对弈可以无限地产生数据。大多数现实问题没有这两样东西。
8. RLHF:强化学习与大语言模型 · RL from human feedback
8.1 为什么预训练 + SFT 还不够
第 1 讲 §3.6 说过,大语言模型的预训练是”预测下一个 token”——它学会的是模仿互联网上的文本,而不是”给出有帮助、诚实、无害的回答”。第一步改进是 SFT(supervised fine-tuning):请人写一批”好回答”,在上面继续做监督学习。但 SFT 有两个局限:
- 写一个好回答很贵,比较两个回答哪个更好要容易得多。
- “好回答”不是一个可以逐 token 打标签的东西,它是对整段回答的一个评价——这正是强化学习的设定:一个动作序列(整段回答)之后,得到一个评价性的分数。
所以 RLHF(reinforcement learning from human feedback)的思路是:用人的比较训练一个”打分器”(奖励模型),再用强化学习让语言模型去追求高分。这个想法最早在 Christiano et al. (2017) 里用于 Atari 和机器人模拟:只需要对不到 1% 的交互给人类反馈(大约一小时的人类时间),就能学会难以写出奖励函数的行为(比如让模拟机器人后空翻)。后来被用于文本摘要(Stiennon et al. 2020),再到 InstructGPT(Ouyang et al. 2022)和 ChatGPT。
8.2 三步走:SFT → 奖励模型 → RL
InstructGPT 的流程:
第 1 步  SFT:       人写的示范回答 ──监督学习──→ π_SFT
第 2 步  奖励模型:   对同一个问题,π_SFT 生成 K 个回答(K = 4 到 9),人排序
                     ──Bradley–Terry 损失──→ 奖励模型 r_φ(x, y)(论文用的是 6B 参数的模型)
第 3 步  RL:         用 PPO 优化  E[ r_φ(x, y) − β · log(π(y|x) / π_SFT(y|x)) ]
                     (KL 惩罚加在每个 token 上;PPO-ptx 版本还混入预训练的梯度)
论文里一个常被引用的结果:人们更喜欢 1.3B 参数的 InstructGPT 的回答,而不是 175B 的 GPT-3——参数少了 100 多倍。还有一个细节值得注意:论文把第 3 步的环境描述为一个 bandit 环境——给一个随机的问题,模型生成一个回答,奖励模型打一个分,回合结束。也就是说,在”整段回答”这个层面上,RLHF 就是一个巨大的多臂老虎机:每个可能的回答是一个”按钮”。这正是代码 03 用老虎机来讲 REINFORCE 的原因。
8.3 奖励模型:Bradley–Terry
人给出的是”回答 比 好”(w = win,l = lose)。Bradley–Terry 模型假设
两个回答的分数差越大,人越不会选错;分数差不多时接近抛硬币。训练奖励模型就是最大化这个似然:。如果 是特征的线性函数,这就是第 2 讲的逻辑回归:输入是两个回答的特征之差,标签是”人选了第一个”。注意只有分数的差有意义:所有分数加同一个常数,所有比较都不变(和 §6.3 的 baseline 是同一回事)。
代码 03 演示 3 造了一个玩具:2000 个候选回答(同一个问题的不同回答),每个用三个数描述——内容有多有用 、礼貌 、长度 (单位”百字”)。真实质量是
人喜欢有用、礼貌的回答;长度在 2.4 左右最好,太短说不清,太长啰嗦。参考策略(SFT 之后的模型)偏爱短回答,平均长度 1.34,给长度 > 3.5 的回答的总概率只有 0.009。从参考策略抽 1000 对回答,按 Bradley–Terry 模拟人的选择,训练一个线性的奖励模型 :
- 学到的权重: +0.974, +0.221, +0.319。
- 在另外 20,000 对(也来自参考策略)上预测人的选择:奖励模型猜对 0.737,“知道真实质量”的上限是 0.738。剩下的错误来自人类标签本身的随机性。从验证集上看,这是一个几乎完美的奖励模型。
但它学到了”越长越好”( 的权重为正)。按长度分组看(每组里所有候选回答的平均,两列都减去了参考策略下的平均):
| 长度 L | 候选个数 | 参考策略给的概率 | 代理奖励 | 真实质量 |
|---|---|---|---|---|
| 0–1 | 481 | 0.342 | −0.518 | −0.654 |
| 1–2 | 951 | 0.507 | −0.207 | −0.098 |
| 2–3 | 443 | 0.129 | −0.089 | −0.069 |
| 3–4 | 103 | 0.019 | +0.209 | −0.365 |
| ≥ 4 | 22 | 0.003 | +0.687 | −1.005 |
前三组两列一起上升;从 3–4 这一组开始分道扬镳:代理奖励继续升高,真实质量却在下降。线性模型表示不了”太长就啰嗦”,而参考策略几乎不写长回答,那里没有训练数据能纠正它。(这个玩具是有意设计成”奖励模型的函数族表示不了真实偏好”的,用来展示过度优化的一种机制;真实的奖励模型是一个大网络,它的错误来源更多样:有限的数据、标注者的偏差、分布外的外推。)
8.4 KL 惩罚与过度优化
现在用策略梯度去”讨好”这个奖励模型。代码 03 演示 4 的策略是 (从参考策略出发,只能沿三个特征的方向调整)。每步抽 64 条回答,每条的奖励是 ,用这一组的平均奖励当 baseline——“对同一个问题生成一组回答、和组内平均比”。GRPO(Shao et al. 2024,DeepSeekMath)、RLOO 这类方法估计优势也是这个思路(细节上有差别:GRPO 还会除以组内的标准差,RLOO 用”除了自己以外”的平均)。学习率 0.1,400 步。
先预测:(不加 KL 惩罚)时,代理奖励会一直涨。真实质量呢?
| 步数(β = 0) | 代理奖励 | 真实质量 | KL(π ‖ π_ref) | 平均长度 |
|---|---|---|---|---|
| 0 | 0.000 | 1.342 | 0.000 | 1.34 |
| 25 | 1.567 | 2.953 | 1.381 | 1.27 |
| 50 | 2.091 | 3.368 | 2.534 | 1.53 |
| 75 | 3.324 | 2.193 | 7.281 | 4.98 |
| 100 | 3.385 | 2.133 | 7.654 | 5.12 |
| 200 | 3.414 | 2.113 | 7.842 | 5.18 |
| 400 | 3.421 | 2.112 | 7.896 | 5.19 |
代理奖励一路上涨到 3.421;真实质量在第 50 步达到最高(3.368)之后往下掉,400 步时只剩 2.112。平均长度从 1.34 涨到 5.19:策略发现”写长”能刷高奖励模型的分数,一路写到了奖励模型最不懂的地方。这就是奖励模型的过度优化(reward model over-optimization):Goodhart 定律说”当一个指标变成了目标,它就不再是一个好指标”。
为什么偏偏落在最差的地方?演示 4 列出了奖励模型打分最高的 5 条回答:其中 3 条是真正的好回答,但第 1 名是一条长度 5.20 的回答,真实质量只有 2.112;400 步后策略把 99.0% 的概率押在了它身上。优化只关心”代理的最大值在哪里”,而代理的最大值往往恰好落在代理最不可靠的地方——那里数据最少、误差最大,“偏高的误差”最容易被挑中。这和 §5.6 DQN 的过估计是同一个统计现象:对带噪声的估计取最大值,挑出来的往往是被高估的那个。
KL 惩罚把策略拴在参考模型附近,不许它走到奖励模型没见过的地方:
| β | 代理奖励 | 真实质量 | KL | 平均长度 |
|---|---|---|---|---|
| 0 | 3.421 | 2.112 | 7.896 | 5.19 |
| 0.1 | 3.411 | 2.114 | 7.828 | 5.17 |
| 0.3 | 2.501 | 3.085 | 3.646 | 2.64 |
| 1 | 0.955 | 2.317 | 0.465 | 1.45 |
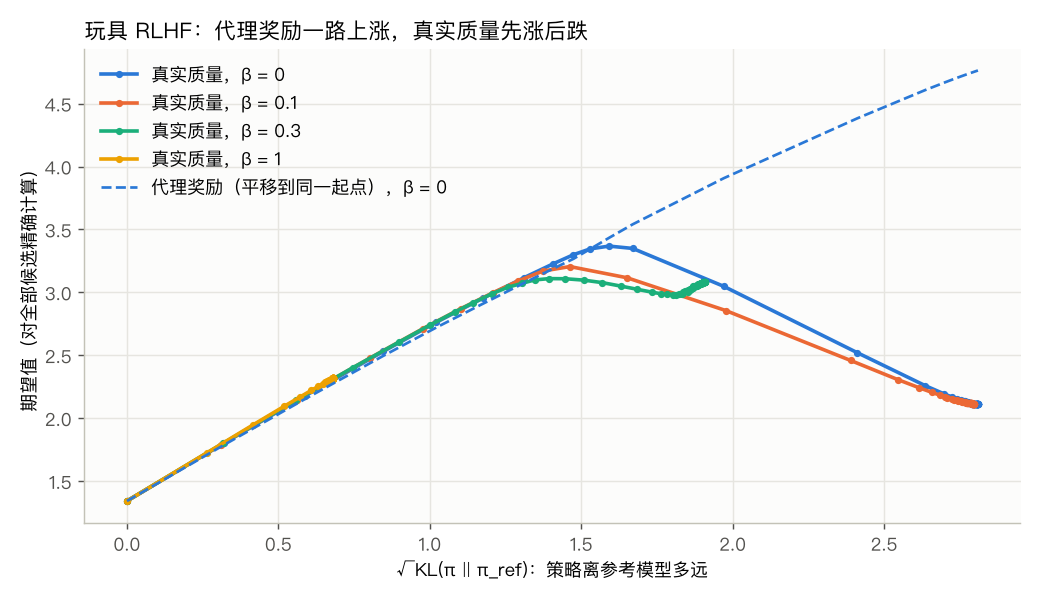
太弱,和不加差不多; 太强,策略走得不远,真实质量只提高到 2.317; 最好(3.085)。换 5 个种子(每个种子重新标注 1000 对、重新训练奖励模型、重新做策略梯度),400 步后的真实质量: 是 2.111(2.110–2.235),而它们各自轨迹上的最高点是 3.333(3.157–3.770),5/5 个种子都是先涨后跌; 是 3.052(2.729–3.432); 是 2.315(2.234–2.469)。
几点要记住:
- 要在真实质量上调,而真实质量正是我们拿不到的东西。实践中只能用留出的人类评估(或者用更强的模型当裁判)来监控和调节。
- 这个”先涨后跌”的形状在真实的大模型上也观察到了。Gao, Schulman & Hilton (2023) 用一个固定的 6B 奖励模型当”黄金标准”(代替人),训练 3M 到 3B 参数的代理奖励模型,再对代理做 best-of-n 采样或 RL:随着策略离初始模型越来越远(用 衡量),黄金分数先升后降,并且可以用简单的函数形式拟合(RL 的是 ,、 是拟合出来的常数)。上面这张图的横轴用 ,对应他们函数形式里的 。
- 实践中最常见的”钻空子”之一,正好就是回答越来越长:奖励模型(和人类标注者)往往偏爱更长、看起来更详尽的回答(Singhal et al. 2023)。
8.5 DPO:不需要显式 RL
带 KL 惩罚的目标 有一个闭式解(练习 8 让你推导):
右边说:最优策略本身就”藏着”一个奖励函数。Rafailov et al. (2023) 的 DPO(Direct Preference Optimization,论文副标题是 Your language model is secretly a reward model)把这个式子代进 Bradley–Terry, 在”两个回答的差”里抵消了,得到一个直接训练策略的损失:
不用训练单独的奖励模型,不用在训练中采样,就是在偏好数据上做一个类似分类的监督学习。代码 03 演示 4 (d) 在同一份偏好数据上按这个公式训练策略(log π 对全部候选做 softmax,用 L-BFGS 训练到收敛),和”奖励模型 + 闭式最优解”对比:
| β | 闭式解:真实质量 | KL | DPO:真实质量 | KL | max |βθ_DPO − w| |
|---|---|---|---|---|---|
| 3 | 1.690 | 0.055 | 1.690 | 0.055 | 1.4e−08 |
| 1 | 2.317 | 0.465 | 2.317 | 0.465 | 6.4e−08 |
| 0.3 | 3.097 | 3.700 | 3.097 | 3.700 | 4.6e−08 |
| 0.1 | 2.120 | 7.924 | 2.120 | 7.924 | 6.4e−08 |
| 0.03 | 2.112 | 7.968 | 2.112 | 7.968 | 4.6e−08 |
两者完全一样:DPO 学到的 就是奖励模型的 。在这个玩具里它们等价,是因为策略和奖励模型用了同一组特征(DPO 的损失只依赖 ,和训练奖励模型是同一个逻辑回归)。这也说明了一件常被忽略的事:DPO 并不能免于过度优化—— 小时,它同样把回答写到平均长度 5 以上,真实质量掉到 2.1 左右。在真实的大模型上,DPO 和 RLHF 的训练过程不同(DPO 不在训练中采样新回答,只用固定的偏好数据),两者谁好要看具体任务,实证结果各有胜负。
(还有一个对照:演示 4 的策略梯度在 时 400 步后的真实质量 3.085、KL 3.646,已经很接近闭式解的 3.097、3.700。)
8.6 可验证奖励与”推理模型”
奖励模型会被钻空子,那能不能不用它?有些任务的答案可以自动检验:数学题有标准答案,代码能跑单元测试。在这些任务上可以直接用规则打分——答对 +1、答错 0。2024 年 9 月 OpenAI 的 o1 介绍说,他们用大规模强化学习训练模型在回答前生成很长的”思维链”,并且性能随 RL 训练的计算量和推理时”思考”的时间都在提高。2025 年 1 月 DeepSeek 的 R1 论文更具体:R1-Zero 直接在基础模型上做强化学习、不先做 SFT,奖励只有两条规则(答案是否正确、格式是否符合要求),用的算法是 GRPO;他们明确说没有用神经网络的奖励模型,原因之一正是担心 reward hacking。这一类做法常被称为”可验证奖励的强化学习”(RL with verifiable rewards)。
回头看 §7.4:AlphaGo 有完美的规则和客观的输赢,所以能靠自我对弈不断变强;数学和代码是语言任务里最接近”有客观输赢”的领域,强化学习在这里进展最快,并非偶然。
9. 强化学习的实际难点 · RL in practice
- 样本效率低。DQN 每个游戏要 5000 万帧(约 38 天的游戏时间),人类玩几分钟就能上手。在模拟器里这还能接受,在真实世界里(机器人、医疗)往往不行。
- 奖励设计难。§1.4 的赛艇、§8.4 的长回答:模型优化的永远是你写下的奖励,不是你想要的东西。奖励稀疏时(Montezuma’s Revenge)又学不动。
- 模拟到现实(sim-to-real)。在模拟器里训练的策略,放到真实世界常常失效,因为模拟器和现实有差距。常见的对策是在模拟器里随机化各种参数(domain randomization),让策略见过足够多的”变体”。
- 不稳定、对种子敏感。代码 02 里同一个设置、不同的种子,2000 步时接住率从 0.334 到 0.816。Henderson et al. (2018) 系统地展示过:深度强化学习的结果在不同随机种子之间的差别,足以让两组”同一个算法”的运行看起来像两个不同的算法。所以报告多个种子、看中位数和范围是基本要求,只报告最好的一个种子是误导。
- 安全。智能体在学习过程中要”试”,而在现实世界里有些错误试不起;它找到的高分策略也可能是人没预料到的。
对你做项目的建议(延续第 10、11 讲的思路):如果你能拿到”正确答案”的标签,先用监督学习(或模仿学习:模仿专家的示范);强化学习适合”说不清怎么做,但能打分”的问题。先在一个很小的环境里把整个流程调通(像代码 01、02 这样),确认奖励设计没有漏洞,再放大;永远同时看代理奖励和你真正关心的指标。
10. 小结 · Summary
- 强化学习:智能体在环境里做动作、拿奖励,目标是让整个回合的折扣回报 最大。和监督学习的区别:没有标签只有评价性的奖励、奖励延迟(信用分配)、数据由策略自己收集(不是 i.i.d.)、必须探索。
- Bellman 最优方程 。走廊上手算的 Q-table(1、8.1、7.29、9、8.1、10)就是值迭代的不动点;+10 的消息每轮往回传一格,第 3 轮之前格子 1 还”以为”往左好。 是任务定义的一部分: 时最优策略变成往左; 是有效视野(第 8 讲的 )。
- Q-learning:,只要采样、不要模型;off-policy,随机乱走也能学到 。在随机环境里常数 留下误差底(0.467)——第 8 讲的噪声球。
- 探索 vs 利用:ε = 0 的机器人 20 个种子里只有 1 个找到 +10;ε 越大越容易找到,但训练期间拿到的回报越少;乐观初始化是另一种探索。难探索的游戏(Montezuma’s Revenge)DQN 得 0 分。
- DQN = 神经网络近似 Q + TD 目标当标签 + 叠帧 + 经验回放 + 目标网络 + Huber 损失 + ε 衰减。迷你 Breakout 上:完整 DQN 接住率中位数 1.000,去掉经验回放 0.472,只给 1 帧 0.472,去掉目标网络看不出影响(Atari 上它有用)。Q 估值 1.083 高于任何可能的回报 0.923:max 带来过估计(Double DQN)。函数近似 + 自举 + 异策略 = deadly triad。
- 策略梯度:,不需要模型、不需要奖励可导;softmax 策略时就是”把抽到的动作当标签的交叉熵 × 回报”。无偏但方差大;减 baseline 不改变期望(),老虎机上奖励加 10 时方差小 106 倍,不减 baseline 的 REINFORCE 10 个种子里只有 4 个选中最好的按钮。Actor-critic 用学出来的 当 baseline;PPO 限制每次更新离旧策略不太远。
- AlphaGo = SL 策略网络(人类棋谱)+ 自我对弈的 RL 策略网络 + 价值网络(每盘只取一个局面)+ MCTS;4:1 胜李世石。AlphaGo Zero 不用人类数据,一个网络两个头,以树搜索为老师,100:0 胜 AlphaGo Lee。
- RLHF = SFT → Bradley–Terry 奖励模型(就是一个逻辑回归)→ 带 KL 惩罚的 RL(InstructGPT 用 PPO)。在整段回答的层面它是一个 bandit。玩具实验里奖励模型在同分布上几乎完美(0.737 vs 上限 0.738),但 时代理奖励一路涨到 3.421,真实质量在 3.368 见顶后跌到 2.112(回答越写越长)——过度优化;KL 惩罚 时 3.085。DPO 把闭式解 代进 Bradley–Terry,直接训练策略;玩具里它和 RLHF 的最优解完全一样,也同样会过度优化。可验证奖励的 RL 是”推理模型”的关键训练方法。
11. 常见误区 · Common pitfalls
- “强化学习就是没有标签的监督学习。” 不只是没有标签:奖励是延迟的(信用分配),数据由策略自己收集(分布随策略变、相邻样本相关),还必须探索(§1.3)。这三点让它比监督学习难得多。
- “奖励越简单直接越好,模型会明白我的意思。” 模型优化的是你写下的奖励,不是你的意思(§1.4 的赛艇、§8.4 的长回答)。奖励设计本身就是项目里最难的部分之一。
- “γ 只是一个让和收敛的技术参数,取 0.99 就行。” 改变的是”什么是最优行为”(§2.5:0.31 和 0.32 的最优策略不同)。它也决定了有效视野,取值要和任务的时间尺度匹配。
- “Q 值就是期望回报,可以直接拿来汇报。” DQN 的 Q 值系统性偏高(§5.6:1.083 vs 0.923)。要知道策略有多好,就让它真的去跑、统计实际的回报。
- “在小问题上没看出作用的技巧,在大问题上也没用。” 代码 02 里目标网络看不出作用,Atari 上它是关键零件(§5.4、§5.5)。反过来,在玩具上有效的技巧也不保证能放大。
- “REINFORCE 有 baseline 会引入偏差。” 只要 baseline 不依赖当前的动作,期望就不变(§6.3 的推导)。依赖动作的 “baseline” 才会引入偏差。
- “只报告一个种子的结果就够了。” 强化学习对种子非常敏感(代码 02:同一设置 2000 步时 0.334–0.816)。至少报告几个种子的中位数和范围(§9)。
- “奖励模型在验证集上准确率很高,所以可以放心地优化它。” 验证集来自参考策略的分布;优化会把策略推到奖励模型没见过的地方(§8.4:验证上 0.737 几乎完美,优化后真实质量却下降)。
- “DPO 不做 RL,所以不会钻奖励的空子。” DPO 优化的是同一个带 KL 惩罚的目标, 小时同样会过度优化(§8.5)。
- “AlphaGo 证明了强化学习可以从零学会任何东西。” AlphaGo Zero 依赖完美的模拟器(规则)和客观的输赢,可以无限自我对弈。现实问题大多没有这两样东西,样本效率和奖励设计才是瓶颈(§7.4、§9)。
12. 练习 · Exercises
练习 1(手算 Q-table)。把走廊左端的奖励从 +1 改成 +2(更接近 2018 年课上的例子),其余不变(5 格,起点格子 1,右端 +10,)。(a) 写出三个非终点状态的 。(b) 最优策略是什么?(c) 小于多少时,格子 1 的最优动作变成往左?
参考答案
(a) 往右的一侧不变:,,。。,。和原来只差 一个数。
(b) 仍然一路往右(8.1 > 2)。
(c) 令 ,。可以在 01_q_learning.py 里把 Corridor() 改成 Corridor(r_left=2.0) 验证。
练习 2(Q-learning 一步)。走廊上,当前 ,,,,。(a) 机器人在格子 2 往右走到格子 3,奖励 0。TD 目标是多少?更新后的 是多少?(b) 接着在格子 3 往右走进回收站(+10,结束)。更新后的 是多少?(c) 为什么 (b) 的目标里没有 那一项?
参考答案
(a) ;。
(b) ;。
(c) 回合结束了,没有”下一个状态”,未来的回报是 0。代码里写成 target = r if done else r + gamma * Q[s2].max();DQN 里写成 (1 − done) 乘在后一项上。忘了处理终点,是写强化学习代码最常见的 bug 之一:网络会以为游戏结束之后还有奖励。
练习 3(DQN 的目标与 Huber 损失)。Catch 里某个转移:,动作 (不动),,没有结束,目标网络给出 ,。(a) 算 TD 目标 、误差 和 Huber 损失(: 时 ,否则 )。(b) 另一个转移:动作 ,球落地、接住了(,结束),。算 和 Huber 损失。和平方误差 相比,Huber 对 的梯度有什么不同?
参考答案
(a) ,误差 ,Huber (误差小,和平方误差一样)。
(b) 结束了,,误差 ,Huber 。梯度大小:Huber 是 1(被”裁剪”了),平方误差 是 1.1。误差越大差别越明显——这就是 Nature DQN 论文”把误差项裁剪到 [−1, 1]“的意思,防止一个异常大的 TD 误差把网络推得太远。
练习 4(折扣与有效视野)。(a) ,奖励序列 , 是多少?(b) 计算 和 ,和 比较。这和第 8 讲 §3.3 的哪个结论是同一件事?(c) 一个游戏每局约 1000 步,最后才有奖励。 合适吗?
参考答案
(a) 。
(b) ,,都接近 。第 8 讲:指数加权平均”约等于最近 天的平均”,因为 。这里是同一个算式, 是有效视野。
(c) 不合适。 约是 ,开局时最后的奖励几乎被折没了,前面的决定得不到任何信号。需要 接近 1(比如 0.999,有效视野约 1000 步),或者设计一些中间奖励(但要小心 §1.4 的钻空子)。
练习 5(推导:baseline 不改变期望)。(a) 证明对任何不依赖动作的 ,。(b) 如果用依赖动作的 (比如 的估计),为什么就不行了?(c) 对 softmax 策略 ,验证 。
参考答案
(a) 。
(b) 不能提到求和外面, 一般不为 0,估计就有偏了。极端情况 时 ,梯度永远是 0,什么也学不到。
(c) ,,相减为 0。这也是代码 03 演示 1 里”减了 baseline 平均值不变”的原因。
练习 6(手算一步 REINFORCE)。3 个按钮,(每个概率 1/3),抽到第 3 个按钮,奖励 ,学习率 0.1。(a) 算 。(b) 不减 baseline, 的更新量是多少?(c) 减去 baseline 呢?更新后三个按钮的概率是多少?(d) 如果 (低于 baseline),(c) 的更新方向会怎样?
参考答案
(a) 。
(b) 。
(c) 。新的概率 。
(d) ,更新量是 :第 3 个按钮的概率被压低。不减 baseline 时,只要 ,抽到的按钮总被推高——这就是演示 2 里”锁死”的原因。
练习 7(Bradley–Terry)。奖励模型给两个回答打分 、。(a) 模型认为人选回答 1 的概率是多少?(b) 人确实选了回答 1,这一对的损失 是多少?如果人选了回答 2 呢?(c) 两个分数都加 5,(a)(b) 的答案会变吗?(d) 损失对 的导数是多少?(提示:第 2 讲交叉熵的梯度。)
参考答案
(a) 。
(b) 选 1:;选 2:。
(c) 不变:只有分数的差有意义。所以奖励模型的分数没有”绝对零点”,RLHF 里常常要把它归一化,或者像代码 03 那样减去一组回答的平均。
(d) :梯度下降会把 推高、 压低,推多少取决于模型现在”有多不确定”——和第 2 讲 一模一样。
练习 8(推导:带 KL 惩罚的最优策略)。(a) 对有限个回答 ,在 的约束下最大化 ,证明最优解是 。(提示:拉格朗日乘子,对 求导令其为 0。)(b) 三个回答,,。分别算 和 时的 和 。(c) 时 KL 趋向多少?它和 给最好回答的概率有什么关系?
参考答案
(a) 拉格朗日函数 。对 求导:,所以 ,即 ,常数由归一化决定。
(b) :权重 ,归一化得 ,期望奖励约 1.350,KL 约 0.323。:,期望奖励约 2.000,KL 约 1.609。
(c) 时策略把全部概率放在奖励最高的回答上,KL 。代码 03 里 时 KL 停在 7.9 左右,也是同一个原因:参考策略给奖励模型的第 1 名的概率很小,KL 的上限就是它的 。
练习 9(改代码,先预测再运行)。代码 03 的奖励模型是线性的,表示不了”太长就啰嗦”。在 make_answer_world 的返回值里把特征改成 np.stack([h, p, L, L ** 2], axis=1)(多一个”长度平方”特征),并在 FEATURES 里加一个名字 "长度平方 L²"。先预测:(a) 奖励模型在同分布测试对上的准确率会变吗?(b) 时还会”先涨后跌”吗?5 个种子都一样吗?然后运行验证。
参考答案
预期趋势(具体数字以你运行的结果为准):(a) 几乎不变——原来的准确率已经接近上限,在参考策略常见的长度范围里,线性和二次差别不大。这再次说明”验证集上的准确率”看不出奖励模型在分布外对不对。(b) 奖励模型现在能学到”长度平方”的权重为负,它的最大值不再落在超长的回答上, 的终点真实质量会高得多,接近最好的那几条回答;但它仍然是从有限的、主要是短回答的数据里估出来的,训练途中策略可能先往长回答冲一段再回来,而且不同种子的结果可能差别很大(有的种子仍然可能停在很差的地方)。修正奖励模型的函数族能去掉这一种钻空子的方式,但去不掉”对有限数据估出来的代理求最大值”这件事本身的风险——这就是为什么真实的 RLHF 里 KL 惩罚几乎总是保留的。
练习 10(AlphaGo 与经验回放)。AlphaGo 训练价值网络时,从每盘自我对弈的棋里只取一个局面。(a) 如果把每盘棋的所有局面(约 150 个)都拿来训练,会出什么问题?(b) 这和 DQN 的经验回放要解决的问题有什么共同点?(c) 这样做浪费了很多数据,AlphaGo 为什么还是这样做?
参考答案
(a) 同一盘棋相邻的局面只差一两颗子,标签(这盘最后谁赢)完全相同。网络很容易记住”长得像这一盘的局面 → 这个结果”,而不是学会判断局面本身,在训练集上很好、在新棋局上很差——第 6 讲的过拟合。
(b) 都是”样本之间高度相关”:DQN 里是同一局游戏里连续的帧,AlphaGo 里是同一盘棋里连续的局面。监督学习的方法默认样本是 i.i.d. 的,强化学习产生的数据天然不是,所以要想办法打散。
(c) 因为自我对弈可以几乎无限地产生新棋局(有完美的模拟器),数据不是瓶颈,相关性才是。论文用 3000 万盘不同的棋、每盘一个局面。在数据昂贵的问题里,就得用别的办法(比如随机抽样的回放池、正则化)。
13. 延伸阅读 · Further reading
课程与教材
- CS230 Autumn 2018 Lecture 9 “Deep Reinforcement Learning”(Kian Katanforoosh,YouTube,Stanford Online 频道)——本讲对应的课堂录像。
- Sutton & Barto (2018). Reinforcement Learning: An Introduction(第 2 版,作者网站免费提供)。第 3 章(MDP 与 Bellman 方程)、第 6 章(TD 学习与 Q-learning)、第 11.3 节(deadly triad)、第 13 章(策略梯度、REINFORCE、actor-critic)。
- Stanford CS234 Reinforcement Learning;OpenAI Spinning Up in Deep RL(在线教程,代码清晰,适合本讲之后动手)。
- Lambert, Reinforcement Learning from Human Feedback(在线书,rlhfbook.com)——RLHF 的系统介绍。
价值方法与 DQN
- Watkins (1989). Learning from delayed rewards. PhD thesis, Cambridge;Watkins & Dayan (1992). Q-learning. Machine Learning.
- Mnih et al. (2013). Playing Atari with deep reinforcement learning. NIPS Deep Learning Workshop.
- Mnih et al. (2015). Human-level control through deep reinforcement learning. Nature. ——§5.3 的设置和 §5.4 的对照实验都在这里(Extended Data Tables 1–3)。
- van Hasselt, Guez & Silver (2016). Deep reinforcement learning with double Q-learning. AAAI.
- Hessel et al. (2018). Rainbow: Combining improvements in deep reinforcement learning. AAAI.
- Badia et al. (2020). Agent57: Outperforming the Atari human benchmark. ICML.
- Bellemare et al. (2016). Unifying count-based exploration and intrinsic motivation. NeurIPS;Burda et al. (2019). Exploration by random network distillation. ICLR;Ecoffet et al. (2021). First return, then explore. Nature.
策略梯度
- Williams (1992). Simple statistical gradient-following algorithms for connectionist reinforcement learning. Machine Learning. ——REINFORCE。
- Mnih et al. (2016). Asynchronous methods for deep reinforcement learning. ICML. ——A3C。
- Schulman et al. (2015). Trust region policy optimization. ICML;Schulman et al. (2017). Proximal policy optimization algorithms. arXiv.
AlphaGo
- Silver et al. (2016). Mastering the game of Go with deep neural networks and tree search. Nature.
- Silver et al. (2017). Mastering the game of Go without human knowledge. Nature. ——AlphaGo Zero。
- Silver et al. (2018). A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play. Science. ——AlphaZero;Schrittwieser et al. (2020). Mastering Atari, Go, chess and shogi by planning with a learned model. Nature. ——MuZero。
RLHF 与大语言模型
- Christiano et al. (2017). Deep reinforcement learning from human preferences. NeurIPS.
- Stiennon et al. (2020). Learning to summarize from human feedback. NeurIPS.
- Ouyang et al. (2022). Training language models to follow instructions with human feedback. NeurIPS. ——InstructGPT。
- Rafailov et al. (2023). Direct preference optimization: Your language model is secretly a reward model. NeurIPS.
- Gao, Schulman & Hilton (2023). Scaling laws for reward model overoptimization. ICML.
- Singhal, Goyal, Xu & Durrett (2023). A long way to go: Investigating length correlations in RLHF. ——RLHF 里”回答变长”有多少来自奖励模型对长度的偏好。
- Shao et al. (2024). DeepSeekMath: Pushing the limits of mathematical reasoning in open language models. ——GRPO;DeepSeek-AI (2025). DeepSeek-R1: Incentivizing reasoning capability in LLMs via reinforcement learning.
- OpenAI (2024). Learning to reason with LLMs.(博客,o1)
难点与反思
- Clark & Amodei (2016). Faulty reward functions in the wild.(OpenAI 博客)
- Henderson et al. (2018). Deep reinforcement learning that matters. AAAI.
14. 下一讲预告 · Next lecture
这一讲从一个 5 格的走廊出发,走到了 DQN、AlphaGo 和 RLHF。最后一站——RLHF——把强化学习和大语言模型连在了一起:今天的聊天模型大多经过了”预训练 → SFT → 偏好优化”这条流水线。
第 20 讲:超越模型——增强 LLM 应用(对应 Fall 2025 Lecture 8)。有了一个训练好的大语言模型,怎样把它用好?你会看到:
- prompting 与 few-shot:不训练任何参数,只靠提示词让模型完成任务;
- RAG(检索增强):让模型在回答前先去查资料;
- 工具调用与 agentic workflows:让模型分步骤地规划、使用工具、检查自己的结果——某种意义上,这是把语言模型当作一个在环境里行动的”智能体”;
- 微调、提示、检索各在什么时候用,以及怎样评估一个 LLM 应用、做误差分析(把第 10 讲的方法用到 LLM 系统上)。
本讲 §8 的教训在那里同样适用:你优化什么指标,就会得到什么;离开了你真正关心的评估,任何代理分数都可能被”钻空子”。