对应 Maps to:Coursera Deep Learning Specialization C5M2 “Natural Language Processing & Word Embeddings”(Word Representation、Using Word Embeddings、Properties of Word Embeddings、Embedding Matrix、Learning Word Embeddings、Word2Vec、Negative Sampling、GloVe Word Vectors、Sentiment Classification、Debiasing Word Embeddings)和 C5M3 “Sequence Models & Attention Mechanism”(Basic Models、Picking the Most Likely Sentence、Beam Search、Refinements to Beam Search、Error Analysis in Beam Search、Bleu Score、Attention Model Intuition、Attention Model、Speech Recognition、Trigger Word Detection);编程作业 “Operations on Word Vectors”(余弦相似度、类比、neutralize / equalize)、“Emojify”(平均词向量 vs LSTM)、“Neural Machine Translation with Attention”(人写日期 → YYYY-MM-DD,可视化注意力)、“Trigger Word Detection”。在 Fall 2025 的安排里,C5M2、C5M3 和第 9 次课堂讲座(11/18)在同一周。另外参考了两份 Fall 2017 CS230 公开课件:Lecture 8 “Word2Vec applications + Recurrent Neural Networks with Attention”(课程网站上的 Handout 8)和 Lecture 10 “Sequence models II”(BLEU、beam search、CTC 语音识别;Handout 10)。 依据说明:Coursera 的视频和编程作业只对注册学员开放。本讲依据 Andrew Ng 在 C5M2、C5M3 里广为人知的讲法和例子来写(orange juice / apple juice、Sally Johnson is an orange farmer、“I want a glass of orange ”、“Completely lacking in good taste…”、“Jane visite l’Afrique en septembre”、beam 宽度 3 的走法、“the cat is on the mat”、“ttt_h_eee _qqq”),视频里的具体讲法是凭记忆复述的,细节可能和原视频略有出入。Fall 2017 的两份课件是公开的 PDF。技术细节一律以原始论文为准(Mikolov et al. 2013a/b;Bengio et al. 2003;Pennington et al. 2014;Bolukbasi et al. 2016;Sutskever et al. 2014;Cho et al. 2014;Bahdanau et al. 2015;Papineni et al. 2002;Graves et al. 2006;Xu et al. 2015;Vinyals et al. 2015),见 §15。原作业用 TensorFlow / Keras,本讲义用 numpy(词向量从零实现)和 PyTorch(seq2seq)。本讲的顺序和 Coursera 略有不同:先讲注意力(§8),再讲 beam search 和 BLEU(§9–§10),因为后两者要在一个训练好的翻译模型上演示。 配套代码 Code:
code/lecture16/(numpy + PyTorch;5 个脚本 + 5 个模块。01 约 30 秒,02 约 10 秒,03 约 5 秒,04 约 55 秒,05 约 25 秒;04、05 有--quick) 预计阅读时间:3.5–4 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说清 one-hot 表示的问题(任意两个词的内积都是 0,模型没法从 orange juice 推广到 apple juice),以及词嵌入(word embedding)怎样解决它;知道嵌入矩阵 乘 one-hot 就是”取一行”,所以实际中用查表。
- 用余弦相似度做类比推理(),知道”排除题面词”这个细节、t-SNE 图上为什么不该找平行四边形。
- 推导 skip-gram + 负采样的损失和梯度(就是 个逻辑回归),说出 、、窗口大小各自的作用;写出 GloVe 的损失和加权函数 。
- 用预训练词向量做迁移学习(三步),解释”平均词向量”做情感分类为什么学不会否定,以及小数据上为什么不要微调词向量。
- 说出词向量里的偏见从哪里来,会用 neutralize / equalize 去偏,并知道它的局限(Gonen & Goldberg 2019)。
- 把机器翻译写成条件语言模型 ;讲清编码器-解码器在长句子上的瓶颈,以及 Bahdanau 注意力的三步(打分 → softmax 得 → 加权平均得上下文 )。
- 实现 beam search(含长度归一化),用 与 做 beam search 的误差分析;从零实现 BLEU(修正精确率、裁剪、几何平均、简短惩罚);说出 CTC 的折叠规则。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开 Previewed only |
|---|---|
第 15 讲:RNN 的参数共享;many-to-one / many-to-many / one-to-many;语言模型与采样;梯度消失与梯度裁剪;GRU / LSTM 的门控直觉;双向与深层 RNN。本讲直接用 PyTorch 的 nn.GRU / nn.LSTM | 自注意力、Q / K / V、多头、Transformer(第 17 讲) |
第 9 讲 §3:softmax、交叉熵、log-sum-exp;§4:PyTorch 训练循环(torch_utils) | 预训练语言模型、BERT / GPT 式的上下文相关词向量(第 17、20 讲) |
| 第 10 讲:单一数字评估指标(§2)、误差分析(§6)、迁移学习(§9);第 13 讲 §7:冻结与微调 | CTC 的前向-后向动态规划(§11 只讲折叠规则和”把对齐加起来”) |
| 第 5 讲 §1.4、§3:编码 / embedding、triplet loss 人脸编码;§5:触发词检测的标签设计 | 语音识别的完整流水线、语言模型融合 |
| 第 2 讲:逻辑回归和它的梯度 | 可解释性:注意力权重算不算”解释”(第 21 讲) |
第 15 讲讲的是”一个 RNN 怎样读一个序列”;本讲讲三件事:词怎样变成向量(§1–§6),怎样把一个序列翻译成另一个序列(§7–§8),以及怎样从模型里挑出最好的输出、怎样给它打分(§9–§11)。新的机制——负采样的梯度、GloVe、去偏、注意力、beam search、BLEU、CTC 的折叠——都在本讲的代码里从零写出来。
0.3 本讲地图 Map
§1  词的表示:one-hot 的问题;特征化表示;可视化                    ← 代码 01 演示 1
§2  使用词嵌入:命名实体识别;迁移学习三步;和人脸编码的区别          ← 代码 02 演示 2
§3  性质:类比推理;余弦相似度;平行四边形                          ← 代码 01 演示 3
§4  学习词嵌入:嵌入矩阵;神经语言模型;skip-gram;负采样;
    窗口与 k;GloVe                                                ← 代码 01 演示 1、2、4、5
§5  情感分类:平均词向量 vs LSTM;为什么平均法学不会否定            ← 代码 02
§6  偏见与去偏:找方向;neutralize;equalize;局限                  ← 代码 03
§7  序列到序列:编码器-解码器;图像描述;条件语言模型
§8  注意力模型:长句子的问题;α 和上下文向量;日期翻译;可视化       ← 代码 04
§9  挑最可能的句子:贪心 vs beam search;B 的取舍;长度归一化;
    beam search 的误差分析                                          ← 代码 05 演示 1、2、3、5
§10 BLEU:修正精确率、裁剪、几何平均、简短惩罚                      ← 代码 05 演示 4、5
§11 语音识别与触发词检测:频谱;CTC;触发词(回顾第 5 讲)           ← 代码 05 演示 6
§12–16  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,补充本讲新增的)
| 符号 | 含义 | 例子 |
|---|---|---|
| (或 ) | 词表大小 | Ng 的例子 10,000;我们的语料 323 |
| 词 的 one-hot 向量 | = orange | |
| 词 的词向量(嵌入); 是维数 | Ng 用 300 维;代码里 50 维 | |
嵌入矩阵。Ng 的视频里是 ,;代码里按 PyTorch 的习惯存成 , = E[w] | ||
| ; | skip-gram 里的 context(输入词)和 target(要预测的附近的词), 是 的”输出向量”。注意:Mikolov 的论文里叫法正好相反(输入叫 center word) | (orange, juice) |
| 负采样时每个正样本配几个负样本 | 5 | |
| ; | 共现次数:词 出现在词 附近的次数;GloVe 的加权函数 | |
| ,;, | 输入 / 输出序列的第 个元素;输入 / 输出的长度(第 15 讲的记号) | 日期任务 |
| 编码器在输入位置 的”注解”(双向 RNN 两个方向的激活拼起来) | ||
| 解码器在输出位置 的隐藏状态 | ||
| ,, | 注意力的打分、注意力权重(对 做 softmax)、上下文向量 | |
| beam 宽度(beam width) | 3、10 | |
| ;BP | 修正的 -gram 精确率;简短惩罚(brevity penalty) |
三个 α 撞名了:学习率 (第 1 讲)、注意力权重 (§8)、长度归一化的指数 (§9.4)。Ng 的视频里就是这样用的,本讲出现时都会写明是哪一个。另外 也有两个意思:词向量 (下标是词)和注意力打分 (上标是位置)。
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出(固定种子,CPU 单线程,同一台机器上重复运行逐字相同,没有计时类的数字)。所有数据都是合成的:词向量的语料是用模板拼出来的 60,000 句话(word_world.py),语义结构(性别、首都、比较级、职业的性别关联、好评 / 差评词)是写进去的;日期和”伪法语”翻译也都是代码生成的(seq_worlds.py)。所以我们知道”真相”,能检查模型学到了什么;但数字只说明机制,比真实任务干净得多(比如类比准确率 0.991,真实词向量远没有这么高)。有不少结果和我写代码前的预想不一样(最重要的两处:平均词向量学会了 “lacking in”,却学不会 “not”;长度归一化在干净数据上反而有害),讲义按实际结果来写,这些情况都列在代码 README 的”关于实验结果”里。
1. 词的表示 · Word representation
1.1 one-hot 的问题
第 15 讲的 RNN 读的是 one-hot 向量:词表有 个词,词 就是一个长度 的向量 ,只有第 个位置是 1。它简单、不需要学,但有一个根本的问题。先想一想: 和 的内积是多少? 和 呢?
代码 01 演示 1 在我们的词表()上算了一下:
| 词对 | 内积 | 余弦相似度 | 欧氏距离 |
|---|---|---|---|
| orange – apple | 0 | 0.000 | 1.414 |
| orange – king | 0 | 0.000 | 1.414 |
| man – woman | 0 | 0.000 | 1.414 |
任何两个不同的 one-hot 向量都正交、距离都是 。在模型眼里,orange 和 apple 的距离,跟 orange 和 king 的距离一模一样。Ng 的例子:语言模型学会了”I want a glass of orange juice”,看到”I want a glass of apple ___“时,它没有任何理由猜 juice——apple 的 one-hot 向量和 orange 毫无共同之处,在 orange 上学到的东西一点也推广不过来。
1.2 特征化的表示
换一种表示:给每个词打一组”特征分”。Ng 在视频里画了一张表(下面是仿照它写的示意数字,不是学出来的):
| Gender | Royal | Age | Food | |
|---|---|---|---|---|
| man | −1.00 | 0.01 | 0.03 | 0.04 |
| woman | 1.00 | 0.02 | 0.02 | 0.01 |
| king | −0.95 | 0.93 | 0.70 | 0.02 |
| queen | 0.97 | 0.95 | 0.69 | 0.01 |
| apple | 0.00 | −0.01 | 0.03 | 0.95 |
| orange | 0.01 | 0.00 | −0.02 | 0.97 |
现在 orange 和 apple 的余弦相似度是 0.999——模型在 orange 上学到的”后面接 juice”,可以推广到 apple 上。而且 ,,两个差向量的余弦相似度是 1.000:“男 → 女”这层关系在两对词上是同一个向量。这就是 §3 类比推理的来源。
真实的词向量有 50–300 维,但我们不会手写这些特征,而是从大量文本里学出来(§4)。学出来的每一维通常没有”性别""食物”这样可以解释的含义:Ng 在讲 GloVe 时指出,把所有词向量乘以任意一个可逆矩阵 (同时把输出向量乘以 ),损失完全不变,所以坐标轴的方向是任意的;有意义的是方向和距离,不是单独的某一维。
1.3 “嵌入”这个名字,以及怎样画出来
把 10,000 个词”嵌”进一个 300 维的空间,每个词是空间里的一个点,所以叫词嵌入(word embedding)。人看不了 300 维,常用 t-SNE(van der Maaten & Hinton, 2008)把它压到二维画出来:水果聚成一团、数字聚成一团、人物聚成一团。
但要知道 t-SNE 是非线性的:它努力保留”谁和谁是邻居”,却不保留距离和方向。所以在 t-SNE 图上找不到平行四边形,也不该在上面推断类比。想看线性结构,要用线性投影。代码 01 画了一张(figures/lecture16_embedding_pca.png):左图把 man、woman、king、queen 投到”性别方向”和”王室方向”两个轴上,右图用 PCA 的前两个主成分画国家 → 首都:
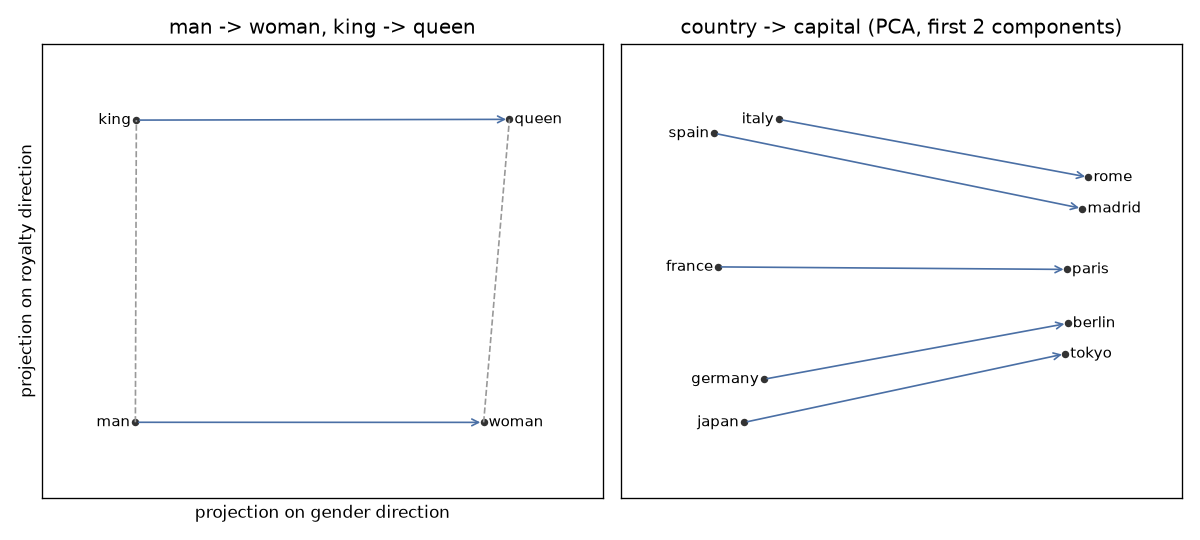
(这张图由 01_word_vectors.py 生成;没装 matplotlib 时只打印表格。)
2. 使用词嵌入 · Using word embeddings
2.1 一个例子:命名实体识别
Ng 用的例子:从”Sally Johnson is an orange farmer”里认出人名。如果训练集里有这句话,模型看到”Robert Lin is an apple farmer”时,靠词向量知道 apple 和 orange 很像,很容易猜对 Robert Lin 是人名。更难的是”Robert Lin is a durian cultivator”——durian(榴莲)和 cultivator(种植者)可能根本没出现在你那几千句标注数据里。但如果词向量是在几十亿个词的无标签文本上学的,它见过 durian,知道 durian 是一种水果、cultivator 和 farmer 很像。
2.2 迁移学习的三步
这就是第 10 讲 §9 的迁移学习用在文字上:
- 在一个很大的文本语料上学词向量(Ng 说的是 10 亿到 1000 亿个词),或者直接下载别人训练好的(word2vec、GloVe 都公开了训练好的向量);
- 把词向量迁移到只有少量标注数据的新任务上(比如 10 万个词的训练集),用它代替 one-hot 作为输入——维数也从 10,000 降到 300;
- (可选)如果新任务的数据足够多,再跟着任务一起微调词向量。
第 3 步为什么是”可选”、而且只在数据多时才做?代码 02 有一个直接的答案。我们在 01 的无标签语料上训练好词向量,然后做一个只有 800 条训练数据的情感分类。训练集里只出现 8 个情感词(good、great …… bad、awful ……);测试集另用 8 个训练集里从没出现过的情感词(excellent、superb …… terrible、dreadful ……)。在”没见过的情感词”上,LSTM 分类器的准确率(普通句子,§5 详细讲):
| 词向量 | 没见过的情感词 · 普通句 |
|---|---|
| 预训练、冻结 | 1.000 |
| 预训练、跟着微调 | 0.545 |
| 随机初始化、从零学 | 0.675 |
- 冻结的预训练词向量完美地推广到了没见过的词:superb 从来没出现在 800 条训练数据里,但它的向量和 great、good 在”好评 − 差评”的方向上站在同一边(02 演示 1)。
- 小数据上微调反而更糟,比随机初始化还差:微调只移动了训练集里出现过的那 8 个词的向量,没见过的词留在原地,两者”错开”了。这正是 Ng 说”新任务数据少时不要微调”的原因,和第 13 讲 §7 冻结卷积底座是同一个道理。
2.3 和人脸编码的区别
第 5 讲 §3 的人脸编码器也是”把输入变成一个向量”。区别在于:人脸编码器是一个函数,任何一张没见过的脸都能编码;词嵌入是一张查找表,只有词表里的 个词有向量,表外的词(unknown,常记为 <UNK>)只能共用一个向量。Ng 在视频里专门提了这一点。后来的子词(subword)切分和上下文相关的词向量(第 17、20 讲)在很大程度上解决了这个问题。
3. 词嵌入的性质:类比 · Properties of word embeddings
3.1 man 之于 woman,如同 king 之于 ?
Mikolov, Yih & Zweig (2013) 发现,学出来的词向量能回答类比题:“man 之于 woman,如同 king 之于 ?”。做法正是 §1.2 那张表的直觉:如果 ,那么答案的向量应该接近 。在所有词里找最接近它的:
3.2 余弦相似度
“接近”用余弦相似度衡量:
方向相同为 1,垂直为 0,相反为 −1。为什么不直接用内积或欧氏距离?因为词向量的长度和词频有关(常见的词向量往往更长),而我们关心的是”方向像不像”。Ng 也提到可以用欧氏距离的平方衡量”不像”,但余弦相似度更常用。Coursera 作业 “Operations on Word Vectors” 的第一个函数就是它。
3.3 实验:几乎全对,但别太当真
代码 01 演示 3 在我们学到的 50 维词向量上做类比(§4 讲怎么学的):
| 类比题 | 前 3 个答案(余弦相似度) |
|---|---|
| man : woman :: king : ? | queen 0.977、princess 0.754、prince 0.680 |
| man : boy :: queen : ? | princess 0.836、king 0.742、prince 0.710 |
| france : paris :: japan : ? | tokyo 0.913、athens 0.831、madrid 0.829 |
| france : french :: germany : ? | german 0.886、spanish 0.760、russian 0.757 |
| big : bigger :: small : ? | smaller 0.761、louder 0.642、slower 0.642 |
按”关系”统计 top-1 准确率(必须恰好猜中那个词才算对):
| 性别(72 题) | 平民→王室(12) | 大人→小孩(30) | 国家→首都(90) | 国家→语言(90) | 原级→比较级(56) | 全部 | |
|---|---|---|---|---|---|---|---|
| skip-gram + 负采样 | 1.000 | 0.750 | 1.000 | 1.000 | 1.000 | 1.000 | 0.991 |
| 随机向量(对照) | 0.000 | 0.000 | 0.000 | 0.011 | 0.000 | 0.000 | 0.003 |
几个要点:
- 对照组:随机向量只有 0.003,所以 0.991 不是”类比题本身太容易”。
- 别太当真:我们的语料是模板拼出来的,关系极其干净。Ng 在视频里说,研究论文在真实词向量上报告的类比准确率大约在 30% 到 75% 之间。
- 一个容易忽略的细节:排除题面词。 离 本身往往最近(差向量比词向量短),所以标准做法是不许回答 a、b、c 三个题面词。不排除的话,准确率从 0.991 掉到 0.923。§6.4 会看到,这个细节对”词向量里的偏见”的讨论很重要。
- 错的 3 道题全在”平民 → 王室”:man : king :: girl : ? 答 queen(应为 princess)——“王室”和”年龄”两个方向在这几个词上纠缠在一起。
3.4 平行四边形
“同一种关系 ≈ 同一个方向”可以直接量:把性别关系的 9 对词的差向量 、 …… 两两算余弦相似度,平均是 0.874;国家 → 首都的 10 个差向量是 0.840;随机 10 对词的差向量只有 −0.001。§1.3 的图就是这几个差向量的线性投影。
4. 学习词嵌入 · Learning word embeddings
4.1 嵌入矩阵
把所有词向量排成一个矩阵 。Ng 的写法里 是 ,第 列是词 的向量,于是
——一个矩阵乘一个 one-hot,结果就是取出第 列。这个式子方便推导(它说明”嵌入层”就是一个没有偏置、没有激活的线性层,可以用反向传播学),但不要真的这样算:代码 01 演示 1 验证了 和直接取 E[w] 一模一样(最大差 0),而矩阵乘法要做 次乘法,在 Ng 的例子里是每个词 3,000,000 次,几乎全在乘 0。所以 PyTorch 的 nn.Embedding、Keras 的 Embedding 层都是查表。
4.2 一个起点:神经语言模型
从哪里来?最早成功的做法之一是 Bengio et al. (2003) 的神经语言模型:用前几个词预测下一个词。Ng 的例子:“I want a glass of orange ___”。
  I      want    a      glass   of     orange
  o_4343 o_9665  o_1    o_3852  o_6163 o_6257      one-hot(10,000 维)
    ↓ E    ↓ E    ↓ E     ↓ E    ↓ E     ↓ E        同一个 E(参数共享)
  e_4343 e_9665  e_1    e_3852  e_6163 e_6257      每个 300 维
    └──────────── 拼起来 ─────────────┘
                     ↓
隐藏层 → softmax(10,000 类)→ 预测 "juice"通常只看固定的最近几个词(比如最近 4 个,拼起来是 1200 维),这样不管句子多长输入都是同样大小。 和网络的其余参数一起用反向传播学。为了预测好下一个词,模型会把”可以出现在同样位置”的词(orange、apple 都在 “glass of ___ juice” 里)放到相近的地方。
上下文不一定是”前面 4 个词”。如果目的只是学词向量(而不是做一个真正的语言模型),可以有别的选择:左右各 4 个词;只用前 1 个词;甚至只用附近随便一个词。最后这个最简单的选择,就是 word2vec 的 skip-gram。
4.3 skip-gram
skip-gram(Mikolov et al., 2013a):在句子里随机挑一个词作为 context ,再在它左右一个窗口(比如 ±5 或 ±10 个词)里随机挑一个词作为 target ,训练模型”看到 ,预测 ”:
这个任务本身很难(orange 附近可能是 juice、glass、my、tree……),但我们不在乎它做得多好——在乎的是为了做这个任务学出来的 。训练样本是”免费”的:每个词和它附近的词组成一对 ,不需要任何人工标注,这是第 1 讲 §3.6 说的自监督学习。代码 01 演示 2:例句 “i want a glass of orange juice”,窗口 ±2 时以 orange 为 的样本是 (orange, juice)、(orange, of)、(orange, glass);整个语料 362,378 个词,窗口 ±4 时一共 1,699,024 对。
问题是分母:每算一次 都要对 个词求和。 时已经很慢,真实的词表常常上百万。两个办法:
- 分层 softmax(hierarchical softmax):把 类的选择变成一棵二叉树上的一串”往左还是往右”,每次只算 个二分类。实际中这棵树不是平衡的:常见的词放在靠近根的位置(Huffman 编码),走几步就到。本讲不展开。
- 负采样(§4.4):更简单,也更常用。
还有一个细节: 怎么抽? 如果均匀地从语料里抽,the、of、a 这样的高频词会占绝大部分样本。Mikolov et al. (2013b) 对高频词做了下采样(subsampling),Ng 在视频里也提到要用一些启发式方法平衡常见词和少见词。我们的代码为了简单没有做(窗口也是固定的,原版会在 1..window 之间随机取)。另一个变体 CBOW(continuous bag-of-words)反过来:用周围的词预测中间的词。
4.4 负采样
负采样(negative sampling,Mikolov et al., 2013b)把” 选一”换成”判断真假”。对每个真实的 (标签 1),再从词表里随机抽 个词 ,和 组成 对”假的”样本(标签 0):
| context | word | 标签 |
|---|---|---|
| orange | juice | 1 |
| orange | king | 0 |
| orange | book | 0 |
| orange | the | 0 |
| orange | of | 0 |
(of 也许真的出现在 orange 附近,但它是随机抽的,就标 0,不用管。)模型是逻辑回归:
每一步只更新 个输出向量和 1 个输入向量,而不是 个。设 ,它的梯度就是第 2 讲逻辑回归的”预测 − 标签”:
取多少? Mikolov et al. 的建议是小数据集 5–20,大数据集 2–5。负样本怎么抽? 按词频抽,the 会被抽得太多;均匀地抽,又和真实的词分布差得太远。论文的经验选择是介于两者之间的
是词频。代码 01 演示 2 比较了几个词被抽中的概率:
| 词 | 词频 | 按词频抽 | 按 抽 | 均匀地抽 |
|---|---|---|---|---|
| the | 0.1607 | 0.1607 | 0.0703 | 0.0031 |
| was | 0.0420 | 0.0420 | 0.0257 | 0.0031 |
| king | 0.0025 | 0.0025 | 0.0031 | 0.0031 |
| durian | 0.0012 | 0.0012 | 0.0018 | 0.0031 |
动手实现(embedding_tools.py)。手写的梯度和 PyTorch autograd 在 float64 下逐数字对照,最大差 2.2e−16。然后是一个真实踩到的坑:为了在 numpy 里跑得快,我们一次处理 1024 对。照 word2vec 的设置用 SGD(学习率 0.025),训练发散了:
| 更新规则 | 第 1 步 | 第 10 步 | 第 50 步 | 第 100 步 | 第 300 步 |
|---|---|---|---|---|---|
| SGD,batch 1024 | 4.159 | 3.998 | 893.290 | 6893282.276 | 第 157 步发散 |
| SGD,batch 128 | 4.159 | 4.159 | 4.076 | 3.472 | 2.601 |
| AdaGrad,batch 1024 | 4.159 | 2.444 | 1.752 | 1.588 | 1.457 |
原因:the 在一个 batch 里会被当成负样本抽中几百次(1024 × 5 × 0.07 ≈ 360),几百个梯度加在同一行上,步子太大。word2vec 原版是一对一对地更新的,没有这个问题;小 batch 的 SGD 不发散,但学得慢。我们改用 AdaGrad(GloVe 论文用的也是它):每个参数累积自己的梯度平方 ,步长 ,被更新得越多的行步子越小。这类”每一行被更新的次数差别很大”的稀疏更新,正是 AdaGrad 一类方法擅长的。
训练 2 个 epoch(50 维、窗口 ±4、)之后的最近邻:
| 词 | 最近的 5 个词(余弦相似度) |
|---|---|
| orange | apple 0.99、mango 0.99、lemon 0.99、peach 0.99、banana 0.99 |
| king | queen 0.86、prince 0.81、man 0.68、princess 0.65、throne 0.63 |
| paris | athens 0.90、madrid 0.90、stockholm 0.89、moscow 0.89、warsaw 0.89 |
| good | bad 0.94、wonderful 0.93、tasty 0.92、excellent 0.92、lovely 0.90 |
| nurse | doctor 0.95、librarian 0.91、dancer 0.90、babysitter 0.89、secretary 0.89 |
cos(orange, apple) 从 one-hot 时的 0 变成了 0.992,cos(orange, king) 是 0.274。但请注意 good 的最近邻是 bad:反义词出现在几乎一样的语境里(the food was very ___),词向量会把它们放得很近。词向量里的”相似”是”能出现在同样的位置”,不完全等于”意思相同”。§5 会看到,好评和差评的区别仍然在词向量里——只不过是一个方向,而不是”离谁近”。
4.5 两个超参数:窗口与
代码 01 演示 4 只改窗口大小和 ,其余不变:
| 设置 | 性别 | 平民→王室 | 大人→小孩 | 国家→首都 | 国家→语言 | 原级→比较级 | 全部 | 每步点积 |
|---|---|---|---|---|---|---|---|---|
| 窗口 ±1, | 1.000 | 0.333 | 0.500 | 0.111 | 0.078 | 0.339 | 0.363 | 6,144 |
| 窗口 ±2, | 1.000 | 0.583 | 1.000 | 0.133 | 0.156 | 1.000 | 0.546 | 6,144 |
| 窗口 ±4, | 1.000 | 0.750 | 1.000 | 1.000 | 1.000 | 1.000 | 0.991 | 6,144 |
| 窗口 ±4, | 1.000 | 0.667 | 1.000 | 0.967 | 0.467 | 1.000 | 0.843 | 2,048 |
| 窗口 ±4, | 1.000 | 0.667 | 0.900 | 1.000 | 1.000 | 1.000 | 0.980 | 16,384 |
- 窗口决定了”上下文”是什么。我们的语料里,国家、首都、语言靠”招牌菜”绑在一起:baguette is popular in france(隔 4 个位置)、the menu was in french and offered baguette(隔 3 个位置)。窗口 ±2 看不到这两种联系,国家 → 首都只有 0.133。窗口 ±1 时连比较级也坏了:the elephant is bigger 里 bigger 和 elephant 隔着一个 is。一般的经验是:小窗口学到的更偏”语法上可以互换”,大窗口更偏”话题相关”。
- : 明显差(0.843), 和 差不多(0.980 vs 0.991),但每步的计算量是 2.7 倍。不同 的损失不能直接比( 越大损失里的项越多),所以这里比的是类比准确率。
- 负采样省了多少:每步的点积数是 batch × = 6,144;完整的 softmax 是 batch × = 330,752(); 时是 10,240,000——一千多倍。
4.6 GloVe
word2vec 是”一对一对地扫过语料”。另一条路是先数数: = 词 出现在词 附近(某个窗口内)的次数。用对称的窗口时 。GloVe(Global Vectors,Pennington, Socher & Manning, 2014)直接拟合共现次数的对数:
加权函数 做三件事:
- 时 :没共现过的词对不参加训练( 没有定义;约定 "");
- 常见的词对(“of the”、“this is”)权重不要太大;
- 少见的词对(“durian”)权重也不要太小。
论文用的是 (),否则为 1,。在这个损失里 和 的地位是对称的,所以最后的词向量取两者的平均 。
代码 01 演示 5 把三种方法放在一起比(窗口都是 ±4):
| 方法 | 全部类比准确率 |
|---|---|
| skip-gram + 负采样,50 维 | 0.991 |
| PPMI + SVD(共现矩阵的正逐点互信息,再截断 SVD),50 维 | 0.694 |
| PPMI + SVD,100 维 | 0.940 |
| GloVe,50 维 | 0.709 |
| GloVe,50 维,换一个初始化种子 | 0.566 |
- 在这个玩具语料上 skip-gram 最好,GloVe 对初始化很敏感。这不能推广到真实数据:GloVe 论文报告的是 GloVe 更好,Levy, Goldberg & Dagan (2015) 发现把各种方法的超参数都调好以后,差别大多会消失。这里的结论只是:三种方法都能从共现统计里学出类比结构。
- GloVe 的加权损失降到了 0.0026,几乎完美地拟合了 6,467 个非零的 ,类比却一般。一个没有验证的猜测:GloVe 只拟合非零项,“从来不一起出现”这个信息被丢掉了;负采样(负样本)和 PPMI(矩阵里的 0)都用到了它。
- “相似”来自共享的上下文,不是”一起出现”:——“paris is the capital of france” 里两者隔了 5 个位置,窗口 ±4 内从来没有一起出现过。但 、:两者都和 baguette 一起出现,类比照样做得出来。
- 计数法和预测法其实是近亲:Levy & Goldberg (2014) 证明了 skip-gram + 负采样在隐式地分解一个”平移过的 PMI 矩阵”。
5. 情感分类 · Sentiment classification
5.1 问题:标注数据很少
情感分类:输入一段评论,输出几颗星。Ng 的例子:“The dessert is excellent” → 4 星,“Service was quite slow” → 2 星,“Completely lacking in good taste, good service, and good ambience” → 1 星。困难在于标注数据往往很少(Ng 说 1 万到 10 万个词的训练集并不少见),所以要靠在大语料上学好的词向量(§2.2)。
Ng(和 Coursera 作业 “Emojify”)比较了两个模型:
- 平均法:把句子里所有词的词向量平均,接一个 softmax。不管句子多长都变成一个 维向量;但词序完全丢了。
- RNN(LSTM):按顺序读词,用最后的隐藏状态做 many-to-one 的分类(第 15 讲)。
Ng 说平均法的问题出在 “Completely lacking in good taste, good service, and good ambience” 这样的句子上:三个 good 把平均向量拉向好评。
5.2 实验
代码 02 造了 4 个等级的合成评论(1★ 很差 / 2★ 差 / 4★ 好 / 5★ 很好),标签由规则决定:
| 类型 | 例句 | 标签 |
|---|---|---|
| 普通 | the food was bland | 2★ 差 |
| 程度词 | the music was very awful | 1★ 很差 |
| 否定 | the coffee was not bland | 4★ 好 |
| 否定 + 程度词 | the service was not very poor | 4★ 好 |
| lacking in | it was lacking in nice room and tasty soup | 2★ 差 |
| 并列 | the food was good and the room was tasty | 4★ 好 |
训练 800 条,词向量用 01 训练好的那一份。测试时 lacking in 后面跟 3 个好评词(训练时只有 1–2 个),模仿 Ng 的例子。在见过的情感词上:
| 模型 | 训练集 | 普通 | 程度词 | 否定 | lacking in | 并列 |
|---|---|---|---|---|---|---|
| 平均 + 冻结 | 0.707 | 0.855 | 1.000 | 0.330 | 1.000 | 0.700 |
| 平均 + 微调 | 0.711 | 0.810 | 1.000 | 0.340 | 1.000 | 0.760 |
| 平均 + 随机 | 0.725 | 0.825 | 1.000 | 0.340 | 1.000 | 0.785 |
| LSTM + 冻结 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 |
在没见过的情感词上:
| 模型 | 普通 | 程度词 | 否定 | lacking in | 并列 |
|---|---|---|---|---|---|
| 平均 + 冻结 | 0.815 | 1.000 | 0.325 | 1.000 | 0.750 |
| 平均 + 随机 | 0.555 | 0.515 | 0.525 | 1.000 | 0.515 |
| LSTM + 冻结 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 |
| LSTM + 微调 | 0.545 | 0.900 | 0.475 | 1.000 | 0.665 |
| LSTM + 随机 | 0.675 | 0.555 | 0.320 | 1.000 | 0.595 |
先猜一猜:平均法会栽在哪一类句子上?答案和 Ng 的说法不完全一样:
- 否定是平均法的死穴:0.330,连训练集都只拟合到 0.707。不是数据不够,是模型表示不了(§5.3)。
- 平均法学会了 lacking in(1.000,哪怕后面跟着 3 个 good)。在我们的数据里,lacking 只出现在”差”的句子里,给它一个很大的负权重就够了。Ng 的例子要成立,需要 lacking 这类词在训练数据里很少见、或者也出现在别的语境里——真实数据往往正是这样。
- 程度词也学会了(1.000):very 只是给”很好 / 很差”加一个固定的偏移。
所以更准确的说法是:平均法学不会的是”一个词的作用取决于别的词”(not 把后面的词反过来),而不是”句子里有负面的词”。
5.3 为什么平均法学不会否定
平均法对”4★ 好 vs 2★ 差”的打分是 , 是平均词向量。每个词贡献 ,所以
两个差的符号永远相同。可正确的标签要求前者为正(good 好于 bad)、后者为负(not good 差于 not bad)。代码 02 演示 3 打印了训练出的模型:,两个差分别是 +0.417 和 +0.334——不管怎么训练,这四句话至少错一句。这和 XOR(第 1 讲 §1.3、第 4 讲 §5.3)是同一种结构:线性模型只能把各个词的作用加起来,表示不了”not 的作用取决于后面是什么”。实际训练出的平均法甚至把 “the food was good” 也判成了 2★(为了照顾否定句,整体往”差”偏),这就是它普通句子只有 0.855 的原因。
LSTM 按顺序读,读到 not 时改变内部状态,后面的 good / bad 就被”反过来”理解了。四句全对。
5.4 回到迁移学习
两张表合起来看 §2.2 的结论:能推广到没见过的词,靠的是冻结的预训练词向量(LSTM + 冻结 1.000;平均 + 冻结也有 0.815,而平均 + 随机只有 0.555)。随机初始化的词向量对 superb 一无所知;微调过的词向量把见过的 8 个词挪了位置,和没见过的词”错开”了。
6. 词嵌入里的偏见与去偏 · Debiasing word embeddings
6.1 问题
词向量从人写的文本里学来,文本里的统计关联也会被学进去,包括社会偏见。Bolukbasi et al. (2016) 的标题就是一个例子:“Man is to Computer Programmer as Woman is to Homemaker?”;Ng 的另一个例子是 father : doctor :: mother : nurse。这不是 word2vec 的 bug:它在忠实地描述语料。问题在于,这些向量会被用到招聘、贷款、搜索这样的决策里,模型会把统计关联当成”知识”用起来,甚至放大它。
我们的合成语料故意给每个职业设了一个性别关联:比如 engineer 的语境里 90% 配 he / his / father,nurse 只有 10%(数字是随手设的,不代表任何真实统计)。好处是我们知道”偏见的真相”。
6.2 第一步:找偏见的方向
Ng 的简单做法:把定义性的词对的差平均起来,。Bolukbasi et al. 的做法更稳一点:对这些差做 PCA(这里用 SVD),取第一主成分。代码 03 演示 1 用了 11 对词(he/she、his/her、man/woman……husband/wife):
- 两种做法几乎一样(余弦相似度 0.998);
- 第一主成分解释了 63% 的方差,第二主成分还有 28%。Bolukbasi et al. 在真实词向量上看到第一主成分远大于其余的;我们的玩具里”性别”不完全是一个方向:名词对的差和 的余弦在 0.84–0.97,代词对(he/she 0.41、his/her 0.45)的性别差落在另一个方向上。
演示 2 看每个职业在 上的投影:carpenter +0.264、engineer +0.183 …… nurse −0.194、babysitter −0.213;和语料里真实的 P(男性 | 职业) 的相关系数是 0.988。词向量把文本里的统计关联几乎原样学了进去,我们从来没有告诉它”engineer 是男性职业”。
6.3 第二步和第三步:neutralize 与 equalize
neutralize(中和):对每个不该有性别的词(doctor、babysitter……),减掉它在 上的分量:
( 是单位向量时就是 ;Bolukbasi et al. 减完之后再归一化成单位长度。)
equalize(均衡):对每一对定义性的词(grandmother / grandfather、man / woman),让它们只在 上不同。设两个词都是单位向量,,,:
同理。结果是两个词的非性别部分都等于 ,性别部分大小相同、方向相反。于是任何一个中和过的词到 、 的距离完全相等——Ng 的例子:babysitter 离 grandmother 和 grandfather 一样远。
哪些词该中和? Bolukbasi et al. 训练了一个分类器判断一个词是不是”定义上就有性别”(king、mother 是,doctor 不是),发现绝大多数词都应该是中性的;而需要均衡的词对比较少,可以人工列出。我们的语料里定义性的词就是那 11 对,直接用它。
代码 03 演示 3 的结果:中和之后 22 个职业在 上的投影最大只有 2.3e−16;均衡之后它们到 man、woman 的距离完全相等:
| 职业 | 去偏前:到 man / woman | 去偏后:到 man / woman |
|---|---|---|
| engineer | 0.555 / 0.630 | 0.588 / 0.588 |
| nurse | 0.681 / 0.588 | 0.625 / 0.625 |
| babysitter | 0.766 / 0.689 | 0.718 / 0.718 |
(余弦距离 = 1 − 余弦相似度。)
6.4 类比是一个粗糙的偏见测量工具
| 类比(排除题面词) | 去偏前 | 去偏后 |
|---|---|---|
| he : engineer :: she : ? | babysitter 0.74、secretary 0.70 | secretary 0.66、lawyer 0.66、babysitter 0.66 |
| father : pilot :: mother : ? | nurse 0.81、hairdresser 0.81 | scientist 0.76、surgeon 0.76 |
| man : doctor :: woman : ? | nurse 0.93、librarian 0.85 | nurse 0.88、librarian 0.82 |
去偏之后,中性词在 上没有分量了, 和每个中性词的相似度只剩下”和 engineer 像不像”,答案退化成 engineer 的近邻(三个答案几乎打平)。man : doctor :: woman : ? 去偏后仍然是 nurse,但原因变了:nurse 是 doctor 的最近邻(0.98,两者都和 patient 一起出现)。
还记得 §3.3 的”排除题面词”吗?Nissim, van Noord & van der Goot (2020) 指出,很多流传很广的”带偏见的类比”在不排除题面词时,最好的答案其实是题面词自己(“man is to doctor as woman is to doctor”)。在我们的语料里,这个关联是”真的”(语料就是这样造的):不排除题面词时 nurse(0.93)仍然排在 doctor(0.89)前面。但在真实词向量上评估偏见时,要用比类比更可靠的工具。
6.5 局限:“给猪涂口红”
投影变成 0 了,偏见就没了吗?Gonen & Goldberg (2019) 的论文标题是 “Lipstick on a Pig: Debiasing Methods Cover up Systematic Gender Biases in Word Embeddings But do not Remove Them”。他们发现,去偏之后,原来偏同一性别的词仍然聚在一起,一个分类器能从去偏后的向量里以很高的准确率恢复出原来的性别倾向——偏见分散在很多方向上,“减掉一个方向”只是把它从最显眼的地方藏了起来。
代码 03 演示 4 在玩具里做了两个类似的检查:近邻投票(每个职业看它最近的 3 个职业偏哪边)和线性探针(留一法岭回归,从词向量预测 P(男性 | 职业),第 1 讲 §2.3 的探针):
| 近邻投票准确率 | 探针预测和真值的相关 | |
|---|---|---|
| 去偏前 | 0.900 | 0.964 |
| 去偏后(中和 1 个方向) | 0.600 | 0.225 |
| 去偏后(中和前 2 个主成分) | 0.550 | −0.012 |
在我们的玩具里,残留的偏见很弱(只有 22 个职业,留一法的相关系数在没有任何信号时也会偏负,打乱标签的对照是 −0.422),中和两个方向后几乎没有了。这比 Gonen & Goldberg 在真实词向量上看到的情况好得多,原因是我们的语料里偏见只通过 he / his / father 这些性别词进入职业。真实文本里,性别和无数别的词(爱好、形容词、话题)相关,偏见是分散的。
要点:去偏是一个有用的工具,但不是终点。数据从哪里来、下游任务里模型的决策是否公平,要在下游任务上直接评估(第 10 讲的误差分析可以按人群分组来做)。
7. 序列到序列模型 · Sequence-to-sequence models
7.1 编码器-解码器
第 15 讲的 RNN 有几种形状:many-to-one(情感分类)、many-to-many 且长度相同(命名实体识别)。机器翻译是 many-to-many、长度不同:“Jane visite l’Afrique en septembre”(5 个词)→ “Jane is visiting Africa in September”(6 个词)。Sutskever, Vinyals & Le (2014) 和 Cho et al. (2014) 同时提出了编码器-解码器(encoder-decoder)结构:
  编码器:读完整句法语                                解码器:一个词一个词地写英语
  x<1>   x<2>    x<3>      x<4>  x<5>                 y<1>   y<2>  y<3>      ...  <eos>
  Jane → visite → l'Afrique → en → septembre → [ 一个向量 ] → Jane → is → visiting → ...
编码器把整句话读成一个向量,解码器从这个向量出发,像第 15 讲的语言模型一样一个词一个词地生成,每一步把上一步的输出喂回去。Fall 2017 CS230 的课件里有一页”Inverting input works better?!!”:Sutskever et al. 发现把源句倒过来输入效果更好——倒过来以后,源句的开头离译文的开头更近,梯度更容易传。这是”一个向量装不下整句话”的第一个信号(§7.3)。
图像描述(image captioning)是同一个结构:把一个预训练的 CNN(比如去掉 softmax 的 AlexNet,第 13 讲)当编码器,图片 → 4096 维向量,再接一个 RNN 解码器写出 “a cat sitting on a chair”(Mao et al. 2014;Vinyals et al. 2015 “Show and Tell”;Karpathy & Fei-Fei 2015)。
7.2 机器翻译 = 条件语言模型
对比一下第 15 讲的语言模型:它从全零的 出发,建模 。翻译的解码器和它一模一样,只是起点换成了编码器的输出,所以它建模的是
Ng 把它叫做条件语言模型(conditional language model)。训练和语言模型一样:每一步的交叉熵加起来,解码器的输入用正确答案的上一个词(teacher forcing)。
训练好以后怎么用?第 15 讲里我们从语言模型采样来生成恐龙名字。翻译不能这样:同一句法语,采样一次可能得到”Jane is visiting Africa in September”,再采样一次得到”Her African friend welcomed Jane in September”。我们要的是最可能的那一句 。怎样找到它,是 §9 的主题。
7.3 长句子的问题
编码器-解码器有一个结构上的瓶颈:不管源句多长,都要压进一个固定长度的向量。Fall 2017 课件把问题列得很清楚:编码器把源句的全部信息编码进一个固定长度的向量;可是输出的某一部分往往只和输入的某一部分有关;结果是在长句子上表现很差。Ng 在 “Attention Model Intuition” 里画了 Bahdanau et al. (2015) 的那张图:没有注意力的模型,BLEU(§10)在句子超过二三十个词以后明显下降。
人类翻译员不是这样工作的:他不会把一整段话背下来再从头翻译,而是看一部分、翻一部分,需要时再回头看原文。这就是注意力。
8. 注意力模型 · Attention model
8.1 模型
Bahdanau, Cho & Bengio (2015) 的做法:
- 编码器用一个双向 RNN(第 15 讲)读输入,在每个位置 得到一个”注解”(annotation):它包含了整句话的信息,但重点在 附近。
- 解码器在生成第 个词之前,先决定”现在该看输入的哪里”:给每个输入位置一个权重 ,所有权重加起来是 1;
- 用这些权重对注解加权平均,得到这一步专属的上下文向量:
- 解码器的 RNN 用 、上一个输出词和上一步的状态 算出新状态 ,再预测 。
权重从哪里来? 先用一个小的神经网络打分,再做 softmax:
为什么打分要看 和 ?因为”该不该看第 个位置”取决于两件事:我已经写到哪里了(解码器的状态),以及那个位置有什么(注解)。至于这个函数具体长什么样,我们不知道,就让一个小网络去学——它和整个模型一起用反向传播训练(Fall 2017 课件的说法:训练方法和普通的机器翻译模型一样,只是多了对注意力参数的求导)。Coursera 作业里的小网络是”拼接 → Dense(10, tanh) → Dense(1)“,和上面的公式是同一个想法;Luong et al. (2015) 还试过更简单的乘法式打分 ——第 17 讲的点积注意力就从这里来。
代价:每个输出位置都要和每个输入位置打一次分,一共 个 。翻译一句几十个词的话没问题;对几千个词的长文档就很贵了(第 17 讲的自注意力有同样的平方代价)。
8.2 实验:日期翻译
Coursera 作业 “Neural Machine Translation with Attention” 的任务:把各种格式的人写日期翻译成 YYYY-MM-DD。代码 04 做同样的事,11 种格式:
    9 july 1998                    → 1998-07-09
    5/31/1959                      → 1959-05-31
    30.12.1979                     → 1979-12-30
    the 27th of july, 1992         → 1992-07-27
    saturday, january 9, 2044      → 2044-01-09
为了模仿”越来越长的句子”,我们再把 1–3 个日期用 ” and ” 连起来一起翻译(“27 august 2006 and march 24 1971” → “2006-08-27 1971-03-24”):输入越长,要记住的内容就越多。输入是字符序列(8–87 个字符),输出 11、22、33 个字符(含 <eos>)。
两个模型只差一件事(seq2seq_attention.py):同样的双向 GRU 编码器、同样的 GRU 解码器、同样的输出层;没有注意力时,解码器每一步看的是编码器读完整句后的同一个总结向量(Cho et al. 2014 的写法),有注意力时每一步重新算 。参数 44,655 vs 48,815 个。同样 6000 条数据、同样 6 个 epoch:
| epoch | 没有注意力:1 / 2 / 3 个日期 | 有注意力:1 / 2 / 3 个日期 |
|---|---|---|
| 2 | 0.020 / 0.000 / 0.000 | 0.157 / 0.003 / 0.000 |
| 4 | 0.100 / 0.000 / 0.000 | 0.890 / 0.820 / 0.667 |
| 6 | 0.303 / 0.000 / 0.000 | 0.997 / 0.977 / 0.967 |
按输入长度看(6 个 epoch 后):
| 输入长度(字符) | 0–15 | 16–25 | 26–40 | 41–60 | 61–100 |
|---|---|---|---|---|---|
| 没有注意力 | 0.265 | 0.316 | 0.019 | 0.000 | 0.000 |
| 有注意力 | 0.995 | 0.991 | 0.967 | 0.977 | 0.977 |
这就是 Ng 画的那条曲线的玩具版:没有注意力的模型随输入变长迅速崩溃,有注意力的模型在所有长度上都差不多。读这两张表要注意三点:
- “长”的意思是”要记的东西多”。单个日期的 11 种格式之间,没有注意力的模型准确率在 0.214–0.458 之间,和格式本身的长短没有明显关系;塌下来是因为日期变多了。3 个日期时它连第 1 个日期都翻不对(0.010):总结向量要同时装三个日期,每一个都装不准。
- 这是同样预算下的比较。没有注意力的模型如果只学单个日期(同样 6000 条、6 个 epoch),能到 0.853;和长句子混在一起训练时它在单个日期上只有 0.303,部分原因是训练数据里 2/3 是它学不会的长句子。更大、训练更久,它可能做得更好(我们没有试)。
- 注意力让同样大小的模型学得快得多:单个日期在第 6 个 epoch 到 0.997,三个日期 0.967。
8.3 把注意力画出来
注意力最直观的好处:可以看模型在”看”哪里。代码 04 演示 4 把 打印成字符热力图(每一行是一个输出字符,每一列是一个输入字符,越黑权重越大),也存了一张图(figures/lecture16_attention_heatmap.png):
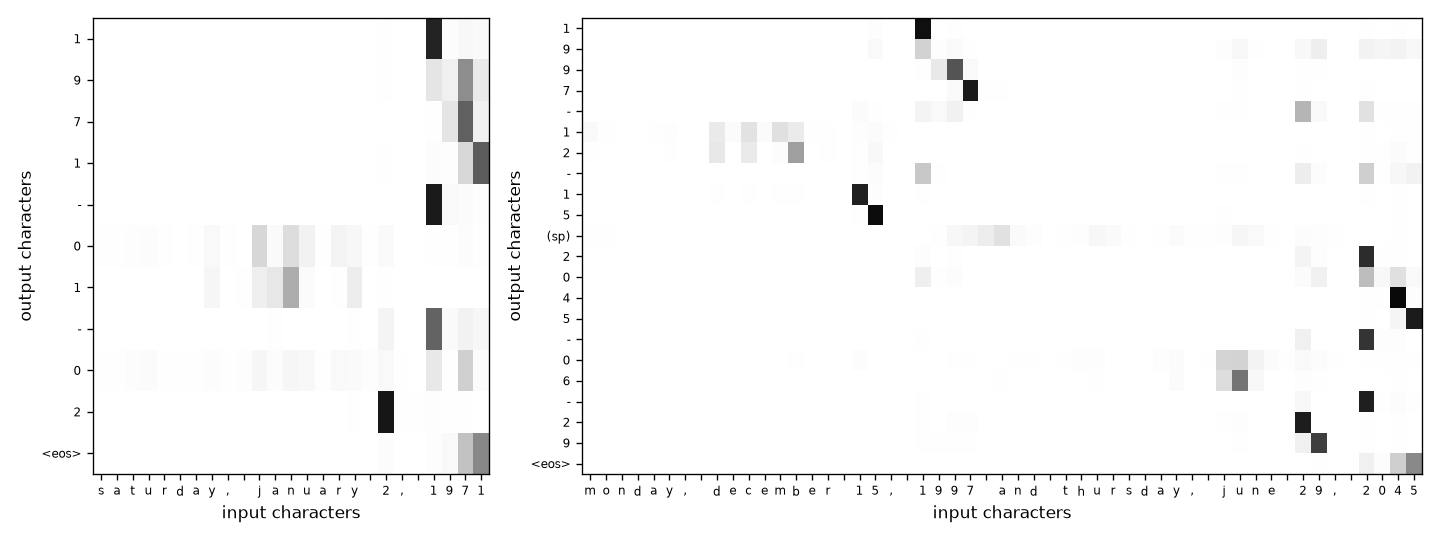
输入 “the 17th of november, 1988” → 输出 “1988-11-17”
        the 17th of november, 1988
  1                           @      最大 α = 0.90(第 23 个字符 “1”)
  9                           : -.   最大 α = 0.39(第 25 个字符 “8”)
  8                            .#.   最大 α = 0.71(第 25 个字符 “8”)
  8                             :*   最大 α = 0.66(第 26 个字符 “8”)
  -                           % .    最大 α = 0.80(第 23 个字符 “1”)
  1                 :.  :            最大 α = 0.23(第 13 个字符 “n”)
  1                 *.               最大 α = 0.69(第 13 个字符 “n”)
  -                           #      最大 α = 0.80(第 23 个字符 “1”)
  1         %                        最大 α = 0.89(第 5 个字符 “1”)
  7          %                       最大 α = 0.87(第 6 个字符 “7”)
输出的顺序是年 → 月 → 日,输入的顺序是日 → 月 → 年:注意力先看末尾的年份,跳回中间的 november,再跳回开头的 17。没有人告诉模型年份在哪里——这种对齐(alignment)是从”翻译对了”这一个目标里自己学出来的,Bahdanau et al. 的论文标题就叫”jointly learning to align and translate”。
统计全部翻译正确的测试样本:输出年 / 月 / 日的数字时,分别有 84% / 74% / 78% 的注意力落在输入里对应的字段上;落在星期几上的只有 2.2%——星期几是多余的信息,模型学会了不看它。两个日期时,有 87% 的注意力落在”对的那个日期”上:解码器写第二个日期时,注意力跳到了输入的第二个日期。
注意力权重是很好的调试工具,但它不一定等于”模型为什么这样做”的解释(Jain & Wallace 2019,“Attention is not Explanation”)。第 21 讲讲可解释性时会再谈。
8.4 图像描述里的注意力
同样的想法用在图像上就是 Show, Attend and Tell(Xu et al., 2015):CNN 的最后一个卷积层给出 个位置的特征 (每个位置是图像的一块),解码器写每个词之前对这 个位置做注意力——写 “bird” 时看鸟,写 “water” 时看水。Fall 2017 课件里还提到这篇论文的一个正则项 :鼓励每个位置在整句描述里总共被”看”大约一次,免得模型只盯着一处。
9. 挑最可能的句子:beam search · Picking the most likely sentence
9.1 为什么不用贪心
§7.2 说我们要找 。最直接的想法是贪心搜索:第一步选最可能的 ,第二步在此基础上选最可能的 ,依此类推。Ng 的反例:两句译文”Jane is visiting Africa in September”和”Jane is going to be visiting Africa in September”,前者更好;但写完”Jane is”之后,going 在英语里太常见了, 可能比 大,贪心就走上了后一条路。每一步都选最可能的词,拼出来的不一定是最可能的句子。 而把所有句子都枚举一遍也不可能:10 个词的句子、10,000 个词的词表,就有 种。
代码 05 用 Ng 的例句造了一个玩具翻译任务(seq_worlds.py):“伪法语” → 英语,同一句话有好几种正确的译文,训练数据里按固定的比例出现(像不同的译者):
| “jane visite l’ afrique en septembre” 的译文 | 真实 P | 模型学到的 P |
|---|---|---|
| jane visits africa in september | 0.360 | 0.364 |
| jane is visiting africa in september | 0.240 | 0.242 |
| jane is going to be visiting africa in september | 0.200 | 0.256 |
| in september jane visits africa | 0.090 | 0.041 |
因为比例是我们写下的,所以知道最可能的译文是哪句。训练好的带注意力的 seq2seq(和 §8 同一个模型)学到的分布很接近真实分布;训练损失 0.2197,理论下限(真实分布的熵除以平均句长)0.2132——哪怕是完美的模型,也有这么多”误差”,它来自数据本身的随机性。
代码 05 演示 2 让贪心一步一步走:
  P(y<1> | x, —)                         jane 0.87  in 0.13
  P(y<2> | x, jane)                      is 0.58  visits 0.42
  P(y<3> | x, jane is)                   going 0.51  visiting 0.48
  ...
B = 1:jane is going to be visiting africa in september    P = 0.256
B = 3:jane visits africa in september                     P = 0.364
第二个词 is 确实比 visits 可能(真实 0.30 + 0.25 = 0.55 vs 0.45:is 后面有两种说法,概率加在一起),第三个词模型又恰好偏向了 going——几乎就是 Ng 视频里的例子。
9.2 beam search
beam search 是贪心的推广:每一步保留到目前为止最好的 个部分句子,而不是 1 个。 叫 beam 宽度(beam width)。Ng 用 走了一遍:
- 第 1 步:算 ,在 10,000 个词里留下最好的 3 个,比如 “in”、“jane”、“september”。
- 第 2 步:对这 3 个前缀,各算一遍 ,一共 个候选,按 排序,再留下最好的 3 个,比如 “in september”、“jane is”、“jane visits”。注意 “september” 开头的前缀这时被淘汰了。实现时相当于把网络复制 3 份,每份处理一个前缀。
- 继续下去。以
<eos>结尾的候选算”完成了”,放到一边;最后在完成的句子里挑分数最高的。
时就是贪心。beam_bleu.py 的 beam_search 每一步用 torch.topk 在 个候选里取最好的 个。在 300 个随机源句上:
| 平均 | = 真实最可能的那句 | 现在时 | 过去时 | 将来时 | |
|---|---|---|---|---|---|
| 1(贪心) | −0.9095 | 0.663 | 0.038 | 1.000 | 1.000 |
| 2 | −0.8545 | 0.887 | 0.676 | 1.000 | 1.000 |
| 3 | −0.8545 | 0.887 | 0.676 | 1.000 | 1.000 |
| 10 | −0.8545 | 0.887 | 0.676 | 1.000 | 1.000 |
贪心在现在时的句子上几乎从来找不到最可能的译文(0.038); 就把平均 从 −0.9095 提到 −0.8545,再大就不变了——我们的玩具里每种时态只有三种动词说法。
9.3 取多大,以及 beam search 不是精确搜索
越大,考虑的可能越多,结果越好,但越慢(每步 个候选,内存也要存 个前缀的状态)。Ng 的经验:产品里常用 左右, 对产品来说已经很大了;做研究、为了论文里最好的数字,有人用到 1000、3000。收益是递减的:从 1 到 3、到 10 提升明显,从 1000 到 3000 就很小了。
和广度优先(BFS)、深度优先(DFS)这类精确搜索不同,beam search 不保证找到 :真正最好的句子可能在某一步排在第 名,被剪掉了。它换来的是速度。
9.4 长度归一化
是很多个小于 1 的数相乘,句子长了会小到浮点数下溢,所以实际中都用 ,把乘法变成加法:。但这个目标还有一个问题:每多一个词就多加一个负数,所以它天然偏爱短句。Ng 的修正是除以长度的 次方:
是完全归一化(每个词的平均 概率), 是不归一化,Ng 说 是常见的折中,这是一个启发式的做法,没有太多理论依据,但实践中好用。做法:beam search 过程中照常按 剪枝,最后在所有完成的句子(不同长度)里按这个归一化的分数挑。
代码 05 演示 5 在两份数据上试了它。“干净”的数据就是 §9.1 那份;“嘈杂”的数据里,35% 的人工译文漏掉了时间状语(想象从网上爬来的、质量参差不齐的平行语料),没漏的那些,介词还有 in / during / sometime in 三种说法。同一句源句在嘈杂数据里的分布:
| 译文 | 真实 P |
|---|---|
| jane visits africa | 0.158 |
| jane visits africa in september | 0.117 |
| jane is visiting africa | 0.105 |
漏掉时间状语的短句只有一种写法,概率集中;完整的句子有很多种写法(介词 × 位置),每一种都被分薄了。于是最可能的译文是一句漏了信息的短句。300 个源句,每句 2 个(从干净分布里抽的)参考译文,BLEU(§10):
| 训练数据 | 解码 | BLEU | 平均长度 | 带时间状语 | = 真实最可能 |
|---|---|---|---|---|---|
| 干净 | 贪心 | 0.859 | 5.66 | 1.000 | 0.663 |
| 干净 | , | 0.848 | 5.43 | 1.000 | 0.887 |
| 干净 | , | 0.841 | 5.69 | 1.000 | 0.787 |
| 干净 | , | 0.843 | 5.95 | 1.000 | 0.710 |
| 嘈杂 | 贪心 | 0.467 | 3.52 | 0.033 | 0.033 |
| 嘈杂 | , | 0.452 | 3.40 | 0.033 | 0.033 |
| 嘈杂 | , | 0.577 | 4.36 | 0.290 | 0.233 |
| 嘈杂 | , | 0.648 | 5.18 | 0.433 | 0.307 |
| 嘈杂 | , | 0.699 | 6.44 | 0.707 | 0.327 |
- 嘈杂数据上,不归一化的搜索几乎总是输出短句:只有 3.3% 的输出带时间状语,BLEU 0.452。贪心也一样:按真实分布,写到 “jane visits africa” 之后,
<eos>的条件概率约 0.40,比任何一个介词(in 约 0.30)都大。 比贪心的 BLEU 还略低——搜索得越”好”,越容易找到短句。Koehn & Knowles (2017) 在真实的神经机器翻译系统里报告过”beam 越大、BLEU 反而下降”,原因之一就是译文变短;Stahlberg & Byrne (2019) 甚至发现,对很多句子,模型给出的全局最可能的译文是空串。 - 长度归一化往回拉: 时,带时间状语的比例升到 29.0% / 43.3% / 70.7%,BLEU 升到 0.577 / 0.648 / 0.699。但它奖励的是长度,不是内容:Jane 这一句在 时选中的是 “jane is going to be visiting africa”——更长,仍然漏掉了时间。根本的办法是清理训练数据(第 10 讲 §7)。
- 干净数据上,归一化帮不上忙,反而有害:输出等于真实最可能那句的比例从 0.887()降到 0.710(),因为更长、但更不可能的说法(jane is going to be visiting …)占了便宜。
所以长度归一化是一个启发式的修正:它修正的是模型 / 数据里”偏爱短句”的倾向;真实的翻译模型普遍有这个倾向,所以它通常有用;但 要在 dev 集上调,不能想当然。(表里还有一个小插曲:干净数据上贪心的 BLEU 0.859 甚至比 的 0.848 略高——参考译文是从真实分布里抽的,常常比”最可能那句”更长,最可能那句吃了一点简短惩罚。” 最大”和”BLEU 最高”不是一回事。)
9.5 beam search 的误差分析
翻译系统由两部分组成:模型(RNN,给出 )和搜索(beam search,找 )。dev 集上出错了,该怪谁?加大 便宜,改模型(更多数据、正则化、换结构)贵,所以值得先弄清楚。Ng 的例子:法语 “Jane visite l’Afrique en septembre”,人工翻译 = “Jane visits Africa in September”,算法输出 = “Jane visited Africa last September”。用模型分别算 和 :
- :模型其实更喜欢 ,是 beam search 没找到它——怪搜索;
- : 明明更好,模型却认为 更可能——怪模型。
(如果用了长度归一化,就比较归一化后的分数。)把 dev 集上的错例逐个过一遍,列一张表,算出两种错误的比例;如果大部分怪搜索,就加大 ;如果大部分怪模型,再用第 10 讲 §6 的误差分析深挖模型的问题。
代码 05 演示 3 把真实最可能的译文当作 :
| 错例 | 怪搜索 | 怪模型 | |
|---|---|---|---|
| (贪心) | 101 / 300 | 67(66%) | 34 |
| 34 / 300 | 0 | 34 |
两个典型的错例:
| (贪心) | 怪谁 | |||
|---|---|---|---|---|
| sara visits africa in september | sara is going to be visiting africa in september | −1.044 | −1.568 | 搜索 |
| ali visits peru in february | ali is visiting peru in february | −1.088 | −1.022 | 模型 |
贪心的错误三分之二怪搜索,加大到 之后这部分全部消失;剩下的 34 个错例全部怪模型:真实概率 0.36 和 0.24 的两种说法,模型在 9% 的源句上把排序弄反了(05 演示 1)。这时再加大 没有用,该改模型。
10. BLEU · Bleu score
10.1 为什么需要它
图像分类有唯一的正确答案,翻译没有:同一句法语,“The cat is on the mat” 和 “There is a cat on the mat” 都对。请人评价又贵又慢。Papineni et al. (2002) 的 BLEU(bilingual evaluation understudy)的核心想法是:机器译文越接近专业的人工译文越好,用和若干个参考译文(references)之间的 -gram 重叠来衡量。它便宜、可以自动算、和人工评价大体一致,所以成了机器翻译的单一数字评估指标(第 10 讲 §2),让”想法 → 实验”的循环转得快。
10.2 修正的精确率与裁剪
Ng 的例子:法语 “Le chat est sur le tapis”,参考译文 1 “The cat is on the mat”,参考译文 2 “There is a cat on the mat”。一个很糟的机器译文:
MT 输出:the the the the the the the精确率(precision):机器译文的每个词有没有出现在参考译文里?7 个 the 都出现了,7/7 = 100%。显然不对。修正的精确率(modified precision)把每个词的计数裁剪(clip)到它在任何一个参考译文里出现的最多次数:the 在参考译文 1 里出现 2 次,所以只算 2 个,修正精确率 2/7。(Fall 2017 课件的这一页写成了 2/6,按 7 个词应为 2/7。)
推广到 -gram(相邻的 个词)。Ng 的第二个例子 “The cat the cat on the mat” 的 bigram:
| bigram | 机器译文里的次数 | 裁剪后(参考译文里最多出现的次数) |
|---|---|---|
| the cat | 2 | 1 |
| cat the | 1 | 0 |
| cat on | 1 | 1 |
| on the | 1 | 1 |
| the mat | 1 | 1 |
修正的 bigram 精确率 = 4/6。一般地:
BLEU 是为整个测试集设计的:分子、分母先在所有句子上加起来,再相除(corpus-level),而不是每句算一个精确率再平均。
10.3 合起来:几何平均 × 简短惩罚
把 取几何平均(log 的平均再取 exp):任何一个 是 0,BLEU 就是 0。再乘一个简短惩罚(brevity penalty):
是机器译文的总长度, 是参考译文的”有效”总长度(每句取长度最接近机器译文的那个参考译文)。为什么只惩罚太短、不惩罚太长?因为多说的词本来就匹配不上,会让精确率下降;而少说的词不影响精确率——一句只有 “the cat” 的译文,。
代码 05 演示 4 从零实现(modified_precision、corpus_bleu),用已知的例子验证:
| 候选 | 结果 |
|---|---|
| the the the the the the the | 修正 unigram 精确率 2/7 = 0.286 |
| the cat the cat on the mat | = 5/7、 = 4/6、 = 2/5、 = 1/4,BP = 1,BLEU = 0.467 |
| the cat is on the mat(和参考译文 1 一样) | BLEU = 1.000 |
| the cat(太短) | ,但 BP = exp(1 − 6/2) = 0.135 |
| BLEU 论文的候选 1 / 候选 2 | unigram 17/18 vs 8/14,bigram 10/17 vs 1/13(和论文的数字完全一致) |
10.4 BLEU 的局限
- 同义的说法会被扣分:参考译文里是 “in september”,机器写 “during september”,BLEU 就会扣分,尽管意思一样。参考译文越多,这个问题越小。
- 单句的 BLEU 很粗糙:短句子的 4-gram 经常一个都匹配不上,整句就是 0。
- 它和”模型认为最好”不是一回事:§9.4 的干净数据上,贪心的 BLEU 甚至略高于 beam search。
- 后来还有许多别的自动指标(ROUGE 用于摘要,以及基于预训练模型的指标)和人工评估(CS230 Section 8 列了一些)。但 BLEU 作为”便宜、可复现的单一数字”,在机器翻译里用了二十多年。Ng 提到它常用于机器翻译、图像描述这类”有多种正确答案”的任务;语音识别通常只有一个正确答案,用的是词错误率(Fall 2017 课件提到,BLEU 的”接近程度”正是仿照语音识别的词错误率设计的)。
11. 语音识别与触发词检测 · Speech recognition & trigger word detection
11.1 从声音到文字
语音识别的输入是一段音频:麦克风记录的是气压随时间的变化。常见的预处理是把它转成频谱图(spectrogram):横轴是时间,纵轴是频率,颜色是能量——和人耳做的事情差不多。过去的系统要先人工设计音素(phoneme)这一中间表示;深度学习让端到端(第 10 讲 §11)成为可能:直接从频谱到文字。前提是数据够多:Ng 说学术界常用 300 小时、3000 小时的数据集,最好的商业系统用 1 万小时甚至 10 万小时。
§8 的注意力模型可以直接用来做语音识别(输入是频谱的帧,输出是字符,例如 Chan et al. 的 Listen, Attend and Spell)。另一个经典做法是 CTC。
11.2 CTC:让每一帧都输出
语音的难点是输入远比输出长:10 秒的音频、每秒 100 帧,就是 1000 个输入,而 “the quick brown fox” 只有十几个字符,而且我们不知道每个字母在哪一帧。Fall 2017 课件的说法:“input length ≠ output length”。CTC(connectionist temporal classification,Graves et al., 2006)的办法是让 RNN 每一帧都输出一个字符,字符表里多一个特殊的 blank(记作 _),再用一个折叠函数 把逐帧的输出变成文字:
先合并相邻的重复字符,再去掉 blank。
Ng 的例子:ttt_h_eee___ ___qqq__ → “the q”(中间那个是空格字符)。代码 05 演示 6:
β('hh_e_ll_lo')    = 'hello'
β('hhee_lll_lloo') = 'hello'
β('h_e_l_o') = 'helo' 两个 l 之间没有 blank,被合并成一个一句文字对应很多种逐帧输出(对齐,alignment)。CTC 假设各帧的输出在给定输入时条件独立,一个对齐的概率是各帧概率的乘积,一句文字的概率是所有能折叠成它的对齐的概率之和:
损失是 。演示 6 用 7 帧、字母表 “_helo” 验证了这一点: 种逐帧输出里有 11 种折叠成 “hello”,把它们的概率加起来得 6.938817e−03,和 PyTorch ctc_loss 的 相对差 1.3e−16。枚举要 次, 时完全不可能;真正的 CTC 用动态规划(前向-后向算法),计算量只和 文字长度成正比,本讲不展开(延伸阅读里 Hannun 2017 的 Distill 文章讲得很清楚)。
推理时也有一个”贪心 vs 搜索”的问题:每帧取概率最大的字符再折叠(best path)得到的,不一定是概率最大的文字。演示 6 的手造例子:2 帧、每帧 P() = 0.6、P(a) = 0.4。best path 是 ”__“,折叠成空串,概率 0.36;但 “a” 的概率是 P(a) + P(_a) + P(aa) = 0.64。所以推理时常用(合并相同前缀的)beam search——Fall 2017 课件的原话是 “beam search > max decoding”。
11.3 触发词检测
“Alexa”、“Hey Siri”、“Okay Google”、“小度你好”:设备一直在听,听到触发词就醒来。Ng 在 C5M3 最后一个视频里讲的做法:频谱 → RNN,每个时间步输出一个 0 / 1;训练标签在触发词刚说完之后标 1。这个任务我们在第 5 讲 §5 已经用”五问”完整地讨论过(作业里 、,词后连续标 50 个 1;合成训练数据;为什么逐帧准确率没有意义;看唤醒召回率和每小时误唤醒),第 5 讲代码 04 也做了实验(只标 1 个 vs 标 个: 时误唤醒 ≤ 10 次 / 小时的召回率 0.669, 只有 0.428),本讲不重复。和本讲的联系是:它是 many-to-many、长度相同的序列模型(第 15 讲),不需要编码器-解码器,也不需要 beam search——每一帧的决定是独立做出的。
12. 小结 · Summary
- one-hot 两两正交:模型没法从 orange juice 推广到 apple juice。词嵌入把每个词变成一个稠密向量,“能出现在同样位置”的词靠得近(代码 01:cos(orange, apple) 从 0 变成 0.992)。嵌入矩阵 乘 one-hot = 取一行,实际中用查表。
- 类比 = 向量加减 + 余弦相似度:。要排除题面词(不排除时 0.991 → 0.923);t-SNE 是非线性的,别在它的图上找平行四边形。
- skip-gram + 负采样: 个逻辑回归代替 类 softmax,梯度是”σ(s) − 标签”;负样本按 抽;窗口决定”上下文”是什么(±2 看不到招牌菜,国家 → 首都 0.133)。大 batch 时要小心高频词的梯度累加(SGD 在第 157 步发散,AdaGrad 稳定)。GloVe 拟合 加权的 。“相似”来自共享的上下文:paris 和 france 从没一起出现过,类比照样成立。
- 迁移学习三步:大语料上学(或下载)→ 迁移到小任务 → 数据多时才微调。代码 02:没见过的情感词上,冻结 1.000,微调 0.545,随机 0.675。
- 平均词向量学不会否定: 和 必然同号(+0.417、+0.334);但它学得会”lacking”这种自己就带方向的词。LSTM 读顺序,全对。
- 偏见:职业在性别方向上的投影和语料里的真实关联相关 0.988。neutralize 把中性词的投影减到 0,equalize 让性别词对到中性词等距。但偏见不只在一个方向上(Gonen & Goldberg 2019);类比是粗糙的偏见测量工具(Nissim et al. 2020)。
- seq2seq = 编码器 + 条件语言模型 。一个固定长度的向量装不下长句子:日期任务上,没有注意力的模型 3 个日期时准确率 0。
- 注意力: 由一个小网络打分 → softmax 得 → 。同样的预算,有注意力 0.997 / 0.977 / 0.967;对齐是自己学出来的(输出月份时 74% 的注意力落在月份上,星期几只有 2.2%)。代价是 。
- beam search:每步留 个最好的前缀; 是贪心(会被 “is going to be visiting” 带偏);不保证找到最优。长度归一化 修正”偏爱短句”——在嘈杂数据上把带时间状语的比例从 3.3% 拉到 70.7%,在干净数据上反而有害。
- beam search 的误差分析:比较 与 ,大则怪搜索、小则怪模型(贪心的错例 66% 怪搜索, 时全部怪模型)。
- BLEU = BP × 1–4 gram 修正精确率(裁剪计数)的几何平均;我们的实现和论文的 17/18、10/17 等数字完全一致。
- CTC:每帧都输出,合并重复、去掉 blank; 是所有对齐的概率之和。触发词检测见第 5 讲 §5。
13. 常见误区 · Common pitfalls
- “词向量的每一维都有含义(性别、食物……)。” 那只是讲课用的示意表。学出来的坐标轴可以被任意可逆变换,有意义的是方向和距离(§1.2)。
- “词向量相似 = 意思相同。” good 的最近邻是 bad(0.94):词向量的相似是”能出现在同样的位置”。极性在词向量里是一个方向(§4.4、§5.4)。
- “在 t-SNE 图上看到 man→woman 和 king→queen 平行,说明……” t-SNE 是非线性的,不保留平行四边形。要看线性结构用 PCA 或者直接算余弦(§1.3、§3.4)。
- “类比时直接取和 e_b − e_a + e_c 最近的词。” 不排除题面词,答案常常就是 c 自己(§3.3);反过来,很多”偏见类比”恰恰依赖这条排除规则(§6.4)。
- “有了预训练词向量,就一起微调吧。” 新任务数据少时,微调会让见过和没见过的词”错开”:代码 02 里微调把没见过的词上的准确率从 1.000 降到 0.545(§2.2)。
- “平均词向量的问题是看到负面的词就判错。” 它学得会 lacking;学不会的是 not 这种”作用取决于别的词”的词(§5.3)。
- “去偏之后投影为 0,偏见就消除了。” 只是从最显眼的方向上拿掉了(§6.5)。
- “解码时从 P(y | x) 采样,或者每步取最可能的词。” 翻译要的是 argmax_y P(y | x);贪心每步最优 ≠ 整句最优(§9.1)。
- “beam 越大越好。” 越大越慢,收益递减;当模型偏爱短句时,越大的 beam 越容易找到短句,BLEU 可能反而下降(§9.4)。beam search 也不保证找到最优(§9.3)。
- “长度归一化总是有用,α = 0.7 就行。” 它是对”偏爱短句”的启发式修正;模型没有这种偏差时它会扭曲结果。α 要在 dev 集上调(§9.4)。
- “翻译错了就加大 B。” 先做 beam search 的误差分析:如果大部分错例 P(y*) ≤ P(ŷ),问题在模型,加大 B 没用(§9.5)。
- “注意力权重告诉了我们模型为什么这样做。” 它是很好的调试工具,但不一定是可靠的解释(§8.3)。
14. 练习 · Exercises
练习 1(嵌入矩阵的账)。词表 ,词向量 。(a) 嵌入矩阵有多少个参数?(b) 用 取一个词的向量要做多少次乘法?其中多少次是乘以 0?(c) 一个 batch 有 64 句话、每句 20 个词,用矩阵乘法取出全部词向量一共要做多少次乘法?查表呢?
参考答案
(a) 个参数(第 1 层全连接网络的规模)。
(b) 是 的矩阵乘一个长度 10,000 的向量: 次乘法,其中 次是乘以 0,只有 300 次乘以 1。
(c) 个词,矩阵乘法 次(38.4 亿次);查表 0 次乘法,只是复制 个数。这就是 nn.Embedding 用查表的原因(§4.1)。
练习 2(余弦相似度)。,。(a) 算 。(b) 把 换成 ,结果变吗?欧氏距离呢?(c) 为什么词向量的比较更常用余弦相似度?
参考答案
(a) ,,,。 (b) 不变(分子分母同乘 10)。欧氏距离会变:,。 (c) 词向量的长度和词频等因素有关,和”意思像不像”关系不大;余弦只看方向(§3.2)。
练习 3(负样本的分布)。一个小语料里三个词的出现次数:the 1000 次、cat 100 次、durian 10 次。分别按词频、按 、均匀地抽负样本,三个词被抽中的概率各是多少?
参考答案
按词频:、、。 按 :、、,总和约 215.1,概率约 0.827、0.147、0.026。 均匀:各 1/3。 把 the 的份额从 0.901 压到 0.827,把 durian 从 0.009 提到 0.026(约 3 倍)——介于两个极端之间。(代码 01 演示 2 的表是同样的计算。)
练习 4(推导负采样的梯度)。对 ,,推导 和 。提示:。
参考答案
; 。 再用 、: ,。 两个括号都是”预测的概率 − 标签”(正样本标签 1、负样本标签 0),和第 2 讲逻辑回归的 一模一样。代码 01 演示 2 把它和 autograd 对照过(最大差 2.2e−16)。
练习 5(neutralize 与 equalize 手算)。二维的例子,性别方向 。(a) 中性词 ,中和并归一化后是多少?(b) 一对性别词 、(都是单位向量),按 §6.3 的公式均衡。(c) 验证 (a) 的结果到 、 的距离相等。
参考答案
(a) ,,归一化后 。 (b) ,,,。,方向 ,所以 ;,。两个都是单位向量(),只在 方向上不同。 (c) 到两者的距离都是 ;余弦相似度都是 0.7。
练习 6(beam search 手算)。词表只有 a、b 和 <eos>。模型给出::a 0.6、b 0.4;:a 0.4、b 0.3、<eos> 0.3;:<eos> 0.9、a 0.05、b 0.05;:<eos> 1.0。(a) 贪心的输出和它的概率?(b) 、不归一化的输出?(c) 改用 的长度归一化( 包括 <eos>),选哪一句?
参考答案
(a) 第 1 步选 a(0.6),第 2 步在 a 后面选 a(0.4),第 3 步 <eos>:输出 “a a”,概率 。
(b) 第 1 步留 a(0.6)、b(0.4)。第 2 步的 6 个候选:a a 0.24、a b 0.18、a <eos> 0.18、b <eos> 0.36、b a 0.02、b b 0.02。留下最好的 2 个:b <eos>(0.36,完成)和 a a(0.24),后者下一步以概率 1 结束,得 0.24。最后在完成的句子里挑:“b”,概率 0.36——比贪心好。(a b 后面怎样我们不知道,它在第 2 步就被剪掉了:这就是”不保证最优”。)
(c) “b <eos>”:;“a a <eos>”:。归一化后选 “a a”——更长、但概率更低的那句。这正是 §9.4 在干净数据上看到的现象。
练习 7(BLEU 手算)。参考译文只有一个:“the cat is on the mat”。机器译文:“the cat sat on the mat”。(a) 算 、。(b) BP 是多少?(c) 只用 1–2 gram(几何平均)的 BLEU 是多少?
参考答案
(a) unigram:the(2 次,参考里最多 2 次)→ 2,cat 1,sat 0,on 1,mat 1,。bigram:the cat ✓、cat sat ✗、sat on ✗、on the ✓、the mat ✓,。
(b) 、,,BP 。
(c) 。可以用 beam_bleu.sentence_bleu(cand, [ref], max_n=2) 验证。
练习 8(beam search 的误差分析)。你在 dev 集上看了 10 个错例, 和 如下(没有用长度归一化):(−2.1, −2.5)、(−3.0, −2.2)、(−1.8, −1.9)、(−4.0, −3.1)、(−2.6, −2.4)、(−3.3, −2.9)、(−1.5, −2.6)、(−2.9, −2.0)、(−3.8, −3.5)、(−2.2, −2.1)。(a) 几个怪搜索、几个怪模型?(b) 下一步该做什么?(c) 如果系统用了 的长度归一化,这个比较要怎样改?
参考答案
(a) 的怪搜索:第 1(−2.1 > −2.5)、第 3(−1.8 > −1.9)、第 7(−1.5 > −2.6)个,共 3 个;其余 7 个怪模型。 (b) 70% 的错误怪模型,加大 最多修好 30%。应该把主要精力放在模型上(更多数据、正则化、换结构),再对这 7 个错例做第 10 讲 §6 式的误差分析,看模型错在哪一类句子上。 (c) 比较归一化后的分数 :搜索真正优化的是这个分数,“怪不怪搜索”要用它来判断。两句长度不同时,结论可能翻转。
练习 9(先预测,再运行:漏掉多少才算”太多”)。05 的嘈杂数据里,现在时的源句以概率 漏掉时间状语,没漏时句末 / 句首 0.8 / 0.2,介词 in / during / sometime in 0.5 / 0.3 / 0.2。(a) 按真实分布,“jane visits africa”(漏掉)和 “jane visits africa in september”(完整里最可能的)哪个更可能?写出 的临界值。(b) 把 seq_worlds.py 里的 P_DROP_NOISY 从 0.35 改成 0.2,先预测演示 5 里”嘈杂、、“那一行带时间状语的比例会怎样变,再运行验证。
参考答案
(a) 两句的动词部分概率相同(visits 0.45),比较的是 和 。漏掉的更可能 ⇔ ⇔ 。 时 ,漏掉的那句是 argmax。 (b) 预期(具体数字以你运行的结果为准):,按真实分布完整的句子重新成为 argmax,不归一化的 beam search 带时间状语的比例应该从 3.3% 大幅回升(接近 1)。但 离临界值不远,模型的估计误差可能让一部分句子仍然输出短句;贪心那一行的变化也值得看:写到 jane visits africa 之后, ≈ 0.24,而 in 是 ≈ 0.38,贪心会继续写下去。
练习 10(CTC 数对齐)。字母表 {_, a, b}, 帧,目标文字 “ab”。(a) 列出所有能折叠成 “ab” 的逐帧输出。(b) 如果目标是 “aa”, 时有几种?为什么比 (a) 少?
参考答案
(a) 5 种:ab_、a_b、_ab、aab、abb。
(b) 只有 1 种:a_a。两个相同的字母之间必须隔一个 blank(否则会被合并),3 帧刚好够放 a、_、a,没有多余的帧可以重复或加 blank。这就是为什么 CTC 要求 至少等于”文字长度 + 相邻重复字母的对数”。可以用 beam_bleu.ctc_brute_force_prob 在任意概率下验证这两个个数。
15. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C5M2 “Natural Language Processing & Word Embeddings”、C5M3 “Sequence Models & Attention Mechanism”(Andrew Ng);编程作业 Operations on Word Vectors、Emojify、Neural Machine Translation with Attention、Trigger Word Detection。
- CS230 Fall 2017 公开课件:Lecture 8 “Word2Vec applications + Recurrent Neural Networks with Attention”(Handout 8);Lecture 10 “Sequence models II”(BLEU、beam search、CTC;Handout 10)。web.stanford.edu/class/cs230/fall2017/
- Hannun (2017). Sequence Modeling with CTC. Distill. ——CTC 的动态规划和解码,图解得非常清楚。
词向量
- Bengio, Ducharme, Vincent & Jauvin (2003). A neural probabilistic language model. JMLR.
- Mikolov, Chen, Corrado & Dean (2013a). Efficient estimation of word representations in vector space. ——skip-gram 和 CBOW。
- Mikolov, Sutskever, Chen, Corrado & Dean (2013b). Distributed representations of words and phrases and their compositionality. NeurIPS. ——负采样、、高频词下采样。
- Mikolov, Yih & Zweig (2013). Linguistic regularities in continuous space word representations. NAACL. ——类比。
- Pennington, Socher & Manning (2014). GloVe: Global vectors for word representation. EMNLP.
- Levy & Goldberg (2014). Neural word embedding as implicit matrix factorization. NeurIPS.
- Levy, Goldberg & Dagan (2015). Improving distributional similarity with lessons learned from word embeddings. TACL.
- van der Maaten & Hinton (2008). Visualizing data using t-SNE. JMLR.
偏见
- Bolukbasi, Chang, Zou, Saligrama & Kalai (2016). Man is to computer programmer as woman is to homemaker? Debiasing word embeddings. NeurIPS.
- Gonen & Goldberg (2019). Lipstick on a pig: Debiasing methods cover up systematic gender biases in word embeddings but do not remove them. NAACL.
- Nissim, van Noord & van der Goot (2020). Fair is better than sensational: Man is to doctor as woman is to doctor. Computational Linguistics.
seq2seq 与注意力
- Sutskever, Vinyals & Le (2014). Sequence to sequence learning with neural networks. NeurIPS.
- Cho et al. (2014). Learning phrase representations using RNN encoder-decoder for statistical machine translation. EMNLP.
- Bahdanau, Cho & Bengio (2015). Neural machine translation by jointly learning to align and translate. ICLR.
- Luong, Pham & Manning (2015). Effective approaches to attention-based neural machine translation. EMNLP.
- Vinyals, Toshev, Bengio & Erhan (2015). Show and tell: A neural image caption generator. CVPR.
- Xu et al. (2015). Show, attend and tell: Neural image caption generation with visual attention. ICML.
- Jain & Wallace (2019). Attention is not explanation. NAACL.
解码与评估
- Papineni, Roukos, Ward & Zhu (2002). BLEU: a method for automatic evaluation of machine translation. ACL.
- Koehn & Knowles (2017). Six challenges for neural machine translation. Workshop on Neural Machine Translation. ——包括”beam 越大、质量反而下降”。
- Stahlberg & Byrne (2019). On NMT search errors and model errors: Cat got your tongue? EMNLP.
语音
- Graves, Fernández, Gomez & Schmidhuber (2006). Connectionist temporal classification. ICML.
- Chan, Jaitly, Le & Vinyals (2016). Listen, attend and spell. ICASSP.
16. 下一讲预告 · Next lecture
本讲的注意力是”编码器-解码器注意力”:解码器的每一步回头看编码器的全部输出。它解决了”一个向量装不下整句话”,但模型的骨架仍然是 RNN:编码器要一个字一个字地读,解码器要一个词一个词地写,第 步必须等第 步算完——没法并行,长距离的信息仍然要一步步传过去。
一个自然的问题是:如果把 RNN 去掉,只留下注意力,会怎样? 让每个词都直接”看”句子里的所有其他词(包括输入句子自己),用注意力代替循环。
第 17 讲:Transformer。 我们会讲:
- 自注意力(self-attention):Q / K / V 的直觉,以及为什么缩放点积注意力要除以 ——它和本讲 §8.1 的打分函数是一家人;
- 多头注意力、位置编码(去掉 RNN 以后,模型怎么知道词的顺序?)、mask;
- 编码器-解码器的完整结构,残差 + LayerNorm;
- 为什么 Transformer 成了几乎所有模态的通用架构——以及本讲的 代价在那里变成了什么。
到第 17 讲结束时,你会从零写出一个小 Transformer,并在玩具序列任务上和 RNN 对比。