对应 Maps to:Coursera Deep Learning Specialization C5M1 “Recurrent Neural Networks”(Why Sequence Models?、Notation、Recurrent Neural Network Model、Backpropagation Through Time、Different Types of RNNs、Language Model and Sequence Generation、Sampling Novel Sequences、Vanishing Gradients with RNNs、Gated Recurrent Unit (GRU)、Long Short Term Memory (LSTM)、Bidirectional RNN、Deep RNNs);编程作业 “Building your Recurrent Neural Network – Step by Step”(numpy 实现
rnn_cell_forward、rnn_forward、lstm_cell_forward、lstm_forward,选做反向传播)、“Dinosaur Island – Character-Level Language Modeling”(字符级语言模型、梯度裁剪、采样新的恐龙名)、“Jazz Improvisation with LSTM”。在 Fall 2025 的安排里,C5M1 和课堂 Lecture 8(11/11)在同一周。Fall 2017 的 CS230 有一次课堂讲座 “Overview of recurrent neural networks”,推荐阅读是 Karpathy 的博客 The Unreasonable Effectiveness of Recurrent Neural Networks(2015)。 依据说明:Coursera 的视频和作业不对外公开,Fall 2017 那次讲座的 slides 也不公开。本讲依据 C5M1 里广为人知的内容来写(“Harry Potter and Hermione Granger” 的记号例子、“The cat, which already ate …, was full”、“Teddy Roosevelt / Teddy bears”、GRU 与 LSTM 的公式和门的记号)。视频里的具体数字(比如语言模型那一页的两个句子概率)是凭记忆复述的,细节可能和视频有出入。技术细节以原始论文为准:Elman(1990)、Bengio, Simard & Frasconi(1994)、Hochreiter & Schmidhuber(1997)、Gers et al.(2000)、Cho et al.(2014)、Chung et al.(2014)、Pascanu et al.(2013)、Schuster & Paliwal(1997),见 §16。原作业的后两个用 Keras,本讲义用 numpy 从零实现 RNN / LSTM / GRU,训练模型用 PyTorch。 配套代码 Code:code/lecture15/(numpy 从零写的 RNN、LSTM、GRU 和 BPTT,与 PyTorch 逐数字对照;合成的”恐龙名”字符级语言模型;梯度消失 / 爆炸与裁剪;RNN、GRU、LSTM 的长程依赖实验;5 个脚本 + 3 个模块;最慢的05_gated_memory.py约 100 秒,其余 1–45 秒) 预计阅读时间:3–3.5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说出序列数据为什么需要专门的模型:标准网络的两个问题(输入输出长度可变;不同位置学到的东西不共享),以及 RNN 怎样用”同一组参数在每个时间步重复使用”同时解决它们。
- 熟练使用序列的记号(、、、、词表、one-hot、
<UNK>、<EOS>),写出 RNN 的前向公式(包括 的简写),并手算几步。 - 说清沿时间反向传播(BPTT)在做什么:损失对时间步求和,梯度沿时间往回传,共享参数的梯度是各时间步贡献之和;用 numpy 写出来并和 autograd 对上。
- 区分 many-to-many(等长 / 不等长)、many-to-one、one-to-many、one-to-one 几种结构,知道各自对应什么任务。
- 理解语言模型: 的链式分解、teacher forcing、困惑度(perplexity);会从模型里采样,知道温度的作用、字符级与词级的取舍,以及”背训练集”和”学会规律”的区别。
- 解释 RNN 里的梯度消失与爆炸为什么比普通深网更难对付(同一个 连乘),知道梯度裁剪(按范数 vs 逐元素)怎样做、什么时候有用。
- 写出 GRU 和 LSTM 的公式,用”门”的直觉解释它们为什么能把信息和梯度传得更远;知道 PyTorch 的门顺序和写法上的差别;了解双向 RNN 和深层 RNN 的结构与代价。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开 Previewed only |
|---|---|
| 第 3–4 讲:tanh、sigmoid 及其导数;L 层网络的前向 / 反向与 cache | 词嵌入(word embedding)、word2vec、GloVe(第 16 讲;本讲输入用 one-hot 或一个 nn.Embedding 层) |
| 第 7 讲 §2–3:深网里的梯度消失 / 爆炸是”一串矩阵连乘”;方差保持的初始化;§4 梯度检验 | encoder–decoder(seq2seq)、beam search、BLEU、注意力机制(第 16 讲;本讲只画结构) |
| 第 8 讲:Adam、学习率;第 6 讲:过拟合、early stopping | Transformer 和自注意力(第 17 讲) |
第 9 讲 §3–4:softmax 与交叉熵();PyTorch 训练循环 torch_utils | CTC 损失、语音识别的完整系统(第 16 讲) |
| 第 5 讲 §5:触发词检测,“输入是序列、输出也是序列” | 可解释性:怎样读懂网络内部(第 21 讲) |
本讲是 Part V”序列模型”的第一讲。和第 12 讲一样,新机制先用 numpy 从零写一遍、再和 PyTorch 对照;训练模型用 PyTorch。
0.3 本讲地图 Map
§1  为什么序列需要专门的模型:七个例子;标准网络的两个问题               ← 代码 01 演示 1
§2  记号:x<t>、T_x、词表、one-hot、<UNK>、<EOS>                         ← 代码 01 演示 2
§3  RNN 的前向传播:参数共享;W_a[a, x];和 nn.RNN 对照;只看过去的局限   ← 代码 01 演示 3;代码 02 演示 1
§4  沿时间反向传播(BPTT):参数共享 ⇔ 梯度求和                          ← 代码 02 演示 4
§5  RNN 的类型:many-to-many / many-to-one / one-to-many / encoder–decoder ← 代码 01 演示 4
§6  语言模型:链式分解、teacher forcing、困惑度                           ← 代码 03 演示 1、2
§7  采样新序列:温度;exposure bias;字符级 vs 词级;记忆 vs 泛化           ← 代码 03 演示 2–4
§8  梯度消失与梯度爆炸:同一个 W_aa 连乘;梯度裁剪                         ← 代码 04
§9  GRU:记忆单元与更新门;两种写法                                       ← 代码 02 演示 3
§10 LSTM:三个门;梯度高速公路;长程依赖实验;打开 GRU 看一看              ← 代码 02 演示 2、5;代码 05
§11 双向 RNN                                                              ← 代码 01 演示 5
§12 深层 RNN                                                              ← 代码 01 演示 4
§13–17  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 | 例子 / 形状 |
|---|---|---|
| 输入序列的第 个元素(尖括号上标 = 第几个时间步) | 第 个词的 one-hot 向量, | |
| 、 | 第 步的标签、预测 | |
| 、 | 输入、输出序列的长度 | “Harry Potter …” 的 |
| 、 | 第 个样本的第 步;第 个样本的长度 | 每个样本可以不一样长 |
| 第 步的隐藏状态(activation), | ||
| 、、 | 隐藏状态的参数:第一个下标是”算出什么”,第二个是”乘的是什么” | 、、 |
| 、 | 输出层的参数 | 、 |
| 左右拼起来的矩阵; 表示上下拼起来的向量 | ||
| 、 | 记忆单元(memory cell)、候选值(candidate) | GRU 里 |
| 更新门、相关门、遗忘门、输出门(gate),取值在 (0, 1) | 和 同形状 | |
| 逐元素相乘(Ng 在视频里写作 ) | numpy 的 * | |
| 、 | 第 步的损失;整个序列的损失 |
两套形状约定:Coursera 作业和本讲的 numpy 代码把一批序列存成 (样本按列,第 1 讲的约定,再加一维时间);PyTorch 的 batch_first=True 用 。两者差一个 transpose(1, 2, 0)(代码 02 演示 1)。代码里的下标从 0 开始:讲义的 是 x[:, :, 0]。
0.5 关于数字 · About the numbers
讲义里的实验数字都来自配套代码的实际输出:固定种子,PyTorch 在 CPU 上单线程运行,同一台机器上重复运行输出逐字相同(本讲没有计时类的数字)。数据全部是在代码里生成的:恐龙名来自手写的音节规则,“主谓一致”和”Teddy”两个任务来自小词表上的模板(rnn_data.py 开头写了全部规则)。好处是我们知道真相:能精确算出真实分布的困惑度,能判断一个采样出的名字是背下来的、符合规则的还是乱造的。有几处结果和我写代码前的预想很不一样(最明显的是 §8.3 的逐元素裁剪、§10.4 的”没有短句子就学不会”和 §10.5 的”门并没有关上”),讲义按实际结果来写,这些情况都列在代码 README 的”关于实验结果”里。
1. 为什么序列需要专门的模型 · Why sequence models?
1.1 七个例子
Ng 在 C5M1 的第一个视频里列了一串例子。代码 01 演示 1 把它们的 、 写成表:
| 任务 | 输入 | 输出 | 类型(§5) |
|---|---|---|---|
| 语音识别 | 一段音频(帧的序列) | 一句话(词的序列) | many-to-many(不等长) |
| 音乐生成 | 什么都不给,或一个风格编号 | 一串音符 | one-to-many |
| 情感分类 | 一段影评:“There is nothing to like in this movie.” | 1–5 颗星 | many-to-one |
| DNA 序列分析 | AGCCCCTGTGAGGAACTAG | 每个碱基是否属于某种区域 | many-to-many(等长) |
| 机器翻译 | 一个法语句子 | 一个英语句子 | many-to-many(不等长) |
| 视频动作识别 | 一帧一帧的图像 | “跑步” | many-to-one |
| 命名实体识别 | “Harry Potter and Hermione Granger invented a new spell.” | 每个词是不是人名 | many-to-many(等长) |
这些任务的共同点:数据有顺序,而且长度不固定。“狗咬人”和”人咬狗”用的是同样的字,意思完全不同;一段影评可以是 5 个词,也可以是 500 个词。
1.2 先试最简单的:全连接网络
我们已经会用全连接网络了(第 2–4 讲)。能不能把一句话的 个 one-hot 向量拼成一个长向量,直接喂进去?Ng 指出了两个问题。
问题一:输入输出的长度不固定。 全连接网络的输入维数是固定的。只能把每个句子补齐(padding)到某个最大长度 。代码 01 演示 1 算了一下:词表 10,000 个词、、第一层 100 个单元,光第一层就有 个参数;而且比 50 个词长的句子根本放不进去。
问题二:不同位置之间不共享学到的东西。 在拼起来的长向量里,“Harry 出现在第 1 个位置”和”Harry 出现在第 7 个位置”对应两组完全不同的权重。网络在第 1 个位置学到了”Harry 是人名”,对第 7 个位置毫无帮助——每个位置都要从头学一遍。
第二个问题你在第 12 讲见过:全连接网络处理图像时,同一个图案换个位置就要重新学。卷积的解决办法是同一个滤波器在每个位置滑动。RNN 的解决办法是同一个想法在时间上的版本:同一组参数在每个时间步重复使用。同样的例子里,RNN 的 、、 加起来只有 个参数,约为全连接网络第一层的 1/50,而且和句子多长无关。
2. 记号 · Notation
2.1 一句话怎样变成
Ng 的例子是命名实体识别(named entity recognition,NER):找出句子里的人名。
Harry Potter and Hermione Granger invented a new spell.
把每个词记作 ,,所以 。输出也是每个词一个: 表示这个词是人名的一部分。。对第 个训练样本,写成 和 ——不同的句子长度可以不同。
2.2 词表、one-hot、<UNK>、<EOS>
计算机不认识词,只认识数字。做法是先定一个词表(vocabulary):把常用词排个序、编上号。Ng 的例子是 10,000 个词(“a” 是第 1 个,“aaron” 第 2 个,……,“zulu” 是最后一个);实际系统常用三五万个,大公司有用到上百万的。然后每个词表示成一个 one-hot 向量:长度等于词表大小 ,只有这个词的编号那一位是 1。
代码 01 演示 2 用一个 22 个词的小词表把这句话编码出来(. 表示 0):
| 词 | 编号 | |||
|---|---|---|---|---|
| 1 | harry | 9 | .........1............ | 1 |
| 2 | potter | 15 | ...............1...... | 1 |
| 3 | and | 4 | ....1................. | 0 |
| 4 | hermione | 10 | ..........1........... | 1 |
| 5 | granger | 8 | ........1............. | 1 |
| 6 | invented | 12 | ............1......... | 0 |
| … | … | … | … | 0 |
两个特殊记号:
<UNK>(unknown):词表里没有的词一律换成它。“the egyptian mau is a breed of cat .” 在这个小词表下变成 “the<UNK><UNK><UNK>a<UNK>of<UNK>.”。<EOS>(end of sentence):加在句子末尾,语言模型(§6)要靠它学会”什么时候该停”。
one-hot 有一个明显的缺点:任何两个词的向量都正交,“cat” 和 “dog” 不比 “cat” 和 “spell” 更接近。第 16 讲会换成稠密的词嵌入。本讲的 PyTorch 代码在两个任务里用了 nn.Embedding,它在数学上等于”one-hot 向量 × 一个矩阵”,只是不真的造出 one-hot 向量。
2.3 一个 batch 的形状
一批 个句子要放进一个三维数组 :第 1 维是词表,第 2 维是样本,第 3 维是时间。句子不一样长时,短的在后面补 0。代码 01 演示 2 把三个长度为 9、10、9 的句子放进 X.shape == (22, 3, 10)。补齐的位置不能算进损失:代码 03 在 PyTorch 的交叉熵里用 ignore_index 把它们跳过(另一种做法是 pack_padded_sequence)。
3. 循环神经网络 · Recurrent neural network model
3.1 直觉:读一个词,更新一次记忆
你读这句话的时候,并不是把所有的字一起看,而是一个字一个字地读,脑子里保持着”到目前为止读到了什么”的印象,每读一个新字就更新一下。RNN 做的就是这件事:
           ŷ<1>          ŷ<2>          ŷ<3>                ŷ<T_x>
            ↑             ↑             ↑                    ↑
  a<0> → [ RNN ] → a<1> → [ RNN ] → a<2> → [ RNN ] → a<3> ··· [ RNN ]
            ↑             ↑             ↑                    ↑
           x<1>          x<2>          x<3>                x<T_x>
         (同一组参数 W_aa、W_ax、b_a、W_ya、b_y 在每一格里重复使用)
隐藏状态 就是那个”印象”:它是到第 步为止读过的全部内容的一个 维摘要。
3.2 前向传播
每一步做两件事:
通常取全 0。 通常是 tanh(偶尔用 ReLU); 取决于输出:二分类用 sigmoid,多分类用 softmax。和第 3 讲的隐藏层 相比,只多了一项 :上一步的隐藏状态被当作这一步的另一个输入。这一项就是”循环”(recurrent)的全部含义。
代码 01 演示 3 手算了一个 、、一个 sigmoid 输出的 3 步 RNN(参数和输入见代码):
| 1 | [0, 0] | [+1.000, −1.000] | [+1.000, −0.900] | [+0.762, −0.716] | 0.8143 |
| 2 | [+0.524, −0.210] | [0, +2.000] | [+0.524, +1.890] | [+0.481, +0.955] | 0.3835 |
| 3 | [+0.049, +0.430] | [+1.000, +1.000] | [+1.049, +1.530] | [+0.782, +0.910] | 0.4678 |
第 1 步 ,所以 只由 决定;第 3 步的 通过 、 依赖前三个输入。rnn_numpy.rnn_forward 算出的结果和手算的完全一样(差 0.0e+00)。
3.3 参数共享
上面那张表里,三步用的是同一个 、、、、。这个小 RNN 一共 13 个参数;代码让它分别处理长度 3、7、50 的序列,参数个数都还是 13。这就是 §1.2 那两个问题的答案:
- 序列多长都行:循环多走几步而已;
- 在第 1 步学到的”Harry 是人名”(体现在 里),在第 7 步自动可用。
和第 12 讲对照:卷积在空间上共享参数(同一个滤波器在每个位置滑动),RNN 在时间上共享参数。两者都把”同样的模式可能出现在任何位置”这个先验写进了网络的结构。
3.4 简写:
Ng 在视频里把公式写得更紧凑:
把两个矩阵左右拼成 ,把两个向量上下拼成 ,分块相乘正好是 。如果 、, 就是 。代码 01 演示 3 验证了第 2 步两种写法的结果完全相同。后面 GRU 和 LSTM 的门全都用这种写法。
3.5 和 PyTorch 的 nn.RNN 对照
代码 02 演示 1 把 nn.RNN 的参数拷进 numpy 版,在 float64 下对照:
| PyTorch 参数 | 形状 | 对应 |
|---|---|---|
weight_ih_l0 | ||
weight_hh_l0 | ||
bias_ih_l0、bias_hh_l0 | 两者相加 = |
形状和 Ng 的约定完全一样(行 = 输出单元)。唯一的区别是 PyTorch 有两个偏置(为了和 NVIDIA cuDNN 的实现一致,数学上是多余的)。对上之后,每一步的隐藏状态最大差 1.1e−16,只剩浮点舍入误差。
3.6 只看过去的局限
这种 RNN 在第 步只用到了 。Ng 的例子:
He said, “Teddy Roosevelt was a great President.” He said, “Teddy bears are on sale!”
读到 Teddy 时,单看前面的 “He said” 根本判断不了它是不是人名——答案在下一个词。§11 的双向 RNN 解决这个问题;代码 01 演示 5 会量出单向 RNN 在这种词上只有瞎猜的水平。
4. 沿时间反向传播 · Backpropagation through time
4.1 损失:每个时间步一份,加起来
以命名实体识别为例,每一步是一个二分类,用第 2 讲的交叉熵:
多分类时把每一步换成 softmax 交叉熵即可。
4.2 把 RNN 展开,就是一个深网
把 §3.1 那张图横着看:它就是一个 层的深网,第 层的输入是 和 。反向传播在这张展开的图上”从右往左”走,所以叫沿时间反向传播(backpropagation through time,BPTT,Werbos 1990)。名字听起来很厉害,其实它就是第 4 讲的反向传播,没有任何新东西。
一个 RNN 单元的反向(rnn_numpy.rnn_cell_backward):设 , 是损失对 的总梯度,那么
有两个”下游”:这一步的输出 ,以及下一步的 。所以 收到的总梯度是两路之和——rnn_backward 里的 da[:, :, t] + da_prevt。
请记住最后那个式子 :梯度每往过去走一步,就要乘一次 和 tanh 的导数。§8 的全部麻烦都从这里来。
4.3 参数共享 ⇔ 梯度求和
为什么 是""?代码 02 演示 4 用一个实验回答:在名字 “stegosaurus”(12 个时间步)上,给每个时间步一份独立的 副本。这就是一个普通的 12 层深网,每层有自己的权重,autograd 给出每份副本的梯度。把 12 份梯度加起来,和共享 的梯度最大差 3.3e−16。每份副本的梯度也和 rnn_cell_backward 在那一步算出的贡献一致(差 1.4e−16)。
所以参数共享在反向传播里的样子很简单:每一步各算各的贡献,最后加起来。演示 4 还打印了每一步的贡献大小: 的贡献恰好是 0——,而 也是全 0(语言模型的约定,§6.2)、初始化时 ,所以 ,前两步的 根本没起作用。
4.4 验证
同一个演示里,手写的 BPTT(lm_backward = 每一步的 + rnn_backward)和 PyTorch autograd 的最大差是 8.9e−16,和数值梯度的相对误差最大 5.8e−09(第 7 讲 §4.3 的标准:小于 1e−7 说明没写错)。LSTM 的 BPTT(lstm_backward)也和 autograd 对上了(代码 02 演示 5,最大差 4.4e−16)。
一个实践细节:截断 BPTT。 一本书有几十万个字符,不可能把整本书展开成一个几十万层的网络再反传。实践中把长序列切成一段段(比如 100 步),隐藏状态在段与段之间往前传,但梯度只在段内反传。这叫截断 BPTT(truncated BPTT)。代价是:模型很难学到跨度超过一段的依赖。
5. RNN 的类型 · Different types of RNNs
5.1 五种结构
§1.1 的七个例子里,输入和输出有的是序列、有的不是,序列的长度也不一定相等。Ng(借用 Karpathy 2015 博客里的图)把它们分成几类:
 one-to-one        one-to-many          many-to-one          many-to-many (T_x = T_y)    many-to-many (T_x ≠ T_y)
                     ŷ  ŷ  ŷ                    ŷ              ŷ  ŷ  ŷ  ŷ                          ŷ  ŷ  ŷ
     ŷ               ↑  ↑  ↑                    ↑              ↑  ↑  ↑  ↑                          ↑  ↑  ↑
    [ ]             [ ]→[ ]→[ ]        [ ]→[ ]→[ ]→[ ]        [ ]→[ ]→[ ]→[ ]        [ ]→[ ]→[ ]→[ ]→[ ]→[ ]
     ↑               ↑                  ↑   ↑   ↑   ↑          ↑  ↑  ↑  ↑            ↑   ↑   ↑   encoder | decoder
     x               x                  x   x   x   x          x  x  x  x            x   x   x
 普通网络          音乐生成             情感分类             命名实体识别            机器翻译
代码 01 演示 4 用 PyTorch 把它们都搭了出来( 个样本):
| 类型 | 例子 | 输入形状 | 输出形状 | 参数个数 |
|---|---|---|---|---|
| many-to-many() | 命名实体识别 | (4, 9) | (4, 9, 2) | 2,466 |
| many-to-one | 情感分类(5 档) | (4, 8) | (4, 5) | 2,565 |
| one-to-many | 音乐生成(3 种风格) | (4,) + 已生成的 | (4, 64, 50) | 7,346 |
| many-to-many() | 机器翻译(encoder–decoder) | (4, 6) | (4, 7, 60) | 13,340 |
| one-to-one | 普通的全连接网络 | (4, 10) | (4, 2) | 418 |
- many-to-many(等长):每一步都输出。第 5 讲 §5 的触发词检测也属于”逐步输出”的这一类:每个输出时间步给一个”刚才是不是说完了 activate”(作业里输入 5511 步、输出 1375 步,是先用一维卷积把时间分辨率降下来,再逐步输出,输出和输入在时间上仍是对齐的)。
- many-to-one:读完整个序列,只在最后一步输出。代码 05 的”主谓一致”任务就是这样。
- one-to-many:一个输入(或者什么都没有)决定初始状态,然后把上一步生成的东西喂回去,一步步生成。Coursera 的 Jazz 作业用 LSTM 生成爵士乐片段,用的就是这个结构,和 §7 的采样是同一个过程。
- many-to-many(不等长):先用一个 RNN(encoder)把整个输入读成一个向量,再用另一个 RNN(decoder)从这个向量出发生成输出。机器翻译的基本结构。第 16 讲会真正训练它,并加上注意力机制——让 decoder 不必把整句话压进一个向量。
6. 语言模型 · Language modeling
6.1 一个语言模型在做什么
语音识别系统听到一句话,可能拿不准是 “The apple and pair salad” 还是 “The apple and pear salad”——发音一模一样。Ng 的回答:让一个语言模型(language model)给两个句子打分,选概率高的那个。他在视频里给的例子是第一句约 、第二句约 (凭记忆复述,数量级是重点)。
语言模型的任务就是:给任意一个句子 ,算出它的概率 。今天的大语言模型,本质上也是这件事。
6.2 链式分解,以及 RNN 怎样算它
概率的链式法则把一个句子的概率拆成一串”下一个词”的条件概率:
这个等式不需要任何假设,永远成立。RNN 正好适合算右边的每一项:
- 第 1 步输入 ,输出 = softmax 给出的”第一个词是什么”的分布;
- 第 步输入上一个真实的词 ,输出 ≈ ——“到目前为止”的信息都在隐藏状态里;
- 句子最后一个目标是
<EOS>。
训练数据就是一大堆文本,标签不需要人标:每个位置的”正确答案”就是下一个词(第 1 讲 §3.6 说的自监督学习)。每一步的损失是 softmax 交叉熵 (给正确答案的概率取负对数),全句的损失是它们的和——恰好等于 。
Coursera 的 Dinosaur Island 作业做的是字符级的版本:词表是 26 个字母加一个换行符(换行符起 <EOS> 的作用),训练样本是一个个恐龙名。rnn_data.name_to_xy 照作业的写法构造输入和目标:
X = [None, d, i, n, o]          None → x<1> = 全 0 向量
Y = [d,    i, n, o, \n]         每一步的目标就是下一个字符
6.3 Teacher forcing
注意训练时第 步的输入是真实的上一个字符 ,不管模型上一步自己预测了什么。这种做法叫 teacher forcing(Williams & Zipser 1989):像老师手把手地纠正,每一步都从正确的位置继续。它让每一步的训练互相独立地有正确的上下文,训练又快又稳。代价在采样时才显现(§7.2)。
6.4 困惑度:一个语言模型有多好
衡量语言模型最常用的数是困惑度(perplexity):
也就是”平均每个字符的交叉熵损失”取 exp。直觉:如果模型每一步都在 个字符之间均匀地犹豫,困惑度就是 。所以困惑度可以读成模型平均在几个选项之间犹豫。一个什么都没学的模型(均匀分布)困惑度等于词表大小。
本讲的数据是用手写的音节规则生成的”恐龙名风格”的名字(rnn_data.py):名字 = 1–3 个音节 + 可选的连接字母 “o” + 一个后缀(saurus 最常见,还有 raptor、don、ceratops 等 12 种)+ 换行符;音节 = 声母 + 元音 + 可选的韵尾。训练集 1500 个、dev 集 500 个,平均 12.07 个字符,例如 teprardon、ladaraptor、saoraptor、megemimus。代码 03 演示 1 给出几个基线:
| 模型 | dev 困惑度(每个字符) |
|---|---|
| 均匀分布:每个字符概率 1/27 | 27.000 |
| 一元模型:只看字符频率 | 16.531 |
| 二元模型:只看前一个字符 | 7.584 |
| 真实分布(规则本身,任何模型的下限) | 3.478 |
最后一行是用合成数据才能得到的东西:因为规则是我们写的,可以精确算出每个名字在真实分布下的概率(dino_log_prob 用动态规划把所有生成方式的概率加起来)。名字本身就有随机性——下一个音节是什么本来就是抽签决定的——所以任何模型在这份数据上的困惑度都不可能低于 3.478。这和第 10 讲的 Bayes 误差是同一个概念。
6.5 复刻 Dinosaur Island
代码 03 演示 2 完全按 Coursera 作业的设定训练一个 numpy RNN(据作业的默认值:,每步一个名字,普通 SGD,学习率 0.01,逐元素裁剪到 ±5,35,000 步)。每 5000 步采样几个名字:
| 步数 | dev 困惑度 | 采样出的名字(前 4 个) |
|---|---|---|
| 1 | 26.927 | bfuobkldscjmkosygqrg, zhhxolt, sjbqyephtsevqrvk…, wchmvzsensariorrnnemclntj |
| 5000 | 4.311 | bosdon, sanspurdon, zantoroton, sasruraptor |
| 15000 | 4.068 | kobiorykon, theloceratops, kalosaurus, spephasteolonosaurus |
| 30000 | 3.965 | pholeraptor, stasosaurus, sonaodon, bezonbenosaurus |
| 35000 | 4.153 | spesaaorophuchus, trazuldon, disaurus, dinoosaurus |
一开始是乱码(困惑度接近 27);几千步后名字就以 saurus、raptor、don 结尾了——模型最先学会的是最常见、最长的固定片段,然后才是音节的拼法。每步只看一个名字,SGD 的噪声很大,10000 步以后的 dev 困惑度在 3.965–4.334 之间跳动;比二元模型(7.584)好得多,离下限 3.478 还有距离。
7. 采样新序列 · Sampling novel sequences
7.1 按分布抽,而不是取最大
训练好的语言模型可以用来生成。做法和 §6.2 只有一处不同:第 步的输入不再是真实的上一个字符,而是模型自己上一步抽出来的字符(rnn_numpy.sample):
- ,;
- 算出 ,按这个概率分布随机抽一个字符(
np.random.choice(vocab_size, p=ŷ)); - 把它的 one-hot 当作 ,重复,直到抽到换行符 /
<EOS>,或者长度到了上限(Ng 也提到可以拒绝<UNK>再抽一次)。
为什么要”抽”而不是每次取概率最大的那个?取最大值是确定性的:同一个模型永远生成同一个名字。按分布抽才能得到多样的结果。
温度(temperature) 给”多大胆”加了一个旋钮:采样前把 logits 除以 再做 softmax,。 放大差距(更保守), 缩小差距(更大胆), 就是模型本身的分布。代码 03 演示 4 用同一个 LSTM(§7.4 里 dev 困惑度最好的那个),每个温度采样 1000 个名字,按真实规则分类:
| 温度 | 背下来的(和训练集一模一样) | 新的、符合规则 | 违反规则 | 不同名字的比例 | 平均长度 |
|---|---|---|---|---|---|
| 0.5 | 0.049 | 0.921 | 0.030 | 0.938 | 12.08 |
| 0.8 | 0.029 | 0.836 | 0.135 | 0.987 | 12.08 |
| 1.0 | 0.022 | 0.667 | 0.311 | 0.996 | 12.33 |
| 1.5 | 0.004 | 0.288 | 0.708 | 0.991 | 12.95 |
时几乎不出错(违反规则的只有 3%),但更爱重复高概率的组合(thoraptor 出现了 5 次); 时几乎不重复,但七成名字违反了规则。没有哪个温度”最好”,它是”可靠”和”多样”之间的旋钮。今天的大语言模型也有这个参数,还有只在概率最高的一部分候选里抽的 top-、top-(nucleus sampling,Holtzman et al. 2020)。
7.2 Exposure bias:训练时没见过自己的错误
演示 2 的 numpy RNN 训练完后采样 1000 个名字:3.6% 和训练集一模一样,68.5% 是符合规则的新名字,27.9% 违反了规则。违反规则的名字往往是在中间某一步抽到了一个低概率的字符(比如一个不存在的辅音组合),然后模型要在一个它训练时从没见过的前缀上继续——teacher forcing 下,模型永远只见过正确的前缀。一步错,后面跟着错。这个训练与使用之间的错位叫 exposure bias。缓解它的方法之一是 scheduled sampling(Bengio et al. 2015):训练时逐渐用模型自己的预测替换一部分真实输入。
7.3 字符级 vs 词级
| 词级(word-level) | 字符级(character-level) | |
|---|---|---|
| 词表 | 几万到几十万,需要 <UNK> | 几十到一百多个,没有 <UNK> |
| 序列长度 | 短 | 长得多(一个词约 5 个字符) |
| 长程依赖 | 相对容易 | 更难:同样的内容跨更多步 |
| 训练成本 | 低 | 高 |
| 能生成的东西 | 只能组合词表里的词 | 能拼出新词、处理拼写错误、专有名词 |
Ng 的总结是:字符级模型更贵、更难捕捉长距离的关系,所以大多数 NLP 系统用词级;但在专门需要拼写的场合(比如恐龙名)它很合适。代码 03 演示 1 给了一个极端的例子:如果把”一个名字”当成一个词,dev 里 98% 的名字在训练集里没出现过,全是 <UNK>,这样的模型永远造不出新名字。今天的大语言模型用的是两者之间的折中——子词(subword)切分,比如 BPE(第 16、17 讲会提到)。
7.4 记忆 vs 泛化:模型是在学规律还是在背?
一个生成模型可能有两种”差”:乱造(违反规则)和复述(背下训练集)。代码 03 演示 3 训练一个 128 个单元的 LSTM(83,867 个参数,numpy RNN 只有 5,277 个),Adam 学习率 0.003,训练 100 个 epoch:
| epoch | 训练困惑度 | dev 困惑度 | 背下来的 | 新且合规 | 违反规则 | 不同名字 |
|---|---|---|---|---|---|---|
| 1 | 12.962 | 12.963 | 0.000 | 0.000 | 1.000 | 0.941 |
| 5 | 4.262 | 4.412 | 0.005 | 0.178 | 0.817 | 0.984 |
| 10 | 3.639 | 3.891 | 0.031 | 0.536 | 0.433 | 0.986 |
| 20 | 3.223 | 3.875 | 0.032 | 0.772 | 0.196 | 0.982 |
| 40 | 2.326 | 5.132 | 0.108 | 0.710 | 0.182 | 0.969 |
| 60 | 1.969 | 7.082 | 0.329 | 0.546 | 0.125 | 0.925 |
| 100 | 1.839 | 9.909 | 0.583 | 0.345 | 0.072 | 0.864 |
| 规则本身 | — | 3.478 | 0.022 | 0.978 | 0.000 | 0.992 |
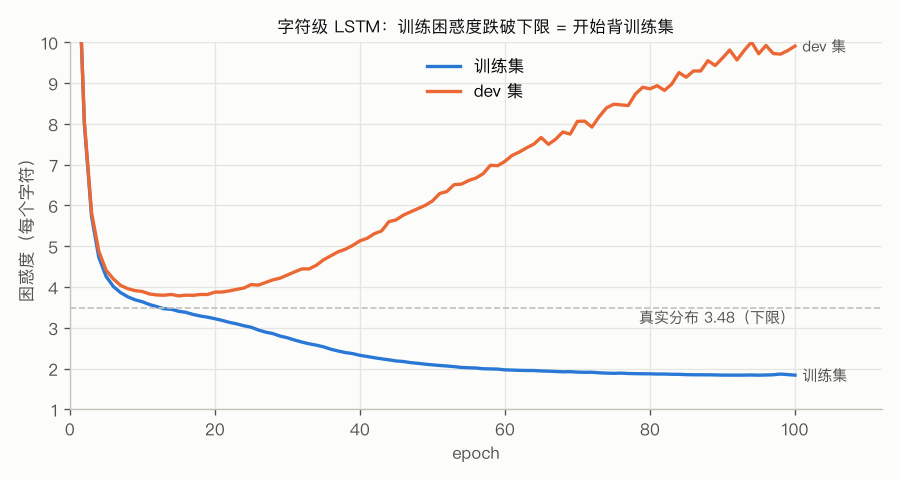
- dev 困惑度在第 15 个 epoch 最低(3.782),之后一路上升到 9.909;训练困惑度一直下降到 1.839。
- 关键的一条线是真实分布:它在训练集上的困惑度是 3.445。模型从第 15 个 epoch 起比它还低——比”知道真实规则”还会预测训练集。只有一种解释:模型在背训练集里的具体名字。这就是第 6 讲的过拟合,在语言模型里能看得特别清楚。
- 采样印证了这一点:100 个 epoch 后,58.3% 的采样名字和训练集一模一样。最后一行是用规则本身抽 1000 个名字,恰好和训练集重复的只有 2.2%——一个”学会了规则”的模型大约也应该是这个水平(第 15 个 epoch 的模型在 时正好是 0.022)。
dev 困惑度同时惩罚两种”差”,所以是挑模型的好指标:用它做 early stopping(第 6 讲),演示 4 用的就是第 15 个 epoch 的参数。
8. 梯度消失与梯度爆炸 · Vanishing & exploding gradients with RNNs
8.1 长程依赖,以及为什么 RNN 的梯度更糟
Ng 的例子:
The cat, which already ate an apple, a pear and a lot of fish, was full. The cats, which already ate …, were full.
用 was 还是 were,取决于很多个词以前的主语。这叫长程依赖(long-range dependency)。要学会它,损失在 was / were 处的梯度必须一路传回到 cat / cats 处,告诉那里的参数”该怎样改”。
第 7 讲 §2 已经看过:深网的反向传播是一串矩阵连乘,乘多了会指数式地变大或变小。§4.2 说过,RNN 展开就是一个深网,梯度每往回一步乘一次 :
但和普通深网有一个关键区别:每一”层”乘的是同一个 。这会更糟吗?代码 04 演示 1 比较了两种连乘,都用第 7 讲的”增益 = 1”初始化(每个元素方差 ,),各抽 200 次,看一个长度为 1 的向量乘了 次之后的长度:
| 步数 | 同一个 连乘(RNN):10% / 中位数 / 90% | 每层独立的 (普通深网):10% / 中位数 / 90% |
|---|---|---|
| 1 | 0.846 / 0.997 / 1.15 | 0.834 / 0.996 / 1.17 |
| 10 | 0.456 / 0.910 / 2.42 | 0.495 / 0.867 / 1.54 |
| 50 | 0.0467 / 6.44 / 556 | 0.132 / 0.445 / 1.49 |
| 100 | 0.0153 / 129 / 1.11e+06 | 0.0362 / 0.195 / 0.999 |
| 200 | 3.56e−04 / 2.65e+04 / 7.96e+12 | 3.77e−03 / 3.40e−02 / 0.372 |
每层独立时,200 步后 10%–90% 分位只差 2.0 个数量级:每层的随机性互相独立,好坏部分抵消——这正是第 7 讲方差保持初始化起作用的前提。同一个 连乘时差了 16.3 个数量级:有的 RNN 梯度缩到 3.56e−04,有的胀到 7.96e+12。原因是同一个矩阵乘很多次后,结果由它的谱半径 (最大的 |特征值|)决定,:200 个矩阵的 从 0.898 到 1.347, 和 的相关系数是 0.998。 是你抽到的那一个矩阵的属性,没有平均可言:,。
所以,同样深度下,RNN 的梯度问题比普通深网更难靠初始化解决:要控制的是 的谱半径,而训练会不断改变它。这个问题在 1990 年代就被认识到了(Hochreiter 1991 的毕业论文;Bengio, Simard & Frasconi 1994),比”深度学习”这个名字流行起来还早。
8.2 tanh 让它更偏向”消失”
代码 04 演示 2 构造 ( 是随机正交矩阵,所以每个特征值的模都恰好是 ),让损失只依赖最后一步,看梯度往回传 步还剩多少(,64 个样本平均):
| 模型 | ||||||
|---|---|---|---|---|---|---|
| 0.5 | 线性 | 0.5 | 3.12e−02 | 9.77e−04 | 9.54e−07 | 9.09e−13 |
| 0.5 | tanh | 0.333 | 3.93e−03 | 1.47e−05 | 2.44e−10 | 4.83e−20 |
| 1.0 | 线性 | 1 | 1 | 1 | 1 | 1 |
| 1.0 | tanh | 0.632 | 9.71e−02 | 1.03e−02 | 9.60e−05 | 7.61e−09 |
| 1.1 | 线性 | 1.1 | 1.61 | 2.59 | 6.73 | 45.3 |
| 1.1 | tanh | 0.669 | 0.174 | 2.95e−02 | 8.13e−04 | 7.07e−07 |
| 1.5 | 线性 | 1.5 | 7.59 | 57.7 | 3.33e+03 | 1.11e+07 |
| 1.5 | tanh | 0.878 | 0.538 | 0.303 | 8.90e−02 | 1.11e−02 |
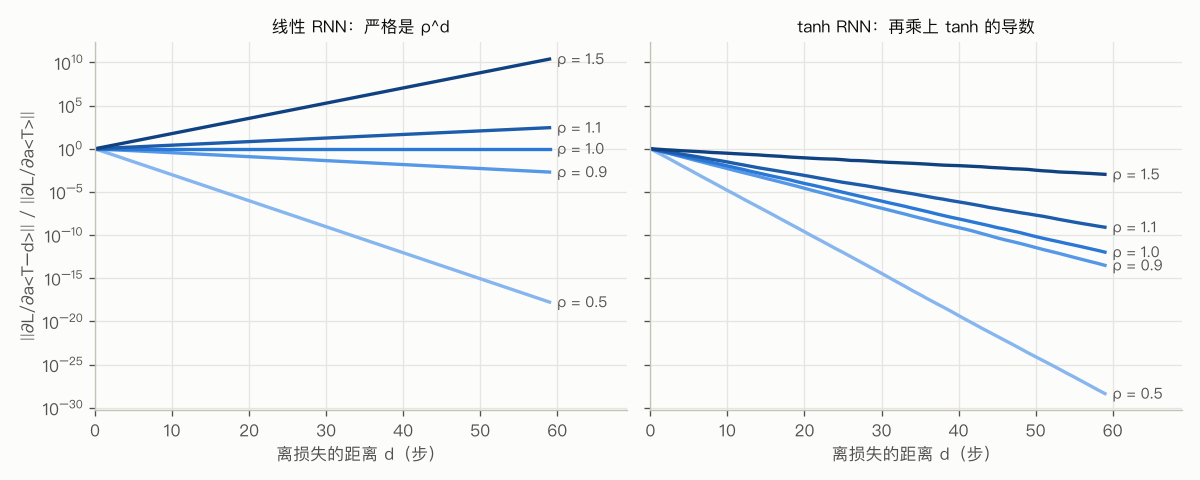
线性 RNN 严格按 变化。tanh RNN 每一步还要乘 tanh 的导数 (这里平均约 0.5),所以总是比线性的小; 时前向信号变大、tanh 更饱和、导数更小,两者一抵,线性时会爆炸的 、 在 tanh 下都变成了消失( 时平均每步约 ×0.89)。所以 tanh RNN 在初始化时的常态是梯度消失;爆炸更多发生在训练途中——参数跨过某个”悬崖”的那几步(Pascanu et al. 2013)。
梯度消失的后果:离损失 40 步的输入几乎收不到任何”该怎样改”的信号,模型就学不会 40 步以外的依赖。它不报错,只是安静地学不到——所以 Ng 说梯度消失比梯度爆炸更难发现、也更难对付。
8.3 梯度爆炸与梯度裁剪
梯度爆炸很容易发现:损失突然跳上去,参数里出现 inf / NaN(第 1 讲 §6.3 的”安静的 NaN”在这里同样要显式检查)。对策也简单——梯度裁剪(gradient clipping):梯度太大时把它缩小。两种做法:
- 逐元素裁剪(Coursera Dinosaur 作业的
clip):把每个元素截到 。 - 按整体范数裁剪(Pascanu et al. 2013;PyTorch 的
clip_grad_norm_):把全部梯度看成一个长向量 ,如果 ,就整体乘 。
区别在方向: 逐元素截到 ±5 变成 ,和原方向的余弦只有 0.891;按范数裁剪变成 ,方向不变,只是步子短了。
代码 04 演示 3 在恐龙名上用 numpy RNN 做了对照(每步一个名字,普通 SGD,10,000 步;“损失”是每个字符的平均负对数似然,瞎猜是 ):
| 学习率 | 种子 | 裁剪 | 最大梯度范数 | 后 1000 步的损失 | dev 困惑度 |
|---|---|---|---|---|---|
| 0.01 | 1 | 不裁剪 | 87 | 1.381 | 4.212 |
| 0.01 | 1 | 逐元素 ±5 | 210 | 1.383 | 4.173 |
| 0.01 | 1 | 按范数 5 | 238 | 1.597 | 5.197 |
| 0.05 | 1 / 2 / 3 | 不裁剪 | 20262 / 25124 / 498 | 4.957 / 6.803 / 5.199 | 77.0 / 505.9 / 136.8 |
| 0.05 | 1 / 2 / 3 | 逐元素 ±5 | 3621 / 151235 / 20140 | 4.499 / 3.177 / 4.019 | 36.2 / 21.6 / 60.7 |
| 0.05 | 1 / 2 / 3 | 按范数 5 | 130 / 248 / 244 | 1.375 / 1.388 / 1.370 | 4.313 / 4.280 / 4.302 |
几件事值得想清楚:
- 学习率 0.01(作业的设定)时,不裁剪也能训练。步子小,偶尔的大梯度造不成破坏。
- 学习率 0.05 时,不裁剪的三个种子都坏掉了:后 1000 步的损失比瞎猜还差。某一步的梯度范数到了几百甚至几万,参数被一下子推到很远的地方,之后再也回不来。
- 逐元素裁剪在这里挡不住。我原以为作业里的
clip至少能保住训练,结果三个种子的 dev 困惑度是 21.6–60.7。每个元素都不超过 5,但几千个元素合起来,整体步长仍然可以很大。 - 按范数裁剪三个种子都正常,后 1000 步的损失(1.370–1.388)和学习率 0.01 不裁剪时(1.381)差不多,而且前期下降得更快(前 1000 步 2.14–2.15 vs 2.57)。裁剪让更大的学习率变得安全。
- 但阈值不能太小:学习率 0.01 再加范数 5 的裁剪反而更差(dev 5.197)。这里每个名字的损失是求和,梯度范数天然就有几十,阈值 5 几乎每一步都在起作用(98% 以上的步),等于把学习率缩小了好几倍。阈值应该只拦住少数异常的步:常见做法是先不裁剪跑一段,看梯度范数的分布再定。PyTorch 里常见的 1–5 是在”损失按样本 / token 取平均”的前提下说的。
8.4 梯度消失怎么办
梯度爆炸有裁剪这个简单的补丁;梯度消失没有对应的”放大”补丁——你不知道该放大哪一部分。第 7 讲的初始化在这里帮助有限(§8.1)。真正的解决办法是改结构:给信息和梯度一条不必每步都乘 和 tanh 导数的路。这就是 GRU 和 LSTM。(第 13 讲的残差连接是同一个想法在深度方向上的版本:。)
9. 门控循环单元 · Gated Recurrent Unit (GRU)
9.1 直觉:一个记忆单元,加一个”写不写”的开关
Ng 讲 GRU 从一个简化版开始。还是 “The cat, which …, was full”:我们希望网络有一个记忆单元 (memory cell),读到 cat 时在里面记下”单数”,然后在 which 后面那一长串词里一直保持不变,直到用它决定 was。
简化的 GRU(Ng 的写法,):
- 是候选值:如果要改写记忆,打算写成什么。
- 是更新门(update gate):sigmoid 的输出,在 (0, 1) 之间,而且大多数时候很接近 0 或 1。 是希腊字母 G,代表 gate。
- 最后一行是一个加权平均: 时,用候选值覆盖记忆(读到 cat 时”写入”); 时,,记忆原样保留(在从句里”保持”)。
所有这些量都是向量, 逐元素相乘:每一维有自己的门,可以有的维度在记”单复数”、有的在记别的东西,各自决定什么时候更新。
9.2 完整的 GRU:再加一个相关门
完整的 GRU(Cho et al. 2014;Chung et al. 2014)在算候选值时多了一个相关门 (relevance gate,文献里多叫 reset gate):算新内容时,旧记忆有多”相关”?
研究者试过很多种门的组合。GRU 和 LSTM 是经过大量实验、被最广泛采用的两种;为什么偏偏是这几个门,并没有一个从第一性原理推出来的理由。
9.3 为什么门能对付梯度消失
看 对 的导数。最后一行里有一项 ,所以
第一项是一条加法的路:梯度沿它往回走,每步只乘 ,不乘 、也不乘 tanh 的导数。如果某一维的 ,100 步之后还剩 ;而一个每步乘 0.5 的 vanilla RNN 只剩 。门”关上”的维度,既能把信息保存很久,也能把梯度传很远。
9.4 同名不同式:Ng 的 GRU 和 PyTorch 的 nn.GRU
代码 02 演示 3 发现了一个容易踩的坑。PyTorch 的 nn.GRU 用的公式是:
和 Ng 的写法有两处不同:
- 相关门乘在哪里:Ng(以及 Cho et al. 2014 原文)先用 乘旧记忆、再乘矩阵;PyTorch(和 cuDNN)先乘矩阵、再乘 ——这样可以把 和其他门的矩阵乘法一起算,更快。用 Ng 的公式和
nn.GRU对照,状态差 0.232;换成 PyTorch 的写法(gru_cell_forward(..., reset_after=True)),差 1.1e−16。 - 更新门的方向相反:PyTorch 的 大 = 保留旧值,Ng 的 大 = 写入新值,。拷贝权重时取负号即可:。
两种写法的表达能力和效果通常差不多,但要在框架之间搬权重时,必须用同一种。
10. 长短期记忆 · Long Short-Term Memory (LSTM)
10.1 三个门,c 和 a 分开
LSTM(Hochreiter & Schmidhuber 1997)比 GRU 早十几年,也更”通用”一些。Ng 的写法:
和 GRU 比,三处不同:
- “写多少”和”留多少”分开:GRU 用 和 绑在一起;LSTM 用两个独立的门 、。它可以既保留旧记忆、又加进新内容。
- 多一个输出门:记忆 里有多少拿出来用,由 决定。所以 (内部的记忆)和 (对外的输出)是两个不同的状态,都要传到下一步。
- 门看的是 ,不是 。有一种变体让门也看 ,叫 peephole 连接(Gers & Schmidhuber 2000)。
一个历史细节:1997 年的原始 LSTM 没有遗忘门,记忆单元的自连接权重固定为 1(“constant error carousel”);遗忘门是 Gers, Schmidhuber & Cummins(2000)加上的,让网络能主动清空记忆。今天说的”LSTM”一般指带遗忘门的版本。
10.2 记忆单元是一条梯度高速公路
lstm_cell_backward 里最重要的一行是
从 传回 的梯度只乘一个门,不乘任何矩阵。对比 vanilla RNN 的 :每一步都要乘一次 。只要 接近 1,记忆和梯度都能沿着 这条”传送带”几乎无损地走很远。Ng 在视频里把 LSTM 的图画成一串单元,上面一条横线贯穿始终,说的就是这个。
10.3 和 nn.LSTM 对照:门的顺序
代码 02 演示 2:nn.LSTM 的 weight_ih_l0 形状是 ——四组权重按行叠在一起,顺序是 i、f、g、o(g 就是候选值 )。按正确的顺序拆开、再按 左右拼接,numpy 和 PyTorch 每一步的 最大差 8.3e−17。如果以为顺序是 f、i、g、o,程序照样运行、不报任何错,但隐藏状态差到 0.22;当成 i、o、f、g 则差 0.50。PyTorch 和 Keras 都是 i、f、g(c)、o,TensorFlow 1.x 的 LSTMCell 是 i、c、f、o,ONNX 是 i、o、f、c。迁移权重、读别人的代码时,门的顺序是头号陷阱。
10.4 实验:谁能记住主语?
前面讲的都是”门能够做到什么”。它们在实际训练中真的有用吗?代码 05 把 Ng 的 cat / cats 例子做成了一个玩具任务:
the cats , which today tree apple liked saw cats bird ,  →  were
the cat , which small old dogs with red horse small ,    →  was
“the + 主语 + , + which + 个随机词 + ,“,预测 was 还是 were。中间的词里约三分之一是 cat / cats 这样的名词,单复数随机——它们是干扰项。演示 1 显示,“看最近的名词”这个只有短期记忆的基线在 时准确率是 0.510 / 0.504 / 0.498 / 0.510,和瞎猜一样。要做对,模型必须在读到主语时把单复数存起来,并且在之后 个词里不让任何东西覆盖它。
演示 2:嵌入 16 维 → 循环层 32 个单元 → 线性层;每一步造一批新句子,间隔 在 之间随机;Adam 学习率 0.003,batch 32,1500 步,按范数裁剪到 1.0;每种设定 3 个种子。
| 单元 | 测试准确率(种子 0 / 1 / 2) | 学会 | 学会于(步) | 时的准确率 | |
|---|---|---|---|---|---|
| 10 | RNN | 1.000 / 1.000 / 1.000 | 3/3 | 300, 300, 200 | 1.000 / 1.000 / 1.000 |
| 10 | GRU | 1.000 / 1.000 / 1.000 | 3/3 | 200, 100, 200 | 1.000 / 1.000 / 1.000 |
| 10 | LSTM | 1.000 / 1.000 / 1.000 | 3/3 | 200, 200, 200 | 1.000 / 1.000 / 1.000 |
| 20 | RNN | 0.499 / 0.518 / 1.000 | 1/3 | —, —, 500 | 0.524 / 0.522 / 1.000 |
| 20 | GRU | 1.000 / 1.000 / 1.000 | 3/3 | 200, 200, 200 | 1.000 / 1.000 / 1.000 |
| 20 | LSTM | 1.000 / 1.000 / 1.000 | 3/3 | 300, 600, 200 | 1.000 / 1.000 / 1.000 |
| 40 | RNN | 0.514 / 0.491 / 1.000 | 1/3 | —, —, 400 | 0.522 / 0.500 / 1.000 |
| 40 | GRU | 1.000 / 1.000 / 1.000 | 3/3 | 600, 500, 500 | 1.000 / 1.000 / 1.000 |
| 40 | LSTM | 1.000 / 1.000 / 1.000 | 3/3 | 700, 700, 1100 | 1.000 / 1.000 / 1.000 |
| 80 | RNN | 0.522 / 0.485 / 0.494 | 0/3 | —, —, — | 0.488 / 0.510 / 0.506 |
| 80 | GRU | 0.528 / 1.000 / 1.000 | 2/3 | —, 1400, 1200 | 0.490 / 1.000 / 1.000 |
| 80 | LSTM | 0.536 / 0.536 / 0.491 | 0/3 | —, —, — | 0.480 / 0.484 / 0.498 |
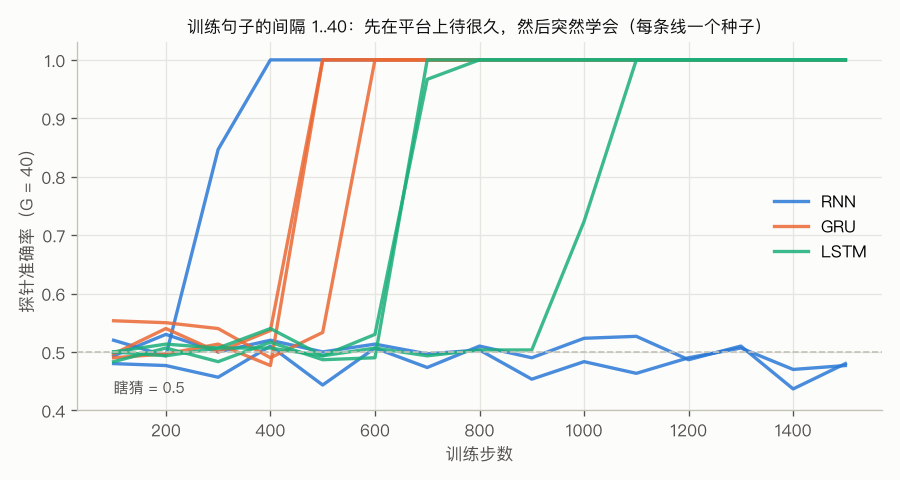
先别急着下结论,这张表有好几层:
- 门控单元确实能学会远得多的依赖:vanilla RNN 只在 时稳定学会,GRU 和 LSTM 到 40 都是 3/3。有意思的是, 时唯一学会的那个 RNN(种子 2)反而学得比所有门控模型都早(第 400 步,见上图):对 vanilla RNN 来说,学不学得会更像碰运气;门控单元的好处是每个种子都能学会。
- 没有中间状态:36 个模型里,测试准确率要么约 1.000,要么约 0.5,介于 0.6 和 0.95 之间的一个都没有。学习曲线(上图)是”在瞎猜的平台上待几百步,然后突然学会”。间隔越长,平台越长。
- 学会的模型都能推广到长得多的句子:最后一列,所有学会了的模型(包括 、40 时各自学会的那一个 vanilla RNN)在 上都是 1.000。所以 vanilla RNN 的问题不是表示不了长程记忆,而是梯度下降很难找到它。
- 门控也不是万能的: 时,1500 步的预算里 GRU 2/3、LSTM 0/3。
第 3 条和第 4 条合起来,指向”学习”而不是”表示”。演示 3 直接测了梯度:刚初始化时,损失传回主语处的梯度相对于传回最后一个词的梯度还剩多少(3 个种子的几何平均):
| 单元 | |||||
|---|---|---|---|---|---|
| RNN | 2.5e−03 | 6.2e−05 | 4.0e−08 | 2.1e−14 | 6.0e−27 |
| GRU | 1.2e−02 | 9.9e−04 | 7.4e−06 | 5.4e−10 | 4.0e−18 |
| LSTM | 1.1e−02 | 9.1e−04 | 6.9e−06 | 6.7e−10 | 9.9e−18 |
比值随间隔指数式下降(这就是 §8 的梯度消失,在真实任务里)。GRU / LSTM 在每个间隔上都比 RNN 大几个数量级——即使在初始化时门还没学会”关”(),§9.3 那条加法的路已经让梯度传得远得多。但 时它们也只剩 1e−10 量级:光靠初始化时的梯度,谁都学不会这么长的依赖。那它们是怎么学会的?
演示 5 给出了答案:把训练集换成”所有句子的间隔都是 20”(没有短句子),同样 1500 步:
| 单元 | 测试准确率(种子 0 / 1 / 2) | 学会 | 对照:间隔 1..20 混合时 |
|---|---|---|---|
| RNN | 0.504 / 0.516 / 0.509 | 0/3 | 1/3 |
| GRU | 0.525 / 0.496 / 0.514 | 0/3 | 3/3 |
| LSTM | 0.518 / 0.482 / 0.518 | 0/3 | 3/3 |
九个模型一个都没学会。混合长度时,短句子提供了”主语离答案很近”的容易的例子:模型先在短句子上学会”记住主语”,再把这个机制推广到长句子上;门控单元在中等长度上能拿到可用的梯度,所以推广得更远。只有长句子时,所有单元都卡在平台上。这和课程学习(curriculum learning,Bengio et al. 2009)的想法一致:门控让长程依赖更容易学到,但不保证一定学到;训练数据里有没有容易的例子同样重要。
训练之后再测同一个比值(演示 3(b)),结果反而很”奇怪”:学会了的 vanilla RNN 是 1.2e−35,学会了的 LSTM 是 1e−6 到 1e−5 量级,GRU 是 1.6e−03 到 0.50。学会了的模型,梯度不一定大。原因是:一个稳健的记忆(几十个干扰词都推不动它)必然对主语处输入的微小变化也不敏感,而”对微小变化不敏感”就是梯度小。Bengio, Simard & Frasconi(1994)证明的正是这一点:要在噪声中稳健地存住信息,系统就必须处在梯度会消失的区域。所以梯度消失真正的伤害发生在学会之前——那时需要靠梯度去找到记忆,信号却太弱。
10.5 打开 GRU 看一看:门真的”关上”了吗?
§9.1 的直觉图是:少数几个”记忆单元”的 在主语处打开、在从句里接近 0。代码 05 演示 4 打开了演示 2 里训练好的一个 GRU(,种子 0),在 1000 个 的句子上重算每一步的门(用 §9.4 的关系 ;重算的状态和 nn.GRU 的输出最大差 6.0e−07)。下表对全部 32 个单元平均:
| 位置 | 平均 | 平均 | 状态分离度 | 与 同号 |
|---|---|---|---|---|
| the | 0.371 | 0.235 | 0.000 | — |
| 主语 | 0.665 | 0.261 | 0.340 | 0.407 |
| , | 0.476 | 0.375 | 0.726 | 0.707 |
| which | 0.543 | 0.565 | 1.027 | 0.859 |
| 从句:干扰名词 | 0.493 | 0.884 | 1.747 | 0.964 |
| 从句:其他词 | 0.469 | 0.883 | 1.746 | 0.961 |
| 末尾的 , | 0.462 | 0.917 | 1.823 | 0.971 |
(“状态分离度”= 单数句和复数句的 之差的绝对值,每个单元算一次再平均。)
我原以为会看到那幅直觉图,实际上不是这样:
- 32 个单元全部记着单复数(最后一步的状态和标签的 |相关系数| 都 > 0.9),不是”少数几个记忆单元”。
- 从句里的平均 是 0.469 / 0.493,离 0 很远。如果只靠”少写”来保存,每步保留约 0.53,40 步后只剩约 1e−11,早就忘光了。
- 记忆靠的是最后一列:从句里候选值 和上一步状态同号的比例是 0.961。每一步”写进去的新内容”就是”原来的内容”:整个 32 维状态落进了两个稳定的点之一(单数一个、复数一个),干扰名词也推不动它(分离度 1.747)。这种记忆叫吸引子(attractor)。没有门的 vanilla RNN 要记住东西,也只能靠这种动力学——区别在于它能不能被梯度找到。
- 状态也不是在主语那一步一次写好的:分离度从主语处的 0.340 经过逗号(0.726)、which(1.027)逐步变大,进入从句后稳定在 1.75 左右。
所以,” 时记忆原样保留”是门控能够做到的事,它解释了梯度为什么能传得更远(演示 3);但训练出来的网络用什么办法记住信息,要打开看才知道。在更难、需要同时记很多东西的任务上,网络更可能用到”关门”的机制——Karpathy、Johnson & Fei-Fei(2015)在真实文本上就找到过一些可解释的 LSTM 单元(比如跟踪”是否在引号里”的单元)。这是第 21 讲”可解释性”的一个小预告。
10.6 GRU 还是 LSTM?
- 参数和计算量:同样 ,LSTM 有 4 组权重,GRU 有 3 组,vanilla RNN 1 组。代码 01 演示 4:、输入 16 维时分别是 6,400、4,800、1,600 个参数。
- 效果:大量对比实验没有发现谁全面胜出。Chung et al.(2014)在音乐和语音建模上发现两者都明显好于 vanilla RNN、彼此差不多;Jozefowicz, Zaremba & Sutskever(2015)发现把 LSTM 遗忘门的偏置初始化成 1 能缩小它和 GRU 的大部分差距;Greff et al.(2017)比较了 8 种 LSTM 变体,没有一种显著好于标准 LSTM,遗忘门和输出的 tanh 是最关键的部分。
- Ng 的建议:LSTM 历史更久、被验证得更充分,是更稳妥的默认选择;GRU 更简单、更快,更容易做大。实际项目里两个都试一下,用 dev 集说话(第 10 讲)。
- 今天在大多数 NLP 任务上,两者都已被 Transformer 取代(第 17 讲);但在流式(streaming)、低延迟、端侧的场合,以及作为很多新架构的灵感来源,循环结构仍然常见。
11. 双向 RNN · Bidirectional RNN
11.1 结构
回到 §3.6 的 Teddy。双向 RNN(bidirectional RNN,BRNN;Schuster & Paliwal 1997)用两个独立的循环层:一个从左往右读,得到 ;一个从右往左读,得到 。第 步的输出同时用两者:
于是第 步同时”看到了”过去和未来。注意这个图是无环的:两个方向各算各的,不需要互相等待。每个方向的单元可以是 RNN、GRU 或 LSTM;Ng 说在 NLP 里,“双向 + LSTM”一度是很常见的首选。PyTorch 里加一个参数 bidirectional=True,out 的最后一维变成 ,参数变成单向的 2 倍(代码 01 演示 4:12,800 vs 6,400)。
11.2 实验与代价
代码 01 演示 5 造了一个标注任务:每个句子 10 个词,里面插入一个两词短语——“模糊名 + 姓”(teddy roosevelt,标 1 1)、“模糊名 + 物品”(teddy bears,标 0 0)或”普通名 + 姓”(harry smith,标 1 1)。teddy、april、jordan 这些词是不是人名,只取决于下一个词。三个种子的平均:
| 模型 | 全部词的准确率 | 模糊名(teddy 等) | 其他词 |
|---|---|---|---|
| 单向 LSTM | 0.965 | 0.503 | 1.000 |
| 双向 LSTM | 1.000 | 1.000 | 1.000 |
| 单向 LSTM,晚一步回答 | 1.000 | 1.000 | 1.000 |
单向 LSTM 在模糊名上只有 0.503(瞎猜):读到 teddy 时它还没看到下一个词。在 “…teddy roosevelt…” 和 “…teddy bears…” 两个句子里,它给 teddy 是人名的概率都是 0.454——一模一样,因为它在那一刻看到的输入一模一样。双向 LSTM 给出 1.000 和 0.000。
第三行是一个折中:单向 RNN 多读一个词再回答(第 步输出第 个词的标签),模糊名也全对。它揭示了双向 RNN 真正的代价——延迟:
- “晚一步回答”的单向 RNN,延迟一个词;
- 双向 RNN 要等整个序列结束才能输出第一个标签。
Ng 的例子:做实时语音识别时,不能等说话人把一整段话说完才开始识别。所以实时系统常用单向模型,或者只往后看一小段的折中结构。离线任务(整篇文档已经在手里,比如命名实体识别、文本分类)则没有这个限制,双向几乎总是更好。
还有一类任务根本不能用双向:语言模型(§6)要预测的就是”下一个词”,如果模型能看到未来,任务就没有意义了。
12. 深层 RNN · Deep RNNs
把几个循环层叠起来:第 层在第 步的输入是第 层在第 步的输出和第 层自己上一步的状态:
每一层有自己的参数,但在时间上共享。代码 01 演示 4 里,nn.LSTM(16, 32, num_layers=L) 在 时分别有 6,400、14,848、23,296 个参数(第 2、3 层的输入是 32 维,所以每层多 8,448 个);out 只是最上面一层的输出,h_n 的第 0 维 = 层数 × 方向数。
和第 4 讲的深网不同,循环层通常不叠很多层。Ng 的说法是,三层就已经算很深了:每一层都要沿时间展开 步,网络在”时间 × 深度”两个方向上都很大,训练成本和梯度问题都会叠加。常见的做法是叠 2–3 个循环层,然后在每一步的输出上接几层不沿时间连接的全连接层。Graves 等人(2013)用深层双向 LSTM 在语音识别上取得了当时的最好结果,是这一结构的代表性工作。
13. 小结 · Summary
- 序列需要专门的模型,因为输入输出长度可变,而且同样的模式可能出现在任何位置。全连接网络补齐到最大长度既浪费(代码 01:5000 万 vs 101 万个参数),又不共享各位置学到的东西。
- RNN = 同一组参数在每个时间步重复使用:,;简写为 。numpy 版和
nn.RNN差 1.1e−16(PyTorch 多一个多余的偏置)。 - BPTT 就是在展开的图上做反向传播;损失对时间步求和,共享参数的梯度是各时间步贡献之和(代码 02:12 份副本的梯度之和 = 共享 的梯度)。
- RNN 的类型:many-to-many(等长 / 不等长 = encoder–decoder)、many-to-one、one-to-many、one-to-one。
- 语言模型: 的链式分解 + teacher forcing 训练;困惑度 = exp(平均每个字符的交叉熵)。合成恐龙名上,真实分布的困惑度 3.478 是任何模型的下限;LSTM 的训练困惑度跌破下限时,58% 的采样是背下来的训练名字。
- 采样:按分布抽、把输出喂回去;温度在”可靠”和”多样”之间取舍( 违反规则 3%, 是 71%);exposure bias;字符级没有
<UNK>、能造新词,代价是序列更长。 - 梯度消失 / 爆炸在 RNN 里更难对付:同一个 连乘,200 步后梯度大小跨 16.3 个数量级(独立矩阵只跨 2.0 个),由谱半径决定;tanh RNN 的常态是消失。按范数裁剪让学习率 0.05 的训练恢复正常,逐元素裁剪挡不住;阈值太小会拖慢训练。
- GRU:记忆单元 + 更新门(+ 相关门), 里的加法路径让梯度传得远。LSTM:更新门、遗忘门、输出门, 和 分开, 是梯度高速公路。PyTorch 的门顺序 i、f、g、o,
nn.GRU的公式和 Ng 的不同。 - 长程依赖实验:门控单元学会的距离远得多(:RNN 1/3,GRU、LSTM 3/3),学会的模型都能推广到 ;但 时门控也会失败,去掉短句子后谁都学不会。训练好的 GRU 没有”关门”,而是把状态”吸”到两个稳定点上。
- 双向 RNN 看得到未来(Teddy:0.503 → 1.000),代价是要等整个序列;深层 RNN 通常 2–3 层就够。
14. 常见误区 · Common pitfalls
- “RNN 每个时间步有自己的参数。” 不是。所有时间步共享同一组参数,这正是 RNN 能处理任意长度、能在不同位置共享知识的原因(§3.3)。反向传播时,共享参数的梯度要把各步的贡献加起来(§4.3)。
- “RNN 能记住任意长的历史。” 理论上隐藏状态可以携带任意久以前的信息,实际上梯度消失让它很难学会这样做(代码 05:vanilla RNN 在 时大多学不会)。要区分”能表示”和”能学到”。
- “有了 LSTM / GRU 就不怕长程依赖了。” 门控让学习容易得多,但不是无限的: 时 LSTM 0/3;训练数据里没有短句子时,三种单元在间隔 20 上都学不会(§10.4)。
- “梯度裁剪总是有益的,阈值随便设。” 阈值太小等于缩小了学习率(代码 04:学习率 0.01 加范数 5 的裁剪,dev 困惑度从 4.212 变差到 5.197);逐元素裁剪会改变梯度方向,而且在大参数量下可能挡不住爆炸。优先用按整体范数的裁剪,阈值参考正常训练时的梯度范数。
- “训练困惑度越低越好。” 训练困惑度低于数据本身的熵,说明模型在背训练集(代码 03:1.839 vs 下限 3.445)。看 dev 困惑度,并用它做 early stopping。
- “采样时取概率最大的字符就好。” 那样是确定性的,永远生成同一个结果,而且容易陷入重复。按分布采样,用温度控制大胆程度(§7.1)。
- “PyTorch 的 GRU / LSTM 就是视频里那几个公式。” 门的顺序(i、f、g、o)、两个偏置、GRU 的相关门位置和更新门方向都可能不同。拷贝权重时按错顺序不会报错,只会给出完全不同的数(代码 02 演示 2、3)。
- “双向 RNN 总是更好。” 只在整个序列都已经在手里时成立。实时任务要等整句话就不可接受;语言模型这类”预测下一个”的任务根本不能用双向(§11.2)。
- “训练好的门控网络一定是靠’关门’来记忆的。” 代码 05 的 GRU 用的是吸引子:门一直半开,候选值不断重写同样的内容(§10.5)。直觉图是机制的可能性,不是训练结果的保证。
15. 练习 · Exercises
练习 1(数参数)。词表 10,000 个词(one-hot 输入),输出也是 10,000 类的 softmax(语言模型),。分别算出 vanilla RNN、GRU(Ng 的写法,每个门一个偏置)、LSTM 的参数个数(都包括输出层)。哪一部分参数最多?
参考答案
vanilla RNN: 100 × 10,000 = 1,000,000; 100 × 100 = 10,000; 100; 10,000 × 100 = 1,000,000; 10,000。合计 2,020,100。
GRU:3 组 (每个 100 × 10,100)加 3 个偏置,,加输出层 1,010,000,合计 4,040,300。
LSTM:4 组,,加输出层,合计 5,050,400。
参数最多的是”和词表相连”的两块:输入矩阵(每组 1,000,000)和输出矩阵(1,000,000)。 只有 10,000。这也是为什么第 16 讲的词嵌入(把 10,000 维的 one-hot 先压成几百维)能省下大量参数。
练习 2(手算一个标量 RNN,以及梯度的衰减)。一个 的 RNN:,,输入 。(a) 算出 。(b) 算出 。(c) 每往回一步,梯度大约乘多少?为什么比 0.5 还小?
参考答案
(a) ,,,。输入的影响一步步衰减。
(b) 链式法则:;,三步分别是 0.4340、0.4838、0.4960。相乘得 (数值差分验证:0.043738)。
(c) 每步乘 :权重本身 0.5,再乘 tanh 的导数(≤ 1)。这就是 §8.2 表里 tanh RNN 总是比线性 RNN 衰减得更快的原因。
练习 3(困惑度)。(a) 一个模型在名字 “don” 上依次给出正确字符 d、o、n、换行符的概率 0.5、0.25、0.8、0.9。它在这个名字上的困惑度是多少?(b) 证明:均匀分布在 27 个字符上的困惑度正好是 27。(c) 代码 04 演示 3 里,学习率 0.01 不裁剪时后 1000 步”每个字符的平均损失”是 1.381。对应的训练困惑度大约是多少?
参考答案
(a) 。等价地,是四个概率几何平均数的倒数。
(b) 每个字符的概率都是 1/27,。所以”困惑度 = 在几个选项之间均匀犹豫”的读法在这里是精确的。
(c) 。(这是边训练边算的、按名字加权的平均,和演示里在 dev 集上算的 4.212 不是一回事,但量级一致。)
练习 4(两种裁剪)。梯度 ,阈值 。(a) 逐元素裁剪后是什么?范数是多少?和原方向的余弦是多少?(b) 按整体范数裁剪后是什么?(c) 如果学习率是 0.05,两种裁剪下这一步参数最多移动多远?
参考答案
(a) ,范数 ,余弦 。注意裁剪后的范数(7.81)甚至大于阈值 6。
(b) ,乘 :,范数正好 6,方向不变。
(c) 按范数裁剪:步长至多 ,和参数个数无关。逐元素裁剪:每个元素至多移动 0.3, 个参数时整体步长至多 ——代码 04 里 numpy RNN 有 5,277 个参数,这个上限约是 21.8。这就是逐元素裁剪在演示 3 里挡不住爆炸的原因。
练习 5(GRU 的梯度路径)。在简化 GRU 里,假设某一维的更新门在一段 100 步的从句里一直是 ,而且忽略经过 的那些项。(a) 主语处写入的值在 100 步后还剩多少?梯度呢?(b) 对比一个每步梯度乘 0.5 的 vanilla RNN。(c) 如果 呢?这说明门要关到什么程度?
参考答案
(a) ,只看第一项,100 步后保留 ; 也是 0.99,梯度同样剩约 0.366。
(b) ,相差 30 个数量级。
(c) :已经衰减得很厉害了。要跨 步传递,需要 不太小,即 。这也提醒我们:门”半开”(,代码 05 演示 4 里实际看到的值)根本不足以靠”少写”来保存信息,那个 GRU 一定在用别的机制(§10.5 的吸引子)。
练习 6(门的顺序)。nn.LSTM(16, 32) 的 weight_ih_l0 和 weight_hh_l0 形状各是多少?遗忘门的权重在哪些行?要拼出 Coursera 格式的 (形状是多少?),代码怎么写?
参考答案
weight_ih_l0:(128, 16);weight_hh_l0:(128, 32)。顺序是 i、f、g、o,每块 32 行,遗忘门是第 32–63 行(下标从 0 开始)。 乘的是 ,形状 (32, 48):
rows = slice(32, 64)
Wf = np.concatenate([Whh[rows], Wih[rows]], axis=1)   # 先隐藏部分、后输入部分,和 [a; x] 的顺序一致
bf = (b_ih[rows] + b_hh[rows])[:, None]
这正是 02_rnn_from_scratch.py 里 lstm_params_from_torch 做的事。
练习 7(先预测,再运行:裁剪阈值)。把 04_vanishing_exploding.py 演示 3 里”按范数 5”改成”按范数 50”(settings 里的 5.0 → 50.0)。先预测:学习率 0.01 和 0.05 时,结果分别会怎样?然后运行验证(约 45 秒)。
参考答案
我改代码运行了一次(不在脚本的默认输出里):
- 学习率 0.01:dev 困惑度 4.209,和不裁剪(4.212)几乎一样。阈值 50 很少起作用(这次运行里范数超过 100 的只有 3 步)。
- 学习率 0.05:三个种子 dev 困惑度 19.7、24.1、32.7,训练又坏掉了(虽然比不裁剪的 77–506 好一些)。
原因见练习 4(c):按范数裁剪限制的是每一步的步长 = 学习率 × 阈值。阈值 5 时步长至多 0.25,阈值 50 时至多 2.5——足够把参数推下”悬崖”。阈值和学习率要一起考虑。
练习 8(先预测,再运行:没有短句子、间隔 10)。在 05_gated_memory.py 里把演示 5 的间隔从 20 改成 10(demo_fixed_gap(10, ...),对照列需要演示 2 有 的结果,已经有了)。先预测三种单元各有几个种子能学会。如果 LSTM 的结果出乎意料,试着把它遗忘门的偏置初始化成 1 再训练一次(提示:bias_ih_l0 的第 32–63 个元素)。
参考答案
我改代码运行了一次(不在脚本的默认输出里),结果是 vanilla RNN 0/3、GRU 3/3、LSTM 0/3。间隔 10、只有一种长度时,GRU 能学会,LSTM 却和 vanilla RNN 一样卡住了。
把 LSTM 遗忘门的偏置初始化成 1(model.rnn.bias_ih_l0[32:64].fill_(1.0),同时把 bias_hh_l0 的这一段设成 0)之后,三个种子都学会了(测试准确率 1.000)。原因:PyTorch 默认把偏置初始化在 0 附近,遗忘门 ,记忆每步丢掉一半,刚开始训练时信息和梯度都传不远;偏置为 1 时 ,默认”多记住一些”。这是 Gers et al.(2000)就提过、Jozefowicz et al.(2015)系统验证过的技巧,很多框架和教程都推荐。
练习 9(哪些任务能用双向 RNN?)。(a) 给直播视频实时生成字幕;(b) 对已经存好的病历做命名实体识别;(c) 手机输入法预测你要输入的下一个词;(d) 给一整段影评打分。
参考答案
(a) 不适合完整的双向:必须等整段话结束才能输出,延迟不可接受。可以用单向模型,或”往后看一小段”的折中(类似代码 01 演示 5 的”晚一步回答”),用一点延迟换准确率。(b) 适合:整篇病历都在手里,没有延迟要求。(c) 不能用:任务本身就是预测未来,模型不能看到它要预测的东西(这是一个语言模型,§6)。(d) 适合:many-to-one,整段影评都在手里,双向编码通常更好。
练习 10(teacher forcing 与 exposure bias)。(a) 训练字符级语言模型时,如果不用 teacher forcing,而是把模型自己采样的字符喂给下一步,会遇到什么困难?(b) 代码 03 演示 2 的 numpy RNN,采样出的名字有 27.9% 违反规则。为什么这个比例比”每一步出错的概率”大得多?
参考答案
(a) 训练初期模型几乎在乱猜,喂回去的前缀全是乱码,后面每一步的”正确答案”都对不上这个前缀,学习信号很差、训练很慢;而且采样是不可导的,梯度传不过”抽签”这一步。teacher forcing 让每一步都在正确的前缀上学习,又快又稳。
(b) 一个名字有十几步,只要任何一步抽到一个低概率的错误字符,整个名字就违反规则;而且出错之后模型处在一个训练时从没见过的前缀上,后面更容易继续出错(exposure bias)。如果每一步独立地有 2% 的概率出错,13 步里至少错一步的概率就是 。
16. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C5M1 “Recurrent Neural Networks”(Andrew Ng)——本讲的主线;编程作业 Building your RNN – Step by Step、Dinosaur Island、Jazz Improvisation with LSTM。
- Karpathy, A. (2015). The Unreasonable Effectiveness of Recurrent Neural Networks.(博客)——CS230 Fall 2017 的推荐阅读;字符级 LSTM 生成莎士比亚、Linux 源码、LaTeX;§5 那张”RNN 的类型”图的出处。
- Goodfellow, Bengio & Courville (2016). Deep Learning, 第 10 章 “Sequence Modeling: Recurrent and Recursive Nets”。
- Olah, C. (2015). Understanding LSTM Networks.(博客)——LSTM 示意图最常被引用的版本。
RNN 与 BPTT
- Elman, J. L. (1990). Finding structure in time. Cognitive Science. ——“简单循环网络”(Elman network)。
- Werbos, P. J. (1990). Backpropagation through time: what it does and how to do it. Proceedings of the IEEE.
- Williams, R. J. & Zipser, D. (1989). A learning algorithm for continually running fully recurrent neural networks. Neural Computation. ——teacher forcing。
梯度消失、爆炸与裁剪
- Bengio, Y., Simard, P. & Frasconi, P. (1994). Learning long-term dependencies with gradient descent is difficult. IEEE Transactions on Neural Networks. ——“稳健地存住信息 ⇒ 梯度消失”(§10.4)。
- Pascanu, R., Mikolov, T. & Bengio, Y. (2013). On the difficulty of training recurrent neural networks. ICML. ——按范数裁剪、“悬崖”的几何图像。
LSTM 与 GRU
- Hochreiter, S. & Schmidhuber, J. (1997). Long short-term memory. Neural Computation.
- Gers, F. A., Schmidhuber, J. & Cummins, F. (2000). Learning to forget: Continual prediction with LSTM. Neural Computation. ——遗忘门。
- Gers, F. A. & Schmidhuber, J. (2000). Recurrent nets that time and count. IJCNN. ——peephole 连接。
- Cho, K. et al. (2014). Learning phrase representations using RNN encoder–decoder for statistical machine translation. EMNLP. ——GRU 和 encoder–decoder。
- Chung, J., Gulcehre, C., Cho, K. & Bengio, Y. (2014). Empirical evaluation of gated recurrent neural networks on sequence modeling. NIPS Deep Learning Workshop.
- Jozefowicz, R., Zaremba, W. & Sutskever, I. (2015). An empirical exploration of recurrent network architectures. ICML. ——遗忘门偏置初始化为 1。
- Greff, K. et al. (2017). LSTM: A search space odyssey. IEEE Transactions on Neural Networks and Learning Systems.
双向、深层、语言模型与采样
- Schuster, M. & Paliwal, K. K. (1997). Bidirectional recurrent neural networks. IEEE Transactions on Signal Processing.
- Graves, A., Mohamed, A. & Hinton, G. (2013). Speech recognition with deep recurrent neural networks. ICASSP.
- Mikolov, T. et al. (2010). Recurrent neural network based language model. Interspeech.
- Graves, A. (2013). Generating sequences with recurrent neural networks. arXiv.
- Karpathy, A., Johnson, J. & Fei-Fei, L. (2015). Visualizing and understanding recurrent networks. arXiv(ICLR 2016 workshop)。——可解释的 LSTM 单元。
- Bengio, S. et al. (2015). Scheduled sampling for sequence prediction with recurrent neural networks. NeurIPS. ——exposure bias。
- Holtzman, A. et al. (2020). The curious case of neural text degeneration. ICLR. ——top-(nucleus)采样。
- Bengio, Y., Louradour, J., Collobert, R. & Weston, J. (2009). Curriculum learning. ICML.
17. 下一讲预告 · Next lecture
第 16 讲:词嵌入、Seq2Seq 与注意力机制。 本讲的 RNN 把每个词当成一个孤立的 one-hot 向量,而且 encoder–decoder 只画了个结构。下一讲把这两块补上:
- 词嵌入(word embeddings):把 10,000 维的 one-hot 换成几百维的稠密向量,让 “cat” 和 “dog” 靠得更近;word2vec、负采样、GloVe;“man : woman = king : ?” 这样的类比;嵌入里的偏见与去偏。
- Seq2Seq:本讲 §5 的 encoder–decoder 真正训练起来,做”日期格式翻译”;条件语言模型、贪心解码 vs beam search,以及评估翻译质量的 BLEU。
- 注意力机制:encoder 把整句话压进一个向量,长句子会丢信息——让 decoder 每一步”回头看”输入的不同位置。这是从 RNN 走向第 17 讲 Transformer 的关键一步。