对应 Maps to:Coursera Deep Learning Specialization C4M3 “Object Detection”(Object Localization、Landmark Detection、Object Detection、Convolutional Implementation of Sliding Windows、Bounding Box Predictions、Intersection Over Union、Non-max Suppression、Anchor Boxes、YOLO Algorithm、Region Proposals、Semantic Segmentation with U-Net、Transpose Convolutions、U-Net Architecture Intuition、U-Net Architecture)和 C4M4 “Special Applications: Face Recognition & Neural Style Transfer”(What is Face Recognition?、One Shot Learning、Siamese Network、Triplet Loss、Face Verification and Binary Classification、What is Neural Style Transfer?、What are deep ConvNets learning?、Cost Function、Content Cost Function、Style Cost Function、1D and 3D Generalizations);编程作业 “Car Detection with YOLO”、“Image Segmentation with U-Net”、“Face Recognition”、“Art Generation with Neural Style Transfer”;Stanford CS230 Fall 2017 公开课件 Handout 6(课件标题 “CS230: Lecture 5 — Advanced Topics in Object Detection”,Kian Katanforoosh、Andrew Ng);CS230 Section 8(Advanced Evaluation Metrics:IoU、AP、mAP)。在 Fall 2025 的安排里,C4M3、C4M4 在 11/4 那一周(停课、期中考试)自学。 依据说明:Coursera 的视频和作业只对注册学员开放。本讲依据 Andrew Ng 在 C4M3、C4M4 里广为人知的讲法来写(例子里的网络形状、3×3 网格与 anchor 的 3×3×16、1D / 3D 卷积的形状都按公式重新算过),视频里的具体讲法是凭记忆复述的,细节可能和原视频略有出入。Fall 2017 的 Handout 6 是公开的 PDF,本讲用了它的提纲(检测直觉 → R-CNN → Fast R-CNN → Faster R-CNN → YOLO)和其中的公式。架构细节一律以原始论文为准(Sermanet et al. 2014;Redmon et al. 2016;Redmon & Farhadi 2017;Girshick et al. 2014;Girshick 2015;Ren et al. 2015;Ronneberger et al. 2015;Taigman et al. 2014;Schroff et al. 2015;Gatys et al. 2015;Zeiler & Fergus 2014),见 §16。原作业用 TensorFlow / Keras,本讲义用 PyTorch。 配套代码 Code:
code/lecture14/(numpy + PyTorch;5 个脚本 + 3 个模块。01 约 1 秒,02 约 55 秒,03 约 40 秒,04 约 40 秒,05 约 20 秒;02–05 都有--quick) 预计阅读时间:3.5–4 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 区分分类、定位、检测三个任务;写出定位网络的输出向量 和它的损失,说清楚为什么 时只罚 ;知道关键点检测(landmark detection)为什么要求标注的含义在所有图片里一致。
- 算出滑动窗口的计算量;把全连接层改写成卷积层,用一次前向完成所有窗口(OverFeat),并说出这样做”省多少”取决于什么。
- 讲清 YOLO 的网格编码:中心所在的格子负责;框相对格子参数化;输出张量 ;用 IoU 判断框对不对,用逐类的非极大值抑制去掉重复框;anchor boxes 解决”同一格两个物体”并提供形状先验。
- 手算一个类别的 AP 和 mAP(包括 IoU 阈值、重复框、插值的影响);说出 R-CNN → Fast R-CNN → Faster R-CNN 各自改进了什么。
- 写出转置卷积的输出尺寸 ,知道它为什么叫”转置”、棋盘格伪影从哪来;画出 U-Net,解释跳跃连接补上了什么(以及分割为什么看 mIoU)。
- 区分人脸验证与识别;用 one-shot learning 的问题设定解释为什么要学一个相似度函数 ;会用 Siamese 网络、triplet loss 或”在 上做逻辑回归”训练和部署人脸系统,知道为什么要提前算好数据库里的编码。
- 写出风格迁移的代价 ,用”浅层 = 局部纹理、深层 = 内容”解释内容层和风格层怎么选;知道 1D、3D 卷积分别用在哪里。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开 Previewed only |
|---|---|
| 第 12 讲:卷积、padding、stride、输出尺寸公式 ;平移等变与全局池化(§9) | 实例分割(Mask R-CNN)、全景分割、DETR 这类基于 Transformer 的检测器(§8 只点名;Transformer 见第 17 讲) |
第 13 讲:1×1 卷积(§4.1)、残差连接(§3)、迁移学习(§7)、shapes_world / transfer_kit | 可解释性:saliency、occlusion、CAM(第 21 讲;§11.1 只讲”找出最大激活的图块”) |
| 第 5 讲 §3–§4:人脸验证的”五问”、triplet loss(margin、semi-hard、坍缩)、风格迁移”优化输入而不是参数”、Gram 矩阵 | GAN 里的转置卷积生成器(第 18 讲) |
第 10 讲 §2:precision / recall、PR 曲线、AP;第 9 讲:softmax、torch_utils | 对比学习、CLIP 这类更一般的度量学习(第 5 讲 §3.6 已点名) |
第 5 讲已经用一个 100 维的”像素向量”世界讲透了 triplet loss,用固定的随机滤波器讲了风格迁移的核心想法。本讲不重复那些实验,而是在图像上、用卷积网络把它们真正搭起来,并补上第 5 讲没讲的部分:one-shot 的问题设定、把验证写成二分类、数据库部署、训练过的网络的特征(浅层 vs 深层)。
0.3 本讲地图 Map
§1  从分类到检测:三个任务;定位的输出与损失;关键点检测                    ← 代码 01 演示 1、代码 04 演示 1
§2  滑动窗口与它的卷积实现(OverFeat)                                      ← 代码 01 演示 2、代码 02 演示 1
§3  YOLO:网格、"中心所在的格子负责"、框的参数化
§4  IoU 与非极大值抑制                                                      ← 代码 01 演示 3、4
§5  Anchor boxes                                                            ← 代码 01 演示 5
§6  评估检测器:AP 与 mAP                                                    ← 代码 01 演示 6
§7  训练一个小 YOLO:损失、结果、anchor 的作用                               ← 代码 02 演示 2、3
§8  区域提议:R-CNN、Fast R-CNN、Faster R-CNN
§9  语义分割:转置卷积与 U-Net                                               ← 代码 03 演示 1、2
§10 人脸识别:验证 vs 识别、one-shot、Siamese、triplet、二分类、部署        ← 代码 04 演示 2–4
§11 神经风格迁移:深层 CNN 在学什么;内容代价;风格代价                       ← 代码 05
§12 1D 与 3D 卷积                                                           ← 代码 03 演示 3
§13–17  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4、第 12 讲 §0.4,本讲新增)
| 符号 | 含义 | 出现在 |
|---|---|---|
| “这里有没有物体”的概率(objectness) | §1.2、§3 | |
| ; | 框的中心;框的高和宽(定位里以整张图为单位,YOLO 里以格子为单位) | §1.2、§3.2 |
| ;; | 网格边长( 个格子);每格 anchor 个数;类别数 | §3、§5 |
| IoU | 交并比 | §4.1 |
| AP、mAP | 一个类别的 PR 曲线下面积;对类别取平均 | §6 |
| 人脸编码器(encoding) | §10 | |
| 相似度函数(“差异度”):越小越像;常用 | §10.2 | |
| (§10) | triplet loss 的 margin(和第 5 讲一致) | §10.3 |
| 、、(§11) | 风格迁移的内容图、风格图、生成图(和类别数 、网格 撞了名字,看上下文) | §11 |
| ; | 第 层的激活;它的 Gram 矩阵 | §11 |
| (§11) | 内容代价、风格代价的权重 | §11.2 |
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出。PyTorch 在 CPU 上单线程、固定种子,同一台机器上重复运行输出逐字相同;只有计时(代码 02 演示 1、代码 04 演示 4,以及代码 02 打印的训练用时)每次不同。数据全是合成的:32×32 的”街景”(球、车、人三类,scene_world.py)、32×32 的卡通人脸(face_world.py),风格迁移用第 13 讲在形状世界上预训练的小 CNN。网络都很小、训练都很短,数字只说明机制,不代表 COCO、LFW 上的大小。有好几处结果和我写代码前的预想不一样(最重要的两处:风格迁移的第一版满屏彩色噪点,改了三处设计;训练过的网络的深层特征反而比随机网络”记得”更少的布局),讲义按实际结果写,这些情况都列在代码 README 的”关于实验结果”里。
1. 从分类到检测 · Classification, localization, detection
1.1 三个任务
到第 13 讲为止,我们的网络都在回答一个问题:“这张图是什么?“——图像分类(image classification)。但很多应用要的不止这个:
| 任务 | 回答的问题 | 输出 |
|---|---|---|
| 分类 classification | 这张图里是不是车? | 一个类别 |
| 带定位的分类 classification with localization | 是车,车在哪里?(图里通常只有一个主要物体) | 类别 + 一个框 |
| 目标检测 object detection | 图里有哪些东西,各在哪里?(个数不定、类别可以不同) | 若干个(类别, 框) |
| 语义分割 semantic segmentation | 每个像素属于哪一类? | 和图一样大的类别图(§9) |
自动驾驶是 Ng 一直用的例子:车不只要知道”前面有行人”,还要知道行人在哪、离多远。检测之所以比分类难,是因为输出的个数不固定:一张图里可能有 0 个、1 个或者 20 个物体。这一讲的前半部分就是一步步解决这个问题。
1.2 定位:分类 + 回归
先从”图里最多一个物体”开始。Ng 的例子有四类:行人、汽车、摩托车、背景(什么都没有)。卷积网络最后不只接一个 softmax,而是输出一个向量:
- :图里有没有物体(是不是”背景”);
- :物体中心,:框的高和宽。约定图像左上角是 、右下角是 ;
- :是行人、汽车还是摩托车。
一张有车的图,标签大约是 ;一张只有背景的图,——问号不是 0,而是”没有定义”:图里没有车,“车的中心在哪”没有答案。所以损失要分情况:
代码 01 演示 1 把这个公式算了一遍:有车的图 8 项平方误差之和是 0.0308;背景图按正确的写法只罚 ,是 0.0100;如果偷懒把问号填成 0、8 项全算,就变成 1.3634,其中 1.3534 来自那 7 个”不关心”的数。这样写,梯度会逼着网络在每一张背景图上把框缩成 0——学一件毫无意义的事,还和”在有车的图上把框画准”争抢网络的容量。
实践中三部分常用不同的损失(Ng 在视频里也这样说): 用逻辑回归的交叉熵,框用平方误差,类别用 softmax 交叉熵。写成代码时用一个”掩码”:
这里乘的 是标签里的 0 / 1。Fall 2017 课件里 Fast R-CNN 的多任务损失 是同一个写法: 表示”真实类别不是背景()时才算框的损失”。
1.3 关键点检测 · Landmark detection
把”回归一个框(4 个数)“推广一下:网络可以回归任意多个点的坐标。人脸上标 64 个关键点(眼角、嘴角、下巴轮廓……),输出就是 个数(第一个数是”有没有脸”);人体姿态估计标肩、肘、腕、膝……的位置。用途很多:人脸对齐(把眼睛摆到固定位置再送进编码器,§10)、表情识别、AR 滤镜(在头顶戴一顶虚拟的帽子)。
代码 04 演示 1 在合成人脸上(face_world.py:身份决定五官的几何,姿态 / 光照 / 表情是干扰)训练一个小 CNN 输出 5 个关键点的 10 个坐标:
| 测试集上每个关键点的平均误差(像素,图 32×32) | 左眼 | 右眼 | 鼻尖 | 左嘴角 | 右嘴角 | 平均 |
|---|---|---|---|---|---|---|
| 永远猜训练集的平均位置 | 2.22 | 2.23 | 2.25 | 2.70 | 2.66 | 2.41 |
| CNN,标注一致 | 1.05 | 1.07 | 1.08 | 1.42 | 1.40 | 1.20 |
| CNN,一半训练图把左右眼标反 | 3.91 | 4.26 | 1.19 | 1.44 | 1.44 | 2.45 |
第三行是一个很实际的教训:关键点的编号在所有图片里必须有同样的含义(Ng:“第 1 个点永远是左眼的左眼角”)。一半的图把左右眼标反时,网络面对同一张脸收到两个互相矛盾的答案,平方误差最小的折中是”两只眼睛的中点”——眼睛的误差涨到 4 像素左右,接近两眼间距(7.65 像素)的一半;没标反的鼻尖、嘴角几乎不受影响。标注规范写不清楚,模型再好也没用。
2. 滑动窗口与它的卷积实现 · Sliding windows
2.1 最直接的检测器
有了分类器,最朴素的检测方法是滑动窗口(sliding windows):
- 用”裁得很紧”的小图训练一个分类器(车 / 不是车);
- 拿一个固定大小的窗口,从左上角开始,按一定步长滑过整张图,每个位置裁一块送进分类器;
- 换几个窗口大小,再滑一遍。
这个方法在深度学习之前就很流行(那时的分类器是线性模型 + 手工特征,跑得快)。换成 CNN 以后,它的问题是计算量:步长小,窗口多,慢;步长大,框不准。Fall 2017 课件的评语是:“far too many computations”。
2.2 算一笔账
代码 01 演示 2 逐层数了乘加次数(MACs,第 13 讲 §0.4)。Ng 的小分类器:14×14×3 → 5×5 卷积 16 个 → 2×2 池化 → 全连接 400 → 全连接 400 → 4 类;另一个例子是在 448×448 的图上用 224×224 的窗口、步长 32 跑 VGG-16:
| 网络与输入 | 窗口数 | 逐窗口:乘加 | 卷积实现:乘加 | 比值 |
|---|---|---|---|---|
| Ng 小网络,16×16(窗口 14,步长 2) | 4 | 1,766,400 | 1,459,200 | 1.21 |
| Ng 小网络,28×28(窗口 14,步长 2) | 64 | 28,262,400 | 21,273,600 | 1.33 |
| VGG-16,448×448(窗口 224,步长 32) | 64 | 990,096,916,480 | 69,299,077,120 | 14.29 |
“逐窗口”一列就是 §2.1 的做法:64 个 VGG-16 前向,约一万亿次乘加——只为了一张图。“卷积实现”是下一节的主角。
2.3 把全连接层改写成卷积层 · Convolutional implementation (OverFeat)
关键的观察(Sermanet et al. 2014,OverFeat):全连接层可以一字不改地写成卷积层。
- 第一个全连接层的每个单元看的是 5×5×16 = 400 个数(池化后的整个特征图)。这和”一个 5×5、16 通道的滤波器”做的事完全一样。所以 400 个单元 = 400 个 5×5×16 的滤波器,输出 1×1×400。
- 后面的全连接层,每个单元看的是前一层同一个位置的 400 个数 = 1×1 卷积(第 13 讲 §4.1)。
窗口分类器(14×14×3):
  14×14×3 ─CONV 5×5,16→ 10×10×16 ─POOL 2→ 5×5×16 ─"FC"=CONV 5×5,400→ 1×1×400 ─CONV 1×1,400→ 1×1×400 ─CONV 1×1,4→ 1×1×4
同一个网络,输入一张 28×28×3 的图:
  28×28×3 ─CONV 5×5,16→ 24×24×16 ─POOL 2→ 12×12×16 ─CONV 5×5,400→ 8×8×400 ─CONV 1×1,400→ 8×8×400 ─CONV 1×1,4→ 8×8×4
输入变大以后,网络的输出也从 1×1×4 变成了 8×8×4:输出的每个位置,恰好就是一个 14×14 窗口的分类结果(窗口的步长 = 池化的步长 2)。相邻窗口重叠区域上的卷积只算了一次,这就是省下来的部分。
为什么 Ng 的小网络只省了 1.33 倍,VGG-16 却省了 14.29 倍?代码 01 演示 2 顺便算了:Ng 的小网络里卷积层只占一个窗口计算量的 27.2%,72.8% 在三个”全连接”层;而全连接层是每个窗口各算各的,没法共享。VGG-16 的计算有 99.2% 在卷积层,几乎全部可以共享。省多少,取决于能共享的部分占多大。
2.4 实验:同一个函数,两种算法
代码 02 演示 1 在 14×14 的小图上训练了 Ng 的窗口分类器(323,620 个参数,4 类:背景 / 球 / 车 / 人;这个小任务太简单,测试准确率 1.000),然后把它的权重原样复制进全卷积版本,在一张 32×32 的街景上比较:
| 做法 | 结果 | 耗时(毫秒,每次运行不同) |
|---|---|---|
| 逐个窗口调用 100 次 | 10×10×4 | 3.34 |
| 把 100 个窗口拼成一个 batch | 10×10×4 | 0.89 |
| 全卷积:整张图一次前向 | 10×10×4 | 0.32 |
逐窗口和全卷积的 400 个输出最大相差 2.1e-14(float64 的舍入误差)——同一个函数,两种算法。输出的类别图(代码里打印成字符)还暴露了滑动窗口的两个老毛病:一个物体附近好几个相邻的窗口都报了它(重复检测,§4.2 的 NMS 要处理);只框住物体一部分的窗口会被认错(分类器在裁得很紧的小图上训练,没见过半个物体)。而且窗口的位置只能是 2 像素的整数倍、大小固定为 14——框画不准。下一节的 YOLO 让每个位置不只输出类别,而是直接回归一个框。
3. YOLO:每个格子直接回归框 · Bounding box predictions & YOLO
3.1 网格,以及”中心所在的格子负责”
YOLO(You Only Look Once,Redmon et al. 2016)的想法是把 §1.2 的定位和 §2.3 的卷积实现合在一起:
- 把图分成 个格子(Ng 的讲解用 3×3,实际用 19×19);
- 每个格子输出一个 §1.2 那样的 向量:;
- 一个物体只交给一个格子负责:物体中心落在哪个格子,就由哪个格子负责,即使物体横跨好几个格子。
整个网络是全卷积的,输出张量的形状是 :3×3 网格、3 个类别时是 3×3×8。和滑动窗口相比,YOLO 没有”窗口”,只有一次前向;每个输出位置的感受野覆盖了整张图(或很大一块),所以能看到物体的全貌。
为什么要规定”只由中心所在的格子负责”?如果让每个和物体重叠的格子都报这个物体,标签就是模糊的(四个格子都说”这是我的车”),训练时网络不知道该在哪里输出 。规定一个唯一的负责人,标签就确定了;剩下的重复框交给 NMS。
3.2 框怎样参数化
在 YOLO 里,框的坐标相对于负责的那个格子:
- :中心相对格子左上角的偏移,以格子边长为单位,所以在 里(网络里用 sigmoid 保证这一点);
- :以格子边长为单位,可以大于 1——物体比格子大是常事(网络里用 保证它是正数)。
代码 01 演示 5(a) 用 det_tools 的 yolo_encode 编码了 Ng 的例子(99×99 的图、3×3 网格、左右两辆车):
| 格子 | 类别 | |||||
|---|---|---|---|---|---|---|
| 行 1、列 0 | 1 | 0.667 | 0.667 | 0.909 | 0.545 | 车 |
| 行 1、列 2 | 1 | 0.424 | 0.515 | 1.030 | 0.606 | 车 |
| 其余 7 个 | 0 | ? | ? | ? | ? | ? |
右边那辆车比格子还宽()。编码 → 解码是精确可逆的(误差 0)。
3.3 一个格子只有一个 时的问题
如果两个物体的中心落在同一个格子里怎么办?一个 向量只能描述一个物体,另一个只能丢掉——在训练标签里就丢掉,网络连学的机会都没有。网格越粗,这种情况越常见。§5 的 anchor boxes 就是为了它。
4. IoU 与非极大值抑制 · IoU & non-max suppression
4.1 IoU:框对不对
检测器画了一个框,怎样判断它”对不对”?交并比(Intersection over Union):
两个框的交集也是一个矩形:左边界取两个左边界里大的,右边界取两个右边界里小的;如果”右 < 左”,交集为空(代码里的 max(·, 0))。并集 = 面积 1 + 面积 2 − 交集。常用的约定是 IoU ≥ 0.5 就算框对了。
代码 01 演示 3 让这个 0.5 变得具体(标注框 10×10):
| 预测框 | IoU |
|---|---|
| 完全重合 | 1.000 |
| 向右偏 0.2 个框宽 | 0.667 |
| 向右偏 1/3 个框宽 | 0.500 |
| 同心,边长 × 1.414(面积翻倍) | 0.500 |
| 同心,边长 × 0.5 | 0.250 |
| 向右下各偏一半 | 0.143 |
只沿一个方向偏 个框宽时,IoU ;同心缩放 倍时 IoU (练习 2)。0.5 其实挺宽松:偏 1/3 个框宽、面积大一倍都还算”对”。IoU 是相对的:大框偏 2 像素无所谓,小框偏 2 像素就是大错——这正是我们想要的。
IoU 在检测里有三个用处:评估(§6)、NMS(§4.2)、训练时把物体分给 anchor(§5)。
4.2 非极大值抑制:一个物体只留一个框
YOLO 的 19×19 个格子里,物体中心附近的好几个格子都可能觉得”这是我的”,于是同一辆车被报了好几次。非极大值抑制(non-max suppression, NMS)的规则很朴素:
- 先扔掉分数太低的框(YOLO 的分数 = 类别概率,Coursera 作业里叫
box_scores); - 在剩下的框里挑分数最高的,输出它;
- 删掉所有和它 IoU ≥ 阈值(常用 0.5)的框;
- 回到第 2 步,直到没有剩下的框。
而且要逐类做:Ng 讲 YOLO 算法时说的是”对每一个类别,单独做一遍 NMS”。代码 01 演示 4 手工构造了一组检测结果——两辆停得很近的车(真车之间 IoU 0.358)、一个骑摩托的人(人和摩托的框 IoU 0.529),各有几个重复框,外加一个低分的误检:
| 做法 | 保留几个框 | 结果 |
|---|---|---|
| 逐类 NMS,阈值 0.5 | 4 | 车 0.90、人 0.85、车 0.80、摩托 0.70 ✓ |
| 不分类别的 NMS,阈值 0.5 | 3 | 摩托被分数更高的”人”删掉了 |
| 逐类 NMS,阈值 0.3 | 3 | 两辆车被当成一辆,车只剩 1 个框 |
| 逐类 NMS,阈值 0.9 | 8 | 重复框删不掉,车剩 5 个框 |
不同类的物体重叠是正常的(人骑在摩托上、行人站在车前面),不应该互相抑制。阈值的选择是一个取舍:太低会把挨在一起的同类物体合并成一个,太高会留下重复框。拥挤场景(人群、停车场)是 NMS 的软肋。
5. Anchor boxes
5.1 一个格子,几个槽位
§3.3 的问题:Ng 的例子是一个行人站在一辆车前面,两个中心几乎重合,落在同一个格子里。anchor boxes 的做法:
- 事先定好 个形状(anchor),比如一个”高瘦”(像行人)、一个”矮胖”(像汽车);
- 每个格子不再只有一个 ,而是 个,每个 anchor 一个;输出从 变成 (Ng 的例子:3×3×2×8 = 3×3×16);
- 训练时,每个物体先找中心所在的格子,再找这个格子里和它形状最像(形状 IoU 最大)的 anchor,写进那个槽位。
“形状 IoU”只比形状、不比位置:把物体框和 anchor 框放在同一个中心算 IoU。代码 01 演示 5(b):车和两个 anchor 的形状 IoU 是 [0.907, 0.247],人是 [0.223, 0.902]——各去各的槽位,两个都保住了。没有 anchor 时写进去 1 个、丢掉 1 个(人)。
anchor 不是万能的:两辆车挤在同一格时,它们都分给”矮胖”那个 anchor,还是会丢一个;物体比 anchor 多时也一样。Ng 的说法是”这种情况算法处理得不好,但很少见”。到底多罕见?代码 01 演示 5(c) 在本讲的合成街景(32×32、4×4 网格、每格 8 像素)上统计了 2000 张图的 4008 个物体:
| 每格几个槽位 | 编码时写不进标签的物体 |
|---|---|
| B = 1(无 anchor) | 148 个(3.69%) |
| B = 2(矮胖 2.0×0.9、高瘦 0.8×2.0 个格子) | 74 个(1.85%) |
| B = 3(再加一个 1.4×1.4 的方形) | 39 个(0.97%) |
格子越细,撞车越少(练习 8: 时 B = 1 也只丢 0.35%)。真实的 YOLO 两样都用:Coursera 作业里输入 608×608,输出 19×19 个格子、每格 5 个 anchor、80 个类别,张量是 (19, 19, 5, 85)(Fall 2017 课件里也是这个数)。
5.2 anchor 还是一个形状先验
anchor 的另一个好处在 §7.3 的实验里看得更清楚:每个槽位只负责一种形状,网络只需要预测”相对这个 anchor 放大或缩小多少”(YOLOv2 里 ),而不是从零猜出宽高。怎样选 anchor?可以手选,也可以像 YOLOv2(Redmon & Farhadi 2017)那样,在训练集所有标注框的宽高上做 k-means(用 当距离),聚出 5 个最有代表性的形状。
6. 评估检测器:AP 与 mAP · Evaluating detectors
第 10 讲 §2.4 讲过 AP:把所有预测按分数排序,往下数,画 PR 曲线,算面积。检测的 AP 只多了一步:一个框算不算对(TP),要看它和某个同类标注框的 IoU ≥ 阈值,而且那个标注框还没有被分数更高的框”认领”过。没配上的框是 FP;没被任何框配上的标注框拉低 recall。这是 Pascal VOC 的规则,CS230 Section 8 讲的也是这一套。
代码 01 演示 6 手算了一个例子:3 张图、“车”这一类 4 个标注框,检测器给了 7 个框:
| 排名 | 分数 | 最大 IoU | TP/FP | precision | recall |
|---|---|---|---|---|---|
| 1 | 0.95 | 0.905 | TP | 1.000 | 0.250 |
| 2 | 0.90 | 0.768 | TP | 1.000 | 0.500 |
| 3 | 0.80 | 0.754 | FP | 0.667 | 0.500 |
| 4 | 0.70 | 0.000 | FP | 0.500 | 0.500 |
| 5 | 0.60 | 0.618 | TP | 0.600 | 0.750 |
| 6 | 0.40 | 0.640 | TP | 0.667 | 1.000 |
| 7 | 0.30 | 0.000 | FP | 0.571 | 1.000 |
几个值得停下来看的地方:
- 排名第 3 的框 IoU 0.754,却是 FP:它和排名第 1 的框指向同一辆车。所以没删干净的重复框会直接拉低 AP——NMS 是评估的一部分。
- 两种 AP:不插值(第 10 讲的写法);插值(Pascal VOC 2010 以后、COCO 的写法)先把 precision 换成”往后看的最大值” 再算面积,0.833。两个数不能混着比。
- IoU 阈值:同一组框,阈值提到 0.75 时 AP = 0.500;COCO 的主指标在 0.5, 0.55, …, 0.95 十个阈值上平均(AP@[0.5:0.95]),这里是 0.475。它奖励框画得准的检测器。
- mAP = 对每个类别算 AP,再取平均。“[email protected]”是 Pascal VOC 的主指标。
Fall 2017 课件还提到 Hoiem et al. (2012) 的检测器误差诊断:把 FP 分成定位不准(Loc)、和相似类别混淆(Sim)、和不相似类别混淆(Oth)、背景误检(BG)四类,分别统计——这正是第 10 讲 §6 的误差分析用在检测上。
7. 训练一个小 YOLO · Putting it together
7.1 损失
代码 02 的 TinyYOLO:32×32×3 → 三个 [3×3 卷积 → BN → ReLU → 2×2 池化] → 3×3 卷积 64 → 1×1 卷积,输出 4×4×B×(5 + 3)。最后一层的感受野 38 像素,比整张图还大。损失按 §1.2 的掩码写法,对每个格子、每个 anchor:
、 是 YOLOv1 论文的取值:绝大多数格子没有物体,不压低它们的权重,网络会倾向于”处处说没有”。宽高用对数:对数尺度上的误差约等于相对误差,大框、小框一视同仁(YOLOv1 用的是开平方,同一个想法)。B = 1 时也用一个”平均大小”的参照框 个格子,这样两个模型只差 anchor 的个数。训练循环直接用第 9 讲的 torch_utils.fit,只换了模型和损失。
7.2 结果
代码 02 演示 2:4000 张训练图、30 个 epoch,在 1000 张新图(1974 个物体)上:
| 指标(B = 1) | 数值 |
|---|---|
| [email protected](球 / 车 / 人的 AP:0.827 / 0.803 / 0.753) | 0.794 |
| [email protected] | 0.199 |
| mAP@[0.5:0.95](COCO 式) | 0.337 |
| 不做 NMS 时的 [email protected] | 0.790 |
| 训练集前 1000 张的 [email protected] | 0.948 |
分数 ≥ 0.3 的框里,配上标注框的那些平均 IoU 0.729、中心误差 1.07 像素、宽高的相对误差 10.3%;召回率 0.783。每张图的框数:网络输出 4×4×1 = 16 个 → 分数 ≥ 0.3 剩 2.00 个 → NMS 后 1.88 个(真实物体平均 1.97 个)。
- 一次前向就给出整张图的检测结果,[email protected] = 0.794。没有滑动窗口,也没有区域提议。
- 框”大致对、但不精确”:阈值从 0.5 提到 0.75,mAP 从 0.794 掉到 0.199。16 个”发言人”要从很大的感受野里回归出精确的坐标,不容易。
- NMS 在这里作用很小(0.790 → 0.794)。和我预想的不一样:这个检测器本来就很少给重复框,因为训练时每个物体只交给一个格子,邻居格子被明确地教成”这里没有物体”。网格更细、anchor 更多时(每个物体附近有几十个候选),NMS 才不可少。
- 明显的过拟合:训练集 0.948、测试集 0.794(第 6 讲的高方差)。4000 张图对检测来说很少;真实的检测器靠大数据集、数据增强和预训练的骨干网络(第 13 讲的迁移学习)。
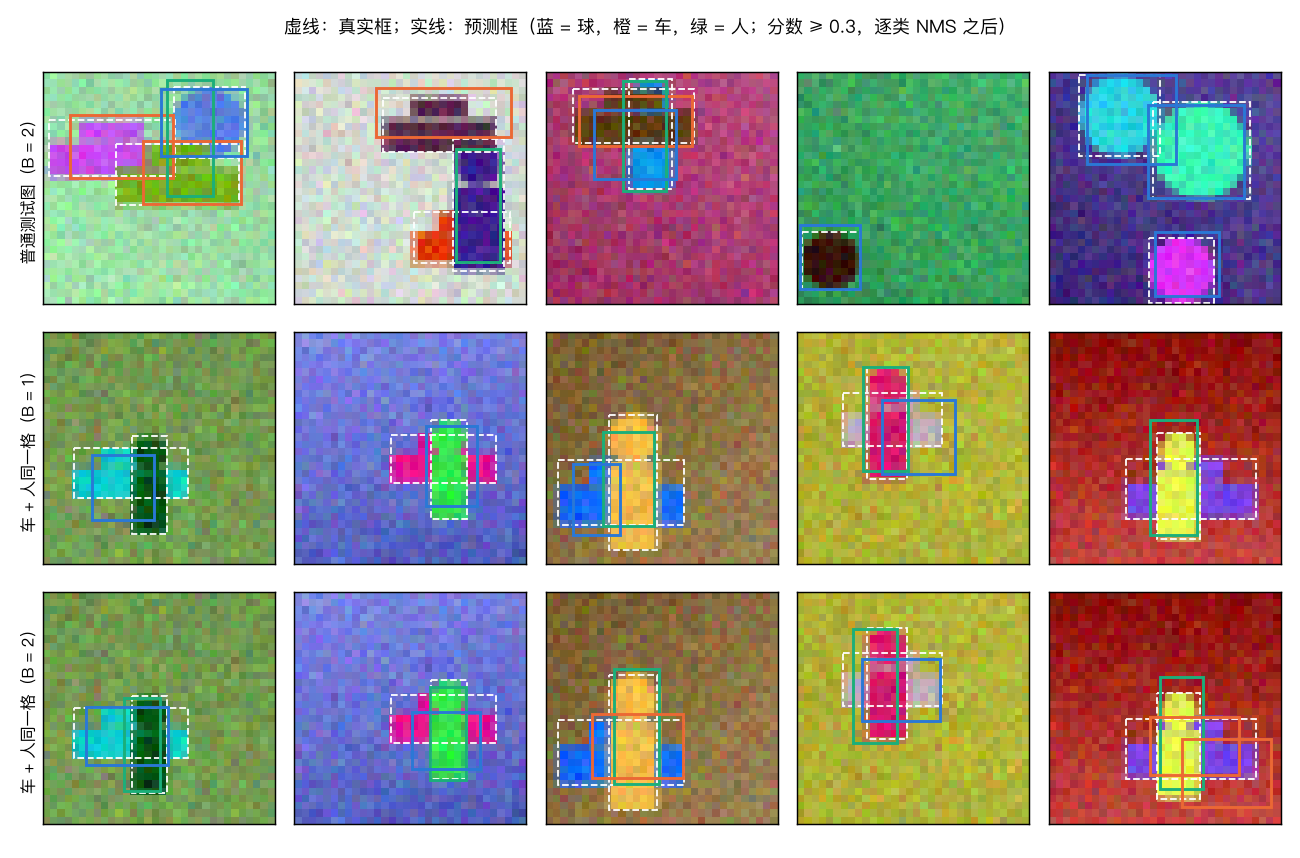
(第一行:普通测试图上 B = 2 的预测;第二、三行:同一批”车 + 人挤在同一格”的图,B = 1 和 B = 2。虚线是真实框。)
7.3 anchor 的作用
代码 02 演示 3 用同样的网络、同样的数据训练 B = 2(矮胖 / 高瘦两个 anchor;参数从 25,168 个变成 25,688 个,只有最后的 1×1 卷积变大了):
| [email protected] | AP 球 / 车 / 人 | [email protected] | COCO 式 | |
|---|---|---|---|---|
| B = 1 | 0.794 | 0.827 / 0.803 / 0.753 | 0.199 | 0.337 |
| B = 2 | 0.846 | 0.870 / 0.854 / 0.815 | 0.296 | 0.391 |
然后在”拥挤”测试图上比较(每张图两个物体,中心落在同一个格子里,各 300 张;分数 ≥ 0.3、IoU ≥ 0.5、类别对才算找到):
| 车 + 人:车 | 人 | 两个都找到 | 球 + 车:球 | 车 | 两个都找到 | |
|---|---|---|---|---|---|---|
| B = 1 | 0.167 | 0.550 | 0.007 | 0.193 | 0.740 | 0.007 |
| B = 2 | 0.493 | 0.877 | 0.410 | 0.170 | 0.707 | 0.003 |
- “车 + 人”:B = 1 时两个都找到的只有 0.007——一个格子只能报一个物体。B = 2 时 0.410:人去”高瘦”槽位、车去”矮胖”槽位。
- “球 + 车”:两者的形状都更接近”矮胖”那个 anchor,B = 2 也帮不上忙(0.003)。这就是 §5.1 说的”anchor 处理不好的情况”。
- 拥挤图里还有一个预想之外的难点:人站在车前面,把车身中间挡住了,车看起来像两块分开的色块,常被认成”球”(上图第二、三行的蓝框)。遮挡是真实检测里最难的问题之一。
- 普通测试图上 B = 2 也更好(0.846 vs 0.794),[email protected] 涨得更多(0.296 vs 0.199)。普通图里挤在同一格的物体只有几个百分点,多出来的槽位能解释的部分有限;一个可能的解释(没有专门验证)是 §5.2 的形状先验让宽高更好回归。
7.4 回顾:YOLO 的完整流程
和 Coursera 作业 “Car Detection with YOLO” 的流程一一对应:
- 训练:标注框 →
yolo_encode→ 的目标张量;网络输出同形状的张量;按 §7.1 的损失训练。 - 预测:一次前向 → 每个格子、每个 anchor 算出分数 类别概率 → 扔掉分数低于阈值的(作业里默认 0.6)→ NMS(IoU 阈值 0.5,最多保留 10 个框)。Ng 在视频里讲的是逐类做 NMS;据我记忆,作业里的实现为了简单把所有类别放在一起做,细节以作业为准。
- 评估:[email protected] 或 COCO 式的 mAP。
YOLOv1 在 Pascal VOC 上的速度是每秒 45 帧(更小的 Fast YOLO 每秒 155 帧),这是它当年最大的卖点:第一次让深度学习的检测”实时”了。
8. 区域提议:R-CNN 家族 · Region proposals
YOLO 是”一阶段”(one-stage)检测器。另一条路线是”两阶段”(two-stage):先找出可能有物体的区域,再逐个分类。Fall 2017 课件按时间顺序讲了这条线:
| 方法 | 区域从哪来 | 怎样分类 | 改进了什么 |
|---|---|---|---|
| R-CNN(Girshick et al. 2014) | selective search(一种基于图像分割的传统算法),每张图约 2000 个候选区域 | 每个区域缩放成固定大小,单独过一遍 CNN,得到 4096 维特征,再用每类一个 SVM 打分;框再做一次回归 | 第一次把 CNN 特征用到检测上,Pascal VOC 上大幅超过之前的方法;但 2000 次 CNN 前向,很慢,而且 CNN、SVM、框回归要分开训练 |
| Fast R-CNN(Girshick 2015) | 仍然是 selective search | 整张图只过一次 CNN,在特征图上用 RoI pooling 取出每个区域的特征(这正是 §2.3 的”共享计算”);softmax 分类 + 框回归,一个多任务损失(§1.2)一起训练 | 论文报告训练快约 9 倍、测试快约 213 倍(和 R-CNN 相比,用 VGG-16);瓶颈变成了 selective search 本身 |
| Faster R-CNN(Ren et al. 2015) | 区域提议网络(RPN):在同一张特征图上滑动,每个位置用 个 anchor(论文里 3 种大小 × 3 种长宽比 = 9 个)预测”是不是物体”和框的修正 | 同 Fast R-CNN | 区域提议也交给网络,和检测共享卷积特征;用 VGG-16 时约每秒 5 帧 |
两条路线的共同点比区别多:都在共享的卷积特征图上工作,都用 anchor,都用 IoU 和 NMS。Ng 在视频里的看法是:区域提议的想法很有意思,但他自己更常用 YOLO 这类一阶段的方法——“一步到位”更简单、更快。两阶段方法通常更准一些,尤其是小物体。后来的发展(SSD、RetinaNet 的 focal loss、Mask R-CNN 的实例分割、基于 Transformer 的 DETR)都在这两条路线上继续演化,本讲不展开。
9. 语义分割:转置卷积与 U-Net · Semantic segmentation with U-Net
9.1 每个像素一个类别
检测给每个物体一个框;语义分割给每个像素一个类别(道路、车、行人、天空……)。Ng 的例子:自动驾驶要知道哪些像素是可以开的路面;医学影像要圈出肿瘤的精确边界(框太粗了)。输出和输入一样大:,每个像素做一次 softmax。(“语义”分割不区分同一类的两个个体,两辆挨着的车是同一片”车”像素;区分个体的叫实例分割。)
问题是:分类网络一路把图缩小(32 → 16 → 8 → …),深处的特征”知道这是一辆车”,但分辨率很低;分割却要在原始分辨率上画出边界。所以需要一个把特征图放大回去的操作。
9.2 转置卷积 · Transpose convolution
普通卷积:每个输出像素 = 一个输入小方块和滤波器的点积。转置卷积反过来:每个输入像素拿着滤波器往输出上”盖一个章”(滤波器乘以这个像素的值),相邻输入像素的章错开 格,重叠的地方相加,最后从四周裁掉 圈:
正好是普通卷积 倒过来。注意 padding 在这里的意思是”从输出上裁掉”。
代码 03 演示 1 从零写了 conv_transpose2d_numpy,用一个和 Ng 的视频结构相同的例子(2×2 输入、3×3 滤波器、、,数字是本讲自己选的):不裁边的画布是 5×5,裁掉一圈得到 3×3;视频里画出的输出(凭记忆)是 4×4,按 PyTorch 的约定那要再加 output_padding = 1(在下边、右边多留一行一列)。不同的书和框架对”padding”的画法不完全一样,对不上时先用公式算一下尺寸。五组随机的多通道配置下,numpy 和 nn.ConvTranspose2d 逐数字相同(差 1e-16 量级)。
为什么叫”转置”? 把普通卷积写成一个矩阵 (输入拉平成向量,),转置卷积就是用 去乘。演示 1(c) 检查了 (两边都是 −0.728941),而且 autograd 算出的 和 完全相同——转置卷积就是卷积层反向传播时”把梯度传回输入”的那一步(第 12 讲 §10 的 dA_prev)。所以它不是卷积的”逆”:它恢复的是形状,不是原来的数值。
棋盘格伪影:演示 1(d) 用全 1 的输入和全 1 的滤波器数了每个输出像素被”盖到”几次。、 时是 1、2、4 交替的格子花纹——即使输入是常数,输出也不均匀;、(核是步长的整数倍)时内部均匀。生成图像时这会留下”棋盘格伪影”(Odena et al. 2016);常见的替代做法是”先最近邻 / 双线性放大,再做普通卷积”。
9.3 U-Net:编码器、解码器与跳跃连接
U-Net(Ronneberger et al. 2015,最初用于生物医学图像)的形状像一个 U:
  输入 h×w×3                                                      输出 h×w×n_classes
  [conv]×2 ─────────────────── 拼接(跳跃连接)──────────────→ [conv]×2 → 1×1 conv
     ↓ max pool                                                   ↑ 转置卷积(放大 2 倍)
  [conv]×2 ─────────────────── 拼接 ──────────────────────→ [conv]×2
     ↓ max pool                                                   ↑ 转置卷积
…… 瓶颈:分辨率最低、通道最多 ……- 左边(编码器):和普通分类网络一样,卷积 + 池化,越来越小、通道越来越多——学”这是什么”。
- 右边(解码器):转置卷积把特征图一级级放大回去。
- 跳跃连接(skip connections):把编码器同一分辨率的特征图直接拼(concatenate)到解码器上。深层负责”这是什么”,浅层负责”边界在哪个像素”。
- 最后一个 1×1 卷积把每个像素的特征变成 个分数(第 13 讲:1×1 卷积 = 每个像素上的全连接层)。
原论文用 valid 卷积,编码器的特征图比解码器的大,拼接前要裁剪(输入 572×572、输出 388×388);现在的实现多用 same 卷积,尺寸正好对齐。跳跃连接和第 13 讲的残差连接是同一类想法:给信息开一条近路——残差是相加,U-Net 是拼接(更像 DenseNet)。
9.4 实验:跳跃连接到底帮了什么
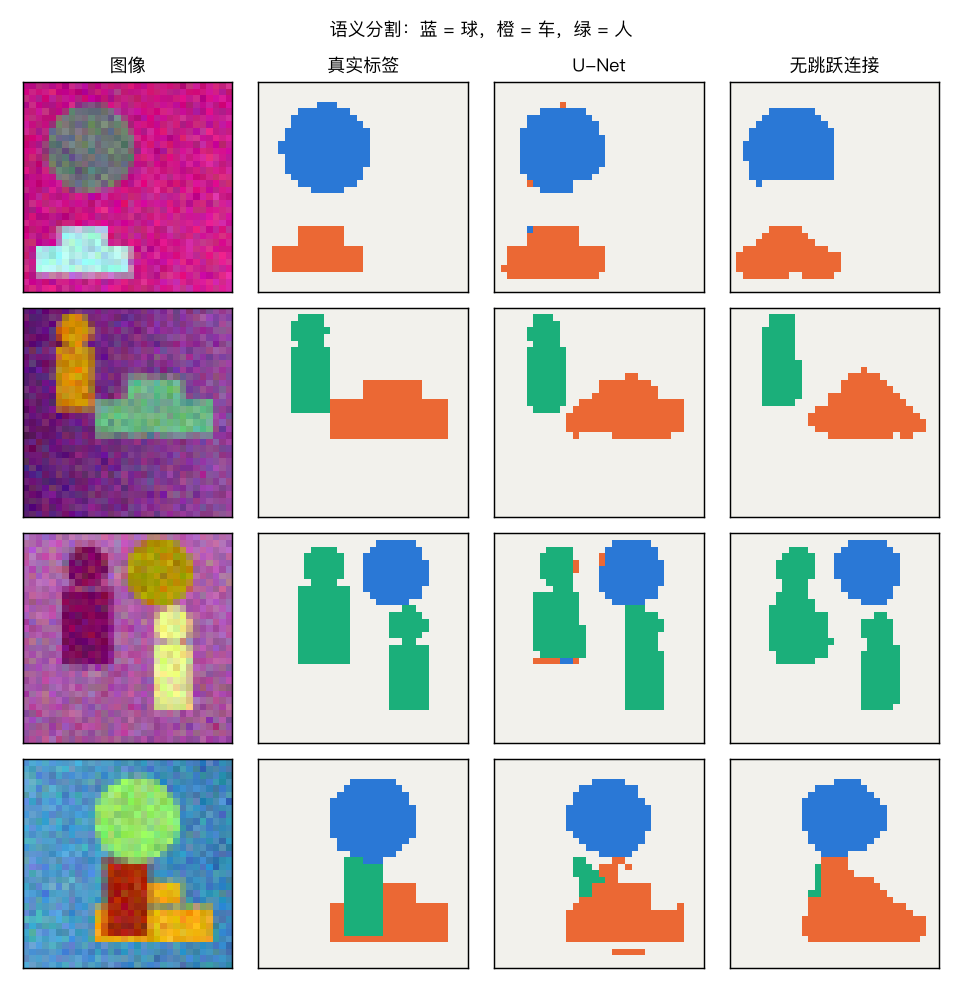
代码 03 演示 2 在合成街景的逐像素标签上(2000 张训练图、500 张测试图、4 类,8 个 epoch)比较一个两级的小 U-Net 和去掉两条跳跃连接的同一个网络:
| 模型 | 参数 | 像素准确率 | mIoU | IoU 背景 / 球 / 车 / 人 | 边界像素 | 内部像素 |
|---|---|---|---|---|---|---|
| 全猜背景 | — | 0.823 | 0.206 | 0.82 / 0.00 / 0.00 / 0.00 | 0.494 | 0.872 |
| U-Net(有跳跃连接) | 57,188 | 0.972 | 0.849 | 0.98 / 0.80 / 0.81 / 0.81 | 0.858 | 0.990 |
| 编码器–解码器(无跳跃连接) | 45,668 | 0.962 | 0.815 | 0.96 / 0.80 / 0.77 / 0.73 | 0.773 | 0.990 |
(“边界像素”:上下左右四个邻居里有别的类别的像素,占测试集的 13.1%。)
- 先看第一行:背景占 82.3% 的像素,“全猜背景”的像素准确率就有 0.823,mIoU 只有 0.206。和第 10 讲的类别不平衡一样,分割要看 mIoU(每类的 IoU 再平均;IoU 的公式和检测一样,只是对象换成了像素集合)。
- 两个模型在物体内部一样好(都是 0.990),差别全在边界上:0.858 vs 0.773。没有跳跃连接时,所有信息都要穿过 8×8 的瓶颈,“边界在第几个像素”在下采样时已经丢了,放大回去只能画出圆滑的轮廓——下图最右一列的物体都变成了圆角的”团”。
- U-Net 多了 11,520 个参数(解码器卷积多出的输入通道,正是用来读跳跃连接的)。我们没有做”参数一样多”的对照;但内部准确率相同、只有边界不同,说明差距来自”边界的细节”,而不是整体的拟合能力。
CS230 Section 7(公开网页)的调试练习用的正是一个 U-Net 分割代码库:图里有重叠的圆、三角、方块,每类一个输出通道、逐像素 sigmoid。这一节的代码可以当作它的一个小号版本。
10. 人脸识别 · Face recognition
第 5 讲 §3 用”学校门禁”的案例讲了为什么要学一个编码、怎样用 triplet loss 训练它(margin、semi-hard 挖掘、只拉近不推开会坍缩),那里的数据是 100 维的向量。这一节在图像上用卷积编码器把系统搭起来,并补上 C4M4 的另外几块。
10.1 验证 vs 识别
- 人脸验证(verification):输入一张照片和一个身份(姓名 / ID),输出”是不是这个人”。一对一。
- 人脸识别(recognition):输入一张照片,输出”这是数据库里 个人中的谁”(或者”都不是”)。一对多。
识别比验证难得多。Ng 的说法:一个 99% 准确的验证系统,放到 100 个人的识别里就不够用了——每次识别要和 99 个”别人”比较,每次都有机会认错(练习 9:假设每次和别人比较有 1% 的概率误判为同一人,99 次里至少错一次的概率是 63%)。所以识别系统需要的验证准确率要高得多。
10.2 One-shot learning 与相似度函数
人脸识别的真正难点是 one-shot learning:数据库里每个人往往只有一张照片(员工证、学生证照片),却要在以后认出他。
最直接的想法是把它当成 类的分类问题:每个人一类,输出层一个 维 softmax。代码 04 演示 2(a) 试了:100 个新同学、每人 1 张注册照,用这 100 张图训练一个 100 类的 CNN。它把训练集背得滚瓜烂熟(训练准确率 1.000),在同一批人的其他照片上只认对 0.032(瞎猜是 0.01)。而且每来一个新同学都要改输出层、重新训练。
换个思路:不学”这是谁”,而学一个相似度函数
有了 ,验证就是比一次;识别就是和数据库里每个人比一次,取最小的(如果最小的也大于 ,就是”不认识”)。新同学入学只需要存一张照片,不用重新训练任何东西。剩下的问题是: 从哪来?
10.3 Siamese 网络与 triplet loss
DeepFace(Taigman et al. 2014)的做法:用一个卷积网络把每张脸编码成一个向量 (FaceNet 是 128 维),然后
两张图过的是同一个网络(共享参数)——“孪生网络”(Siamese network)就是这个意思,最早用于签名验证(Bromley et al. 1993)。训练目标:同一个人, 小;不同的人, 大。第 5 讲 §3.4 推导过 triplet loss(Schroff et al. 2015,FaceNet):
以及两个”网络会钻空子”的细节:margin 防止所有编码挤成一点;编码归一化到单位长度。训练需要每个人多张照片(Ng 的例子:1000 个人、共 10,000 张图),但训练用的人和以后要认的人不必是同一批——编码器在训练人群上学会的是”怎样从照片里读出身份”这种通用的本领。
选三元组:随机抽的三元组大多数”太容易”( 本来就比 大出 以上,损失为 0),第 5 讲看到第 500 步时一批里 0% 的三元组还有梯度,于是用了 semi-hard 挖掘。代码 04 换了一种常用的做法(Hermans et al. 2017 的 “batch all”):每步取 16 个人 × 每人 4 张,一个 batch 里所有合法的三元组都算,只对损失大于 0 的那些取平均——最难的那些自然包含在里面。
10.4 实验:在图像上
合成人脸(face_world.py,32×32 灰度):身份决定脸型、肤色、发际线、眼距、眉毛、鼻子、嘴等 12 个参数;每张照片重新抽姿态(平移、±12° 旋转、缩放)、光照(整体亮度、侧光、背景)、表情(微笑、眯眼)和噪声。编码器:三个 [卷积 → BN → ReLU → 池化] + 全连接 → 32 维、单位长度,22,360 个参数。在 300 个人 × 8 张上训练 1000 步,在另外 100 个从没见过的人(每人 6 张)上测试:
| 方法 | 验证:训练人群 | 验证:新同学 | one-shot 识别(100 选 1) |
|---|---|---|---|
| 100 类 softmax(每类 1 张训练图) | — | — | 0.032 |
| 像素距离 | 0.529 | 0.519 | 0.020 |
| 随机初始化的编码器(训练前) | 0.546 | 0.542 | 0.022 |
| triplet 编码器 | 0.982 | 0.907 | 0.566 |
(验证:2000 对同一人 + 2000 对不同人,瞎猜 0.5;阈值 在训练人群上选好,原封不动用到新同学身上。)
- 像素距离几乎等于瞎猜(0.519)。这个世界比第 5 讲的难得多:背景亮度、整体增益和侧光让同一个人的两张照片在像素上差得很远(第 5 讲是 0.668)。
- triplet 编码器:新同学的验证 0.907、one-shot 识别 0.566,没有用新同学的任何照片训练。同一个人的平均 是 0.381,不同人是 1.944(单位球面上 最大是 4)。
- 训练人群 0.982 vs 新同学 0.907:300 个人不算多(FaceNet 用了约 800 万个人),编码器有一部分记住了训练人群。
- batch 里有损失的三元组从第 0 步的 57.9% 降到最后的 0.5%:训练越久,“难的三元组”越少——和第 5 讲一样,这就是为什么挑三元组那么重要。
10.5 把验证写成二分类
验证本来就是一个二分类问题:“这两张照片是不是同一个人?“Ng 的另一种做法:把两个编码的逐维差的绝对值当特征,训练一个逻辑回归
(DeepFace 还用过 形式 。) 让模型自己决定哪些维度更重要;绝对值让 对两张图的顺序对称。可以只在冻结的编码器上训练这个逻辑回归,也可以把交叉熵一路反向传播进编码器,端到端地训练整个 Siamese 网络,完全不用 triplet loss。代码 04 演示 3:
| 编码器的训练方式 + 判定规则 | 验证:新同学 | one-shot 识别 |
|---|---|---|
| triplet loss + 阈值 | 0.907 | 0.566 |
| triplet loss(冻结)+ 逻辑回归 | 0.910 | 0.538 |
| 端到端二分类(交叉熵)+ 它自己的逻辑回归头 | 0.890 | 0.192 |
| 端到端二分类的编码 + 阈值 | 0.840 | 0.184 |
- 冻结编码器上的逻辑回归和阈值法几乎一样(0.910 vs 0.907)。32 个权重里 31 个是负的(这一维差得越多越不像),所以它学到的就是”加权的距离 + 阈值”;阈值法相当于”每一维权重相同、用平方差”的特例。编码已经把信息整理好了,最后一步换什么规则差别不大。
- 端到端二分类:验证差得不多(0.890),one-shot 识别差得多(0.192 vs 0.566)。一个可能的解释(没有专门验证):二分类损失只要求”同一个人的对”和”不同人的对”落在一个阈值的两边;识别要在 100 个人里排出谁最近,triplet loss 直接优化的正是这种相对的排序(A 离 P 比离 N 近)。这只是一个种子、一组超参数的比较,换了数据和训练细节,结论可能不同。
10.6 部署:提前算好数据库的编码
编码器训练好之后是固定的,注册照的编码永远不变——没有理由每次查询都重算。Coursera 作业 “Face Recognition” 也是这样做的:先把每个人的编码算好,存在一个字典 database 里,验证和识别都只需要编码门口拍的那一张照片。代码 04 演示 4:数据库里 1000 个人、每人 1 张注册照,50 张查询照片:
| 做法 | 每次查询的乘加 | 每次查询的耗时(毫秒,每次运行不同) | 识别准确率 |
|---|---|---|---|
| 每次都重新编码 1000 张注册照 | 680,647,936 | 61.15 | 0.180 |
| 注册时算好编码,查询只编码 1 张 | 711,936 | 0.13 | 0.180 |
结果完全一样,计算量差近千倍。另一个数也值得注意:库里从 100 人变成 1000 人,识别准确率从 0.566 掉到 0.180(50 张查询照片,这个数本身有 ±0.05 左右的波动)——人越多,“长得像”的人越多,这就是 §10.1 说的识别比验证难。大规模系统还会用近似最近邻搜索在上亿个编码里快速找最近的(第 5 讲 §6.2)。
第 5 讲 §3.6 的提醒在这里同样适用:人脸识别涉及隐私和知情同意,也有在不同人群上错误率不同的问题。用到人脸的项目,“数据从哪里来、征得同意了吗、在不同人群上表现一样吗”是必须回答的问题。
11. 神经风格迁移 · Neural style transfer
第 5 讲 §4 讲了风格迁移的核心:内容用某一层的激活值表示,风格用同一层(或几层)激活值的 Gram 矩阵表示,固定网络参数、用梯度下降改像素。那里的”网络”是一个固定的、随机初始化的卷积层。Gatys et al. (2015) 用的是在 ImageNet 上训练好的 VGG-19。这一节回答:训练过的网络的特征有什么不同?内容层、风格层怎么选?
11.1 深层 CNN 在学什么?· What are deep ConvNets learning?
Zeiler & Fergus (2014) 的可视化方法之一:选网络里的一个单元,在整个数据集里找出让它激活最大的那些图块,看它”喜欢”什么。他们在 ImageNet 网络上看到的规律:第 1 层的单元喜欢边缘和颜色;第 2 层喜欢纹理和简单的图案;越往深,单元对应越复杂的结构——物体的部件,再到整个物体(狗、车轮、文字……)。一个原因是感受野越来越大:浅层单元只看得见几个像素,深层单元看得见大半张图。
代码 05 演示 1 在第 13 讲的源模型上(transfer_kit.pretrain_source:16 类形状、9600 张训练图,源任务测试准确率 0.720)做了同样的事:对每个单元找出最大激活最高的 20 张图,看这 20 张里最多的那一类占多少(“类别纯度”;随便挑 20 张图是 0.177):
| 层 | 单元数 | 感受野 | 类别纯度:训练过的 | 随机网络 | 纯度 ≥ 0.5 的单元 |
|---|---|---|---|---|---|
| conv1_1 | 16 | 3×3 | 0.188 | 0.191 | 0 / 16 |
| conv2_2 | 32 | 12×12 | 0.302 | 0.191 | 0 / 32 |
| conv3_2 | 64 | 30×30 | 0.648 | 0.194 | 51 / 64 |
浅层单元对类别”不挑”(3×3 的颜色、边缘在任何形状里都有);conv3_2 的单元大多只对某一类形状有反应(打印的例子里,有一个单元的前 20 张图全是星形)。同样结构的随机网络各层都在 0.19 左右——层次化的、和类别有关的特征是训练出来的,不是结构自带的。更系统的可视化方法(saliency map、occlusion、CAM)在第 21 讲。
对风格迁移来说,这张表给了一个直觉:浅层特征 ≈ 局部的颜色和纹理(适合描述风格),深层特征 ≈ “这里有个什么东西”(适合描述内容)。
11.2 代价函数
用 Ng 的记号:内容图 、风格图 、生成图 。
算法:
- 随机初始化 (比如 100×100×3 的噪声),或者用”内容图 + 噪声”;
- 用梯度下降改 :(网络参数固定不动)。
Gatys 等人用 L-BFGS 而不是普通的梯度下降。 的比例决定”像内容”和”像风格”之间的取舍(第 5 讲演示过 )。
11.3 内容代价
选一个隐藏层 ,内容代价是两张图在这一层的激活之差:
(Coursera 作业里的归一化常数是 ;常数只是改变了 的含义。) 怎么选?Ng 的建议是”中间的某一层”:太浅, 被逼着复刻 的每个像素;太深,可能连 里有什么都管不住。
代码 05 演示 2 只用内容代价,从同一张噪声图出发重建 48×48 的内容图(一座蓝墙红顶的房子),看每一层”记得”多少:
| 网络与内容层 | 像素 RMSE | 布局相关(6×6 块平均亮度的相关) |
|---|---|---|
| 训练过的网络,conv1_1 | 0.000 | 1.000 |
| 训练过的网络,conv2_2 | 0.226 | 0.912 |
| 训练过的网络,conv3_2 | 0.471 | 0.186 |
| 随机网络,conv1_1 | 0.007 | 1.000 |
| 随机网络,conv2_2 | 0.164 | 0.995 |
| 随机网络,conv3_2 | 0.389 | 0.891 |
- 越浅越像原图:conv1_1 几乎完美复原(RMSE 0.000),conv3_2 的激活一样、像素却差得很远。很多张不同的图在深层看起来是”同一个东西”(Mahendran & Vedaldi 2015 系统地研究过这种”反演”)。
- 和我预想的不一样:训练过的网络的 conv3_2 连”房子在哪”都几乎不记得了(布局相关 0.186),同样结构的随机网络反而记得(0.891)。原因很可能是源任务本身:它要求”不管形状在哪、什么颜色都认出来”,训练让深层特征主动扔掉位置和颜色的信息;随机网络没学过”该忽略什么”。这正是”深层 = 内容”的另一面:深层保留的是任务关心的内容。我们的源任务只关心”是哪种形状”,所以深层对房子的布局不敏感;VGG 在 ImageNet 上学的”内容”要丰富得多。
11.4 风格代价
第 5 讲 §4.2 讲过 Gram 矩阵(Ng 叫它”风格矩阵”):
第 个元素衡量第 个和第 个通道”在同一个位置一起出现”的程度——Ng 用的词是两个通道之间的相关(correlation):如果”竖条纹”通道和”橙色”通道总是一起亮,这幅画的笔触就是橙色的竖条纹。对所有位置求和以后,“在哪里”被扔掉了,只剩”有哪些图案、哪些常常一起出现”。
和内容不同,风格要在多层上一起算:浅层的 Gram 矩阵抓住细的笔触和颜色,深层的抓住更大尺度的结构。Coursera 作业用 VGG-19 的 5 层,每层 。
代码 05 的实现有一处改动:内容和每层风格代价都除以目标本身的大小(、),这样每一项开始时都在 1 附近,训练过的网络和随机网络的数可以放在一起比。这和 Ng 的常数一样,只是给每一项乘了一个固定的数,等价于换一组 。
11.5 实验
代码 05 演示 3:内容图是房子,风格图是绿 / 橙的 45° 斜条纹,风格层取全部 5 层,、,L-BFGS 改像素,外加一个小的”总变差”(total variation)正则项(相邻像素差的平方,压住像素级的噪点;Ng 的课没讲,但很多实现都加,比如 Johnson et al. 2016)。三个和网络无关的指标:布局相关(房子还在不在)、风格色占比(像素颜色接近绿或橙的比例)、斜条纹指数(沿条纹方向和垂直方向的亮度相关之差;风格图 2.0、内容图 0)。
| 设置 | 布局相关 | 风格色占比 | 斜条纹指数 |
|---|---|---|---|
| (参照)内容图 | 1.000 | 0.000 | 0.000 |
| (参照)风格图 | 0.000 | 1.000 | 2.000 |
| A 训练过,内容 conv2_2,从噪声 | 0.764 | 0.263 | 0.552 |
| B 训练过,内容 conv3_2,从噪声 | 0.165 | 0.280 | 0.636 |
| C 训练过,内容 conv2_2,从”内容图 + 噪声” | 0.973 | 0.129 | 0.303 |
| D 随机网络,内容 conv2_2,从噪声 | 0.419 | 0.401 | 0.655 |
| E 训练过,只要风格() | 0.354 | 0.361 | 0.936 |
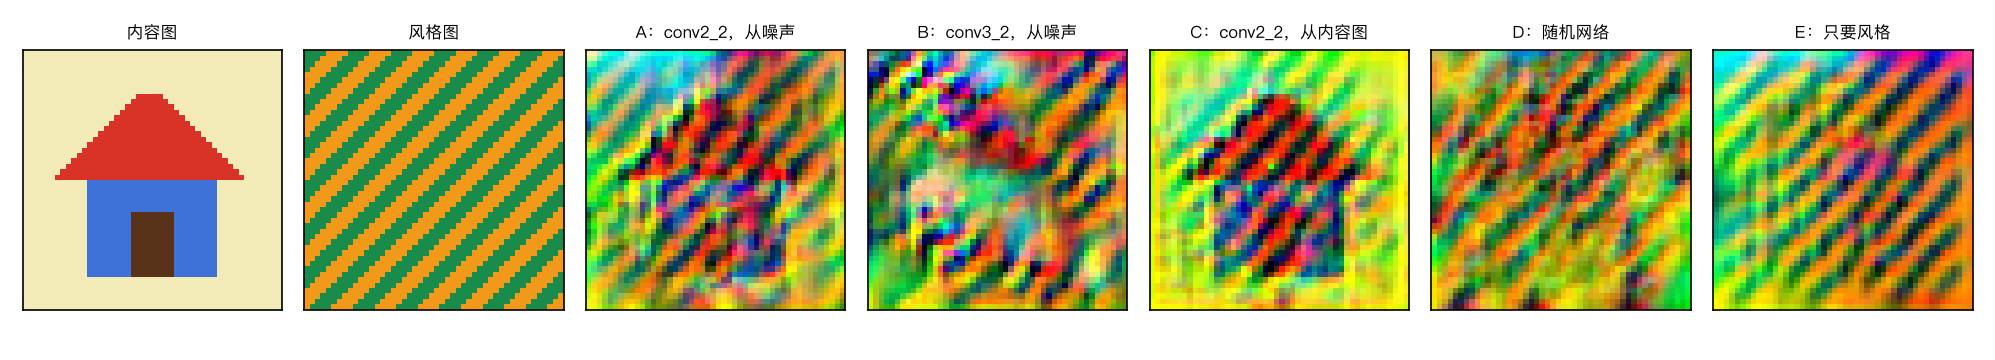
- A:房子的轮廓还在,墙和屋顶上长出了斜条纹。但颜色并不只是绿和橙(风格色占比 0.263):Gram 矩阵记录的是”哪些特征一起出现”,这个小网络的特征对”到底是哪种绿”不太敏感,生成图里混进了很多别的颜色。
- B(内容层更深):布局相关只剩 0.165,和演示 2 一致——这个网络的深层几乎不记得房子在哪,内容约束太松,生成图主要由风格决定。
- C(从内容图出发,Coursera 作业的做法):起点就是房子,布局相关 0.973,条纹少一些(0.303)。起点会影响最后停在哪个局部最优。
- D(随机网络,第 5 讲的做法):同样的 下风格更重(条纹指数 0.655)、内容更轻(0.419)。在这个只有两张图的小例子里,训练过的和随机的网络都”能用”,差别主要在内容和风格各占多少;“训练过”的优势要在真实照片、真实画作这种复杂得多的图上才明显。第 5 讲引用的 Ustyuzhaninov et al. (2016) 也发现,随机滤波器的统计已经能合成不少纹理。
- E(只要风格):没有内容项,生成的是一块纹理,斜条纹指数最高(0.936);这就是纹理合成(Gatys et al. 2015 的另一篇论文)。它的布局相关却有 0.354——只有 6×6 = 36 个块的相关,偶然达到 ±0.3 并不稀奇;所以 B 的 0.165 也应该读成”和没有内容约束差不多”。风格迁移 = 纹理合成 + 内容约束。
诚实的说明:这一组设置不是第一版。第一版用 24×24 的图、Adam 改像素、没有总变差项,五个结果全是满屏的彩色噪点(风格项的 Gram 矩阵被一堆杂乱的像素也”满足”了)。我改了三处——图放大到 48×48(让一张图里有更多位置可以平均)、换成 L-BFGS(Gatys 的做法)、加总变差项——并在草稿里试过 和 ,看到这一组才定下来。第一版的数字记录在代码 README 的”关于实验结果”里。这本身也是一个教训:风格迁移的结果对这些”工程细节”相当敏感。
12. 1D 与 3D 卷积 · 1D and 3D generalizations
卷积不只用在 2D 图像上。C4M4 的最后一个视频把它推广到 1D 和 3D:
| 数据 | 例子 | 卷积怎样滑 |
|---|---|---|
| 1D | 心电图(ECG)、音频、传感器时间序列 | 只沿时间滑 |
| 2D | 图像 | 沿高、宽滑 |
| 3D | CT / MRI 的体数据(一摞切片)、视频(时间当第三维) | 沿三个方向滑 |
代码 03 演示 3 按 Ng 的例子核对了形状和参数:
| 输入 | 卷积层 | 输出 | 参数个数 |
|---|---|---|---|
| 1D 14×1 | 16 个 5×1 | 10×16 | 96 |
| 1D 10×16 | 32 个 5×16 | 6×32 | 2,592 |
| 3D 14×14×14×1 | 16 个 5×5×5×1 | 10×10×10×16 | 2,016 |
| 3D 10×10×10×16 | 32 个 5×5×5×16 | 6×6×6×32 | 64,032 |
输出尺寸公式在每一维上照用;参数个数只取决于滤波器,和信号多长、体数据多大无关——和 2D 一样的参数共享。3D 滤波器多了一维,参数和计算量都多一个因子 。
演示 3 还用 numpy 写了一个 1D 卷积(和 F.conv1d 差 5.6e-16),拿一个固定的心跳模板当滤波器,在 20 秒、25 次心跳、噪声 σ = 0.25 的合成心电图里找心跳:直接在原始信号上找峰,只对上 18 次(找到 19 个峰);做完 1D 卷积再找峰,25 次全部对上。卷积在任何时刻都能认出同一个形状(时间上的平移等变),而且把噪声平均掉了。深度学习做的,是让网络自己学这些模板。
13. 小结 · Summary
- 分类 → 定位 → 检测:定位的输出 ,一个网络同时做分类和回归; 时只罚 (代码 01:错误的写法让背景图的损失从 0.0100 变成 1.3634)。关键点检测回归任意多个坐标,标注的含义必须一致(标反一半眼睛时,眼睛的误差从约 1 像素涨到约 4 像素)。
- 滑动窗口很慢;把全连接层改写成卷积层,一次前向算完所有窗口(OverFeat),结果逐数字相同。省多少取决于卷积部分的占比:Ng 的小网络 1.33 倍,VGG-16 14.29 倍。
- YOLO: 网格,中心所在的格子负责,框相对格子参数化(, 可以 > 1),输出 (作业:19×19×5×85)。
- IoU ≥ 0.5 算框对(偏 1/3 个框宽就到 0.5 了);NMS 要逐类做,阈值是”合并挨着的物体”和”留下重复框”之间的取舍。
- anchor boxes 让一个格子能报多个物体(拥挤的”车 + 人”两个都找到:0.007 → 0.410),也是形状先验([email protected] 0.794 → 0.846);形状相同的物体挤在一格时仍然不行。
- mAP:按分数排序、逐个判 TP / FP(IoU + 每个标注框只认领一次)、算 PR 曲线下的面积、对类别平均;重复框算 FP,插值与否、IoU 阈值都会改变数字。
- R-CNN → Fast R-CNN → Faster R-CNN:区域提议 + 逐个分类 → 共享卷积特征 → 区域提议也交给网络(RPN + anchors)。
- 语义分割:每个像素一个类别,看 mIoU;转置卷积 ,是卷积的”转置”不是”逆”, 不是 的整数倍时有棋盘格伪影;U-Net 的跳跃连接补上边界细节(边界像素 0.773 → 0.858,内部都是 0.990)。
- 人脸:验证是 1:1,识别是 1:K(更难);one-shot 下当成分类不行(0.032),要学相似度函数 ;Siamese 编码器 + triplet loss 在新同学上验证 0.907、识别 0.566;也可以在 上做逻辑回归,或端到端用二分类训练;部署时提前算好数据库的编码(乘加差近千倍)。
- 风格迁移:;深层单元对类别更”挑”(类别纯度 0.188 → 0.648),浅层 ≈ 纹理、深层 ≈ 任务关心的内容;内容层选中间、风格在多层上算;结果对优化器、图像大小、正则项相当敏感。
- 1D / 3D 卷积:同样的局部连接和参数共享,用在时间序列和体数据、视频上。
14. 常见误区 · Common pitfalls
- “背景图的框标签填 0 就行。” 那 7 个数是”没有定义”,不是 0。要用掩码只罚 (§1.2)。
- “卷积实现滑动窗口总能大幅提速。” 只有卷积部分能共享;全连接层占大头的小网络只快 1.33 倍(§2.2)。它也不解决”框不准”。
- “NMS 对所有框一起做。” 要逐类做,否则人会把他骑的摩托车删掉(§4.2)。
- “IoU ≥ 0.5 说明框很准。” 偏 1/3 个框宽就是 0.5;要精确的框看 [email protected] 或 COCO 式的 mAP(§6、§7.2)。
- “一个格子负责所有和它重叠的物体。” 只负责中心落在里面的那个;同一格的第二个物体需要 anchor(§3.3、§5)。
- “anchor 越多越好、能解决一切拥挤。” 形状相近的物体挤在一格时 anchor 帮不上(“球 + 车”0.003,§7.3);更细的网格同样重要。
- “mAP 是一个数,大家都一样算。” 插值与否、IoU 阈值、重复框怎么算都会改变它(0.817 vs 0.833,0.833 vs 0.500,§6)。比较时要用同一套评估代码。
- “转置卷积是卷积的逆运算(deconvolution)。” 它是卷积的转置,恢复形状不恢复数值(§9.2)。
- “分割的像素准确率 97% 很高。” 全猜背景就有 82%;看 mIoU 和边界附近的准确率(§9.4)。
- “人脸识别就是一个 K 类分类问题。” 每类一张图、类别还会变,分类方案在 one-shot 下失败(0.032);要学相似度函数(§10.2)。
- “每次查询都把数据库里的照片过一遍网络。” 编码要提前算好存起来(§10.6)。
- “风格迁移的内容层越深越好 / 越浅越好。” 太浅复刻像素,太深连布局都丢;而且”深层记得什么”取决于网络在什么任务上训练过(§11.3)。
15. 练习 · Exercises
练习 1(定位的损失)。一张有摩托车的图:,网络输出 。(a) 用 §1.2 的平方误差损失,算 。(b) 如果这是一张背景图(),网络输出同样的 , 是多少?(c) Fast R-CNN 损失里的 对应 (a)、(b) 里的哪个区别?
参考答案
(a) 逐项平方误差:,合计 。 (b) 只算第一项:。 (c) 是”真实类别不是背景”的指示函数:背景()时框的损失乘以 0,正是 (b) 里只算 那一项的做法。
练习 2(IoU)。(a) 算框 和 (左, 上, 右, 下)的 IoU。(b) 证明:一个框沿 方向平移 个框宽()后,和原框的 IoU 是 ;同心放大 倍时 IoU 是 。(c) 要让 IoU ≥ 0.5,最多能平移几个框宽?最多能放大几倍?
参考答案
(a) 面积 和 ;交集 、,面积 4;并集 ;IoU 。 (b) 设框宽 、高 。平移后交集 ,并集 ,比值 。同心放大:小框完全在大框里,交集 = 小框面积 ,并集 = 大框面积 ,比值 。 (c) ;。和代码 01 演示 3 的表一致。
练习 3(数输出和参数)。(a) Coursera 作业的 YOLO:19×19 个格子、每格 5 个 anchor、80 个类别,输出张量多少个数?如果最后一层是从 1024 个通道到这个张量的 1×1 卷积,它有多少个参数(含偏置)?(b) Ng 的人脸关键点例子标 64 个点,再加一个”有没有脸”,输出层多少个单元?(c) Faster R-CNN 的 RPN 在每个位置用 9 个 anchor,每个 anchor 输出”是物体 / 不是物体”两个分数和 4 个框修正,RPN 在每个位置输出多少个数?
参考答案
(a) 个数。1×1 卷积: 个参数。 (b) 个。 (c) 个(论文里写作 个分数和 个坐标,)。
练习 4(手做 NMS)。同一类的四个框和分数:A 0.9;B 0.8;C 0.7;D 0.6。IoU 阈值 0.5,NMS 之后剩哪几个?阈值改成 0.3 呢?(提示:先算 A–B、A–C、B–C 的 IoU。)
参考答案
A–B:交集 ,并集 ,IoU 。A–C:交集 ,并集 160,IoU 。B–C:交集 、,,并集 155,IoU 。D 和谁都不相交。
阈值 0.5:选 A,删 B(0.681),C(0.25)留下;再选 C(剩下的 C、D 里分数最高),D 和 C 不重叠,再选 D。剩 A、C、D。
阈值 0.3:A 删 B(0.681);C 和 A 的 IoU 0.25 < 0.3,留下。结果还是 A、C、D。要到阈值 ≤ 0.25 时 C 才会被 A 删掉——如果 A 和 C 其实是两辆挨着的车,这就是”阈值太低会合并物体”。可以用 det_tools.nms 验证。
练习 5(AP 手算)。某一类有 4 个标注框。按分数从高到低,5 个检测的结果是 TP、FP、TP、TP、FP。(a) 写出每一步的 precision 和 recall。(b) 算不插值的 AP 和插值的 AP。(c) 如果再多给一个分数最低的 TP,两个 AP 分别变成多少?
参考答案
(a) precision:1, 0.5, 0.667, 0.75, 0.6;recall:0.25, 0.25, 0.5, 0.75, 0.75。
(b) 不插值:。插值:往后看的最大 precision 是 1, 0.75, 0.75, 0.75, 0.6,AP 。(用 det_tools.average_precision 验证:0.6042、0.6250。)
(c) 第 6 个检测:precision ,recall 1.0,多出来的面积 。不插值 ;插值 (前面几步”往后看的最大值”不变,因为 0.667 < 0.75)。即使是排在最后的 TP,也能把 recall 补到 1、显著提高 AP。
练习 6(转置卷积的尺寸)。(a) 4×4 的特征图,转置卷积 、、,输出多大?(b) 反过来,8×8 的图做普通卷积 、、,输出多大?(c) 为什么 GAN 的生成器里常用 而不是 ?
参考答案
(a) ,正好放大一倍。 (b) ,正好缩小一半——两者是一对。 (c) 是 的整数倍,内部每个输出像素被”盖章”的次数相同(代码 03 演示 1(d):都是 4 次); 时是 1、2、4 交替,容易出现棋盘格伪影(Odena et al. 2016)。
练习 7(Gram 矩阵)。某一层有 2 个通道,每个通道是 2×2:通道 1 ,通道 2 。(a) 按 §11.4 的公式(不归一化)算 。(b) 把两个通道的四个位置用同一种方式打乱(比如左右翻转), 变吗?这说明了什么?(c) 如果只翻转通道 1、不翻转通道 2 呢?
参考答案
(a) 拉平:通道 1 ,通道 2 。,,。。 (b) 不变:求和不在乎位置的顺序,只要两个通道的位置对应关系不变。这就是”Gram 矩阵扔掉了位置信息,只保留哪些特征一起出现”(第 5 讲演示 1:平移 6 像素,Gram 只变 0.028)。 (c) 左右翻转后通道 1 , 还是 6,但 ——“一起出现”的关系变了,Gram 矩阵就变了。
练习 8(改代码:更细的网格,先预测再运行)。把 01_detection_basics.py 演示 5(c) 里的网格从 改成 (每格 4 像素;yolo_encode(o, 4, 3, 32, ...) 的第二个参数),只看 B = 1 那一行。先预测:写不进标签的物体比例会从 3.69% 变成多少?然后运行验证。更细的网格有什么代价?
参考答案
时 B = 1 只丢 14 个物体(0.35%);反过来 时丢 475 个(11.85%)。格子数变成 4 倍,两个中心落在同一格的概率大约变成 1/4 以下。代价:(1) 输出张量和最后一层的计算变大;(2) 每个格子的感受野相对物体变小、能看到的上下文变少;(3) 物体横跨的格子更多,邻居格子”也觉得是我的”的情况更多,更依赖 NMS;(4) 我们的网络有三次池化(步长 8),要输出 8×8 就得少池化一次,网络结构也要改。YOLO 用 19×19 + 5 个 anchor 是在这些因素之间的折中。
练习 9(验证与识别)。一个人脸验证系统,和”别人”比较时有 1% 的概率误判为同一人(误识率 FAR = 1%),各次比较相互独立。(a) 数据库里有 100 个人,一个库里的人来查询,他要和另外 99 个人比较,至少被误判一次的概率是多少?(b) FAR 降到 0.1% 呢?(c) 这和代码 04 演示 4 里”100 人 → 1000 人,识别准确率 0.566 → 0.180”有什么关系?
参考答案
(a) 。(b) 。 (c) 同一个道理:识别要和库里每个人比,库越大,“长得像的别人”越多,任何一个比真身更近都会认错。所以 Ng 说识别需要比验证高得多的准确率(99.9% 甚至更高),实际系统还常用”最近的距离也要小于阈值,否则答’不认识‘“来控制误识。
练习 10(3D 卷积的参数)。(a) 一个 3D 卷积层:3×3×3 的核,64 个输入通道、128 个输出通道,有多少参数(含偏置)?和 3×3 的 2D 卷积(同样的通道数)比是几倍?(b) 一段视频 16 帧、每帧 112×112×3,用 3×3×3、same padding、64 个滤波器,输出形状是什么?
参考答案
(a) ;2D:;约 3 倍(多了一个 的因子)。
(b) same padding、步长 1:16×112×112×64(时间、高、宽都不变)。这类网络(比如 C3D)用 3D 卷积同时提取空间和时间上的特征。可以用 nn.Conv3d(3, 64, 3, padding=1) 和一个形状 (1, 3, 16, 112, 112) 的张量验证。
16. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C4M3 “Object Detection”、C4M4 “Special Applications: Face Recognition & Neural Style Transfer”(Andrew Ng)——本讲的主线;四个编程作业 Car Detection with YOLO、Image Segmentation with U-Net、Face Recognition、Art Generation with Neural Style Transfer。
- Stanford CS230 Fall 2017 Handout 6 “Advanced Topics in Object Detection”(公开 PDF:https://web.stanford.edu/class/cs230/fall2017/files/CS230_Handout6.pdf)。
- CS230 Section 8 “Advanced Evaluation Metrics”(IoU、AP、mAP)、Section 7 “Debugging DL Projects”(U-Net 分割代码库):https://cs230.stanford.edu/section/8、https://cs230.stanford.edu/section/7。
- Dumoulin & Visin (2016). A guide to convolution arithmetic for deep learning. arXiv. ——卷积、转置卷积的尺寸算术,带大量示意图。
检测
- Sermanet, Eigen, Zhang, Mathieu, Fergus & LeCun (2014). OverFeat: Integrated recognition, localization and detection using convolutional networks. ICLR. ——卷积实现滑动窗口。
- Redmon, Divvala, Girshick & Farhadi (2016). You only look once: Unified, real-time object detection. CVPR. ——YOLO。
- Redmon & Farhadi (2017). YOLO9000: Better, faster, stronger. CVPR. ——YOLOv2:anchor、k-means 选 anchor。
- Girshick, Donahue, Darrell & Malik (2014). Rich feature hierarchies for accurate object detection and semantic segmentation. CVPR. ——R-CNN。
- Girshick (2015). Fast R-CNN. ICCV.
- Ren, He, Girshick & Sun (2015). Faster R-CNN: Towards real-time object detection with region proposal networks. NeurIPS.
- Uijlings, van de Sande, Gevers & Smeulders (2013). Selective search for object recognition. IJCV.
- Hoiem, Chodpathumwan & Dai (2012). Diagnosing error in object detectors. ECCV.
- Everingham et al. (2010). The Pascal visual object classes (VOC) challenge. IJCV;Lin et al. (2014). Microsoft COCO: Common objects in context. ECCV. ——两套评估标准。
分割
- Long, Shelhamer & Darrell (2015). Fully convolutional networks for semantic segmentation. CVPR.
- Ronneberger, Fischer & Brox (2015). U-Net: Convolutional networks for biomedical image segmentation. MICCAI.
- Odena, Dumoulin & Olah (2016). Deconvolution and checkerboard artifacts. Distill.
人脸
- Bromley, Guyon, LeCun, Säckinger & Shah (1993). Signature verification using a “Siamese” time delay neural network. NeurIPS.
- Taigman, Yang, Ranzato & Wolf (2014). DeepFace: Closing the gap to human-level performance in face verification. CVPR.
- Schroff, Kalenichenko & Philbin (2015). FaceNet: A unified embedding for face recognition and clustering. CVPR.
- Hermans, Beyer & Leibe (2017). In defense of the triplet loss for person re-identification. arXiv. ——batch hard / batch all。
可视化与风格迁移
- Zeiler & Fergus (2014). Visualizing and understanding convolutional networks. ECCV.
- Mahendran & Vedaldi (2015). Understanding deep image representations by inverting them. CVPR.
- Gatys, Ecker & Bethge (2015). A neural algorithm of artistic style. arXiv(CVPR 2016 版:Image style transfer using convolutional neural networks);以及同一组作者的 Texture synthesis using convolutional neural networks. NeurIPS 2015.
- Johnson, Alahi & Fei-Fei (2016). Perceptual losses for real-time style transfer and super-resolution. ECCV.
17. 下一讲预告 · Next lecture
第 15 讲:循环神经网络——语言模型、GRU 与 LSTM。 Part IV 到这里结束:卷积网络利用了图像的局部性和平移不变性,本讲最后一节看到,同样的想法可以沿时间方向用在 1D 信号上。但很多序列问题需要的不只是”局部的模板”:
- 一句话里,句首的主语决定了句尾的动词形式——依赖可以跨越很长的距离;
- 输入和输出的长度都不固定(翻译、语音识别、生成文本);
- 我们想要一个能”一边读、一边记”的模型。
第 15 讲从循环神经网络(RNN)开始:同一组参数在每个时间步重复使用(又是参数共享,只是沿时间方向),用字符级语言模型生成合成的”恐龙名字”,再看为什么普通 RNN 记不住长距离的依赖,GRU 和 LSTM 的”门”怎样解决它。