对应 Maps to:Coursera Deep Learning Specialization C4M2 “Deep Convolutional Models: Case Studies”(Why look at case studies?、Classic Networks、ResNets、Why ResNets Work?、Networks in Networks and 1x1 Convolutions、Inception Network Motivation、Inception Network、MobileNet、MobileNet Architecture、EfficientNet、Using Open-Source Implementation、Transfer Learning、Data Augmentation、State of Computer Vision);编程作业 “Residual Networks”(ResNet-50 的 identity block 与 convolutional block)和 “Transfer Learning with MobileNet”(MobileNetV2:冻结底座、加分类头、再解冻顶部若干层微调;数据增强层);Stanford CS230 Fall 2025 Lecture 6 那一周的推荐阅读(Dropout 论文、DenseNet 论文)。在 Fall 2025 的安排里,C4M1、C4M2 和第 6 次课堂讲座(10/28)在同一周。 依据说明:Coursera 的视频和编程作业只对注册学员开放。本讲依据 Andrew Ng 在 C4M2 里广为人知的讲法来写:三个经典网络的形状与参数、残差块的公式与”为什么容易学恒等映射”、Inception 的 28×28×192 计算量例子(约 1.2 亿 vs 约 1240 万次乘法)、depthwise separable 的 6×6×3 例子与 、迁移学习按数据量选择冻结多少层、数据增强的几种做法、“计算机视觉现状”里数据与手工设计的权衡。视频里的具体讲法是凭记忆复述的,细节可能和原视频略有出入。架构细节一律以原始论文为准(LeCun et al. 1998;Krizhevsky et al. 2012;Simonyan & Zisserman 2014;He et al. 2016;Lin et al. 2013;Szegedy et al. 2015;Howard et al. 2017;Sandler et al. 2018;Tan & Le 2019;Huang et al. 2017),见 §13。原作业用 TensorFlow / Keras,本讲义用 PyTorch。 配套代码 Code:
code/lecture13/(PyTorch;5 个脚本 + 3 个模块。01 约 2 秒,02 约 2 分钟,03 约 80 秒,04 约 100 秒,05 约 90 秒;02–05 都有--quick) 预计阅读时间:3–3.5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说出 LeNet-5、AlexNet、VGG-16 的结构和它们留给后来者的设计模式(高和宽变小、通道变多;“参数在全连接层,计算在卷积层”),并能自己数出任何一层的输出形状、参数个数和乘加次数。
- 讲清退化问题(degradation):深的 plain 网络训练误差反而更高,这不是过拟合;写出残差块 ,用”权重为 0 时就是恒等映射”和”梯度的直通路”两个直觉解释它为什么有效,并知道这两个直觉的边界(初始化、BN 要和结构配套)。
- 区分 ResNet-50 的 identity block 和 convolutional block,知道维度不一致时捷径上的 (1×1 卷积投影)和 bottleneck 结构为什么省计算。
- 解释 1×1 卷积(“每个像素上的全连接层”)的三种用途,用它算出 Inception 瓶颈层省下的计算量;推导 depthwise separable 卷积的计算量之比 ,说清 MobileNet v2 的”扩张 → depthwise → 线性投影 + 残差”,以及 EfficientNet 的复合缩放;知道”乘加少”不等于”跑得快”。
- 按目标数据量选择迁移学习的做法(冻结整个底座只训练头 / 冻结前面、微调后面 / 全部微调),会预先算特征、给微调设学习率,避开”冻结了参数却没冻结 BN 统计量”的坑。
- 说出常见的数据增强(镜像、随机裁剪、旋转 / 剪切 / 局部扭曲、颜色变换、PCA 颜色增强)各自在对抗哪种变化,以及”增强是对’标签不变’的一个断言”。
- 复述 Ng 对”计算机视觉现状”的判断:数据越少越依赖手工设计和迁移学习;benchmark 上的集成、多裁剪测试为什么不适合生产。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开 Previewed only |
|---|---|
| 第 12 讲:卷积、padding、stride、输出尺寸公式、多通道卷积、池化、参数共享与稀疏连接(§1.1 有一段回顾) | 目标检测、分割里怎样用这些骨干网络(第 14 讲) |
| 第 4 讲 §5:为什么要深;“能表示 ≠ 能学到”;第 7 讲 §3:信号传播与初始化;第 9 讲 §2:Batch Norm | 神经架构搜索(NAS)怎样找到 EfficientNet-B0(§5.6 只点名) |
第 6 讲:dropout、数据增强的基本想法(§6.1、§6.4);第 9 讲的 torch_utils 训练循环 | 迁移学习”什么时候有用”的判断原则(第 10 讲);本讲讲 CNN 上怎样做 |
PyTorch 基础:nn.Module、nn.Conv2d、model.train() / model.eval()(第 9 讲 §4) | Transformer 里的残差 + LayerNorm(第 17 讲);可视化网络学到了什么(第 21 讲) |
第 12 讲讲的是”一个卷积层怎么算”;本讲讲的是”怎样把很多卷积层搭成一个好网络”,以及”怎样借用别人已经训练好的网络”。所以本讲不再从零实现卷积,而是直接用 PyTorch 的 nn.Conv2d 搭积木(arch_blocks.py)。新的、需要看清每一行的东西——残差块、bottleneck、Inception 模块、depthwise separable、倒残差块、dense block、冻结与微调、数据增强——都在本讲的代码里从零写出来。
0.3 本讲地图 Map
§1  为什么看经典网络;第 12 讲回顾
§2  经典网络:LeNet-5、AlexNet、VGG-16;从账本里读出的模式                 ← 代码 01 演示 1–3、5
§3  残差网络:退化问题;残差块;为什么有效;W_s 与 bottleneck;ResNet-50;
    没有 BN 时的初始化                                                      ← 代码 02、代码 01 演示 4
§4  1×1 卷积与 Inception:Network in Network;瓶颈层;Inception 模块        ← 代码 03 演示 1–2
§5  MobileNet 与 EfficientNet:depthwise separable;v1、v2;实测;复合缩放    ← 代码 03 演示 3–6
§6  DenseNet 与推荐阅读:相加 vs 拼接
§7  开源实现与迁移学习:三种做法;数据量;学习率;BN 的坑;哪一层最通用      ← 代码 04、代码 05 演示 1–2
§8  数据增强:常见做法;实时增强;各自的作用;会改变标签的增强              ← 代码 05 演示 3–5
§9  计算机视觉的现状
§10–14  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,补充本讲新增的)
| 符号 | 含义 | 例子 |
|---|---|---|
| 一层激活值的高 × 宽 × 通道数(Ng 的写法;PyTorch 的张量形状是 ) | VGG-16 的输入 224×224×3 | |
| 、、 | 卷积核边长、步长、补零圈数;输出边长 (第 12 讲) | |
| 、 | 一个卷积层的输入、输出通道数(§5 的 depthwise separable 公式里用) | |
| MACs | 乘加次数(multiply–accumulate),一次乘法加一次加法;本讲用它衡量计算量 | VGG-16 每张图约 155 亿次 |
| 残差块的”主路径”(main path): | ||
| 捷径(shortcut)上的投影矩阵 / 1×1 卷积,在维度不一致时把 变成和 同形状 | ||
| MobileNet v2 的扩张倍数(expansion factor),默认 6 | ||
| (MobileNet) | 宽度乘子:每层通道数乘以 | |
| ;(EfficientNet) | 复合缩放系数;深度、宽度、分辨率每一级放大的倍数 | 1.2、1.1、1.15 |
| (DenseNet) | 增长率(growth rate):每层新增的通道数 |
注意两个 :MobileNet 的宽度乘子和 EfficientNet 的深度系数撞了名字(论文里就是这样写的),和学习率 也无关;在本讲里出现时都会写明是哪一个。
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出。PyTorch 一律在 CPU 上单线程运行、固定种子,同一台机器上重复运行输出逐字相同;只有代码 03 里的计时(毫秒、“训练 1000 张要几秒”)每次不同,讲义里引用的是我运行的某一次。数据是合成的”形状世界”(shapes_world.py:彩色小图里的圆、方块、三角、十字……)和”纹理世界”,网络都很小、训练都很短(几百步),所以数字只说明机制,不代表 ImageNet 上的大小。有好几处结果和我写代码前的预想不一样(最重要的一处:在这么短的训练里,深的残差网络并没有比浅的更好),讲义按实际结果来写,这些情况都列在代码 README 的”关于实验结果”里。架构的参数个数、乘加次数是逐层数出来的,和论文、torchvision 公认的数字逐一核对过(§2、§5.5)。
1. 为什么看经典网络 · Why look at case studies?
1.1 先回顾第 12 讲
第 12 讲把卷积层拆开看过一遍,这里只列出本讲要用到的几件事:
- 卷积:一个 的核在输入上滑动,每个位置算一次加权和,得到输出的一个通道; 个核就得到 个通道。一个核在所有位置上共享同一组权重,每个输出只和输入的一小块相连(稀疏连接)——所以卷积层的参数比全连接层少得多,而且天生适合”同一个图案可能出现在任何位置”的图像。
- padding 与 stride:输出边长 。“same” 卷积(、)不改变高和宽;“valid” 卷积不补零。
- 池化:最大池化 / 平均池化,通常 ,高和宽减半,没有参数。
- 一个简单的 CNN:几个 conv → pool 之后接全连接层和 softmax。
本讲在这个基础上回答下一个问题:一层层怎么搭,才是一个好网络?
1.2 Ng 的理由:读别人的网络,学搭网络
Ng 给的理由很朴素:学写代码的好办法是读别人的代码;学搭网络的好办法是读别人搭好的网络。计算机视觉的研究者花了大量精力去找”在 ImageNet 上好用”的结构,而一个在一种视觉任务上好用的结构,往往在别的视觉任务上也好用——你做猫狗分类、医学影像、自动驾驶,都可以直接拿 ResNet 或 MobileNet 当骨干。
读这些网络还有一个好处:很多论文的作者会把训练好的权重公开。到 §7 你会看到,“借用”一个在大数据集上训练好的网络(迁移学习),往往是小数据项目里最有效的一招。要借得好,你得先看懂它的结构。
1.3 本讲的三条线
这一讲的十几个视频,其实在回答三个问题:
- 怎样变深(§2–§3):LeNet(5 层)→ AlexNet(8 层)→ VGG(16 层)→ ResNet(50–152 层)。第 4 讲 §5 说过”能表示 ≠ 能学到”,并且承诺”后面几讲会逐步改变”深网训练不出好处的局面——残差连接是兑现这个承诺最关键的一步(§3 会看到,它要和 BN、初始化配合才管用)。
- 怎样变省(§4–§5):1×1 卷积、Inception 的瓶颈层、depthwise separable 卷积、EfficientNet 的缩放规则。同样的准确率,计算量可以差几十倍。
- 怎样借(§7–§9):用开源实现和预训练权重、迁移学习、数据增强。
2. 经典网络 · Classic networks
2.1 LeNet-5(1998)
LeNet-5 是 LeCun 等人为识别手写数字设计的网络(第 1 讲 §1.3 的历史表里,1989 年那一行就是它的前身)。Ng 课上的版本(输入 32×32 的灰度图):
32×32×1 ─conv 5×5, 6 个─→ 28×28×6 ─平均池化 2×2─→ 14×14×6
        ─conv 5×5, 16 个─→ 10×10×16 ─平均池化─→ 5×5×16 = 400
─FC─→ 120 ─FC─→ 84 ─→ 10 个输出先预测:参数主要在卷积层还是全连接层?
代码 01 演示 1 逐层数了一遍(模型在 PyTorch 里真正搭出来,用 forward hook 记下每一层的输出形状):
| 层 | 输出形状 | 参数 | 乘加 MACs |
|---|---|---|---|
| conv1 5×5, 6 | 28×28×6 | 156 | 117,600 |
| 平均池化 | 14×14×6 | 0 | 0 |
| conv2 5×5, 16 | 10×10×16 | 2,416 | 240,000 |
| 平均池化 | 5×5×16 | 0 | 0 |
| FC 400 → 120 | 120 | 48,120 | 48,000 |
| FC 120 → 84 | 84 | 10,164 | 10,080 |
| FC 84 → 10 | 10 | 850 | 840 |
| 合计 | 61,706 | 416,520 |
参数 61,706 个(Ng 说”约 6 万”),其中 95.8% 在三个全连接层里。卷积层因为参数共享,第一层 6 个 5×5 的核只有 156 个参数,却要在 28×28 个位置上各用一次——这一层的乘加(117,600)约是参数的 750 倍。
两个延续至今的模式:
- 高和宽一路变小,通道一路变多:32 → 28 → 14 → 10 → 5,同时 1 → 6 → 16。越往后,每个”像素”代表输入里越大的一块区域(感受野变大),描述它需要的特征种类也越多。
- conv → pool → conv → pool → 几个全连接层 → 输出。
和原论文的差别(Ng 也提到过,建议读论文时重点读第 II、III 节):原论文的第二个卷积层(C3)只连接部分输入通道(16 个输出通道一共连了 60 个输入通道,参数 1,516 个而不是全连接时的 2,416 个),池化层有可训练的系数和偏置,输出层是 RBF 单元;激活函数是 sigmoid / tanh 一类,而且非线性放在池化之后。演示 1 按原论文的结构数出来是 60,840 个参数。部分连接在当年是为了省计算、也为了”打破对称”,今天已经没人这样做了。
2.2 AlexNet(2012)
AlexNet(Krizhevsky, Sutskever & Hinton)在 2012 年 ImageNet 比赛上把 top-5 错误率从 26.2% 降到 15.3%(第 1 讲 §1.3),让整个计算机视觉界转向深度学习。
227×227×3 ─conv 11×11, s4, 96─→ 55×55×96 ─max pool 3×3, s2─→ 27×27×96
          ─conv 5×5 same, 256─→ 27×27×256 ─max pool─→ 13×13×256
          ─conv 3×3 same, 384─→ ─conv 3×3, 384─→ ─conv 3×3, 256─→ 13×13×256 ─max pool─→ 6×6×256 = 9216
          ─FC 4096─→ ─FC 4096─→ 1000 类 softmax
一个小细节:论文写的输入是 224×224,但 ,只有 227 才能得到论文里的 55×55(代码 01 演示 2 打印了这两个数)。读论文时遇到”数字对不上”,很多时候就是这种笔误,自己算一遍最可靠。
演示 2 的账本:
| 版本 | 参数 | 乘加 / 张图 | 全连接层占参数 | 全连接层占乘加 |
|---|---|---|---|---|
| 单 GPU(今天的常见写法) | 62,378,344 | 1,135,256,096 | 94.0% | 5.2% |
| 原论文:两块 GPU 各算一半(第 2、4、5 个卷积分组) | 60,965,224 | 724,406,816 |
两 GPU 版的 6097 万就是论文说的”6000 万个参数”。第一个全连接层(9216 → 4096)一层就有 37,752,832 个参数。参数在全连接层,计算在卷积层——这是读 CNN 账本时最有用的一句话。
AlexNet 和 LeNet 是同一个模式,只是大了约 1000 倍。让它训练得动的几样东西,前几讲都见过:ReLU(第 1 讲代码 04:比 sigmoid / tanh 好训练得多)、GPU(两块 3GB 显存的 GTX 580,模型放不下一块卡,所以拆成两半)、dropout(第 6 讲,用在前两个全连接层)、数据增强(本讲 §8)。它还用了一种叫 LRN(Local Response Normalization,局部响应归一化)的层:让每个位置上相邻通道的响应互相抑制。后来 VGG 的论文专门做了对照,发现 LRN 并不提高准确率,今天已经基本没人用了(它的位置被第 9 讲的 Batch Norm 取代)。Ng 的评价是:这篇论文让计算机视觉界真正相信了深度学习,而且它在当时算是一篇比较容易读的论文。
2.3 VGG-16(2014)
VGG(Simonyan & Zisserman)的想法是:别再为每一层挑核大小、步长了,整个网络只用两种零件:
- 3×3、stride 1、same 的卷积;
- 2×2、stride 2 的最大池化。
五个阶段,每个阶段若干个卷积层 + 一个池化:通道 64 → 128 → 256 → 512 → 512,边长 224 → 112 → 56 → 28 → 14 → 7;13 个卷积层 + 3 个全连接层 = 16 个有权重的层(VGG-19 是 16 个卷积层)。
代码 01 演示 3:参数 138,357,544 个(约 1.38 亿),每张图 15,470,264,320 次乘加(约 155 亿)。全连接层占参数的 89.4%,却只占乘加的 0.8%。每个阶段结束时激活值的个数:112×112×64 = 802,816 → 56×56×128 = 401,408 → 28×28×256 = 200,704 → 14×14×512 = 100,352 → 7×7×512 = 25,088——通道翻倍、面积变成 1/4,所以每个阶段的激活值大致减半。
为什么只用 3×3? VGG 论文自己给的理由:两个 3×3 卷积叠起来,感受野和一个 5×5 一样(第二层的每个输出看第一层的 3×3,而第一层的每个输出又看输入的 3×3,合起来是 5×5),但是:
| 感受野 | 一层大核( 个通道进出,不算偏置) | 几个 3×3 叠起来 | 演示 3() |
|---|---|---|---|
| 5×5 | 两层:(少 28%) | 1,638,400 vs 1,179,648 | |
| 7×7 | 三层:(少 45%) | 3,211,264 vs 1,769,472 |
参数更少,中间还多了 ReLU(更多非线性)。这是”用深度换宽度”的一个很具体的例子。
VGG 的缺点也很明显:大。每张图前向时,卷积、池化、全连接层的输出一共 15,087,080 个数(float32 约 58 MB),训练时反向传播要用到它们(第 4 讲 §4.4 的 cache),乘上 batch 大小就是显存吃紧的原因。Ng 很喜欢 VGG 的”系统化”:你只需要决定每个阶段放几个卷积层,网络的形状就定了。
2.4 从三个网络里读出的模式
代码 01 演示 5 把它们和 §3.5 的 ResNet-50 放在一起:
| 网络 | 年份 | 有权重的层 | 参数 | 乘加 / 张图 | 乘加 / 参数 | 全连接层参数占比 |
|---|---|---|---|---|---|---|
| LeNet-5 | 1998 | 5 | 61,706 | 416,520 | 7 | 95.8% |
| AlexNet | 2012 | 8 | 62,378,344 | 1,135,256,096 | 18 | 94.0% |
| VGG-16 | 2014 | 16 | 138,357,544 | 15,470,264,320 | 112 | 89.4% |
| ResNet-50 | 2015 | 50 | 25,557,032 | 3,857,973,248 | 151 | 8.0% |
三条规律值得记住:
- 高和宽变小、通道变多——四个网络都是。
- 参数在全连接层,计算在卷积层——前三个网络都是;ResNet-50 用”全局平均池化 + 一个全连接层”把分类头的参数从上亿降到 200 万(§3.5),这条规律才被打破。
- “乘加 / 参数”越来越大:卷积核在每个位置都要用一次,参数被反复复用。手机上更在乎乘加次数和内存,§5 的 MobileNet 就是冲着这一列去的。
从 LeNet 到 VGG,网络越来越深、越来越大;ResNet-50 更深,参数和计算却少得多。“深”和”大”是两件事(第 4 讲 §5.2 说过一次),ResNet 是怎么把它们分开的?这是下一节的主题。
3. 残差网络 · Residual networks (ResNets)
3.1 越深越好吗?
VGG 证明了”更深更好”——16、19 层比 11 层好。那么 30 层、50 层、100 层呢?
第 4 讲 §5 已经给了一个警告:在全连接网络上,“能表示”不等于”能学到”,更深的网络没有带来好处。第 7 讲讲了一个原因:信号和梯度在深网里会指数地变大或变小;第 9 讲的 Batch Norm 在每一层把尺度拉回来。有了 He 初始化和 BN,是不是就可以随便加深了?
He et al. (2016) 的实验给出了一个出人意料的答案。他们在 CIFAR-10 上比较 20 层和 56 层的 plain 网络(就是普通的卷积层一层接一层,没有捷径;每层都有 BN):56 层网络的测试误差更高——这不奇怪,可能是过拟合;但它的训练误差也更高。
先停下来想一想:这为什么出人意料?
因为更深的网络至少能做到和浅的一样好:把 20 层网络的参数原样复制过来,多出来的 36 层都设成”恒等映射”(输出 = 输入),这个 56 层网络的训练误差就和 20 层的完全一样。既然存在这样一组参数,训练误差就不该更高——除非梯度下降找不到它。He et al. 把这叫做退化问题(degradation problem):问题出在优化上,不是出在过拟合上,也不是(他们认为)出在梯度消失上。
3.2 在玩具世界里看见退化
代码 02 演示 3 复现了这个现象的缩小版:形状世界里的 8 种形状(16×16 彩色图,训练 4000 张、测试 2000 张),He et al. 在 CIFAR-10 上用的 层结构(stem 卷积 + 三个阶段各 个块、每块两个 3×3 卷积 + 全连接层;通道 8 → 16 → 32,比原论文窄一半),每层都有 BN、He 初始化,SGD 学习率 0.1(原论文的值)、动量 0.9、batch 64、训练 300 步,3 个种子。先只看 plain 网络:
| 网络 | 参数 | 训练误差(3 个种子平均) | 各种子 | 测试误差 |
|---|---|---|---|---|
| plain-8 | 19,152 | 0.442 | 0.482 0.379 0.466 | 0.473 |
| plain-20 | 67,984 | 0.750 | 0.826 0.755 0.668 | 0.754 |
| plain-32 | 116,816 | 0.809 | 0.850 0.752 0.825 | 0.812 |
(训练误差是训练结束后在全部 4000 张训练图上算的;8 类瞎猜的误差是 0.875。)
plain 网络越深,训练误差越高,三个种子都是 8 层最好。测试误差和训练误差几乎一样——根本谈不上过拟合,深网络连训练集都没学好。
代码 02 演示 5 再做那个”存在性”的实验:拿演示 3 里训练好的 plain-8(种子 0),在每个阶段插入”恒等块”(两个卷积核都是”中心为 1、其余为 0、只连同一个通道”,BN 设成不改变输入),直接得到 20 层、32 层的 plain 网络:
| 网络 | 层数 | 训练损失 | 训练误差 |
|---|---|---|---|
| 训练好的 plain-8 | 8 | 1.0546 | 0.4820 |
| + 插入恒等块 | 20 | 1.0546 | 0.4820 |
| 对照:SGD 从随机初始化训练的 plain-20 | 20 | 2.0469 | 0.8263 |
| + 插入恒等块 | 32 | 1.0546 | 0.4820 |
| 对照:SGD 从随机初始化训练的 plain-32 | 32 | 2.0724 | 0.8498 |
更深的 plain 网络能做到和浅网络一样好(解是存在的,我们亲手构造了它),但 SGD 从随机初始化出发找不到它。这就是第 4 讲 §5.4”能表示 ≠ 能学到”在卷积网络上的又一次出现。
3.3 残差块 · The residual block
He et al. 的解决办法只改了一行。普通的两层(Ng 的记号, 是 ReLU):
残差块(residual block)在最后一步之前,把两层之前的输入直接加上来:
走的这条路叫捷径(shortcut)或跳跃连接(skip connection);经过两层计算的那条路叫主路径(main path)。把主路径写成 ,,残差块就是 ——主路径只需要学”输出和输入差多少”(残差,residual),这是名字的由来。在卷积网络里, 换成卷积, 后面通常有 BN;代码里就是 arch_blocks.BasicBlock 的这一行:
z = z + self.shortcut(a) # z[l+2] + a[l]:残差连接就是这一行把很多残差块叠起来就是残差网络(ResNet)。代码 02 里的 plain 网络和残差网络逐层一一对应,唯一的差别就是这一行(外加两处通道数变化时捷径上的 1×1 投影,§3.5,每处多几百个参数)。演示 3 的完整结果:
| 网络 | 训练误差(平均) | 各种子 | 测试误差 | 最后 50 步的训练损失 |
|---|---|---|---|---|
| plain-8 | 0.442 | 0.482 0.379 0.466 | 0.473 | 1.037 |
| plain-20 | 0.750 | 0.826 0.755 0.668 | 0.754 | 1.835 |
| plain-32 | 0.809 | 0.850 0.752 0.825 | 0.812 | 1.921 |
| 残差-8 | 0.526 | 0.537 0.403 0.638 | 0.566 | 1.057 |
| 残差-20 | 0.616 | 0.585 0.619 0.643 | 0.640 | 1.408 |
| 残差-32 | 0.775 | 0.866 0.712 0.747 | 0.786 | 1.859 |
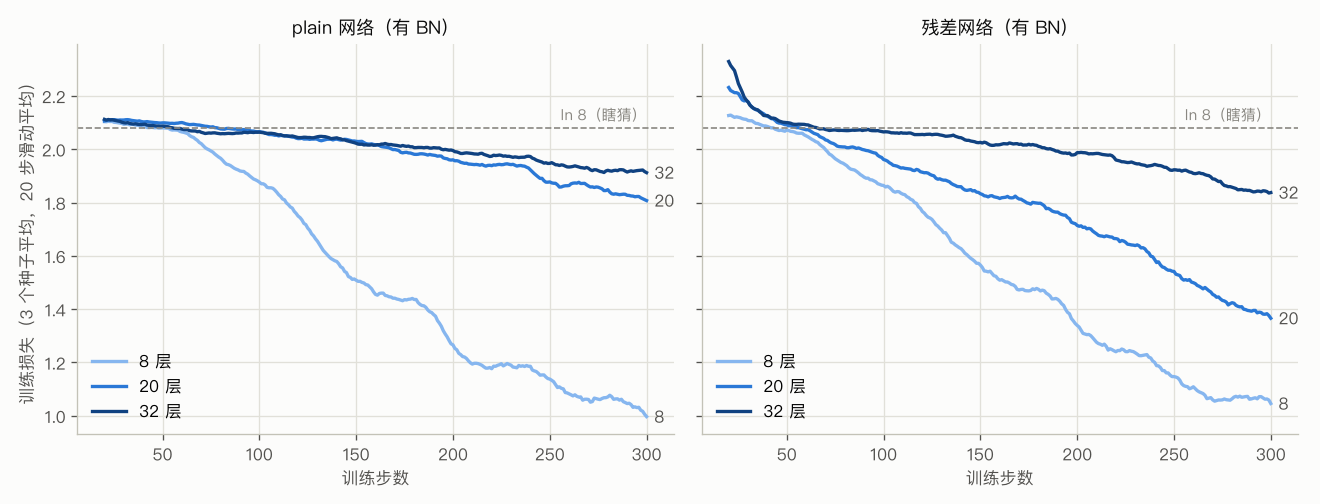
(这张图由 02_plain_vs_residual.py 生成,画的是训练过程中、训练模式下的 mini-batch 损失;没装 matplotlib 时脚本只打印表格。)
这张表要诚实地读:
- 20 层时,残差网络明显好于 plain 网络:训练误差 0.616 vs 0.750,三个种子都是如此;图里 20 层的残差曲线(右)远低于 20 层的 plain 曲线(左)。
- 32 层时,残差网络平均好一些(0.775 vs 0.809),但不是每个种子都好(种子 0 反而更差:0.866 vs 0.850)。
- 8 层时残差网络反而略差(0.526 vs 0.442;训练模式下最后 50 步的损失 1.057 vs 1.037 几乎一样)。
- 在这么短的训练里(300 步,不到 5 个 epoch),残差网络也没有做到”越深越好”:残差-32 比残差-8 差得多。He et al. 的”越深越好”来自训练到收敛(CIFAR-10 上 6.4 万步)、更宽的网络;我们的 CPU 预算只够看到训练的开头。
所以在这个玩具世界里,结论要说得准确:残差连接缓解了退化(尤其在 20 层),但在我们的预算里没有完全消除它。§3.4 的演示 2 会给出一个线索,练习 6 让你试一个常用的改进。(表里”训练误差”和”最后 50 步的训练损失”偶尔不一致,比如残差-8 的 eval 模式损失 1.427、训练模式 1.057:前几百步参数变得很快,BN 的 running 统计量跟不上,第 9 讲 §2.5。)
3.4 为什么残差网络有效 · Why ResNets work
直觉一:恒等映射是”默认值”。 这是 Ng 在 “Why ResNets Work?” 里给的论证。设想你在一个已经训练好的大网络后面再加两层,做成一个残差块:
如果用了 L2 正则化(weight decay,第 6 讲 §4.3),权重会被一路往 0 压。极端情况 、:
最后一个等号成立,是因为 本身是 ReLU 的输出,非负,ReLU 对它什么也不做。也就是说,残差块想学成恒等映射,只要把权重变成 0 就行——这件事对梯度下降来说再容易不过。所以加上这两层,最坏的情况也只是”什么都不做”,不会让网络变差;运气好的话,它们还能学到一点有用的东西。plain 网络就没有这个保底:权重为 0 时它的输出是 0,信息被整个抹掉。
代码 02 演示 1 把这个论证变成数字。(a) 把同一组权重乘以 、让 :
| plain 块: | 残差块:同左 | |
|---|---|---|
| 1 | 1.5875 | 1.59e+00 |
| 0.1 | 0.9910 | 1.67e−04 |
| 0.01 | 0.9999 | 1.67e−08 |
| 0 | 1.0000 | 0.00e+00 |
(b) 从 He 初始化出发,用 Adam 训练一个块去拟合恒等映射(3 个种子平均):第 300 步时,plain 块的相对误差还有 4.8e−02,残差块是 1.7e−05。plain 块必须用两个卷积、两个 ReLU 拼出一个恒等映射(每个 3×3 核的中心是 1、其余是 0);残差块只需要把主路径压小。
直觉二:梯度的”高速公路”。 先忽略最后那个 ReLU,残差块是 。对 求导:
多了一个单位矩阵 。叠很多块时,从损失传回第 层的梯度是一串 的乘积,展开以后总有一项是 ——梯度可以沿着捷径直接流回前面的层,不必穿过每一个主路径。plain 网络里则只有 这一项,任何一层”打了折”或”放大了”,都会被连乘下去(第 7 讲 §2)。
代码 02 演示 2 在刚初始化时看了信号和梯度(一个 batch 128 张,3 个种子的中位数):
| 网络 | (a) 信号:最后一块 / stem 的 RMS,32 层 | 110 层 | (b) 梯度: 第一个卷积 / 最后一个卷积,32 层 | 110 层 | (c) 初始损失,32 层 | 110 层 |
|---|---|---|---|---|---|---|
| plain + BN | 0.988 | 0.98 | 32.4 | 2.57e+06 | 2.132 | 2.130 |
| 残差 + BN | 2.8 | 5.48 | 4.94 | 39.8 | 2.479 | 3.153 |
| plain,无 BN | 0.000609 | 2.43e−12 | 0.724 | 12 | 2.068 | 2.076 |
| 残差,无 BN | 32 | 2.08e+05 | 0.282 | 0.253 | 15.310 | 7.60e+04 |
| 残差,无 BN,分支末层置 0 | 0.89 | 0.817 | 0.508 | 0.608 | 2.080 | 2.155 |
这张表比我预想的有意思:
- plain + BN:前向的信号很稳定(BN 每一层都把尺度拉回来),但反向的梯度越往前越大:第一个卷积和最后一个卷积的梯度之比,8 层时 0.977,32 层时 32.4,110 层时 2.57e+06——随深度指数增长的梯度爆炸。Yang et al. (2019) 用 mean-field 理论证明过:在没有捷径的深网络里,BN 本身就会在初始化时造成梯度爆炸。He et al. 说退化”不太可能是梯度消失造成的”,我们的测量也同意——不是消失,是爆炸。
- 残差 + BN:梯度之比只到 39.8(110 层),这是”高速公路”在起作用。代价是信号随深度慢慢变大(8 层 1.41 → 110 层 5.48)、初始损失也从 2.114 涨到 3.153:每个块都往”总和”里再加一份方差。演示 3 里深的残差网络起步慢,可能与此有关(练习 6)。
- 没有 BN 的两行和最后一行留到 §3.6。
He et al. 本人对”为什么”的解释是第一个直觉(让多出来的层容易学成恒等映射);后来的研究给了更多角度,比如残差网络的损失曲面更平滑(Li et al. 2018 的可视化),plain 深网的梯度在不同输入之间几乎不相关、像白噪声(Balduzzi et al. 2017 的 “shattered gradients”)。和第 9 讲讲 BN 时一样:方法好用,不等于我们完全知道它为什么好用。
3.5 维度不一致:、identity block 与 convolutional block
要求两者形状相同。ResNet 里大量使用 same 卷积,大多数时候形状确实不变。但每个阶段开头要把边长减半、通道加倍,这时 Ng 的写法是在捷径上乘一个矩阵:
可以是学出来的参数,也可以是固定的(比如用 0 把多出来的通道补齐)。卷积网络里, 就是一个 1×1、stride 2 的卷积(§4.1 会讲 1×1 卷积为什么等于”在每个像素上乘一个矩阵”)。原论文的 CIFAR 实验用的是补零的捷径(“option A”),代码 02 用的是 1×1 投影(“option B”),残差网络因此比 plain 网络多几百个参数(比如 19,888 vs 19,152)。
这就是 Coursera 作业 “Residual Networks” 里两个函数的区别:
- identity block(恒等块):输入输出形状相同,捷径就是 本身。
- convolutional block(卷积块):形状变了,捷径上放一个 1×1 卷积(+ BN)。
ResNet-50 还用了 bottleneck(瓶颈)结构:每个块是三层而不是两层——1×1 卷积把通道压窄 → 3×3 卷积 → 1×1 卷积恢复。昂贵的 3×3 只在窄的通道上做。代码 01 演示 4:在 512 个通道上,bottleneck 块(512 → 128 → 128 → 512)的卷积权重 278,528 个,两个 512 通道的 3×3 卷积是 4,718,592 个,多 17 倍。
| 阶段 | 块的组成 | 输出形状(输入 224×224×3) | 参数 |
|---|---|---|---|
| stem | 7×7 conv, s2 + 3×3 max pool, s2 | 56×56×64 | 9,536 |
| 阶段 2 | 卷积块 [64, 64, 256], s = 1 + 2 个恒等块 | 56×56×256 | 215,808 |
| 阶段 3 | 卷积块 [128, 128, 512], s = 2 + 3 个恒等块 | 28×28×512 | 1,219,584 |
| 阶段 4 | 卷积块 [256, 256, 1024], s = 2 + 5 个恒等块 | 14×14×1024 | 7,098,368 |
| 阶段 5 | 卷积块 [512, 512, 2048], s = 2 + 2 个恒等块 | 7×7×2048 | 14,964,736 |
| 头 | 全局平均池化 + FC 1000 | 1000 | 2,049,000 |
| 合计 | 1 + 16 × 3 + 1 = 50 层 | 25,557,032(乘加 3,857,973,248) |
和 VGG-16 比,参数约五分之一、乘加约四分之一,却深了三倍多。省在两个地方:bottleneck,以及全局平均池化(global average pooling,来自 §4.1 的 Network in Network):把 7×7×2048 直接平均成 2048 个数再接一个全连接层,分类头只有约 205 万个参数,而 VGG-16 的三个全连接层有 1.24 亿个。Coursera 作业的设定(输入 64×64×3、SIGNS 手势 6 类)参数是 23,520,326 个——和 224×224 时几乎一样,因为卷积层的参数和输入大小无关(第 12 讲),只有最后的全连接层随类别数变。
(细节:作业和原论文把 stride 2 放在卷积块的第一个 1×1 卷积上;torchvision 的 “ResNet v1.5” 放在 3×3 卷积上,参数个数相同,乘加略多。)
3.6 没有 BN 时:初始化要和结构配套
回到 §3.4 表里没有 BN 的两行。
- plain,无 BN:He 初始化保证的只是信号的期望尺度不变;我们的网络很窄(8–32 个通道),涨落是逐层相乘的(第 7 讲 §3.7),110 层时信号比只剩 2.43e−12。
- 残差,无 BN:每一块都在 上加一个和 差不多大的 ,信号一路放大:110 层时 2.08e+05,初始损失 7.6e+04(logits 爆炸)。He 初始化是为 plain 网络推导的,直接用在没有 BN 的残差网络上并不对。
解决办法正好来自 §3.4 的第一个直觉:把每个残差分支的最后一层初始化为 0。这样刚开始每一块都是恒等映射,整个网络等于”stem + 两处 1×1 投影 + 分类头”,信号比在 0.744–1.01 之间(不恰好是 1,是因为通道数变化的两处有 1×1 投影卷积)、初始损失约等于 ,和深度无关。这个思路有好几个版本:Goyal et al. (2017) 把每个残差块最后一个 BN 的 初始化为 0(torchvision 里叫 zero_init_residual);Fixup(Zhang et al. 2019)则不用 BN,靠重新缩放初始化来训练很深的残差网络。
代码 02 演示 4 在没有 BN 的情况下训练了一遍(1 个种子,其余设置和演示 3 相同;训练误差 / 训练损失):
| 网络 | 8 层 | 20 层 | 32 层 |
|---|---|---|---|
| plain,He 初始化 | 0.723 / 1.756 | 0.875 / 2.081 | 0.875 / 2.081 |
| 残差,He 初始化 | 0.657 / 1.552 | 0.875 / 2.081 | 第 3 步就发散(nan) |
| 残差,分支末层置 0 | 0.734 / 1.797 | 0.742 / 1.777 | 0.874 / 2.080 |
没有 BN 时一切都慢得多(8 层的三种网络 0.657–0.734;同样是种子 0,有 BN 时 0.482–0.537);plain 网络 20 层以上完全不动;标准初始化的残差网络 32 层时第 3 步就数值爆炸;分支末层置 0 让 20 层能训练起来,但 32 层在 300 步里仍然没动。只有 1 个种子,这一节只能当作定性的例子。它想说明的是:残差连接不是一个孤立的技巧,它和初始化、BN 是配套设计的——今天的 ResNet、Transformer(第 17 讲)都是”残差 + 归一化 + 合适的初始化”一起用。
4. 1×1 卷积与 Inception · Network in Network and Inception
4.1 1×1 卷积:每个像素上的全连接层
1×1 的卷积听起来很奇怪:卷积核只有一个像素大,能看到什么?
如果输入只有一个通道,1×1 卷积确实没用——就是把每个数乘以一个常数(代码 03 演示 1:权重 2 的单通道 1×1 卷积把 [1, 2, …, 6] 变成 [2, 4, …, 12])。但输入有 192 个通道时,一个 1×1 卷积核在每个像素上做的是:拿这个像素的 192 个数做一个加权和(再加偏置、过 ReLU)。 个核,就是在每个像素上做一次 192 → 的全连接层,所有像素共享同一组权重。演示 1 在 float64 下验证了:Conv2d(192, 32, 1) 和”对每个像素做 Linear(192, 32)”的结果最大差 1.4e−15(只是舍入误差)。
Lin, Chen & Yan (2013) 把它叫做 Network in Network。它有三种用途:
- 压缩通道:28×28×192 → 1×1 卷积 32 个 → 28×28×32(参数 6,176 个)。池化压缩的是高和宽,1×1 卷积压缩的是通道。
- 扩展通道:反过来把通道变多(§5.4 的 MobileNet v2)。
- 只加非线性:通道数不变(192 → 192),只是多了一层 ReLU,让网络能表示更复杂的函数。
同一篇论文还提出了全局平均池化:最后一层的每个通道在整张图上求平均,直接得到每个类别(或特征)的一个分数,代替巨大的全连接层。§3.5 已经看到它把 ResNet-50 的分类头压到了 200 万个参数。
4.2 Inception 的动机:让网络自己选
设计一层卷积时,你要选:1×1、3×3 还是 5×5?要不要池化?Szegedy et al. (2015) 的想法是:不选了,都用上。同一个输入同时走几条分支,输出在通道维上拼接(Ng 的例子):
                 ┌─ 1×1 卷积, 64 ──────────────────→ 28×28×64  ┐
28×28×192 ──────┼─ 3×3 卷积 (same), 128 ───────────→ 28×28×128 ├─ 拼接 → 28×28×256
                 ├─ 5×5 卷积 (same), 32 ────────────→ 28×28×32  │
                 └─ 3×3 最大池化 (same, s1) → 1×1, 32 → 28×28×32  ┘
各条分支要用 same 卷积 / stride 1 的池化,保证高和宽一样才能拼接。池化分支后面加一个 1×1 卷积,是因为池化不改变通道数,否则它会带着全部 192 个通道进入输出。网络自己通过训练决定每条分支有多重要。
4.3 计算量问题与瓶颈层
先算一算:只看 5×5 那条分支,28×28×192 → 28×28×32,要做多少次乘法?
输出有 28 × 28 × 32 个数,每个数是一个 5 × 5 × 192 的核和输入做内积:
一张图、一条分支就是 1.2 亿次。Ng 给的办法是先用 1×1 卷积把 192 个通道压到 16 个(瓶颈层,bottleneck layer),再做 5×5:
代码 03 演示 2 用真实的 PyTorch 层验证:
| 做法 | 参数 | 乘加(逐层统计) | 乘加(公式) | 8 张图前向(毫秒,我运行的一次) |
|---|---|---|---|---|
| 直接 5×5 | 153,632 | 120,422,400 | 120,422,400 | 6.6 |
| 1×1 压到 16 → 5×5 | 15,920 | 12,443,648 | 12,443,648 | 0.6 |
乘加少了 9.7 倍,参数少了 9.7 倍;运行时间也快了约 11 倍(我运行的那一次是 10.8 倍,计时每次不同)——普通卷积的时间大致跟着乘加走。会不会伤害表现?Ng 的回答是:只要瓶颈层压得合理(不要太窄),通常不会明显变差——192 个通道里的信息有大量冗余,1×1 卷积先把它”总结”成 16 个通道,5×5 再在这 16 个通道上看空间结构。这和 §3.5 的 bottleneck 是同一个想法。
4.4 Inception 模块与 GoogLeNet
把瓶颈层加到 3×3、5×5 分支前面,再给池化分支接一个 1×1,就是 GoogLeNet 论文里的 Inception 模块。演示 2 按论文 Table 1 的 inception (3a) 配置(1×1: 64;1×1 压到 96 → 3×3: 128;1×1 压到 16 → 5×5: 32;池化 → 1×1: 32)数了一遍:
| 版本 | 输出通道 | 参数 | 乘加 |
|---|---|---|---|
| 朴素版(没有 1×1 压缩) | 416 | 387,296 | 303,464,448 |
| 带 1×1 瓶颈(论文) | 256 | 163,696 | 128,049,152 |
论文表里这一层写的计算量是 128M,和我们数的一致。朴素版不光计算量大 2.4 倍,输出还有 416 个通道(池化分支带着 192 个通道原样输出),一层层叠下去,通道数会越滚越大。
GoogLeNet(名字是向 LeNet 致敬)就是把很多个 Inception 模块叠起来,中间插几个池化层缩小尺寸。它还有一个特别的设计:在网络中间引出几个旁支(side branches),各接一个小的 softmax 分类器,训练时把它们的损失也加进总损失。这让中间层的特征也要对分类有用,起到一点正则化的作用(测试时不用这些旁支)。Ng 讲完这一节时提到,“Inception”这个名字来自电影《盗梦空间》里的一句台词 “We need to go deeper”——论文的参考文献里真的引用了这个网络梗。
5. MobileNet 与 EfficientNet · Efficient architectures
5.1 动机:在手机上跑
VGG-16 每张图 155 亿次乘加。在服务器的 GPU 上没问题,在手机、摄像头、手表上就太慢、太耗电了。MobileNet(Howard et al. 2017)的目标是:计算量降一两个数量级,准确率尽量不掉。核心零件是 depthwise separable 卷积。
5.2 depthwise separable 卷积
普通卷积的每个核同时做两件事:在空间上看一个 的邻域,并且把所有 个输入通道混合起来。depthwise separable 把这两件事拆开:
- depthwise 卷积:每个输入通道各用一个自己的 核,只在空间上滤波,通道之间不混合。输入 个通道,输出还是 个通道。(PyTorch 里就是
groups = n_c的卷积。) - pointwise 卷积:一个 1×1 卷积(§4.1),在每个像素上把 个通道线性组合成 个。
Ng 的例子:输入 6×6×3,3×3 核,5 个输出通道,valid 卷积 → 4×4×5。
比例 (代码 03 演示 3 打印了这三个数)。一般地,输出边长 时:
和输入通道数、图像大小都无关。 时 ,正好对上。实际网络里 通常是几百, 可以忽略,3×3 时计算量约降到 1/9:
| 32 | 128 | 512 | ||
|---|---|---|---|---|
| 3 | 0.236 | 0.142 | 0.119 | 0.113 |
| 5 | 0.165 | 0.071 | 0.048 | 0.042 |
代价是表达能力受了限制:一个普通卷积核可以对每个通道用完全不同的空间图案,separable 的”核”必须能分解成”每个通道一个空间核 × 一个通道组合”。MobileNet 论文里,同样结构的普通卷积版在 ImageNet 上 top-1 准确率 71.7%,separable 版 70.6%,只掉了约 1 个百分点,计算量却少了 8 倍多。
5.3 MobileNet v1
MobileNet v1 的结构很简单:一个普通的 3×3 卷积(stride 2),然后 13 个 depthwise separable 块(每块:depthwise 3×3 → BN → ReLU → pointwise 1×1 → BN → ReLU),中间有几块 stride 2 把边长减半,最后平均池化 + 全连接 + softmax。它还给了两个”旋钮”:宽度乘子 (每层通道数乘以 )和分辨率乘子(缩小输入图像),让你按设备的预算选模型大小。
5.4 MobileNet v2:扩张、depthwise、线性投影
MobileNet v2(Sandler et al. 2018)的块叫 bottleneck 块或倒残差块(inverted residual):
输入 n×n×c ─1×1 扩张(×t)→ n×n×tc ─depthwise 3×3 → n×n×tc ─1×1 投影 → n×n×c'  (+ 输入,如果形状相同)
            BN + ReLU6               BN + ReLU6              BN,**没有** ReLU
Ng 的讲法是:
- 扩张(expansion,默认 ):depthwise 卷积很便宜,所以先用 1×1 把通道”撑宽”,让它在更宽的空间里提取更丰富的特征(比如 3 个通道 → 18 个)。
- 投影(projection):再用 1×1 把通道压回去(18 → 3)。块与块之间传递的是窄的表示,内存占用小——这对手机很重要。
- 残差:形状相同时把输入加到输出上(§3.3)。和 ResNet 的 bottleneck 正好反过来:ResNet 是”宽 → 窄 → 宽”、捷径连宽的两头;v2 是”窄 → 宽 → 窄”、捷径连窄的两头,所以叫 inverted。
- 线性瓶颈:投影之后不加 ReLU。论文的论证是:在很窄的通道上做 ReLU 会把落在负半轴的信息永久丢掉。
ReLU6 是 ,把输出限制在 [0, 6],在手机上用 8 位整数做推理时更稳。
5.5 账本与实测
代码 03 演示 4 在 meta 设备上搭出 ImageNet 级别的几个网络(输入 224×224×3,1000 类):
| 网络 | 参数 | 乘加 | 相对 VGG-16 的乘加 | 论文 / 公认的数字 |
|---|---|---|---|---|
| VGG-16 | 138,357,544 | 15,470,264,320 | 1 | 138M |
| ResNet-50 | 25,557,032 | 3,857,973,248 | 1/4 | 25.6M、约 3.8G |
| MobileNet v1() | 4,231,976 | 568,740,352 | 1/27 | 4.2M、569M |
| MobileNet v1() | 1,331,592 | 149,497,088 | 1/103 | |
| MobileNet v2 | 3,504,872 | 300,774,272 | 1/51 | 3.4M、300M |
MobileNet v1 的数字和论文完全对上。v2 的结构和 torchvision 的 mobilenet_v2 一致,参数个数也和它一致;和论文写的 3.4M 的差别从哪里来,我没有查清。按论文报告的 ImageNet top-1 准确率(v1 70.6%、v2 72.0%;MobileNet 论文表里 VGG-16 是 71.5%),计算量少了几十倍,准确率却差不多。宽度乘子 让参数和乘加都大约变成 1/4(两者都和通道数的平方成正比)。
乘加少,就一定跑得快吗? 演示 3 在真实大小的层上计时(batch 8,3×3,我运行的一次):
| 层 | 普通卷积乘加 | separable 乘加 | 乘加之比 | 普通 ms | separable ms | 时间之比 |
|---|---|---|---|---|---|---|
| 56×56×64 → 128 | 231,211,008 | 27,496,448 | 8.4 | 4.0 | 2.1 | 1.9 |
| 28×28×128 → 128 | 115,605,504 | 13,748,224 | 8.4 | 2.2 | 1.0 | 2.2 |
| 14×14×256 → 256 | 115,605,504 | 13,296,640 | 8.7 | 2.7 | 0.7 | 3.7 |
乘加少了 8–9 倍,时间只少了 2–4 倍。depthwise 卷积每做一次乘法要读的数据更多(“计算密度”低),在 CPU 和 GPU 上都不如普通卷积高效。乘加次数是”省了多少”的上限,不是实际的加速比——MobileNet 的速度优势,要在为它专门优化过的芯片和推理引擎上才能完全兑现。
最后,代码 03 演示 6 在形状世界的 16 类任务上(24×24,训练 6400 张、测试 3200 张,Adam,200 步,3 个种子)训练了三个同骨架的小网络:
| 卷积块(通道) | 参数 | 乘加 / 张图 | 测试准确率 | 各种子 | 训练 1000 张(秒,我运行的一次) |
|---|---|---|---|---|---|
| 普通 3×3 卷积 (16, 32, 64) | 71,008 | 4,231,168 | 0.325 | 0.305 0.302 0.368 | 0.38 |
| depthwise separable (16, 32, 64) | 11,152 | 785,536 | 0.146 | 0.150 0.129 0.159 | 0.52 |
| depthwise separable (32, 64, 128) | 37,648 | 2,455,808 | 0.251 | 0.265 0.168 0.320 | 1.11 |
这个结果和 MobileNet 论文的结论不一样:同样宽度时,separable 版本的乘加只有 1/5.4,准确率却掉了一半多;把省下的预算拿去加宽(通道翻倍,乘加仍只有普通版的 58%)追回了一部分,但仍不如普通版。可能的原因(没有专门验证):我们的通道只有 16–64 个,depthwise 那一步每个通道只有 9 个参数,表达能力受限比 ImageNet 级的宽网络严重得多;训练只有 2 个 epoch,参数少的网络可能需要更久。另外看最后一列:在 CPU 上,乘加最少的网络并不是训练最快的,加宽的 separable 版本反而最慢。省计算的架构,省的是”在合适的硬件上、合适的规模下”的计算——这正是为什么要在自己的任务和设备上实测,而不是只看论文的表格。
5.6 EfficientNet:复合缩放
假设你有一个基准网络,现在多了一倍的计算预算,该怎么花?可以加深(更多层)、加宽(更多通道)、或者用更高分辨率的输入。Tan & Le (2019) 的发现是:三个维度一起按比例放大,比只放大其中一个更好。理由是三者互相需要:分辨率高了,需要更深的网络(更大的感受野)才能看到整个物体,也需要更宽的网络(更多通道)去捕捉多出来的细节。
卷积网络的计算量大致 深度 × 宽度² × 分辨率²(宽度出现两次:输入、输出通道都变宽;分辨率出现两次:高和宽)。EfficientNet 用一个系数 控制:
论文在基准网络(用神经架构搜索得到的 EfficientNet-B0,由 MobileNet v2 式的倒残差块组成)上小范围搜出 ,于是 每加 1,计算量大约翻一倍; 就是 B1 到 B7。
代码 03 演示 5 在一个小网络上只数了乘加(没有训练):; 时乘加是基准的 1.00、2.25、3.99、8.51 倍(块数向上取整、通道取 4 的倍数,所以只是大致符合 )。只放大一个维度、计算量也约翻倍的三个对照:只加深 1.96 倍、只加宽 1.81 倍、只加分辨率 2.09 倍。三种花法在我们的小任务上谁更准,留作练习 8。
Ng 对这一节的建议很实用:如果你要把模型部署到不同的设备上,EfficientNet 给了一个”按预算选大小”的现成配方;很多框架里 B0–B7 都有预训练好的权重。
6. DenseNet 与推荐阅读 · DenseNet and the recommended reading
Fall 2025 第 6 次课那一周的推荐阅读是两篇论文:Dropout(Srivastava et al. 2014,第 6 讲 §5 已经讲过它的机制)和 DenseNet(Huang et al. 2017)。后者是对 ResNet 的一个很自然的追问:既然”把前面的输出传下去”这么有用,为什么只传给后面隔一层的那一层?
dense block:第 层的输入是前面所有层输出的拼接:
是 BN → ReLU → 3×3 卷积,每层只输出 个新通道( 叫增长率,growth rate,论文里常用 12 或 32)。一个 层的 dense block 有 条连接,输出通道数是 (代码 arch_blocks.DenseBlock 的自检:16 个通道进、、3 层,出来 28 个通道)。
和 ResNet 的对比:
| ResNet | DenseNet | |
|---|---|---|
| 怎样把前面的信息传下去 | 相加: | 拼接: |
| 后面的层能看到什么 | 前面所有层”加在一起”的结果 | 前面每一层各自的输出 |
| 每层输出多少通道 | 和输入一样多 | 很少() |
| 代价 | — | 通道数随层数线性增长,块之间要用 1×1 卷积 + 池化的 transition 层压缩 |
相加会把信息”混”在一起,后面的层分不清哪部分来自哪一层;拼接保留了每一层的特征,后面的层可以直接复用,所以每层只需要产生很少的新特征。论文报告 DenseNet 用更少的参数达到了和 ResNet 相当的准确率;代价是拼接带来的内存占用(需要特别的实现技巧来省显存)。
读这两篇论文时,可以用第 21 讲会系统讲的”多遍读法”:第一遍只看摘要、图和结论(Dropout 论文的图 1、DenseNet 论文的图 1 和图 2 已经说清了核心想法);第二遍看方法和主要实验;需要复现时再看细节。
7. 开源实现与迁移学习 · Open-source implementations & transfer learning
7.1 使用开源实现
Ng 在 “Using Open-Source Implementation” 里讲了一个很现实的问题:很多论文的细节(学习率衰减的时间表、初始化、数据预处理)写得不全,从论文复现一个网络往往很难。所以做计算机视觉项目的第一步,通常是找一个开源实现:在 GitHub 上搜架构的名字(“ResNet PyTorch”),看许可证,克隆下来,跑通,然后在它的基础上改。CS230 Section 3(公开网页:https://cs230.stanford.edu/section/3)给了一张评估开源仓库的清单:star 数、开源许可、README 是否清晰、是否报告了结果、是否提供数据和预训练权重、框架是否匹配、代码是否可读。最后一条——预训练权重——引出了下面的迁移学习。
在 PyTorch 里,torchvision.models 提供了 ResNet、MobileNet、EfficientNet 等架构和在 ImageNet 上训练好的权重(本讲义的代码全部离线运行,所以没有下载它们,而是在 §7.2 里自己”预训练”了一个小模型)。
7.2 迁移学习为什么能用
第 10 讲会讨论迁移学习”什么时候有用”(源任务和目标任务的输入类型相同、源数据多得多、源任务学到的低层特征对目标任务有帮助)。本讲讲在 CNN 上具体怎样做。
Ng 的例子:你想识别自己家的两只猫 Tigger 和 Misty(外加”都不是”一类),每只猫只有几十张照片。从零训练一个 CNN 远远不够。但有人已经在 ImageNet(120 万张图、1000 类)上训练好了一个网络,它的前面几十层已经学会了边缘、纹理、部件这些”看图”的通用能力。你只需要把它最后的 1000 类 softmax 换成你自己的 3 类 softmax。
代码 04 演示 1 在玩具世界里做同样的事:源任务是 16 种形状 × 600 张 = 9600 张 24×24 彩色图(我们的”ImageNet”),在上面训练一个小 CNN(transfer_kit.TransferCNN:block1 → block2 → block3 → head,71,008 个参数,4 个 epoch),源任务测试准确率 0.720(16 类瞎猜是 0.0625)。它并不完美,这没关系:迁移学习要的是它的底座学到的特征,不是它在源任务上的分类头。目标任务有两个,各 5 类:
- 相关的任务:5 种新形状(L、T、月牙、等号、Λ),由同样的零件(直边、角、弧线)组成;
- 不太相关的任务:5 种纹理(条纹、棋盘格、斑点、云纹、细线),图像统计和形状世界差别很大。
一个容易忽略的细节:目标任务的图要用源任务的均值和标准差做标准化——预训练的权重是在那个尺度下学出来的。用 ImageNet 预训练的模型,标准做法就是减去 ImageNet 的通道均值、除以通道标准差。
7.3 三种做法
Ng 按目标数据的多少给了三种做法:
            ┌──────────── 预训练的底座(block1 → block2 → block3)────────────┐ ┌ 新的头 ┐
数据很少:   [ 冻结 ][ 冻结 ][ 冻结 ]                                              [ 训练 ]
数据中等:   [ 冻结 ][ 冻结 ][ 用预训练权重初始化,微调 ]                           [ 训练 ]
数据很多: [ 全部用预训练权重初始化,一起微调 ] [ 训练 ]- 数据很少:冻结整个底座,只训练新的头。 框架里通常有
trainable = False或requires_grad = False这样的开关。还可以更进一步:既然底座不变,每张训练图经过底座的输出(特征)也不变,那就预先算好,存到硬盘上,然后只在这些特征上训练一个很小的分类器——每个 epoch 不用再把图像过一遍底座,快得多(transfer_kit.features)。代价是没法做”实时”数据增强(§8)。 - 数据中等:冻结前面的层,微调后面的层(或者把后面几层换成你自己设计的层)。数据越多,冻结的越少。
- 数据很多:用预训练的权重做初始化,全部微调。 这时预训练权重的作用相当于一个很好的初始化(比第 7 讲的任何随机初始化都好得多)。
Ng 的总结是:在计算机视觉里,除非你有一个特别大的数据集和算力预算,几乎总是应该做迁移学习。
7.4 实验:四种做法 × 数据量
代码 04 演示 2:四种做法(从零训练 / 冻结底座只训练头 / 冻结前两块、微调第三块 / 全部微调)× 每类 10、30、100、300 张 × 3 个种子。每种做法训练同样的步数(10 个 epoch,夹在 100–200 步之间);预训练的层学习率 3e−4,新的层 1e−3,只训练头时 1e−2。测试准确率(3 个种子平均,括号里是最低–最高;5 类瞎猜是 0.2):
相关任务:新形状
| 每类张数 | 从零训练 | 冻结底座,只训练头 | 冻结前两块,微调第三块 | 全部微调 |
|---|---|---|---|---|
| 10 | 0.280(0.255–0.321) | 0.840(0.827–0.852) | 0.863(0.853–0.873) | 0.730(0.696–0.772) |
| 30 | 0.426(0.404–0.465) | 0.878(0.873–0.883) | 0.924(0.912–0.935) | 0.897(0.888–0.912) |
| 100 | 0.778(0.751–0.809) | 0.884(0.876–0.896) | 0.956(0.953–0.961) | 0.960(0.960–0.961) |
| 300 | 0.884(0.852–0.933) | 0.888(0.881–0.899) | 0.958(0.941–0.971) | 0.961(0.936–0.975) |
不太相关的任务:纹理
| 每类张数 | 从零训练 | 冻结底座,只训练头 | 冻结前两块,微调第三块 | 全部微调 |
|---|---|---|---|---|
| 10 | 0.402(0.367–0.435) | 0.782(0.768–0.803) | 0.785(0.775–0.796) | 0.673(0.635–0.700) |
| 30 | 0.567(0.527–0.607) | 0.835(0.824–0.844) | 0.872(0.865–0.883) | 0.832(0.804–0.875) |
| 100 | 0.748(0.708–0.803) | 0.855(0.843–0.863) | 0.924(0.917–0.936) | 0.930(0.923–0.940) |
| 300 | 0.835(0.791–0.868) | 0.863(0.857–0.872) | 0.942(0.933–0.951) | 0.959(0.956–0.961) |
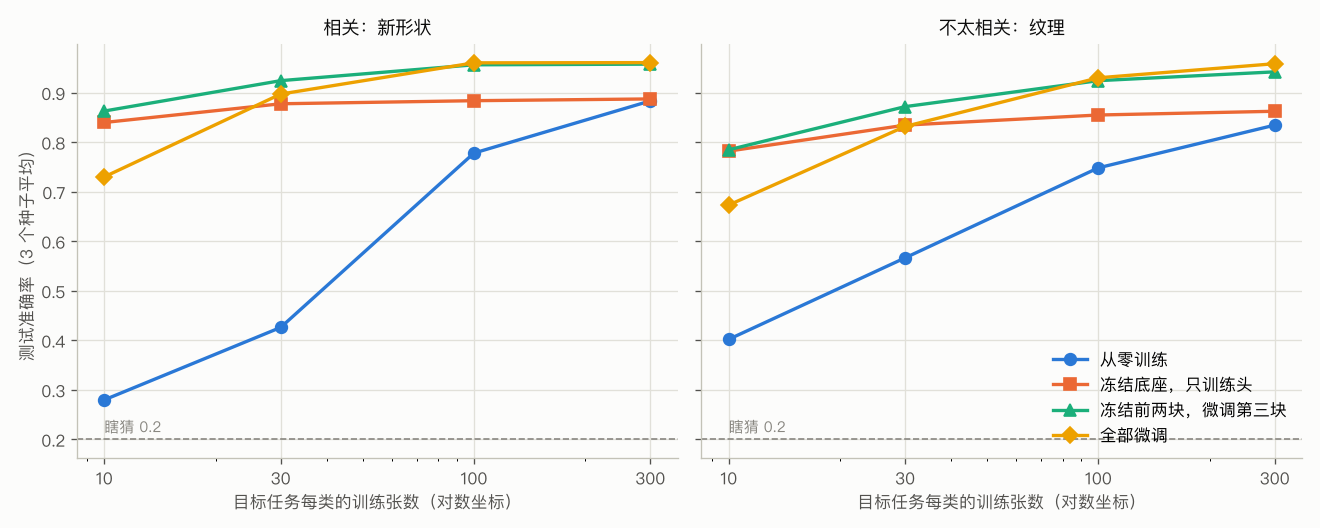
逐条对照 Ng 的规则:
- 数据很少(每类 10 张,一共 50 张):从零训练只有 0.280,借来的特征就是全部的本钱(只训练头 0.840)。同样只有 50 张,全部微调明显不如只训练头(0.730 vs 0.840):7 万个参数跟着几十张图一起改,很快就把预训练的特征”改坏”了。这正是”数据少就冻结”的原因。但在我们的世界里,“冻结前两块、只微调最后一块”(0.863)比冻结全部还要好一点——最佳的冻结位置要在 dev 集上试,不是一条死规则。
- 数据中等(每类 30 张):冻结前面、微调后面最好(0.924),和规则一致。
- 数据多(每类 100、300 张):全部微调最好(0.960、0.961),“微调第三块”几乎一样好。“只训练头”停在 0.88–0.89 不再上升:冻结的特征是为源任务学的,数据够多时,让它们也跟着目标任务调整更好。
- 从零训练涨得最快(0.280 → 0.884),在每类 300 张时追平了”只训练头”(0.888),但离微调还差 0.077:在同样的 200 步里,从预训练权重出发的网络起点高得多。每类 300 张对这个网络还不算”很多”;数据再多、训练再久,从零训练和微调的差距会继续缩小(这也是 Ng 说”数据特别多时也可以从零训练”的意思)。
- “不太相关”的纹理任务上,迁移学习仍然有很大帮助(每类 10 张:0.782 vs 0.402),四种做法的排序和相关任务完全一样;“只训练头”的天花板略低(0.863 vs 0.888)。形状世界里学到的边缘、斑点检测器对纹理一样有用——这提醒我们,“相关”和”不相关”是一个程度问题,低层特征的通用性往往比你想的强。
注意表里的最低–最高:数据最少的几行,同一种做法换一批训练图能差好几个百分点(比如每类 10 张的全部微调:0.696–0.772)。小数据时的结论,一定要多跑几个种子。
7.5 怎样微调:学习率、两阶段,以及 BN 的坑
学习率。 常见的建议是:微调时预训练的层用比从零训练小的学习率(比如 1/10),新的头用正常的学习率。理由是预训练的权重已经在一个好地方,大步子可能把学到的特征冲掉;而新的头是随机初始化的,刚开始传回去的梯度又大又乱。代码 05 演示 1(相关任务,每类 30 张,100 步,3 个种子):
| 做法 | 测试准确率(平均) | 各种子 |
|---|---|---|
| 只训练头(底座冻结,参照) | 0.861 | 0.865 0.871 0.848 |
| 全部微调:所有层 1e−3(和从零训练一样) | 0.897 | 0.885 0.899 0.908 |
| 全部微调:预训练的层 3e−4,头 1e−3 | 0.906 | 0.893 0.905 0.920 |
| 全部微调:预训练的层 1e−4,头 1e−3 | 0.891 | 0.885 0.891 0.897 |
| 两阶段:先只训练头,再全部微调(1e−4) | 0.891 | 0.899 0.893 0.881 |
四种微调方式只差 0.015,和种子之间的波动一样大:在这个 7 万参数的小网络、100 步的设定里,学习率在 1e−4 到 1e−3 之间都可以,我们的小实验没有显出”小学习率”的好处。这个建议在大模型、长时间微调时更要紧(大模型有更多的特征可以被”冲掉”)。所有微调都比只训练头好,和 §7.4 每类 30 张那一行一致。
两阶段微调就是 Coursera 作业 “Transfer Learning with MobileNet” 的做法:先冻结底座、只训练新的头;等头训练好了、不再乱给梯度了,再解冻底座顶部的若干层,用小学习率一起微调。在这里它(0.891)比只训练头好,和直接全部微调(1e−4)差不多。
冻结时的 BatchNorm 陷阱。 这是迁移学习里最容易踩、也最难发现的坑。在 PyTorch 里把参数设成 requires_grad = False,只是不再用梯度更新参数(权重、BN 的 、)。BN 的 running mean / var 不是参数,是”缓冲量”(buffer):只要这一层处在 train() 模式,每次前向都会用当前 batch 更新它们。代码 05 演示 2(每类 30 张,只训练头,100 步,3 个种子):
| 目标任务 | 正确:底座保持 eval() | 忘了:底座跟着 train() | 底座第一个 BN 的 running_mean 变了多少 |
|---|---|---|---|
| 相关:新形状 | 0.861 | 0.858 | 相对变化 458% |
| 不太相关:纹理 | 0.823 | 0.798 | 相对变化 303% |
参数一个都没动,BN 的统计量却被目标数据完全改写了。后果在这里不算大(两个任务都略差,纹理任务掉得多一些),所以这个 bug 很难被发现:模型照样能用,只是悄悄地差了一点。所谓”冻结”,在 PyTorch 里要同时做两件事:requires_grad = False,并且让这些层保持 eval()(transfer_kit.train_steps 的 frozen 参数就是干这个的);Keras 里对应的是调用底座时传 training=False,MobileNet 作业专门强调过这一点。
用目标数据重新估计 BN 统计量有时是有用的——这甚至是一种领域适应的方法(AdaBN,Li et al. 2016)。但那应该是你有意做的选择,并且在 dev 集上验证过,而不是忘了一行 eval() 的副作用。
7.6 哪一层的特征最通用?
为什么”数据中等时冻结前面、微调后面”?代码 04 演示 3 在预训练网络每一块的输出上(全局平均成一个向量)训练一个线性分类器(第 1 讲 §2.3 的线性探针,每类 100 张训练):
| 特征 | 相关:新形状 | 不太相关:纹理 |
|---|---|---|
| 预训练 block1(16 维) | 0.287 | 0.505 |
| 预训练 block2(32 维) | 0.711 | 0.805 |
| 预训练 block3(64 维) | 0.889 | 0.889 |
| 随机初始化 block3(64 维,对照) | 0.263 | 0.456 |
两个任务都是最后一块最好;但最后一块比 block2 多出的部分,纹理任务(+0.084)比相关任务(+0.179)小。Yosinski et al. (2014) 在 ImageNet 上系统地研究过这个问题:前面层的特征(边缘、颜色块)很通用,越往后越专门针对源任务。我们这个只有三块的小网络里,只看到了一个弱的迹象。对照组很重要:随机初始化的同一个网络,block3 只有 0.263 / 0.456——差距是预训练学来的,不是网络结构自带的。(block1 只有 16 维,维数小本身也对它不利。)
8. 数据增强 · Data augmentation
8.1 常见做法
第 6 讲 §6.1 说过:数据增强是对训练样本做不改变标签的随机变换,“免费”造出新样本;§6.4 用翻转 + 平移把一个过拟合的全连接网络的测试误差从 0.123 降到了 0.062。Ng 在 C4M2 里说,在计算机视觉里,几乎所有任务都”数据不够”,所以数据增强几乎总是有用的。常见的做法:
- 镜像(mirroring):左右翻转。
- 随机裁剪(random cropping):从图中随机裁一块(通常还会缩放回原尺寸)。裁出来的块要足够大,否则可能裁不到物体。
- 旋转、剪切(shearing)、局部扭曲(local warping):用得少一些,因为实现更复杂、选错幅度容易”扭坏”图像。
- 颜色变换(color shifting):给 R、G、B 三个通道各加一个随机的偏移(Ng 的例子:R + 20、G − 20、B + 20),模拟不同的光照和白平衡。网络因此不会把”偏黄的光照”当成线索。
- PCA 颜色增强(AlexNet 的做法,也叫 “fancy PCA”):先对训练集所有像素的 RGB 值做 PCA,得到 3 个主成分 和特征值 ;每张图加一个偏移 ,。偏移沿着”训练集里颜色本来就会变化的方向”走,变化最大的方向(通常是整体亮度)走得最远。Krizhevsky et al. 报告这一招把 top-1 错误率降了 1 个百分点以上。(论文公式写的是 ;我们按像素在 [0, 1] 的尺度用标准差 ,这也是很多开源实现的做法。)
8.2 实现:一边加载、一边增强
增强后的图每个 epoch 都不一样,所以通常不提前存到硬盘,而是在训练时实时生成。Ng 描述的做法是:用一个(或多个)CPU 线程从硬盘读图、做随机变换、拼成 mini-batch,同时另一个线程 / 进程(通常在 GPU 上)用这些 mini-batch 训练——两件事并行进行,GPU 不用等数据。在 PyTorch 里,这就是 DataLoader(..., num_workers=k): 个子进程负责加载和增强(第 9 讲 torch_utils.make_loader 用的是默认的 num_workers=0,对内存里的小数据最快、也最容易复现)。本讲的代码为了简单和可复现,在主进程里对整个 batch 做增强(transfer_kit 的 flip_lr、translate、color_jitter、pca_color,每个都只有几行)。
增强本身也有超参数(翻转的概率、平移多少像素、颜色扰动多强)。Ng 的建议是:先用开源实现里的默认值,再按需要调。
8.3 实验:各种增强各自的作用
代码 05 演示 3:相关目标任务,每类 30 张(一共 150 张),从零训练 150 步(约 32 个 epoch),3 个种子:
| 增强 | 训练准确率 | 测试准确率(平均) | 各种子 |
|---|---|---|---|
| 不增强 | 1.000 | 0.472 | 0.527 0.423 0.467 |
| 左右翻转 | 0.976 | 0.469 | 0.563 0.395 0.451 |
| 随机平移 ±3 像素 | 0.953 | 0.509 | 0.597 0.477 0.453 |
| 颜色扰动(每通道增益 / 偏移) | 0.996 | 0.575 | 0.551 0.584 0.589 |
| PCA 颜色(AlexNet,σ = 0.1) | 0.996 | 0.447 | 0.533 0.417 0.389 |
| 翻转 + 平移 + 颜色扰动 | 0.778 | 0.587 | 0.583 0.573 0.604 |
这张表和我写代码前的预想不一样。我原以为平移最有用(形状的位置是随机的)、颜色类的增强没什么用(形状的颜色本来就是随机的)。实际上:
- 颜色扰动单独就带来 +0.103,三个种子都变好。一个可能的解释(没有专门验证):每张图的形状色、背景色虽然是随机的,但 150 张图一共只有 150 种颜色搭配,网络可以靠”这种颜色搭配”记住训练图(训练准确率 1.000);颜色扰动让这条捷径失效,逼它去看形状。
- 随机平移 +0.037,只在 2 个种子上变好,不稳定。
- **左右翻转、PCA 颜色(σ = 0.1)**和不增强差不多(差别在种子波动以内)。5 种形状里有几种本来就左右对称(T、等号、Λ),翻转带来的”新”图不多;PCA 颜色在 σ = 0.1 时改动很小。
- 三种叠加最好(0.587),训练准确率降到 0.778:训练集”变难”了,这就是正则化的样子。
教训是:哪种增强有用,取决于训练集缺少哪种变化,而这往往不是你凭直觉能猜对的。和别的正则化手段一样(第 6 讲 §6.4),要在 dev 集上试。
8.4 一个会改变标签的增强
增强的前提是”这种变换不改变标签”。如果这个前提错了呢?代码 05 演示 4 用箭头任务:朝左、朝右、朝上、朝下 4 类,每类 30 张,从预训练权重全部微调 150 步,3 个种子:
| 增强 | 测试准确率 | 左 ↔ 右认反的比例 | 上 / 下两类的准确率 |
|---|---|---|---|
| 不增强 | 0.632 | 0.343 | 0.623 |
| 随机平移 | 0.701 | 0.288 | 0.708 |
| 左右翻转 | 0.578 | 0.493 | 0.663 |
左右翻转把一张”朝左”的图变成”朝右”的样子,标签却还是”朝左”:一半的训练图在告诉网络”左和右是一回事”。于是左 ↔ 右认反的比例从 0.343 变成 0.493——如果网络完全分不清左右,这个比例约为 0.5。上 / 下两类没有变差。同样的翻转在 §8.3 的形状任务里是无害的。
增强是你对任务的一个断言:“这种变换不改变标签”。 字母 b 和 d、数字 6 和 9(旋转 180°)、左转和右转的交通标志、医学影像里的左右(心脏在左边)……断言错了,增强就是在往训练集里加错误的标签。平移在箭头任务里是安全的(箭头挪到哪里都还朝那个方向),也确实有帮助(0.632 → 0.701)。
8.5 和迁移学习叠加
代码 05 演示 5(相关任务,每类 30 张,150 步,3 个种子):
| 做法 | 测试准确率(平均) | 各种子 |
|---|---|---|
| 从零训练,不增强 | 0.472 | 0.527 0.423 0.467 |
| 从零训练 + 翻转 + 平移 + 颜色扰动 | 0.587 | 0.583 0.573 0.604 |
| 全部微调,不增强 | 0.910 | 0.897 0.911 0.921 |
| 全部微调 + 翻转 + 平移 + 颜色扰动 | 0.916 | 0.927 0.916 0.907 |
从零训练时,增强带来 +0.115;迁移学习带来的多得多(+0.438)。两者叠加只比迁移学习多 +0.007——预训练的特征已经对颜色、位置相当鲁棒(源任务里这些都是随机的),增强能补的就不多了。实践里两者几乎总是一起用:预训练权重解决”特征从哪里来”,增强解决”这几十张图的变化不够多”;哪个贡献更大,取决于你的预训练数据覆盖了多少目标任务的变化。
9. 计算机视觉的现状 · The state of computer vision
Ng 在 C4M2 的最后一个视频里,把这一讲的内容放进了一张更大的图里。
两种知识来源。 一个学习算法的知识来自两个地方:有标签的数据,和手工设计(hand-engineering:设计特征、设计网络结构、设计系统的各个组件,以及数据增强这类”技巧”)。数据越少,越要依赖手工设计;数据越多,越可以用简单的算法、少一些手工设计,让网络自己学。
  数据少  ←───────────────────────────────────────────────────→  数据多
  目标检测                     图像识别                          语音识别
  (标注很贵:每个物体画框)    (ImageNet 级别,但很多类别仍嫌少)   (相对充足)
  更多手工设计、更复杂的架构、迁移学习            更简单的算法、更少的"技巧"
Ng 的判断是:计算机视觉整体上仍然处在”数据不够”的那一边——即使 ImageNet 有上百万张图,对”看懂图像”这个任务来说仍然不算多。这就是为什么计算机视觉里有那么多复杂的架构和技巧,也是为什么迁移学习在计算机视觉里几乎总是值得做。第 1 讲 §4.3 的”小数据区间”和本讲 §7.4 的表说的是同一件事。
在 benchmark 上刷分的技巧。 论文和比赛里常见两招:
- 集成(ensembling):独立训练几个(3–15 个)网络,把它们的输出平均。通常能提高 1–2 个百分点。
- 测试时多裁剪(multi-crop at test time):把一张测试图裁成几块(比如 “10-crop”:中心和四个角各一块,再加上左右翻转后的同样 5 块),分别分类,再把结果平均。
Ng 明确说:这些技巧适合刷 benchmark、赢比赛,很少用在生产系统里——集成要跑好几个网络,多裁剪要对每张图跑好几次,计算成本和延迟成倍增加,换来的提升却很小。(这和第 11 讲要讲的”部署时的延迟、成本”是同一个话题。)
给做项目的建议(Ng 的原话大意):
- 用文献里发表过的架构(§2–§6),不要从零发明;
- 尽量用开源实现(§7.1);
- 用预训练模型,在你的数据集上微调(§7.3–7.5)。
10. 小结 · Summary
- 经典网络的模式:高和宽变小、通道变多;conv → pool 交替、最后接全连接。参数在全连接层,计算在卷积层(AlexNet:全连接层占参数 94.0%、乘加 5.2%;VGG-16:89.4%、0.8%)。LeNet-5 约 6 万参数,AlexNet 约 6000 万,VGG-16 约 1.38 亿;VGG 只用 3×3 same 卷积和 2×2 池化,两个 3×3 的感受野等于一个 5×5、参数少 28%。
- 退化问题:深的 plain 网络训练误差更高(代码 02:8 → 20 → 32 层,0.442 → 0.750 → 0.809),不是过拟合;解是存在的(插入恒等块的 32 层网络训练损失和 8 层一样,1.0546),SGD 找不到。
- 残差块 :权重为 0 时就是恒等映射(演示 1: 时相对误差 0);梯度有一条”直通路”(演示 2:110 层时 plain + BN 的梯度比 2.57e+06,残差 + BN 是 39.8)。在我们 300 步的预算里,残差网络在 20 层明显好于 plain(0.616 vs 0.750),但没有做到”越深越好”。
- 维度不一致时捷径上用 (1×1 卷积投影):identity block vs convolutional block;bottleneck(1×1 压 → 3×3 → 1×1 恢复)和全局平均池化让 ResNet-50 只有 2556 万参数。没有 BN 时,残差网络要配合”分支末层初始化为 0”这类初始化。
- 1×1 卷积 = 每个像素上的全连接层:压缩 / 扩展通道、加非线性。Inception 同时用多种核,用 1×1 瓶颈把 5×5 分支的乘法从 120,422,400 降到 12,443,648。
- depthwise separable = depthwise + pointwise,计算量之比 (Ng 的例子 672 / 2160 = 0.311)。MobileNet v1 有 423 万参数、5.69 亿次乘加;v2 用”扩张 → depthwise → 线性投影 + 残差”的倒残差块。乘加少 ≠ 跑得快(乘加少 8–9 倍,CPU 上时间只少 2–4 倍);在我们的小任务上 separable 版本准确率也掉得比论文多。EfficientNet 按 同时放大深度、宽度、分辨率。
- DenseNet 用拼接代替相加,每层只新增 个通道。
- 迁移学习:数据很少 → 冻结底座、只训练头(可以预先算特征);中等 → 冻结前面、微调后面;很多 → 全部微调。代码 04:每类 10 张时只训练头 0.840 vs 从零 0.280(全部微调 0.730 反而更差);每类 300 张时全部微调 0.961 最好。“冻结”要同时
requires_grad = False和eval(),否则 BN 统计量会被悄悄改写。 - 数据增强:镜像、裁剪、旋转 / 剪切 / 扭曲、颜色变换、PCA 颜色;训练时用 CPU 线程实时生成。哪种有用取决于训练集缺什么(代码 05:颜色扰动 +0.103,翻转几乎没用);增强是对”标签不变”的断言,错了就是在加错误的标签(箭头任务:左 ↔ 右认反的比例 0.343 → 0.493)。
- 计算机视觉的现状:数据越少越依赖手工设计和迁移学习;集成、多裁剪是刷 benchmark 的技巧,不适合生产。
11. 常见误区 · Common pitfalls
- “网络越深越好。” 没有残差连接时,深的 plain 网络连训练误差都更高(代码 02 演示 3);有了残差连接,也要训练得足够久才能看到深度的好处(我们 300 步的预算里没看到)。
- “深网络训练误差更高,是过拟合。” 过拟合是训练误差低、测试误差高。退化问题是训练误差本身就高(plain-32 的训练误差 0.809、测试误差 0.812)。诊断时先看训练误差(第 6 讲的 bias / variance)。
- “有了 BN,深网就不会有梯度问题。” BN 让前向的信号稳定,但在没有捷径的深网络里,反向的梯度会随深度指数爆炸(代码 02 演示 2:110 层时 2.57e+06)。
- “残差连接 + 随便什么初始化都能训练。” 没有 BN 时,标准的 He 初始化让残差网络的信号随深度爆炸(110 层 2.08e+05),32 层第一步就 nan;要配合”分支末层初始化为 0”之类的做法(§3.6)。
- “参数多 = 计算多。” 两者常常相反:VGG-16 的全连接层占参数的 89.4%,却只占乘加的 0.8%。比较模型时要分别看参数(内存)和乘加(计算)。
- “乘加少 8 倍,就快 8 倍。” depthwise 卷积的计算密度低,CPU 上只快了 2–4 倍;在我们的小网络上,乘加最少的网络训练反而最慢(代码 03 演示 3、6)。要在目标硬件上实测。
- “1×1 卷积什么都没做。” 只有一个通道时是这样;多通道时它是每个像素上的全连接层,是压缩通道、扩展通道、加非线性的主要工具。
- “迁移学习就是把整个网络拿来全部微调。” 数据很少时全部微调反而更差(代码 04:每类 10 张时 0.730,只训练头 0.840)。冻结多少层要随数据量变。
- “设了
requires_grad = False就冻结了。” BN 的 running 统计量照样被更新(代码 05 演示 2:变了 458%);还要让冻结的层保持eval()。 - “数据增强总有好处,越多越好。” 会改变标签的增强有害(箭头任务的左右翻转);不会改变标签的增强也可能毫无作用(形状任务的翻转)。增强是一个关于任务的断言,要用 dev 集验证。
- “benchmark 上的技巧也该用在产品里。” 集成和多裁剪让计算成本成倍增加,提升却很小;生产系统里很少值得。
12. 练习 · Exercises
练习 1(数 AlexNet 的一层)。AlexNet 第二个卷积层:输入 27×27×96,256 个 5×5 的核,same 卷积,stride 1。(a) 输出形状是多少?(b) 参数多少个(含偏置)?(c) 乘加多少次?(d) 如果像原论文那样分成两组(每组 128 个核,只看 48 个输入通道),(b)、(c) 变成多少?
参考答案
(a) same 卷积、stride 1,高和宽不变:27×27×256。 (b) 每个核 5 × 5 × 96 = 2400 个权重 + 1 个偏置,256 个核:256 × 2401 = 614,656。 (c) 每个输出数要做 2400 次乘加,输出有 27 × 27 × 256 = 186,624 个数:186,624 × 2400 = 447,897,600。 (d) 每个核只看 48 个通道:参数 256 × (5 × 5 × 48 + 1) = 307,456,乘加 186,624 × 1200 = 223,948,800,都减半。 这几个数和代码 01 演示 2 的表一致(两 GPU 版的总参数 60,965,224 就是这样减出来的)。
练习 2(Inception 的瓶颈)。Ng 的例子里,如果瓶颈层不是压到 16 个通道,而是压到 32 个,5×5 分支的总乘法是多少?压到 64 呢?瓶颈压得越窄越好吗?
参考答案
一般式:。 :12,443,648(和讲义一致);:24,887,296;:49,774,592。仍然都比直接做的 120,422,400 少。 不是越窄越好:瓶颈太窄(比如 )会把 192 个通道里有用的信息挤掉,5×5 卷积能看到的东西太少。 是一个要在计算量和表现之间权衡的超参数;GoogLeNet 的 inception (3a) 用的是 16(5×5 分支)和 96(3×3 分支)。
练习 3(推导 depthwise separable 的比例)。(a) 推导 。(b) 一个 14×14×512 → 14×14×512 的 3×3 same 卷积,普通卷积和 separable 各要多少次乘加?比例是多少?(c) 为什么这个比例和 无关?
参考答案
(a) 设输出边长 。普通卷积: 个输出,每个 次乘法,共 。depthwise: 个输出,每个 次,共 ;pointwise: 个输出,每个 次,共 。相除:。 (b) 普通:(和代码 01 演示 3 里 VGG-16 第 24 层的乘加一致)。separable:。比例 0.113 = 1/512 + 1/9。 (c) 两种做法的乘法次数里都恰好有一个因子 (每个输出都要”读”所有输入通道一次——普通卷积在一步里读,separable 在 pointwise 那一步里读),相除时约掉了。
练习 4(残差块的梯度)。忽略最后的 ReLU,残差块是 ,一共 块。(a) 写出 。(b) 设每个 都是 (一个很小的数乘单位矩阵),算出 ;和 plain 网络 、 比较。(c) 设 ,,两者各是多少?
参考答案
(a) 链式法则:。
(b) 残差:;plain:。展开 ,里面总有一项是 1——梯度可以完全沿着捷径走;plain 网络只有 这一项。
(c) 残差:;plain:。前者会偏大(这就是代码 02 演示 2 里”残差,无 BN”的信号和梯度都偏大的原因,§3.6),后者完全消失。实际网络里 不是 ,但”一个和式 vs 一个乘积”这个结构上的差别是一样的。可以在 Python 里验证:1.1 ** 50、0.1 ** 50。
练习 5(VGG 的 3×3)。(a) 证明三个 3×3(stride 1)卷积叠起来,最后一层的每个输出看的是输入的 7×7 区域。(b) 个通道进出时,三层 3×3 和一层 7×7 的参数之比是多少?(c) 除了参数少,三层 3×3 还有什么好处?代价是什么?
参考答案
(a) 一层 3×3:每个输出看 3×3。每多一层,感受野每边多 1 个像素(多看一圈):3 → 5 → 7。 (b) ,少 45%(代码 01 演示 3 里 时 1,769,472 vs 3,211,264)。 (c) 好处:中间多了两个 ReLU,表达能力更强(VGG 论文的第二个理由)。代价:多了两层的激活值要存(显存),层数多了也更难优化——这正是 §3 要解决的问题。
练习 6(先预测再运行:把残差分支的 γ 初始化为 0)。在 02_plain_vs_residual.py 的 run 里,残差网络加上 zero_init=True(有 BN 时,它把每个残差块最后一个 BN 的 初始化为 0)。先预测:8、20、32 层的残差网络的训练误差会怎样变?“越深越好”会出现吗?然后运行验证(只改残差网络,3 个种子,约 40 秒)。
参考答案
我运行的结果(一次修改运行,不在脚本的默认输出里):训练误差 8 层 0.672(0.654 0.649 0.713)、20 层 0.666(0.686 0.592 0.719)、32 层 0.659(0.603 0.585 0.788);训练模式下最后 50 步的损失 1.686、1.329、1.269。
- 32 层从 0.775 降到 0.659,不再比浅的差;训练损失出现了”越深越低”的趋势(1.686 → 1.329 → 1.269)。刚开始每一块都是恒等映射,深网络等于从一个浅网络出发,再逐渐用上多出来的层。
- 但 8 层变差了(0.526 → 0.672):8 层网络只有 3 个块,开始时等于”stem + 分类头”,起步太慢。在这么短的训练里,初始化的选择对浅网络和深网络的影响方向相反。
- 种子之间的波动仍然很大(32 层:0.585–0.788)。这是 Goyal et al. (2017) 的做法,torchvision 里叫
zero_init_residual。
练习 7(迁移学习的选择)。对下面每种情况,你会选 §7.3 的哪种做法?为什么?(a) 一家诊所有 200 张标注好的皮肤病变照片(3 类),想用 ImageNet 预训练的 ResNet-50。(b) 一个工厂有 5 万张标注好的零件照片(缺陷 / 正常)。(c) 你有 2000 张卫星图像(土地类型 6 类),以及一个在 ImageNet 上预训练的 MobileNet v2。(d) 你有 1000 万张标注好的商品照片。
参考答案
(a) 数据很少:冻结整个底座,只训练新的 3 类头(可以预先算好 2048 维的特征);再试一试”解冻最后一个阶段、小学习率微调”,用 dev 集决定(代码 04 里每类 10 张时,微调最后一块比冻结全部还好一点)。加上合适的增强(皮肤照片可以翻转、旋转,颜色要谨慎——颜色可能就是诊断线索)。 (b) 数据中等偏多:冻结前面的阶段、微调后面的阶段,或者直接全部微调(小学习率);两种都试。 (c) 数据中等,而且卫星图像和 ImageNet 的照片差别不小(俯视、多光谱、没有”物体在中间”):冻结前面几个阶段(低层特征仍然通用,§7.6),微调后面的;卫星图像上下翻转、旋转 90° 都不改变标签,是很好的增强。 (d) 数据很多:用预训练权重初始化、全部微调;甚至可以从零训练(数据足够多时,两者的差距会缩小,§7.4 最后一行的趋势)。但即使在这里,预训练初始化通常也能让训练更快收敛。
练习 8(先预测再运行:EfficientNet 的三种花法)。代码 03 演示 5 只数了乘加。在 03_efficient_convs.py 里仿照演示 6 写一个实验:以 tiny_cnn(16, widths=(16, 24, 40), mode="inverted", depth_mult=3)、输入 24×24 为基准,比较”只加深(块数 × 2)""只加宽(通道 × √2)""只加分辨率(24 → 34)""复合缩放 “四种计算量都约翻倍的网络在形状世界上的测试准确率。先预测谁最好,再运行。(提示:改分辨率时,make_shapes(..., size=34) 直接生成更高分辨率的图;每个网络会比演示 6 的慢不少,先用 1 个种子、少量步数试。)
参考答案
这道题没有标准答案,具体数字以你运行的结果为准。可以预期的几点:
- 在这么小的任务、这么短的训练上,四者的差别可能小于种子之间的波动——EfficientNet 的结论来自 ImageNet 上训练到收敛的大模型;
- 只加分辨率时,多出来的像素主要是”同一个形状画得更细”,对认形状帮助有限,而且感受野相对变小了(网络层数没变);
- 复合缩放如果没有明显胜出,也不要奇怪:Tan & Le 的系数是在 ImageNet 上为他们的 B0 搜出来的,换一个任务、一个基准网络,最佳的 可能不同。 这道题想练的是:怎样设计一个”计算量相同”的公平对比,以及怎样诚实地读一个噪声很大的结果。
练习 9(哪些增强不改变标签)。对下面每个任务,判断”左右翻转""上下翻转""旋转 90°""颜色扰动”是否保持标签:(a) 手写数字识别;(b) 卫星图像的土地类型分类;(c) 胸部 X 光片判断肺炎;(d) 识别交通信号灯的颜色;(e) 判断照片是白天还是黑夜(第 5 讲)。
参考答案
(a) 都不安全:翻转会造出镜像的数字(有的变成别的字形),旋转 90° 会让 6 和 9、1 和 7 之类的混淆;颜色扰动安全(数字的身份和颜色无关)。小角度旋转(±10°)通常是安全的。 (b) 左右、上下翻转、旋转 90° 一般都安全(俯视图没有”上下”);颜色扰动要谨慎——植被、水体的颜色就是线索,小幅度的亮度 / 对比度变化可以。 (c) 左右翻转有风险:心脏在左侧,一些病变的位置有意义;上下翻转、旋转 90° 会造出不存在的图像;轻微的亮度 / 对比度变化通常可以。很多医学影像项目会请医生确认哪些增强可以用。 (d) 几何变换基本安全;颜色扰动不安全——颜色就是标签。 (e) 翻转安全(第 6 讲 §6.4 用过左右翻转);整体亮度的扰动不安全(亮度就是白天 / 黑夜的主要线索),色调的小扰动可能可以。 总的原则:先问”标签是由什么决定的”,增强只能改变和标签无关的东西。
练习 10(读账本)。根据 §2.4 和 §5.5 的表回答:(a) 如果一个手机应用对内存特别敏感,你更关心参数还是乘加?对电量 / 延迟呢?(b) ResNet-50 的参数只有 VGG-16 的约 1/5,但乘加是它的 1/4,为什么两个比例不一样?(c) MobileNet v1 的 从 1 降到 0.5,参数从 4,231,976 降到 1,331,592,为什么不是正好 1/4?
参考答案
(a) 内存(模型文件大小、加载权重需要的内存)主要看参数;电量和延迟主要看乘加(以及实际硬件上的效率,§5.5)。激活值的内存(尤其训练时)还取决于每层输出的大小。 (b) 参数和乘加分布在不同的地方:VGG-16 的参数九成在全连接层(乘加很少),ResNet-50 用全局平均池化去掉了这些参数,所以参数比例降得更多;而乘加主要在卷积层,ResNet-50 的卷积层靠 bottleneck 省下的乘加没有那么多。 (c) 参数里只有和”通道 × 通道”成正比的部分(pointwise 卷积、全连接层的输入那一侧)会变成 1/4;depthwise 卷积的参数只和通道数成正比(变成 1/2),最后的全连接层 1024α × 1000 也只和通道数成正比(变成 1/2),BN 的参数也是线性的。所以总体比 1/4 多一些(1,331,592 / 4,231,976 ≈ 0.31)。
13. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C4M2 “Deep Convolutional Models: Case Studies”(Andrew Ng)——本讲的主线;编程作业 “Residual Networks”、“Transfer Learning with MobileNet”。
- CS230 Section 3 “Implementation First Steps: Codebases, Baselines”(公开网页:https://cs230.stanford.edu/section/3)——怎样挑选和复现开源实现。
- Stanford CS231n 课程笔记 “Convolutional Neural Networks: Architectures”、“Transfer Learning”(cs231n.github.io)——另一种角度的同一批内容。
经典网络
- LeCun, Bottou, Bengio & Haffner (1998). Gradient-based learning applied to document recognition. Proc. IEEE. ——LeNet-5;Ng 建议重点读第 II、III 节。
- Krizhevsky, Sutskever & Hinton (2012). ImageNet classification with deep convolutional neural networks. NeurIPS. ——AlexNet;也是 PCA 颜色增强的出处。
- Simonyan & Zisserman (2014). Very deep convolutional networks for large-scale image recognition. ICLR 2015. ——VGG。
残差网络与它的后续
- He, Zhang, Ren & Sun (2016). Deep residual learning for image recognition. CVPR. ——ResNet、退化问题、bottleneck。
- He, Zhang, Ren & Sun (2016). Identity mappings in deep residual networks. ECCV. ——把 BN、ReLU 挪到卷积前面(pre-activation),让捷径成为”干净”的恒等映射。
- Huang, Liu, van der Maaten & Weinberger (2017). Densely connected convolutional networks. CVPR. ——DenseNet(Fall 2025 推荐阅读)。
- Srivastava, Hinton, Krizhevsky, Sutskever & Salakhutdinov (2014). Dropout: A simple way to prevent neural networks from overfitting. JMLR. ——Fall 2025 推荐阅读(机制见第 6 讲)。
- Balduzzi et al. (2017). The shattered gradients problem: If resnets are the answer, then what is the question? ICML.
- Li, Xu, Taylor, Studer & Goldstein (2018). Visualizing the loss landscape of neural nets. NeurIPS. ——跳跃连接让损失曲面更平滑的可视化。
- Yang, Pennington, Rao, Sohl-Dickstein & Schoenholz (2019). A mean field theory of batch normalization. ICLR. ——没有捷径时 BN 在初始化时造成梯度爆炸。
- Goyal et al. (2017). Accurate, large minibatch SGD: Training ImageNet in 1 hour. ——残差块最后一个 BN 的 γ 初始化为 0。
- Zhang, Dauphin & Ma (2019). Fixup initialization: Residual learning without normalization. ICLR.
1×1 卷积、Inception 与高效网络
- Lin, Chen & Yan (2013). Network in network. ICLR 2014. ——1×1 卷积与全局平均池化。
- Szegedy et al. (2015). Going deeper with convolutions. CVPR. ——GoogLeNet / Inception。
- Howard et al. (2017). MobileNets: Efficient convolutional neural networks for mobile vision applications. arXiv.
- Sandler, Howard, Zhu, Zhmoginov & Chen (2018). MobileNetV2: Inverted residuals and linear bottlenecks. CVPR.
- Tan & Le (2019). EfficientNet: Rethinking model scaling for convolutional neural networks. ICML.
迁移学习与数据增强
- Yosinski, Clune, Bengio & Lipson (2014). How transferable are features in deep neural networks? NeurIPS. ——哪一层的特征最通用。
- Li, Wang, Shi, Liu & Hou (2016). Revisiting batch normalization for practical domain adaptation. arXiv. ——AdaBN。
- Shorten & Khoshgoftaar (2019). A survey on image data augmentation for deep learning. Journal of Big Data.
14. 下一讲预告 · Next lecture
第 14 讲:视觉应用——目标检测、语义分割、人脸识别与神经风格迁移。 到这里,你已经有了一个”会看图”的骨干网络(ResNet、MobileNet……),也知道怎样借用预训练的权重。下一讲把它用到”不只是分类”的任务上:
- 目标检测:不光说”图里有车”,还要画出车在哪里——定位 = 分类 + 回归;YOLO 把图分成网格,每个格子预测框;IoU 与非极大值抑制;anchor boxes。
- 语义分割:给每个像素一个类别——转置卷积把特征图”放大”回原尺寸,U-Net 用跳跃连接把前面层的细节直接接到后面(和本讲的残差连接、DenseNet 的拼接是同一类想法)。
- 人脸识别:one-shot learning、Siamese 网络与 triplet loss(第 5 讲 §3 的案例会在这里用 CNN 实现)。
- 神经风格迁移:用预训练网络中间层的特征定义”内容”和”风格”(Gram 矩阵)——本讲 §7.6 看到的”不同层学到不同层次的特征”,在那里成了损失函数的一部分。