对应 Maps to:Coursera Deep Learning Specialization C4M1 “Foundations of Convolutional Neural Networks”(Computer Vision、Edge Detection Example、More Edge Detection、Padding、Strided Convolutions、Convolutions Over Volume、One Layer of a Convolutional Network、Simple Convolutional Network Example、Pooling Layers、CNN Example、Why Convolutions?);编程作业 “Convolutional Model: Step by Step”(用 numpy 实现
zero_pad、conv_single_step、conv_forward、pool_forward,选做conv_backward、pool_backward)和 “Convolutional Model: Application”(在 SIGNS 手势数据上训练一个 CNN)。在 Fall 2025 的安排里,C4M1、C4M2 和课堂 Lecture 6(10/28)放在同一周。 依据说明:Coursera 的视频和作业不对外公开。本讲依据 C4M1 里广为人知的内容来写:6×6 图像与 3×3 垂直边缘核的例子、Sobel / Scharr 核、输出尺寸公式、“valid” 与 “same” 卷积、多通道卷积、一层卷积的记号、LeNet-5 风格的 CNN 例子、“Why Convolutions” 里的参数个数对比。视频里的具体数字是凭记忆复述的:6×6 的例子和池化的两个例子,代码算出的结果和我记得的完全一致;stride 那个 7×7 的例子有两个数对不上,讲义只用代码算出的数字(§4.3)。据我记忆,视频里有两处参数计数漏乘了输入通道数(§8.1、§9.1),讲义按公式给出正确的数,并注明视频里的写法。平移等变 / 不变的部分另外依据 Goodfellow 等人的教材第 9 章和两篇关于”CNN 对小平移不稳定”的论文(§14)。原作业用 TensorFlow / Keras 做 Application 部分,本讲义用 PyTorch;形状约定的差别在 §6.4 说明。 配套代码 Code:code/lecture12/(numpy 从零实现卷积与池化的前向、反向,和 PyTorch 逐数字对照;PyTorch 训练小 CNN;5 个脚本 + 2 个模块;最慢的04_translation_experiment.py约 60 秒,其余几秒到 40 秒) 预计阅读时间:3–3.5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说出全连接网络处理图像的两个问题:参数太多(第一层就爆炸),以及”同一个图案换个位置就要重新学”;并能用第 2 讲的橙色十字数据说明后者。
- 手算一个二维卷积(深度学习里其实是互相关 cross-correlation),解释它为什么能做边缘检测、正负号代表什么、Sobel / Scharr 核和最简单的核各自好在哪里,以及为什么”把核翻不翻转”对学习没有影响。
- 熟练使用输出尺寸公式 ,说清 padding(valid / same)和 stride 的作用,知道 为什么几乎总是奇数。
- 说清多通道卷积的形状规则(滤波器的通道数 = 输入的通道数;滤波器的个数 = 输出的通道数),写出一个卷积层的前向公式和第 层的全部记号,算出一层的参数个数,并解释它为什么和输入图像的大小无关。
- 说清 max / average pooling 做什么、有哪些超参数、为什么没有参数;读懂 Ng 的 CONV-POOL-CONV-POOL-FC-FC-softmax 例子的形状表,知道”高宽变小、通道变多、参数集中在全连接层”这几条规律。
- 用参数共享和稀疏连接解释卷积为什么有效;区分平移等变(equivariance)和平移不变(invariance),知道池化只带来”近似的”不变,并能用实验说明 CNN 在位置变化的数据上、在数据少的时候为什么比 MLP 好得多。
- 用 numpy 写出卷积层、池化层的前向和反向传播(Coursera 作业的接口),并和 PyTorch 在 float64 下逐数字对上。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开 Previewed only |
|---|---|
| 第 1 讲 §3.4、代码 02:图片是 (高, 宽, 通道) 的数组;拉平丢掉了”谁是邻居” | 经典架构 LeNet-5、AlexNet、VGG、ResNet、Inception、MobileNet(第 13 讲) |
| 第 2 讲 §9.2–9.3:逻辑回归 = 一个固定位置的线性模板;位置抖动让它失效 | 1×1 卷积、depthwise separable 卷积、全局平均池化的细节(第 13 讲) |
| 第 4 讲 §4:L 层网络的前向、反向与 cache;§5.1 层次化特征 | 迁移学习、数据增强的系统做法(第 13 讲;第 6 讲 §6.1 已有直觉) |
| 第 6 讲:bias / variance;数据增强(平移、翻转) | 目标检测、语义分割、转置卷积、风格迁移(第 14 讲) |
第 9 讲 §3–5:softmax、PyTorch 训练循环模板 torch_utils、行约定 | 网络内部可视化(第 21 讲) |
本讲是 Part IV”卷积神经网络”的第一讲。它只讲到”一个简单的 CNN”为止:卷积和池化这两种新的层是什么、为什么这样设计、怎样从零实现,以及它们在实际数据上带来什么。更深、更现代的网络结构是第 13 讲的内容。和第 9 讲一样,每样新东西先用 numpy 写一遍、再和 PyTorch 对照;训练网络一律用 PyTorch。
0.3 本讲地图 Map
§1  为什么图像需要新的网络结构:参数爆炸;每个位置都要重新学             ← 代码 04 演示 1
§2  卷积运算:一个小核在图上滑动;互相关 vs 卷积                          ← 代码 01 演示 1、3
§3  边缘检测:垂直 / 水平、正负号、Sobel 与 Scharr、让网络自己学          ← 代码 01 演示 2;代码 02 演示 1–3
§4  padding 与 stride:valid / same、输出尺寸公式                        ← 代码 01 演示 4、5
§5  多通道卷积:RGB 图像、多个滤波器                                      ← 代码 02 演示 4
§6  一个卷积层:偏置、激活、参数个数、记号、和 PyTorch 对照                ← 代码 03 演示 1、4
§7  池化层:max / average、没有参数                                       ← 代码 03 演示 2
§8  一个完整的 CNN:Ng 的例子;合成手势上 CNN vs MLP;第一层学到了什么   ← 代码 05
§9  为什么卷积有效:参数共享、稀疏连接、等变与不变;平移实验              ← 代码 04
§10 (进阶)卷积层与池化层的反向传播                                     ← conv_numpy.py、代码 03 演示 3
§11–15  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 | 例子 / 形状 |
|---|---|---|
| 一个”体”(volume)的高、宽、通道数 | RGB 图像 | |
| 、、 | 第 层的滤波器边长、padding、stride | |
| 第 层滤波器的个数 = 输出的通道数 | ||
| 第 层全部滤波器 | ||
| 每个滤波器一个偏置 | ||
| 第 层的激活( 个样本) | (Coursera,通道在后) | |
| 卷积(深度学习的用法,实为互相关;Ng 的视频里写作 ) | §2.3 | |
| 向下取整 |
两套形状约定:Coursera 作业和本讲的 numpy 代码用”通道在后”(channels-last):;PyTorch 用”通道在前”(channels-first):,nn.Conv2d 的 weight 是 。讲义正文写形状时按 Ng 的习惯写成”高 × 宽 × 通道”。
0.5 关于数字 · About the numbers
讲义里的实验数字都来自配套代码的实际输出:固定种子,PyTorch 在 CPU 上单线程运行,同一台机器上重复运行输出逐字相同(代码 03 演示 1 末尾的计时除外)。数据全部是合成的:边缘检测用几何图形,平移实验复用第 2 讲的”橙色十字”(同样的种子、同样的大小),完整 CNN 用第 9 讲的合成手势。合成数据的参数(噪声、抖动幅度)是前几讲定下的,本讲没有改动;本讲新加的几个设定(比如 §9.5 里”左边 / 右边”的划分)是写代码时一次定下的,没有为了结果去调。有几处结果和我写代码前的预想不一样(最明显的是 §3.4 的”抗噪”、§8.4 的”第一层学到了什么”和 §9.3 的”全局池化也不是严格不变”),讲义按实际结果来写,这些情况列在代码 README 的”关于实验结果”里。
1. 为什么图像需要新的网络结构 · The problem with fully connected layers on images
1.1 计算机视觉在做什么
Ng 在 C4M1 的第一个视频里列了几类视觉任务:图像分类(这张图是不是猫)、目标检测(图里的车在哪里,画出框)、神经风格迁移(把一张照片画成梵高的风格)。它们的共同点是输入是图像,而图像有两个让全连接网络很难受的特点:很大,以及同一个东西可以出现在任何位置。
1.2 问题一:参数爆炸
第 1 讲练习 2 算过:64×64 的彩色图拉平后有 12,288 个数,layer_dims = [12288, 20, 7, 5, 1] 一共 245,973 个参数,99.9% 在第一层。这还只是 64×64 的小图、20 个隐藏单元。Ng 举的例子是一张 1000×1000 的照片:拉平后有 3,000,000 个输入,第一层只要 1000 个隐藏单元,权重矩阵 就是 ,30 亿个参数(代码 04 演示 1 也打印了这个数)。
参数多带来两个麻烦:一是内存和计算吃不消;二是数据不够——要把 30 亿个参数训练好而不过拟合,需要的数据量难以想象(第 6 讲)。
1.3 问题二:每个位置都要重新学
第二个问题更本质。回忆第 2 讲 §9.3 的实验:逻辑回归在”橙色十字 vs 其他”上学到一个固定位置的模板,十字的位置抖动越大,它越不灵:
| 抖动 | ±0 | ±1 | ±2 | ±3 | ±4 |
|---|---|---|---|---|---|
| 逻辑回归测试准确率(第 2 讲) | 0.986 | 0.958 | 0.806 | 0.792 | 0.764 |
第 2 讲在那里留了一句话:“要识别任何位置的十字,需要隐藏层或卷积(第 12 讲)。“隐藏层真的能解决吗?先预测一下,§9.4 会给出答案:一个有 49,346 个参数的 MLP,在抖动 ±4 时测试准确率只有 0.780,比逻辑回归好不了多少。
原因是全连接网络把每个像素当作一个独立的输入维度。“十字的横杠在第 5 行”和”十字的横杠在第 7 行”,对它来说是两个毫无关系的输入模式,它得分别学会。第 6 讲 §6.4 用”随机平移”的数据增强救了 32×32 的白天 / 黑夜网络,第 9 讲的合成手势在平移 ±2 像素下让 MLP 吃尽苦头,第 4 讲 §5.2 的条纹任务上深网也没占到便宜——那几处都指向同一个原因:全连接网络不知道”同一个检测器可以在每个位置复用”。
1.4 两个先验:局部性与平移
人看图时用了两条”常识”,全连接网络都没用上:
- 局部性(locality):要判断”这里有没有一条竖边”,只需要看这个位置附近的几个像素,不需要看整张图。
- 平移(translation):竖边在左上角是竖边,在右下角也是竖边;猫往右挪两个像素还是猫。所以”检测竖边”的那组权重,应该在每个位置都一样。
把这两条写进网络的结构,就得到卷积:一个小的权重模板(只看局部),在整张图上滑动(每个位置用同一组权重)。第 1 讲 §3.3 把这叫作归纳偏置(inductive bias)——归纳偏置对了,网络用更少的参数、更少的数据就能学会。本讲的后半部分(§8、§9)会用实验把这句话变成具体的数字。
2. 卷积运算 · The convolution operation
2.1 一个 3×3 的核在图上滑动
Ng 的第一个例子:一张 6×6 的灰度图(每个数是一个像素的亮度),和一个 3×3 的核(kernel,也叫滤波器 filter):
图像 (6×6)                    核 (3×3)            输出 (4×4)
   3   0   1   2   7   4        1   0  -1          -5   -4    0    8
   1   5   8   9   3   1        1   0  -1         -10   -2    2    3
   2   7   2   5   1   3        1   0  -1           0   -2   -4   -7
   0   1   3   1   7   8                           -3   -2   -3  -16
   4   2   1   6   2   8
2 4 5 2 3 9规则只有一句:把核盖在图像的一个 3×3 区域上,对应位置相乘,全部加起来,得到输出的一个数。左上角:
然后核向右滑一格,算下一个数();滑到最右边,再往下一行……6×6 的图上,3×3 的核能放 个位置,所以输出是 4×4。代码 01 演示 1 把这 16 个数都算了一遍(和我记得的 Ng 视频里的结果一致),PyTorch 的 F.conv2d 给出完全相同的数(差 0)。
2.2 公式
把输入记成 、核记成 (),输出位置 的值是:
和全连接层的 对比,区别只有两点:(1) 这里的 只是图像的一小块;(2) 同一个 在所有位置重复使用。这两点就是 §1.4 那两条常识。它们后来有专门的名字:稀疏连接和参数共享(§9.1)。
2.3 深度学习的”卷积”其实是互相关
如果你学过信号处理或数学里的卷积,会发现上面的公式少了一步:数学上的卷积要先把核旋转 180°(上下翻、左右翻),再滑动相乘相加:
深度学习框架省掉了这个翻转,实际算的是互相关(cross-correlation),但大家约定俗成地仍叫它”卷积”。代码 01 演示 3 验证了两件事:
- 在左亮右暗的图上,互相关给出 ,真正的卷积给出 ;真正的卷积 = “核旋转 180° 后的互相关”(差 0)。
- 为什么这不影响学习:用一个不对称的”真”核 做真正的卷积,造出目标输出;再用最小二乘去拟合一个互相关核 。学到的 和” 旋转 180°“的差只有 2.7e−15(舍入误差),和 本身差 5.00。
| 真核 | 旋转 180° | 学到的互相关核 |
|---|---|---|
[[2, −3, −2], [−2, −2, 2], [3, 1, −3]] | [[−3, 1, 3], [2, −2, −2], [−2, −3, 2]] | [[−3.00, 1.00, 3.00], [2.00, −2.00, −2.00], [−2.00, −3.00, 2.00]] |
核里的数是学出来的:网络只会学出一个”翻转过的核”,能表示的函数一模一样。翻转的好处是让卷积满足结合律 ,这在信号处理里很有用,在神经网络里用不上。所以读论文时看到 convolution,几乎总是指互相关。
3. 边缘检测 · Edge detection
3.1 垂直边缘
为什么 Ng 用 [[1, 0, −1]] × 3 这个核?看它在一张”左半边亮(10)、右半边暗(0)“的图上做了什么(代码 01 演示 2):
10 10 10  0  0  0                     0  30  30   0
10 10 10  0  0  0      ⋆   1 0 -1     0  30  30   0
10 10 10  0  0  0          1 0 -1  =  0  30  30   0
10 10 10  0  0  0          1 0 -1     0  30  30   0
   ……(共 6 行)
这个核算的是”左边一列之和 − 右边一列之和”。核落在全亮或全暗的区域里,左右相等,输出 0;只有跨在亮暗交界上时,输出才不为 0(30 − 0 = 30)。输出中间那条”亮带”就是检测到的竖边。它有 2 列宽,只是因为图太小;在 1000×1000 的照片上它就是一条细线。
3.2 正负号:亮到暗,还是暗到亮
把图左右翻过来(左暗右亮),输出变成 。正负号表示亮度变化的方向:正的是”从左到右由亮变暗”,负的是”由暗变亮”。如果只关心”有没有边”,可以取绝对值。
3.3 水平边缘,以及中间的过渡值
把核转置成 [[1, 1, 1], [0, 0, 0], [−1, −1, −1]],就是水平边缘检测器(上面一行之和 − 下面一行之和)。Ng 的第二个例子是一张”左上、右下亮”的图:
10 10 10  0  0  0                     0    0    0    0
10 10 10  0  0  0      ⋆   1  1  1    30   10  -10  -30
10 10 10  0  0  0          0  0  0  = 30   10  -10  -30
 0  0  0 10 10 10         -1 -1 -1     0    0    0    0
   ……
最左边的 30:上亮下暗;最右边的 :上暗下亮。中间的 10 和 是过渡值:核的 3 列一部分落在左边的块、一部分落在右边的块上,正负抵消了一部分。在大图上这种过渡区只占很窄的一条。同一张图用垂直核,找到的是中间那条竖直分界线(上半段 30、下半段 )。一个核只对一种方向的边敏感——想同时找横的、竖的、斜的边,就需要好几个核,这正是卷积层有很多滤波器的原因(§5.3)。
代码 02 演示 1 在一张有矩形和三角形的 16×16 图上把几种核都用了一遍:
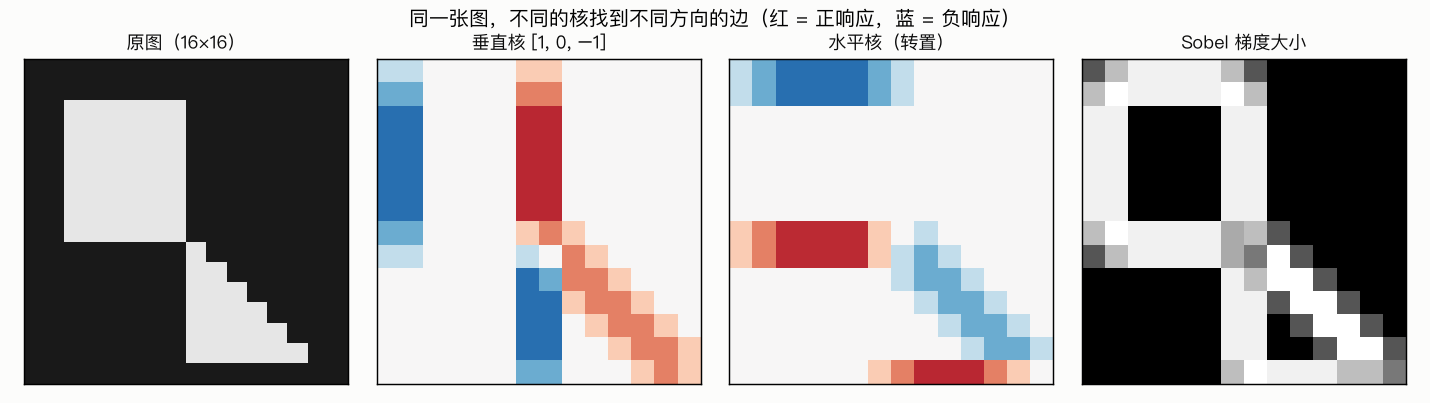
垂直核只看到矩形的左右两条边(左边负、右边正,响应 = 亮度差 0.8 × 3 个像素),水平核只看到上下两条边;三角形的 45° 斜边同时出现在两张图里,强度较弱——斜边既有左右的亮度变化,也有上下的。把两张图合起来 ,就得到不分方向的”边的强度”。这是深度学习之前计算机视觉的典型做法:人来设计一组核,算出边、角、纹理,再交给分类器。
3.4 Sobel 与 Scharr:好在哪里?
Ng 提到另外两个常用的垂直边缘核:
它们给中间一行更大的权重。Ng 的说法是这样”也许更稳健一些”。稳健在哪里?代码 02 演示 2 做了两个测试:
(a) 噪声:一条笔直的竖边 + 独立的像素噪声(200 张 20×20 的图),比较”边上的平均响应 / 平坦区域响应的标准差”:
| 核 | 实测信噪比 | 理论比例 | 实测 / 理论 |
|---|---|---|---|
[1, 0, −1](也叫 Prewitt 核) | 3.62 | 1.732 | 2.09 |
| Sobel | 3.42 | 1.633 | 2.09 |
| Scharr | 3.09 | 1.473 | 2.10 |
最简单的核信噪比最高。这在意料之外,但理由很简单:信号正比于一列权重之和 ,独立噪声的标准差正比于 ;权重相等时这个比值最大(最后一列几乎相同,说明实测和这个理论完全吻合)。所以”Sobel 更抗噪”并不准确。
(b) 方向:斜着的条纹(周期 5 像素,0°–90° 共 19 个方向),用 、 估计条纹的方向,看误差:
| 核 | 平均误差 | 最大误差 |
|---|---|---|
[1, 0, −1] | 2.63° | 4.39° |
| Sobel | 1.20° | 1.98° |
| Scharr | 0.18° | 0.31° |
中间加权让核在各个方向上的表现更一致(更”各向同性”);Scharr 的 3 : 10 : 3 正是为这个目标优化出来的。结论:没有”最好的核”,只有”对某个目标最好的核”。手工设计时得先想清楚目标;而神经网络的做法是——
3.5 让网络自己学这 9 个数
Ng 在 “Edge Detection” 视频的最后说:与其让计算机视觉研究者手工挑这 9 个数,不如把它们当成参数,用反向传播学出来;网络可能学到 45°、70° 的边缘检测器,或者人想不到的东西。代码 02 演示 3 试了两种情形:
(a) 有目标:20 张灰度图,目标 = Sobel 核的输出;一个随机初始化的 3×3 卷积层,均方误差 + Adam。
| 第 0 步 | 第 200 步 | 第 1000 步 | 第 3000 步 |
|---|---|---|---|
| 随机的 9 个数(loss 0.26) | 已能看出”左正右负、中间一行更大”(中心行 0.95 / −0.83) | 接近 Sobel(loss 2e−06) | 和 Sobel 的最大差 8.4e−15 |
卷积核就是普通的参数,梯度下降能把它调成任何需要的样子。当然这是”作弊”:我们直接告诉了它目标输出。
(b) 只给任务:12×12 的图里有一根 5 像素长的竖条或横条(位置随机、噪声 0.3);模型是”1 个 3×3 滤波器 → ReLU → 全局最大池化 → 逻辑回归”。三个种子的测试准确率 0.886、0.888、0.878,学到的核:
种子 0                  种子 1                  种子 2
-0.27 -0.36  1.29       1.12 -0.30 -0.12      -0.23 -0.28  1.18
-0.21 -0.24  1.21       1.02 -0.21 -0.11      -0.18 -0.21  1.13
-0.06 -0.47 1.34 1.15 -0.35 -0.06 -0.05 -0.40 1.23三个都是竖线检测器:一列 3 个大的正权重(1.02 到 1.34),其余是负的。它不是”边缘”检测器,而是”线条”检测器,因为这个任务里的图案本来就是 1 像素宽的线——网络学到的特征由数据和任务决定。亮的那一列在左边还是右边无所谓,后面是全局最大池化,只问”整张图里最大的响应有多大”。一个横线检测器同样能完成任务(“响应小”就说明是横条),这次三个种子碰巧都选了竖线。§8.4 会看一个真正训练好的 CNN 第一层学成了什么样。
4. Padding 与 Stride
4.1 不补 0 的两个问题
的图用 的核,输出是 。Ng 指出这有两个问题(代码 01 演示 4):
(1) 图像越卷越小。32×32 的图连续叠卷积层:
| 每层 | L = 1 | L = 2 | L = 5 | L = 7 | L = 10 | L = 15 |
|---|---|---|---|---|---|---|
| 3×3,不补 0 | 30 | 28 | 22 | 18 | 12 | 2 |
| 5×5,不补 0 | 28 | 24 | 12 | 4 | — | — |
| 3×3,补 1 圈 | 32 | 32 | 32 | 32 | 32 | 32 |
5×5 的核每层少 4 个像素,第 8 层就放不下了。第 13 讲的网络动辄几十上百层,不可能这样一路缩下去。
(2) 边缘的信息被”冷落”。6×6 的图、3×3 的核,每个像素被多少个窗口用到:
不补 0(输出 4×4)        补 1 圈 0(输出 6×6)
 1  2  3  3  2  1          4  6  6  6  6  4
 2  4  6  6  4  2          6  9  9  9  9  6
 3  6  9  9  6  3          6  9  9  9  9  6
 3  6  9  9  6  3          6  9  9  9  9  6
 2  4  6  6  4  2          6  9  9  9  9  6
 1  2  3  3  2  1          4  6  6  6  6  4
角上的像素只被用 1 次,中间的被用 9 次。在图像四周补一圈 0(zero padding)之后,角上的像素被用 4 次,原来的边缘不再那么吃亏(补的 0 本身不携带信息)。
4.2 Valid 与 Same
- valid 卷积:不补 0,,输出 。
- same 卷积:补 圈,让输出和输入一样大:。 时 , 时 。
是偶数时 不是整数,没法两边对称地补。代码 01 演示 4 里 PyTorch 的 padding='same' 遇到 时只好上 / 左补 1 圈、下 / 右补 2 圈(和手动这样补的结果差 0)。这是 Ng 说” 几乎总是奇数”的第一个原因;第二个原因是奇数的核有一个中心像素,可以说”这个滤波器在哪个位置”。最常见的是 3×3,其次是 1×1、5×5、7×7。
4.3 Stride
stride(步长)是核每次滑动的格数。步长为 时,输出大约缩小为 。Ng 讲 stride 用的是一张 7×7 的数字图、一个 3×3 的核、步长 2(代码 01 演示 5;视频里的具体数字我凭记忆写的,有两个输出和我记得的对不上,可能是我记错了图里的某个数——下面只列代码算出的、和 PyTorch 一致的结果):
图像 (7×7)                核          步长 2 的输出 (3×3)
2 3 7 4 6 2 9           3 4 4          91  100   88
6 6 9 8 7 4 3           1 0 2          69   91  117
3 4 8 3 8 9 7          -1 0 3          44   72   74
7 8 3 6 6 3 4
4 2 1 8 3 4 6
3 2 4 1 9 8 3
0 1 3 9 2 1 4
4.4 输出尺寸公式
把 padding 和 stride 合起来:
为什么是这个式子?补 0 之后边长是 ,核的左边缘可以放在 ,只要右边缘不出界(左边缘 ),这样的位置共有 个。向下取整的意思是:最后一步如果放不下一个完整的核,就不算这个位置。代码 01 演示 5 用三种方式核对了公式:
| 公式 | numpy | PyTorch | 说明 | |||||
|---|---|---|---|---|---|---|---|---|
| 6 | 3 | 0 | 1 | 4 | 4 | 4 | 4 | valid |
| 6 | 3 | 1 | 1 | 6 | 6 | 6 | 6 | same |
| 6 | 3 | 0 | 2 | 2.5 | 2 | 2 | 2 | 除不尽:向下取整 |
| 39 | 3 | 0 | 1 | 37 | 37 | 37 | 37 | Ng 的简单 CNN 例子:第 1 层 |
| 37 | 5 | 0 | 2 | 17 | 17 | 17 | 17 | 第 2 层 |
| 17 | 5 | 0 | 2 | 7 | 7 | 7 | 7 | 第 3 层 |
| 63 | 7 | 0 | 2 | 29 | 29 | 29 | 29 | |
| 16 | 3 | 1 | 2 | 8.5 | 8 | 8 | 8 | same + stride 2 ≈ 减半 |
那一行:窗口的左边缘在第 0、2 列,覆盖第 0–4 列,第 5 列在这一层完全没被用到。设计网络时最好让尺寸整除,或者用 padding 补齐。
Ng 的”简单 CNN 例子”(Simple Convolutional Network Example)就是表里那三行: → 10 个 3×3 的滤波器 → → 20 个 5×5、步长 2 → → 40 个 5×5、步长 2 → ,拉平成 1960 个数,再接逻辑回归或 softmax。注意高宽越来越小、通道越来越多——§8 会再看到这条规律。
5. 多通道卷积 · Convolutions over volume
5.1 RGB 图像要用 3 层的滤波器
彩色图是 的一个”体”。对它做卷积,滤波器也必须是 :滤波器的通道数必须等于输入的通道数。在每个位置,滤波器把 个像素值乘上 个权重,全部加起来得到一个数。所以不管输入有几个通道,一个滤波器产生的是一张二维的特征图:
5.2 每个通道的权重可以不同
为什么不先把三个通道加起来变成灰度图再卷积?代码 02 演示 4 构造了一个例子:6×6 的图,左半边红 (200, 50, 50)、右半边绿 (50, 200, 50),两种颜色的 R + G + B 一样,“亮度”差不多。两个 3×3×3 的滤波器:
- 滤波器 0:只在 R 那一层放垂直核,G、B 两层全是 0 →“红色通道的竖边”;
- 滤波器 1:三层都放垂直核 → 相当于先把三个通道加起来再找边。
| 红绿交界处的响应 | 拆开看 | |
|---|---|---|
| 滤波器 0(只看 R) | 1.76 | R 从 200 降到 50,是一条清楚的边 |
| 滤波器 1(R、G、B 一起) | 0.00 | R 通道 +1.76,G 通道 −1.76,正好抵消 |
在一张黑白照片里这条边是看不见的。滤波器对各个通道的权重不同,它就能学出”红色的竖边""橙色的斑块”这样的检测器。第 2 讲 §9.2 的逻辑回归模板里”R 正、B 负”的十字核心,就是一个只在一个位置工作的颜色检测器;卷积层让它在每个位置都能工作。
5.3 多个滤波器 → 多个输出通道
一个滤波器找一种特征, 个滤波器就得到 张特征图,叠成一个新的”体”:
演示 4 里两个滤波器给出 的输出,这一层有 个参数。通道(channel)这个词也因此有了更一般的意思:输入层的通道是颜色,后面各层的通道是”不同的特征”。有些书把它叫作深度(depth),Ng 提醒说容易和”网络的深度”混淆,所以他用”通道”。
6. 一个卷积层 · One layer of a convolutional network
6.1 和全连接层一一对应
一个卷积层就是: 个滤波器各做一次卷积,加上各自的偏置(一个实数,加到整张特征图上),再过一个激活函数(通常是 ReLU):
和第 4 讲的 一模一样,只是”矩阵乘法”换成了”卷积”。写成一个输出值:
这就是 Coursera 作业里 conv_single_step 做的事:一个小方块和一个滤波器逐元素相乘、求和、加偏置。conv_forward 只是在样本、行、列、滤波器四个方向上循环调用它。
6.2 参数个数与输入大小无关
Ng 的问题:“一层里有 10 个 3×3×3 的滤波器,这一层有多少参数?“每个滤波器 27 个权重 + 1 个偏置,共 。代码 03 演示 4 把同一个 nn.Conv2d(3, 10, 3) 用在不同大小的输入上:
| 输入 | 输出 | 卷积层参数 | 卷积的乘加次数 | 同样输入输出的全连接层参数 |
|---|---|---|---|---|
| 16×16×3 | 14×14×10 | 280 | 52,920 | 1,507,240 |
| 32×32×3 | 30×30×10 | 280 | 243,000 | 27,657,000 |
| 64×64×3 | 62×62×10 | 280 | 1,037,880 | 472,389,160 |
| 224×224×3 | 222×222×10 | 280 | 13,306,680 | 74,186,712,360 |
参数个数和输入图像多大无关:同一组滤波器在每个位置重复使用,图再大也只是”多滑几步”。这让卷积网络不容易过拟合,也让同一个网络可以处理不同大小的图(第 14 讲的检测、分割会用到这一点)。但要注意计算量随输入变大(224×224 时是 16×16 时的 251 倍):卷积省的是参数,不省计算。第 13 讲的 MobileNet 会专门想办法省计算。
6.3 记号
Ng 给第 层定的记号(代码 03 演示 4 以 、输入 32×32×3、10 个滤波器为例打印了每一项):
| 量 | 形状 | 例子 |
|---|---|---|
| 输入 (一个样本) | 32×32×3 | |
| 每个滤波器 | 3×3×3 | |
| 全部权重 | 3×3×3×10(270 个数) | |
| 偏置 | 1×1×1×10 | |
| 输出 (一个样本) | , | 32×32×10 |
| 个样本 |
两条最容易记混的规则:滤波器的通道数 = 上一层的通道数 ;滤波器的个数 = 这一层的通道数 。
6.4 从零实现,和 PyTorch 对照
conv_numpy.py 按 Coursera 作业的接口实现了 zero_pad、conv_single_step、conv_forward(四重循环)和向量化的 conv_forward_fast(把所有小方块取出来、一次 einsum 算完,就是第 5 讲代码 03 里 im2col 的想法)。代码 03 演示 1 在 6 组不同的 下比较三种写法,最大差不超过 2e−14(float64 的舍入误差):PyTorch 的 F.conv2d 做的正是这个四重循环,框架没有魔法。
两个实际的坑:
- 形状约定。numpy(Coursera)是 、
W是 ;PyTorch 是 、weight是 。转换要用transpose(换轴的顺序),不能用reshape。演示 1 故意让 :用reshape时形状完全对得上、程序不报错,但输出的最大差是 10.48——每个数都被放错了位置。这和第 1 讲 §3.5、第 9 讲 §4.3 是同一类”不报错只给错数字”的 bug。 - 速度。四重循环比 PyTorch 慢几百到上千倍(我的机器上一次是约 600 倍,计时每次不同),向量化写法只慢约 2 倍。循环版用来看懂,训练网络用 PyTorch。
7. 池化层 · Pooling layers
7.1 Max pooling
除了卷积层,CNN 里还常用池化层(pooling layer)来缩小特征图。最常见的是 max pooling:把图分成 的小块(步长 ),每块只留最大的数。Ng 的例子(代码 03 演示 2):
输入 4×4            f = 2, s = 2:max       average
1  3  2  1            9  2                3.75  1.25
2  9  1  1            6  3                3.75  2.00
1  3  2  3
5  6  1  2
直觉:把特征图里的一个数理解成”这里有没有某个特征”(比如一个竖边、一只猫眼)。max pooling 问的是”这个区域里有没有”——只要特征在小块的某处出现(响应大),池化之后它还在;它在小块里的哪一格,被丢掉了。Ng 也坦白说,大家用 max pooling 的主要原因是它在实践中效果好,“有没有”的解释只是一种直觉。
窗口可以重叠:Ng 的第二个例子是 5×5 的输入、、,输出 3×3 = [[9, 9, 5], [9, 9, 5], [8, 6, 9]]。输出尺寸用的是同一个公式 。
7.2 池化的几个性质
- 每个通道单独做:输入 ,输出 ,通道数不变。演示 2 里只改输入的第 0 个通道,输出只有第 0 个通道变了。
- 没有要学的参数:
nn.MaxPool2d(2)的参数个数是 0。只有超参数 、,以及 max 还是 average。最常见的是 (高宽减半),有时用 ;池化通常不补 0。反向传播时梯度只是”穿过”它(§10.2)。 - average pooling 取平均。中间层里现在很少用它,但网络的最后常用全局平均池化把每个通道的整张图压成一个数(第 13 讲)。
因为池化没有参数,Ng 数层数时把”一个 CONV 层 + 它后面的 POOL 层”算作一层(§8.1)。演示 2 的最后把 pool_forward 的循环版、向量化版和 F.max_pool2d / F.avg_pool2d 对照,差别都在 1e−16 以内。
8. 一个完整的 CNN · A simple CNN
8.1 Ng 的例子(LeNet-5 风格)
Ng 在 “CNN Example” 视频里画的网络(他说它的灵感来自 LeCun 的 LeNet-5,第 13 讲会讲原版):32×32×3 的输入(比如手写数字识别),CONV1(5×5,步长 1)→ POOL1(2×2 max)→ CONV2(5×5,16 个)→ POOL2 → 拉平 → FC3(120)→ FC4(84)→ softmax(10 类)。代码 05 演示 1 用 PyTorch 搭出来,逐层打印(CONV1 用 8 个滤波器,和视频里那张表一致):
| 层 | 输出形状 | 激活值个数 | 参数个数 |
|---|---|---|---|
| 输入 | 32×32×3 | 3,072 | 0 |
| CONV1:5×5,8 个,s = 1 | 28×28×8 | 6,272 | 608 |
| POOL1:max,f = 2,s = 2 | 14×14×8 | 1,568 | 0 |
| CONV2:5×5,16 个,s = 1 | 10×10×16 | 1,600 | 3,216 |
| POOL2:max,f = 2,s = 2 | 5×5×16 | 400 | 0 |
| FC3:400 → 120 | 120 | 120 | 48,120 |
| FC4:120 → 84 | 84 | 84 | 10,164 |
| softmax:84 → 10 | 10 | 10 | 850 |
| 合计 | 62,958 |
关于视频里那张表:据我记忆,视频里的参数一列写的是 208、416、48001、10081、841——CONV 层漏乘了输入通道数(),全连接层的偏置只算了 1 个。学员论坛上对此有不少讨论。按公式,CONV1 应该是 ,以上表为准。
这张表有三条规律,几乎所有经典 CNN 都符合:
- 高宽一路变小,通道数一路变多:32×32×3 → 28×28×8 → 14×14×8 → 10×10×16 → 5×5×16。空间细节逐渐被”压缩”,换成越来越多的特征通道;最后拉平成 400 个数交给全连接层。
- 激活值的个数大体在变少(3,072 → 6,272 → 1,568 → 1,600 → 400 → 120 → 84 → 10),但不必单调;一层之内降得太猛通常不是好设计。
- 参数几乎都在全连接层:卷积层合计 3,824 个,全连接层 59,134 个,占 94%;仅 FC3 就有 48,120 个。卷积层用很少的参数做了大部分”看图”的工作。这也是后来的网络(第 13 讲)想办法缩小、甚至去掉大的全连接层的原因。
常见的模式是 CONV → POOL → CONV → POOL → FC → FC → FC → softmax,或者几个 CONV 叠在一起再接一个 POOL。Ng 给的建议是:不要自己从零发明结构,先看别人在类似问题上用了什么(第 13 讲)。
8.2 在合成手势上:CNN vs MLP
Coursera 作业 “Convolutional Model: Application” 在 SIGNS 手势照片(64×64×3)上训练一个小 CNN。据我所知,新版作业的结构大致是 CONV2D(8 个 4×4,same)→ ReLU → MAXPOOL(8×8,步长 8)→ CONV2D(16 个 2×2,same)→ ReLU → MAXPOOL(4×4,步长 4)→ 拉平 → 6 类 softmax(细节可能和作业有出入)。我们没有原始照片,继续用第 9 讲的合成 16×16 手势(平移 ±2 像素、左右手、光照、噪声),按同样的思路搭一个更小的 CNN(代码 05 演示 2):
| 层 | 输出形状 | 参数 |
|---|---|---|
| 输入 | 16×16×1 | 0 |
| CONV 3×3,8 个,same | 16×16×8 | 80 |
| MAXPOOL 2×2 | 8×8×8 | 0 |
| CONV 3×3,16 个,same | 8×8×16 | 1,168 |
| MAXPOOL 2×2 | 4×4×16 | 0 |
| FC 256 → 6 | 6 | 1,542 |
| 合计 | 2,790 |
和第 9 讲作业的 MLP [256, 25, 12, 6] 比较:同样的优化器、同样的训练轮数(Adam、lr 0.001、batch 32、60 个 epoch,和第 9 讲代码 05 演示 2 相同,没有为 CNN 调过任何参数),各 3 个种子:
| 模型 | 参数 | 训练准确率 | dev(3 个种子) | test(3 个种子) | test 均值 |
|---|---|---|---|---|---|
| MLP [256, 25, 12, 6] | 6,815 | 1.000 | 0.872 0.874 0.858 | 0.840 0.870 0.857 | 0.856 |
| CNN | 2,790 | 0.994 | 0.926 0.968 0.940 | 0.909 0.946 0.914 | 0.923 |
| (第 9 讲 §5:随机搜索 24 组后的 MLP [256, 153, 76, 6]) | 51,487 | 0.871 0.870 0.861 | 0.867 |
- MLP 种子 0 的 dev 准确率 0.872,和第 9 讲代码 05 演示 2 打印的完全一样(同样的数据、初始化、训练循环),说明对照是公平的。
- 小 CNN 的参数只有 MLP 的 41%,不调参,test 0.923;第 9 讲花 24 次训练调出来的大 MLP 是 0.867。
- 两者都几乎记住了训练集(1.000、0.994),差别全在泛化。这是第 6 讲 §3.1 basic recipe 里”换一个更合适的架构”可以同时降低方差的例子。
一个细节:MLP 的输入照第 9 讲做逐像素标准化,CNN 的输入用整个通道共用的均值和标准差。卷积的想法是”同一个检测器在每个位置做同样的事”,如果每个像素先被减去不同的均值,同一个图案出现在不同位置时进入网络的数字就不一样了(cnn_tools.hand_sign_tensors 的注释)。
8.3 数据少的时候
代码 05 演示 3 只用训练集的前 张,每个 都训练约 2040 步( 时就是 60 个 epoch,和上表相同),在同一个 1000 张的 test 上评估:
| 训练张数 | MLP test | CNN test | 训练准确率(两者) |
|---|---|---|---|
| 60 | 0.340 | 0.491 | 1.000 / 1.000 |
| 150 | 0.485 | 0.700 | 1.000 / 1.000 |
| 400 | 0.662 | 0.848 | 1.000 / 1.000 |
| 1080 | 0.856 | 0.923 | 1.000 / 0.994 |
换个方向读这张表:CNN 用 150 张(0.700)比 MLP 用 400 张(0.662)还好;CNN 用 400 张(0.848)和 MLP 用全部 1080 张(0.856)只差 0.008。粗略地说,在这个任务上 CNN 只需要 MLP 约三分之一的数据。MLP 要分别学会”手指在第 3 列""手指在第 4 列”……而 CNN 的滤波器在一个位置学到的东西自动用在所有位置上,参数共享相当于把每张训练图”复制”到了许多位置。这和第 1 讲 §4.3”小数据区间里,先验知识更重要”是同一个道理——只不过这次先验写在网络结构里,而不是手工特征里。
8.4 第一层学到了什么?
课上常说”CNN 的第一层学出边缘检测器”,依据是 Zeiler & Fergus (2014) 等人对 ImageNet 上大网络的可视化。我们的小网络呢?代码 05 演示 4 取出上面训练好的 CNN(种子 0)第一层的 8 个 3×3 滤波器,和几种教科书的核(竖边、横边、两种斜边、竖线、横线、中心 − 周围、均匀)比较余弦相似度:
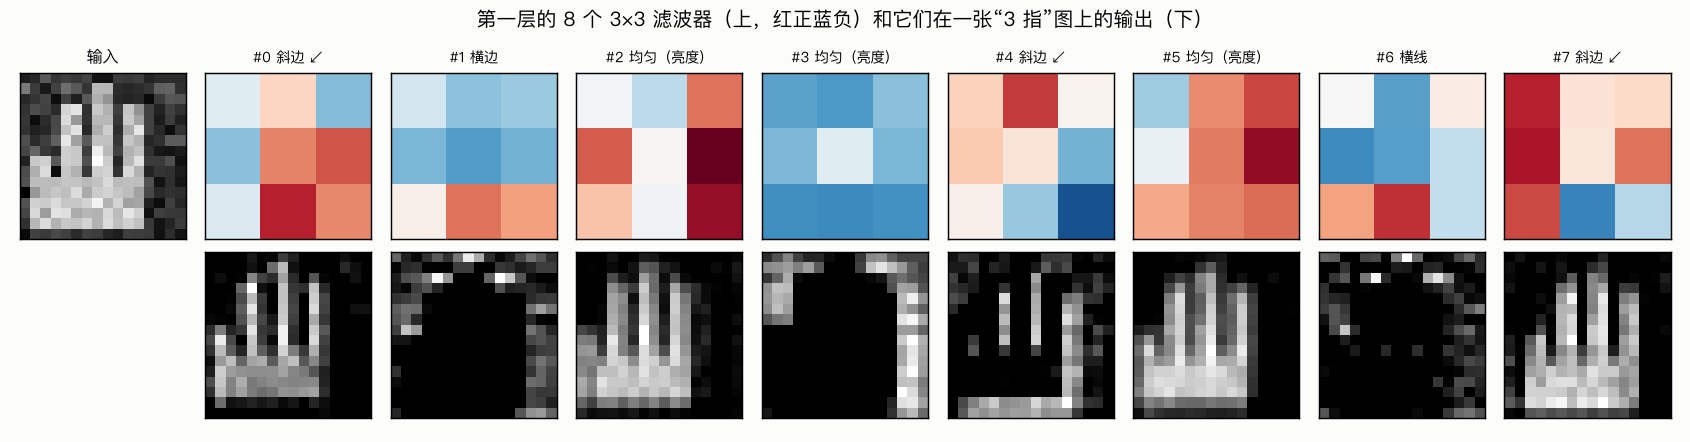
结果要说得谨慎:
- 明确像边缘检测器的只有 1 个(#4,像斜边,);
- 3 个是”亮度型”(#2、#3、#5):权重几乎同号,相当于把小块求个加权平均。其中 #3 的权重几乎全为负、偏置为正,它在暗的地方输出大——是一个”背景检测器”(图里第二行的 #3 只在背景上亮);
- 其余 4 个是几种模式的混合,比如一侧正一侧负,但不像任何教科书的核。
为什么不是教科书式的干净边缘检测器?16×16 的合成手势很简单(亮的手指 + 暗的背景 + 噪声),8 个滤波器、60 个 epoch,网络只需要”够用”的特征;而且后面还有第二层卷积,可以把这些”亮度型”和”混合型”特征组合成它需要的任何东西。第 1 讲 §2.3 也看到过:网络学到的表示往往是分布式的,不一定一个单元对应一个人能命名的概念。真正漂亮的边缘检测器通常出现在用大量自然图像训练的大网络里(第 21 讲讲可视化)。
9. 为什么卷积有效 · Why convolutions?
9.1 参数共享与稀疏连接
Ng 在 “Why Convolutions?” 里的例子:32×32×3 的输入,6 个 5×5 的滤波器,输出 28×28×6。代码 04 演示 1:
| 情形 | 输入 | 输出 | 全连接参数 | 卷积参数 | 倍数 |
|---|---|---|---|---|---|
| Ng 的例子(5×5,6 个) | 32×32×3 | 28×28×6 | 14,455,392 | 456 | 31,700 |
| 本讲小 CNN 的第一层(3×3 same,8 个) | 16×16×3 | 16×16×8 | 1,574,912 | 224 | 7,031 |
| 64×64 彩色图(3×3 same,16 个) | 64×64×3 | 64×64×16 | 805,371,904 | 448 | 1,797,705 |
全连接需要约 1400 万个参数( 个权重加 4704 个偏置),卷积只要 个。(据我记忆,视频里这里算的是 ,同样漏乘了输入的 3 个通道。)Ng 给了两个理由:
- 参数共享(parameter sharing):一个在图像某处有用的特征检测器(比如竖边检测器),在别处很可能也有用。同一个 5×5×3 的滤波器在全部 28×28 个位置上重复使用,而不是每个位置各学一套。
- 稀疏连接(sparse connections):每个输出值只依赖输入里的一个小方块(75 个数),其余 2,997 个输入对它没有影响。
参数少,需要的数据就少、也不容易过拟合(§8.3 已经看到了)。但更重要的是 Ng 提到的第三点:卷积的结构让网络更容易捕捉平移不变性——一只猫往右挪几个像素还是猫。这句话需要说得更准确一些。
9.2 等变:卷积层跟着平移
平移等变(translation equivariance)的意思是:输入平移多少,输出就跟着平移多少。
这是参数共享的直接结果:每个位置用同一个滤波器,图案搬到哪里,同样的响应就出现在哪里。代码 04 演示 2 用一个随机权重(没训练过)的两层 CNN(CONV → ReLU → POOL → CONV → ReLU → POOL → 全局 max),把黑底上的一个 7×7 十字平移若干像素,量每一级表示的相对变化 :
| 平移(下, 右) | 像素 | CONV1 | POOL1 | POOL2 | 全局 max | CONV1 等变误差 |
|---|---|---|---|---|---|---|
| (0, 1) | 0.651 | 0.546 | 0.472 | 0.392 | 0.168 | 0 |
| (0, 2) | 0.921 | 0.815 | 0.730 | 0.554 | 0.000 | 0 |
| (0, 3) | 1.128 | 1.037 | 0.944 | 0.770 | 0.168 | 0 |
| (1, 1) | 0.816 | 0.730 | 0.665 | 0.508 | 0.167 | 0 |
| (2, 2) | 0.985 | 0.971 | 0.913 | 0.721 | 0.000 | 0 |
| (0, 4) | 1.206 | 1.159 | 1.098 | 0.872 | 0.020 | 0 |
最后一列:卷积层的输出和”把原输出平移同样距离”完全相等(误差 0)。所以 CNN 的第一层不需要为每个位置单独学”这里有一段十字的竖杠”。
但等变不是不变。平移 1 个像素,CONV1 的输出整体搬了家,和原来比变化了 0.546(像素本身变化了 0.651)。如果后面直接接一个全连接层,它看到的仍然是”另一个位置的图”——和 MLP 面对的问题一样。
9.3 池化:近似的、局部的不变
同样平移 1 个像素,POOL1 之后的变化是 0.472,POOL2 之后是 0.392,一级比一级小:2×2 的 max pooling 只问”这个小块里有没有”,图案在小块里挪一格,结果可能不变。这是近似的、局部的平移不变(invariance)。
表里还有一个我原先没想到的结果:即使最后取全局最大值(整张图只问”有没有”),对 1 个、3 个像素的平移也会变化约 0.17;只有平移 2 的倍数时才是 0。原因在中间那个步长 2 的池化:奇数平移和它的 2×2 格子对不齐,POOL1 就不再是”原来的图挪了一下”(偶数平移时 POOL1 是精确等变的),后面的层看到的就是不同的数。平移 4 像素时的 0.020 来自边界:十字的响应碰到了 8×8 特征图的边缘,补 0 的效果不同。这个”小平移也会改变 CNN 的输出”的现象在大网络上同样存在,Azulay & Weiss (2019) 和 Zhang (2019) 专门研究过它:下采样(步长 > 1 的池化或卷积)破坏了严格的等变。
所以准确的说法是:卷积层是等变的;池化(下采样)带来近似的不变,同时也破坏了严格的等变。 CNN 对位置变化的容忍,来自”等变的特征 + 逐级丢掉位置信息”。这种”近似”在实践中有多有用?下面看训练好的网络。
9.4 核心实验:橙色十字的位置抖动
回到 §1.3 的问题。代码 04 演示 3 用和第 2 讲 §9.3 同一份数据(训练 1000 张、测试 500 张,像素 / 255),训练四个模型,每个都用 Adam lr 0.001、batch 32、40 个 epoch,各 3 个种子:
| 模型 | 参数 | 结构 |
|---|---|---|
| 逻辑回归 | 1,538 | 拉平 768 → 2(两个输出的 softmax 就是逻辑回归,第 9 讲 §3.4) |
| MLP | 49,346 | 拉平 768 → 64 → 2 |
| CNN(FC 头) | 1,906 | CONV 3×3×8 → POOL → CONV 3×3×16 → POOL → 拉平 256 → 2 |
| CNN(全局池化头) | 1,426 | 同上的卷积部分 → 全局 max(16 个数)→ 2 |
测试准确率(3 个种子的平均):
| 抖动 | 逻辑回归 | MLP | CNN(FC 头) | CNN(全局池化头) |
|---|---|---|---|---|
| ±0 | 0.983 | 0.988 | 0.989 | 0.979 |
| ±1 | 0.949 | 0.957 | 0.980 | 0.983 |
| ±2 | 0.785 | 0.853 | 0.965 | 0.985 |
| ±3 | 0.805 | 0.809 | 0.938 | 0.987 |
| ±4 | 0.768 | 0.780 | 0.927 | 0.983 |
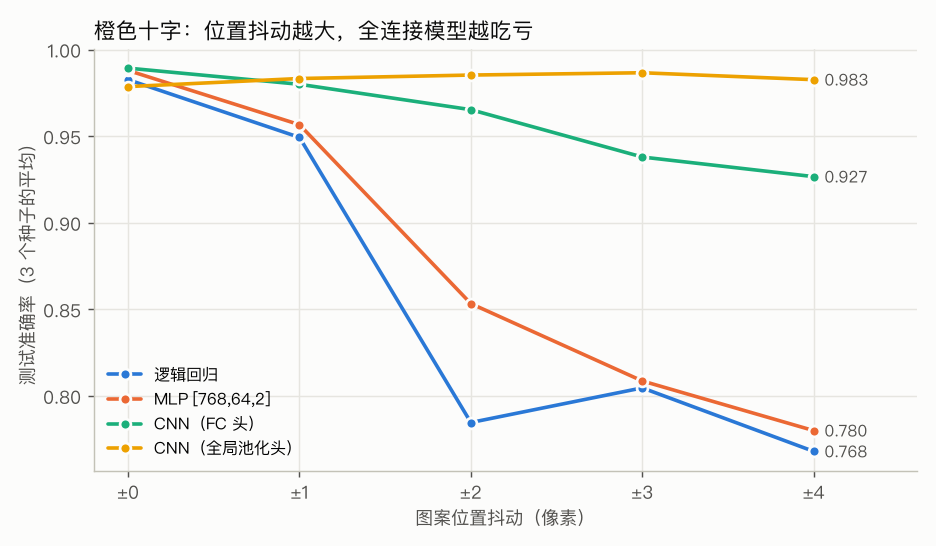
逐行读:
- ±0 时四个模型不分上下(0.979–0.989):位置固定的问题,固定位置的模板就能做好。卷积的优势恰恰体现在”位置会变”上。
- 逻辑回归从 0.983 掉到 0.768,和第 2 讲用梯度下降得到的 0.986 → 0.764 几乎一样(±2 比 ±3 还低一点,是数据的随机波动)。
- MLP 的参数是逻辑回归的 30 多倍,±4 时只好一点点(0.780)。它连训练集都只拟合到 0.877:同一个十字可能出现在 81 个位置,每个位置都要用一套不同的权重去认,1000 张图远远不够。所以第 2 讲那句”需要隐藏层或卷积”要修正一下:在这么少的数据上,光有隐藏层是不够的。
- CNN 的参数不到 MLP 的 1/25,±4 时高出 0.15(FC 头)到 0.20(全局池化头)。全局池化头几乎是一条平线。
最能说明问题的是测试集里的「橙色方块」:它和十字颜色一样,只能靠形状区分。±4 时被判对的比例:
| 抖动 | 逻辑回归 | MLP | CNN(FC 头) | CNN(全局池化头) |
|---|---|---|---|---|
| ±0 | 0.964 | 0.967 | 0.971 | 0.957 |
| ±2 | 0.100 | 0.442 | 0.942 | 0.987 |
| ±4 | 0.096 | 0.142 | 0.883 | 0.996 |
逻辑回归和 MLP 基本把”有一块橙色”当成了十字;CNN 的滤波器在每个位置都能认出”橙色的横杠 + 竖杠”的组合。FC 头的 CNN 随抖动慢慢下降(0.989 → 0.927),全局池化头不降:FC 头的最后一层仍然是”每个格子一套权重”,还保留着对位置的依赖。下一个实验把这个差别放大到极端。
9.5 极端测试:只在左边训练,在右边测试
代码 04 演示 4:训练时图案只出现在图的左边(左上角的列 ∈ {0, 1, 2},图案占第 0–8 列);测试 A 同样在左边,测试 B 只在右边(列 ∈ {7, 8, 9},占第 7–15 列)——训练时从没在那里出现过。
| 模型 | 训练 | 测试 A(左) | 测试 B(右) |
|---|---|---|---|
| 逻辑回归 | 0.897 | 0.868 | 0.482 |
| MLP | 0.966 | 0.906 | 0.491 |
| CNN(FC 头) | 0.980 | 0.961 | 0.485 |
| CNN(全局池化头) | 0.990 | 0.974 | 0.966 |
(测试 B 里”全猜不是十字”的准确率是 0.486。)
- 逻辑回归和 MLP 到了右边掉到瞎猜的水平:它们右半边的权重只在”背景”上训练过,右边的十字对它们是完全陌生的输入。
- CNN(FC 头)也掉到了 0.485。这可能出乎意料:它的卷积层是等变的,右边的十字照样会在特征图的右边产生响应;但它的最后一层是全连接层,“特征图右边的格子”对应的权重同样只在背景上训练过——等变的特征 + 不等变的读出头。
- CNN(全局池化头)在右边是 0.966,和左边(0.974)几乎一样:全局最大池化只问”整张图里有没有十字的特征”,从左边学到的东西原封不动地用到了右边。
教训:卷积层本身给的是等变,不是不变。Ng 的标准结构 CONV-POOL-…-FC 只有局部的不变性;它在 §9.4 里表现好,一半功劳来自训练数据里位置本来就是多样的(如果训练时图案出现在所有位置,FC 头的 CNN 在右边也能做好,见练习 7)。第 13 讲的很多现代网络在最后用全局平均池化代替大的全连接层,这是原因之一;而第 6 讲的平移增强,可以看作是用数据来补足结构没有给的那部分不变性。
9.6 归纳偏置的代价
卷积的先验不是免费的:
- 如果任务需要知道位置(“十字在左上角吗?”),全局池化就把有用的信息丢掉了;CONV-POOL-FC 的 FC 头保留了粗略的位置,是一种折中。
- 卷积只内置了平移。旋转、缩放、视角变化,它不会自动处理,要靠数据(增强)或者更深的网络去学。
- 在数据极多时,先验的价值变小。第 1 讲 §3.3 提到,超大规模数据上更”通用”的 Transformer(第 17 讲)也能做视觉;但在数据有限的大多数项目里,卷积的先验仍然非常值钱(§8.3)。
10. (进阶)卷积层与池化层的反向传播 · Backpropagation in CNNs (optional)
Coursera 作业把这部分列为选做;用框架时 autograd 会替你算。但写一遍能让你看清”参数共享”在梯度里是什么样子。
10.1 卷积层
前向时 。这个式子对三样东西的偏导都很简单,链式法则就是把每个输出位置的 乘上偏导,累加到对应的地方:
对所有样本、所有位置 、所有滤波器 求和。三行各有含义:
- 第一行:一个输入像素属于好几个小方块(窗口重叠),它的梯度是这些小方块传回来的梯度之和。
- 第二行就是参数共享在反向传播里的样子:一个滤波器的梯度 = 它在所有位置、所有样本上的梯度之和。一个 3×3 的核虽然只有 9 个数,却从整张图的每个位置收集梯度——这也是它需要的数据少的另一种说法。
- 第三行:偏置加在整张特征图上,梯度是整张 之和。
最后要把补的 0 “剪掉”:dA_prev = dA_prev_pad[pad : pad + n_H_prev, ...]。(常见的写法 [pad:-pad] 在 pad = 0 时会得到空数组,conv_numpy.conv_backward 的注释里有说明。)
10.2 池化层
池化没有参数,只需要 :
- max pooling:输出只取决于窗口里最大的那个数,其他数稍微变一点,输出不变。所以梯度只回到最大值的位置(作业里的
create_mask_from_window:x == np.max(x))。 - average pooling:平均值对每个输入的偏导都是 ,梯度平均分回去(作业里的
distribute_value)。
代码 03 演示 3 用 §7.1 的 4×4 例子、上游梯度 [[1, 2], [3, 4]]:max pooling 的 只在 9、2、6、3 这四个最大值的位置上是 1、2、3、4,其余全是 0;average pooling 则每格分到 0.25、0.50、0.75、1.00。
10.3 验证
演示 3 把 conv_backward、pool_backward 和 PyTorch autograd 对照(float64,3 组卷积配置、4 组池化配置):卷积层 、、 的最大差都在 1e−15 量级(最大 5.3e−15),池化层差 0。conv_numpy.py 直接运行时还会做一次第 7 讲的双边差分梯度检验,相对误差 1e−10 量级(dA_prev 4.5e−10、dW 2.8e−10、db 5.4e−10)。
一个值得记住的结论(练习 5 会推导):卷积层对输入的梯度,等于把 补 0 之后和旋转 180° 的核做一次卷积。“反向传播穿过一个卷积,还是一个卷积”——第 14 讲的转置卷积(transposed convolution)就是把这个运算当作一种上采样层来用。
11. 小结 · Summary
- 全连接网络处理图像的两个问题:参数爆炸(1000×1000×3 的图、1000 个隐藏单元 → 30 亿个参数);每个位置都要重新学(第 2 讲的逻辑回归在抖动 ±4 时 0.764,本讲的 MLP 也只有 0.780)。
- 卷积 = 一个小核在图上滑动,每个位置”对应相乘、全部相加”。深度学习里实为互相关(不翻转核);因为核是学出来的,翻不翻转不影响能表示的函数(拟合真正卷积造的目标,学到的就是翻转后的核,差 2.7e−15)。
- 边缘检测:
[1, 0, −1]算左右之差,正负号表示亮到暗还是暗到亮;转置就是水平核。Sobel / Scharr 的好处是方向更准(平均误差 2.63° → 1.20° → 0.18°),不是更抗噪(等权重的核信噪比最高)。把 9 个数当参数,网络会学出任务需要的检测器(竖条任务里学成了线条检测器)。 - padding 与 stride:不补 0 时图越卷越小、边缘像素只用 1 次;same 卷积 , 通常是奇数。输出尺寸 ,除不尽向下取整。
- 多通道:滤波器的通道数 = 输入的通道数,每个滤波器输出一张二维特征图;滤波器的个数 = 输出的通道数。滤波器对各通道的权重可以不同(等亮度的红绿边界:只看 R 的滤波器 1.76,三通道相加的 0.00)。
- 一个卷积层:,;参数 ,和输入大小无关(10 个 3×3×3 → 280),但计算量随输入变大。numpy 与 PyTorch 逐数字一致;换形状约定要 transpose,不能 reshape。
- 池化:max / average,每个通道单独做,没有参数,常用 。
- 一个完整的 CNN:高宽变小、通道变多、参数集中在全连接层(LeNet 风格例子里全连接层占 94%)。合成手势上,2,790 个参数的 CNN 不调参 test 0.923,MLP 0.856,调过参的大 MLP 0.867;数据少时差距更大,CNN 约只需 MLP 三分之一的数据。小网络第一层只有 1 个明确的边缘检测器,3 个亮度型、4 个混合型。
- 为什么卷积有效:参数共享 + 稀疏连接(Ng 的例子 14,455,392 vs 456);卷积层等变(误差 0),池化带来近似不变(步长 2 的下采样让奇数平移的全局 max 也变化约 0.17)。抖动 ±4 时 CNN 0.927 / 0.983 vs MLP 0.780;只在左边训练时,FC 头的 CNN 在右边也只有 0.485,全局池化头 0.966——等变的特征需要不变的读出头,或者位置多样的数据。
12. 常见误区 · Common pitfalls
- “CNN 里的卷积就是数学上的卷积。” 实际是互相关,不翻转核(§2.3)。读别人的代码或用 scipy 的
convolve2d对照时要小心这个翻转。 - “卷积网络是平移不变的。” 卷积层是等变的;不变性来自池化,而且只是近似的(§9.3)。CONV-POOL-FC 结构在没见过的位置上可能完全失效(§9.5 的 0.485)。
- “滤波器的通道数是一个可以随便选的超参数。” 不是:它必须等于输入的通道数。能选的是滤波器的个数(= 输出的通道数)和边长 (§5、§6.3)。
- “图越大,卷积层的参数越多。” 参数只取决于 、、,和图的大小无关;变多的是计算量(§6.2)。
- “池化层也有要学的权重。” 没有,只有超参数 、;反向传播时梯度只是按规则”穿过”它(§7.2、§10.2)。
- “用 reshape 就能在 (m, H, W, C) 和 (m, C, H, W) 之间转换。” 要用 transpose。形状碰巧对得上时 reshape 不报错,但每个数都放错了位置(§6.4,最大差 10.48)。
- “Sobel 比简单的差分核更抗噪。” 对独立噪声下的直边,等权重的核信噪比最高;Sobel / Scharr 好在方向估计更准(§3.4)。
- “CNN 第一层一定学出漂亮的边缘检测器。” 大网络、大量自然图像时常常如此;小网络、简单数据时可能只学出”够用”的混合特征(§8.4)。
- “输出尺寸除不尽时会四舍五入,或者补一个半窗口。” 向下取整,最后放不下的那一步直接丢掉,边上的像素可能完全没被用到(§4.4)。
13. 练习 · Exercises
练习 1(输出尺寸与参数)。(a) 64×64×3 的输入,10 个 5×5 的滤波器,,,输出多大?这一层多少参数?(b) 同上但 ?(c) 63×63×16 的输入,32 个 7×7 的滤波器,,,输出多大?(d) 对 (c) 的输出做 2×2、步长 2 的 max pooling,输出多大?
参考答案
(a) ,输出 60×60×10;参数 。
(b) ,输出 64×64×10(same 卷积),参数仍是 760。
(c) ,输出 29×29×32。
(d) ,输出 14×14×32(通道数不变)。29 是奇数,最后一行、一列没有被池化窗口用到。
可以用 conv_numpy.conv_output_size(n, f, p, s) 验证。
练习 2(手算一次卷积和池化)。图像 [[1, 2, 0, 1], [0, 1, 3, 1], [2, 1, 0, 0], [1, 0, 2, 1]],核 [[1, 0], [0, −1]](2×2,,不补 0)。(a) 算出输出。(b) 对输出过 ReLU。(c) 对 (a) 的输出做 、 的 max pooling。
参考答案
(a) 每个位置 = 左上 − 右下。输出 3×3:[[0, −1, −1], [−1, 1, 3], [2, −1, −1]]。例如左上角:;中间:。
(b) [[0, 0, 0], [0, 1, 3], [2, 0, 0]]。
(c) 2×2:[[1, 3], [2, 3]]。
这个核算的是”沿主对角线方向的亮度差”,是一个斜边检测器。
练习 3(全连接 vs 卷积)。输入是 300×300 的彩色图。(a) 第一层是 100 个神经元的全连接层,多少参数(含偏置)?(b) 第一层是 100 个 5×5 的滤波器的卷积层,多少参数?(c) 输入换成 600×600,(a)(b) 各变成多少?
参考答案
(a) 。 (b) 。 (c) 全连接变成 4 倍左右:;卷积不变,还是 7,600(§6.2)。
练习 4(推导:卷积 = 翻转核的互相关)。用一维的情形证明:数学卷积 等于把 倒过来()之后的互相关 。再说明为什么”学一个互相关核”和”学一个卷积核”能表示的函数集合相同。
参考答案
令 ,当 取 时 也取遍 : 。二维时行、列各做一次同样的替换,就是”旋转 180°”。 任何卷积核 都对应一个互相关核 (反过来也一样),这是一个一一对应。所以两种参数化能表示的函数完全相同,梯度下降只是会学出翻转过的那一个(代码 01 演示 3)。
练习 5(推导:卷积层的反向传播)。一维、单通道、步长 1、不补 0:,。已知 。(a) 求 和 。(b) 求 。(c) 说明 (b) 为什么是”一次卷积”。
参考答案
(a) 里含 的项是 ,所以 ——这本身是 和 的互相关(“小方块 × dz 累加”,§10.1 第二行)。。 (b) 出现在所有满足 的项里,即 :(只对 的 求和)。 (c) 把 两边各补 个 0,(b) 就是 和 的数学卷积(等价于和翻转后的 做互相关)。所以”梯度穿过一个卷积层,还是一个卷积”。二维时同理,这就是 §10.1 第一行累加的效果。
练习 6(等变还是不变)。对下面每个运算,判断它对”整数像素的平移”是等变的、不变的、还是两者都不是(不考虑图像边界):(a) 3×3 卷积,步长 1;(b) ReLU;(c) 2×2、步长 2 的 max pooling;(d) 全局 max pooling;(e) 拉平后接一个全连接层。
参考答案
(a) 等变(§9.2,误差 0)。(b) 等变(逐像素的运算,平移前后对每个像素做同样的事)。(c) 只对 2 的倍数的平移等变(格子整体移动一格);对奇数平移既不等变也不严格不变,只是”近似不变”(§9.3)。(d) 对它的输入的平移不变;但如果前面有步长 2 的池化,整个网络对奇数平移就不再严格不变(§9.3 表里的 0.168)。(e) 两者都不是:每个位置有自己的权重(§9.5 里 FC 头的 0.485)。
练习 7(改代码:先预测,再运行)。在 04_translation_experiment.py 的 demo_left_right 里,把训练集改成图案出现在所有位置(lefts=list(range(10))),测试 B 不变(只在右边)。先预测:CNN(FC 头)和 MLP 在测试 B 上大约各多少?
参考答案
我运行的结果(3 个种子,其他设置不变):CNN(FC 头)在测试 B 上平均约 0.914(0.926、0.886、0.930),MLP 约 0.765(具体数字以你运行的结果为准)。 FC 头的 CNN 从 0.485 回到 0.9 以上:训练数据里有了右边的十字,它的 FC 头就学会了读”右边格子”的特征。MLP 只回到约 0.77,和 §9.4 抖动 ±4 时的 0.780 相当——位置多样性本身就是它的难点。这说明 CONV-POOL-FC 的”平移鲁棒性”有相当一部分来自数据里的位置多样性;全局池化头则把它直接写进了结构。
练习 8(改代码:滤波器少一些会怎样)。在 05_simple_cnn_hand_signs.py 里把 build_cnn 的第一层滤波器个数 c1=8 改成 c1=2。(a) 参数个数变成多少?(先手算)(b) 先预测:test 准确率会掉到 MLP(0.856)以下吗?
参考答案
(a) CONV1:;CONV2:;FC:。合计 1,866(原来 2,790)。注意 CONV2 也变小了,因为它的滤波器通道数 = 上一层的通道数。 (b) 我运行的 3 个种子平均约 0.877(0.849、0.872、0.911),比 8 个滤波器时(0.923)低,但仍高于 MLP 的 0.856(具体数字以你运行的结果为准)。只有 2 种第一层特征也能做得不错——第二层的 16 个滤波器可以把它们组合起来。
练习 9(感受野)。本讲的小 CNN 是 CONV 3×3(same)→ POOL 2×2 → CONV 3×3(same)→ POOL 2×2。最后 4×4 特征图里的一个格子,“看得见”输入图像上多大的一块?Ng 的 LeNet 风格例子(CONV 5×5 → POOL 2 → CONV 5×5 → POOL 2)呢?
参考答案
从输出往回推,记”一格对应输入上多大”(感受野 )和”相邻两格在输入上隔多远”(跳距 ):每过一个 、步长 的层,,。从输入开始 : CONV 3×3:;POOL 2:;CONV 3×3:;POOL 2:。所以每个格子看到 10×10 的输入。 LeNet 风格:CONV 5×5:;POOL 2:;CONV 5×5:;POOL 2:,即 16×16。 (我用 PyTorch 把一个输出格子对输入求梯度、看非零区域的大小验证过这两个数;池化要换成平均池化,因为 max pooling 的梯度只流向最大值,会让非零区域看起来更小。)这就是第 4 讲 §5.1 说的”感受野逐层变大”:越往后的层,每个单元看到的范围越大,能表示的图案也越大越复杂。
练习 10(设计)。你要在 128×128×3 的照片上做 10 类分类,训练数据只有 2000 张。(a) 不看第 13 讲,按本讲的规律设计一个 CONV-POOL-…-FC 的网络,写出每层的形状和参数个数。(b) 如果测试时物体可能出现在照片的任何位置,而训练照片里物体几乎都在中间,你会怎样改输出头或数据?
参考答案(一种可能)
(a) 例如:CONV 3×3×16(same)→ 128×128×16(448)→ POOL 2 → 64×64×16 → CONV 3×3×32(same)→ 64×64×32(4,640)→ POOL 2 → 32×32×32 → CONV 3×3×64(same)→ 32×32×64(18,496)→ POOL 2 → 16×16×64 → 拉平 16,384 → FC 10(163,850)。高宽减半、通道翻倍;参数大多在最后的全连接层。 (b) §9.5 说明 FC 头在”没见过的位置”上可能失效。两种办法:把输出头换成全局平均 / 最大池化 + 小的全连接层(结构上的不变);或者训练时做随机平移、裁剪的数据增强(第 6 讲 §6.1,用数据补足不变性)。两者常常一起用。数据只有 2000 张时,第 13 讲的迁移学习通常比从零训练好得多。
14. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C4M1 “Foundations of Convolutional Neural Networks”(Andrew Ng)——本讲的主线;编程作业 “Convolutional Model: Step by Step” 和 “Convolutional Model: Application”。
- Stanford CS231n 课程笔记 “Convolutional Neural Networks: Architectures, Convolution / Pooling Layers”(cs231n.github.io)——对输出尺寸、参数个数、感受野讲得很细,另一个角度的好参考。
- Dumoulin & Visin (2016). A guide to convolution arithmetic for deep learning. arXiv:1603.07285. ——padding、stride、转置卷积的尺寸关系,配了大量示意图。
教材
- Goodfellow, Bengio & Courville (2016). Deep Learning,第 9 章 “Convolutional Networks”(免费在线)——“稀疏交互、参数共享、等变表示”三个动机的经典表述,以及池化与不变性的讨论。
历史上的关键工作
- Hubel & Wiesel (1962). Receptive fields, binocular interaction and functional architecture in the cat’s visual cortex. ——视觉皮层里”只对局部、特定方向的边缘有反应”的简单细胞,是卷积思想的生物学来源。
- Fukushima (1980). Neocognitron. ——最早的”卷积 + 下采样”层次结构之一。
- LeCun et al. (1989). Backpropagation applied to handwritten zip code recognition. ——用反向传播训练卷积网络。
- LeCun, Bottou, Bengio & Haffner (1998). Gradient-based learning applied to document recognition. ——LeNet-5(第 13 讲)。
- Zeiler & Fergus (2014). Visualizing and understanding convolutional networks. ECCV. ——“第一层学出边缘和颜色斑块”的可视化来源(第 21 讲)。
平移不变性的细节
- Azulay & Weiss (2019). Why do deep convolutional networks generalize so poorly to small image transformations? JMLR. ——下采样让 CNN 对一两个像素的平移也不稳定(§9.3)。
- Zhang (2019). Making convolutional networks shift-invariant again. ICML. ——在下采样前加低通滤波(anti-aliasing)来缓解这个问题。
15. 下一讲预告 · Next lecture
第 13 讲:深度卷积架构与迁移学习——LeNet → ResNet → MobileNet。 本讲搭的是”一个简单的 CNN”。下一讲看过去十几年里人们是怎样把它做深、做好、做快的:
- 经典网络:LeNet-5、AlexNet、VGG——本讲 §8.1 的形状规律在它们身上怎样体现,为什么 VGG 只用 3×3 的卷积;
- 残差网络 ResNet:网络加深后连训练误差都变大的”退化问题”,以及跳跃连接为什么让很深的网络也能训练;
- 1×1 卷积与 Inception:用”只在通道方向上做全连接”的卷积来改变通道数、省计算;
- MobileNet:depthwise separable 卷积——本讲 §6.2 说”卷积省参数不省计算”,它专门来省计算;
- 迁移学习与数据增强:数据只有几千张时(练习 10),怎样借用在大数据集上训练好的网络。
本讲的全局池化头(§9.5)在那里也会再次出现:很多现代网络正是用全局平均池化取代了大的全连接层。