对应 Maps to:Stanford CS230 Fall 2025 Lecture 3(10/7,“Full Cycle of a DL Project”);Autumn 2018 Lecture 3 “Full-Cycle Deep Learning Projects”(Andrew Ng)、Lecture 5 “AI + Healthcare”(Pranav Rajpurkar)、Lecture 6 “Deep Learning Project Strategy”(Andrew Ng)(均为 YouTube 公开录像);Fall 2025 Section 1(Getting Started with Your Project)、Section 3(Implementation First Steps: Codebases, Baselines)、Section 7(Debugging DL Projects)(公开网页);CS230 博客 “Tips for the Final Project”。 依据说明:Fall 2025 的课堂 slides 和录像只对选课学生开放,本讲没有用到。2018 年的录像是公开的,但本讲义没有逐字核对录像:§1 里 Ng 的”语音激活设备”主线是按这一讲的内容提纲写的,细节和措辞可能和录像有出入,凡是”Ng 认为……”的地方都只是转述大意。Section 1、3、7 依据公开网页(https://cs230.stanford.edu/section/1 、/section/3 、/section/7 )。§9 的医疗案例依据原始论文(CheXNet、Hannun et al. 2019、MURA、Zech et al. 2018),文中的数字已对照论文。调试清单的几项参考了 Karpathy 的公开博客,部署与监控部分依据公开的工程资料(Google Rules of ML、Sculley et al. 2015 等,见 §14)。配套代码全部用合成数据。 配套代码 Code:
code/lecture11/(PyTorch;5 个脚本 + 3 个模块;一个贯穿全讲的”工厂质检”迷你项目,加一个合成的”类胸片”医疗世界;每个脚本 5–25 秒) 预计阅读时间:3 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说出一个深度学习项目从选题到维护的七个步骤,以及每一步最常见的失败方式;知道它们是一个循环,而不是一条直线。
- 评估一个选题的可行性(数据拿不拿得到、要多少、有没有人类水平可以参照、值不值得做),并在动手之前写下”成功是什么”:一个优化指标加几个满足指标。
- 用实验数字解释**“先快后精”**:为什么应该先花一两天采一个小数据集、尽快走完一整圈;会用学习曲线边采边估计”还要采多少”。
- 快速搭出第一个系统:先复现现成代码,按”多数类 → 规则 → 线性模型 → 网络”的阶梯建 baseline,先在小数据上过拟合。
- 按 Section 7 的四类错误(语法 / 逻辑 / 算法 / 实验)排查问题,熟练使用一份调试清单:看数据、初始损失 ≈ ln C、在一个 batch 上过拟合、打乱标签测试、学习率扫描、检查训练模式;知道每一项能抓住什么、抓不住什么。
- 把模型变成系统:选阈值(它是产品决策)、加前置过滤器、权衡端侧与云端;上线后区分数据漂移和概念漂移,知道哪些能用不需要标签的统计量(PSI、KS、预测分布)发现,哪些只能靠人工抽检;比较几种重训策略。
- 读懂医疗 AI 论文里的”专家水平”结论:专家标签的分歧、参考标准怎样定、置信区间、跨医院泛化与捷径学习。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉、后面再展开 Previewed only |
|---|---|
| 第 5 讲:五问框架;触发词检测的标签设计与数据合成(§5.3–5.4);服务器 vs 手机(§2.6) | 卷积网络(第 12–13 讲):本讲的迷你项目只用全连接网络,CNN 会做得更好 |
| 第 6 讲:train / dev / test、bias 与 variance、basic recipe | 序列模型做语音唤醒的细节(第 15–16 讲) |
第 7 讲:输入归一化、初始化;第 9 讲:torch_utils 训练模板、softmax、model.eval() 的坑(§4.7) | 校准(calibration)、主动学习、联邦学习等(§7、§8、§9 只点名) |
| 第 10 讲的方法:单一数字指标、satisficing / optimizing、误差分析与天花板、错误标签、数据不匹配 | 大模型时代的项目流程(第 20 讲) |
第 10 讲讲的是 ML 策略的方法本身;这一讲把这些方法放回一个完整的项目里用,并补上方法之外的部分:选题、采数据、搭第一个系统、调试、部署、监控。
0.3 本讲地图 Map
§1  一个项目的一生:七个步骤;Ng 的语音台灯;本讲的迷你项目(工厂质检)
§2  选题与可行性;先写下"成功是什么"
§3  数据:先快后精;两支队伍的 60 天;第 3 天的诊断;学习曲线          ← 代码 01 演示 1–4
§4  第一个系统:复现现成代码;baseline 阶梯;先过拟合小数据              ← 代码 01 演示 5
§5  调试:四类错误;检查清单;注入 9 个 bug                            ← 代码 02
§6  迭代:误差分析告诉你下一批数据去哪里采;实验管理                    ← 代码 03
§7  从模型到系统:阈值、前置过滤器、端侧 vs 云端、延迟与吞吐            ← 代码 04 演示 1–2
§8  部署之后:数据漂移 vs 概念漂移;监控面板;什么时候重训              ← 代码 04 演示 3–4
§9  AI + 医疗:专家标签、"超过医生"怎么读、换一家医院                  ← 代码 05
§10 你的 CS230 项目
§11–15  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 | 出现在 |
|---|---|---|
| 类别数;随机初始化时交叉熵约为 | §5 | |
| 召回率 recall、误报率 false alarm rate | 缺陷被拦下的比例;正常品被误拦的比例(= 1 − 特异度) | §3、§7、§8 |
| 阈值: 就拦下 | §7 | |
| 漏检一个、误报一个的代价;本讲假设 | §7 | |
| 、 | 输入的分布;给定输入时标签的分布。前者变了叫数据漂移,后者变了叫概念漂移 | §8 |
| PSI、KS 的 | 两个衡量”分布挪了多少”的统计量 | §8.2 |
| Cohen’s kappa,两个标注者”超出偶然”的一致程度 | §9 | |
| F1、AUC | 精确率与召回率的调和平均;ROC 曲线下面积 | §9 |
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出。PyTorch 在 CPU 上单线程运行、每个演示用自己的随机种子,同一台机器上重复运行逐字相同(只有 04_deploy_and_monitor.py --timing 打印的计时每次不同)。两个世界都是合成的:工厂质检世界(factory_world.py)和”类胸片”世界(clinic_world.py,不是真实医学影像)。世界里的参数(噪声、缺陷对比度、灰尘和水渍的强度、两个工位的亮度差……)是我先在草稿里试了几组之后选的,目的是让”规则 baseline 在小数据时领先、网络在大数据时追上”这样的现象落在几千张图的范围里;这些选择都写在代码开头。有很多结果和我写代码前的预想不一样,讲义按实际结果写,并列在代码 README 的”关于实验结果”里。
1. 一个项目的一生 · The life of a project
1.1 Ng 的例子:一个听得懂一句话的设备
2018 年这一讲,Andrew Ng 用一个语音激活的设备贯穿全程:比如一盏台灯,你对它说一句唤醒词,它就打开。这个例子小到一个学生项目就能做,又完整到包含了真实产品会遇到的几乎所有问题。(以下按这一讲的提纲转述,细节可能和录像有出入。)
先想一想:如果让你从零做这盏台灯,第一周你会做什么?很多人的第一反应是”先读几篇论文,选一个最好的模型”,或者”先采一个大数据集”。Ng 的建议恰恰相反:先用一两天采一个小数据集,尽快做出一个能跑的、粗糙的系统(quick and dirty),再靠误差分析决定往哪里投入。 理由很简单:你事先不知道哪里会出问题。也许是麦克风离得太远,也许是某种口音,也许是电视的声音总把它叫醒。这些问题只有系统真的跑起来、放到真实环境里才会暴露。
1.2 七个步骤
| 步骤 | 要决定什么 | 台灯的例子 | 最常见的失败方式 | 本讲 |
|---|---|---|---|---|
| 1 选题 | 做什么、值不值得、做不做得到 | 一句唤醒词点亮台灯 | 题目太大;数据根本拿不到 | §2 |
| 2 获取数据 | 从哪来、要多少、谁来标、怎么标 | 找人录唤醒词、别的词、背景噪声,合成训练音频(第 5 讲 §5.3) | 花几个月采数据,采法本身有缺陷 | §3 |
| 3 设计模型 | 输入输出、架构、损失 | 频谱图 → 每个时间步一个 0/1(第 5 讲 §5.2) | 一开始就追求最复杂的模型 | §4 |
| 4 训练 | 让它学起来 | 先在小数据上调通 | 流水线有 bug 却以为”模型就这水平” | §5 |
| 5 测试 | 在什么数据上、用什么指标 | 在真实房间里试,数误唤醒和漏唤醒 | dev 集和真实使用的数据不一样 | §3、§6 |
| 6 部署 | 跑在哪里、多快、阈值多少 | 设备上常开一个便宜的语音活动检测(VAD),只把有声音的片段送进网络 | 只看模型,不看系统(延迟、功耗、阈值) | §7 |
| 7 维护 | 上线后世界变了怎么办 | 新的口音、新的背景噪声(换了一台空调) | 不监控,等用户投诉才知道 | §8 |
1.3 不是一条直线
这张表看起来是按顺序走的,实际上是一个循环:测试时发现数据有问题,就回到第 2 步;部署后发现新的噪声,就回到第 2、4 步。第 1 讲 §4.5 的”Idea → Code → Experiment”是这个大循环里的小循环。
两个习惯能让这个循环转得快:
- 每一步都尽早做一个”够用”的版本,让整个循环先转一圈,再回头加强最弱的一环;
- 每一步都写下”出口标准”(exit criteria):做到什么程度就进入下一步。比如”dev 上召回率 ≥ 0.9、误报率 ≤ 5% 就开始试点”。没有出口标准的步骤,很容易一直做下去。
1.4 本讲的迷你项目:工厂质检
语音的例子需要序列模型(第 15–16 讲),而第 5 讲已经详细讲过触发词的标签设计。所以本讲的代码换一个主题,把七个步骤真的走一遍:
一家工厂想用摄像头自动检查金属零件的表面。相机拍 16×16 的灰度小图,模型判断:正常、划痕(一条亮的细线)、还是污点(一个暗斑)。
这个世界(factory_world.py)有几个刻意放进去的”真实感”:金属表面有横向的拉丝纹理;缺陷可以出现在中间 9×9 区域的任何位置;光线暗时缺陷更淡;正常品上也会有灰尘(单个亮点)和水渍(一大片很淡的明暗变化),它们无害,但长得像缺陷。产线上 90% 的零件是正常的。代码 01 演示 1 打印了每类一张(以每张图的中位数为中心 ±0.12 映射到字符):
正常               划痕               污点
+=++*=*+++=++=:+   =-++==++-+++==*+   +#++=+*++==-++*+
++*-=++==*-+=*+*   ++#+-+-+++==:===   +*****=++=. ::++
==--+*++=*++++**   ++-=++===-+*=++-   =+#*+=++-     -+
=+===++*+-==+===   *-====+++@#+-=*#   *==++*++.     .+
+=++=@+-++=====+   ++@+++*=++@@*===   #*#*=###-     :+
=++++*++*++==++-   ==+--=+++=-*@%+=   +=%+*+++-     :+
(只截了前 6 行。)正常品上那个孤立的 @ 是一粒灰尘;划痕是一串斜着的 @;污点是一片空白(暗)。
2. 选题与可行性 · Choosing a project
2.1 三个问题:值不值得、做不做得到、数据从哪来
选题时最常见的两种失败:题目大到做不完(“用深度学习诊断所有疾病”),或者做完了才发现数据根本拿不到。动手之前问三个问题:
- 价值:做成了,谁会用?比现在的做法好多少?(产线上人工目检很累、会漏,这就是价值。)
- 技术可行性:现在的技术做得到吗?一个粗略的经验来自 Ng 的一篇短文(Harvard Business Review, 2016):一个普通人想一秒钟就能做出的判断,往往是监督学习可以自动化的。人看一眼能分出划痕和灰尘,这就是个好兆头;要靠十年经验和整本病历才能下的判断,就难得多。
- 数据:能不能拿到?要多少?谁来标?标注员之间会不会意见不一?涉及隐私和许可吗?(医疗数据尤其如此,§9。)
还有一个常被忽略的问题:有没有一个参照?人类水平、现有的规则系统、竞争对手的产品——有了参照,你才知道”0.9 的准确率”是好还是坏(第 10 讲:human-level performance 是 Bayes error 的代理)。
| 可行性检查 | 工厂质检 | 语音台灯 |
|---|---|---|
| 一个人一秒钟能判断吗 | 能(看一眼) | 能(听一句) |
| 数据能自己采吗 | 能:产线每天几千个零件,质检员会标 | 能:找人录,再合成 |
| 每天能采多少 | 本讲假设 150 张(拍照 + 标注) | 一天能录几十个人 |
| 参照 | 人工目检;一条手写规则(§4.2) | 现有的唤醒词产品 |
| 两种错误的代价 | 漏检(流到客户)≫ 误报(人工复检) | 误唤醒(烦人、隐私)vs 漏唤醒 |
2.2 CS230 的项目:四类
CS230 Section 1(公开网页)把往届成功的项目分成四类:把流行的架构用到一个新任务上;为任务设计定制的架构;复现一篇著名论文;研究型项目(研究网络的某种行为)。不管哪一类,都要有自己的东西(新的数据、新的问题、新的分析)。同一页的数据建议也值得照抄:不要在采数据上花太多时间;可以自己采、爬、合成,也可以用现成的数据集;“几万个样本”是很多任务的一个粗略目标(医学影像常常少得多),任务越复杂、模型越大,需要的越多;数据少时考虑多采、数据增强、迁移学习;注意许可和隐私。
2.3 先写下”成功是什么”
在采第一张图之前,就要写下怎样判断项目成功了。第 10 讲讲过两个工具:单一数字的评估指标(一个数,能比较两个方案谁更好),以及 optimizing vs satisficing(优化一个指标,其余的只要满足门槛)。放到工厂里:
- 优化指标:缺陷召回率(漏检的零件会流到客户手里);
- 满足指标:误报率 ≤ 5%(复检的人手有限);每个零件的推理时间 ≤ 产线节拍允许的时间。
注意这里用的不是准确率。产线上 90% 是正常品,一个**永远说”正常”**的系统准确率就有 0.90,却一个缺陷都拦不住(代码 01 演示 5 会看到这个数)。指标选错了,后面所有的迭代都在优化错误的东西。
3. 数据:先快后精 · Get data fast, then iterate
3.1 为什么要快
“先采一个大数据集再说”听起来稳妥,实际上是把所有风险都押在了”采法没有问题”上。数据的问题往往只有训练之后才暴露:采的环境和真实使用的不一样、标注标准不一致、某类样本几乎没有、数据里藏着一条捷径……你越晚发现,浪费的数据越多。
所以 Ng 建议:先花一两天采一个小数据集,马上训练,马上放到真实环境里试。这不是说小数据就够了,而是说先用小数据找到方向,再放心地大量投入。
3.2 实验:两支队伍的 60 天
代码 01 演示 2 把这个论证变成了数字。两支队伍做同一个项目,每天都能采并标 150 张图。他们的采法一样,而且有同一个问题:正常品在产线工位上拍,缺陷品是从废品箱里挑出来、拿到质检实验室拍的——那里有现成的台子和灯,拍起来方便。标签全部正确,图也清楚。
- 快队:第 1–2 天采 300 张 → 第 3 天训练,并在产线上随手拿 500 个零件试一试(试点)→ 发现问题 → 第 4 天起改在产线工位上采。
- 慢队:第 1–40 天采 6000 张 → 第 41 天第一次训练 + 试点 → 发现同一个问题 → 第 42 天起改在产线工位上采。
我们(写讲义的人)有一个两队都看不到的”产线评估集”:4000 个零件,按产线的真实比例(90% 正常)。每格是缺陷召回率 / 误报率:
| 第几天 | 快队手里的训练数据 | 召回 / 误报 | 慢队手里的训练数据 | 召回 / 误报 |
|---|---|---|---|---|
| 3 | 300 张(实验室拍缺陷) | 0.073 / 0.030 | 在采:已有 450 张 | — |
| 10 | 1050 张(产线工位) | 0.825 / 0.270 | 在采:已有 1500 张 | — |
| 20 | 2550 张(产线工位) | 0.924 / 0.130 | 在采:已有 3000 张 | — |
| 30 | 4050 张(产线工位) | 0.935 / 0.085 | 在采:已有 4500 张 | — |
| 41 | 5700 张(产线工位) | 0.948 / 0.070 | 6000 张(实验室拍缺陷) | 0.110 / 0.016 |
| 50 | 7050 张(产线工位) | 0.948 / 0.060 | 1350 张(产线工位) | 0.843 / 0.264 |
| 60 | 8550 张(产线工位) | 0.958 / 0.073 | 2850 张(产线工位) | 0.919 / 0.110 |
几件事:
- 数据多了 20 倍,问题一点没少:300 张时召回 0.073,6000 张时 0.110。问题出在”怎么采”,不在”采多少”。
- 快队浪费了 2 天的数据,慢队浪费了 40 天。到第 60 天,快队召回 0.958、误报 0.073,慢队 0.919 / 0.110:先快后精的好处会一直保持下去。
- 快队第 10 天的模型也不好(误报 0.270)。误报普遍偏高,一部分原因是这里直接用”三类里概率最大的那一类”做决定,而训练数据里缺陷占 2/3、产线上只占 10%——§7.4 会讲怎样选阈值。
3.3 第 3 天发生了什么
快队是怎样在第 3 天找到问题的?代码 01 演示 3 复盘了这一天。快队把 300 张图按 80/20 分成训练集和 dev 集:
| 同一个模型(240 张训练) | 准确率(三类) | 缺陷召回率 | 误报率 |
|---|---|---|---|
| 自己的 dev(60 张) | 0.817 | 0.976 | 0.056 |
| 产线试点(500 个零件) | 0.866 | 0.080 | 0.047 |
dev 上几乎所有缺陷都抓到了,试点上 50 个缺陷只拦下 4 个。先停下来想:为什么 dev 没有报警? 因为 dev 和训练集来自同一种采法,带着同一个偏差。dev 只能告诉你”在和训练一样的数据上”好不好(第 6 讲 §1.4:dev 要来自你将来面对的分布)。另外,试点上三类准确率 0.866 看着还行,那是因为 90% 的零件本来就是正常的。
接下来是一个小小的错误分析:漏掉的缺陷有什么共同点?把每类图的平均亮度列出来:
| 正常 | 划痕 | 污点 | |
|---|---|---|---|
| 采来的 300 张 | 0.497 | 0.614 | 0.594 |
| 产线试点 500 个 | 0.503 | 0.506 | 0.486 |
采来的缺陷图比正常图亮了约 0.11:实验室的灯更亮。产线上三类一样亮。两个检查坐实了这个猜测:
- “笨模型”检查:只用一个特征(平均亮度)、一个阈值(亮度 > 0.547 就判缺陷),在自己的 dev 上”是否缺陷”就判对了 0.933,在试点上召回率 0.100。当一个”不该有用”的特征就能解决大半问题时,几乎可以肯定数据里有捷径(shortcut)。
- 反事实检查:同样 300 个缺陷零件,缺陷的位置、形状、对比度完全一样,只换拍摄的灯。模型给出的平均 :实验室拍 0.979,产线工位拍 0.082。模型学会的是”亮 = 有缺陷”。
这一切在演示 1 里本来就能看到,只要”看数据”时顺手打印了按类别分组的简单统计量。所以”先看数据”不只是看几张图,还要看每类的均值、方差、来源、采集时间。这个”实验室的灯”是虚构的,但同类的事在医疗影像里真实发生过(§9.4)。
3.4 要采多少?边采边估计
小数据集还有一个用处:画学习曲线,估计”要采多少张才够”。代码 01 演示 4 在产线工位的数据上训练了 7 个大小(dev 是 3000 张、三类均衡):
| 训练张数 | 150 | 300 | 600 | 1200 | 2400 | 4800 | 9600 |
|---|---|---|---|---|---|---|---|
| 采集天数 | 1 | 2 | 4 | 8 | 16 | 32 | 64 |
| dev 错误率 | 0.398 | 0.389 | 0.372 | 0.270 | 0.182 | 0.131 | 0.081 |
第 1 讲 §4.6 说过,错误率随数据量常常近似按幂律下降:,在双对数坐标里是一条直线。假装我们在项目进行中,每次用”手里已有的点”拟合一次,外推到 9600 张,并估计”错误率降到 0.10 要多少张”:
| 拟合用的点 | 外推到 9600 | 降到 0.10 需要 | |
|---|---|---|---|
| 前 4 个(≤ 1200 张,8 天) | 0.175 | 0.205 | 576,374 张 |
| 前 5 个(≤ 2400 张,16 天) | 0.278 | 0.143 | 34,841 张 |
| 前 6 个(≤ 4800 张,32 天) | 0.336 | 0.119 | 15,973 张 |
| 实际 | 0.081 | 4800–9600 之间 |
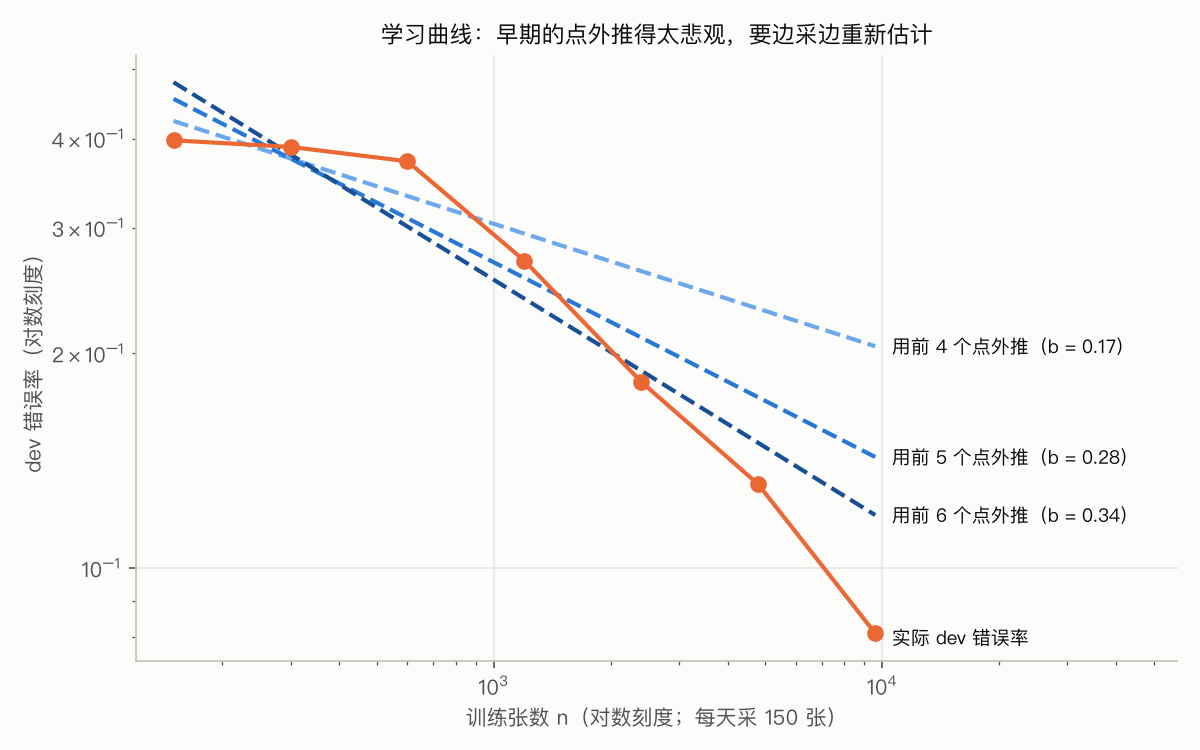
(这张图由 01_data_fast_then_baseline.py 生成;没装 matplotlib 时只打印表格。)
我原以为早期的点外推出来会”大致对”。实际上前 600 张几乎是平的(0.398 → 0.372):网络还没学会划痕和灰尘的形状差别,多给一点数据几乎没用,之后曲线才陡然下降。用这段”起步阶段”拟合的直线严重悲观,估计要 57 万张,差了几十倍。随着数据增加、重新拟合,估计从 57 万张降到 3.5 万张、再到 1.6 万张,一步步接近实际(4800 到 9600 张之间就降到了 0.10 以下)。
所以学习曲线的正确用法是边采边重新估计,而不是在第一周算一次就定下标注预算。早期估计哪怕错得离谱,也逼你在第一周就问:“照这个速度,这个项目值不值得做?要不要换方法?”
3.5 标注策略
数据的另一半是标签。几条经验:
- 先写标注指南:什么算划痕?多淡的算?灰尘和污点怎么区分?指南不清楚,两个标注员会给同一张图不同的标签(§9.2 会看到专家之间也是这样)。最好先让两三个人各标同一批图,比一比,把分歧写进指南。
- 能合成就合成:第 5 讲 §5.3 的触发词数据就是”录一点、合成很多”,标签免费而且精确。
- dev / test 的标签要比训练集的更干净:训练集里一点随机噪声,大量样本能把它平均掉一部分(§9.2 有实验);dev / test 的标签决定你相信哪个结论,值得多花人力(多人标注、裁决)。
- 把”难的样本”留下来:质检员复检时发现的误报和漏检,就是下一批最有价值的训练数据(§6)。
4. 第一个系统:baseline · Build your first system quickly
4.1 先复现现成的代码
CS230 Section 3(公开网页)给的第一条建议是:先找一份现成的实现,把它的结果复现出来;如果你的任务没有现成实现,就找一个已经被解决的”代理任务”,再换上自己的数据和标签。为什么?因为从零写一个训练流水线,大部分时间会花在调 bug 上(§5),而一份别人已经跑通的代码把这部分风险去掉了。
怎样判断一个 GitHub 仓库值不值得用?Section 3 列了一张清单:
| 看什么 | 为什么 |
|---|---|
| star 数、开源许可(license) | 用的人多,坑少;许可决定你能不能用在项目里 |
| README 清楚、报告了结果 | 你知道”复现成功”应该是什么数字 |
| 提供数据处理脚本和预训练权重 | 省掉最容易出错的部分 |
| 框架和你熟悉的一致;代码可读 | 你迟早要改它 |
| 有对应的论文 / 参考文献 | 出问题时能对照原文 |
同一页还建议:先在数据的一个子集上、在本地或 Colab 上调通,再搬到云 GPU 上跑全量;用完记得关机器。本讲的代码也是这么做的:没有从零写训练循环,而是直接用第 9 讲的 torch_utils.py 模板。
4.2 baseline 的阶梯
baseline 是第一个简单的模型,它的作用是给后面所有的改进一个比较的起点。不要只建一个,建一个阶梯:从”什么都不做”开始,一级一级往上。代码 01 演示 5 用 20 天的数据(3000 张,产线工位):
| 方法 | 参数个数 | dev 准确率 | 缺陷召回 | 误报率 |
|---|---|---|---|---|
| 多数类:永远判”正常” | 0 | 0.325 | 0.000 | 0.000 |
| 规则:行中位数残差(两个阈值 0.145 / 0.105) | 2 | 0.884 | 0.914 | 0.102 |
| softmax 回归 [256, 3] | 771 | 0.660 | 0.791 | 0.413 |
| MLP [256, 128, 64, 3](第 9 讲模板,默认超参数) | 41347 | 0.847 | 0.950 | 0.105 |
(dev 三类均衡;后两列在产线评估集上算。)
- 多数类:在均衡的 dev 上 0.325;放到产线评估集上准确率有 0.904,却漏掉所有缺陷。任何指标先和这个”什么都不做”的数比一比。
- 规则是一个有经验的工程师会先写出来的东西:每个像素减去它所在行的中位数(去掉横向的拉丝纹理),最亮的点超过阈值就判”划痕”,最暗的点低于阈值就判”污点”。只有两个参数,dev 准确率 0.884,比 3000 张图训练出来的 MLP(0.847)还高。放大看它的错误:误报的 97 张正常品 100% 带灰尘或水渍;漏掉的缺陷平均对比度 0.131(全部缺陷 0.250)。它只看”最突出的那一点有多突出”,不懂形状。
- 对照演示 4 的学习曲线,MLP 要到 4800 到 9600 张之间才超过规则。这就是第 1 讲代码 03 那张”规模”图的左半边:小数据时,领域知识(手工特征)领先。
- softmax 回归只有 0.660:一个线性模板对付不了”缺陷可以出现在任何位置”(第 2 讲 §9.3)。
这张表是项目的第一个里程碑:你知道了下限、一个强 baseline、网络现在在哪。Google 的 Rules of Machine Learning 第一条是”不要害怕在没有机器学习的情况下上线”:规则可以先上线、开始收集真实数据,网络在数据够了之后再替换它,或者留下来当网络前面的过滤器(§7.3)。
4.3 先在小数据上过拟合
Section 3 的另一条建议:先在很小的一组样本上训练,确认模型能把它们背下来,再逐步加数据。 网络连 32 张图都背不下来,说明流水线有 bug,或者学习率之类的设置有问题,而不是”数据不够”。小数据上一次实验只要几秒,你可以很快地试架构和超参数。这一条是下一节检查清单里最重要的一项。
5. 调试 · Debugging
5.1 四类错误
CS230 Section 7(公开网页)把深度学习项目里的错误分成四类:
| 类别 | 含义 | 例子 | 难度 |
|---|---|---|---|
| 1 语法 / 运行错误 | 代码跑不起来 | 少了冒号;张量形状对不上 | 最容易:Python 会告诉你哪一行 |
| 2 逻辑错误 | 能跑,但没有按你的意图做 | 打乱数据时只打乱了图片;在训练集上算 dev 准确率 | 最危险:不报错,结果”差一点”或”好得不真实” |
| 3 算法错误 | 代码照你写的做了,但方法不适合这个数据 / 任务 | 用线性模型检测位置不固定的缺陷 | 需要判断”是 bug 还是能力不够” |
| 4 实验错误 | 方法对,但超参数或设置错了 | 学习率差了 100 倍 | 靠扫描和对照实验 |
Section 7 的练习是一个预置了 8 个 bug 的图像分割代码库(UNet),要学生修到能训练。它给的技巧包括:直接打印各层的输出、权重和梯度;画出输入数据和权重的大小;用 profiler 找慢的地方;一次只改一处、看有没有帮助;每次改动之后从头运行一遍(notebook 里的”Restart & Run All”),免得漏掉某个单元格。
5.2 一份检查清单
把 Section 7、Section 3 和 Karpathy 的博客 A Recipe for Training Neural Networks(2019)里的建议合在一起,得到一份每一项都只要几秒钟的清单:
| 检查 | 正常的样子 | 为什么 | |
|---|---|---|---|
| A | 能跑吗 | 前向传播不报错 | 先让它能跑 |
| B | 看数据:送进网络的 对得上吗 | 按标签分组后,各组的图明显不同(这里看”最亮点突出程度”:划痕组应该比正常组高) | 看的是进网络之前最后一步的数据,而不是原始文件 |
| C | 初始损失 | 随机初始化时 (3 类时 1.099) | 输出层的 logits 一开始应该很小,对各类”一视同仁”: |
| D | 在一个 batch 上过拟合 | 32 张图训练几百步,损失降到接近 0 | 网络有能力背下 32 张图;背不下来说明梯度、更新或损失有问题 |
| E | 打乱标签测试 | 用打乱的训练标签训练,汇报的 dev 准确率 ≈ ,而且明显低于正常标签 | 模型确实在用”图片 ↔ 标签”的关系;能抓住”评估写错了” |
| F | 学习率扫描 | 每个数量级(1e−5 … 1e−1)训练几个 epoch,当前学习率在最好的那一档附近 | 实验错误里最常见的一种 |
| G | 训练时在训练模式吗 | 每一步 model.training 都是 True | 第 9 讲 §4.7 的反面:评估后忘了切回 train() |
关于 E 有一个细节:网络有足够的容量时,连随机标签都能背下来(Zhang et al. 2017),所以打乱标签后训练准确率仍可能上升。要看的是 dev:打乱的标签和图片没有任何关系,dev 准确率不可能高于瞎猜。
清单之外还有几条通用的习惯:可视化预测(把模型最自信地判错的图拿出来看);逐步加复杂度(先小网络、小数据、不加正则化,跑通了再一样一样加);一次只改一处。
5.3 实验:往同一份代码里注入 9 个 bug
代码 02 写了一份”项目训练代码”(数据准备 → 模型 → 训练循环,训练循环完整写出来,不用 torch_utils.fit),里面有 9 个开关,每个开关注入一个真实项目里常见的 bug。正确的代码([256, 128, 64, 3] + dropout 0.2,Adam 0.001,15 个 epoch)七项全部通过:初始损失 1.111,32 张图 300 步后损失 0.0005,打乱标签后 dev 0.287,学习率扫描最好的一档恰好是 1e−3,最终 dev 准确率 0.828。然后逐个打开 bug(✗ = 这一项报警):
| bug | 类别 | A | B | C | D | E | F | G | 真实 dev 准确率 |
|---|---|---|---|---|---|---|---|---|---|
| 忘了把 16×16 的图拉平 | 1 语法/运行 | ✗ | · | · | · | · | · | · | 报错 |
| 忘了归一化(直接喂 0–255) | 2 逻辑 | ✓ | ✓ | ✗ | ✗ | ✗ | ✓ | ✓ | 0.323 |
| 打乱时只打乱了图片、没打乱标签 | 2 逻辑 | ✓ | ✗ | ✓ | ✓ | ✗ | ✓ | ✓ | 0.328 |
| 模型最后加了 softmax,再交给 CrossEntropyLoss | 2 逻辑 | ✓ | ✓ | ✓ | ✗ | ✓ | ✓ | ✓ | 0.751 |
| 在训练集上算”dev 准确率” | 2 逻辑 | ✓ | ✓ | ✓ | ✓ | ✗ | ✓ | ✓ | 0.828 |
评估后没有切回 model.train() | 2 逻辑 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✗ | 0.833 |
| 用 softmax 回归(没有隐藏层) | 3 算法 | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | 0.664 |
| 学习率大了 100 倍(0.1) | 4 实验 | ✓ | ✓ | ✓ | ✗ | ✗ | ✗ | ✓ | 0.330 |
| 学习率小了 100 倍(1e−5) | 4 实验 | ✓ | ✓ | ✓ | ✗ | ✓ | ✗ | ✓ | 0.449 |
| (正确的代码) | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | 0.828 |
(· = 代码在第一步就报错了,后面的检查没法做。)
先盯着这张表想一想:哪一列最值钱?哪个 bug 最危险?
5.4 逐个看
- 忘了拉平:报错信息直接说出了形状对不上(
1024x16 and 256x128)。能报错的 bug 是好 bug。 - 忘了归一化:初始损失 9.465,是 ln 3 的八倍多。一秒钟的 C 项就抓住了。不修的话:32 张图都背不下来(损失停在 0.7125),完整训练后训练集准确率只有 0.352。
- 只打乱了图片:能跑、初始损失正常、32 张图也能背下来(随便什么标签都能背)。只有 B 和 E 报警:按标签分组后,“划痕”组和”正常”组的图一模一样(“最亮点突出程度”都是 2.42);正常标签(0.328)和打乱标签(0.341)一样差。症状很典型:训练集 0.691(网络在硬背),dev 0.328(瞎猜)。
- softmax 两次:初始损失 1.100,C 项抓不住;但在一个 batch 上过拟合时损失停在 0.5517,降不下去。这就是第 9 讲 §3.8 的”地板”:3 类时是 。最终 dev 0.751,比正确代码低 0.077——低得不多,很像”模型还不够好”。
- 在训练集上评估:汇报的 dev 准确率 0.967,比正确代码还好看。只有打乱标签测试抓住了它:标签打乱以后”dev 准确率”还有 0.695。打乱的标签和图片毫无关系,这个数只可能来自”网络背下了训练集”。好得不真实的结果,第一反应应该是怀疑。
- 没切回
train():只有 G 项(训练循环里一行assert model.training)能抓住。我原以为它会让结果明显变差;这一次它几乎没有代价(0.833 vs 0.828):dropout 在第 1 个 epoch 之后就被关掉了,训练集准确率升到 0.996,过拟合更重,但 dev 刚好没变差。bug 不一定让结果变差,这正是它难被发现的原因。 - softmax 回归:七项全部通过,代码没有 bug。它只是能力不够:32 张图能背下来,整个训练集却只有 0.739。“能在一个 batch 上过拟合,却拟合不好整个训练集” 说明问题在方法(high bias,第 6 讲),该换模型,而不是找 bug。D 项的真正价值就在这里:它帮你分清第 2 类和第 3 类错误。
- 学习率大 100 倍:网络彻底学不动(训练集 0.321),D、E、F 报警;小 100 倍:300 步不够把 32 张图背下来(D),F 的扫描同样指向 1e−3。
5.5 换一个架构,清单的灵敏度会变
代码 02 演示 4 把模型里的 dropout 换成 BatchNorm,再查三份代码:
| 代码(BatchNorm 版) | C 初始损失 | D 一个 batch | E 正常 / 打乱 | 真实 dev | (dropout 版) |
|---|---|---|---|---|---|
| 正确的代码 | 1.299 ✓ | 0.0031 ✓ | 0.843 / 0.370 ✓ | 0.843 | 0.828 |
| 忘了归一化 | 1.313 ✓ | 0.0031 ✓ | 0.323 / 0.297 ✗ | 0.323 | 0.323 |
| 学习率大 100 倍 | 1.299 ✓ | 0.0000 ✓ | 0.791 / 0.323 ✓ | 0.791 | 0.330 |
- 有了 BN,忘了归一化的初始损失只有 1.313,C 项抓不住了:BN 会把第一层的输出重新标准化,输入是 0–1 还是 0–255,对初始 logits 几乎没影响。但网络照样学不好,只有 E 项还在报警。
- 到底缺的是哪一半?一个对照实验:只减均值、仍然是 0–255 的尺度,BN 版 0.830、dropout 版 0.816;只除以 255、不减均值,BN 版 0.323、dropout 版 0.647。缺的是”减均值”:每个像素都在同一个大偏移附近,第一层的输出被这个共同的偏移主导,缺陷那一点点变化被淹没了。这是第 7 讲 §1.5”数据离原点远”的问题在真实流水线里的样子。
- 学习率大 100 倍在 BN 网络里不再是灾难(0.791,dropout 版 0.330),和第 9 讲 §2.6”BN 让网络扛得住大学习率”一致。
所以清单里的每一项都是必要条件的检查,不是证明:通过了不代表没 bug,它的灵敏度取决于你的架构。几项互相印证,比依赖任何一项都可靠。排查的顺序就是四类错误的顺序:先让它能跑;再确认它在做你想做的事(B–E、G);然后看方法够不够(D 过、整个训练集不行);最后才调超参数(F,第 9 讲 §1)。
6. 迭代:误差分析驱动 · Iterate with error analysis
6.1 从”更多数据”到”去哪里采”
接着工厂的故事:快队在产线工位采了 20 天,3000 张。但他们只在 1 号产线架了相机。工厂其实有两条线:2 号线占产量的 25%,零件是转了 90° 放的,拉丝纹理是竖的。dev 集按”模型将来要面对的数据”来建:1125 张来自 1 号线、375 张来自 2 号线。另外,标注员大约有 2% 的时候会标错。
基线模型(第 9 讲模板,默认超参数)3 个种子的 dev 准确率是 0.789、0.799、0.789,训练集 1.000:明显的 high variance(第 6 讲),药方首先是更多的数据。但是,下一批数据该去哪里采?
6.2 误差分析表
第 10 讲讲过误差分析的做法:拿出约 100 个 dev 上的错例,一个个看,像电子表格一样逐列打勾,再数一数每一类占多少。代码 03 演示 1 照做了(真实项目里要人一张张看图;这个世界里每张图怎么来的都记在 meta 里,打勾可以自动完成)。随机抽的 100 个错例里,前几行是这样的:
| # | 标签 → 预测 | 错误类型 | 2 号线 | 淡缺陷(c < 0.2) | 正常品带灰尘 / 水渍 | 标签本身标错了 |
|---|---|---|---|---|---|---|
| 1 | 正常 → 污点 | 误报 | ✓ | |||
| 3 | 划痕 → 正常 | 漏检 | ✓ | |||
| 4 | 正常 → 污点 | 误报 | ✓ | ✓ | ||
| 6 | 划痕 → 正常 | 漏检 | ✓ | ✓ | ||
| 合计(100 个) | 25% | 44% | 28% | 7% |
再在全部 317 个错例上算每一类的天花板:如果这一类错误全部修好,dev 错误率最多能降到多少:
| 类别 | 错例个数 | 占错例 | dev 里这类图的比例 | 这类图的错误率 | 天花板 |
|---|---|---|---|---|---|
| 2 号线 | 76 | 24% | 25% | 0.203 | 0.161 |
| 淡缺陷(c < 0.2) | 131 | 41% | 23% | 0.372 | 0.124 |
| 正常品带灰尘 / 水渍 | 83 | 26% | 22% | 0.255 | 0.156 |
| 标签本身标错了 | 28 | 9% | 2% | 0.933 | 0.193 |
(dev 错误率 0.211。一个错例可以同时属于几类,所以各类加起来超过 100%,天花板也不能相加。)
这张表和我的预想不一样。 训练集里一张 2 号线的图都没有,我以为”没见过的产线”会是最大的问题。数出来,2 号线的错误率(0.203)和 1 号线(0.214)差不多,它的错误只占它在 dev 里的份额。竖的纹理并没有让模型”失明”。最大的一类是淡缺陷。先数,再下结论。 另外注意:抽 100 个错例数出来的比例(44%、28%、25%、7%)和全部错例(41%、26%、24%、9%)很接近,这就是为什么 100 个通常就够用。
6.3 同样的预算,五种花法
误差分析给出的是天花板,它准不准?代码 03 演示 2 用同样的预算(再采并标 1500 张,相当于 10 天)试了五种做法,每种 3 个种子:
| 做法 | dev 准确率 | 1 号线 | 2 号线 | 比基线 |
|---|---|---|---|---|
| 基线(1 号线 3000 张) | 0.792 | 0.797 | 0.778 | |
| (a) 随机多采 1 号线 | 0.820(±0.006) | 0.830 | 0.788 | +0.028 |
| (b) 专门去 2 号线采 | 0.831(±0.003) | 0.830 | 0.835 | +0.039 |
| (c) 按产线比例采(3:1) | 0.820(±0.001) | 0.825 | 0.804 | +0.028 |
| (d) 专门采难的图(淡缺陷 + 带干扰的正常品) | 0.832(±0.003) | 0.844 | 0.798 | +0.040 |
| (e) 不采数据,网络加宽到 [512, 256] | 0.812(±0.002) | 0.819 | 0.792 | +0.020 |
- 两种有针对性的做法并列第一:(d) 瞄准误差分析里最大的两类,(b) 瞄准没见过的产线,都比”随机多采”多涨了约 0.01。同样 10 天的预算,收益多了三分之一以上。
- (b) 的天花板最低,收益却和 (d) 一样多。 看分产线的两列:2 号线的图让 2 号线从 0.778 涨到 0.835,也让 1 号线涨到 0.830,和”随机多采 1 号线”一样多;反过来,1 号线的图对 2 号线帮助很小(0.778 → 0.788)。转了 90° 的图对 1 号线来说就像免费的数据增强(缺陷的形状不分方向)。天花板告诉你最多能拿到多少,不告诉你拿到它有多容易:“没见过的情况”(覆盖缺口)通常补一点数据就好,“本来就难的样本”补很多数据也只能改善一部分(§6.4)。
- 换更大的网络(e)有一点帮助,但不如任何一种加数据的做法。high variance 的主药方是数据和正则化。
- 误差分析的价值不在于算得精确,而在于几分钟就排除掉不值得的方向(这里:先别换模型、别急着清理标签),把候选缩小到两三个,再用小实验比较。
6.4 第二轮
代码 03 演示 3 把 (b) 和 (d) 各 1500 张都加进训练集(6000 张),dev 准确率 0.849,再做一次误差分析:
| 每一类图的错误率 | 第一轮 | 第二轮 |
|---|---|---|
| 2 号线 | 0.203 | 0.155 |
| 淡缺陷(c < 0.2) | 0.372 | 0.349 |
| 正常品带灰尘 / 水渍 | 0.255 | 0.126 |
| 其余的图 | 0.126 | 0.078 |
带干扰的正常品错误率减半,淡缺陷几乎没动,尽管 (d) 里有 750 张专门挑的淡缺陷。现在淡缺陷占全部错例的 54%(第一轮 41%),标签错误占 12%(第一轮 9%)。
淡缺陷降不动,可能是因为最淡的那些本来就和灰尘、噪声分不开——接近这个输入下的不可避免误差(第 6 讲 §2.3 的 Bayes 错误率)。如果是这样,下一步该改的是输入(更好的相机、更合适的光照),而不是继续堆数据。(这只是一个猜测,代码里没有验证;验证的办法是请人在同样的图上判断这些淡缺陷,估计 human-level performance,第 10 讲。)标签错误的比例在上升:模型越好,剩下的错误里”其实是标签错了”的比例越高,到这一步清理 dev 标签才值得考虑。
这就是迭代:误差分析 → 投入最值得的方向 → 再做一次误差分析。每一轮的排序都可能变,所以不要一次规划好几个月。
6.5 实验管理
做了十几个实验之后,最常见的问题不是”模型不够好”,而是”我不记得那个好结果是怎么来的了”。代码 03 演示 4 把每次实验记成一行:名字、数据版本(训练数据的 SHA-1 指纹,前 8 位)、种子、配置、结果:
实验                    数据版本  种子  配置                              结果
baseline(1 号线 3000) 2d4f2336  0     hidden=128x64, n_train=3000       dev=0.789, line1=0.786, line2=0.797
baseline(1 号线 3000) 2d4f2336  1     hidden=128x64, n_train=3000       dev=0.799, line1=0.808, line2=0.771
(b) +1500               351cb05a  0     hidden=128x64, n_train=4500       dev=0.829, line1=0.827, line2=0.837
(e) 更大的网络          2d4f2336  0     hidden=512x256, n_train=3000      dev=0.810, line1=0.816, line2=0.792
(节选。)同一个配置换种子,dev 准确率的标准差最大是 0.006。两种做法的差别比这个小,就不能说谁更好(第 9 讲 §5:“最后一步在挑噪声”)。几条实践:
- 固定随机种子,并且把种子记下来(本讲义所有代码都这样做);
- 每个实验一个目录、一个配置文件。CS230 博客的项目示例代码(“Tips for the Final Project”那一页)就是这样组织的:
experiments/下每个实验一个目录,里面一个params.json(学习率、batch 大小、epoch 数……),训练日志、最后几个 epoch 的权重、dev 上最好的权重都存在同一个目录里;search_hyperparams.py为每组超参数建一个子目录,synthesize_results.py把所有实验汇总成一张表;test 集只在项目最后跑一次; - 数据只追加、不覆盖,文件名带版本号,或者像这里一样记下哈希(工具有 DVC、git-lfs 等);
- 结果自动写进表格(TensorBoard、Weights & Biases、MLflow),而不是靠记忆。
7. 从模型到系统 · From model to system
7.1 系统 = 模型 + 很多别的东西
上线的从来不只是一个模型。Sculley et al.(2015)那张常被引用的图里,ML 代码只是中间一个小方块,周围是数据采集、特征提取、数据校验、服务基础设施、监控……一个质检系统至少包括:相机和光照、预处理(标准化参数 μ、σ)、模型权重、阈值、前置规则、人工复检流程、监控。它们要一起版本化、一起上线:只换了模型却沿用旧的阈值,系统的行为也会变(§8.4 会看到)。
7.2 跑在哪里:端侧 vs 云端
第 5 讲 §2.6 简单比较过服务器和手机。放到本讲的两个例子里:
| 端侧(edge / on-device) | 云端(cloud / server) | |
|---|---|---|
| 延迟 | 不用上传,快;没网也能用 | 要上传数据,受网络影响 |
| 隐私 | 数据不离开设备(台灯:你家里的声音) | 数据要传出去 |
| 算力、功耗 | 很有限(台灯里的芯片要常开) | 几乎不限,模型可以很大 |
| 更新 | 要推送到每台设备 | 改服务器上的一份就行 |
| 典型选择 | 唤醒词检测;手机相册的人脸分组 | 唤醒之后的完整语音识别;大模型 |
很多产品两者结合:台灯里一个小模型常开、只负责”听到唤醒词了没有”,唤醒之后的复杂请求再交给云端。工厂产线上通常是靠近相机的一台工控机(“边缘服务器”),因为产线节拍要求每个零件在几十毫秒内出结果,而且工厂不希望生产数据离开厂区。
7.3 延迟、吞吐与前置过滤器
延迟(latency)是一个请求从进来到出结果要多久;吞吐(throughput)是每秒能处理多少个。把多个输入凑成一个 batch 能提高吞吐,但每个输入都要等 batch 凑齐,延迟变大。04_deploy_and_monitor.py --timing 在我的电脑上测了一次(数字每次运行都不同):batch 1 时每秒约 7.8 万张、每次 0.013 毫秒;batch 4096 时每秒约 1180 万张,但每个 batch 要 0.347 毫秒。产线一个零件一个零件地来,延迟更重要;离线复查一整天的图片,吞吐更重要。
Ng 在台灯例子里提到的一个系统设计是前置过滤器:设备一直在听,但绝大部分时间是安静的。先用一个便宜的、非 ML 的语音活动检测(voice activity detection,VAD)判断”有没有人在说话”,只把有声音的片段送进神经网络。代码 04 演示 2 在质检系统里做了同样的事:用 §4.2 那条规则的”最突出的一点”做过滤器,明显平静的零件直接放行,其余送进网络(网络每张图约 41,088 次乘加,规则约 1,024 次运算,粗略估计):
| 过滤器设定 | 送进网络 | 平均运算 / 件 | 召回率 | 误报率 | 代价 / 千件 |
|---|---|---|---|---|---|
| 不用过滤器 | 100.0% | 42,112 | 0.932 | 0.036 | 98.2 |
| 让验证集里 99.5% 的缺陷通过 | 48.2% | 20,837 | 0.928 | 0.030 | 97.0 |
| 让 98.0% 的缺陷通过 | 35.5% | 15,627 | 0.918 | 0.025 | 102.6 |
| 让 95.0% 的缺陷通过 | 28.6% | 12,759 | 0.899 | 0.020 | 116.0 |
(代价的定义见 §7.4。)第二行:一半多的零件不用过网络,平均计算量降到约一半,召回只从 0.932 掉到 0.928,误报还少了一点(被直接放行的零件里有一些本来会被网络误报)。但过滤器放行的零件永远不会被网络看到:过滤器漏掉的缺陷,网络再好也救不回来,所以它要设得”宁可多送、不可漏放”,它的召回率是整个系统召回率的上限。在 16×16 的小图上省这点计算没什么意义;但在一直在听的语音设备、绝大多数帧什么都没发生的监控视频里,它决定了模型能不能在芯片上跑、电池能撑多久。
7.4 阈值是一个产品决策
上线的质检系统只做一件事:放行还是拦下。所以上线的是一个二分类模型,输出 ,超过阈值 就拦下。 选多少?很多人默认 0.5。先想一想:0.5 有什么特别的吗?
把两种错误的代价写下来:漏检一个缺陷(流到客户、退货索赔)的代价 ,误报一个正常品(人工复检一次)的代价 。总代价
选让它最小的 。本讲假设 。代码 04 演示 1 在验证集(5000 个零件,产线比例,缺陷 9.7%)上扫了一遍:
| 召回率 | 误报率 | 漏检 / 千件 | 误报 / 千件 | 代价 / 千件 | |
|---|---|---|---|---|---|
| 0.5 | 0.951 | 0.069 | 4.8 | 62.6 | 110.6 |
| 0.7 | 0.951 | 0.056 | 4.8 | 50.4 | 98.4 |
| 0.9 | 0.932 | 0.036 | 6.6 | 32.8 | 98.8 |
| 0.95 | 0.918 | 0.028 | 8.0 | 25.4 | 105.4 |
| 0.99 | 0.889 | 0.018 | 10.8 | 15.8 | 123.8 |
| 0.999 | 0.844 | 0.008 | 15.2 | 7.6 | 159.6 |
细扫之后代价最小的是 (召回 0.932、误报率 0.036)。几点:
- 没有任何特别之处。 模型是在”缺陷占 2/3”的数据上训练的(故意多采了缺陷),它给出的概率偏向”缺陷”;产线上缺陷只占 10%。
- 概率不一定可信。 这个模型的输出非常极端:正常品的 中位数 0.0004,缺陷品 1.0000。有意义的阈值都挤在 0.9 以上,“误报率 ≤ 1%“要把 推到 0.9984,召回掉到 0.846。过拟合的网络常常这样”过度自信”,需要的话可以做校准(calibration,比如 temperature scaling,Guo et al. 2017)。
- 阈值是产品决策,不是模型参数。 代价比变了(客户换了、复检变便宜了), 就要重选,模型不用动。选 必须用和真实使用比例一样的数据,并且和模型、标准化参数一起保存、一起上线。台灯也一样:误唤醒和漏唤醒哪个更烦人,决定了阈值(第 5 讲 §5.4 的”固定误唤醒次数”)。
8. 部署之后:监控与维护 · Monitoring & maintenance
8.1 世界会变:数据漂移与概念漂移
模型上线的那一天,就开始”过时”了。台灯会遇到新的口音、新买的空调;产线会换相机、灯会老化、会出现新的缺陷类型、质量标准会改。按”变的是什么”,可以分成:
- 数据漂移(data drift,也叫 covariate shift):输入的分布 变了,但”什么样的 对应什么 “没变。换相机、灯变暗都是。
- 概念漂移(concept drift): 变了:同样的图,答案变了。比如质量标准改成”小污点算合格”。
- 还有一种常见的是标签漂移(label shift / prior shift): 变了,比如某批原料让缺陷率从 10% 涨到 20%。
区分它们很重要,因为能发现它们的手段不同:数据漂移不需要标签就能看出来;概念漂移只看输入是看不出来的。
8.2 监控什么
不需要标签的统计量(当天就能算):
- 输入的统计量:每张图的平均亮度、图内的标准差(对比度 + 噪声)……和上线时的参考分布比。
- 模型行为:拦下率(预测为缺陷的比例)、 的分布、平均置信度。
- 系统指标:延迟、报错率。
需要标签的(慢、贵):每天随机抽一些零件请质检员人工检验(人在回路,human-in-the-loop),用它们估计真实的召回率和误报率。
怎样衡量”分布挪了多少”?两个常用的统计量:
PSI(population stability index,群体稳定性指数):在参考数据上按分位数切 个桶,每个桶里参考数据占 (约 ),当前数据占 :
它是两个方向的 KL 散度之和,总是 ≥ 0,分布完全一样时为 0。风控行业流传的经验门槛是 < 0.1 稳定、0.1–0.25 有变化、> 0.25 显著(只是经验值)。
KS 统计量:两条经验累积分布函数之间最大的竖直距离,,在 0 到 1 之间。
但是报警门槛不该拍脑袋定:同分布的两批数据之间,PSI 也不是 0(有限样本的噪声)。正确的做法是先在”一切照旧”的数据上看每个统计量自己的波动,再决定多大的偏离算报警。
8.3 实验:监控面板
代码 04 演示 3 先在 20 个”一切照旧”的星期(每周 5000 个零件)上算出每个统计量的均值和标准差,把”偏离 4 个标准差以上”定为报警(带 !);然后模拟五种变化,各一周。抽检是每天 200 个:
| 情况 | 亮度 PSI | 标准差 PSI | 分数 KS | 拦下率 | 置信度 | 抽检误报 | 抽检召回 | 真实召回 | 真实误报 |
|---|---|---|---|---|---|---|---|---|---|
| “一切照旧” 20 周的均值 | 0.003 | 0.003 | 0.016 | 0.123 | 0.973 | 0.036 | 0.904 | ||
| 标准差 | 0.001 | 0.001 | 0.004 | 0.004 | 0.001 | 0.006 | 0.022 | ||
| 一切照旧 | 0.006 | 0.003 | 0.025 | 0.122 | 0.971 | 0.038 | 0.919 | 0.910 | 0.036 |
| 换了相机(噪声 0.02 → 0.03) | 0.002 | 4.582! | 0.397! | 0.333! | 0.928! | 0.264! | 0.926 | 0.944 | 0.265 |
| 灯变暗(亮度 −0.08) | 4.157! | 0.011! | 0.061! | 0.116 | 0.970 | 0.051 | 0.821 | 0.818 | 0.044 |
| 光照不均(左右差 0.10) | 0.006 | 5.732! | 0.425! | 0.352! | 0.925! | 0.277! | 0.937 | 0.933 | 0.288 |
| 新缺陷类型:裂纹(占缺陷一半) | 0.002 | 0.004 | 0.011 | 0.126 | 0.971 | 0.037 | 0.915 | 0.912 | 0.035 |
| 质量标准变了:小污点算合格 | 0.002 | 0.005 | 0.022 | 0.115 | 0.973 | 0.052 | 0.897 | 0.891 | 0.057 |
逐行读:
- 换相机、光照不均:误报率暴涨到 0.265、0.288,不需要标签的列几乎全亮了,当天就能发现。
- 灯变暗更隐蔽:真实召回从约 0.90 掉到 0.818,拦下率却几乎没变(0.116)——少拦了一些缺陷,又多拦了一些正常品,两边抵消了。只有输入统计量(亮度 PSI 4.16)报了警。输入监控能告诉你”有东西变了”,但不能告诉你”变好还是变坏”。抽检召回 0.821 偏离了 3.7 个标准差,还没到报警线。
- 新缺陷类型:什么都没报警,而模型对裂纹拦得还行(真实召回 0.912)。一个”正常 vs 不正常”的分类器对没见过的缺陷有一定的泛化。我原以为它会漏掉大部分裂纹;这次是运气好,没见过的东西会被拦下还是放行,事先没人知道。
- 概念漂移:图片一模一样,只是”什么算缺陷”变了。所有不需要标签的统计量都看不出来,只有抽检的标签有反应:抽检误报率 0.052(平时 0.036,偏离 2.9 个标准差)。一周 1400 个抽检还不够让它越过报警线。 靠标签的监控是唯一能发现概念漂移的手段,但它又慢又贵:抽检越多,越早发现,人工成本越高(练习 8 会把抽检加到每天 600 个)。
8.4 什么时候重训
代码 04 演示 4 模拟了上线后的 60 天:每天 1000 个零件,每天抽检 200 个(一半进”训练池”,一半进”验证池”)。第 15 天换了相机,第 31 天起灯每天暗一点。三种策略看到的产线数据完全相同:
- 从不更新;
- 每 14 天重训;
- 报警时重训:亮度 PSI 或标准差 PSI > 0.25,或者拦下率偏离上线时 0.03 以上,就重训,之后冷却 7 天。
两种主动策略的重训流程一样:用”上线时的训练集 + 训练池”训练一个候选模型 → 在最近 14 天的验证池上为它重新选 (训练数据的缺陷比例在变,旧阈值不再合适)→ 在同一批验证数据上和线上系统比,候选更好才替换。
| 策略 | 第 1–14 天(一切照旧)召回 / 误报 / 日均代价 | 第 15–30 天(新相机) | 第 31–60 天(新相机 + 灯渐暗) | 总代价 | 换模型次数 |
|---|---|---|---|---|---|
| 从不更新 | 0.904 / 0.032 / 124 | 0.948 / 0.256 / 282 | 0.915 / 0.261 / 321 | 15,889 | 0 |
| 每 14 天重训 | 0.904 / 0.032 / 124 | 0.959 / 0.301 / 312 | 0.793 / 0.047 / 251 | 14,271 | 3 |
| 报警时重训 | 0.904 / 0.032 / 124 | 0.917 / 0.169 / 237 | 0.781 / 0.043 / 259 | 13,308 | 4 |
每 14 天重训在第 14、28、42 天换了模型,第 56 天的候选没通过验证;报警重训在第 15、22、34、41 天换了模型,第 48、55 天的候选被放弃。
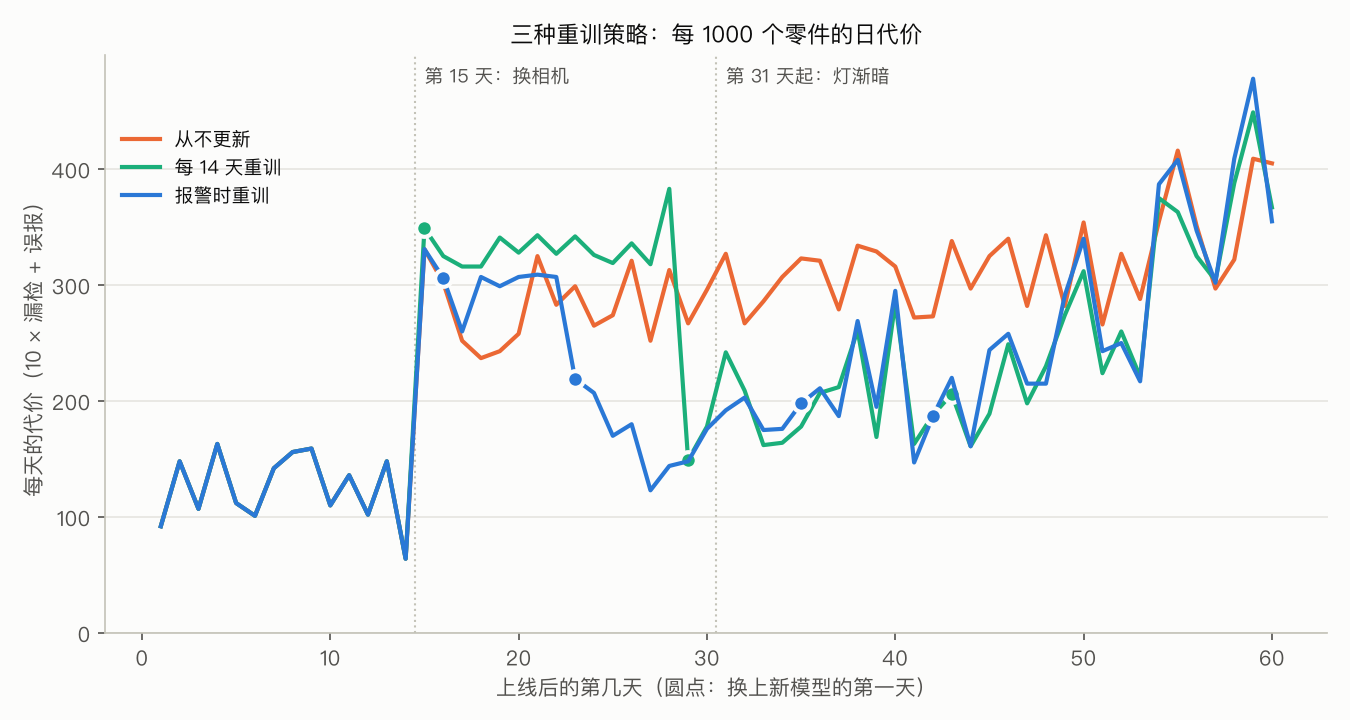
(这张图由 04_deploy_and_monitor.py 生成。前 14 天三种策略完全一样,三条线重合。)
- 从不更新:换相机后误报率从 0.032 跳到 0.256。它在第 31–60 天的召回(0.915)看起来最高,那是因为它把四分之一的正常品都拦下了——只看召回会被骗。
- 报警时重训:换相机当天就报警,第二天换上新模型,第 15–30 天日均代价 237。每 14 天重训这一段反而是 312,比从不更新(282)还高:它第 14 天那次重训发生在换相机之前,换上的新模型碰巧对新相机更敏感,下一次重训要等到第 28 天。
- 第 31–60 天灯越来越暗,缺陷越来越淡,两种重训策略的日均代价都只压到 251–259,召回掉到 0.8 左右。重训能让模型适应新数据,但补不回输入里已经丢掉的信息——该修的是灯。
- 几次候选模型没通过验证:重训不等于变好。每次都要在新鲜的、带标签的数据上和线上系统比一比再替换。
8.5 维护的几条原则
- 人在回路:重训用的数据全部来自人工抽检;抽检同时也是唯一能发现概念漂移的监控。台灯的对应物是”用户说了唤醒词却没反应、又说了一遍”这类隐式反馈。
- 定期 + 触发:定期重训简单、可预期,适合慢慢变的世界;触发式重训对突变反应快,但依赖监控统计量选得对、门槛定得好(它对概念漂移无能为力)。实践中常常两者结合。
- 安全地替换:先在验证数据上比;再”影子部署”(shadow deployment,新模型跟着跑、但不做决定)或先在一小部分流量上试(canary);出问题能一键回滚到旧版本。
- 当心反馈回路:如果只有被拦下的零件才会被人检验,你就永远看不到漏检的那些——训练数据会越来越偏。所以抽检要包括随机抽取的、被放行的零件。
9. AI + 医疗 · AI + Healthcare
2018 年的第 5 讲由 Pranav Rajpurkar(当时是 Ng 组的博士生)讲 AI 在医疗中的应用。医疗是”项目全周期”里每一步都格外难的领域:数据受隐私保护、标签要专家来给而且专家之间意见不一、一家医院训练的模型换一家医院可能就不灵了、出错的代价是病人的健康。这一节先介绍几个代表性的工作,再用一个合成的”类胸片”世界(clinic_world.py,不是真实医学影像)把三个难题做成实验。
9.1 三个代表性的工作
- CheXNet(Rajpurkar et al., 2017):在 ChestX-ray14 数据集(112,120 张正位胸片,每张最多 14 种疾病的标签,标签是用自然语言处理从放射科报告里抽出来的)上训练一个 121 层的 DenseNet,检测肺炎。测试集 420 张,由斯坦福 4 位执业放射科医生独立标注(从业 4、7、25、28 年)。评估方式:每个标注者(4 位医生和模型)把另外 4 个标注者轮流当参考答案算 F1,取平均。结果:CheXNet F1 0.435(95% CI 0.387–0.481),医生平均 0.387(0.330–0.442),差值 0.051(0.005–0.084)不包含 0。论文自己列了局限:医生和模型都只看到正位片(有些诊断需要侧位片),也都不能看病史。值得注意的是表里第 4 位医生的 F1 是 0.442,比 CheXNet 还高。
- 心电图心律失常检测(Hannun, Rajpurkar et al., Nature Medicine 2019):91,232 份单导联动态心电图(约 5.4 万名病人),12 类心律,一个直接读原始信号的深度神经网络(不手工设计特征)。测试集由多位执业心脏科医生组成的委员会共同裁决标注。平均 AUC 0.97;平均 F1 0.837,高于心脏科医生的平均 0.780。
- MURA(Rajpurkar et al., 2017):40,561 张骨骼肌肉 X 光片(14,863 个检查),判断正常 / 异常,模型是 169 层的 DenseNet。测试集的 207 个检查由 6 位放射科医生额外标注,其中 3 位的多数票作金标准,用 Cohen’s κ 比较模型和其余的医生:在手指和手腕上和最好的医生相当,在肘、前臂、手、肱骨、肩上不如最好的医生。
三篇论文的共同点:参考标准都来自医生,评估方式各不相同(轮流当参考、委员会裁决、多数票),比较的对象也不同(“医生平均”还是”最好的医生”)。读这类结论时,这些细节和结论本身一样重要。
9.2 专家标签:噪声与分歧
代码 05 演示 1:5 位”医生”读同一批 2000 张片子。每个病人有一个看不见的严重程度 , 为阳性(真相);医生 看到的是 加上自己的偏差和噪声。两两之间的 Cohen’s κ(超出偶然的一致程度,κ = 1 完全一致,0 和瞎猜一样)在 0.72–0.84 之间,5 人意见完全一致的片子 79.7%。分歧集中在哪里?
| 真实严重程度 | 片子数 | 5 人不一致的比例 | 多数票错的比例 |
|---|---|---|---|
| [0.00, 0.30) | 1018 | 3.9% | 0.0% |
| [0.30, 0.45) | 255 | 51.8% | 3.5% |
| [0.45, 0.55) | 142 | 94.4% | 27.5% |
| [0.55, 0.70) | 204 | 43.1% | 2.9% |
| [0.70, 1.00) | 381 | 3.1% | 0.0% |
分歧几乎全部落在边界病例上: 接近 0.5 的片子,94.4% 有人意见不同,连 5 人的多数票都有 27.5% 是错的。难的病例,专家也拿不准。
用谁的标签训练? 代码 05 演示 2 在 A 院 3000 人上比较了几种训练标签,测试时和真相比(只有模拟才做得到):
| 训练标签 | 病人数 | 读片次数 | 训练标签错的比例 | 测试 AUC | 测试准确率 |
|---|---|---|---|---|---|
| 真相(现实中拿不到) | 3000 | — | 0.0% | 0.983 | 0.942 |
| 3000 人 × 随机 1 位医生 | 3000 | 3000 | 7.1% | 0.970 | 0.920 |
| 3000 人 × 3 位医生多数票 | 3000 | 9000 | 2.9% | 0.981 | 0.933 |
| 3000 人 × 5 位医生多数票 | 3000 | 15000 | 3.0% | 0.980 | 0.928 |
| 1000 人 × 3 位医生多数票 | 1000 | 3000 | 3.2% | 0.960 | 0.905 |
- 用”随便一位医生”的标签训练(0.920)和用多数票训练(0.928–0.933)差得不多,离”用真相训练”(0.942)也不远:这里的标签噪声是随机的、落在边界病例上,大量样本会把它平均掉一部分。
- 同样 3000 次读片:3000 个病人各读 1 次(0.920)比 1000 个病人各读 3 次(0.905)好。这个模型还缺数据,更多的病人比更干净的标签更值钱(Sheng et al. 2008 讨论过”要不要再找一个人标”的一般规律:取决于噪声大小和数据量)。
- 但测试集反过来:宁可少一点病人,也要多位专家、仔细裁决,因为它决定你相信哪个结论。如果某位医生有系统性偏差(总把某种表现判错),平均也消不掉它。
9.3 “超过医生”怎么读
代码 05 演示 3 照 CheXNet 论文的方式评估了一次:420 张测试片,4 位医生各自读一遍;模型用 3000 个病人、每张片子随机一位医生的标签训练。每个标注者的 F1 = 把另外 4 个标注者轮流当参考答案、取平均:
| F1(CheXNet 口径) | 95% 置信区间 | F1(对真相) | |
|---|---|---|---|
| 医生 #0 | 0.881 | [0.851, 0.906] | 0.955 |
| 医生 #1 | 0.870 | [0.837, 0.896] | 0.895 |
| 医生 #2 | 0.842 | [0.804, 0.876] | 0.871 |
| 医生 #3 | 0.853 | [0.815, 0.887] | 0.896 |
| 医生平均 | 0.861 | [0.832, 0.890] | 0.904 |
| 模型 | 0.825 | [0.783, 0.863] | 0.856 |
模型 − 医生平均 = −0.037,同一批 bootstrap 样本上的 95% 置信区间 [−0.064, −0.011]。我原以为这个模型会和医生不相上下;实际上在这个口径下它比医生平均差,而且区间不包含 0。从这张表能学到读这类结论的几条规则:
- 算差值的置信区间。每个 F1 自己的区间都有 0.06–0.08 宽(420 张片子里只有 137 个阳性)。比较”模型 vs 医生”要在同一批 bootstrap 样本上算差值的区间(配对比较),而不是看两个区间重不重叠。CheXNet 论文就是这样做的。
- “比平均好”不等于”比每个人都好”。CheXNet 比医生平均高,但不比第 4 位医生高。
- 参考标准不是真相。这里和真相比,医生之间的排名也变了:按 CheXNet 口径 #1(0.870)明显高于 #3(0.853),按真相两人几乎一样(0.895 vs 0.896)。拿别人当参考答案,会”奖励”和多数人想法一样的读片者,而不一定是读得最准的。
- 看实验条件:医生能不能看病史和旧片?测试集来自几家医院?F1 依赖阈值和阳性比例。
9.4 换一家医院
Zech et al.(2018,PLOS Medicine)用 NIH、Mount Sinai、Indiana 三个医疗系统的胸片训练肺炎检测 CNN,发现 5 组自然比较里有 3 组的内部表现好于外部:比如在 Mount Sinai + NIH 上联合训练的模型,内部 AUC 0.931,到 Indiana 只有 0.815。他们还发现 CNN 能以很高的准确率认出片子来自哪个医院(NIH 99.95%、Mount Sinai 99.98%),甚至哪个科室——医院、设备、病人群体的差异,都是模型能”看到”、也可能偷偷利用的信号。
代码 05 演示 4 在合成世界里重现了这种机制。A 院(训练)和 B 院(外部测试)的扫描仪不同、阳性比例不同(34.1% vs 23.7%);而且 A 院的重症病人常用床旁便携机拍,片子左上角会有一个亮的标记——它和病情相关,却不是病本身。B 院一半的片子都有这个标记,和病情无关。
| 模型 | A 院 AUC | 灵敏度 | 特异度 | PPV | B 院 AUC | 灵敏度 | 特异度 | PPV |
|---|---|---|---|---|---|---|---|---|
| 原样训练 | 0.978 | 0.897 | 0.952 | 0.907 | 0.939 | 0.799 | 0.945 | 0.819 |
| 训练和测试都遮住左上角 | 0.967 | 0.863 | 0.940 | 0.882 | 0.958 | 0.801 | 0.971 | 0.896 |
- 原样训练:A 院内部 AUC 0.978,到 B 院掉到 0.939。PPV(判阳性的人里真阳性的比例)从 0.907 掉到 0.819,一部分是因为 B 院阳性比例更低——同一个分类器,病人群体变了,PPV 就变(练习 4)。
- 模型在看标记吗? 同一批 A 院的阴性片子,左上角加上标记,平均 从 0.038 变成 0.165。它学会了这条捷径。
- 遮住左上角重新训练:内部 AUC 从 0.978 降到 0.967,外部 AUC 从 0.939 升到 0.958。去掉捷径,内部分数变差、外部分数变好——只看内部测试集,你会选错模型。这正是 §3.3”实验室的灯”的医疗版本(Geirhos et al. 2020 把这类现象统称为 shortcut learning)。
- 遮住标记以后,一个小网络从片子本身认医院的准确率是 0.659(瞎猜 0.5):扫描仪的差别留下了一点”指纹”。在这个玩具世界里它很弱,真实胸片上要强得多(上面 Zech et al. 的数字)。
9.5 医疗项目的几条特殊要求
- 多中心、外部验证:至少在一家没参与训练的医院测试;按设备、科室、人群分组报告。
- 参考标准写清楚:谁标的、几个人、怎样裁决、能看到什么信息。
- 报告置信区间和配对比较,而不是只报一个点估计。
- 前瞻性评估:回顾性数据上的好成绩,不等于放进临床流程以后病人结局变好。
- 隐私与许可(如美国的 HIPAA)、监管审批、医生怎样使用模型的输出(辅助还是替代)——这些都会反过来影响你能拿到什么数据、能做什么题目。
10. 你的 CS230 项目 · Your CS230 project
把这一讲落到课程项目上。Fall 2025 的时间线是:项目提案(Proposal,10/14)、中期报告(Milestone,11/11)、最终视频和报告(12/7)(来自 Section 1 页面)。几条建议:
- 提案:写清楚 是什么、 是什么、数据从哪来(已经拿到了吗?)、用什么指标、和什么比(baseline、人类水平)。数据还没拿到的题目,风险最大。
- 中期报告之前:至少走完一整圈——数据 → baseline 阶梯 → 一个能训练的网络 → 一次误差分析。中期报告里最有说服力的不是一个高分,而是”我们发现了什么问题、下一步打算怎么改”。
- 最终报告和海报:问题和动机 → 数据(来源、划分、统计量)→ 方法(baseline 和你的模型)→ 实验(主结果表、消融实验、学习曲线)→ 误差分析(附几张典型的错例)→ 局限与未来工作。数字要附上种子之间的波动;test 集只用一次(CS230 示例代码的建议)。
- 用好本讲的调试清单和实验记录:项目最后两周最痛苦的,往往是”复现不出自己三周前的结果”。
11. 小结 · Summary
- 七个步骤:选题 → 数据 → 模型 → 训练 → 测试 → 部署 → 维护。它是一个循环;每一步先做一个”够用”的版本,写下出口标准。
- 选题:值不值得、做不做得到(“一个人一秒钟能做出的判断”)、数据从哪来、有没有参照。动手前写下优化指标和满足指标;类别不平衡时别用准确率(永远说”正常”就有 0.90)。
- 先快后精:采法的缺陷只有训练并放到真实环境里试才会暴露。快队第 3 天就发现了(召回 0.073),慢队第 41 天(6000 张也只有 0.110),到第 60 天快队 0.958 vs 慢队 0.919。用”笨模型”和反事实检查找捷径(同一个零件换个灯, 0.979 → 0.082)。学习曲线要边采边重估(早期外推差了几十倍)。
- 第一个系统:先复现现成代码(Section 3 的仓库清单);baseline 阶梯:多数类 → 规则(0.884)→ softmax 回归(0.660)→ MLP(3000 张时 0.847,要到 4800–9600 张才超过规则);先在小数据上过拟合。
- 调试:四类错误(语法 / 逻辑 / 算法 / 实验)。清单 A–G 每项几秒钟;9 个 bug 抓住了 8 个,剩下的 softmax 回归本来就不是 bug(能背下 32 张、拟合不好整个训练集 = 方法不够)。打乱标签是唯一能抓住”在训练集上评估”(汇报 0.967)的检查;BatchNorm 会让”初始损失”对忘了归一化失明。
- 迭代:误差分析数出最大的一类(淡缺陷 41%,不是我预想的 2 号线);同样 1500 张,有针对性的两种做法(+0.040、+0.039)比随机多采(+0.028)好,换大网络只有 +0.020。天花板说”最多多少”,不说”有多容易”。记下数据版本、种子和配置;种子波动 0.006 以内的差别不算数。
- 系统:阈值是产品决策(代价最小的 ,不是 0.5);前置过滤器(VAD 的同类)省一半计算、召回只掉 0.004,但它的召回是系统的上限;端侧 vs 云端看延迟、隐私、算力、更新。
- 监控:数据漂移不用标签就能发现,当天报警;灯变暗时拦下率不变、召回却掉了;概念漂移只有抽检的标签能发现,而且慢。重训策略:报警重训总代价 13,308 < 定期 14,271 < 从不更新 15,889;重训前要验证,重训补不回输入里丢掉的信息。
- 医疗:专家之间 κ 0.72–0.84,分歧集中在边界病例;训练时更多病人 > 更干净的标签,测试时反过来;“超过医生”要看参考标准、差值的置信区间、比的是平均还是最好的;去掉捷径,内部分数降、外部分数升;必须做外部验证。
12. 常见误区 · Common pitfalls
- “先把数据采够再开始。” 采法的问题只有训练、试点之后才暴露;6000 张有缺陷的数据和 300 张一样没用(代码 01 演示 2)。
- “dev 上很好,就可以上线了。” dev 和训练用同一种采法时,会带着同一个偏差(dev 召回 0.976,试点 0.080)。dev 要来自真实使用的分布,上线前要在真实环境里试点。
- “第一个模型就该用最新的网络。” 先建 baseline 阶梯。一条两个参数的规则在 3000 张图时比 MLP 还好。
- “损失在下降,所以代码没问题。” 9 个 bug 里有好几个损失照样下降、最终准确率”说得过去”。跑一遍检查清单。
- “结果比预期好,太好了。” 好得不真实的结果(在训练集上评估:0.967)要先怀疑。打乱标签测试能抓住它。
- “更多数据总是对的,随便采就行。” 先做误差分析:同样 10 天,采对地方的收益多三分之一以上。
- “模型输出 0.5 以上就是缺陷。” 阈值要按两种错误的代价、在真实比例的数据上选;训练数据的类别比例会让概率整体偏移。
- “上线之后看看拦下率就够了。” 灯变暗时拦下率几乎不变,召回却从 0.90 掉到 0.818;概念漂移只有人工抽检才看得出来。
- “重训一定会让模型变好。” 候选模型要在新鲜的带标签数据上和线上系统比;有几次重训的候选就没通过。
- “模型的 F1 超过了医生平均,所以它比医生强。” 要看参考标准怎么定的、差值的置信区间、是平均还是最好的医生、能不能推广到别的医院。
13. 练习 · Exercises
练习 1(初始损失与”地板”)。(a) 10 类分类问题,随机初始化时交叉熵大约是多少?(b) 如果模型最后已经做了 softmax,又交给 CrossEntropyLoss(再做一次 softmax),在一个样本上完美预测(输入的”概率”是 one-hot)时,损失最低是多少?分别算 和 。(c) 代码 02 里正确代码的初始损失是 1.111,BatchNorm 版是 1.299,为什么都比 略大?
参考答案
(a) 。
(b) 第二次 softmax 的输入是 one-hot 向量 ,输出正确类的概率是 ,损失 。:(代码 02 实测 0.5517);:。类别越多,地板越高。
(c) 是 logits 全部为 0 时的值。随机初始化的 logits 有一点随机的大小,各类不完全相等,交叉熵就会比 略大,logits 越分散,偏得越多。我在代码 02 里加了一行打印初始 logits 的标准差:dropout 版约 0.15,BN 版约 0.61。BN 把隐藏层的输出标准化成方差约 1,送进最后一层的数更大,logits 也就更分散。Karpathy 的建议是把最后一层初始化得很小,让初始损失非常接近 ,这样真正的偏离更容易看出来。
练习 2(手算 PSI)。参考数据按四分位数切成 4 个桶,每桶 25%;本周的数据落在四个桶里的比例是 10%、20%、30%、40%。(a) 算 PSI。(b) 按”> 0.25 显著”的经验门槛,要不要报警?(c) 代码 04 演示 3 的监控面板为什么不用 0.25,而用”偏离一切照旧的均值 4 个标准差”当报警线?演示 4 为了简单用了 0.25,什么情况下这样做没问题?
参考答案
(a) 。
(b) 0.228 < 0.25,按经验门槛不报警,但已经在”有变化”的区间里。
(c) PSI 本身有抽样噪声,门槛应该相对于”一切照旧”时的波动来定,而且每个统计量的噪声大小不同(演示 3 里抽检误报率这种只有一千多个样本的量,噪声比 PSI 大得多),用同一个”偏离几个标准差”的规则可以一视同仁。演示 3 里同分布的一周(5000 个零件)亮度 PSI 是 0.003 左右;演示 4 每天只有 1000 个,噪声大一些(同分布时 PSI 的期望大约是 ,这里约 0.01),但仍然远小于 0.25,而真正的漂移(换相机后标准差 PSI 4.582)又大了两个多数量级,0.25 落在中间很宽的空白里,用它没问题。如果样本很少(比如每天只有几十个),同分布的两批数据之间 PSI 也可能超过 0.25,那时就会频繁误报。
练习 3(阈值与代价比)。用 §7.4 的表(每千件的漏检和误报个数)回答:(a) 如果漏检的代价是误报的 50 倍,表里六个 中哪个最好?(b) 先预测:在 0.01–0.999 上细扫,最优 会更大还是更小?误报率大约多少?然后把 04_deploy_and_monitor.py 里的 COST_MISS 改成 50 运行验证。
参考答案
(a) 代价 = 50 × 漏检 + 误报::;0.7:;0.9:362.8;0.95:425.4;0.99:;0.999:。表里最好的是 0.7。
(b) 会更小:漏检越贵,越要”宁可错拦”。我实际运行的结果是 ,召回 0.990,误报率 0.212,代价 241.0 / 千件——每 5 个正常品就拦下 1 个。这时你可能会回头质疑那个 50 倍的假设,或者加一个满足指标(误报率 ≤ 5%),在满足它的阈值里选召回最高的。这正是 optimizing vs satisficing(第 10 讲)。
练习 4(PPV 和阳性比例)。一个模型的灵敏度 0.9、特异度 0.95,不随医院改变。(a) 在阳性比例 34% 的医院,PPV 是多少?(b) 23.7% 呢?(c) 5% 呢?(d) 这和代码 05 演示 4 的 PPV 从 0.907 掉到 0.819 有什么关系?
参考答案
。
(a) 。(b) 。(c) :阳性很少时,判阳性的人里一半以上是假阳性。
(d) A 院阳性 34.1%、B 院 23.7%,单是阳性比例的变化就会让 PPV 从约 0.90 降到约 0.85;演示 4 里 B 院的 PPV(0.819)掉得更多,是因为灵敏度也从 0.897 掉到了 0.799(扫描仪和捷径的影响)。所以报告医疗模型的 PPV 时,一定要同时报告人群的阳性比例。
练习 5(学习曲线的局部斜率)。用 §3.4 的表:(a) 只用 1200 和 2400 两个点算幂律指数 ()。(b) 用它从 2400 外推到 9600,和实际的 0.081 比。(c) 为什么它比”用前 4 个点拟合”准得多?这对边采边估计有什么启示?
参考答案
(a) 。
(b) 9600 是 2400 的 4 倍:,实际 0.081,非常接近。
(c) 前 4 个点里有 3 个落在”起步阶段”(150–600 张几乎是平的),把直线拉得很平。用最近的、已经进入稳定下降段的两三个点估计局部斜率,外推近一些的距离(一两倍到四倍),通常更可靠。但越往后,曲线会因为接近不可避免误差而变平,局部斜率又会偏乐观。所以每多采一批,就用最新的几个点重估一次。
练习 6(改代码,先预测再运行:去掉亮度捷径)。在代码 01 演示 3 里,把训练和试点的图片都减去每张图自己的平均亮度(X - X.mean(axis=(1, 2), keepdims=True))再训练。先预测:试点上的缺陷召回率会从 0.080 变成多少?dev 上的表现会变好还是变差?然后运行验证。
参考答案
我实际运行的结果:试点召回率从 0.080 升到 0.700,但误报率从 0.047 涨到 0.402;自己 dev 上的三类准确率从 0.817 降到 0.583。
解释:减去每张图的平均亮度,把”整体更亮”这条捷径基本拿掉了,模型只好去看缺陷本身,所以试点上能拦下大部分缺陷。但 240 张图太少,模型学不好形状,误报很多;dev 变差是因为 dev 上那条捷径本来是”有效”的——去掉捷径,同分布的分数下降、换分布的分数上升,和代码 05 演示 4 遮住标记是同一个现象。另外,亮度差还通过另一条路影响缺陷:这个世界里缺陷的幅度和底色亮度成正比,实验室拍的缺陷”更明显”,减均值去不掉这种差别。真正的修复仍然是在产线工位上重新采。
练习 7(调试清单)。下面三种情况,各最可能是四类错误中的哪一类?清单里哪一项最先报警?(a) 32 张图训练 300 步后损失停在 0.69 附近(二分类),换小 10 倍的学习率也一样。(b) 32 张图能背下来,完整训练后训练集准确率 0.75、dev 0.74。(c) dev 准确率 0.99,远好于论文报告的 0.85;打乱训练标签后 dev 准确率仍有 0.80。
参考答案
(a) 逻辑错误的可能性最大(D 项报警):连 32 张图都背不下来,而且和学习率无关,说明梯度传不到参数、标签和输入没对上、损失写错了等。0.69 ≈ ln 2,正是二分类”什么都没学到”时的损失。先查 B(看送进网络的数据和标签),再查损失函数和 zero_grad / step 有没有调用。
(b) 算法错误(或者说 high bias):代码能背下 32 张图,说明流水线本身是通的;训练集都拟合不好,是模型能力不够(或者特征不够),对应第 6 讲的 basic recipe:更大的网络、训练更久、换架构。
(c) 逻辑错误,而且是”评估写错了”或”数据泄露”那一类(E 项报警):打乱的标签和输入没有关系,dev 准确率不可能远高于瞎猜。检查评估时用的是不是 dev 数据、dev 和训练集之间有没有重复样本、特征里有没有”偷偷带着标签”的东西。
练习 8(改代码:抽检的数量)。把 04_deploy_and_monitor.py 里的 AUDIT_PER_DAY 从 200 改成 600。先预测:演示 3 里”质量标准变了”那一行,抽检误报率会不会越过报警线?“灯变暗”的抽检召回呢?然后运行验证。代价是什么?
参考答案
我实际运行的结果:每天 600 个抽检时,“一切照旧”周之间抽检误报率的标准差从 0.006 降到 0.003,抽检召回的从 0.022 降到 0.015。“质量标准变了”那一行抽检误报率 0.058(偏离 8.5 个标准差)报警了;“灯变暗”的抽检召回 0.831(偏离 5.3 个标准差)也报警了。
抽检量增加 3 倍,标准差约缩小 倍,所以更小的变化也能被发现。代价是人工:每天多检 400 个零件。也可以不加人,而是把窗口拉长(两周的抽检合在一起),代价是发现得更晚。
练习 9(分类漂移)。下面每种情况是数据漂移、概念漂移还是标签漂移?哪些能被不需要标签的监控发现?(a) 台灯卖到了一个新的国家,用户的口音不同。(b) 产品改名,唤醒词从一个词换成了另一个词。(c) 一批新原料让缺陷率从 10% 涨到 20%,缺陷的样子没变。(d) 胸片检测模型部署到一家新医院,那里的病人更年轻、病情更轻。
参考答案
(a) 数据漂移: 变了(声音的分布),“说没说唤醒词”的含义没变。输入统计量可能看出来,也可能看不出来(口音的差别不一定反映在简单统计量上),最可靠的信号是用户行为(重复唤醒)。
(b) 概念漂移:同样的声音,答案变了(旧唤醒词不该再唤醒)。只看输入看不出来;实际上这种情况你自己知道,应该直接重新采数据、重训。
(c) 标签漂移( 变了, 不变):拦下率会明显上升,不需要标签就能看到;模型本身可能还是对的,但最优阈值和 PPV 会变。
(d) 数据漂移和标签漂移都有:人群变了(),阳性比例也变了();如果新医院的诊断标准也不同,还会有概念漂移。这就是为什么医疗模型要做外部验证(§9.4)。
练习 10(设计题:台灯的系统)。为语音台灯设计一个上线方案:(a) 模型放在设备上还是云端?(b) 用不用前置过滤器?它的设定原则是什么?(c) 选一个优化指标和两个满足指标。(d) 上线后监控什么?怎样拿到标签?
参考答案
参考思路(没有唯一答案):(a) 唤醒词检测放在设备上:要常开、低延迟、声音不离开家(隐私);唤醒后的复杂指令可以交给云端。(b) 用:一个便宜的 VAD 常开,只在有声音时启动网络,省电;设定原则是”宁可多送、不可漏放”,它的召回是系统召回的上限(§7.3)。(c) 优化:唤醒召回率;满足:每 24 小时误唤醒 ≤ 1 次、唤醒延迟 ≤ 几百毫秒(还可以加:在设备的内存和功耗预算以内)。(d) 监控输入的能量分布、唤醒率(每天被唤醒几次)、唤醒后用户是否马上取消(误唤醒的信号)、用户是否连说两遍(漏唤醒的信号)。标签可以来自这些隐式反馈,加上征得用户同意后的少量抽样人工标注。
14. 延伸阅读 · Further reading
课程材料
- CS230 Autumn 2018 Lecture 3 “Full-Cycle Deep Learning Projects”、Lecture 5 “AI + Healthcare”、Lecture 6 “Deep Learning Project Strategy”(YouTube,Stanford Online 频道)。
- CS230 Fall 2025 Section 1 / 3 / 7(https://cs230.stanford.edu/section/1 、/section/3 、/section/7 );CS230 博客 “Tips for the Final Project”(https://cs230.stanford.edu/blog/tips ,项目代码示例的组织方式)。
- Andrew Ng, Machine Learning Yearning(免费电子书):误差分析、“先快速搭一个系统再迭代”、dev / test 的设置。
- Andrew Ng (2016). What Artificial Intelligence Can and Can’t Do Right Now. Harvard Business Review。
工程实践
- Karpathy (2019). A Recipe for Training Neural Networks(博客):调试清单的来源之一。
- Zinkevich. Rules of Machine Learning: Best Practices for ML Engineering(Google)。
- Sculley et al. (2015). Hidden Technical Debt in Machine Learning Systems. NeurIPS。
- Breck et al. (2017). The ML Test Score: A Rubric for ML Production Readiness and Technical Debt Reduction. IEEE Big Data。
- Chip Huyen (2022). Designing Machine Learning Systems. O’Reilly:部署、监控、数据漂移的系统性讲解。
- Zhang et al. (2017). Understanding deep learning requires rethinking generalization. ICLR:网络能记住随机标签。
- Guo et al. (2017). On Calibration of Modern Neural Networks. ICML:temperature scaling。
数据漂移与捷径
- Gama et al. (2014). A survey on concept drift adaptation. ACM Computing Surveys。
- Rabanser, Günnemann & Lipton (2019). Failing Loudly: An Empirical Study of Methods for Detecting Dataset Shift. NeurIPS。
- Geirhos et al. (2020). Shortcut learning in deep neural networks. Nature Machine Intelligence。
标签噪声
- Sheng, Provost & Ipeirotis (2008). Get another label? Improving data quality and data mining using multiple, noisy labelers. KDD。
- Northcutt, Athalye & Mueller (2021). Pervasive label errors in test sets destabilize machine learning benchmarks. NeurIPS Datasets and Benchmarks。
AI + 医疗
- Rajpurkar et al. (2017). CheXNet: Radiologist-Level Pneumonia Detection on Chest X-Rays with Deep Learning. arXiv:1711.05225。
- Hannun, Rajpurkar et al. (2019). Cardiologist-level arrhythmia detection and classification in ambulatory electrocardiograms using a deep neural network. Nature Medicine 25。
- Rajpurkar et al. (2017). MURA: Large Dataset for Abnormality Detection in Musculoskeletal Radiographs. arXiv:1712.06957。
- Irvin et al. (2019). CheXpert: A Large Chest Radiograph Dataset with Uncertainty Labels and Expert Comparison. AAAI。
- Zech et al. (2018). Variable generalization performance of a deep learning model to detect pneumonia in chest radiographs: A cross-sectional study. PLOS Medicine。
- Wang et al. (2017). ChestX-ray8: Hospital-scale chest X-ray database and benchmarks… CVPR(ChestX-ray14 的来源)。
15. 下一讲预告 · Next lecture
第 12 讲:卷积神经网络基础。 这一讲的迷你项目一直在用全连接网络,它有一个明显的弱点:缺陷可以出现在图上的任何位置,全连接网络要在每个位置上分别学会”划痕长什么样”,所以要几千张图才能超过一条两个参数的规则。第 12 讲会讲:
- 为什么全连接网络处理图像会”参数爆炸”、而且没有平移不变性;
- 卷积:一个小的、共享权重的特征检测器在整张图上滑动——用 numpy 从零实现,再和 PyTorch 对照;
- padding、stride、多通道、池化,以及输出尺寸的公式;
- 在”平移的图案”任务上比较 MLP 和 CNN 的参数量与泛化。
学完之后,你可以回头用一个小 CNN 重做本讲的质检项目,看看学习曲线会往左移多少。