对应 Maps to:Coursera Deep Learning Specialization C3 “Structuring Machine Learning Projects” 的全部两个模块——C3M1 “ML Strategy”(Why ML Strategy、Orthogonalization、Single Number Evaluation Metric、Satisficing and Optimizing Metric、Train/Dev/Test Distributions、Size of the Dev and Test Sets、When to Change Dev/Test Sets and Metrics、Why Human-level Performance?、Avoidable Bias、Understanding Human-level Performance、Surpassing Human-level Performance、Improving your Model Performance)和 C3M2 “ML Strategy 2”(Carrying Out Error Analysis、Cleaning Up Incorrectly Labeled Data、Build your First System Quickly then Iterate、Training and Testing on Different Distributions、Bias and Variance with Mismatched Data Distributions、Addressing Data Mismatch、Transfer Learning、Multi-task Learning、What is End-to-end Deep Learning?、Whether to use End-to-end Deep Learning);两个案例测验 “Bird Recognition in the City of Peacetopia” 和 “Autonomous Driving”;CS230 Fall 2025 Section 8 “Advanced Evaluation Metrics”;Andrew Ng 的免费书 Machine Learning Yearning。在 Fall 2025 的安排里,C3M1、C3M2 在第 5 周(和课堂 Lecture 5 同一周)。 依据说明:Coursera 的视频和案例测验只对注册学员开放。本讲依据 Andrew Ng 在 C3 里广为人知的内容来写(例子里的数字,如”普通人 3%、医生小组 0.5%”、“200,000 张网络图片 + 10,000 张手机照片”,都是视频里的经典例子);视频里的具体措辞是凭记忆复述的,细节可能和原视频略有出入。两个案例测验的题面不公开,§12 按它们考察的决策点改编,数字是我设定的。Section 8 依据公开网页(https://cs230.stanford.edu/section/8)。*Machine Learning Yearning* 是 C3 的展开版,本讲引用它时只写章节的标题。 配套代码 Code:
code/lecture10/(PyTorch + numpy;共享模块strategy_tools.py+ 5 个脚本:01 约 5 秒、02 约 4 秒、03 约 32 秒、04 约 17 秒、05 约 30 秒) 预计阅读时间:3–3.5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 用正交化(orthogonalization)的眼光看一个项目:知道”训练集 → dev → test → 真实世界”四个目标各有哪些旋钮,为什么一个旋钮最好只管一件事,为什么 early stopping 不正交。
- 为项目设定单一数字评估指标:会算 precision / recall / F1 / AP,知道类别不平衡时准确率为什么会骗人、阈值为什么也是要在 dev 上调的超参数;会用 satisficing + optimizing 处理多个指标;知道什么时候该改指标或改 dev / test 集。
- 用人类水平(human-level performance)估计 Bayes 错误率,算出可避免偏差(avoidable bias)和方差,知道”选哪个人类水平”什么时候会改变结论,以及超过人类水平之后为什么进展变慢。
- 做一次误差分析(error analysis):随机拿约 100 个 dev 错例逐个归类、算每一类的天花板,并知道天花板不等于能拿到的收益;知道训练集和 dev / test 里的错误标签各该怎样处理。
- 在训练分布和 dev / test 分布不同时正确地划分数据,用 train-dev set 把误差拆成可避免偏差、方差、数据不匹配、对 dev 过拟合四部分,并知道怎样处理数据不匹配、人工合成数据有什么风险。
- 判断迁移学习(transfer learning)、多任务学习(multi-task learning)、端到端学习(end-to-end learning)各在什么条件下有用——以及在什么条件下没用(本讲的实验里有几个”没用”的例子)。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给原则,后面几讲再展开 Previewed only |
|---|---|
| 第 6 讲:train / dev / test 的作用与大小、dev 和 test 同分布、赢家的诅咒、四象限的 bias / variance 诊断、basic recipe、early stopping | 一个完整项目从选题到部署的全过程、调试清单、部署后的监控与数据漂移(第 11 讲,会在一个完整项目里用本讲的方法) |
| 第 5 讲:触发词检测里”准确率会误导”、唤醒召回率与每小时误唤醒;“人类代理”;triplet 编码 | CNN 上的迁移学习:冻结哪些层、用多大的学习率、数据增强(第 13 讲) |
| 第 3 讲:Bayes 最优分类器;第 1 讲 §2.1:误差下限 | 目标检测里的 mAP、IoU(第 14 讲);NLP 的 BLEU、困惑度(第 16–17 讲) |
第 9 讲:PyTorch、torch_utils 训练模板、超参数搜索 | 把误差分析用到 LLM 应用上(第 20 讲) |
第 6 讲回答的是”模型有没有过拟合、该怎么正则化”;本讲往上走一层,回答”整个项目下一步该做什么”。前者是技术,后者是 Ng 所说的策略(strategy)——他认为这是很多团队最缺、也最能拉开差距的东西:方向选错,几个月的工作可能毫无收益。
0.3 本讲地图 Map
§1  为什么需要策略;正交化:四个目标、各自的旋钮;early stopping 为什么不正交
§2  单一数字评估指标:precision / recall / F1、多地区取平均、阈值与 PR 曲线、F1 为什么不能当损失  ← 代码 01 演示 1、2
§3  satisficing vs optimizing:时延、误报                                                     ← 代码 01 演示 3
§4  dev / test 集:分布、大小;什么时候改指标(给不良图片加权)、什么时候改 dev / test          ← 代码 01 演示 4
§5  和人类水平比较:Bayes 错误率、可避免偏差、选哪个人类水平、超过人类之后                       ← 代码 03 演示 1
§6  误差分析:数 100 个错例、表格、天花板、100 个够不够、天花板 ≠ 收益;先做出第一个系统        ← 代码 02 演示 1
§7  错误的标签:训练集里随机 vs 系统性;dev / test 要不要清理、怎样清理                        ← 代码 02 演示 2、3
§8  训练和测试分布不同:怎样划分、train-dev 与五个误差、处理数据不匹配、人工合成数据的风险       ← 代码 03 演示 2–4
§9  迁移学习                                                                                  ← 代码 04 演示 1
§10 多任务学习                                                                                ← 代码 04 演示 2
§11 端到端学习                                                                                ← 代码 05
§12 两个案例:Peacetopia 的鸟、自动驾驶(改编)
§13–17 小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
本讲的代码和第 9 讲一样每一行一个样本: 的形状是 ,二分类的标签和预测是 的 0/1 数组,多任务的标签是 。
| 符号 | 含义 | 代码里 |
|---|---|---|
| TP / FP / FN / TN | 真阳性 / 假阳性(误报)/ 假阴性(漏报)/ 真阴性 | confusion_counts |
| , | precision(精确率)、recall(召回率) | precision_recall_f1 |
| F1 分数:、 的调和平均 | 同上 | |
| FPR | 误报率(false positive rate):负例里被判成正例的比例 | at_threshold(...)["fpr"] |
| AP | average precision:PR 曲线下的面积 | average_precision |
| 样本权重(加权错误率、加权损失) | weighted_error、train_net(W=...) | |
| train-dev set | 和训练集同分布、但不参与训练的一小份数据 | 代码 03 |
| avoidable bias | 可避免偏差 = 训练误差 − 人类水平(Bayes 错误率的代理) | diagnose |
| data mismatch | 数据不匹配 = dev 误差 − train-dev 误差 | diagnose |
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出(固定随机种子;每个演示用自己的随机数生成器;同一台机器上重复运行逐字相同;本讲没有计时类的数字——代码 01 里的”时延”是由乘加次数换算的)。数据全是合成的,而且每个世界都是为了让某个现象看得清楚而设计的:Bayes 错误率已知、每张”图片”是什么都记录在案,这样”人工看 100 个错例”、“人类水平”、“数据不匹配”才能用代码模拟并核对。所以数字只说明机制,交叉点、比例在真实任务里都会不同。好几个结果和我写代码前的预想不一样——最明显的是多任务学习在这里几乎没有收益、只用 1 份素材合成的数据比不合成还差——讲义按实际结果来写,这些情况列在代码 README 的”关于实验结果”里。
1. 为什么需要机器学习策略 · Why ML strategy? Orthogonalization
1.1 一个 90% 的猫分类器,十个想法
Ng 在 C3 一开头描述了一个很常见的局面:你的猫分类器准确率 90%,不够好。团队里冒出一串想法——
- 多收集数据;收集更多样的训练数据(不同姿势的猫、不同的负样本);
- 梯度下降训练得更久;换成 Adam;
- 更大的网络;更小的网络;
- 加 dropout;加 L2 正则化;
- 改网络结构(激活函数、隐藏单元数……)。
每一个都”可能有用”,而每一个都可能花掉几周甚至几个月。Ng 讲过一个真实的教训:有团队花了六个月收集更多数据,最后发现几乎没有改善。机器学习策略要回答的就是:在这一串想法里,哪几个最可能有效?哪几个可以放心地丢掉? 本讲给的不是灵感,而是一套可以照着做的诊断流程。
1.2 正交化:一个旋钮只管一件事
Ng 用两个比喻讲正交化(orthogonalization):
- 老式电视机背后有一排旋钮:一个调高度、一个调宽度、一个调梯形、一个调左右位置。每个旋钮只管一件事,所以你很容易把画面调正。如果有一个旋钮同时改变 0.3 × 高度 + 0.8 × 宽度 − 1.2 × 梯形,几乎不可能调好。
- 汽车有方向盘、油门、刹车:方向盘只管方向,油门和刹车只管速度。如果有一根操纵杆同时改变方向和速度,车就很难开。
“正交”是线性代数里的词:两个方向互相垂直,沿一个方向走不会改变另一个方向上的坐标。对机器学习的意思是:给每个问题准备一组只影响它的旋钮,诊断出是哪个问题,就去拧哪组旋钮,不会顾此失彼。
1.3 四个目标,四组旋钮
一个监督学习系统要做好,Ng 认为通常要依次满足四件事(像一条链,前一环不满足,后面的就谈不上):
| 目标 | 做不到时的旋钮 | 本讲义的位置 |
|---|---|---|
| ① 在训练集上把代价函数拟合好(对很多任务来说,要接近人类水平) | 更大的网络;更好的优化算法(Adam 等);更久的训练;换架构 | 第 3–4、8 讲;本讲 §5 |
| ② 在 dev 集上也好 | 正则化(L2、dropout、数据增强);更大的训练集;换架构 | 第 6 讲 |
| ③ 在 test 集上也好 | 更大的 dev 集(在 dev 上挑过头了,第 6 讲 §1.5) | 本讲 §8.2 |
| ④ 在真实世界里也好(用户满意) | 改 dev 集,或者改代价函数 / 评估指标 | 本讲 §4、§8 |
用法很简单:看到哪一环出了问题,就只去拧那一环的旋钮。 训练集上就不好(①),加正则化、收集更多数据都是白费;dev 上好、test 上差(③),说明在 dev 上挑过头了,改网络结构也不对症;test 上好、用户不满意(④),说明 dev / test 集或者指标本身没有反映你真正关心的东西——这时改模型是在错误的靶子上越打越准。
1.4 为什么 early stopping 不正交
第 6 讲 §6.3 已经讨论过:early stopping 用同一个旋钮(迭代次数)同时影响①和②——停得早,训练集拟合得不够(伤①),dev 上的过拟合少了(帮②)。你没法单独改进其中一件。所以 Ng 说他更倾向于 L2 这种”正交”的工具:把 优化到底(只管①),再单独调 (只管②)。这不是说 early stopping 不能用(它便宜,很多人用),而是说它让诊断变得更难。
1.5 本讲的思路
把正交化放在最前面,是因为本讲后面的每一节都是在回答”该拧哪个旋钮”:
先有一把尺子           §2–§4  单一数字指标;satisficing / optimizing;dev / test 怎么设、什么时候改
再有一个参照物         §5     人类水平 ≈ Bayes 错误率 → 可避免偏差 vs 方差
看清楚错在哪里         §6–§7  误差分析;错误标签
分布不同时多一个诊断   §8     train-dev set → 数据不匹配
借别人的数据和结构     §9–§11 迁移学习、多任务学习、端到端学习
2. 单一数字评估指标 · Single number evaluation metric
2.1 为什么只要一个数
第 1 讲 §4.5 说过:深度学习是 Idea → Code → Experiment 的循环,转得越快进步越快。每转一圈,你都要回答”这个想法比上一个好吗?“。如果你看的是两个数,答案经常是”一个好、一个差”,于是团队开始争论。Ng 的建议是:项目一开始就定下一个单一数字评估指标(single-number evaluation metric),在一个 dev 集上,用它来比较一切。Machine Learning Yearning 的说法是:单一数字的指标能加快你做决定的速度(CS230 Section 8 也引用了这句话)。
2.2 precision、recall 与 F1
先看 CS230 Section 8(公开网页)的例子:10 个病人里 9 个健康、1 个肺炎(最后一个),三个模型的预测。代码 01 演示 1:
| 模型 | 预测 | 准确率 | precision | recall | F1 |
|---|---|---|---|---|---|
| 模型 1(全判健康) | 0 0 0 0 0 0 0 0 0 0 | 0.90 | —(0/0) | 0.000 | 0.000 |
| 模型 2 | 1 1 0 0 0 0 0 0 0 1 | 0.80 | 0.333 | 1.000 | 0.500 |
| 模型 3 | 1 1 1 1 1 0 0 0 0 1 | 0.50 | 0.167 | 1.000 | 0.286 |
准确率最高的是模型 1——它把所有人都判成健康,一个病人都没找到。**类别不平衡时,准确率会把最没用的模型排第一。**这正是第 5 讲触发词检测里的那个警报(“永远输出 0”的逐帧准确率 98.46%)。要看的是另外两个数:
它们是两个数。Ng 的例子:分类器 A 的 precision 95%、recall 90%;B 的 precision 98%、recall 85%。谁好?各赢一个,没法决定。解决办法是把两者合成一个数,F1 分数:
它是 和 的调和平均(harmonic mean)。为什么不用算术平均?先想一想:一个模型 precision 1.00、recall 0.01(只在最有把握的一个病人身上喊了一次),算术平均是多少?
| 分类器 | precision | recall | 算术平均 | F1 |
|---|---|---|---|---|
| A | 0.95 | 0.90 | 0.9250 | 0.9243 |
| B | 0.98 | 0.85 | 0.9150 | 0.9104 |
| C(极端) | 1.00 | 0.01 | 0.5050 | 0.0198 |
算术平均给 C 0.505,看起来”还行”;F1 只有 0.020。调和平均被小的那个数拖住,要两个都好才高。最后一个写法 还有一个好处:模型 1 的 precision 是 0/0、没有定义,F1 仍然能算出 0。
2.3 多个数时取平均
另一种常见的”多个数”:猫 app 在几个地区的错误率。代码 01 演示 1 (c)(Ng 视频里的一个例子):
| 算法 | 美国 | 中国 | 印度 | 其他 | 平均 |
|---|---|---|---|---|---|
| A | 3% | 7% | 5% | 9% | 6.0% |
| B | 5% | 6% | 5% | 10% | 6.5% |
| C | 2% | 3% | 4% | 5% | 3.5% |
四列数字要看半天;平均值一眼就告诉你 C 最好。如果各地区的用户数差别很大,就用按用户数加权的平均——关键是事先定好一个公式,而不是每次比较时临时争论。
2.4 同一个模型,不同的阈值
precision 和 recall 不只是模型的属性,还取决于阈值:输出概率 ≥ 阈值就判阳性。代码 01 演示 2 造了一个”疾病筛查”任务:20 个化验指标,患病由一个随机的非线性规则决定,患病率 dev 上 4.35%(训练 20,000、dev 10,000、test 10,000)。训练一个 [20, 64, 64, 1] 的网络,然后只改阈值:
| 阈值 | 判阳性比例 | 准确率 | precision | recall | F1 |
|---|---|---|---|---|---|
| 0.9 | 0.30% | 95.91% | 0.933 | 0.064 | 0.120 |
| 0.7 | 0.94% | 96.29% | 0.840 | 0.182 | 0.299 |
| 0.5 | 1.83% | 96.42% | 0.710 | 0.299 | 0.421 |
| 0.3 | 3.36% | 96.05% | 0.560 | 0.432 | 0.488 |
| 0.2 | 4.75% | 95.42% | 0.476 | 0.520 | 0.497 |
| 0.1 | 7.59% | 93.70% | 0.372 | 0.648 | 0.472 |
| 0.05 | 10.82% | 91.29% | 0.299 | 0.743 | 0.426 |
(「永远判健康」的准确率:95.65%。)
- 准确率几乎不提供信息:阈值 0.5 时 96.42%,只比”永远判健康”高 0.8 个百分点,而它只找到了 29.9% 的病人。dev 上准确率最高的阈值是 0.59(96.49%)——那是”尽量少犯错”的阈值,不一定是筛查要的阈值。
- 降低阈值,recall 升、precision 降:同一个模型在”找得全”和”喊得准”之间滑动。把所有阈值连起来就是 precision–recall 曲线(PR 曲线):
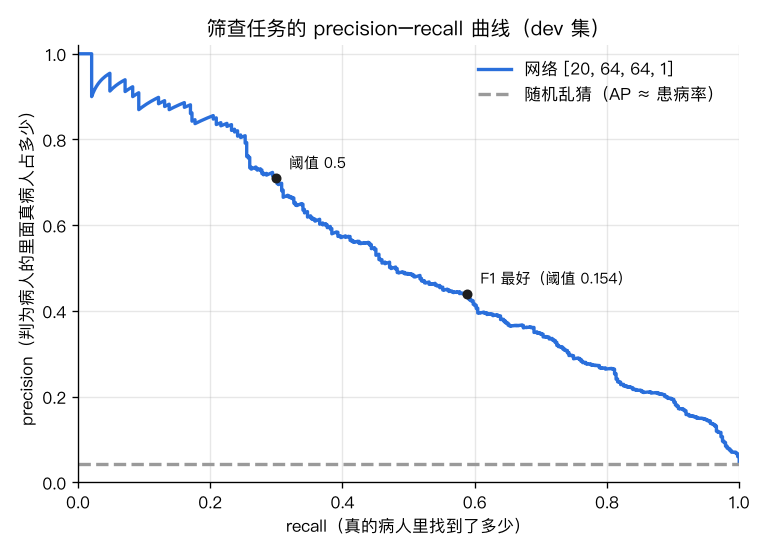
(这张图由 01_single_number_metrics.py 生成;没装 matplotlib 时脚本只打印表格。)
- F1 在中间最高:扫遍所有阈值,dev 上 F1 最好的阈值是 0.154(dev F1 0.504)。把这个在 dev 上选的阈值用到 test 上,F1 0.493;默认阈值 0.5 在 test 上只有 0.387。阈值也是一个超参数:在 dev 上调,在 test 上验证。
- AP(average precision,PR 曲线下的面积)不依赖阈值:dev 0.524、test 0.480,而随机乱猜的 AP 约等于患病率 0.043。比较两个模型时 AP 是一个好的单一数字;部署时你仍然要选一个阈值,那是 §3 的事。目标检测里的 mAP(第 14 讲)就是”每一类的 AP 再取平均”。
2.5 为什么不能直接拿 F1 当损失函数
CS230 Section 8 留了一个思考题:既然 F1 是我们要的指标,为什么不直接最小化 ?代码 01 演示 2 (c) 把输出层的偏置 推一点点(相当于把所有 logit 平移 ),看交叉熵和 F1 怎样变:
| 交叉熵 | F1(阈值 0.5) | 判阳性的人数 | |
|---|---|---|---|
| 0 | 0.1110438 | 0.4207 | 183 |
| 1e−6 | 0.1110438 | 0.4207 | 183 |
| 1e−4 | 0.1110427 | 0.4207 | 183 |
| 1e−3 | 0.1110327 | 0.4207 | 183 |
| 1e−2 | 0.1109329 | 0.4233 | 184 |
| 1e−1 | 0.1100185 | 0.4247 | 196 |
交叉熵随 连续地变(数值导数约 −0.0112);F1 一动不动,直到某个病人的概率越过阈值才跳一下(数值导数 0.0000)。F1 是”阈值之后数个数”,对参数是一级一级的台阶,导数几乎处处为 0,梯度下降无从下手。所以实践中的分工是:训练时用可导的代理损失(交叉熵),评估和选阈值时用你真正关心的指标(F1、recall@误报率……)。两者之间的差距靠”在 dev 上调阈值”和”给损失加权”(§4.3)来弥合。
3. Satisficing 与 optimizing 指标 · Satisficing and optimizing metrics
3.1 准确率和运行时间
有时候你关心的东西确实没法合成一个数。Ng 的例子:
| 分类器 | 准确率 | 运行时间 |
|---|---|---|
| A | 90% | 80 ms |
| B | 92% | 95 ms |
| C | 95% | 1,500 ms |
你可以硬凑一个公式,比如”准确率 − 0.5 × 运行时间”,但系数 0.5 没有道理可讲。更自然的说法是:运行时间只要 ≤ 100 ms 就行(用户感觉不出区别),在这个前提下准确率越高越好。于是选 B。
- optimizing metric(优化指标):越好越好的那一个——准确率;
- satisficing metric(满足指标):只要过线就行的那些——运行时间 ≤ 100 ms。“satisfice”是 satisfy + suffice 拼成的词,意思是”够好就行”。
一般地,N 个指标里选 1 个做 optimizing,其余 N − 1 个做 satisficing。Ng 的另一个例子是唤醒词(第 5 讲的触发词检测):在”每 24 小时误唤醒不超过 1 次”(satisficing)的前提下,让唤醒的准确率(说了唤醒词时设备有反应的比例,optimizing)尽量高。第 5 讲 §5.4 “在相同误唤醒次数下比较召回率”,用的就是这个思路。
3.2 实验:495 个候选,挑哪一个
代码 01 演示 3 在演示 2 的筛查任务上训练 5 个大小不同的网络,每个网络配 99 个阈值(0.01–0.99),一共 495 个候选。假设模型要跑在一台很弱的可穿戴设备上(假设它每毫秒能做 1,000 次乘加,于是 [20, 64, 64, 1] 一次预测 5.44 ms、[20, 256, 256, 1] 要 70.91 ms)。三种挑选规则:
| 挑选规则 | 挑中的网络 | 阈值 | 时延 ms | dev 准确率 | dev recall | dev 误报率 |
|---|---|---|---|---|---|---|
| 只看准确率 | [20, 256, 256, 1] | 0.88 | 70.91 | 96.36% | 0.244 | 0.37% |
| 时延 ≤ 10 ms,准确率最高 | [20, 32, 1] | 0.58 | 0.67 | 96.32% | 0.271 | 0.53% |
| 时延 ≤ 10 ms 且误报率 ≤ 1%,recall 最高 | [20, 64, 64, 1] | 0.46 | 5.44 | 96.19% | 0.343 | 0.99% |
- “只看准确率”挑中的是设备跑不动的大网络,而且漏掉了四分之三的病人。
- 把产品要求写成”两个 satisficing + 一个 optimizing”之后,挑中的候选清楚地反映了要求:跑得动、误报不超过 1%、尽量多找病人。
- 硬凑的公式”准确率 − λ × 时延”:λ 从 1e−2 扫到 1e−6,挑中了 3 种不同的网络(λ = 1e−2 时是逻辑回归 [20, 1],1e−6 时是大网络)。λ 取多少,没人说得清。
两个挑中的候选在 test 上(test 没有参与任何挑选):
| test 准确率 | test recall | test 误报率 | 误报人数 / 健康人数 | |
|---|---|---|---|---|
| 只看准确率 | 95.99% | 0.231 | 0.638% | 61 / 9558 |
| satisficing + optimizing | 96.08% | 0.330 | 1.004% | 96 / 9558 |
误报率在 dev 上是 0.99%,到 test 上变成 1.004%,略超预算。阈值本身是在 dev 上”挑最好”挑出来的,带一点乐观偏差(第 6 讲 §1.5 的赢家的诅咒);约束卡得很紧时,要给它留一点余量,或者用更大的 dev 集来定阈值。第 5 讲的触发词检测里”验证集上定 10 次、测试集上变成 14–29 次”是同一件事,只是那里还叠加了说话人不同(§8 的数据不匹配)。
4. dev / test 集:分布、大小,以及什么时候该改 · Setting up dev/test sets
4.1 dev 集 + 指标 = 靶子
Ng 的比喻:dev 集和评估指标一起,定义了团队要瞄准的靶子;之后几个月的所有努力,都是在让这个靶子上的数字变好。所以靶子放在哪里,比怎样打得准更重要。
dev 和 test 必须来自同一个分布,而且是你将来真正要表现好的那个分布。Ng 举过两个反面例子:
- 猫 app 在八个地区运营,把美国、英国、欧洲其他地区、南美的数据当 dev,把印度、中国、亚洲其他地区、澳大利亚的数据当 test。团队在 dev 上优化了几个月,到 test 上才发现靶子换了。
- 一个团队用”中等收入地区(按邮编)“的贷款申请数据优化了几个月,然后被要求在”低收入地区”上测试——分布不同,几个月的工作大多白费。
第 6 讲 §1.4 用”上半场 / 下半场”的实验量过这个代价:dev 来自上半场时,“上半场最好的模型”在下半场排第 18 / 20。这里不再重复。Ng 的原则:选 dev 和 test 时,让它们反映你预期将来会遇到、并且认为重要的数据;训练集可以来自别的分布(§8)。
4.2 多大
也在第 6 讲 §1.3 讲过:dev 要大到能分辨你在比较的方案之间的差别(准确率估计的标准误约 ),百万级数据时 98/1/1 就够;test 要大到让你对最终系统的表现有足够的信心。只有 train / dev、没有 test 也可以(很多团队这么做),但你报告的 dev 分数会偏乐观——这时要诚实地叫它 dev 集,而不是 test 集。
4.3 什么时候该改指标:给不能放过的错误加权
Ng 的例子:猫 app 用分类错误率做指标。算法 A 错误率 3%,B 错误率 5%——按指标 A 更好。可是 A 会把一些不良图片(色情图片)当成猫推给用户,B 不会。你和用户都更喜欢 B。
这时的结论不是”指标说的不对,凭感觉选 B 吧”,而是:指标没有反映你真正关心的东西,要改指标。改法是给不良图片的错误加权:
除以 而不是 ,让它仍然落在 0 到 1 之间。代价是:dev / test 里的不良图片都得标出来,多了一份标注工作。
这里正交化又出现了,而且分成清楚的两步:
- 定义指标(把靶子放对):只考虑”什么样的结果算好”,先不管怎样做到;
- 想办法在这个指标上做好(瞄准、射击):比如把同样的权重放进训练的代价函数 。
代码 01 演示 4 造了这样一个世界:40% 是猫、57% 是普通非猫、3% 是不良图片(标签”不是猫”,但长得像猫)。两个同样结构的网络:A 用普通交叉熵训练,B 训练时不良图片权重 10。阈值都在 dev 上选,数字都在 test 上算:
| 模型 | 普通错误率 | 不良图片放行 | 猫被拒绝 | 加权错误率 |
|---|---|---|---|---|
| A:普通交叉熵,阈值 0.5 | 8.92% | 64.7% | 9.8% | 20.87% |
| A:阈值按加权错误率调到 0.84 | 13.30% | 22.1% | 30.2% | 15.19% |
| B:训练时不良图片权重 10,阈值 0.5 | 11.52% | 18.5% | 21.3% | 13.01% |
| B:阈值按加权错误率调到 0.50 | 11.52% | 18.5% | 21.3% | 13.01% |
- 按普通错误率,A 更好;按加权错误率,B 更好——排序翻了。新的指标把”产品真正在乎的”写进了数字。(这个世界是为了说明问题而设计的,翻转几乎是设定好的。)
- 第 2 步有不同的”瞄准”方式。只调 A 的阈值是最便宜的:加权错误率降到 15.19%,但 A 分不清”不良图片”和”猫”,为了少放行,拒掉了 30.2% 的猫。B 把权重放进训练,学会了两者的区别。
- B 在 dev 上的最佳阈值恰好就是 0.50:用加权损失训练出来的概率,已经按新指标”校准”好了。
4.4 什么时候该改 dev / test 集
第二种情况:指标没问题,数据有问题。Ng 的例子:dev / test 是从网上收集的高清、构图好的猫图,而用户上传的是手机拍的、模糊的、构图随意的照片。你的模型在 dev / test 上表现很好,用户却不满意。规则是:
如果在”指标 + dev / test”上做得好,不等于在你的应用里做得好,就改指标和 / 或 dev / test 集。
Ng 的另一个实用建议:不要因为还没想清楚完美的指标和 dev 集,就迟迟不开始。先快速定一个,让团队转起来;发现它不对时,再改。没有靶子的团队效率最低。手机照片和网络图片怎样分、怎样诊断,是 §8 的内容。
5. 和人类水平比较 · Comparing to human-level performance
5.1 为什么和人比
Ng 画过一张示意图:横轴是时间(项目进展),纵轴是准确率。
 准确率 ↑
        |- - - - - - - - - - - - - - - - - - - -  Bayes 最优(理论上限)
        |                       __________________
        |- - - - - - - - - - -_/- - - - - - - - -  人类水平
        |                 __/
        |             __/      ← 接近人类之前进展快;超过人类之后明显变慢
        |          _/
        |       _/
+------------------------------------------→ 时间两个现象:接近人类水平之前进展往往很快;超过人类水平之后变慢,最后逼近一个永远越不过去的上限——Bayes 最优错误率(Bayes optimal error),任何函数(不管是人还是机器)都不可能低于它(第 1 讲 §2.1 的”误差下限”、第 3 讲 §8.2 的 Bayes 最优分类器、第 6 讲 §2.3)。图片太模糊、录音噪声太大,有些样本本来就分不清。
为什么超过人类之后变慢?一个原因是人类水平本身就离 Bayes 不远(对看图、听声音这类自然感知任务尤其如此),剩下的空间本来就小。另一个原因更有意思:只要模型还不如人,你手里就有三件好用的工具——
- 请人来标注更多数据;
- 做人工误差分析:模型错了而人对了,人是怎么看出来的?(§6)
- 更好地做 bias / variance 分析:用人类水平当 Bayes 错误率的代理(§5.2)。
超过人类之后,这三件工具都不太灵了。
5.2 可避免偏差 · Avoidable bias
第 6 讲的诊断以 Bayes 错误率为参照。真实任务里不知道它,就用人类水平代替。Ng 的例子——同样的训练 / dev 误差,人类水平不同,结论不同:
| 场景 1 | 场景 2 | |
|---|---|---|
| 人类水平(≈ Bayes) | 1% | 7.5% |
| 训练误差 | 8% | 8% |
| dev 误差 | 10% | 10% |
| 可避免偏差 = 训练 − 人类 | 7% | 0.5% |
| 方差 = dev − 训练 | 2% | 2% |
| 先治 | bias:更大的网络、训练更久 | variance:正则化、更多数据 |
场景 2 里的图片可能很模糊,人也只能做到 92.5%。训练误差 8% 离”能做到的最好”只差 0.5%,再拼命降训练误差意义不大;该治的是方差。“训练误差 − 人类水平”叫可避免偏差(avoidable bias):剩下的那部分偏差(人类水平本身)是不可避免的。
5.3 哪一个”人类水平”?
Ng 的医学影像例子:
| 谁来看 | 错误率 |
|---|---|
| 普通人 | 3% |
| 普通医生 | 1% |
| 有经验的医生 | 0.7% |
| 有经验的医生组成的小组(讨论后给结论) | 0.5% |
作 Bayes 错误率的代理时,应该用哪个?Ng 的回答:用能达到的最好的那个(0.5%)——Bayes 错误率 ≤ 0.5%,最好的人类水平给的是它的一个上界。(如果你的目的是写论文、或者部署一个”比普通医生好”就有用的系统,那么 1% 也是一个有意义的目标;但做 bias / variance 分析时用最好的。)
代码 03 演示 1 在一个 Bayes 错误率已知的合成世界里模拟了四种”标注员”:人知道判断规则,但看图时对内容的感知有误差 ;“专家小组”是三位专家独立看、投票:
| 标注员 | 感知误差 σ | 错误率 |
|---|---|---|
| 普通人 | 0.30 | 12.91% |
| 有经验的标注员 | 0.10 | 6.43% |
| 专家 | 0.05 | 4.64% |
| 三位专家投票 | 0.05 | 4.08% |
| Bayes 最优(只有合成世界才知道) | 2.88% |
(σ 和投票人数是我设定的,只为造出”人和人之间有差别”的局面。)四种人都高于 Bayes;三位专家投票比任何一位专家单独看都好——看走眼的情况被多数决抵消了一部分。但即使最好的代理,也比 Bayes 高了 1.2 个百分点,这一点 §8.3 会再碰到。
选哪个代理什么时候重要? 用 Ng 的数字,同一组训练 / dev 误差分别用”普通医生 1%“和”医生小组 0.5%“去读(代码 03 演示 1 打印了这张表):
| 训练 | dev | 用 1%:可避免偏差 / 方差 | 用 0.5%:可避免偏差 / 方差 | 先治 | |
|---|---|---|---|---|---|
| 情形 1 | 5.0% | 6.0% | +4.0% / 1.0% | +4.5% / 1.0% | bias |
| 情形 2 | 1.0% | 5.0% | +0.0% / 4.0% | +0.5% / 4.0% | variance |
| 情形 3 | 0.7% | 0.8% | −0.3% / 0.1% | +0.2% / 0.1% | 取决于代理 |
| 超过人类 | 0.3% | 0.4% | −0.7% / 0.1% | −0.2% / 0.1% | 不知道了 |
离人类水平远的时候(情形 1、2),用哪个代理都一样;离得越近,代理的选择越关键(情形 3:用 1% 会以为”已经超过人类、只剩方差”,用 0.5% 才看出可避免偏差 0.2% 比方差 0.1% 大)。也正因为如此,模型越好,诊断越难。
5.4 超过人类之后
最后一行:训练误差 0.3%、dev 0.4%,已经低于最好的人类水平 0.5%。可避免偏差变成负数,你不再知道 Bayes 错误率在哪里——是 0.1%、0.2% 还是 0.3%?于是不知道该继续降偏差还是降方差。这是”超过人类之后进展变慢”的另一个原因:你失去了方向感。
哪些问题上机器已经明显超过人类?Ng 列举的典型例子是:在线广告(预测点击)、商品推荐、物流(预测运输时间)、贷款审批。它们的共同点:结构化数据(第 1 讲 §3.2),不是自然感知任务,而且有海量数据——一个系统能看到的用户行为,比任何一个人一辈子能看到的都多。在自然感知任务上,机器也在一些问题上达到或超过了人类:一部分语音识别、一部分图像识别,以及一些狭窄的医学任务(读心电图、皮肤癌分类、某些放射影像任务,见延伸阅读)。但这些都比结构化数据上的超越难得多。
5.5 小结:改进模型的两个基本假设
Ng 把这几节总结成一句话:一个监督学习系统要好,需要两个基本假设成立——
- 你能很好地拟合训练集(可避免偏差小);
- 训练集上的表现能很好地推广到 dev / test(方差小)。
          人类水平 ──┐
                     │ 可避免偏差 → 更大的网络;训练更久 / 更好的优化(Momentum、RMSprop、Adam);换架构、搜超参数
          训练误差 ──┤
                     │ 方差       → 更多数据;正则化(L2、dropout、数据增强);换架构、搜超参数
          dev 误差 ──┘
这就是第 6 讲 basic recipe 的升级版:参照物从”0”换成了”人类水平”。§8 会在这张图上再加一层(train-dev 和数据不匹配)。
6. 误差分析 · Error analysis
6.1 先数一数
回到 §1.1 的猫分类器:dev 错误率 10%。队友看了几个错例,发现有些狗被认成了猫,提议”花几个月专门解决狗的问题”(比如收集更多狗的图片、为狗设计专门的特征)。该不该?
Ng 的做法简单得惊人:
- 从 dev 集判错的样本里随机拿出约 100 个;
- 人工逐个看,数一数其中有几个是狗。
如果只有 5 个(5%),那就算把狗的问题彻底解决,错误率也只能从 10% 降到 9.5%——这个上限叫天花板(ceiling)。如果有 50 个(50%),天花板是 10% → 5%,那就值得做。
花几个月之前,先花半天数一数。Ng 特别强调,很多工程师不愿意做这种”手工活”,觉得不够高级;但它常常能省下几个月。
6.2 并行评估多个想法:一张表
通常你手里不止一个想法。Ng 的做法是建一张表:每一行一个错例,每一列一个”错误类别”,在对应的格子里打勾,最后一行算百分比。看的过程中发现新类别(比如”Instagram 滤镜”),就加一列。
代码 02 造了一个”知道每张图是什么”的猫分类世界:猫、普通非猫、狗、大型猫科(狮子、老虎),再加上 20% 的图模糊、8% 的图加了滤镜,标注员在模糊图上有 4% 的概率标错、清楚的图 0.5%。训练一个网络(训练 10,000 张、dev 10,000 张),dev 错误率(按标注的标签)7.69%,一共 769 个错例。演示 1 从中随机抽 100 个,打印成 Ng 的那种表格(这里列出前 6 行;真实工作里,这一步是人去看图):
| 图片 | 狗 | 大型猫科 | 模糊 | 滤镜 | 标签错误 | 模型说 / 标签说 |
|---|---|---|---|---|---|---|
| #5937 | ✓ | ✓ | 猫 / 非猫 | |||
| #81 | ✓ | 非猫 / 猫 | ||||
| #8976 | ✓ | 猫 / 非猫 | ||||
| #775 | ✓ | ✓ | 猫 / 非猫 | |||
| #9989 | ✓ | ✓ | 猫 / 非猫 | |||
| #784 | ✓ | ✓ | ✓ | 非猫 / 猫 |
100 个错例的统计,和”看遍全部 769 个错例”的真实比例对照:
| 类别 | 100 个里 | 估计比例 | 真实比例 | 天花板:全修好后的错误率 |
|---|---|---|---|---|
| 狗 | 9 | 9% | 4.4% | 7.69% → 7.00% |
| 大型猫科 | 27 | 27% | 27.0% | 7.69% → 5.61% |
| 模糊 | 68 | 68% | 69.8% | 7.69% → 2.46% |
| 滤镜 | 15 | 15% | 12.9% | 7.69% → 6.54% |
| 标签错误 | 10 | 10% | 14.8% | 7.69% → 6.92% |
(各列加起来超过 100%:36% 的错例同时属于两类以上,比如一只模糊的狮子;10% 的错例不属于任何一列,归为”其他”。)
队友想解决的狗只占 9%(看遍全部错例是 4.4%):天花板只有 7.69% → 7.00%。模糊图占七成,大型猫科占四分之一——这两个方向的天花板高得多。一张表,一次就看清了几个想法的优先级。这就是”并行评估多个想法”。
6.3 100 个够不够?
100 个错例估计出的比例有随机误差,标准差约 。演示 1 (c) 把”随机抽 100 个错例”重复 2000 次:
| 类别 | 真实比例 | 估计的标准差(实测) | 公式 |
|---|---|---|---|
| 狗 | 4.4% | 1.9% | 2.1% |
| 大型猫科 | 27.0% | 4.2% | 4.4% |
| 模糊 | 69.8% | 4.1% | 4.6% |
| 滤镜 | 12.9% | 3.1% | 3.3% |
| 标签错误 | 14.8% | 3.3% | 3.6% |
(实测的标准差比公式略小,因为 100 个是从 769 个里不放回地抽的。)
- 2000 次里,100 个错例估计出的”最大的一类”每次都是模糊(100.0%);“大型猫科(27.0%)排在滤镜(12.9%)前面”的比例 99.6%。差别大的时候,100 个绰绰有余。
- 但”标签错误(14.8%)排在滤镜(12.9%)前面”只有 63.3% 的时候是对的(另有 8.1% 打平)。两类很接近时,100 个分不清——这时就多看一些。上面那次抽样里狗是 9 个(真实 4.4%),就是一次正常的随机波动。
误差分析的目的是决定先做什么,不是精确测量,所以 100 个通常够用;dev 集很大时,Machine Learning Yearning 还建议把 dev 分成两份:一份你亲自看错例(“eyeball dev set”),另一份只看数字、不看图(“blackbox dev set”),因为你看过的那一份会被你的直觉”过拟合”。
6.4 天花板不等于能拿到的收益
天花板说的是”全部修好”。实际能修好多少,取决于这一类错误能不能修好。Ng 讲人类水平时说的第二件工具在这里用得上:这一类错误,人能不能做对?
演示 1 (d) 做了一个现实检查:同一个世界,训练数据多 10 倍(100,000 张)、网络更大 [32, 128, 128, 1],dev 错误率从 7.69% 降到 6.76%。按类别看:
| 类别 | 天花板能降 | 10 倍数据实际降 | 错例数:现在 | 10 倍数据 | 这一类里的错误率:现在 | 10 倍数据 |
|---|---|---|---|---|---|---|
| 狗 | 0.34% | 0.04% | 34 | 30 | 16.1% | 14.2% |
| 大型猫科 | 2.08% | 0.42% | 208 | 166 | 18.2% | 14.5% |
| 模糊 | 5.37% | 0.60% | 537 | 477 | 26.9% | 23.9% |
| 滤镜 | 0.99% | 0.19% | 99 | 80 | 12.2% | 9.9% |
| 标签错误 | 1.14% | 0.00% | 114 | 114 | 78.6% | 78.6% |
- 模糊图的天花板最高(5.37%),但 10 倍的数据只让它的错例从 537 降到 477:模糊在”拍照”时就把信息丢了,再多的数据也补不回来(这个世界里人来看也一样难)。这部分错误大多是不可避免的。
- 清楚的大型猫科错误率从 6.3% 降到 2.4%:信息在图里,只是网络没学好——这部分是”可避免的”。
- 标签错误一个都没少:那些”错例”其实是模型对了、标签错了,换什么模型都一样。
所以排优先级时,天花板告诉你最多能得到多少,“人能不能做对”告诉你大概能得到多少。(这个世界里”模糊图的信息真的没了”是我设定的;真实的模糊图里信息丢了多少,要看人能认出多少。)
6.5 先快速做出第一个系统,再迭代
误差分析需要错例,错例需要一个系统。Ng 在这里给了一个很实际的建议:先快速做出第一个系统,再迭代(build your first system quickly, then iterate)。他用语音识别举例:可以改进的方向有几十个——嘈杂的背景(咖啡馆噪声、车内噪声)、口音、离麦克风很远、小孩的声音、口吃、“嗯""啊”这样的填充词……每一个都可以做很久。在动手之前,你不知道哪个最重要。
所以:
- 快速定好 dev / test 集和指标(§2–§4);
- 快速搭一个初始系统(几天,而不是几周);
- 用 bias / variance 分析(§5)和误差分析(§6)决定下一步。
例外:如果你在这个领域有丰富的经验,或者有大量成熟的文献可以参考(比如人脸识别),可以一开始就做一个更复杂的系统。但大多数团队的问题不是”想得太少、做得太快”,而是想得太多、迟迟没有一个能跑的系统。CS230 Section 3(公开网页)的建议也是同一个精神:先找现成的实现、先建 baseline、先在一小份数据上过拟合。第 11 讲会把这些放进一个完整项目里。
7. 错误的标签 · Cleaning up incorrectly labeled data
7.1 训练集里:随机的错误 vs 系统性的错误
标注员也会标错。训练集里的错误标签要不要清理?Ng 的回答:深度学习算法对训练集里(不太多的)随机错误相当稳健,对系统性错误不稳健。系统性错误的例子:某个标注员总是把白色的狗标成猫。
代码 02 演示 2 在同一个世界里,训练标签本来全对,再人为加错误,在 dev 上用真实标签评估:
| 训练标签 | 错误标签占比 | dev 错误率 | 大型猫科错误率 | 其他图片错误率 |
|---|---|---|---|---|
| 没有错误标签 | 0.0% | 6.42% | 18.3% | 4.98% |
| 随机翻转 5% | 4.7% | 7.27% | 20.5% | 5.67% |
| 随机翻转 11% | 11.7% | 7.56% | 23.1% | 5.68% |
| 随机翻转 30% | 30.6% | 12.26% | 35.6% | 9.44% |
| 系统性:大型猫科全标成猫 | 11.2% | 14.08% | 98.2% | 3.89% |
同样是 11%–12% 的标签错了:随机的错误让 dev 错误率从 6.42% 变成 7.56%,系统性的错误让它变成 14.08%——大型猫科的错误率涨到 98.2%,模型老老实实地学会了”狮子是猫”。
为什么?随机翻转时,在输入空间的每一小块里,正确的标签仍然占多数,网络拟合的是”这一块里大多数样本是什么”,少数的错误被平均掉了。系统性的错误在某一块里就是多数,网络无从分辨。随机错误也不是完全无害:翻转 30% 时 dev 错误率几乎翻倍,网络把一部分错误背了下来(第 6 讲 §3.4 提到过,大网络连完全随机的标签都能背下来)。
7.2 dev / test 里:值不值得清理
dev 里的错误标签会让你看错:模型对了、标签错了,也被算成错误。在误差分析的表里加一列”标签错误”(§6.2 就有),然后看它占错例的多大比例。Ng 的两个例子:
| 例子 1 | 例子 2 | |
|---|---|---|
| dev 总错误率 | 10% | 2% |
| 其中来自标签错误 | 0.6% | 0.6% |
| 其中来自其他原因 | 9.4% | 1.4% |
| 标签错误占错例的比例 | 6% | 30% |
| 结论 | 先做别的 | 值得清理 |
例子 2 还有一个更要紧的问题:dev 集的作用是帮你在两个模型之间做选择。如果 A 是 2.1%、B 是 1.9%,而 0.6% 的错误来自标签,你就不能相信 dev 告诉你的”B 更好”。模型越好,标签错误占的比例越大,dev 集就越需要干净。代码 02 演示 3 的 dev 里有 1.25% 的标签是错的:dev 错误率 7.10% 里有 1.05% 来自标签错误(占错例的 14.8%),和 Ng 的两个例子相比,介于”先做别的”和”值得清理”之间。
7.3 怎样清理:三条原则
Ng 给了三条原则,演示 3 把前两条量了出来:
| 怎样清理 dev 的标签 | 复查了多少张 | dev 上测得的错误率 | 真实错误率 |
|---|---|---|---|
| 1. 不清理 | 0 | 7.10% | 6.25% |
| 2. 只复查模型判错的样本 | 710 | 6.05% | 6.25% |
| 3. 判对、判错的都复查 | 10000 | 6.25% | 6.25% |
| dev 测得 | test 测得 | dev − test | |
|---|---|---|---|
| dev、test 都不清理 | 7.10% | 7.03% | 0.07% |
| 只清理 dev | 6.25% | 7.03% | −0.78% |
| dev、test 都清理 | 6.25% | 6.41% | −0.16% |
- dev 和 test 用同样的流程清理,让它们保持同一个分布。只清理 dev 时,dev 比 test 低了 0.78 个百分点,看起来像”在 dev 上过拟合了”,其实只是两份数据的标签标准不一样了。
- 判对的样本也要看(至少抽查一部分)。只复查判错的样本,测得 6.05%,比真实的 6.25% 还低:被你修好的标签都在帮模型”翻案”,而”模型错了、标签也错得一模一样”的那 20 个样本看起来是判对的,从来没人去看。当然,判对的样本多得多(这里 9,290 张 vs 710 张),全看很贵——这是 Ng 说”考虑”而不是”必须”的原因。
- 训练集可以不清理(它通常大得多,而且 §7.1 说明随机的少量错误伤害不大)。于是训练集和 dev / test 的分布会有一点点不同——这没关系,§8 专门讲这种情况。
8. 训练和测试分布不同 · Training and testing on different distributions
8.1 200,000 张网络图片 + 10,000 张手机照片
深度学习很饿,能大量获得的数据往往不是你最终要处理的数据。Ng 的例子:猫 app 的用户用手机拍照上传。你从网上爬到 200,000 张猫图(清楚、构图好),用户上传的手机照片只有 10,000 张(暗、模糊、构图随意)。你在乎的是手机照片。怎么分?
- 方案 1:210,000 张全部打乱,分成训练 205,000 / dev 2,500 / test 2,500。好处是三份同分布。坏处致命:dev 里平均只有约 2,500 × 10,000 / 210,000 ≈ 119 张手机照片,你的靶子主要是网络图片。
- 方案 2(Ng 推荐):训练 = 200,000 张网络图片 + 5,000 张手机照片;dev = 2,500 张手机照片;test = 2,500 张手机照片。靶子放对了;代价是训练分布和 dev / test 分布不同。
Ng 的另一个例子是语音控制的汽车后视镜:可以买到、收集到的各种语音数据(买来的语音数据、智能音箱、语音输入法……)约 500,000 条,真正来自后视镜的只有 20,000 条。按同样的思路:训练 = 500,000 + 10,000 条后视镜语音,dev 和 test 各 5,000 条后视镜语音。
代码 03 把猫 app 缩小成一个合成世界:每张图有一个 10 维的”内容”,标签由一个固定的非线性规则决定,再有 3% 的图本身就模棱两可(标签随机翻转)——Bayes 错误率恰好是 3%。网络图片 = 内容 + 一点点杂乱;手机照片 = (对比度降到 0.6 倍、整体偏色的内容)+ 大量的杂乱。内容和杂乱放在互相垂直的方向上,所以手机照片里内容也没丢,Bayes 错误率同样是 3%。网络图片 40,000 张、手机照片 4,000 张,另外 20,000 张手机照片当”真实世界”(真实工作中没有它,这里用来核对)。演示 2:
| 训练集里的手机照片 | dev 里的手机照片 | dev 错误率 | 真实世界(手机)错误率 | |
|---|---|---|---|---|
| 方案 1:全部打乱,42000/1000/1000 | 3817 | 92 | 6.7% | 17.2% |
| 方案 2:训练 = 网络 + 一半手机 | 2000 | 1000 | 17.5% | 18.8% |
方案 1 的 dev 说”6.7%“,模型在手机照片上的真实表现是 17.2%——你接下来几个月瞄准的是一个错的靶子。方案 2 的 dev(17.5%)和真实世界(18.8%)基本一致。
注意一个细节:方案 1 的训练集里有 3,817 张手机照片,方案 2 只有 2,000 张(另外 2,000 张拿去当 dev / test 了),所以方案 1 的模型在手机上反而略好(17.2% vs 18.8%)。Ng 的取舍是:先保证 dev / test 测的是你在乎的东西,训练数据的问题再用后面的办法处理。
8.2 分布不同时,bias / variance 怎么读:train-dev set
方案 2 带来一个新问题。假设人类水平约 0%,训练误差 1%,dev 误差 10%。第 6 讲会说”high variance”。但现在 dev 和训练不同分布,这 9% 的差距里混着两件事:
- 模型没见过的图就不行(方差);
- dev 的图和训练的图本来就不一样(数据不匹配)。
Ng 的办法:从训练集里随机留出一小份,叫 train-dev set——它和训练集同分布,但不参与训练。于是有了五个误差和四个差距:
人类水平 ─┐
          │ 可避免偏差 avoidable bias      = 训练 − 人类水平
训练误差 ─┤
          │ 方差 variance                   = train-dev − 训练        (同分布、没见过)
train-dev ┤
          │ 数据不匹配 data mismatch        = dev − train-dev          (分布不同)
dev 误差 ─┤
          │ 对 dev 过拟合 overfitting to dev = test − dev              (在 dev 上挑过头了)
test 误差 ┘
Ng 的四个小例子(人类水平约 0%):
| 训练 | train-dev | dev | 诊断 |
|---|---|---|---|
| 1% | 9% | 10% | 方差 |
| 1% | 1.5% | 10% | 数据不匹配 |
| 10% | 11% | 12% | 可避免偏差 |
| 10% | 11% | 20% | 可避免偏差 + 数据不匹配 |
一个反直觉的情况:dev / test 误差也可能低于 train-dev 误差——如果你在乎的那个分布本身更容易(比如后视镜语音的用语很有限)。Ng 在讲后视镜例子时专门提过这种可能:差距不一定都是正的。
代码 03 演示 3 在合成世界里造了四种做法(人类水平用”三位专家投票”把手里 4,000 张手机照片都看一遍:4.6%;Bayes 3.0%):
| 做法 | 训练 | train-dev | dev | test | 可避免偏差 | 方差 | 数据不匹配 | dev 过拟合 |
|---|---|---|---|---|---|---|---|---|
| A 逻辑回归 [40, 1] | 14.3% | 13.9% | 24.5% | 26.1% | +9.7% | −0.4% | +10.6% | +1.6% |
| B 大网络,只有 1,000 张训练图 | 0.0% | 15.6% | 32.6% | 32.4% | −4.6% | +15.6% | +17.0% | −0.2% |
| C 大网络,只用网络图片训练 | 4.3% | 5.9% | 32.8% | 32.4% | −0.3% | +1.6% | +26.9% | −0.4% |
| D 大网络,训练 = 网络 + 2,000 手机 | 4.5% | 7.3% | 17.5% | 19.1% | −0.1% | +2.9% | +10.1% | +1.6% |
(大网络是 [40, 128, 128, 1]。dev、test 各 1,000 张,误差本身有 ±1–2 个百分点的随机波动。)
- A:连训练集都学不好(可避免偏差 9.7%),同时数据不匹配也有 10.6%。病可以不止一种,按大小排队处理。
- B:训练 0.0%、train-dev 15.6%——很大的方差。如果没有 train-dev,你只看到”训练 0%、dev 32.6%“,分不清这 32.6 个百分点里多少是过拟合、多少是分布不同。
- C:train-dev 5.9% 很好,dev 32.8% 很差——数据不匹配。模型在”训练的那种图”上泛化得很好,只是没见过手机照片。这时加正则化、加更多网络图片,治的都不是这个病。
- D:把 2,000 张手机照片放进训练集,dev 从 32.8% 降到 17.5%,但数据不匹配(10.1%)仍然是最大的问题。下一步该做 §8.3 的事。
- test − dev 在四种做法里都只有一两个百分点、有正有负:我们没有在 dev 上反复挑模型,剩下的是随机波动。
还有一个和 §5.3 呼应的细节:C、D 的训练误差(4.3%、4.5%)已经和人类水平(4.6%)差不多,按人类水平读”可避免偏差几乎为 0”;可这个世界的 Bayes 错误率是 3.0%,真实的可避免偏差约 1.4%。离人类水平越近,代理的误差越要紧。
8.3 处理数据不匹配
数据不匹配没有像正则化那样系统的药方。Ng 给的是两步:
- 做人工误差分析,弄清楚训练集和 dev / test 差在哪里。比如后视镜语音的 dev 里有很多车内噪声,或者经常要识别街道门牌号。只看 dev,不要看 test(否则 test 就不再是无偏的了)。
- 让训练数据更像 dev / test:收集更多和 dev / test 相似的数据;或者人工合成(artificial data synthesis)。
代码 03 演示 4 (a):在合成世界里,“人看得出来的差别”可以直接读出来——
| 对比度 | 偏色 | 杂乱 | 错误率 | |
|---|---|---|---|---|
| 网络图片(训练集里的) | 0.99 | 0.08 | 1.32 | 7.3%(train-dev) |
| 手机照片(dev) | 0.60 | 0.78 | 6.66 | 17.5% |
手机照片对比度低、偏色、杂乱多得多。值得一提的是一个和我预想不一样的结果:在 dev 内部,杂乱较少的一半和较多的一半错误率几乎一样(17.6% vs 17.4%)。问题不在”哪张手机照片更乱”,而在”所有手机照片都和训练图片不一样”——所以要拿 dev 和训练集比,而不只是在 dev 里比。
人工合成:Ng 的例子是语音。你有大量干净的语音(比如一句 “The quick brown fox jumps over the lazy dog”),再录一些车内噪声,把两者叠加,就得到”在车里说话”的录音——这正是第 5 讲触发词检测里”录一点、合成很多”的做法。但他马上提醒了一个风险:
如果你有 10,000 小时的语音,却只有 1 小时的车内噪声,把这 1 小时循环使用 10,000 次来合成——人听起来每一段都”像在车里”,但网络可能会过拟合那 1 小时的噪声。它只是所有可能的车内噪声里极小的一块。
另一个例子:用赛车游戏的画面合成汽车图片。游戏里可能只有 20 种车,人看着都很逼真,网络却会过拟合这 20 种车。
演示 4 (b) 把 40,000 张网络图片合成成”手机照片”(调对比度、加偏色、再从一个”杂乱素材库”里取杂乱),加上 2,000 张真的手机照片一起训练,每种做法 3 个种子取平均:
| 训练数据 | 训练误差 | dev | test | 真实世界 20,000 张 | 各种子的真实世界 |
|---|---|---|---|---|---|
| 不合成(演示 3 的 D) | 4.6% | 18.4% | 19.5% | 18.9% | 18.8% 18.9% 19.1% |
| 只调对比度和偏色 | 4.8% | 15.4% | 15.8% | 15.1% | 15.3% 15.2% 14.9% |
| + 杂乱,素材库只有 1 份 | 6.0% | 17.5% | 18.5% | 18.1% | 17.8% 18.5% 17.8% |
| + 杂乱,素材库 10 份 | 7.6% | 14.8% | 15.9% | 14.8% | 14.7% 15.0% 14.8% |
| + 杂乱,素材库 100 份 | 8.5% | 13.3% | 13.7% | 12.8% | 13.1% 13.1% 12.3% |
| + 杂乱,每张图都用新的 | 7.4% | 14.5% | 13.9% | 13.4% | 13.2% 13.2% 13.7% |
- 按误差分析的线索合成,有效:只调对比度和偏色,真实世界错误率从 18.9% 降到 15.1%;再加上多样的杂乱,降到 12.8%–13.4%。
- 只用 1 份杂乱素材,比不加杂乱还差(18.1% vs 15.1%)。40,000 张图背景里是同一份杂乱,网络学会的是”这一份杂乱不重要”,而不是”杂乱不重要”;在加了杂乱的几种做法里,它的训练误差最低(6.0%),遇到真实手机照片上千变万化的杂乱就不灵了。这就是”1 小时车内噪声”的风险,在一个玩具里被量了出来。
- dev / test 各只有 1,000 张,零点几到一两个百分点的差别分不清(素材库 100 份和每张都新就分不清),所以这里多报了”真实世界”和每个种子的数字。
合成数据的教训:合成出来的数据”人看着像”不够,还要问它覆盖了真实数据里多大的一块变化。覆盖得窄,网络就会钻那一小块的空子。
9. 迁移学习 · Transfer learning
9.1 想法:先在 A 上学,再到 B 上用
你要做放射影像诊断(任务 B),只有几百张有标注的 X 光片。但通用图像识别(任务 A)有上百万张标注好的图片。Ng 的做法:
- 在 A 上训练一个网络(预训练 pre-training);
- 把最后的输出层换成 B 的输出层(随机初始化),在 B 的数据上继续训练(微调 fine-tuning)。数据很少时只训练新的输出层(前面的层冻结);数据多一些时,可以训练全部或者后面几层。
为什么有效?在 A 上学到的前面几层是低层特征——边缘、纹理、形状、部件(第 4 讲 §5.1、第 1 讲 §2.3)——它们对看 X 光片同样有用。B 只需要学”怎样把这些特征组合起来”,这需要的数据少得多。Ng 的另一个例子是语音:在约 10,000 小时的语音识别数据上预训练,再迁移到只有约 1 小时数据的唤醒词检测。第 5 讲的人脸编码器(triplet loss)也是同一个思路:在很多人脸上学一个编码,用到从没见过的学生身上。
9.2 什么时候有用
Ng 给了三个条件,从任务 A 迁移到 B 有意义,当:
- A 和 B 的输入 相同(都是图像,或者都是音频);
- A 的数据比 B 多得多(反过来没什么用:B 的一个样本通常比 A 的一个样本更有价值);
- A 学到的低层特征可能对 B 有用。
9.3 实验
代码 04 演示 1 造了一个”低层特征可以共享”的世界:输入 是 32 个”像素”,一个固定的两层随机 tanh 网络把它变成 8 个”低层特征”;不同的任务在这些特征上用不同的方式读出标签。A 是 10 个二值属性(20,000 张,想成”通用图像识别”);B 是 1 个二值标签(想成”X 光片诊断”,Bayes 错误率约 3%);A’ 是用另一组低层特征定义的 10 个属性(“不相关的任务”)。网络是 [32, 64, 64, ·],B 的 test 集 10,000 张,每格 3 个种子的平均错误率:
| B 的训练样本数 → | 30 | 100 | 300 | 1000 | 3000 |
|---|---|---|---|---|---|
| 从零训练 | 39.4% | 31.3% | 24.8% | 22.3% | 21.2% |
| 预训练 A + 只训练输出层 | 25.8% | 21.1% | 18.1% | 16.8% | 16.2% |
| 预训练 A + 全部微调 | 28.9% | 25.3% | 20.5% | 18.9% | 17.8% |
| 预训练 A’(不相关)+ 只训练输出层 | 39.1% | 36.2% | 32.6% | 30.4% | 28.8% |
| 预训练 A’(不相关)+ 全部微调 | 36.2% | 29.5% | 24.3% | 21.8% | 19.8% |
- B 的数据越少,迁移的收益越大:30 张时从零训练 39.4%,借 A 的特征 25.8%(少 13.7 个百分点);3,000 张时差距缩小到 4.9 个百分点。
- 这个世界里,“只训练输出层”在每个数据量下都比全部微调好。A 的 10 个属性已经覆盖了 B 需要的全部 8 个特征,改动前面的层只会把好的特征”改坏”一点。Ng 的经验是”数据少就只重训最后一层,数据多就重训全部”;多到什么程度、B 需要的特征和 A 差多远,都要在 dev 上试。(我写的第一版世界里,低层特征有 24 个、A 只覆盖其中 10 个方向,结果正好相反:冻结的特征不够用,3,000 张时比从零训练还差,全部微调最好。见代码 README。这说明”条件 3”不是一个是 / 否的问题,而是”A 的特征覆盖了 B 需要的多少”。)
- 不相关的 A’:冻结它的特征,比从零训练差得多(3,000 张时 28.8% vs 21.2%)——特征本身就不对,数据再多也救不回来;全部微调时和从零训练差不多,只是略好一点。条件 3 不满足,迁移就没有意义。
第 13 讲会在卷积网络上讲迁移学习的实际做法(用 ImageNet 预训练的权重、冻结前几层、用较小的学习率微调、配合数据增强)。今天大语言模型的”预训练 + 微调”(第 20 讲)也是同一个想法,只是规模大了几个数量级。
10. 多任务学习 · Multi-task learning
10.1 一个网络,同时做几件事
迁移学习是”先 A 后 B”;多任务学习是”同时学 A、B、C、D”。Ng 的例子是自动驾驶:一张图里要同时知道有没有行人、车、停车标志、红绿灯。于是 , 的形状是 (Ng 的列约定;代码里按行是 )。网络的输出层有 4 个 sigmoid 单元,损失是 4 个二元交叉熵之和:
和 softmax(第 9 讲 §3)不同:softmax 要求每张图恰好属于一类;这里一张图可以同时有行人和车,4 个输出各自是一个二分类问题。为什么不训练 4 个网络?因为 4 个任务共享低层特征(边缘、颜色、形状),一个网络可以用 4 个任务的标签一起学这些特征。
10.2 标签缺失:掩码
标注员可能只标了一部分:这张图只标了”有没有行人”和”有没有车”,停车标志和红绿灯是 ”?”。Ng 的做法:求和时只对有标签的 求和,缺失的项既不算损失、也不产生梯度。写成掩码 (1 = 有标签):
(分母换成”有标签的项数”只是换了个归一化,和 Ng 的 只差一个常数倍。)strategy_tools.train_net 的权重矩阵 W 就是这个掩码——和 §4.3 的”不良图片权重 10”是同一个机制。
10.3 什么时候有用
Ng 的三个条件:
- 这些任务能从共享的低层特征中受益;
- 通常:每个任务的数据量差不多——这样,对任何一个任务来说,其他任务加起来的数据远多于它自己的(100 个任务、每个 1,000 个样本,对其中一个任务来说其余 99 个任务提供了 99,000 个样本);
- 能训练一个足够大的网络把所有任务都做好。Rich Caruana 的研究发现,多任务学习只有在网络不够大时才会比分开训练差。
他还补充:实践中迁移学习用得比多任务学习多得多;一个主要的例外是计算机视觉里的目标检测(一张图里同时找很多类物体,第 14 讲)。
10.4 实验:几乎没有收益,但掩码和网络大小很重要
代码 04 演示 2 在一个共享低层特征的世界里,给每张图 4 个标签(行人 30%、车 50%、停车标志 10%、红绿灯 20% 是正例),训练集 1,000 张,test 10,000 张,3 个种子平均:
| 做法 | 行人 | 车 | 停车标志 | 红绿灯 | 平均 |
|---|---|---|---|---|---|
| 标签齐全 | |||||
| 4 个网络分开训练 [32, 64, 64, 1] × 4 | 23.9% | 26.0% | 13.8% | 18.4% | 20.5% |
| 1 个网络 4 个输出 [32, 64, 64, 4] | 23.3% | 25.8% | 13.4% | 18.1% | 20.2% |
| 每个标签有 50% 缺失 | |||||
| 4 个网络分开训练(各用自己有标签的图) | 24.9% | 26.8% | 14.3% | 19.1% | 21.2% |
| 多任务 + 掩码 | 25.5% | 26.4% | 14.7% | 19.1% | 21.4% |
| 多任务,把缺失当成 0(错误做法) | 27.8% | 39.7% | 12.8% | 19.9% | 25.1% |
| 多任务,只用 4 个标签齐全的图 | 31.1% | 38.6% | 14.1% | 24.7% | 27.1% |
| 共享的网络很小(每层 4 个单元) | |||||
| 4 个网络分开训练 [32, 4, 4, 1] × 4 | 23.5% | 24.1% | 12.3% | 16.7% | 19.2% |
| 1 个网络 4 个输出 [32, 4, 4, 4] | 29.4% | 39.9% | 12.3% | 20.9% | 25.6% |
- 多任务学习在这里几乎没有收益(20.2% vs 20.5%)。这和我写代码前的预想不一样。我在草稿里还试了几种变化——每个任务只有 200–300 张图、20 个任务、每个任务的标签标在不同的图上——多任务都没有比分开训练好出随机波动以上的幅度。一个可能的解释:这 4 个任务的标签都标在同一批 1,000 张图上,一起学并没有多出新的图;而 Ng 说的收益来自”其他任务加起来的数据远多于单个任务”。演示 1 里 A 的 20,000 张图就是那种情况——所以迁移学习有效,而这里的多任务没有。多任务学习不是免费的午餐。
- 标签缺失时,掩码是正确做法(21.4%,和”各用各的标签分开训练”的 21.2% 差不多)。把缺失当成 0 是错的(25.1%):它等于告诉网络”这张图里没有车”。伤害最大的是正例最多的「车」(39.7% vs 掩码 26.4%)——一半的车被标成了”没有车”;正例只有 10% 的停车标志反而没受伤(12.8% vs 14.7%),对它来说”多判 0”本来就不太亏。只用标签齐全的图,平均每次只剩约 62 张,浪费了大部分数据(27.1%)。
- 网络太小时,多任务明显更差(25.6% vs 19.2%):4 个任务挤在每层 4 个单元里抢容量。这正是 Caruana 的条件:“足够大”是前提。(小网络分开训练反而比大网络分开训练好一点:1,000 张图对大网络来说偏少,第 6 讲的方差。)
11. 端到端学习 · End-to-end deep learning
11.1 什么是端到端
传统的系统常常是一条流水线(pipeline),由人设计好每一段。Ng 的语音识别例子:
流水线:  音频 ──→ 提取特征(MFCC)──→ 机器学习 ──→ 音素 ──→ 拼成词 ──→ 文字
端到端: 音频 ───────────────────────────────────────────────────────→ 文字端到端学习(end-to-end learning)用一个大网络直接学 ,跳过人设计的中间步骤。Ng 的观察是:数据少(比如 3,000 小时)时,流水线往往更好;数据很多(10,000–100,000 小时)时,端到端开始显示威力。
11.2 三个例子
- 门禁人脸识别:摄像头拍到的图里,人可能离得远、在画面的任何位置。直接”整张图 → 这是谁”很难;实际的系统分两步:先检测并裁出人脸,再把裁好的脸和数据库比对(第 5 讲的人脸验证)。为什么两步更好?每一步都更简单,而且每一步都有大量的数据(人脸检测的数据很多,人脸比对的数据也很多);而”整张门禁照片 → 身份”这样的端到端数据很少。
- 机器翻译:过去是”英文 → 文本分析 → …… → 法文”的长流水线;今天端到端(第 16–17 讲的 seq2seq、Transformer)效果最好,因为 (英文, 法文) 句子对的数据非常多。
- 从儿童手部 X 光片估计年龄:流水线是”图像 → 找出骨头、量骨长 → 按骨长查表得年龄”;端到端是”图像 → 年龄”。Ng 认为这里流水线更好:每一段都容易,量骨长的数据也多;而 (X 光片, 年龄) 的数据少,不够学一个复杂的端到端映射。
11.3 优缺点
优点:
- 让数据说话(let the data speak):不强迫网络去学人想出来的中间表示。音素就是一个例子——它是语言学家的发明,网络不一定需要它;
- 少设计手工组件:省去设计、调试每一段的工作。
缺点:
- 可能需要大量的 数据;
- 排除了可能有用的手工设计:数据少时,人的知识(好的特征、好的中间表示)是把知识注入系统的主要途径(第 1 讲 §4.3 的”专家特征”)。
关键问题(Ng 的原话大意):你有没有足够的数据,去学一个复杂度足以把 映射到 的函数?
11.4 实验:数据量决定走哪条路
代码 05 把 X 光片的例子做成了合成世界:(32 维”图像”)经过一个两层随机网络,得到 4 个”骨长” 和 1 个不在 里的”骨密度” ;标签 = 年龄分数 是否大于中位数。流水线的第 1 段用 20,000 张”量过骨长”的图学 (在新图上 ),第 2 段用和端到端同样多的 数据学 ;端到端直接学 。每格 2 个种子的平均 test 错误率:
| α = 0(骨长包含全部信息) | 100 | 300 | 1000 | 3000 | 10000 | 30000 |
|---|---|---|---|---|---|---|
| 端到端 [32, 64, 64, 1] | 27.2% | 22.7% | 20.6% | 19.8% | 18.0% | 14.3% |
| 流水线(第 2 段 [4, 16, 1]) | 15.9% | 14.2% | 13.7% | 13.4% | 13.5% | 13.4% |
| 对照:第 2 段用真实骨长 | 9.5% | 8.3% | 7.8% | 7.8% | 7.8% | 7.8% |
| α = 0.8(骨长之外还有骨密度) | 100 | 300 | 1000 | 3000 | 10000 | 30000 |
|---|---|---|---|---|---|---|
| 端到端 [32, 64, 64, 1] | 29.3% | 25.2% | 24.9% | 22.6% | 20.2% | 17.6% |
| 流水线(第 2 段 [4, 16, 1]) | 22.8% | 21.6% | 21.0% | 20.9% | 20.5% | 20.8% |
| 对照:第 2 段用真实骨长 | 17.8% | 17.2% | 16.8% | 16.7% | 16.3% | 16.4% |
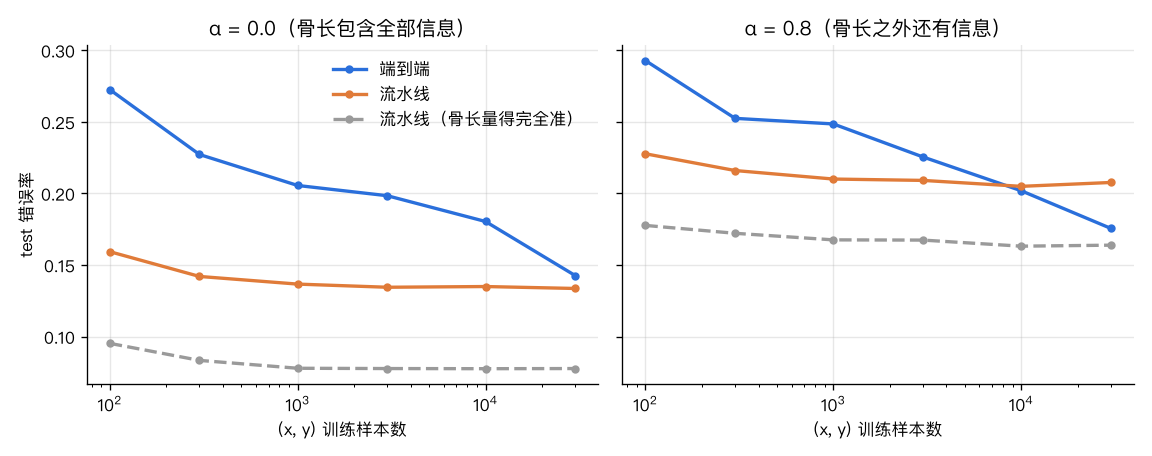
- 数据少时流水线大胜:100 个样本时(α = 0)流水线 15.9%、端到端 27.2%。第 1 段借用了 20,000 张”量过骨长”的图,第 2 段只需要学一个 4 维输入的小问题;端到端要从 100 个样本里同时学会”看骨头”和”骨长 → 年龄”。
- α = 0(中间表示是”对的”):在整个 100–30,000 的范围里流水线都占优,30,000 时 13.4% vs 14.3%。它的瓶颈是第 1 段量得不够准:用真实骨长时 7.8%。要改进这条流水线,该改进的是第 1 段——能分段看误差,本身就是流水线的好处之一(Machine Learning Yearning 里叫”error analysis by parts”)。
- α = 0.8(中间表示漏了东西):流水线从 3,000 起几乎不动(20.9% → 20.8%);就算骨长量得完全准,也停在 16.4% 左右——骨密度不在中间表示里,它永远看不见。端到端从 10,000 起反超,30,000 时 17.6%,而且还在下降。
所以要问的不是”端到端好不好”,而是”我有没有足够的 数据去学完整的映射,人设计的中间表示有没有漏东西”。(交叉点在哪里只在这个世界里成立;世界的参数是我设定的。)
11.5 自动驾驶:不是纯端到端
Ng 最后用自动驾驶说明,实践中常常是混合的:
图像 / 雷达 / 激光雷达 ──(深度学习)──→ 车、行人的位置 ──(运动规划)──→ 路线 ──(控制)──→ 方向盘、油门、刹车感知用深度学习(数据多、人很难手工写规则);规划和控制用传统方法(有成熟的理论、需要可解释和可验证)。有研究尝试”图像 → 方向盘”的纯端到端(见延伸阅读的 Bojarski et al. 2016),但 Ng 在课上的判断是:当时的数据量下,这条路不是最有前途的。每一段用什么方法,取决于这一段有多少数据、这一段的任务有多简单。
12. 两个案例 · Case studies(改编)
C3 的两个测验是”模拟的决策练习”:给你一个项目,问你每一步怎么做。原题不公开,下面按它们考察的决策点改编,数字是我设定的。先自己回答,再看括号里的提示。
12.1 Peacetopia 的鸟
和平城 Peacetopia 的上空有很多鸟,会撞上飞机、无人机。市政府请你做一个系统:从城市各处安全摄像头拍到的天空照片里,判断”有没有鸟”。你有约 1,000 万张有标注的照片。
- 市长说”准确率要高,识别一张不超过 10 秒,模型不超过 10 MB”。这三个指标怎么用?(§3:准确率是 optimizing,时间和内存是 satisficing。)
- 数据怎么分?(§4.2:1,000 万张时 dev、test 各几万张就够,比如 95/2.5/2.5 或更极端。)
- 热心市民送来 100 万张别的城市的鸟照片,有人建议加进 test 集。(§4.1:不行——test 必须反映你在乎的分布;可以考虑加进训练集,再用 §8 的方法诊断。)
- 请了四个人标一部分 dev:两位观鸟专家错误率 0.4%、0.6%,两位普通市民 1.1%、1.5%。你的模型训练 2.0%、dev 2.2%。下一步?(§5:人类水平取 0.4%(如果专家能讨论后给结论,可能更低);可避免偏差 1.6% ≫ 方差 0.2%,先治偏差:更大的网络、训练更久。)
- 几个月后,训练 0.3%、dev 0.35%,已经低于最好的专家。(§5.4:不再知道 Bayes 在哪里,进展会变慢;人工误差分析也变难。)
- 一种新的外来鸟出现了,只有 1,000 张照片,现有系统经常漏掉它。(§4.4:把它加进 dev / test,必要时调整指标;训练集里也加上,或者用数据增强、迁移学习。)
- 训练一次要两周。(第 1 讲 §4.5、本讲 §6.5:迭代太慢是头号敌人——先在小一些的数据、小一些的模型上快速试,或者买更多算力。)
12.2 自动驾驶
一家初创公司要从车载前置摄像头的图像里识别:停车标志、人行横道标志、施工标志、红灯、绿灯(一张图可能同时有好几个)。
- 输出层怎么设计?损失怎么写?(§10:5 个 sigmoid 输出,多标签的二元交叉熵之和;不是 softmax。)
- 你有 10 万张自己车上拍的图(这是你在乎的分布),还能从网上下载 90 万张路标图。怎么分?(§8.1:网络图片全放进训练集;自己拍的图一部分进训练集,dev / test 只用自己拍的。)
- 第一件事做什么?(§6.5:花几天搭一个基础模型,看它犯什么错,而不是先花几周设计”完美”的系统。)
- 五个误差:人类水平 0.5%,训练 7%,train-dev 7.5%,dev 13%,test 13.5%。最大的问题?(§8.2:可避免偏差 6.5% 和数据不匹配 5.5% 都大,方差只有 0.5%;先治偏差,同时做 train 和 dev 的人工对比。)
- dev 错例里:雾天占 40%,挡风玻璃上的雨滴占 15%,标签错误占 10%。同事说”雨滴的问题装个雨刮就能解决”。(§6:雨刮最多让错误率降到原来的 85%;雾天的天花板更高。)
- 你从网上找来 1,000 张雾的照片,叠加到晴天的路面图上合成”雾天”。人看着很逼真,所以一定有用?(§8.3:不一定。1,000 张雾只覆盖了所有雾的一小块,网络可能过拟合这些雾。)
- 同事要识别黄灯,只有 100 张图。(§9:用你的模型做迁移学习——输入相同,你的数据多得多,低层特征有用。)另一个同事想用车外的麦克风”听”周围有没有车。(不适合从你的视觉模型迁移:输入不同。)
13. 小结 · Summary
- 正交化:四个目标(训练集 → dev → test → 真实世界)各有自己的旋钮,诊断出哪一环有问题就只拧那一环的旋钮。early stopping 同时动了①和②,所以不正交(第 6 讲 §6.3)。
- 单一数字评估指标:类别不平衡时准确率会骗人(Section 8 的例子里准确率最高的模型一个病人都没找到;筛查任务里”永远判健康”95.65%)。precision / recall 各赢一个时用 F1(调和平均: 时 F1 只有 0.020)。阈值也是超参数:dev 上选的阈值让 test F1 从 0.387 升到 0.493。F1 对参数是台阶函数,梯度处处为 0,所以训练用交叉熵当代理。
- satisficing + optimizing:N 个指标里 1 个最大化、其余过线。“只看准确率”挑中了设备跑不动的大网络(recall 0.244);“时延 ≤ 10 ms、误报率 ≤ 1%、recall 最高”挑中 recall 0.343 的候选。硬凑公式的系数没有道理可讲;在 dev 上卡紧的约束到 test 上可能略超(1.004%)。
- dev / test:同分布,反映你将来在乎的数据;dev + 指标就是靶子。指标不反映真实需要时改指标(不良图片权重 10:普通错误率 A 好,加权错误率 B 好),数据不反映真实需要时改 dev / test。先定靶子,再瞄准。
- 人类水平是 Bayes 错误率的代理,用能达到的最好的那个(医生小组 0.5%)。可避免偏差 = 训练 − 人类,方差 = dev − 训练。离人类水平越近,代理的选择越关键;超过人类之后失去方向感,进展变慢。结构化数据上机器早已超过人类。
- 误差分析:随机拿约 100 个 dev 错例,逐个归类,算天花板(狗只占 9%:7.69% → 7.00%)。100 个足以分清差别大的类别,分不清接近的类别(63%)。天花板不等于收益:10 倍数据时模糊的错例只从 537 降到 477——要问”人能不能做对”。先快速做出第一个系统,才有错例可分析。
- 错误标签:训练集里随机的少量错误伤害不大(11.7% 随机错误:6.42% → 7.56%),系统性的伤害很大(大型猫科全标成猫:14.08%)。dev 里看标签错误占错例的比例决定要不要清理;dev 和 test 一起清理;判对的也要看(只复查判错的:测得 6.05% < 真实 6.25%)。
- 分布不同:dev / test 只用你在乎的数据(方案 1 的 dev 说 6.7%,真实 17.2%)。用 train-dev 把误差拆成可避免偏差、方差、数据不匹配、对 dev 过拟合。处理数据不匹配:人工对比训练和 dev,让训练数据更像 dev。人工合成有效(18.9% → 12.8%),但只用 1 份素材会过拟合那份素材(18.1%)。
- 迁移学习:输入相同、A 的数据多得多、A 的低层特征对 B 有用时有效(30 张时 39.4% → 25.8%);B 的数据越少收益越大;A 的特征不相关时冻结它比从零还差。
- 多任务学习:一张图多个标签,多个 sigmoid,缺失的标签用掩码(当成 0 是错的:「车」39.7%)。在这里几乎没有收益(20.2% vs 20.5%);网络太小时明显有害(25.6% vs 19.2%)。实践中迁移学习用得多得多。
- 端到端:让数据说话、少手工设计,但需要大量 数据,还排除了有用的手工设计。数据少时流水线大胜(15.9% vs 27.2%);中间表示漏了信息时,端到端在数据多了以后反超(10,000 起;30,000 时 17.6% vs 20.8%)。关键问题:有没有足够的数据学完整的映射。
14. 常见误区 · Common pitfalls
- “准确率 96% 就是好模型。” 正例只占 4% 时,“永远判阴性”就有 96%。先看正例比例,再看 precision / recall 或 AP(§2.4)。
- “F1 是我们的目标,那就直接优化 F1。” F1 对参数几乎处处导数为 0,梯度下降没法用。训练用交叉熵,选阈值时用 F1(§2.5)。
- “阈值就用 0.5。” 0.5 只是”尽量少犯错”在先验和代价都对称时的选择。阈值要按你的指标在 dev 上选,在 test 上验证(§2.4、§3.2)。
- “把所有指标加权合成一个数最客观。” 系数往往没有道理可讲;用 satisficing + optimizing 更清楚(§3)。
- “dev 集反正是用来调参的,从哪里来无所谓。” dev 是靶子:dev 来自网络图片、用户用手机,你几个月都在瞄错的靶子(§4.1、§8.1)。
- “指标说 A 好,但我觉得 B 好,那就选 B。” 应该改指标,让它说出你的直觉——否则下一次比较时同样的分歧会再来一遍(§4.3)。
- “训练误差和人类水平一样了,偏差已经没了。” 人类水平只是 Bayes 的上界。合成世界里最好的”人”比 Bayes 高 1.2 个百分点;离得越近,这个差越要紧(§5.3、§8.2)。
- “误差分析里占比最大的那一类最该做。” 天花板最大不等于收益最大:如果那一类错误人也做不对(信息已经丢了),再努力也收效甚微(§6.4)。
- “只复查模型判错的 dev 样本就够了。” 会让 dev 错误率偏乐观(§7.3);而且 dev 清理了、test 没清理,两者就不再同分布。
- “训练和 dev 分布不同,所以 dev 误差高一定是数据不匹配。” 也可能是方差。没有 train-dev,你分不清(§8.2 的做法 B)。
- “合成数据人看着很真,就一定有用。” 它可能只覆盖了真实变化里很小的一块;网络会过拟合那一块(1 份杂乱素材:18.1%,比不加杂乱还差,§8.3)。
- “迁移学习、多任务学习总会有帮助。” 迁移要求低层特征对新任务有用(不相关的 A’ 冻结后比从零还差);多任务在这里几乎没收益、网络小时有害(§9、§10)。
- “端到端是更先进的做法。” 数据少时它输给流水线一大截(§11.4);先问有没有足够的 数据。
15. 练习 · Exercises
练习 1(precision、recall、F1)。一个唤醒词检测器在 1,000 段录音上测试,其中 60 段说了唤醒词。检测器在 50 段上被唤醒,其中 40 段是对的。(a) 写出 TP、FP、FN、TN。(b) 算准确率、precision、recall、F1。(c) “从不唤醒”的准确率是多少?(d) 另一个检测器 precision 0.9、recall 0.5,按 F1 谁更好?
参考答案
(a) TP = 40,FP = 50 − 40 = 10,FN = 60 − 40 = 20,TN = 1000 − 40 − 10 − 20 = 930。 (b) 准确率 = (40 + 930)/1000 = 0.97;precision = 40/50 = 0.8;recall = 40/60 ≈ 0.667;F1 = 2·40/(2·40 + 10 + 20) = 80/110 ≈ 0.727。 (c) 940/1000 = 0.94。准确率 0.97 只比它高 3 个百分点。 (d) F1 = 2·0.9·0.5/(0.9 + 0.5) ≈ 0.643 < 0.727,第一个更好。但如果产品要求是”每天误唤醒不超过 X 次”,应该在那个约束下比 recall(§3),而不是比 F1。
练习 2(satisficing + optimizing)。要求:识别一张图不超过 10 秒、模型不超过 10 MB,准确率越高越好。五个模型:A(96%,2 秒,4 MB)、B(99%,14 秒,8 MB)、C(97%,4 秒,1 MB)、D(98%,9 秒,12 MB)、E(97.5%,8 秒,6 MB)。选哪个?如果把内存上限放宽到 15 MB 呢?
参考答案
满足两个约束的是 A、C、E(B 太慢,D 太大),其中准确率最高的是 E(97.5%)。内存上限放宽到 15 MB 后 D 也满足了,选 D(98%)。注意 B 的准确率最高,但它从来不在候选里——satisficing 指标是硬约束,不是”扣分项”。
练习 3(可避免偏差)。观鸟任务里,两位专家的错误率是 0.4%、0.6%,两位普通市民 1.1%、1.5%。(a) 用哪个数做 Bayes 错误率的代理?(b) 模型训练 2.0%、dev 2.2%:先治什么?(c) 模型训练 0.5%、dev 1.4%:先治什么?(d) 训练 0.3%、dev 0.35%:你能下什么结论?
参考答案
(a) 0.4%(能达到的最好的人类水平;专家一起讨论后可能更低,Bayes 错误率只会 ≤ 0.4%)。 (b) 可避免偏差 1.6%,方差 0.2%:先治偏差(更大的网络、训练更久、换架构)。 (c) 可避免偏差 0.1%,方差 0.9%:先治方差(更多数据、正则化)。 (d) 训练误差已低于最好的人类水平,可避免偏差的估计变成负数,不知道离 Bayes 还有多远;人工误差分析也会变难(人看不出模型错在哪里)。这时进展通常会变慢。
练习 4(五个误差)。人类水平 1%,训练 2%,train-dev 2.5%,dev 8%,test 12%。(a) 算四个差距。(b) 最该担心的两个问题是什么?各拧哪个旋钮?(c) 如果 dev 是 9%、test 9%,但 train-dev 是 12% 呢?
参考答案
(a) 可避免偏差 1%,方差 0.5%,数据不匹配 5.5%,对 dev 过拟合 4%。 (b) 数据不匹配(人工对比训练集和 dev,收集或合成更像 dev 的训练数据,§8.3)和对 dev 过拟合(dev 太小、在上面挑了太多次:用更大的 dev 集,§1.3 的旋钮③)。先确认 dev 和 test 确实同分布——如果不是,test − dev 的差距就不是”过拟合”。 (c) train-dev 12% > 训练 2%:方差 10% 很大;dev 9% < train-dev 12%:dev 的分布比训练分布”更容易”(§8.2 提到的反直觉情况)。先治方差。
练习 5(天花板)。dev 错误率 12%。看了 200 个错例:模糊 70 个,狗 16 个,标签错误 24 个(可重叠)。(a) 三类各自的天花板是多少?(b) 一个去模糊的方法能修好 60% 的模糊错例,预计错误率是多少?(c) 清理标签值得吗?清理后模型变好了吗?
参考答案
(a) 模糊 35%:12% → 12% × 0.65 = 7.8%;狗 8%:12% → 11.04%;标签错误 12%:12% → 10.56%。 (b) 12% − 0.6 × 12% × 0.35 = 12% − 2.52% = 9.48%。 (c) 标签错误占 12% 的错例(1.44 个百分点),介于 Ng 的两个例子之间;如果你要用 dev 比较的方案之间只差一两个百分点,值得清理。清理只改变测量,不改变模型——测得的错误率会下降约 1.44 个百分点,但模型在真实数据上的表现一点没变。清理时 dev 和 test 一起做,并抽查判对的样本(§7.3)。
练习 6(加权错误率)。dev 有 1,000 张图,其中 30 张是不良图片(权重 10),其余权重 1。模型 A 在普通图片上错了 40 张,放行了 6 张不良图片;模型 B 在普通图片上错了 60 张,放行了 1 张。分别算普通错误率和加权错误率。
参考答案
。 A:普通错误率 46/1000 = 4.6%;加权 (40 + 6 × 10)/1270 = 100/1270 ≈ 7.87%。 B:普通错误率 61/1000 = 6.1%;加权 (60 + 1 × 10)/1270 = 70/1270 ≈ 5.51%。 普通错误率说 A 好,加权错误率说 B 好——和代码 01 演示 4 一样的翻转。
练习 7(只复查判错的样本,偏多少)。dev 有 10,000 张图,模型的真实错误率 5%,2% 的标签随机标错了(和模型对错无关,二分类)。(a) 不清理时,测得的错误率是多少?(b) 只复查”测得判错”的样本并改正标签之后,测得多少?(c) 为什么 (b) 比真实值低?
参考答案
(a) 模型对、标签错(0.95 × 0.02 = 1.9%)被算成错;模型错、标签也错(0.05 × 0.02 = 0.1%,二分类时标错的标签恰好等于模型的错误预测)被算成对。测得 5% − 0.1% + 1.9% = 6.8%。 (b) 复查测得判错的样本,修好那 1.9%;那 0.1% 看起来是”判对了”,没人复查。测得 5% − 0.1% = 4.9%。 (c) 只复查判错的样本时,你修好的每一个标签都在帮模型”翻案”,而”错得一样”的那些永远不会被发现。代码 02 演示 3 里是 6.05% vs 真实 6.25%(漏掉 20 个)。
练习 8(多任务损失与掩码)。两张图、三个任务。图 1:,;图 2:,。(a) 用掩码、对有标签的项取平均,损失是多少?(b) 用 Ng 的写法 (只对有标签的 求和),是多少?(c) 如果把 ”?” 当成 0、对 6 项取平均呢?
参考答案
有标签的 4 项:,,,,和为 0.9083。 (a) 0.9083 / 4 ≈ 0.2271。 (b) 0.9083 / 2 ≈ 0.4542。两种写法只差一个常数倍,梯度方向相同。 (c) 再加上 和 :(0.9083 + 0.9163 + 0.6931)/6 ≈ 0.4196。多出来的两项在惩罚模型”图 1 里可能有任务 3 的目标”——而我们根本不知道有没有。
练习 9(改代码,先预测再运行)。在 04_transfer_and_multitask.py 的 make_tasks 里,把 ro_A = [shared.new_readout() for _ in range(10)] 改成 ro_A = [shared.new_readout() for _ in range(10)][:2](A 只保留 2 个属性;这样写是为了让 B 的读出方向保持不变),并把 pretrain 里的 make_net([N_X, 64, 64, 10], seed) 改成 make_net([N_X, 64, 64, Y.shape[1]], seed)。先预测:“预训练 A + 只训练输出层”那一行会怎样变?“全部微调”呢?然后运行验证。
参考答案
预测:A 只剩 2 个属性,预训练的网络只需要表示 8 个低层特征里和这 2 个属性有关的部分,冻结后的特征覆盖不了 B 需要的全部方向——“只训练输出层”应该明显变差,而且 B 的数据多了也补不回来(冻结的层不再更新);“全部微调”受的影响小一些,因为前面的层还能为 B 调整。
我运行的结果(3 个种子平均;B 有 30 / 100 / 300 / 1000 / 3000 张):
| 30 | 100 | 300 | 1000 | 3000 | |
|---|---|---|---|---|---|
| 从零训练(不变) | 39.4% | 31.3% | 24.8% | 22.3% | 21.2% |
| 只训练输出层:A 有 10 个属性(原来) | 25.8% | 21.1% | 18.1% | 16.8% | 16.2% |
| 只训练输出层:A 只有 2 个属性 | 32.7% | 27.7% | 22.1% | 20.7% | 20.2% |
| 全部微调:A 只有 2 个属性 | 32.4% | 26.9% | 22.3% | 19.8% | 19.4% |
冻结的特征仍然比从零训练好,但收益小了很多(30 张时从 13.7 个百分点缩到 6.7 个);而且从 1,000 张起,全部微调反超了只训练输出层——A 的特征覆盖得不全时,前面的层需要为 B 调整,这正是 Ng 说的”数据多一些就重训全部”的情形。条件 3 不是”是 / 否”,而是”A 的特征覆盖了 B 需要的多少”。
练习 10(端到端还是流水线)。对每个场景说出你的选择和理由:(a) 公司门禁,有 1,000 万张公开的人脸照片和 50 万对”同一个人 / 不同的人”的人脸对,但只有 5,000 张门禁摄像头拍的、标了身份的照片;(b) 英中翻译,有 1 亿个句子对;(c) 从 X 光片估计儿童年龄,有 800 张标了年龄的 X 光片,以及大量标了骨头位置的医学影像;(d) 一个已经用流水线做到不错水平的语音识别系统,公司刚收购了 10 万小时带文字的录音。
参考答案
(a) 流水线:先检测、裁出人脸(检测数据多),再做人脸比对(人脸对的数据多);端到端的门禁数据只有 5,000 张,太少。 (b) 端到端:(x, y) 数据非常多,不需要人设计中间表示。 (c) 流水线:端到端的数据太少;量骨长这一步可以借用大量的骨骼标注,“骨长 → 年龄”的规律也有现成的医学知识。 (d) 值得试端到端:10 万小时已经是 Ng 说的”端到端开始显示威力”的量级;可以和现有流水线在同一个 dev 集上比,用指标说话。
16. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C3 “Structuring Machine Learning Projects”(Andrew Ng)——本讲的主体,包括两个案例测验。
- Andrew Ng, Machine Learning Yearning(免费电子书)——C3 的展开版。和本讲最相关的章节:开发集和测试集怎样建、单一数字指标、optimizing 与 satisficing 指标、误差分析(包括 eyeball / blackbox dev set)、清理标错的样本、和人类水平比较、在不同分布上训练和测试、数据不匹配与人工合成数据、端到端学习的利弊与”按部分做误差分析”。
- CS230 Section 8 “Advanced Evaluation Metrics”(公开网页,https://cs230.stanford.edu/section/8)——precision / recall / F1 的病人例子,以及目标检测、NLP、GAN 的评估指标。
- CS230 Section 3 “Implementation First Steps”(公开网页,https://cs230.stanford.edu/section/3)——先建 baseline、先在小数据上过拟合。
评估指标
- Davis & Goadrich (2006). The relationship between Precision-Recall and ROC curves. ICML.
- Saito & Rehmsmeier (2015). The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets. PLoS ONE.
标签错误
- Northcutt, Athalye & Mueller (2021). Pervasive label errors in test sets destabilize machine learning benchmarks. NeurIPS Datasets and Benchmarks Track. ——常用基准的测试集里平均约 3% 的标签是错的,足以改变模型的排名。
人类水平与医学任务
- Esteva et al. (2017). Dermatologist-level classification of skin cancer with deep neural networks. Nature.
- Rajpurkar et al. (2017). CheXNet: Radiologist-level pneumonia detection on chest X-rays with deep learning. arXiv:1711.05225.
- Hannun et al. (2019). Cardiologist-level arrhythmia detection and classification in ambulatory electrocardiograms using a deep neural network. Nature Medicine.
迁移学习、多任务学习、合成数据
- Yosinski, Clune, Bengio & Lipson (2014). How transferable are features in deep neural networks? NeurIPS. ——前几层的特征通用、后几层的特征专用;任务越不相似,迁移越差。
- Pan & Yang (2010). A survey on transfer learning. IEEE TKDE.
- Caruana (1997). Multitask learning. Machine Learning 28. ——多任务学习的经典论文。
- Ruder (2017). An overview of multi-task learning in deep neural networks. arXiv:1706.05098.
- Tobin et al. (2017). Domain randomization for transferring deep neural networks from simulation to the real world. IROS. ——合成数据要有足够的多样性,才能迁移到真实世界(和 §8.3 的”1 份素材”相对照)。
端到端学习
- Hannun et al. (2014). Deep Speech: Scaling up end-to-end speech recognition. arXiv:1412.5567.
- Bojarski et al. (2016). End to end learning for self-driving cars. arXiv:1604.07316.
17. 下一讲预告 · Next lecture
本讲给了你一套做决定的方法:一把尺子(单一数字指标、satisficing / optimizing),一个参照物(人类水平),一个放大镜(误差分析),一个新的诊断(train-dev 与数据不匹配),以及三种”借力”的方式(迁移、多任务、端到端)。但我们一直是在一个个孤立的小世界里用它们。
第 11 讲:深度学习项目的完整周期——从想法到部署。 把这些方法放进一个完整的项目里:
- 选题与可行性:怎样判断一个想法值不值得做,数据从哪里来;
- 先快速做一个 baseline(本讲 §6.5),然后用 bias / variance 分析和误差分析决定每一轮迭代做什么;
- 调试清单:先让模型在一个 batch 上过拟合、检查数据管道、检查损失是否合理(CS230 Section 7 的”四类错误”);
- 从模型到系统:部署、延迟(本讲 §3 的 satisficing 指标在真实系统里的样子)、监控,以及部署以后数据分布还会变——本讲 §8 的数据不匹配在时间上的版本:数据漂移;
- 以语音激活设备为主线的完整案例,以及 AI + 医疗里的特殊挑战(标签噪声、专家水平作为基准、分布漂移)。
从下一讲起,你看到的每个实验都可以用本讲的语言来读:“这一轮该拧哪个旋钮?”