对应 Maps to:Coursera Deep Learning Specialization C2M3 “Hyperparameter Tuning, Batch Normalization and Programming Frameworks”(Tuning Process、Using an Appropriate Scale to pick Hyperparameters、Hyperparameters Tuning in Practice: Pandas vs. Caviar、Normalizing Activations in a Network、Fitting Batch Norm into a Neural Network、Why does Batch Norm work?、Batch Norm at Test Time、Softmax Regression、Training a Softmax Classifier、Deep Learning Frameworks、TensorFlow);编程作业 “TensorFlow Introduction”(SIGNS 手势数据集,数字 0–5 六类的 softmax 分类);Stanford CS230 Fall 2025 Section 5 “PyTorch/TensorFlow”。在 Fall 2025 的安排里,C2M3 和课堂 Lecture 5(深度强化学习,本讲义第 19 讲)放在同一周。 依据说明:Coursera 的视频和作业、Fall 2025 的 section 材料都不对外公开。本讲依据 C2M3 里广为人知的内容来写:Ng 的超参数重要性排序、对数尺度采样、“熊猫 vs 鱼子酱”、BN 的公式与 covariate shift 的直觉、softmax 的例子、选框架的三条标准。视频里的具体例子(比如 )是凭记忆复述的,细节可能和原视频略有出入。BN 部分另外依据原论文(Ioffe & Szegedy 2015)和之后的争议(Santurkar et al. 2018;Bjorck et al. 2018),超参数搜索部分依据 Bergstra & Bengio (2012),见 §9。原作业用 TensorFlow,本讲义改用 PyTorch:CS230 的课程项目大多用 PyTorch;两个框架的核心概念(张量、自动微分、层、优化器、数据加载)一一对应,学会一个,另一个看文档就能上手。 配套代码 Code:
code/lecture09/(从本讲起用 PyTorch;5 个脚本 + 3 个模块,其中torch_utils.py是后面各讲都能导入的训练循环模板;每个脚本 1–15 秒) 预计阅读时间:3 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说出 Ng 的超参数重要性排序,解释为什么”只有少数几个超参数真正重要”时随机搜索胜过网格搜索,会做由粗到细的搜索,并知道噪声(换种子的波动)会怎样干扰它。
- 在对数尺度上为学习率采样,对 取对数为 采样,并用平均窗口 解释为什么 越接近 1 越敏感;知道”熊猫”和”鱼子酱”两种调参方式各适合什么情况。
- 写出 Batch Normalization 的前向公式,说清 、、 各自的作用、为什么加了 BN 之后偏置 是多余的;推导 BN 的反向传播;知道训练时和测试时的区别(running mean / var),以及忘了
model.eval()的后果。 - 讲清 BN 为什么有用的两种解释(internal covariate shift vs 损失曲面更平滑)和各自的证据,知道 BN 的轻微正则化效果和它的局限(小 batch、序列模型、LayerNorm)。
- 写出 softmax 和多分类交叉熵,推导 ,说明 时 softmax 回归就是逻辑回归;会用”减最大值”和 log-sum-exp 写出数值稳定的版本,知道为什么
nn.CrossEntropyLoss收的是 logits。 - 说清框架替你做了什么:张量与 dtype、反向模式自动微分(计算图)、
nn.Module、torch.optim、DataLoader、device;能把第 1–8 讲的 numpy 代码翻译成 PyTorch,并且在 float64 下逐数字对上。 - 用一个标准的 PyTorch 训练循环模板做完一个小项目(数据 → 模型 → 训练 → 调参 → 最后只看一次 test),并避开从 numpy 迁移到框架时最常见的坑。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开 Previewed only |
|---|---|
| 第 4 讲 §6:参数 vs 超参数;学习率 × 深度的扫描;“种子波动和结构差距同一量级” | 贝叶斯优化、Hyperband 等自动调参方法(§1.6 只点名) |
| 第 6 讲:dev set 用来选模型;dropout 在训练和测试时行为不同 | 卷积层后面的 BN(第 12–13 讲);Transformer 里的 LayerNorm(第 17 讲) |
| 第 7 讲:输入归一化让损失曲面”更圆”;He / Xavier 初始化;梯度检验 | GPU、混合精度、多卡训练(§4.2 只给直觉) |
| 第 8 讲:mini-batch、指数加权平均(EWA)、Momentum、Adam | 用 softmax 预测下一个词(第 15–17 讲);采样时的温度(第 20 讲) |
| 第 2 讲:sigmoid + 交叉熵的 ;第 5 讲 §1.3:多标签 vs 多类别 | TensorFlow / JAX 的具体写法(概念相同,§4.1) |
这一讲是 Part II”改进深度神经网络”的收尾,内容有四块,彼此相对独立:怎样调超参数(§1)、一个让深网好训练得多的层(§2)、多分类的输出层(§3)、从 numpy 换到框架(§4)。最后 §5 用 PyTorch 把它们串起来做一个小项目。从这一讲起,代码用 PyTorch——但每样新东西,我们都先用 numpy 写一遍,再和 PyTorch 逐数字对照,这样你知道框架的每一行背后在算什么。
0.3 本讲地图 Map
§1  超参数调优:重要性排序;随机 vs 网格;由粗到细;合适的尺度;熊猫 vs 鱼子酱          ← 代码 01
§2  Batch Normalization:公式、γ 与 β、放进网络、反向传播、测试时、为什么有用、局限     ← scratch_layers.py、代码 02
§3  Softmax 回归:定义、线性边界、C = 2、多分类交叉熵、Ŷ − Y、数值稳定、训练          ← scratch_layers.py、代码 03
§4  深度学习框架:为什么用、张量、形状约定、自动微分、逐数字对照、训练循环模板、常见坑    ← torch_utils.py、代码 04
§5  综合:用 PyTorch 训练手势分类器,再系统地调一次参                                ← 代码 05
§6–10  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,补充本讲新增的)
| 符号 | 含义 | 形状:Ng 的列约定 / PyTorch 的行约定 |
|---|---|---|
| 类别数(softmax 的输出个数), | ||
| (logits) | 输出层的线性输出,还没有经过 softmax | / |
| 每个样本一个概率分布,各分量加起来等于 1 | / | |
| one-hot 标签:正确类别的位置是 1,其余是 0 | ;PyTorch 通常直接用整数类别,形状 | |
| 、 | 当前 mini-batch 上 每个单元的均值、方差 | |
| (Ng 写作 )、 | 标准化之后的 ;再缩放、平移之后的 | 和 相同 |
| 、 | BN 的可学习缩放、平移(这个 和动量的 只是撞了名字) | ;PyTorch 里叫 weight、bias,形状 |
| 防止除以 0 的小常数(PyTorch 默认 ) | ||
| (PyTorch) | 每一行一个样本,(§4.3) | |
| 对数尺度采样时的指数: |
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出。PyTorch 一律在 CPU 上单线程运行、固定种子,同一台机器上重复运行输出逐字相同(本讲没有计时类的数字)。代码 01 用的是一个”合成的 dev 误差函数”而不是真的训练,目的是把每种搜索方法重复几千次;其余实验用合成数据:三条螺旋臂(3 类)和 16×16 的合成手势图(6 类,SIGNS 的替身,见 multiclass_data.py)。手势图的噪声和平移幅度是我在草稿里试了几组之后选的,为了让”没有隐藏层 < 小网络 < 大一点的网络”这个层次清楚。有好几处结果和我写代码前的预想不一样(最明显的一处在 §4.5),讲义按实际结果来写,这些情况都列在代码 README 的”关于实验结果”里。
1. 超参数调优 · Hyperparameter tuning
1.1 从”试几个值”到”怎样试”
第 4 讲 §6 做过一次调参:1 / 2 / 4 / 8 个隐藏层 × 7 个学习率,28 次训练。那次实验留下了两个教训:可用的学习率范围随深度变化;同一组超参数换个种子,dev 准确率能差 0.006–0.027,和不同配置之间的差距是同一个量级,所以”单个种子挑出来的最好学习率带着运气”。
但第 4 讲只有两个超参数。学完第 6–8 讲,你手里的旋钮已经多了很多:
- 学习率 、学习率衰减;
- 动量的 ;Adam 的 、、;
- mini-batch 大小;
- 层数、每层的单元数;
- L2 正则化的 、dropout 的保留概率(第 6 讲);
- ……
10 个超参数、每个试 3 个值的网格,就是 次训练。这不可能。所以要回答四个问题:哪些超参数值得调?怎样在有限的预算里试?在什么尺度上取值?算力怎么组织? 这一节逐个回答。
1.2 哪些超参数最重要
Ng 在 “Tuning Process” 里给过一个按颜色分级的排序(他也说这不是铁律,别的研究者可能有不同看法):
| 重要程度 | 超参数 | 常见的起点 |
|---|---|---|
| 第一 | 学习率 | 没有通用的默认值,几乎总要调 |
| 第二 | 动量 ;mini-batch 大小;隐藏单元数 | ;batch 取 64–512 之间的 2 的幂 |
| 第三 | 层数;学习率衰减 | |
| 几乎不调 | Adam 的 、、 | 、、 |
为什么学习率排第一?因为它和其他一切都纠缠在一起:同一个网络,学习率差 10 倍,结果可能从”学得很好”变成”一步都不动”或”全部 ReLU 死掉”(第 4 讲代码 05: 时 4 层网络 cost 卡在 )。而 Adam 的 只是防止除以 0 的一个小数,从 改成 几乎不会有任何影响。
这个排序的实际含义是:大多数时候,只有两三个超参数真正决定结果,其余的取个合理的默认值就行。 下一节会看到,这正是随机搜索胜过网格搜索的原因。
1.3 不要用网格,用随机 · Random search beats grid search
早期的机器学习(参数少的模型)常用网格搜索(grid search):两个超参数各取 5 个值,试全部 种组合。Ng 的建议是:在深度学习里,改用随机取点——同样试 25 次,每次每个超参数都随机抽一个值。
为什么?想象两个超参数是学习率 (很重要)和 Adam 的 (几乎不重要)。网格的 25 次试验里, 只有 5 个不同的值——另一个维度上的 5 次重复几乎白做,因为 不影响结果。随机搜索的 25 次试验里, 有 25 个不同的值。你事先不知道哪个超参数重要,随机搜索在每一个维度上都试了尽可能多的不同值。Bergstra & Bengio (2012) 把这个论证系统化了:很多问题的”有效维度”很低(只有少数几个超参数要紧,而且不同数据集上要紧的不是同一批),这时随机搜索比网格高效得多。
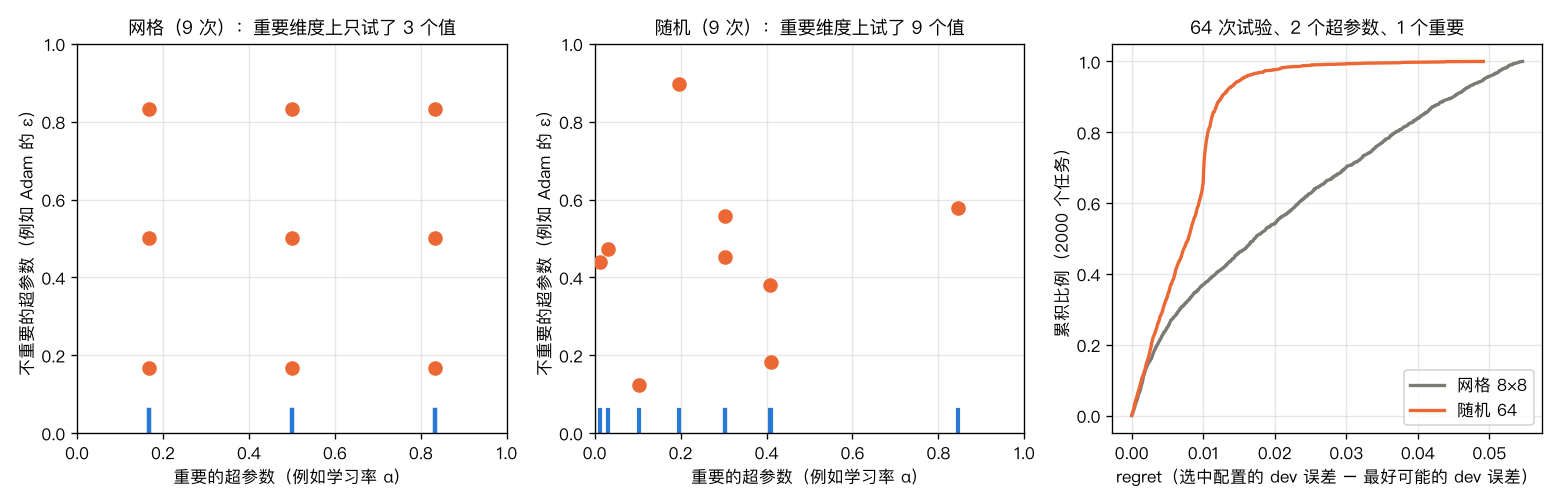
(左、中:9 次试验时,网格在重要维度上只试了 3 个值,随机试了 9 个——这一次具体的随机抽样碰巧扎堆在左边,单次运气好坏不重要;右:下面演示 1 里 2000 个任务上 regret 的累积分布,越靠左上越好。)
代码 01 演示 1 用一个”合成的 dev 误差函数”代替真的训练:每个超参数在 里取值,dev 误差在最优点处最低(0.05),每偏离一点就增加一些。重要维度最多能让 dev 误差涨 0.3,不重要维度最多 0.01。每个”调参任务”随机放置最优点,网格和随机各试 64 次,记录选出来的那组超参数离最好还差多少(regret,遗憾值),重复 2000 个任务:
| 个超参数 / 其中重要的 | 网格每维取值 | 网格 regret | 随机 regret | 随机更好的比例 |
|---|---|---|---|---|
| 2 / 1 | 8 | 0.0203 | 0.0077 | 0.714 |
| 3 / 1 | 4 | 0.0628 | 0.0140 | 0.758 |
| 6 / 1 | 2 | 0.1498 | 0.0337 | 0.884 |
| 6 / 2 | 2 | 0.2659 | 0.0933 | 0.881 |
| 2 / 2(对照组) | 8 | 0.0394 | 0.0610 | 0.398 |
(64 = 8² = 4³ = 2⁶,所以网格在 2、3、6 维时都能正好排满。网格每维取格子中心,比如 2 个值时取 0.25 和 0.75,这对网格已经算是公平的取法。)
三点观察:
- 只有 1 个维度重要时,随机明显占优: 时随机的平均 regret(0.0077)不到网格(0.0203)的一半。网格在重要维度上只试了 8 个值,随机试了 64 个。
- 维度越多,网格越糟: 时网格每维只能取 2 个值,重要维度上的最优值几乎总落在两个值之间,regret 涨到 0.1498;随机仍是 0.0337。真实的调参里,“不重要的维度”往往很多。
- 对照组很重要:两个维度都重要时(最后一行),网格反而略好(0.0394 vs 0.0610),随机更好的比例只有 0.398。网格排得均匀,随机点会扎堆、留空洞。所以随机搜索的优势来自”只有少数维度重要”,不是因为随机本身有什么魔力。
随机搜索还有几个实际的好处:预算可以是任意数(网格必须是 );可以随时加几次试验;某次训练崩了,不会在网格上留下一个”洞”。
1.4 由粗到细 · Coarse to fine
随机搜索之后,你通常会发现 dev 表现最好的几组超参数聚在某一片区域。Ng 的第二个建议:放大这片区域,在里面更密地再随机采样一轮。
代码 01 演示 2:3 个超参数(其中 2 个重要),预算 64 次。“由粗到细”先在整个范围里随机试 32 次,再在观测到的最好点周围 ±0.15 的方框里随机试 32 次。为了接近真实情况,每次”训练”观测到的 dev 误差都加上了噪声 (模仿换种子的波动):
| 观测噪声 | 网格 4×4×4 | 随机 64 | 粗 32 + 细 32 | (若看得到真实误差) | 方框套住最优值 |
|---|---|---|---|---|---|
| 0 | 0.1182 | 0.0700 | 0.0254 | 0.0254 | 91.8% |
| 0.005 | 0.1217 | 0.0698 | 0.0283 | 0.0275 | 90.7% |
| 0.02 | 0.1258 | 0.0732 | 0.0356 | 0.0287 | 91.3% |
(表中是平均 regret。“若看得到真实误差”:同样那 64 个点,如果能按真实误差挑,regret 是多少。“方框套住最优值”:细搜方框在 2 个重要维度上是否都包含真正的最优值。)
- 由粗到细明显更好:没有噪声时 regret 0.0254,纯随机 0.0700。后 32 次试验集中在有希望的区域里,等于把分辨率提高了好几倍。
- 它有风险:约 8–9% 的任务里,方框放错了地方,细搜的 32 次就白花了。
- 噪声的影响和我预想的不一样。我原以为噪声主要会让粗搜”选错区域”。实际上方框放得准不准几乎不受噪声影响(91.8% → 91.3%):粗搜阶段各点之间的真实差距(最多 0.3)远大于噪声。噪声伤害的是最后一步”挑最好的”:细搜阶段的点彼此很接近,真实误差只差零点零几,和噪声同一量级,按观测值挑出来的点 regret 0.0356,而同样 64 个点里真正最好的是 0.0287。
实践含义:粗搜之后放大范围时,看看排名靠前的几组是否落在同一片区域,而不是只盯着一个点;细搜阶段排名接近的几组,要换几个种子重跑再选。§5 在真实的小网络上会再看到这一点。
1.5 在合适的尺度上采样 · Using an appropriate scale
“随机取值”还有一个细节:在什么尺度上均匀?
有些超参数在线性尺度上均匀采样就可以:比如某一层的单元数 在 50 到 100 之间、层数 在 2 到 4 之间,Ng 认为直接均匀取即可(单元数范围更宽时,对数尺度往往更合适,§5 就是这样做的)。
学习率不行。 假设你认为 在 到 之间。在这个区间上线性均匀地取,90% 的样本会落在 ,只有 10% 落在 ——可是 、、、 这几个数量级同样值得试。学习率的效果取决于它的数量级: 和 差别很大, 和 几乎一样。所以应该在对数尺度上均匀采样:
写成代码就是 r = -4 * np.random.rand(); alpha = 10 ** r。一般地,想在 上对数均匀地取,就让 。
(动量、指数加权平均)要对 取对数。 假设 。第 8 讲说过, 的指数加权平均大约是”最近 个值的平均”: 约 10 个, 约 1000 个。所以要均匀覆盖的其实是 的数量级:
为什么 接近 1 时更敏感?平均窗口 对 的导数是 :在 处是 100,在 处是 。同样把 挪动一点点,在 0.999 附近造成的变化大一万倍。所以接近 1 的地方要采得更密——对 取对数恰好做到了这一点。
代码 01 演示 3 把这几件事算了出来:
| 学习率区间 | 线性均匀 | 对数均匀 |
|---|---|---|
| [0.0001, 0.001) | 0.0012 | 0.2471 |
| [0.001, 0.01) | 0.0093 | 0.2588 |
| [0.01, 0.1) | 0.0878 | 0.2452 |
| [0.1, 1) | 0.9017 | 0.2489 |
| 的采样方式 | 平均窗口 10–100 | 平均窗口 100–1000 |
|---|---|---|
| 线性均匀 | 0.9142 | 0.0858 |
| 对数均匀 | 0.4972 | 0.5028 |
| 窗口(前) | 窗口(后) | 变化 | |
|---|---|---|---|
| 0.9 → 0.9005 | 10.0 | 10.1 | 0.5% |
| 0.99 → 0.9905 | 100.0 | 105.3 | 5.3% |
| 0.999 → 0.9995 | 1000.0 | 2000.0 | 100.0% |
最后看它对搜索结果的影响:dev 误差只取决于 离最优值有多远(一个宽 0.3 个数量级的低谷),最优的 在 上随机,用 16 次试验去找:
| 采样方式 | 平均 regret | 找到的 与 相差不到 2 倍的概率 |
|---|---|---|
| 线性均匀 | 0.2318 | 0.205 |
| 对数均匀 | 0.0352 | 0.918 |
线性采样把几乎全部预算浪费在 这一个数量级上。采样尺度选得不理想时,由粗到细能部分补救(第一轮之后你会发现好的值都在小的那一端,于是缩小范围),但白白浪费了一轮预算。
1.6 熊猫 vs 鱼子酱 · Pandas vs Caviar
Ng 用两种动物养育后代的方式比喻两种调参风格:
| 熊猫(Panda) | 鱼子酱(Caviar) | |
|---|---|---|
| 比喻 | 熊猫一次只生很少的幼崽,倾注全部精力照看 | 鱼一次产几百万颗卵,不管单颗,靠数量取胜 |
| 做法 | 一次只训练一个模型,每天看学习曲线,手动调整(学习率降一点、加点正则化……),持续几天甚至几周 | 同时用不同的超参数训练很多个模型,最后挑最好的 |
| 适合 | 算力有限、模型很大、一次训练很贵(比如大型的视觉或语言模型) | 算力充足、单次训练不太贵 |
两者没有优劣之分,取决于你的算力和模型大小。现实中常常是混合的:先用鱼子酱式的小规模搜索确定范围,再用熊猫式的方式照看最终的大模型。
Ng 还提醒了一点:超参数的直觉会过时。数据变了、服务器换了、模型改了,几个月前调好的值未必还是最好;一个长期项目,隔几个月值得重新评估一次。另外,一个领域(比如视觉)的调参经验搬到另一个领域(比如语音、推荐)时,有时能用,有时不能,要验证。
随机搜索之外,还有更”聪明”的自动调参方法,本讲只点名:贝叶斯优化(根据已经试过的结果,决定下一次试哪里,Snoek et al. 2012);Hyperband / successive halving(先用很少的训练步数试很多配置,只让表现好的继续训练,Li et al. 2018);population-based training(一群模型一起训练,定期让差的复制好的、再扰动超参数,介于熊猫和鱼子酱之间,Jaderberg et al. 2017)。它们在大规模调参时很有用,但核心思想和本节一样:重要的维度要多试、要在合适的尺度上试、要提防噪声。
1.7 一张调参清单
把本节和第 4 讲 §6 合起来:
- 固定一个 dev set,所有比较都在它上面做;test set 留到最后只用一次(第 6 讲)。
- 先确定最重要的一两个超参数(几乎总是包括学习率),其余用默认值。
- 随机搜索,学习率等”按倍数起作用”的超参数在对数尺度上采样, 对 取对数。
- 第一轮范围放宽一些(学习率跨 3–4 个数量级);看结果,由粗到细缩小范围。
- 用较短的训练做初筛可以省时间,但要知道它偏向”起步快”的配置(比如大学习率)。
- 最后几名候选换几个种子重跑,看差距是否大于种子间的波动(第 4 讲 §6.2)。
- 选定之后,在 test set 上报告一次。
§5 会在真实的(小)网络上把这张清单走一遍。
2. Batch Normalization
2.1 动机:把输入归一化推广到每一层
第 7 讲讲过输入归一化:把每个输入特征减去均值、除以标准差,让它们的尺度相近,损失曲面就会”更圆”,梯度下降走得更快、更稳。
现在换个角度看一个深层网络。对第 层来说,它的”输入”是上一层的激活值 。如果能把 也归一化,第 层的 不就也更好训练了吗?可是 不是固定的数据——它是前面几层算出来的,而前面几层的参数每一步都在变。所以不能像输入那样”预处理一次”,必须在网络里、每一步、对每个 mini-batch 现场归一化。
这就是 Batch Normalization(批归一化,BN,Ioffe & Szegedy 2015)。归一化 还是归一化 (激活函数之前)?Ng 说这一点有一些争论,但实践中归一化 更常见,他也推荐把它当作默认做法;原论文也是放在非线性之前。
2.2 BN 做了什么
考虑某一层、某一个 mini-batch 里的 个样本,这一层的线性输出是 (每个都是 维的向量,下面的运算对每个单元分别做):
然后用 代替 送进激活函数:。
- 前三步是标准化:每个单元在这个 mini-batch 上变成均值 0、方差(约)1。 防止 时除以 0;正因为有它,标准化后的方差是 0.999999 而不是严格的 1(代码 02 演示 1)。
- 第四步用两个可学习的参数 、 再把均值和方差”调回去”。
为什么要 和 ? 因为”均值 0、方差 1”不一定是隐藏单元最好的分布。比如激活函数是 sigmoid 时,把所有 都挤在 0 附近,等于只用了 sigmoid 中间那段近似直线的部分——网络就失去了非线性。有了 、,网络可以自己学出想要的均值和方差。特别地,当
时,,BN 变成恒等变换(代码 02 演示 1:最大差 1.8e−15)。所以 BN 不会削弱网络的表达能力:最坏情况下它可以学会”什么都不做”。、 和 、 一样,由梯度下降(或 Momentum、Adam)更新。
2.3 把 BN 放进网络
对每个带 BN 的隐藏层,前向传播变成:
注意 里没有偏置 。原因是:BN 第一步就减掉了这个 mini-batch 的均值, 加上任何常数 ,减均值之后都被抵消了。代码 02 演示 1 验证了两件事:
- 加上一个标准差 10 的随机偏置,BN 的输出最多只变了 5.6e−16(舍入误差);
- BN 反向传播得到的 每一行加起来是 0(最大 1.7e−16),所以 : 根本收不到梯度。
于是带 BN 的层把 去掉,平移的工作交给 。每个带 BN 的层的参数变成 ,后两者的形状都是 。在 PyTorch 里就是三行:
nn.Linear(n_in, n_out, bias=False)   # 不要偏置
nn.BatchNorm1d(n_out)                # γ(weight)、β(bias)都是可学习参数,形状 (n_out,)
nn.ReLU()
torch_utils.MLP 的 batchnorm=True 就是这样搭的。网络 不带 BN 时有 4547 个参数,带 BN 后 4675 个:少了两个隐藏层的偏置 ,多了 、 共 。
几个实现上的要点:
- BN 是按 mini-batch 做的:每个 mini-batch 用自己的 、。所以 BN 天然和 mini-batch 梯度下降(第 8 讲)一起用。
- 放在激活函数之前还是之后?Ng 的默认和原论文都是放在之前(对 做);也有不少人放在之后(对 做),两种都能用,差别通常不大。本讲义的代码统一放在之前。
- 输出层一般不加 BN。
- 记号撞车:BN 的 和动量 / Adam 的 毫无关系,Ng 在视频里也特意提醒过。PyTorch 把 BN 的 、 叫
weight、bias,反而不容易混。
2.4 BN 的反向传播
BN 的反向比普通层麻烦一点: 和 是用整个 mini-batch 算的,所以第 个样本的 不只影响自己的 ,还通过 、 影响同一批里所有样本的 。
设损失 对 的梯度是 (从后面的层传回来,对一个单元、 个样本)。、 的梯度和普通的”缩放 + 平移”一样:
再往前一步到 。记 。三个局部导数是:
(求 时, 也随 变的那一项是 。)由 :
把所有 的贡献加起来,得到紧凑的公式:
括号里三项各有含义:第一项是”假如 、 不随 变”时的梯度;第二项来自 也依赖 ;第三项来自 也依赖 。把它对 求和,因为 ,结果恰好是 0——这就是 §2.3 里""的来源:BN 的输出对”整列一起平移”完全不敏感。把它乘上 再求和,得到 ,几乎是 0:BN 的输出对”整列一起放大”几乎不敏感,只有 让它不完全成立(代码 02: 时 5.5e−07, 时 2.2e−16)。
scratch_layers.py 里写了两个版本:batchnorm_backward 用上面的紧凑公式,batchnorm_backward_staged 按计算图一步一步用链式法则(,倒着走)。代码 02 演示 1 把它们和 PyTorch 的 nn.BatchNorm1d + autograd 在 float64 下对照(4 个单元、8 个样本):
| 量 | numpy 形状(列约定) | PyTorch 形状 | 最大差 |
|---|---|---|---|
| 前向输出 BN(Z) | (4, 8) | (8, 4) | 8.9e−16 |
| (4, 8) | (8, 4) | 2.2e−16 | |
(PyTorch:weight.grad) | (4, 1) | (4,) | 1.3e−15 |
(PyTorch:bias.grad) | (4, 1) | (4,) | 4.4e−16 |
紧凑公式和逐步求导的 最大差 1.1e−16;双边差分梯度检验的相对误差 2.2e−09。nn.BatchNorm1d 在训练模式下做的就是这几行;唯一要小心的是形状:numpy 按列放样本,PyTorch 按行放,对照时到处是 .T。
和第 4 讲约定的关系:第 4 讲的 是逐样本的(不含 ), 含 。BN 的反向对 是线性的,所以 的公式在两种约定下都成立;只是按第 4 讲的约定嵌进网络时,、 要和 、 一样再除以 。
2.5 测试时的 BN · Batch Norm at test time
训练时,BN 用每个 mini-batch 自己的 、。可是测试时(或者部署后),你常常一次只处理一个样本——一个样本的”均值和方差”毫无意义。而且我们希望一个样本的预测只取决于它自己,不取决于和谁一起被送进网络。
办法是:训练的时候,顺便为每个 BN 层估计一个”总体的” 和 。最常用的估计就是第 8 讲的指数加权平均(EWA):每处理一个 mini-batch ,就更新
测试时就用这两个固定的数:,。这时 BN 就是一个普通的逐元素仿射变换。Ng 也说,任何合理的估计方法(比如训练结束后在整个训练集上算一遍)都可以;EWA 只是最方便的一种。
PyTorch 里有三个细节,代码 02 演示 1 的最后一张表把它们都核对了(一次前向之后,第 1 个单元):
| 均值 | 方差 | |
|---|---|---|
| 这个 batch:、(除以 ) | 4.122914 | 12.192467 |
| 这个 batch:(除以 ,无偏) | 13.934247 | |
PyTorch 的 running_mean / running_var | 0.412291 | 2.293425 |
| 初值 有偏 | 0.412291 | 2.119247 |
| 初值 无偏 | 2.293425 |
nn.BatchNorm1d(momentum=0.1)的更新是running = (1 − momentum) · running + momentum · batch。所以 PyTorch 的 momentum = 0.1 就是 Ng 写法里的 (,平均窗口约 10 个 batch)。同一个名字,含义”反过来”,而且和优化器的 momentum 毫无关系。- 训练时标准化用有偏方差(除以 ),累积
running_var时用无偏方差(除以 )。 - running 统计量的初值是均值 0、方差 1,没有第 8 讲的偏差修正。
用哪套统计量,由 model.train() / model.eval() 决定。代码 02 演示 2 训练了一个带 BN 的网络 [256, 64, 64, 6](手势数据,30 个 epoch),先核对:训练结束时第 1 个 BN 层的 running_mean 和”用最终权重在整个训练集上算出的均值”最大差是均值幅度的 4.1%,方差的相对差最大 4.4%——很接近,但不相等,因为 EWA 平均的是”当时的”权重算出的统计量。然后故意”忘了 model.eval()”,在 1000 张测试图上评估:
| 模式 | batch 怎么组成 | 准确率 |
|---|---|---|
model.eval()(正确做法) | 随机顺序,每批 256 | 0.844 |
| 忘了 eval(训练模式) | 随机顺序,每批 64 | 0.838 |
| 忘了 eval(训练模式) | 随机顺序,每批 8 | 0.699 |
| 忘了 eval(训练模式) | 按类别排序,每批 64 | 0.233 |
上一行之后再 model.eval() | 随机顺序,每批 256 | 0.810 |
- 训练模式下,每张图的预测取决于同一批里还有谁。随机的 batch 里各类都有,统计量和训练时差不多,准确率 0.838,和正确的 0.844 几乎一样——这正是这个 bug 难发现的原因。batch 小到 8 张时统计量很”抖”,掉到 0.699。
- 测试数据按类别排好序时(真实场景:按文件夹、按时间顺序读进来),每批几乎全是同一类,“减去本批均值”把这一类共有的特征减掉了,准确率掉到 0.233。
- 更隐蔽的是副作用:训练模式下的每次前向都会更新 running 统计量,
torch.no_grad()也挡不住(它只管”记不记计算图”,不管 BN / Dropout 的模式)。被排序的 batch “污染”之后,running_mean 最多变了 0.087,再用正确的model.eval()评估,准确率也从 0.844 变成了 0.810。 - 训练模式下只送 1 个样本,PyTorch 直接报错:
Expected more than 1 value per channel when training。这反而是好事——错误越早暴露越好。
规则很简单:训练前 model.train(),评估 / 预测前 model.eval()。torch_utils.py 的 train_one_epoch 和 evaluate 开头各有一行,就是为了不让你忘。
2.6 BN 为什么有用 · Why does Batch Norm work?
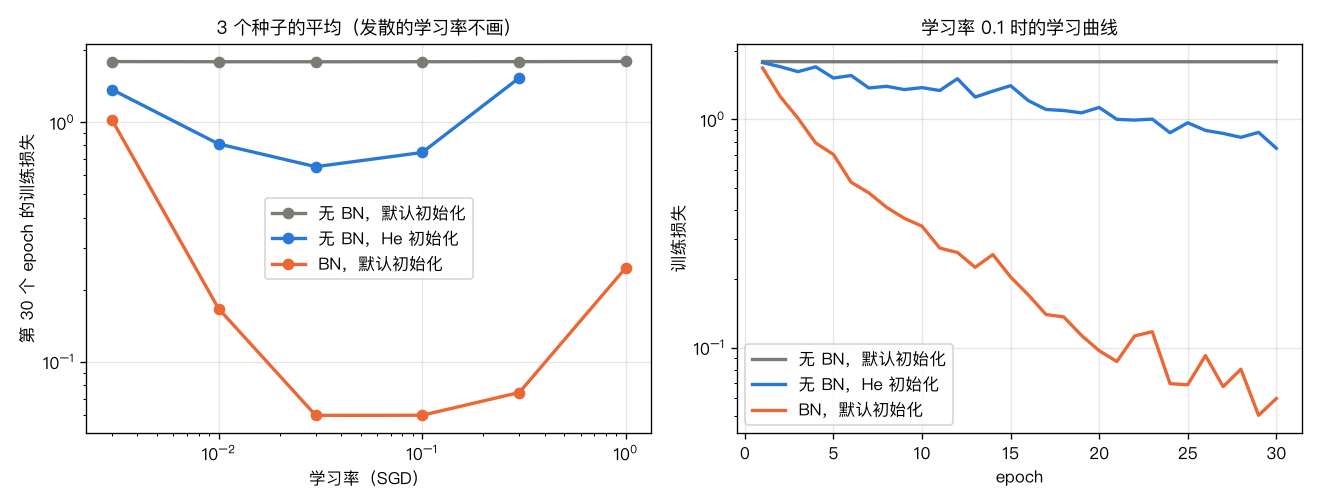
先看效果。代码 02 演示 3:手势数据,8 个隐藏层、每层 64 个单元的网络,普通 SGD(不用 Adam,免得它的自适应步长掩盖差别),batch 64,30 个 epoch,6 个学习率 × 3 个种子,比较三种配置:
最后一个 epoch 的训练损失(3 个种子的平均; 相当于对 6 类一视同仁地猜):
| 配置 | lr=0.003 | lr=0.01 | lr=0.03 | lr=0.1 | lr=0.3 | lr=1 |
|---|---|---|---|---|---|---|
| 无 BN,PyTorch 默认初始化 | 1.7929 | 1.7901 | 1.7897 | 1.7903 | 1.7916 | 1.7947 |
| 无 BN,He 初始化 | 1.3693 | 0.8122 | 0.6524 | 0.7479 | 1.5343 | 发散 |
| BN,PyTorch 默认初始化 | 1.0221 | 0.1668 | 0.0597 | 0.0598 | 0.0744 | 0.2470 |
最后一个 epoch 的 dev 准确率(3 个种子的平均;几个种子波动大的格子在括号里给出最低–最高):
| 配置 | lr=0.003 | lr=0.01 | lr=0.03 | lr=0.1 | lr=0.3 | lr=1 |
|---|---|---|---|---|---|---|
| 无 BN,默认初始化 | 0.175 | 0.190 | 0.190 | 0.174 | 0.174 | 0.175 |
| 无 BN,He 初始化 | 0.385 | 0.543 (0.37–0.67) | 0.754 | 0.433 (0.16–0.65) | 0.363 | 发散 |
| BN,默认初始化 | 0.466 | 0.694 | 0.811 | 0.857 | 0.891 (0.87–0.90) | 0.757 |
刚初始化时,每一层的输出随输入变化的幅度(每个单元在样本之间的标准差,对单元取平均):
| 配置 | 第 1 层 | 第 2 层 | 第 3 层 | 第 4 层 | 第 6 层 | 第 8 层 | logits |
|---|---|---|---|---|---|---|---|
| 无 BN,默认初始化 | 0.1202 | 0.0454 | 0.0145 | 0.0055 | 0.0010 | 0.0002 | 0.0001 |
| 无 BN,He 初始化 | 0.2785 | 0.2191 | 0.2015 | 0.1806 | 0.1503 | 0.1271 | 0.2062 |
| BN,默认初始化 | 0.5853 | 0.5876 | 0.5919 | 0.5916 | 0.5819 | 0.6033 | 0.3219 |
这组结果比我预想的更极端:
- 第一行完全没学:所有学习率下损失都停在 ,dev 准确率 0.17–0.19(瞎猜是 1/6)。原因在最后一张表:PyTorch 的
nn.Linear默认初始化的方差是 ,比 He 初始化的 小 6 倍;对 ReLU 网络,每过一层信号的幅度大约要乘以 (实测前几层每层乘以 0.3–0.4),8 层之后网络对所有输入给出几乎一样的输出,梯度同样消失。这是第 7 讲”梯度消失”在框架里的样子,也是一个重要的提醒:框架的默认初始化不一定适合你的网络。 - 换成 He 初始化就能训练了,但对学习率很挑剔:dev 最好的是 lr = 0.03(0.754),lr = 1 时 3 个种子全部发散,没有一个学习率能在 30 个 epoch 里把训练损失降到 0.5 以下;种子之间的波动也很大。
- 加了 BN(用的还是那个糟糕的默认初始化):每层的输出都被重新标准化(各层 0.58–0.60),从 lr = 0.01 到 1 都能把训练损失降到 0.5 以下,dev 最好的是 lr = 0.3(0.891);同样 lr = 0.1,30 个 epoch 后的训练损失是 0.0598 vs 0.7479。
这就是 Ng 说的:BN 让超参数搜索容易得多,让网络对初始化和学习率都不再那么敏感,能用的学习率范围宽得多,同样的步数里也学得更快。原论文报告,在当时最好的 ImageNet 模型(Inception)上加 BN,用少 14 倍的训练步数就达到了原来的准确率。
那它为什么有用? 这里有一个有意思的科学故事。
解释 1:和输入归一化一样。 每一层的输入都被放到相近的尺度上,优化问题的”条件”更好。这是 Ng 给的第一个直觉。
解释 2:covariate shift(原论文的说法)。 Ng 用了一个例子:你在黑猫的照片上训练了一个猫分类器,然后拿去识别彩色的猫。“是不是猫”这个规律没变,但输入 的分布变了——这叫 covariate shift(协变量偏移),模型往往要重新训练。现在从网络第 3 层的角度看:它的输入是 ,而前两层的参数每一步都在变,所以 的分布也一直在变,第 3 层就像在追一个移动的靶子。BN 让 的均值和方差始终由 、 决定,限制了前面几层的更新能让后面几层的输入分布移动多少,于是每一层可以更”独立”地学习。Ioffe & Szegedy 把网络内部的这种现象叫 internal covariate shift(ICS),并把 BN 的作用归结为”减少 ICS”——论文标题就是这么写的。
争议:Santurkar et al. (2018) 的实验。 几年后,MIT 的一组研究者做了两个很巧妙的检验:
- 他们在 BN 层的后面故意注入随机噪声,每一步随机改变激活值的均值和方差——人为制造大量的”covariate shift”。结果这种”带噪声的 BN”网络训练得和普通 BN 几乎一样好,仍然明显好于不带 BN 的网络。如果 BN 的好处来自”减少 ICS”,这不应该发生。
- 用他们对 ICS 的度量,BN 网络的 ICS 甚至并不比普通网络小。
他们的结论是:BN 的主要作用是让损失曲面更平滑——沿着梯度方向走一步,损失和梯度的变化都更可预测(更好的 Lipschitz 性和 -smoothness),所以可以安全地用更大的学习率、走更大的步子。同年 Bjorck et al. (2018) 也得出了相近的结论:BN 主要是让网络能用更大的学习率训练,更快的收敛和更好的泛化都来自这一点;没有 BN 时,大步长会让激活值随深度失控地增长,只能用小学习率。
我们的实验和这两种解释都相容:BN 网络确实扛得住大学习率(lr = 1 时仍能训练,He 初始化的网络已经发散),也确实让各层的激活值保持在稳定的尺度上。这个实验分不出哪种解释对——要分辨它们,需要 Santurkar 那样专门设计的对照实验。这件事本身就是一个教训:深度学习里很多”为什么”的直觉解释,其实是有待检验的假说;方法好用,不等于我们完全知道它为什么好用。
附带效果:轻微的正则化。 每个样本的 依赖于同一个 mini-batch 里其他样本的均值和方差,而这些统计量每个 batch 都不一样——相当于给每个隐藏单元加了一点噪声(减均值带来加性噪声,除标准差带来乘性噪声),和 dropout 有点像。mini-batch 越大,噪声越小,正则化效果越弱(比如 batch 512 比 64 弱)。Ng 的建议是:不要把 BN 当成正则化手段来用,它的正则化只是一个副作用;要正则化,用第 6 讲的方法。
2.7 BN 的局限与它的亲戚
- 依赖 batch:batch 很小时统计量很不准(代码 02 演示 2:训练模式下每批 8 张,准确率从 0.838 掉到 0.699)。检测、分割这类任务图片很大、每张卡只能放几张图时,这是个真问题;多卡训练时还要考虑跨卡同步统计量。
- 训练和测试的行为不同:running 统计量是近似的,
model.train()/model.eval()忘了切换就会出错(§2.5)。 - 序列模型里每个时间步的分布不同、序列长度可变,BN 不好用。Transformer 用的是 Layer Normalization(Ba et al. 2016):对每个样本自己的所有特征求均值和方差,而不是对一个 batch 的同一个特征——它不依赖 batch,训练和测试时完全一样(第 17 讲)。
- 卷积网络里的 BN(
nn.BatchNorm2d)对每个通道在 batch 和所有空间位置上求统计量(第 12–13 讲);batch 很小时可以换成 Group Normalization(Wu & He 2018)。
3. Softmax 回归 · Softmax regression
3.1 从两类到 C 类
第 1–8 讲的输出层几乎都是一个 sigmoid 单元:二分类。第 5 讲 §1.3 已经比较过两种多类的输出层:三个独立的 sigmoid(“照片里有哪些动物”,多标签)和一个 softmax(“这是哪一种动物”,多类别),并且看到同一组 logits 经过 softmax 得到 。这一节把 softmax 拆开:它为什么长这样、梯度是什么、怎样稳定地算、怎样训练。
Ng 的例子是 4 类:0 = 其他,1 = 猫,2 = 狗,3 = 小鸡,。输出层有 个单元,输出 是一个 4 维向量,第 个分量表示”是第 类的概率”,4 个分量加起来等于 1。
3.2 softmax 的定义
输出层先照常算线性部分 (这个 叫 logits),然后:
代码 03 演示 1 算了 Ng 的例子:
| 第 0 类 | 第 1 类 | 第 2 类 | 第 3 类 | 合计 | |
|---|---|---|---|---|---|
| logits | 5 | 2 | −1 | 3 | |
| 148.4 | 7.4 | 0.4 | 20.1 | 176.3 | |
| softmax | 0.842 | 0.042 | 0.002 | 0.114 | 1.000 |
| hardmax | 1 | 0 | 0 | 0 |
几个性质:
- 取指数让每个分量都变成正数,而且放大差距: 只差 2(5 vs 3),概率差了 7 倍多(0.842 vs 0.114)。
- 除以总和让它们加起来等于 1,能解释成概率。
- 保持顺序:logit 最大的类,概率也最大。所以预测类别时 ,不用真的算 softmax。
- 平移不变:所有 logits 加上同一个常数,softmax 不变(分子分母同乘 )。§3.7 会用到这一点。
- 和 sigmoid、ReLU 这种”逐元素”的激活函数不同,softmax 输入一个向量、输出一个向量,每个输出都依赖所有输入。
“softmax”这个名字是相对于 hardmax 说的:hardmax 把最大的位置变成 1、其余变成 0(上表最后一行);softmax 是它的一个平滑的、处处可导的版本——可导,才能用梯度下降训练。
3.3 softmax 回归:边界是直线
没有隐藏层时,( 是 ),这就是 softmax 回归(softmax regression,也叫多项逻辑回归)。它给每一类一个线性打分 ,预测打分最高的那一类。第 类和第 类之间的边界是”两个打分相等”的地方:
这是一个超平面(二维时是一条直线)。所以 softmax 回归把输入空间切成 块凸的区域,块和块之间是直线边界。Ng 在视频里展示过 3–6 类的例子,边界全是直线。要画出弯曲的边界,需要隐藏层——§3.8 会在螺旋数据上看到这一点。
3.4 C = 2 时就是逻辑回归
两类时:
只有两个 logit 的差有意义。如果 ,那么 ,正是一个以 为参数的逻辑回归。所以 softmax 回归是逻辑回归向 类的推广; 时它多了一组”冗余”的参数(把 、 同时加上同一个向量,预测不变)。代码 03 演示 2 在 1000 个随机样本上核对:softmax 第 0 类的概率和 最大差 2.2e−16,多分类交叉熵和二元交叉熵都是 1.8078925931。
3.5 损失函数:多分类交叉熵
标签用 one-hot 向量表示:正确类别的位置是 1,其余是 0。比如真实类别是猫(第 1 类),。损失是
因为 里只有一个 1,求和只剩正确类那一项。Ng 的例子:,网络输出 ——它把猫只判了 0.2,损失 。要让损失变小,唯一的办法是提高正确类的概率 。这就是最大似然:让模型给观测到的标签分配尽可能高的概率(第 2 讲 §3.3 对二分类做过同样的推导)。 时它就是二元交叉熵。
个样本的 cost 是平均:。Ng 的列约定下, 和 都是 的矩阵,每一列是一个样本。PyTorch 的 nn.CrossEntropyLoss 则直接收整数类别(形状 ,dtype long),不需要 one-hot。
3.6 梯度:dZ = Ŷ − Y
先求 softmax 的雅可比矩阵(一个样本,):
对角线上是 ,和 sigmoid 的导数同一个形状;非对角线上是 :把一个类的 logit 调高,其他类的概率都会下降,“此消彼长”。再由 ,链式法则给出:
(最后一步用了 。)所有的 分母都约掉了,只剩预测 − 标签。向量化后,用第 4 讲的约定:
和第 2 讲 sigmoid + 二元交叉熵的 一模一样。第 2 讲 §3.5 预告过:sigmoid 配二元交叉熵、softmax 配多分类交叉熵、线性输出配平方误差,三种搭配的输出层梯度都是”预测 − 标签”。所以从二分类换到多分类,反向传播只需要改输出层的一行:scratch_layers.softmax_model_backward 用 dZL = AL - Y 起步,之后全是第 4 讲 deep_nn 的积木。
代码 03 演示 2 用三种方式核对这个公式(5 个样本、4 类,cost 对 logits 的梯度和 的最大差):
| 对照 | 最大差 |
|---|---|
| 双边差分 | 2.8e−10 |
| 链式法则:雅可比 | 2.8e−17 |
PyTorch F.cross_entropy + backward()(float64) | 2.8e−17 |
softmax 雅可比本身和双边差分的最大差 5.0e−11,每一列加起来是 4.2e−17(概率的总和恒为 1,动任何一个 ,各概率的变化之和为 0)。
3.7 数值稳定:减去最大值,以及 log-sum-exp
按定义写 np.exp(z) / np.exp(z).sum() 在数学上没错,但在计算机上会出问题。float64 里 在 时溢出成 inf,在 左右下溢成 0;float32(深度学习的默认精度)在 时就溢出了。训练中 logits 达到几十上百并不罕见。
修复 1:先减去最大值。 利用平移不变性,令 :
指数里最大的数是 0,不会上溢;分母至少是 1,不会出现 。
修复 2:交叉熵不要”先 softmax、再取 log”。 即使 softmax 写稳定了,正确类的概率仍可能小到下溢成 0,。正确的做法是直接从 logits 算 log 概率:
代码 03 演示 1:把 平移或放大后再算(正确类取 logit 最小的第 2 类):
| logits | softmax:教科书写法 | softmax:先减最大值 | CE:先 softmax 再取 log | CE:log-sum-exp |
|---|---|---|---|---|
| (0.7054, 0.2595, 0.0351) | (0.7054, 0.2595, 0.0351) | 3.3490 | 3.3490 | |
| (nan, nan, nan) | (0.7054, 0.2595, 0.0351) | 3.3490 | 3.3490 | |
| (nan, nan, nan) | (0.7054, 0.2595, 0.0351) | 3.3490 | 3.3490 | |
| (nan, nan, 0.0000) | (1.0000, 0.0000, 0.0000) | inf | 3000.0000 |
- 教科书写法在 时得到 nan,在 时得到 nan。
- 时,正确类的概率下溢成 0,“先 softmax 再取 log”得到 inf;log-sum-exp 写法给出准确的 3000()。自信地错了,损失就该很大——但它是一个有限的数,梯度 也完全正常。
这就是为什么 PyTorch 的 nn.CrossEntropyLoss 收的是 logits:它内部等于 LogSoftmax + NLLLoss,用的正是 log-sum-exp。同理,二分类用 nn.BCEWithLogitsLoss(收 logit),而不是 sigmoid 之后再用 nn.BCELoss——第 4 讲 §4.3 已经在 numpy 里看到过”fused”写法更稳。规则:模型输出 logits,损失函数里做 softmax;需要概率时(展示给人看、做校准)再单独调用 torch.softmax。
3.8 训练一个 softmax 分类器
代码 03 演示 3:三条交错的螺旋臂,每条一类,每类 200 个训练点。两个模型都用全批量梯度下降(学习率 1.0,3000 步)训练两遍:一遍用 numpy(第 4 讲的积木 + dZL = AL - Y),一遍用 PyTorch(nn.CrossEntropyLoss + autograd),float64,同样的初始参数:
| 模型 | 第 0 步 | 第 100 步 | 第 500 步 | 第 1000 步 | 第 3000 步 | numpy 与 PyTorch:cost 最大差 / 参数最大差 | 训练 | dev |
|---|---|---|---|---|---|---|---|---|
| softmax 回归 [2, 3] | 0.9285 | 0.7386 | 0.7348 | 0.7348 | 0.7348 | 2.2e−16 / 5.3e−15 | 0.528 | 0.530 |
| 一个隐藏层 [2, 100, 3] | 0.9909 | 0.1688 | 0.0644 | 0.0436 | 0.0245 | 2.2e−16 / 2.2e−13 | 0.997 | 0.992 |
字符画是决策区域(背景:. 预测第 0 类,- 第 1 类,空白 第 2 类;数字是训练点的类别,# 是分错的点),这里截取中间的 9 行(完整的图见脚本输出):
softmax 回归 [2, 3]                                一个隐藏层 [2, 100, 3]
      2 ###-----------111-1111--------------   |         2 222    -------111-1111--------------
      2222#--------111111-111111111---------   |         22222   -----111111-111111111---------
      222   -----1111-1--------1-1111-------   |         222    ----1111-1--------1-1111-------
      22       -111-1--------------1111-----   |         22     ---111-1--.......-----1111-----
     222       ##1-------------------1-11---   |        222    ---111---............----1-11---
   22 22       ####--#######-#--------111---   |      22 22    ---1111--0000000.0....----111---
     2222      ####  ####-######------1111--   |        2222   ---1111--0#00.000000...---1111--
       222       ########...0000.......###..   |          222  -----11111222 ..0000...----111--
2222 ..##....0000.......##.. | 2222 ----- 22 ..0000...----11--- numpy 和 PyTorch 两边 3000 步之后 cost 差 2.2e−16、参数差 2.2e−13 以内:算的是同一个东西。
- softmax 回归只能画直线边界,把平面切成三个扇形,绕不过螺旋臂(左图满是
#),训练准确率 0.528,cost 停在 0.7348 再也不动——这是表达能力不够(high bias),训练再久也没用。 - 加一个 100 单元的隐藏层,决策区域跟着螺旋臂弯了过去,训练 0.997、dev 0.992。输出层还是同一个 softmax,变的是它前面的特征——和第 3 讲”逻辑回归 vs 一个隐藏层”在花朵上的故事一样,只是从 2 类变成了 类。
一个常见的坑(代码 03 演示 4):模型最后一层已经做了 softmax,又把概率传给 nn.CrossEntropyLoss——等于”softmax 了两次”。程序不报错:
| 训练时送进损失的是 | 第 500 步 | 第 1000 步 | 第 3000 步 | 训练准确率 | 训练目标(第 3000 步) | 训练目标的下限 |
|---|---|---|---|---|---|---|
| logits(正确) | 0.0644 | 0.0436 | 0.0245 | 0.997 | 0.0245 | 0 |
| softmax(logits)(错误) | 0.0977 | 0.0622 | 0.0328 | 0.995 | 0.5700 | 0.5514 |
(“第 k 步”几列都是用正确的交叉熵记录的,便于比较。)概率 的每个分量都在 里,再做一次 softmax,正确类的概率最多是 ,所以训练目标永远降不到 以下( 时 0.5514)——训练日志里的损失”卡住”了。梯度也被压扁了,用正确的交叉熵衡量,错误写法每个时刻都落后。不过在这个简单任务上,最终的训练准确率几乎一样(0.995 vs 0.997):后果是”慢一些、日志看着奇怪”,而不是”学不会”。因为预测时 argmax 不受影响,这个 bug 很难靠准确率发现;最明显的信号是损失停在一个奇怪的正数上。
4. 深度学习框架 · Deep learning frameworks
4.1 为什么要用框架
回头看第 1–8 讲,我们用 numpy 亲手写过:每种激活函数的前向和导数;每一层的前向、反向和 cache;交叉熵和它的梯度;He / Xavier 初始化;mini-batch 的切分和打乱;Momentum、RMSprop、Adam 的更新公式;梯度检验。每加一种新的层(比如本讲的 BN),就要推导一遍反向传播、写一遍、再做梯度检验。
第 1 讲 §6.3 说过为什么要从零手写:理解是调试的前提。但等你真正理解了,再手写每一个梯度就只是重复劳动,而且容易出错、跑得也慢。深度学习框架提供:
- 张量(tensor):类似 numpy 数组,但可以放在 GPU 上,并且能记住”自己是怎么算出来的”;
- 自动微分(automatic differentiation):你只写前向,反向自动完成(§4.4);
- 现成的层和损失函数:
nn.Linear、nn.BatchNorm1d、nn.CrossEntropyLoss、卷积、注意力…… - 优化器:
torch.optim.SGD、Adam等,一行代码换一个; - 数据加载:
Dataset/DataLoader负责打乱、分 batch、并行读取; - 保存 / 加载模型、部署到服务器或手机等工程工具。
Ng 在 2017 年的视频里列了一串框架:Caffe/Caffe2、CNTK、DL4J、Keras、Lasagne、mxnet、PaddlePaddle、TensorFlow、Theano、Torch。今天的格局简单多了:研究和课程项目里 PyTorch 占主导,TensorFlow/Keras 在一些生产环境里仍很常见,JAX 在一部分研究组里流行。框架会变,Ng 给的三条选择标准不会过时:
- 易于编程:既包括开发(写模型、调试),也包括部署(放到生产环境里);
- 运行速度:同样的模型,训练和推理要快;
- 真正开放:不只是开源,还要有好的治理,让你相信它会长期保持开放,而不是哪天被一家公司收紧控制。这一条的一个注脚:PyTorch 在 2022 年转到了 Linux 基金会下的 PyTorch Foundation 管理。
本讲义从这里起用 PyTorch:CS230 的课程项目大多用它;它是”边执行边建图”(define-by-run)的,写起来就像普通的 Python + numpy,调试时可以随时打印中间结果,对初学者最友好。原作业用的 TensorFlow 2 也已经是同样的风格(tf.GradientTape),两者的概念一一对应。
4.2 张量、dtype 与 device
torch.Tensor 可以先当作 numpy 数组来理解,多了三样东西:
- dtype:PyTorch 的层默认用 float32(numpy 默认 float64)。float32 只有约 7 位有效数字,但内存减半、速度更快;GPU 上还常用 16 位(混合精度)。代码 04 演示 3 显示,同一个网络的梯度,float32 和 float64 差 1e−8 量级——对训练无关紧要,对”逐数字对照”和梯度检验则不够(§4.7)。
- device:张量可以放在 CPU(
"cpu")、NVIDIA GPU("cuda")或苹果芯片的 GPU("mps")上,用.to(device)搬运;模型和数据必须在同一个设备上。本讲义的代码都在 CPU 上运行,网络很小,CPU 足够;GPU 的价值在大模型、大数据上:成千上万个核心同时做矩阵乘法(第 1 讲 §4.4)。 - requires_grad / grad_fn:标记”要对它求导”的张量,以及”它是由哪个运算算出来的”(§4.4)。
和 numpy 互相转换:torch.from_numpy(a)(共享内存,保留 float64)、torch.tensor(a, dtype=torch.float32)(复制并转类型)、t.numpy()、标量用 t.item()。
4.3 形状约定的切换:从 (n_x, m) 到 (m, n_x)
第 1 讲 §3.4 说过:Ng 的约定是每一列一个样本,,;PyTorch(以及 scikit-learn、pandas)的习惯是每一行一个样本,。两者只差一个转置:
最容易记混的是权重的形状。nn.Linear(n_in, n_out) 的 weight 形状是 ——和 Ng 的 完全一样;它算的是 。偏置 bias 是一维的 ,靠广播加到每一行。代码 04 演示 1:
| Ng(numpy,第 1–8 讲) | PyTorch(第 9 讲起) | |
|---|---|---|
| 输入 | (3, 5):每一列一个样本 | (5, 3):每一行一个样本 |
| 权重 | (4, 3) = | weight (4, 3) = |
| 偏置 | (4, 1)(列向量) | bias (4,)(一维) |
| 线性输出 | (4, 5) | (5, 4) |
两边结果的最大差 4.4e−16。所以从 numpy 搬参数到 PyTorch 时, 直接拷, 拉平。
忘了转置会怎样?把 Ng 形状的 (3 × 5)直接送进 nn.Linear(3, 4),矩阵乘法报错:mat1 and mat2 shapes cannot be multiplied (3x5 and 3x4)——这是好事。但如果 恰好等于 (比如这批数据恰好有 3 个样本),程序照常运行,输出形状也对,只是数值全错(代码里最大差 4.20)。又是第 1 讲 §3.5 那种”不报错、只给错数字”的 bug。
换约定时还要跟着变的地方:
- “按特征求均值”(输入标准化)在 Ng 约定下是
axis=1,在 PyTorch 约定下是axis=0(代码 05 的load_data); - BN 在 PyTorch 里对第 0 维(batch)求统计量;
- 分类标签:
nn.CrossEntropyLoss要 的整数类别;nn.BCEWithLogitsLoss要和 logits 同形状的 浮点数。
4.4 自动微分:计算图上的反向模式
框架怎样做到”只写前向、反向自动来”?答案就是第 2 讲 §5 的计算图。
PyTorch 在执行前向的同时,把每一步运算记成图上的一个节点(这叫 define-by-run,或者动态图):每个算出来的张量都带着一个 grad_fn,指向”怎样把梯度传回给输入”的函数。调用 loss.backward() 时,框架从 loss 出发,沿着这张图倒着走,每个节点乘上自己的局部导数(链式法则),走到叶子张量(参数)时,把结果累加进它的 .grad。这和第 2 讲在纸上做的反向传播完全一样,只是自动完成。
代码 04 演示 2 先重做 Ng 在 TensorFlow 视频里的例子:最小化 。我们只写前向那一行,梯度下降(lr = 0.1)从 出发:
| 步数 | (autograd) | (手算) | ||
|---|---|---|---|---|
| 0 | 0.000000 | 25.000000 | −10.000000 | −10.000000 |
| 1 | 1.000000 | 16.000000 | −8.000000 | −8.000000 |
| 2 | 1.800000 | 10.240000 | −6.400000 | −6.400000 |
| 10 | 4.463130 | 0.288231 | −1.073741 | −1.073741 |
| 30 | 4.993810 | 0.000038 | −0.012380 | −0.012380 |
然后看第 2 讲 §5.3 的计算图 ,。PyTorch 在前向时记下的图(从 往回看;右边的注释是我加的):
└─ MulBackward0                    J = 3 · v
  └─ AddBackward0                  v = a + u
    └─ AccumulateGrad              → 写进 a.grad
    └─ MulBackward0                u = b · c
      └─ AccumulateGrad            → 写进 b.grad
      └─ AccumulateGrad            → 写进 c.grad
J.backward() 之后,、、,和手算的 、、 一致。
这种从输出往输入倒着算的方式叫反向模式自动微分(reverse-mode autodiff)。对”一个标量损失、很多参数”的情形,它是最划算的:一次反向就得到损失对所有参数的梯度,代价只是一次前向的一个小常数倍。对比第 7 讲的数值梯度:每个参数要做两次前向,一个有 个参数的模型要做 次前向——根本不可能。代价是内存:反向时要用前向的中间结果,框架会把它们存下来(PyTorch 叫 saved tensors),这就是第 4 讲 §4.4 的 cache。torch.no_grad() 告诉框架”这段不需要求导”,就不记图、不存中间结果,评估时又快又省内存。
最后一个细节:.grad 是累加的。演示 2 里对 (,)不清零地 backward 三次,x.grad 依次是 12.0、24.0、36.0。这是有意的设计(显存不够时,可以把几个小 batch 的梯度加起来再更新),但也意味着训练循环里每一步都要 optimizer.zero_grad()(§4.7)。
4.5 同一个网络:手写 vs autograd
代码 04 演示 3 是本讲最核心的对照:第 4 讲的 numpy 积木 deep_nn 和 PyTorch,在第 3 讲的花朵数据上训练同一个网络 [2, 16, 8, 1](ReLU 隐藏层,sigmoid 输出 + 交叉熵;PyTorch 一侧用 nn.BCEWithLogitsLoss,和 deep_nn 的 fused 写法 是同一个式子),同样的 He 初始化(种子 43),全批量梯度下降。
初始化时一次反向传播,PyTorch 的梯度和手写版的最大差:
| 参数 | 形状 | PyTorch float64 | PyTorch float32 |
|---|---|---|---|
| dW1 | (16, 2) | 1.2e−16 | 6.2e−08 |
| db1 | (16, 1) | 2.1e−17 | 8.1e−09 |
| dW2 | (8, 16) | 1.4e−16 | 5.6e−08 |
| dW3 | (1, 8) | 2.8e−17 | 3.5e−08 |
float64 下每层都差 1e−16 量级——就是舍入误差。autograd 没有什么”更聪明”的算法,它做的正是 linear_backward、relu_backward 那几行,只是自动串起来了。
接着训练 2000 步。这里出了一件我没预料到的事。学习率 0.3(写代码之前定下的设置)时:
| 第几步 | numpy(deep_nn) | PyTorch float64 | 差 | PyTorch float32 | 差 |
|---|---|---|---|---|---|
| 0 | 0.9232240190 | 0.9232240190 | 3.3e−16 | 0.9232240319 | 1.3e−08 |
| 100 | 0.3205426084 | 0.3205426084 | 5.6e−17 | 0.3205426037 | 4.6e−09 |
| 500 | 0.2238220050 | 0.2238220050 | 5.6e−17 | 0.2241070122 | 2.9e−04 |
| 1000 | 0.2027047230 | 0.2027047221 | 9.1e−10 | 0.2031685412 | 4.6e−04 |
| 1500 | 0.1709728247 | 0.1732902505 | 2.3e−03 | 0.1781749278 | 7.2e−03 |
| 2000 | 0.1604785885 | 0.1740602052 | 1.4e−02 | 0.1689668149 | 8.5e−03 |
两边的 cost 在前 955 步里差别都小于 1e−12,之后差别指数增长,到第 2000 步已经差 1.4e−02,参数差 2.2e−02。代码哪里写错了吗?我补了两个学习率做对照(看到上面的结果之后加的):
| 学习率 | cost 回升的步数 | float64 最大差 | 差首次 > 1e−12 | float32 最大差 | 测试准确率 numpy / f64 / f32 |
|---|---|---|---|---|---|
| 0.3 | 1017 | 1.5e−01 | 第 955 步 | 1.5e−01 | 0.8905 / 0.8955 / 0.8950 |
| 0.1 | 502 | 6.1e−16 | — | 1.9e−03 | 0.9090 / 0.9090 / 0.9090 |
| 0.03 | 0 | 3.3e−16 | — | 1.1e−07 | 0.9030 / 0.9030 / 0.9030 |
(“cost 回升的步数”:2000 步里 cost 比上一步还高的次数,越多说明训练越不稳定。)
答案在训练本身:学习率 0.3 时,cost 在 2000 步里回升了 1017 次,梯度下降在剧烈震荡。ReLU 网络里,1e−16 的差别偶尔会让某个 落在 0 的另一侧(这个单元从”开”变”关”),震荡的训练又会把这种小分歧一步步放大——和天气预报里的”蝴蝶效应”是一回事。学习率 0.1 时 cost 也回升了 502 次,但 2000 步里最大差只有 6.1e−16;学习率 0.03 时一路平稳下降,最大差 3.3e−16。
所以结论要说准确:两边每一步算的是同一个东西;但”整条训练轨迹逐位相同”只能在同一份代码、同一个环境里保证。这也是为什么本讲义坚持固定种子、单线程,以及为什么比较两个配置时要看多个种子,而不是盯着最后几位小数。float32 的舍入误差(每步约 1e−7 的相对误差)同样会被不稳定的训练放大(学习率 0.1 时最大差 1.9e−03),但最终的测试准确率几乎不受影响——数据本身的噪声比它大得多。
4.6 一个完整的训练循环
torch_utils.py 把 PyTorch 训练的标准写法整理成一个模板,后面各讲都可以直接导入。它的核心是两个函数:
def train_one_epoch(model, loader, loss_fn, optimizer, device="cpu"):
    model.train()                          # 训练模式:BN 用 batch 统计量,Dropout 打开
    for xb, yb in loader:                  # DataLoader 每次给一个 mini-batch
        xb, yb = xb.to(device), yb.to(device)
        logits = model(xb)                 # 1. 前向(autograd 一边算一边记图)
        loss = loss_fn(logits, yb)         # 2. 损失(这一批的平均)
        optimizer.zero_grad()              # 3a. 清掉上一步留在 .grad 里的梯度
        loss.backward()                    # 3b. 反向:所有参数的 .grad
        optimizer.step()                   # 4. 更新参数
        ...                                # 用 loss.item() 记录,不要存 loss 本身

@torch.no_grad()                           # 评估时不记图
def evaluate(model, loader, loss_fn, device="cpu"):
    model.eval()                           # 测试模式:BN 用 running 统计量,Dropout 关闭
    ...
循环体的五行,就是第 1 讲 §2.1 的”前向 → 损失 → 反向 → 更新”。其余零件:
| 零件 | 作用 | 对应第几讲的手写版本 |
|---|---|---|
Dataset(ArrayDataset) | 回答”一共几个样本""第 个是什么” | 第 1–8 讲的 X[:, idx] |
DataLoader(make_loader) | 每个 epoch 打乱、切成 mini-batch;用自己的 torch.Generator 保证可复现 | 第 8 讲的 mini-batch 切分 |
nn.Module(MLP) | __init__ 里声明层(参数自动登记),forward 里写前向;输出 logits | 第 4 讲的 initialize_parameters_deep + L_model_forward |
nn.CrossEntropyLoss | softmax + 交叉熵,收 logits 和整数类别 | 本讲 §3 |
torch.optim.Adam | 用 .grad 更新参数 | 第 8 讲 |
fit | 训练若干 epoch、每个 epoch 在 dev 上评估、损失变成 inf / nan 时停止 | 第 1 讲 tiny_nn.train |
用法只有几行:
torch.manual_seed(0)                                     # 建模型之前设种子(初始化用全局随机数)
model = MLP([256, 25, 12, 6], batchnorm=False)
opt = torch.optim.Adam(model.parameters(), lr=1e-3)
history, info = fit(model, opt, make_loader(X_tr, y_tr, 32, shuffle=True, seed=0),
make_loader(X_dev, y_dev, 500), epochs=60)模板自检(python3 torch_utils.py)在螺旋数据上训练两次,确认同一个种子的历史记录逐位相同。
4.7 从 numpy 迁移到 PyTorch 时最常见的坑
代码 04 演示 4 把每个坑都做成了一个可以运行的小实验,再加上代码 02、03 里遇到的:
| 坑 | 症状(本讲的实测) | 怎么办 |
|---|---|---|
| 形状约定没换 | 多数时候报错; 时不报错、数字全错(§4.3) | 每一行一个样本;weight 是 |
| numpy 的 float64 碰上层的 float32 | mat1 and mat2 must have the same dtype, but got Double and Float | torch.tensor(X, dtype=torch.float32) 或 .float() |
忘了 optimizer.zero_grad() | 梯度一直累加:前 10 步反而降得更快(cost 0.4854 vs 0.5158),之后一路回升,第 200 步 cost 0.7470、测试准确率 0.500 | 每一步都清零 |
| 用 float32 做梯度检验 | 时相对误差 1.0(完全不可信);float64 是 3.9e−09 | 梯度检验一律用 float64 |
忘了 model.eval() | 预测依赖 batch 的组成(按类别排序时 0.233),还会悄悄改掉 running 统计量(§2.5) | 训练前 train(),评估前 eval() |
以为 no_grad 就是测试模式 | no_grad 只管记不记图,不管 BN / Dropout | 两个都要写 |
| Dropout 在训练模式下 | 同一个输入两次输出 0.5540、−0.6747;20000 次平均 −0.0647,接近测试模式的 −0.0687 | 这是正常行为(第 6 讲的 inverted dropout),评估时记得 eval() |
| 从需要梯度的张量取数 | .numpy() 报错;float(t) 能用但发出 UserWarning;把 loss 本身存进列表会留住整张计算图 | .item()(标量)、.detach().numpy()(数组) |
| 损失函数里的广播 | 预测 (m, 1)、标签 (m,):nn.MSELoss 算出 2.5000,正确值是 0(只发一个警告);BCEWithLogitsLoss 直接报错 | 让两者形状一致;用 python3 -W error 把警告变成错误 |
把概率传给 CrossEntropyLoss | 训练目标有个降不下去的地板(0.5514),训练变慢(§3.8) | 模型输出 logits |
| 默认初始化不是 He | 8 层 ReLU 网络完全学不动(§2.6) | 深网用 He 初始化,或者加 BN |
这张表里的大多数坑有一个共同点:程序不报错。第 1 讲 §6.3 说”理解是调试的前提”,到了框架里这句话一样成立——框架替你做了计算,但没有替你检查你是不是在算你想算的东西。
5. 综合:用 PyTorch 训练手势分类器 · Putting it together
Coursera 编程作业 “TensorFlow Introduction” 用 SIGNS 数据集(手比出数字 0–5 的照片,1080 张训练、120 张测试)训练一个 LINEAR → RELU → LINEAR → RELU → LINEAR → SOFTMAX 的网络,两个隐藏层分别 25 和 12 个单元。代码 05 用合成的 16×16 手势图代替原始照片(1080 张训练、500 张 dev、1000 张 test;test 比原作业大,是为了让准确率本身的随机误差小一些),把本讲的东西放在一起用。
演示 1:数据和基线。 每一行一个样本:训练集 X 是 (1080, 256) float32,y 是 (1080,) int64。输入按训练集的均值和标准差做标准化(第 7 讲)。没有隐藏层的 softmax 回归 [256, 6](1542 个参数)训练 60 个 epoch:训练准确率 0.924,dev 只有 0.670——一个线性模板对付不了”手指出现在不同位置”。
演示 2:作业的网络 + 训练循环模板。 [256, 25, 12, 6],6815 个参数,Adam、学习率 0.001(第一次猜的值)、batch 32:
    epoch   10   train loss 0.3181  acc 0.944   dev loss 0.4777  acc 0.806
    epoch   20   train loss 0.0548  acc 1.000   dev loss 0.3482  acc 0.850
    epoch   30   train loss 0.0153  acc 1.000   dev loss 0.3425  acc 0.862
    epoch   40   train loss 0.0067  acc 1.000   dev loss 0.3558  acc 0.872
    epoch   50   train loss 0.0036  acc 1.000   dev loss 0.3705  acc 0.880
    epoch   60   train loss 0.0022  acc 1.000   dev loss 0.3829  acc 0.872
我们没有写一行反向传播,也没有写 Adam 的公式。训练集全对、dev 低得多,dev loss 在第 30 个 epoch 之后开始回升:典型的 high variance(第 6 讲)。
演示 3:随机搜索 + 由粗到细。 按 §1.7 的清单调 4 个超参数:学习率(,对数尺度)、第一个隐藏层宽度 (,对数尺度;第二层取一半,模仿作业的 25 → 12)、batch 大小(16–256 的 2 的幂)、要不要 BN。每组训练 30 个 epoch,按最后一个 epoch 的 dev 准确率排名。粗搜 16 组:
| 排名 | 学习率 | batch | BN | 训练准确率 | dev 准确率 | |
|---|---|---|---|---|---|---|
| 1 | 0.00128 | 153 | 128 | 否 | 1.000 | 0.910 |
| 2 | 0.00178 | 239 | 32 | 否 | 1.000 | 0.908 |
| 3 | 0.01035 | 255 | 32 | 否 | 1.000 | 0.904 |
| 4 | 0.01742 | 105 | 16 | 是 | 0.974 | 0.896 |
| 5 | 0.00529 | 30 | 32 | 否 | 1.000 | 0.892 |
| 6 | 0.03559 | 112 | 128 | 否 | 0.989 | 0.884 |
| 7 | 0.01069 | 148 | 32 | 是 | 0.972 | 0.880 |
| 8 | 0.09946 | 139 | 64 | 是 | 0.981 | 0.874 |
| 9 | 0.02191 | 197 | 64 | 否 | 0.967 | 0.858 |
| 10 | 0.00196 | 19 | 64 | 否 | 1.000 | 0.858 |
| 11 | 0.00165 | 155 | 256 | 是 | 1.000 | 0.840 |
| 12 | 0.03472 | 66 | 16 | 是 | 0.961 | 0.832 |
| 13 | 0.04159 | 33 | 256 | 是 | 0.992 | 0.828 |
| 14 | 0.00109 | 72 | 256 | 是 | 1.000 | 0.814 |
| 15 | 0.00017 | 40 | 32 | 是 | 0.880 | 0.712 |
| 16 | 0.07085 | 210 | 128 | 否 | 0.172 | 0.142 |
然后在前 4 名覆盖的范围里(两端各放宽 1.5 倍:学习率 ,,batch ∈ {16, 32, 128})再随机抽 8 组,dev 准确率在 0.842–0.904 之间。24 组里 dev 最高的是第一行那组;换 3 个新种子、训练 60 个 epoch 重训,只在这时看一次 test:
| 种子 | 训练准确率 | dev 准确率 | test 准确率 |
|---|---|---|---|
| 7 | 1.000 | 0.890 | 0.871 |
| 8 | 1.000 | 0.902 | 0.870 |
| 9 | 1.000 | 0.904 | 0.861 |
| 平均 | 0.899 | 0.867 |
读这几张表:
- 学习率的两个极端最糟:太小(0.00017,30 个 epoch 只到 0.712),太大且没有 BN(0.07085,训练准确率 0.172,彻底没学会)。16 次对数尺度采样在三个数量级上分别抽到 1、6、9 组——次数少时难免不均匀。
- BN:学习率最大的两组里,没有 BN 的失败了,有 BN 的(0.09946)仍有 0.874,和 §2.6”BN 让网络扛得住大学习率”吻合(只有两组,只能算一个例子)。但在合适的学习率下,这个只有两个隐藏层、用 Adam 训练的小网络并不需要 BN:前 4 名里只有 1 组用了它。BN 的价值在深网、普通 SGD 上(§2.6)更明显。
- 细搜没有找到比粗搜更好的配置(最高 0.904 vs 0.910),但 8 组都不差(最低 0.842):它确认了”学习率 0.001–0.02、宽度 70 以上”这一片整体都好。前几名之间只差 0.01 左右,和换种子的波动(0.890–0.904)同一量级,再细分已经没有意义——这正是代码 01 演示 2 说的”最后一步在挑噪声”。
- dev 分数偏乐观:搜索时那一次 dev 是 0.910,换种子重训后 dev 平均 0.899,test 平均 0.867。一是”在 24 组里挑 dev 最高的”让 dev 分数带着运气;二是 dev 只有 500 张,准确率本身的标准误约 1.3 个百分点。test 没有参与任何选择,它才是对这个配置的诚实估计(第 6、10 讲)。和第一次猜的配置比(dev 0.872),搜索带来了约 0.03 的 dev 提升。
这次搜索一共训练了 27 个模型,在 CPU 上只要几秒——是典型的”鱼子酱”式调参。如果模型大到训练一次要一天,你就只能”熊猫”式地照看一个模型了。
6. 小结 · Summary
- 超参数有主次:学习率最重要;其次是动量 、mini-batch 大小、隐藏单元数;再次是层数、学习率衰减;Adam 的 几乎不调。
- 随机搜索胜过网格,前提是只有少数维度重要(代码 01:1 个重要维度时 regret 0.0077 vs 0.0203;6 维时 0.0337 vs 0.1498;但两个维度都重要时网格略好)。由粗到细进一步把 regret 降到 0.0254;噪声主要伤害”最后一步挑最好的”,而不是”放大到哪片区域”。
- 在合适的尺度上采样:学习率 , 均匀;。线性采样时 90% 的学习率落在 ;16 次试验里找到离最优值不到 2 倍的学习率,对数采样 0.918、线性采样 0.205。 越接近 1 越敏感(0.999 → 0.9995 让平均窗口翻倍)。
- 熊猫 vs 鱼子酱:算力少、模型大时照看一个模型;算力多时并行试很多个。超参数的直觉会过时。
- BN 对每个隐藏单元在 mini-batch 上标准化 ,再用可学习的 、 缩放平移;能学成恒等变换,所以不削弱表达能力;前一层的偏置 多余()。反向公式 ,numpy 和 PyTorch 逐数字一致。
- 测试时用训练中 EWA 累积的 running mean / var(PyTorch 的 momentum = 0.1 即 ,running_var 用无偏方差)。忘了
model.eval():随机 batch 时几乎看不出(0.838 vs 0.844),按类别排序时掉到 0.233,还会悄悄改掉 running 统计量。 - BN 为什么有用:让深网对初始化和学习率都不再敏感(代码 02:8 层网络,默认初始化无 BN 完全不学,He 初始化只在窄范围内能训,BN 从 lr 0.01 到 1 都能训)。原论文的解释是减少 internal covariate shift;Santurkar et al. 的实验表明更可能是让损失曲面更平滑、允许更大的学习率。附带轻微的正则化效果,但别把它当正则化手段。小 batch、序列模型时用 LayerNorm / GroupNorm。
- softmax :hardmax 的平滑版;没有隐藏层时边界是直线; 时就是逻辑回归。多分类交叉熵 ,梯度 。数值上要减最大值、用 log-sum-exp,所以
nn.CrossEntropyLoss收 logits。 - 框架替你做了什么:张量(dtype、device)、反向模式自动微分(前向时记图,backward 沿图倒着走,
.grad累加)、层、损失、优化器、数据加载。PyTorch 每一行一个样本,,weight形状和 Ng 的 相同。float64 下手写版和 autograd 的梯度差 1e−16;训练不稳定时,舍入误差会被放大,整条轨迹只能在同一个环境里逐位复现。 - 训练循环模板(
torch_utils.py):model.train()→ 前向 → 损失 →zero_grad→backward→step;评估时model.eval()+no_grad;固定种子、单线程。迁移时最常见的坑大多不报错。
7. 常见误区 · Common pitfalls
- “网格搜索更系统、更可靠。” 只在每个维度都重要时成立。通常只有少数维度重要,网格在它们上面只试了很少几个值(代码 01:6 维时网格 regret 0.1498,随机 0.0337)。
- “学习率在 [0.0001, 1] 上随机取就行。” 要在对数尺度上取。线性均匀时 90% 的样本落在 [0.1, 1](§1.5)。
- “β 从 0.9 到 0.999 均匀取。” 要对 取对数; 越接近 1 越敏感。
- “搜索里 dev 最高的那个分数就是模型的真实水平。” 它偏乐观:挑最大值本身就挑到了运气(代码 05:0.910 → 换种子 0.899 → test 0.867)。最后要在 test 上报告一次。
- “BN 归一化之后,均值 0、方差 1 就是隐藏单元最好的分布。” 不一定,所以才有 、;它们甚至能把 BN 学成恒等变换。
- “BN 前面的 Linear 也要加偏置。” 多余:减均值把它抵消了,它的梯度恒为 0。用
bias=False,平移交给 。 - “
torch.no_grad()就是测试模式。” 不是。no_grad只管记不记计算图;BN / Dropout 的行为由model.train()/model.eval()决定。只写no_grad的评估既依赖 batch 组成,又会改掉 running 统计量。 - “BN 的作用已经被证明是减少 internal covariate shift。” 这是原论文的假说,后来的实验(Santurkar et al. 2018)对它提出了很强的质疑。BN 好用是事实,“为什么”仍有争论。
- “模型最后一层要加 softmax,再交给
nn.CrossEntropyLoss。” 不要。CrossEntropyLoss自己做 softmax(用稳定的 log-sum-exp),再加一次会让损失有个地板、训练变慢。模型输出 logits。 - “框架算的梯度一定是对的,所以我的代码一定是对的。” autograd 忠实地对你写的前向求导——如果前向写错了(形状广播、概率当 logits、忘了 eval),它会忠实地给出错的梯度。
- “PyTorch 和 numpy 的结果不完全一样,说明有一边写错了。” 不一定。每一步相同、但训练不稳定时,1e−16 的舍入差异也会被放大(§4.5)。先比较单步的梯度,再看训练是否稳定。
8. 练习 · Exercises
练习 1(采样尺度)。(a) 你认为学习率在 之间。在线性尺度上均匀采样, 的概率是多少?在对数尺度上呢?写出对数尺度采样的两行代码。(b) 你认为动量 在 之间,写出采样的代码,并说出对应的平均窗口范围。
参考答案
(a) 线性:,不到 1%。对数:,,概率 。代码:r = np.random.uniform(-5, -1);alpha = 10 ** r。
(b) :r = np.random.uniform(-4, -2);beta = 1 - 10 ** r。平均窗口 从 100 到 10,000。
练习 2(网格 vs 随机的概率)。两个超参数,只有第一个重要;在它的取值范围 里,好的值是一个宽 0.1 的区间 , 在 上均匀随机。预算 25 次。(a) 5×5 网格(每维取 0.1, 0.3, 0.5, 0.7, 0.9)至少有一次落进好区间的概率是多少?(b) 25 次随机搜索呢?(c) 如果第二个超参数也重要,结论会变吗?
参考答案
(a) 网格在第一维只有 5 个不同的值。好区间 包含网格值 当且仅当 ;5 个这样的小区间(各长 0.1,互不重叠,都在 里)总长 0.5,所以概率 。另一维的 5 次重复完全白做。
(b) 随机试验在 上均匀取值,好区间宽 0.1,所以每次落进去的概率是 0.1;25 次至少一次:。
(c) 会。两个维度都重要时,“好区域”是一个小方块,网格的均匀覆盖不再吃亏,甚至可能更好——代码 01 演示 1 的对照组(,两个都重要)里网格的平均 regret 更小(0.0394 vs 0.0610)。
练习 3(手算 softmax)。,正确类别是第 0 类。(a) 算出 softmax、交叉熵损失和 。(b) 把 换成 ,哪些量变了?(c) 把 换成 (“温度” )和 (),softmax 怎样变化?这和语言模型采样时的”温度”有什么关系?
参考答案
(a) ,和 30.193;softmax 。损失 。:把正确类往上推,其余往下推,推的力度就是它们现在的概率。
(b) 都不变(平移不变性)。这正是”先减最大值”合法的原因。
(c) :softmax,更尖(更接近 hardmax);:softmax,更平。语言模型生成文本时按 softmax 的概率抽下一个词,温度低时几乎总选最可能的词(稳定但单调),温度高时更随机(多样但容易出错)——第 20 讲会再提到。
练习 4(推导:C = 2)。证明两类的 softmax 回归和逻辑回归给出相同的预测概率和相同的损失;并说明为什么两类 softmax 回归的参数是”冗余”的。
参考答案
,分子分母同除以 得 。令 、,就是逻辑回归 。损失: 时 , 时 ,合起来就是二元交叉熵。冗余:把 、 同时加上同一个 ,差不变,预测不变——一半的参数没有用。代码 03 演示 2 (c) 数值验证了这一点(最大差 2.2e−16)。
练习 5(推导:dz = ŷ − y)。从雅可比 出发,推导 。如果标签是”软标签”( 的各分量非负、加起来等于 1,但不是 one-hot),结论还成立吗?
参考答案
。推导只用到了 ,没有用到”只有一个 1”,所以软标签也成立(label smoothing、知识蒸馏都依赖这一点;PyTorch 的 CrossEntropyLoss 也接受概率形式的标签)。
练习 6(手算 BN)。一个隐藏单元,mini-batch 里 4 个样本的 ,,,为了好算取 。(a) 算出 、、、。(b) 如果每个 都加上 10(相当于有偏置 ), 变吗?(c) 训练结束时 running mean 是 2.5、running var 是 4。测试时来了一个 的样本, 是多少?(d) PyTorch 累积 running_var 时,用的是这个 batch 的哪个方差?
参考答案
(a) ;,;;。
(b) 不变: 变成 13,减掉之后和原来一样, 不变。这就是带 BN 的层不需要 的原因。
(c) ,。注意这个结果只取决于这一个样本,和它跟谁一起送进网络无关。
(d) 无偏方差 (除以 );标准化时用的是有偏方差 3.5(代码 02 演示 1 核对过)。
练习 7(推导:b 是多余的)。用 §2.4 的紧凑公式证明 ,并由此说明:如果 后面接 BN, 的梯度恒为 0。BN 的输出对”把整列 放大 倍”是否也完全不敏感?
参考答案
,因为 。( 对 的导数是 1)。放大 倍: 时 完全不变; 时 会有一点点变化,所以只是”几乎”不敏感(代码 02: 是 5.5e−07, 时 2.2e−16)。
练习 8(数参数)。作业的网络 [256, 25, 12, 6]。(a) 不带 BN 有多少个可训练参数?(b) 两个隐藏层都加 BN(Linear 去掉偏置)后呢?(c) BN 层还额外存了哪些不参与训练的数?用 torch_utils.count_parameters 和 model.named_buffers() 验证。
参考答案
(a) (代码 05 演示 2 打印的就是这个数)。
(b) 隐藏层去掉 、加上 :。
(c) 每个 BN 层的 running_mean、running_var(各 个数)和一个计数器 num_batches_tracked: 个。它们是 buffer,不是参数:不参与梯度下降,但会随模型一起保存和加载。
练习 9(先预测,再运行)。(a) 在代码 02 演示 2 里,如果”忘了 eval”时把按类别排好序的 1000 张测试图一次性放进一个 batch,准确率大约是多少?每批 256 张呢?(b) 把代码 04 演示 2 (a) 的学习率从 0.1 改成 1.0、1.1, 会怎样?(c) 代码 03 演示 4 如果是 10 类,“softmax 两次”的训练目标下限是多少?
参考答案
(a) 一次 1000 张:顺序无关紧要,整个测试集的统计量接近总体统计量,准确率应和 eval 模式差不多(我运行的结果是 0.851,eval 是 0.844)。每批 256 张时,每批里只有一两个类,准确率会大跌(我运行的结果是 0.368)。
(b) 。:,在 0 和 10 之间来回跳,永远不收敛;:,振幅每步放大 1.2 倍,发散(0、11、−2.2、13.64……)。二次函数 的曲率是 2,临界学习率是 (第 2 讲 §4.2)。
(c) 。类越多,地板越高。
练习 10(设计一次搜索)。你有 4 块 GPU、一周时间;你的模型在一块 GPU 上训练一次要 6 小时。要调学习率、权重衰减 、dropout 保留概率、batch 大小。(a) 你一共能训练多少次?(b) 这是熊猫还是鱼子酱?(c) 写出你的搜索方案(采样尺度、粗搜和细搜各多少次、最后怎样确认)。
参考答案
(a) 次(理想情况,不算调试和意外)。
(b) 介于两者之间,偏鱼子酱:能并行,但总次数有限。
(c) 一种合理的方案:学习率在 对数采样, 在 对数采样(它也是”按倍数起作用”的),保留概率在 线性采样,batch 从 {64, 128, 256} 里选。先用较短的训练(比如 1/4 的 epoch,1.5 小时)粗搜约 60 组;看前 10 名落在哪里,缩小范围细搜约 30 组完整训练;最后前 3 名各换 3 个种子重训(9 次)。剩下的预算留给出错和意外。最终配置在 test 上只评估一次。注意:短训练偏向起步快的配置,粗搜结果要谨慎解读。
9. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C2M3 “Hyperparameter Tuning, Batch Normalization and Programming Frameworks”(Andrew Ng)——本讲的主线。
- PyTorch 官方教程 “Learn the Basics”(pytorch.org/tutorials)——张量、Dataset / DataLoader、nn.Module、autograd、优化循环,和 §4 的顺序几乎一样。
- Goodfellow, Bengio & Courville (2016). Deep Learning. MIT Press:§6.2.2.3(softmax 输出单元)、§6.5(反向传播与计算图)、§8.7.1(Batch Normalization)、§11.4(选择超参数:网格、随机搜索)。
超参数搜索
- Bergstra & Bengio (2012). Random search for hyper-parameter optimization. JMLR 13. ——随机搜索为什么胜过网格(低有效维度)。
- Snoek, Larochelle & Adams (2012). Practical Bayesian optimization of machine learning algorithms. NeurIPS.
- Li, Jamieson, DeSalvo, Rostamizadeh & Talwalkar (2018). Hyperband: A novel bandit-based approach to hyperparameter optimization. JMLR.
- Jaderberg et al. (2017). Population based training of neural networks. arXiv.
- Godbole, Dahl, Gilmer, Shallue & Nado (2023). Deep Learning Tuning Playbook.(Google Research 在 GitHub 上公开的调参指南)
Batch Normalization 及其争议
- Ioffe & Szegedy (2015). Batch normalization: Accelerating deep network training by reducing internal covariate shift. ICML.
- Santurkar, Tsipras, Ilyas & Madry (2018). How does batch normalization help optimization? NeurIPS.
- Bjorck, Gomes, Selman & Weinberger (2018). Understanding batch normalization. NeurIPS.
- Ba, Kiros & Hinton (2016). Layer normalization. arXiv. ——第 17 讲 Transformer 用的就是它。
- Wu & He (2018). Group normalization. ECCV.
自动微分与框架
- Baydin, Pearlmutter, Radul & Siskind (2018). Automatic differentiation in machine learning: a survey. JMLR 18. ——正向模式 vs 反向模式,为什么反向传播只是反向模式自动微分的特例。
- Paszke et al. (2019). PyTorch: An imperative style, high-performance deep learning library. NeurIPS.
- Abadi et al. (2016). TensorFlow: A system for large-scale machine learning. OSDI.
10. 下一讲预告 · Next lecture
到这里,Part II”改进深度神经网络”就结束了。你已经有了一整套工具:怎样诊断偏差和方差、怎样正则化(第 6 讲),怎样让优化问题好解(第 7 讲),怎样更快地下山(第 8 讲),怎样调超参数、用 BN 和 softmax、用框架(本讲)。
但本讲的 §5 也暴露了一个更大的问题:有了这么多旋钮,下一步到底该拧哪一个? 手势分类器训练集 1.000、dev 0.899、test 0.867——是该加数据、加正则化、换架构,还是该检查 dev 和 test 是不是同一个分布?每个方向都可能花掉几周。
第 10 讲:机器学习策略——正交化、评估指标、误差分析与数据不匹配。 这是 Ng 最有特色的一部分内容(Coursera 第三门课,也是 Machine Learning Yearning 的主题):
- 正交化:每个旋钮只管一件事,就像老式电视机的”宽度""高度""梯形”旋钮;
- 单一数字评估指标、satisficing vs optimizing 指标,以及 dev / test 怎样设;
- 用 human-level performance 估计 Bayes error,区分 avoidable bias 和 variance;
- 误差分析:数一数模型错在哪儿,决定先修哪个;
- 训练分布和测试分布不一样时怎么办:train-dev set 与四种误差;迁移学习、多任务学习、端到端学习各在什么时候有用。
从下一讲起,代码继续用 PyTorch;本讲的 torch_utils.py 训练循环模板可以直接导入使用。