对应 Maps to:Coursera Deep Learning Specialization C2M2 “Optimization Algorithms” 的全部视频(Mini-batch Gradient Descent、Understanding Mini-batch Gradient Descent、Exponentially Weighted Averages、Understanding Exponentially Weighted Averages、Bias Correction in Exponentially Weighted Averages、Gradient Descent with Momentum、RMSprop、Adam Optimization Algorithm、Learning Rate Decay、The Problem of Local Optima);编程作业 “Optimization Methods”(月牙数据、三层网络、mini-batch 64,比较 GD / Momentum / Adam;较新的版本加了学习率衰减)。在 Fall 2025 的课表里,C2M2 和 C2M1 排在同一周(那一周的课堂讲座讲对抗样本与生成模型,见第 18 讲)。 依据说明:Coursera 的视频和编程作业要注册才能看,所以本讲不引用其中的原文。内容依据 Andrew Ng 在 C2M2 里广为人知的讲法(伦敦一年的气温、“小球滚下碗”的比喻、Adam 的默认超参数、几个学习率衰减公式、高维空间里的鞍点),以及原始文献:Polyak(1964)的 heavy ball、Hinton 的 Coursera 讲义(RMSprop)、Kingma & Ba(2015,Adam)、Dauphin et al.(2014,鞍点)等(见 §13)。作业里的 sklearn
make_moons换成了第 3 讲planar_data.py里用 numpy 重写的等价版本,所以具体的点和数字和作业不同。文中提到的作业细节(默认学习率、epoch 数、作业的结论)凭对这份公开作业的了解写成,不同版本之间可能有出入。 配套代码 Code:code/lecture08/(numpy 从零实现;5 个脚本 + 2 个工具模块;04约 75 秒(有--quick),其余 3–12 秒) 预计阅读时间:3 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说清楚 batch / mini-batch / stochastic 梯度下降的取舍:每一步的准确度、每个 epoch 走几步、向量化效率。能从”按步数""按样本数""按耗时”三种口径读懂一张收敛曲线,知道 mini-batch 训练的代价曲线为什么会抖。
- 写出指数加权平均 ,用 解释”约等于最近 个数的平均”;说出偏差修正为什么需要、怎么做。
- 用”病态的碗”解释普通梯度下降为什么走之字形、为什么步数和条件数 成正比。
- 写出 Momentum、RMSprop、Adam 的更新公式,说出每一项的作用:momentum 平均掉震荡、允许更大的学习率;RMSprop 按维度缩放步长;Adam 两者结合再加偏差修正。知道 Adam 的默认超参数 、、。
- 知道这些方法各自的局限:同一学习率下 momentum 不一定更快,它也会冲过谷底;按维度缩放只对”和坐标轴对齐”的病态有效;常数学习率的 RMSprop / Adam 停不稳;Adam 不是”不用调学习率”。
- 写出几种学习率衰减公式,解释 mini-batch 噪声造成的”噪声球”,知道现代常用的 warmup + cosine。
- 解释为什么在高维空间里局部最优很少是问题,梯度为 0 的点大多是鞍点,真正拖慢训练的是平台;知道 Adam 为什么会”部分掩盖”梯度消失。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开 Previewed only |
|---|---|
| 第 2 讲 §4:梯度下降、学习率、” 以上会发散” | 为什么输入归一化让碗变圆、Hessian 与条件数的系统讲法(第 7 讲) |
第 4 讲:L 层网络的前向 / 反向(deep_nn.py) | 超参数的系统搜索、Batch Norm(第 9 讲) |
第 1 讲:tiny_nn.train 用 mini-batch、默认用 Adam(当时是黑盒) | PyTorch 里的优化器(torch.optim,第 9 讲起) |
| 一点线性代数:特征值(只在 §9 用到) |
第 1 讲的 tiny_nn.py 把”优化”这一块当黑盒:train 每一步取一个 mini-batch,Adam 类的注释写着”第 8 讲详细推导,这里只给直觉”。这一讲就把它拆开。第 4 讲代码 03、04 借用过这个 Adam,第 5 讲的 case_tools.ArrayAdam 也是同一个公式。读完这一讲,这些代码里的每一行你都能自己写出来。
0.3 本讲地图 Map
§1  优化要解决的三个问题:每一步太贵 / 方向不好 / 步长一成不变
§2  Mini-batch 梯度下降:切块、代价曲线为什么抖、三种口径、batch 大小        ← 代码 01
§3  指数加权平均:伦敦的气温(合成)、1/(1−β) 天、偏差修正                   ← 代码 02 演示 1–3
§4  Momentum:病态的碗、平均掉震荡、"小球"的比喻和它的局限                    ← 代码 03 演示 1、2、4
§5  RMSprop:按维度缩放步长                                                  ← 代码 03 演示 2
§6  Adam:两者结合 + 偏差修正;各自最好的学习率;旋转的碗                     ← 代码 02 演示 4、代码 03 演示 3
§7  在网络上比较:复刻 "Optimization Methods" 作业                           ← 代码 04 演示 3–4
§8  学习率衰减:噪声球、常见公式、warmup + cosine                            ← 代码 04 演示 1、2、5
§9  局部最优的问题:鞍点与平台                                               ← 代码 05
§10–14  小结、常见误区、练习、延伸阅读、下一讲预告
工具模块 optimizers.py 里是本讲所有算法的从零实现,函数名和 Coursera 作业一样(random_mini_batches、initialize_velocity、update_parameters_with_momentum、initialize_adam、update_parameters_with_adam、update_lr、schedule_lr_decay、model……),前向和反向直接用第 4 讲的 deep_nn.py。
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 | 例子 |
|---|---|---|
| 第 个 mini-batch(花括号上标;圆括号 是第几个样本,方括号 是第几层) | 形状 | |
mini-batch 大小(Ng 的视频里没有专门的字母,代码里叫 mini_batch_size) | 64、128、256、512 | |
| epoch | 把训练集完整过一遍 | 、 时 1 个 epoch = 5 步 |
| 、 | §3:第 天的观测值、到第 天为止的指数加权平均 | |
| momentum / 指数加权平均的系数 | 0.9 | |
| 梯度的指数加权平均(“一阶矩”)、梯度平方的指数加权平均(“二阶矩”) | 形状和 相同 | |
| Adam 里 和 的系数(RMSprop 里 的系数也写 ) | 0.9、0.999 | |
| 防止除以 0 的小数 | ||
| §4–6:参数更新的次数(从 1 数起),偏差修正要用 | ||
| 、decay_rate | 学习率衰减的起始学习率、衰减速度 | |
| 条件数:最陡方向的曲率 / 最平方向的曲率 | 的 |
本讲所有平方、开方、除法作用在梯度上时都是逐元素的: 是 的每个元素各自平方,不是矩阵乘法。
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出(固定随机种子,同一台机器上重复运行逐字相同;只有代码 01 演示 3 的计时每次不同)。代码 04 完整运行约 75 秒,讲义里的数字来自完整运行,--quick 的数字会不一样。气温、“老师网络”、月牙都是合成数据,二次函数和鞍点是写下来的公式,所以我们知道真相。好几处实验结果和我写代码前的预想不一样:同一学习率下 momentum 并不更快,作业里”Adam 赢”主要是学习率的原因,等等。讲义按实际结果来写,这些情况都列在代码 README 的”关于实验结果”里。
1. 优化要解决的三个问题 · What problems are we solving?
第 2 讲的梯度下降只有一行:。它在逻辑回归上工作得很好,为什么还需要一整讲的”优化算法”?
先想想训练一个真实的网络时,时间花在哪里。总时间 ≈ 每一步的代价 × 需要走的步数。这两项各有自己的问题,再加上一个和时间有关的问题:
| 问题 | 症状 | 本讲的对策 |
|---|---|---|
| 每一步太贵 | 是几百万时,算一次梯度要把几百万个样本过一遍,走一步要等很久 | mini-batch:每一步只看一小块数据(§2) |
| 每一步的方向不好 | 代价函数是一个被压扁的碗,梯度不指向最低点,而是横着指向”最近的碗壁”,于是走之字形 | momentum、RMSprop、Adam:平均掉震荡、按维度调整步长(§4–6) |
| 步长一成不变 | 开头需要大步走得快,最后需要小步停得准;mini-batch 的噪声让常数学习率停不准 | 学习率衰减(§8) |
还有第四个问题,它和地形本身有关:代价函数上有很多梯度为 0 或接近 0 的地方。早年大家最担心”坏的局部最优”,Ng 用这个模块的最后一个视频解释,在高维空间里真正的麻烦是鞍点和平台(§9)。
本讲用五个”试验场”,每个都选得能把一种现象看清楚:
- “老师网络”分类任务(第 1 讲
dl_data.py):看 batch 大小(§2)和深层 sigmoid 网络的平台(§9.4); - 一年的每日气温(合成):看指数加权平均(§3);
- 二维二次函数 :看各种优化器的轨迹(§4–6);
- 月牙数据(第 3 讲
planar_data.py):复刻 Coursera 作业(§7、§8); - 一个二维鞍点和随机对称矩阵:看局部最优的问题(§9)。
2. Mini-batch 梯度下降 · Mini-batch gradient descent
2.1 一步该看多少数据?
第 2–4 讲的梯度下降每一步都用全部 个样本算 和梯度,这叫 batch gradient descent(全批量梯度下降)。Ng 的例子:。向量化之后一次算 500 万个样本也不算太慢,但每走一步都要把 500 万个样本全部过一遍——在看完所有数据之前,参数一点都没动。
想法很自然:把训练集切成很多小块,每看完一块就更新一次参数。 每块 1000 个样本,就是 5000 块:
的形状是 , 是 。算法是两层循环:
for epoch in range(num_epochs):            # 外层:一个 epoch = 把训练集完整过一遍
    打乱训练集,切成 mini-batch X^{1}, ..., X^{T}
    for t in 1..T:                         # 内层:每个 mini-batch 更新一次
        前向:用 X^{t} 算 A^{[L]}
        cost:J^{t} = (1/B) Σ_{i ∈ 第 t 块} L(ŷ^(i), y^(i))      (+ 正则项,第 6 讲)
        反向:算 dW^{[l]}、db^{[l]}(只用这一块的样本)
        更新:W^{[l]} := W^{[l]} − α dW^{[l]},b 同理
前向、反向、更新的公式和第 4 讲一模一样,只是把 换成了 、把 换成了 。全批量梯度下降一个 epoch 走 1 步,mini-batch 一个 epoch 走 5000 步(代码 01 演示 1(a))。在大数据上,mini-batch 几乎总是快得多,这也是第 1 讲 tiny_nn.train 默认用 batch 128 的原因。
2.2 切 mini-batch:打乱、切块、最后一块
optimizers.random_mini_batches 和 Coursera 作业的同名函数一样做两件事:
- 打乱(shuffle):用同一个随机排列同时重排 和 的列,保证每个输入仍然配着自己的标签(自检里专门检查了这一点);
- 切块(partition):按顺序每 列切一块。 不能被 整除时,最后一块是”不满的”。
代码 01 演示 1(b):月牙数据 、,切出 5 块,大小是 [64, 64, 64, 64, 44]。最后一块怎么办有两种常见做法:
- Coursera 作业(以及
random_mini_batches的默认值):保留这个 44 个样本的小块; - 第 1 讲的
tiny_nn.train:剩下的样本不够一个 batch,就丢掉,直接重新打乱开始下一个 epoch(相当于drop_last=True)。这个 epoch 有 44 个样本(14.7%)没用上,但下个 epoch 没用上的是另一批,长期看每个样本都会被用到。
两种都对。PyTorch 的 DataLoader 也有 drop_last 这个选项。 远大于 时两者几乎没有区别;保留的坏处是最后一块的梯度噪声更大,丢掉的坏处是每个 epoch 有一小部分数据没看到。
为什么一定要打乱? 月牙数据是按类别排好的:前 150 个全是类别 0,后 150 个全是类别 1。演示 1(c) 训练 500 个 epoch,看最后一个 epoch 里每块的情况:
| 第 1 块 | 第 2 块 | 第 3 块 | 第 4 块 | 第 5 块 | 测试准确率 | |
|---|---|---|---|---|---|---|
| 每个 epoch 重新打乱:类别 1 比例 | 0.52 | 0.56 | 0.47 | 0.52 | 0.41 | |
| cost | 0.071 | 0.029 | 0.130 | 0.103 | 0.150 | 0.968 |
| 不打乱:类别 1 比例 | 0.00 | 0.00 | 0.66 | 1.00 | 1.00 | |
| cost | 0.319 | 0.048 | 0.139 | 0.059 | 0.037 | 0.962 |
不打乱时,每个 epoch 的最后两块全是类别 1,网络被推向”猜 1”;下一个 epoch 一开头就是全是类别 0 的一块,cost 冲到 0.319。代价曲线上会出现一个每个 epoch 重复一次的锯齿。诚实地说,在这个小问题上最终测试准确率差不多(0.962 vs 0.968)。数据按时间、按来源排序时,不打乱的害处会大得多。打乱几乎没有成本,所以默认总是打乱。
2.3 代价曲线为什么会抖
用全批量梯度下降时,学习率合适的话 每一步都下降。换成 mini-batch,把每一步的 画出来,曲线会上下抖,但总体趋势向下。Ng 的解释是:有的 mini-batch 碰巧”容易”,有的碰巧”难”(比如有几个标错的样本),所以 本身就有起伏。
更根本的原因是:mini-batch 的梯度是真梯度的一个带噪声的估计。设 是全部 个样本的平均梯度, 是随机抽 个样本的平均梯度。 的期望正好是 (无偏),但它有方差:
其中 是”单个样本的梯度和 的平均平方距离”, 是”不放回抽样”的修正( 时为 0)。误差按 缩小:想把噪声减半,batch 要大 4 倍。
代码 01 演示 2 在刚初始化的网络 [10, 32, 32, 1] 上(“老师网络”任务,4096 个样本),对每个 随机抽 200 个 mini-batch:
| 相对误差 | 理论值 | 平均 | 是下坡方向的比例 | 这块 cost 的标准差 | |
|---|---|---|---|---|---|
| 1 | 2.632 | 2.756 | −0.041 | 44% | 1.157 |
| 8 | 1.006 | 0.974 | 0.703 | 98% | 0.436 |
| 64 | 0.335 | 0.342 | 0.960 | 100% | 0.140 |
| 512 | 0.110 | 0.114 | 0.995 | 100% | 0.046 |
| 4096 | 0.000 | 0.000 | 1.000 | 100% | 0.000 |
几个值得停下来想的地方:
- 实测和理论值吻合,误差确实按 缩小: 从 1 到 64(64 倍),误差从 2.63 降到 0.34(约 1/8)。
- 单个样本的梯度几乎全是噪声:它和真梯度的平均夹角余弦接近 0,只有 44% 的样本给出”下坡方向”(沿它走一小步,全体 cost 会下降)。也就是说,随便挑一个样本,按它的梯度走一小步,更可能让整体 cost 上升。SGD 照样能工作,因为很多步的随机误差会互相抵消,平均下来朝着下坡走。§3 的指数加权平均是同一个道理。
- 时 和 的夹角余弦已经是 0.96,方向基本对了。花 64 倍的计算把梯度算到 那么准,换来的方向改进并不多。这就是 mini-batch 划算的原因。
- 最后一列:mini-batch 上算出来的 cost 本身也在抖。所以训练日志里”每一步的 cost”抖动,一部分是参数在变,一部分只是这一块数据碰巧难或碰巧容易。看趋势要看平均(比如每个 epoch 的平均,Coursera 作业就是这样记录的),或者定期在整个训练集 / 验证集上算一次。
2.4 三种极端的取舍:按步数、按样本数、按耗时
Ng 把 batch 大小的两个极端说得很清楚:
- :batch gradient descent。每一步方向最准,但每一步太贵。
- :stochastic gradient descent(SGD,随机梯度下降)。每一步只看一个样本,方向很吵,而且完全丢掉了向量化的好处。
- 中间:mini-batch。两头的好处各占一部分。
代码 01 演示 3 把这个取舍量化了:同一个网络、同一组初始参数、普通梯度下降,学习率都是 0.1(SGD 另加一组 0.01),比较全训练集上的 cost。
(a) 按更新步数(走了同样多步之后):
| 10 步 | 100 步 | 1000 步 | |
|---|---|---|---|
| 全批量 | 0.582 | 0.382 | 0.296 |
| 0.585 | 0.383 | 0.298 | |
| 0.591 | 0.384 | 0.303 | |
| 0.600 | 0.474 | 0.339 | |
| SGD ,lr 0.1 | 1.436 | 0.513 | 0.409 |
| SGD ,lr 0.01 | 0.794 | 0.595 | 0.406 |
(b) 按看过的样本数(1 epoch = 4096 个样本):
| 1 epoch | 5 epoch | 30 epoch | 30 epoch 的步数 | |
|---|---|---|---|---|
| 全批量 | 0.828 | 0.623 | 0.484 | 30 |
| 0.546 | 0.395 | 0.326 | 480 | |
| 0.417 | 0.340 | 0.262 | 1,920 | |
| 0.371 | 0.308 | 0.164 | 15,360 | |
| SGD,lr 0.1 | 0.510 | 0.431 | 0.630 | 122,880 |
| SGD,lr 0.01 | 0.375 | 0.304 | 0.166 | 122,880 |
(c) 按耗时(下面是我运行的一次,计时数字每次都不一样):
| 每步耗时 | 每个样本 | 降到 cost ≤ 0.3:epoch / 耗时 | |
|---|---|---|---|
| 全批量 | 717 µs | 0.18 µs | 926.00 / 0.666 s |
| 79 µs | 0.31 µs | 59.00 / 0.074 s | |
| 48 µs | 0.74 µs | 16.38 / 0.050 s | |
| 34 µs | 4.28 µs | 4.50 / 0.079 s | |
| SGD,lr 0.1 | 31 µs | 30.62 µs | 未达到 |
| SGD,lr 0.01 | 30 µs | 29.75 µs | 4.88 / 0.606 s |
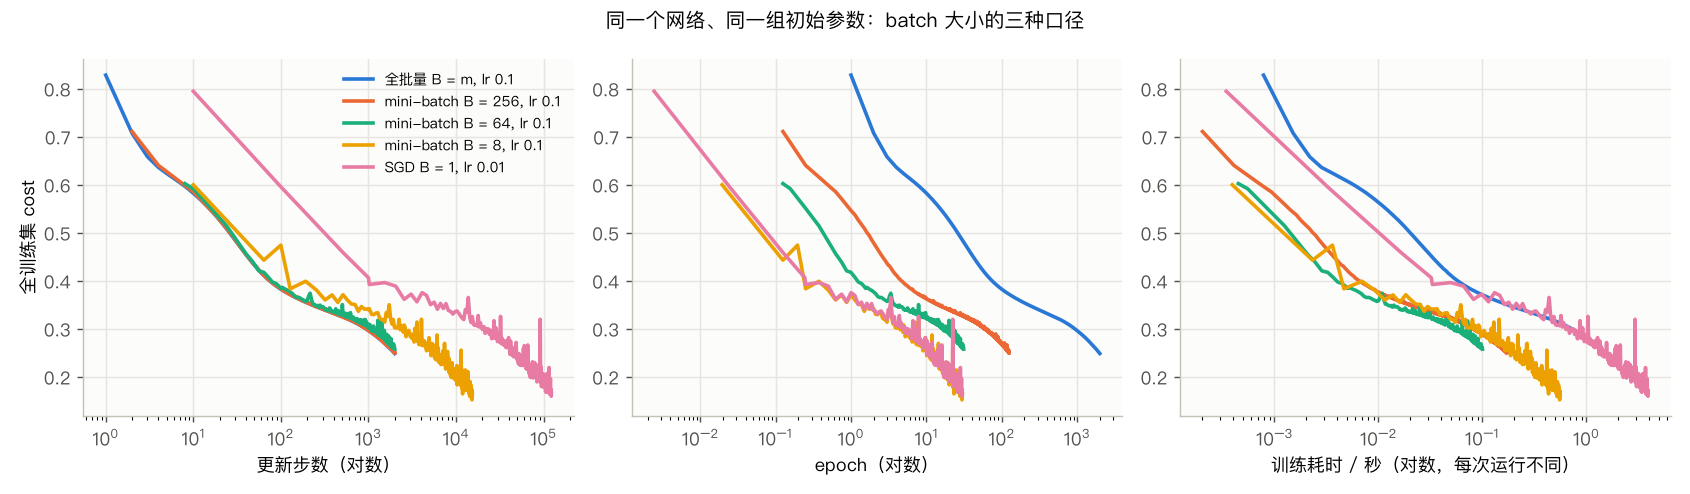
三张表讲了三个不同的故事:
- 按步数,全批量最好:每一步的梯度最准。
- 按样本数,结论反过来:1 个 epoch 里全批量只走了 1 步, 走了 64 步。30 个 epoch 后全批量才到 0.484, 已经 0.262, 到了 0.164。很多步”吵但便宜”的小步,加起来比少数几步”准但贵”的大步走得远。 学习率合适的 SGD(lr 0.01)按样本数也很省数据(0.166)。lr 0.1 的 SGD 噪声太大,cost 一直来回跳。
- 按耗时,mini-batch 最快:SGD 处理一个样本的时间是全批量的约 170 倍(这一次运行的数字;我运行了几次,都在 170–190 倍之间)。一次只算一个样本,Python 的函数调用、numpy 的调度开销完全摊不薄。在 GPU 上这个差距更悬殊,因为 GPU 需要足够大的矩阵才能把成千上万个计算核心填满。
所以实践中几乎总是用 mini-batch:既保留了向量化(每个样本便宜),又每个 epoch 走很多步。
一个说明:这里所有 用的是同一个学习率。最合适的学习率本身会随 变化( 越大噪声越小,通常可以用更大的学习率;Goyal et al. 2017 的”linear scaling rule”建议 batch 放大 倍时学习率也放大 倍,并配合 warmup),所以更严格的比较应该给每个 各自调学习率。这个演示只是展示三种口径的差别,不是给出”最好的 ”。
2.5 mini-batch 大小怎么选
Ng 的经验法则:
- 训练集小(比如 ):直接用全批量梯度下降,mini-batch 带来的好处不大。
- 否则:常用 64、128、256、512。这些都是 2 的幂,Ng 的理由是计算机内存的布局方式让 2 的幂有时跑得更快。这是一个惯例,在现代硬件上差别通常不大,不必拘泥。1024 也有人用,但少一些。
- 确保一个 mini-batch 的数据(连同前向时存下的 cache)能放进 CPU / GPU 的内存。一个 batch 的激活值所占的内存和 成正比(第 4 讲 §4.4 讲过 cache 的代价)。放不下的话,要么减小 ,要么用”梯度累积”(gradient accumulation:几个小 batch 的梯度加起来再更新一次,效果接近一个大 batch)。
本身也是一个超参数,它和学习率是联动的(上面的说明)。一个常被讨论的现象是:很大的 batch 有时泛化得差一些,一种解释是小 batch 的梯度噪声起了某种正则化的作用(Keskar et al. 2017 的”sharp minima”假说;也有研究认为调好学习率和训练时长之后差别可以消除)。这方面没有定论。实用的做法是:在显存允许、训练速度合适的范围里选一个 ,然后围绕它调学习率。
3. 指数加权平均 · Exponentially weighted averages
下面三种优化器(momentum、RMSprop、Adam)共用一个”零件”:指数加权平均(exponentially weighted average,统计里也叫 exponentially weighted moving average)。Ng 先用三个视频把这个零件讲透,再拿它去组装优化器。我们也照这个顺序。
3.1 伦敦的气温(合成)
Ng 的例子是伦敦一年里每天的气温:一串很吵的数 。我们想要一条平滑的曲线,看出季节的变化。
代码 02 用一份合成的数据代替真实的伦敦气温:季节曲线 °C(1 月中旬最冷约 5 °C,7 月中旬最热约 19 °C),加上每天独立的高斯噪声(标准差 3 °C)。这一年最低 −1.7 °C,最高 25.4 °C。真实天气的噪声前后几天是相关的,这里用独立噪声,是为了让”噪声被平均掉多少”有一个干净的公式。另外,Ng 在视频里用华氏度,这里换成了摄氏度。
3.2 公式
每来一个新数,就把旧的平均打 折,再加上新数的 份。代码 02 演示 1 用三个 :
| ≈ 平均几天 | 噪声剩下(°C) | 理论值 | 最热的一天 | 滞后(天) | 季节起伏保留 | 和季节曲线的总误差(°C) | |
|---|---|---|---|---|---|---|---|
| 0.5 | 2 | 1.75 | 1.73 | 第 198 天 | 1 | 100% | 1.76 |
| 0.9 | 10 | 0.80 | 0.69 | 第 206 天 | 9 | 96% | 1.17 |
| 0.98 | 50 | 0.29 | 0.30 | 第 237 天 | 40 | 84% | 3.37 |
(季节曲线本身在第 197 天最热。因为平均是线性的,“噪声剩下多少”只对噪声做平均来量,“滞后多少”只对季节曲线做平均来量,两者互不干扰。表中只看第 61 天以后,避开开头的”热身期”,开头的问题在 §3.5 讲。)
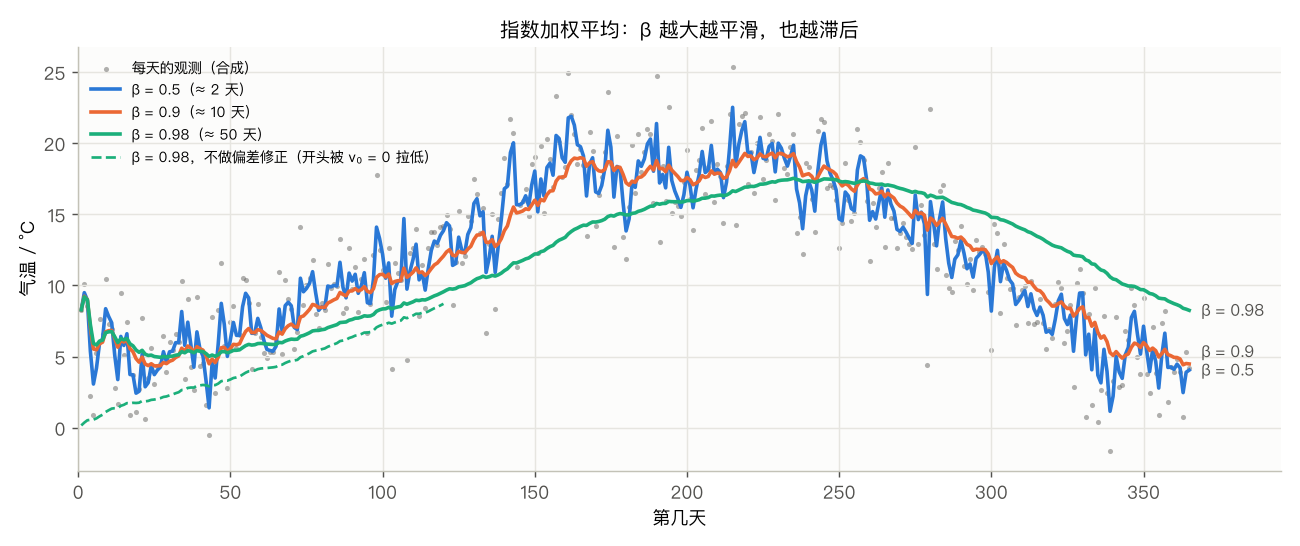
这张表就是 Ng 那三条曲线(黄、红、绿)的定量版:
- 越大,曲线越平滑:噪声从每天 3 °C 降到 1.75、0.80、0.29 °C。对独立噪声,理论值是 (练习 3)。0.9 那一行实测 0.80 和理论 0.69 差得多一点,是因为 大时相邻几天的平均值高度相关,305 天里的样本标准差本身就有不小的随机误差。
- 代价是滞后: 的曲线把最热的一天推迟了 40 天,季节起伏也只剩 84%(夏天不够热、冬天不够冷)。Ng 说绿线”适应得更慢”、“往右移”,就是这个意思。
- 两种误差此消彼长: 噪声大, 滞后大,总误差在 时最小。 是一个超参数,最好的值取决于信号变化得多快、噪声有多大。
在优化里,“信号”是真正的下坡方向,“噪声”是 mini-batch 的随机性和来回的震荡。Momentum 默认用 ,就是在”平滑”和”反应速度”之间取的一个折中。
3.3 为什么”约等于最近 天的平均”
把 (3.1) 一层层展开:
天以前的数拿到的权重是 ,按 的幂指数衰减,“指数加权”的名字就是这么来的。权重衰减到多小可以算”不算了”?Ng 的说法是降到今天的 左右。令 ,那么 天以前的权重相对于今天是
所以 大约是最近 天的平均。代码 02 演示 2:
| 今天的权重 | 天前的权重 | 最近 天的权重之和 | 平均”年龄”(天) | 半衰期(天) | |||
|---|---|---|---|---|---|---|---|
| 0.5 | 2 | 0.500 | 0.12500 | 0.2500 | 0.750 | 1.0 | 1.0 |
| 0.9 | 10 | 0.100 | 0.03487 | 0.3487 | 0.651 | 9.0 | 6.6 |
| 0.98 | 50 | 0.020 | 0.00728 | 0.3642 | 0.636 | 49.0 | 34.3 |
| 0.999 | 1000 | 0.001 | 0.00037 | 0.3677 | 0.632 | 999.0 | 692.8 |
一列从 0.25 逐渐逼近 。这只是一个经验说法,不是精确的窗口:最近 天的权重加起来只有约 63%,另外 37% 分给了更早的日子。另一种同样合理的”窗口长度”是平均年龄 (练习 2), 时是 49 天,它正好是一条直线(线性变化的信号)会被拖后的天数。演示 1 的季节曲线是弯的,实测滞后是 9 天()和 40 天()。
3.4 实现:一行代码,一个数的内存
v = 0
for theta in data:
v = beta * v + (1 - beta) * theta # optimizers.ewa 就是这一行不管平均多少天,只需要记住一个数。如果真的保存最近 50 天的数据再求平均,要 50 倍的内存。对一个有上亿参数的网络,每个参数都要这样一份”平均”,这个差别就很要紧了。这也是为什么 Adam 额外的内存只是参数量的 2 倍(每个参数一份 、一份 )。
3.5 偏差修正 · Bias correction
(3.1) 有一个问题: 是一个”假的”初始值。第 1 天 , 时只有当天气温的 2%。代码 02 演示 3:
| 第 天 | 当天气温 | (不修正) | 前 天简单平均 | ||
|---|---|---|---|---|---|
| 1 | 8.29 | 0.17 | 0.0200 | 8.29 | 8.29 |
| 2 | 10.10 | 0.36 | 0.0396 | 9.20 | 9.19 |
| 5 | 0.93 | 0.57 | 0.0961 | 5.93 | 6.02 |
| 10 | 7.28 | 1.23 | 0.1829 | 6.74 | 6.74 |
| 50 | 7.42 | 3.40 | 0.6358 | 5.34 | 5.36 |
| 200 | 19.53 | 15.68 | 0.9824 | 15.96 | 11.51 |
(;完整的表和 的表见代码输出。)
前几十天的 都被那个 0 往下拉。前 10 天的平均气温是 6.74 °C, 却只有 1.23 °C。原因就在展开式里: 的权重 加起来是 ,不是 1。剩下的 那部分权重给了 。修正的办法就是把权重重新归一化:
修正后 恰好成立(表的第一行)。开头几天 很接近”前 天的简单平均”,因为 远小于 时各天的权重几乎一样。 变大以后 ,修正自动消失:第 200 天 ,修正前后只差 0.28 °C。(第 200 天的 和”前 200 天的简单平均”差得很远,这不是 bug:指数加权平均本来就更看重最近的日子,春夏在升温。)
什么时候需要修正? 偏差大约持续 步。Momentum 用 ,10 步左右偏差就没了,Ng 说实践中很多人不做修正。Adam 的 ,偏差要持续上千步,必须修正(§6.3)。
4. Momentum · Gradient descent with momentum
4.1 病态的碗:梯度下降为什么走之字形
Ng 讲 momentum 时画了一张图:一个被压扁的椭圆碗,梯度下降在窄的方向上来回震荡,在长的方向上慢慢挪。代码 03 把这张图变成可以运行的实验:
叫条件数(condition number):最陡方向的曲率 / 最平方向的曲率。 越大,碗越扁,问题越病态(ill-conditioned)。梯度下降每走一步,两个方向各自按一个固定倍数收缩:
代码 03 演示 1(;“收敛步数”是 降到初始值的 以下并且一直保持的步数):
| 学习率 | 方向倍数 | 方向倍数 | 收敛步数 |
|---|---|---|---|
| 0.01 | 0.990 | 0.750 | 641 |
| 0.03 | 0.970 | 0.250 | 212 |
| 0.06 | 0.940 | −0.500 | 105 |
| 0.0769(最优) | 0.923 | −0.923 | 87 |
| 0.079 | 0.921 | −0.975 | 264 |
| 0.081 | 0.919 | −1.025 | 发散 |
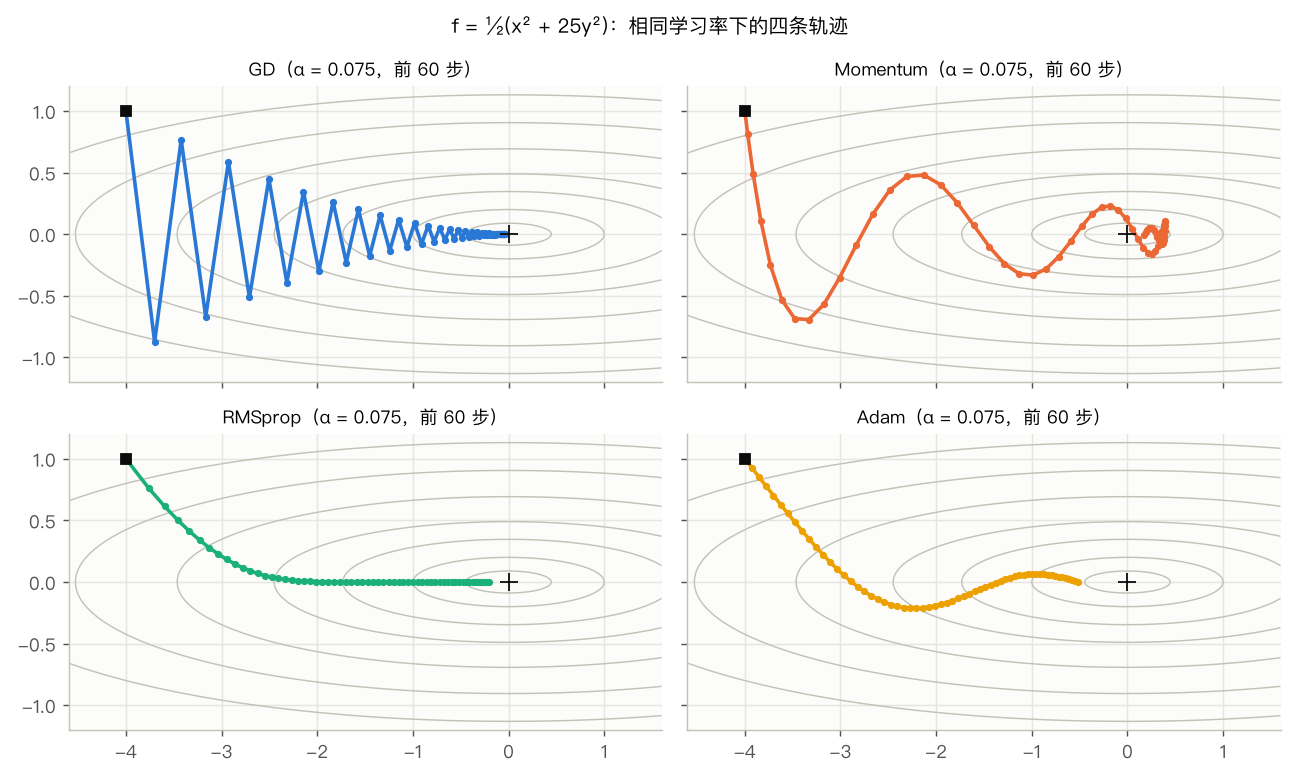
这就是第 2 讲 §4.2”学习率超过 就会发散”在两个方向上的版本:
- 学习率被陡的方向卡住。 时 , 越震越大,发散。 方向的倍数是负数时, 每一步变号,这就是图里左上角 GD 的之字形。
- 在平的方向上, 意味着 每步最多缩小 8%,只能慢慢挪。最优学习率 让两个方向收缩得一样快,每步乘以 。
- 步数和 成正比:最优学习率下, 分别要 35 / 87 / 346 / 3454 步。
深度网络的代价函数在不同方向上的曲率可以差好几个数量级。两种对策:改地形,让碗变圆(第 7 讲的输入归一化,第 9 讲的 Batch Norm);或者改走法,也就是本讲的 momentum、RMSprop、Adam。
4.2 算法
Momentum 的想法:不直接用当前的梯度走,而是用最近若干步梯度的指数加权平均走。 在第 次迭代:
初始化为 0(initialize_velocity),形状和对应的参数相同。超参数是 和 , 是很常用的默认值(“平均最近约 10 步的梯度”),一般不用调。对照 update_parameters_with_momentum,每个参数就是两行。
4.3 为什么有效,以及一个常被说错的地方
Ng 的直觉解释:在 方向(陡的方向),梯度每一步正负交替,平均起来接近 0,震荡被”平均掉”了;在 方向(平的方向),梯度一直指向同一边,平均值仍然那么大,前进不受影响。于是轨迹更直接地朝着最低点走。
这个直觉是对的,但要说准确,它带来的到底是什么好处。代码 03 演示 2 在 的碗上,让四种方法用相同的学习率:
| 0.03 | 0.075 | 0.1 | 0.3 | 1.0 | ||
|---|---|---|---|---|---|---|
| GD | 641 | 212 | 83 | 发散 | 发散 | 发散 |
| Momentum() | 587 | 128 | 128 | 124 | 131 | 135 |
| RMSprop() | 停在 2e−05 | 停在 1e−04 | 停在 9e−04 | 停在 2e−03 | 停在 1e−02 | 停在 2e−01 |
| Adam | 1153 | 367 | 142 | 135 | 128 | 2262 |
(“停在 “表示 3000 步时 ,没有收敛。RMSprop 和 Adam 两行在 §5、§6 解释。)
先看前两行,和很多人的直觉不一样:
- Momentum 的第一个好处是”能用更大的学习率”: 时 GD 发散,momentum 从 0.03 到 1 都能收敛,而且步数几乎一样(124–135)。它对学习率的选择宽容得多。演示 4(c) 算出了它能用的学习率上限: 时是 GD 的 19 倍(理论值 ,和实测 1.520 完全一致,练习 6)。
- 在 GD 也能用的学习率下,momentum 并不更快: 时 GD 83 步,momentum 128 步。原因在公式 (4.1): 是梯度的平均。方向一致时, 稳定在 本身那么大,步子不会比 GD 大。所以同一个 下,平的方向上 momentum 并不加速。
- Momentum 的速度有一个”地板”: 从 0.03 到 1,步数都在 130 左右。 时,误差每一步最好也只能乘以约 ,不能缩得更快(这是 heavy-ball 方法的一个性质,这里不推导)。于是 每步最多只能缩小到原来的约 0.9 倍,降到 要 步。要更快,就得调 (练习 8)。
那 momentum 什么时候真正占优?碗很扁的时候。代码 03 演示 3 给每种方法各自挑最好的学习率(§6.4 的表): 时 GD 要 2420 步,momentum 144 步,快约 17 倍;但 时 momentum(119 步)反而比 GD(39 步)慢。理论上,调好 和 的 momentum 需要的步数大约和 成正比,而 GD 和 成正比(Polyak 1964)。真实网络的代价函数通常是很病态的,这正是 momentum 有用的地方。
4.4 “小球滚下碗”的比喻,以及它的局限
Ng 给了一个物理比喻:把代价函数想成一只碗,参数是一个小球。 像加速度, 像速度, 像摩擦力( 让速度不会无限增大)。小球有惯性,所以不会每一步都被”最近的碗壁”拉着拐弯。
这个比喻很有用,但要知道它在哪里不准。代码 03 演示 4(b)(、前 150 步):
- 小球会冲过谷底: 比上一步升高的次数,GD 0 次,momentum 60 次。GD 始终在 的一侧,momentum 的 最远冲到了 +0.249(最低点在 )。图里右上角那条轨迹(α = 0.075)也冲过了最低点,在它的右侧绕了一圈才回来。所以用 momentum 时,代价不一定单调下降,偶尔上升不一定是学习率太大。
- “速度”不是越滚越快的物理速度:在 Ng 的写法里,方向一致时 稳定在梯度本身那么大,不会无限加速(§4.3 第 2 条)。真实的小球在一个长下坡上会越滚越快。
- 惯性对不太扁的碗可能是坏事: 时, 的小球在谷底来回晃,比 GD 慢 3 倍。
4.5 两种写法
很多资料和框架里的 momentum 写成
(没有 )。这时梯度方向一致时 稳定在 ,是 Ng 写法的 10 倍,所以 时两种写法完全等价。代码 03 演示 4(a) 验证了 200 步的轨迹最大只差 4.4e−16(浮点舍入)。Ng 更喜欢带 的写法,因为 和 是同一个量级,换 时不用重新调 。PyTorch 的 torch.optim.SGD(momentum=0.9) 用的是不带 的写法,在不同框架之间搬运超参数时要注意。
(还有一个常见的变体 Nesterov momentum:先按惯性走一步,再在那个位置算梯度。Ng 的课里没有讲,感兴趣可以看 Sutskever et al. 2013。)
5. RMSprop · Root mean square prop
5.1 按维度缩放步长
Momentum 解决震荡的办法是”平均掉”。RMSprop 换了一个思路:震荡的方向梯度大,就在那个方向上走小步;平缓的方向梯度小,就走大步。 每个参数各自记住”最近梯度有多大”:
同理。 近似”最近一段时间梯度的均方根”(root mean square,名字就是这么来的)。用它去除梯度,每个参数的步长就被归一化了:在 Ng 那张图里,竖直方向(他用 代表)梯度大, 大,除完之后步子小;水平方向()梯度小, 小,除完之后步子相对大。效果相当于给每个参数配了一个自己的学习率。
几个细节:
- (比如 )只是为了防止除以 0:某个参数的梯度一直是 0 时 。它一般不用调。
- 为什么用 这个名字? 为了和 momentum 的 区分,Adam 里两个都要用。
- 取多少? RMSprop 最早出现在 Hinton 在 Coursera 上的神经网络课程里(不是一篇论文,Ng 在视频里特意提到这一点),那份讲义用的是 0.9。PyTorch 的
RMSprop默认 0.99,Keras 默认 0.9。本讲的代码用 0.9,原因见下一条。 - RMSprop 没有偏差修正: 从 0 开始,第 1 步 ,步长变成 乘以梯度的符号。 时这是 , 时是 (练习 7)。所以不带偏差修正的 RMSprop 不宜配太大的 。
5.2 RMSprop 在碗里:快到附近,却停不下来
回到 §4.3 那张表的 RMSprop 一行:每一格都”停在”一个和 有关的水平上,从 时的 到 时的 0.2。图里左下角的轨迹几乎是直奔最低点去的,但到了附近就停不下来。
原因是: 时分母 只记得最近约 10 步。梯度变小时分母跟着变小,两者相除,步长始终约等于 ,和离最低点还有多远无关。于是它在最低点附近以 的幅度来回跳。要精确收敛,就得让 随时间变小,也就是 §8 的学习率衰减。演示 3 里 RMSprop 只有在很小的 (约 0.001–0.003)下才精确收敛,要两三千步。
这其实是”按梯度大小归一化”的两面:好处是步长不依赖梯度的尺度,坐标轴方向上曲率差 1000 倍也不怕;坏处是梯度变小时它不会自动放慢。
6. Adam · Adaptive moment estimation
6.1 两者结合,再加偏差修正
Ng 说,深度学习的历史上,很多人提出过各种优化算法,后来发现它们往往只在少数问题上好用,大家就对新的优化算法有点怀疑。Momentum、RMSprop,以及把两者合起来的 Adam,是少数被证明在很多种网络上都好用的。Adam(Kingma & Ba 2015)的名字来自 Adaptive moment estimation。
初始化 、(initialize_adam)。第 次迭代( 从 1 数起):
同理。分子是”平均下来往哪边走”(平均掉震荡),分母是”这个参数的梯度通常有多大”(按维度缩放)。两者相除之后,每个参数一步大约走 那么远;梯度方向稳定时恰好是 (练习 7)。这一点很重要:Adam 的步长和梯度本身的尺度无关,§7 和 §9.4 会看到它带来的好处和坏处。
6.2 超参数
| 超参数 | 作用 | 常用值 | 要不要调 |
|---|---|---|---|
| 学习率 | 论文建议 0.001(PyTorch 的默认值) | 要调,最重要的超参数 | |
| 一阶矩(梯度平均)的系数 | 0.9 | 几乎不调 | |
| 二阶矩(梯度平方平均)的系数 | 0.999(Adam 作者推荐) | 几乎不调 | |
| 防止除以 0 | 几乎不调(练习 9 看它太大会怎样) |
Ng 的原话大意是:实践中大家用 的默认值,只调 。
6.3 偏差修正为什么必须做
§3.5 说 momentum 可以不做偏差修正。Adam 为什么不行?代码 02 演示 4(a) 设想梯度一直等于同一个数 。做了修正时,Adam 每一步恰好走 ;不做修正时步长变成 。下表是”不修正的步长 / 应有的步长”:
| 第 步 | 1 | 2 | 5 | 10 | 20 | 50 | 100 | 300 | 1000 | 3000 |
|---|---|---|---|---|---|---|---|---|---|---|
| Adam() | 3.16 | 4.25 | 5.80 | 6.53 | 6.24 | 4.50 | 3.24 | 1.96 | 1.26 | 1.03 |
| Momentum() | 0.10 | 0.19 | 0.41 | 0.65 | 0.88 | 0.99 | 1.00 | 1.00 | 1.00 | 1.00 |
| RMSprop() | 3.16 | 2.29 | 1.56 | 1.24 | 1.07 | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 |
- Adam 不修正时,分子 被压小了 10 倍,分母 被压小了约 32 倍。分母偏得更厉害,于是步长反而偏大。分子的偏差 10 步左右就消失了,分母的偏差要上千步,所以放大倍数先升后降:第 12 步最大(6.57 倍),到第 1,751 步才回到 1.1 倍以内。不做偏差修正的 Adam,前几百步的实际学习率是你设定值的好几倍。
- Momentum 不修正时正好相反:开头步子偏小,只是”热身慢一点”,不危险。这就是 Ng 说”momentum 一般不做修正”、而 Adam 论文专门强调要修正的原因。
演示 4(b) 在月牙数据上验证([2, 5, 2, 1]、mini-batch 64、1000 个 epoch,5 个种子的测试准确率):
| 种子 0 | 种子 1 | 种子 2 | 种子 3 | 种子 4 | |
|---|---|---|---|---|---|
| α = 0.01,做偏差修正 | 0.965 | 0.968 | 0.969 | 0.971 | 0.970 |
| α = 0.01,不修正 | 0.969 | 0.971 | 0.969 | 0.969 | 0.968 |
| α = 0.07,做偏差修正 | 0.965 | 0.967 | 0.969 | 0.968 | 0.953 |
| α = 0.07,不修正 | 0.500 | 0.968 | 0.968 | 0.962 | 0.916 |
时修不修正都一样。 时,不修正的 5 次里有 1 次准确率停在 0.5。代码检查了这一次:第 5 步之后,第 2 个隐藏层的 2 个 ReLU 单元已经全部”死掉”(对所有样本都输出 0),而修正后的版本还有 1 个活着。头几步被放大 3–6 倍的步子把 ReLU 推死了,和第 4 讲代码 05”学习率太大,ReLU 全部死掉”是同一种失败。偏差修正几乎不花计算,却让 Adam 在稍大的学习率下也更安全。
6.4 各自用最好的学习率:扁的碗和斜的碗
§4.3 的”同一个 “对 Adam 不太公平:GD 的一步是 梯度,Adam 的一步约等于 ,两者的 单位不一样。所以 Adam 在 时最慢(1153 步),因为它每步只走约 0.01。
代码 03 演示 3 让每种方法在 41 个学习率(0.001 到 10,对数均匀)里各挑最好的那个。为了看清”按维度缩放”到底在做什么,同一个碗还旋转了 45°:碗的形状完全不变,只是扁的方向不再和坐标轴对齐。
| 碗的方向 | GD | Momentum | RMSprop | Adam | |
|---|---|---|---|---|---|
| 10 | 和坐标轴对齐 | 39 | 119 | 1724 | 119 |
| 10 | 旋转 45° | 39 | 119 | 1823 | 121 |
| 100 | 和坐标轴对齐 | 371 | 128 | 2137 | 124 |
| 100 | 旋转 45° | 371 | 128 | 2951 | 139 |
| 1000 | 和坐标轴对齐 | 2420 | 144 | 2048 | 123 |
| 1000 | 旋转 45° | 2420 | 144 | 3000 步内未收敛 | 733 |
(格子里是收敛步数;每种方法最好的学习率见代码输出。)
- GD 和 Momentum 对旋转完全不敏感(每对两行一模一样):它们的更新规则不在乎坐标轴朝哪边。
- Adam 在碗和坐标轴对齐时,不管 多大都只要 119–124 步:它给每个坐标配了自己的步长,相当于把扁碗按坐标轴拉圆了。
- 碗转了 45° 以后,扁的方向是 和 的混合,按坐标缩放就帮不上忙了: 时 Adam 从 123 步变成 733 步,比 momentum 还慢。
- RMSprop(,没有动量)只有很小的 才能精确收敛(§5.2),所以要上千步。
对深度网络意味着什么? 网络里不同参数的梯度尺度确实常常差很多(§9.4 有一个例子:同一个网络里,第 1 层和输出层的梯度差 3000 多倍)。这部分病态和坐标轴是对齐的,Adam 能修正。不和坐标轴对齐的那部分,它和 momentum 一样只能靠惯性。这是 Adam 成为很好的默认选择的原因,也是它不会在所有问题上都赢的原因。
最后,代码 03 演示 3 还把 的 Adam(,这个碗上它最好的学习率)跑了 20000 步:第 1000 步时 已经是 ,但第 3000 步以后又回升,最高到 (第 5344 步)。梯度变得极小以后,分母 也慢慢变小,等效学习率越来越大,最后又被”踢”了出来。常数学习率的 Adam 停不稳,这和 RMSprop 停不下来是同一类问题,药方都是学习率衰减(§8)。在 mini-batch 训练里梯度一直带着噪声,不会小到这个程度,所以通常不会这么极端,但道理是一样的。
6.5 和第 1 讲的黑盒对答案;Adam 的后续
直接运行 optimizers.py 会做一次自检:本讲的 update_parameters_with_adam 和第 1 讲 tiny_nn.Adam 在同一串随机梯度上走 200 步,参数的最大差别是 0.0e+00(逐位相同)。第 1 讲的黑盒,第 4 讲代码 03、04 借用的优化器,第 5 讲的 ArrayAdam,全都是公式 (6.1)。
Adam 之后还有很多改进,最值得知道的一个是 AdamW(Loshchilov & Hutter 2019)。第 6 讲的 L2 正则化是把 加进梯度,可是加进梯度的这一项在 Adam 里也会被 除,正则化的强度因此因参数而异。AdamW 把 weight decay 从梯度里拿出来,直接对参数做 。今天训练 Transformer 和大语言模型,默认几乎都是 AdamW。另外,理论上 Adam 在某些构造出来的问题上可以不收敛(Reddi et al. 2018),有研究发现调好的 SGD + momentum 在一些图像任务上泛化得比 Adam 好(Wilson et al. 2017)。所以 Adam 是”很好的默认选择”,不是”永远最好”。
7. 在网络上比较:复刻 “Optimization Methods” 作业 · GD vs Momentum vs Adam on a network
7.1 设定
Coursera 的编程作业 “Optimization Methods” 在月牙数据(sklearn.datasets.make_moons,300 个点,噪声 0.2)上训练一个三层网络 [2, 5, 2, 1](ReLU + sigmoid 输出,He 初始化),mini-batch 64,学习率 0.0007,较新的版本训练 5000 个 epoch(早期版本是 10000),比较 mini-batch GD、Momentum、Adam。作业报告的结果大约是:GD 和 Momentum 在训练集上约 80%,Adam 约 94%(具体数字随版本略有不同)。作业的结论是:momentum 在这么小的学习率和这么简单的数据上作用几乎可以忽略,Adam 明显更好。
代码 04 演示 3 用 optimizers.model()(作业里 model() 的复刻)和第 3 讲的 numpy 版月牙数据重做一遍,加了一个独立生成的 2000 个样本的测试集,每种优化器跑 3 个种子(种子决定初始化和每个 epoch 的打乱顺序):
| 优化器 | 种子 | 训练集 cost | 训练准确率 | 测试准确率 |
|---|---|---|---|---|
| GD | 0 / 1 / 2 | 0.3780 / 0.5151 / 0.3630 | 0.850 / 0.833 / 0.857 | 0.860 / 0.849 / 0.871 |
| Momentum | 0 / 1 / 2 | 0.3780 / 0.5158 / 0.3630 | 0.850 / 0.833 / 0.857 | 0.860 / 0.849 / 0.871 |
| Adam | 0 / 1 / 2 | 0.0991 / 0.0892 / 0.0889 | 0.960 / 0.967 / 0.960 | 0.966 / 0.965 / 0.971 |
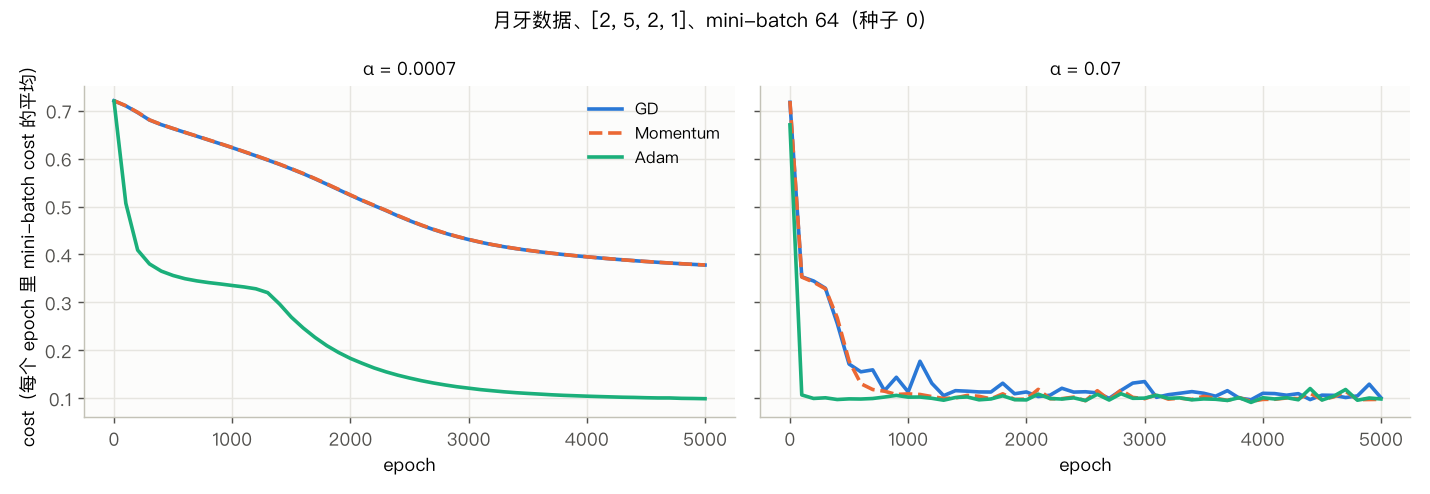
和作业的结论一致:Adam 明显好,GD 和 Momentum 几乎一模一样(训练 cost 最大相差 0.0008),而且 cost 还在缓慢下降,远没有训练完。(左图里 Adam 的曲线在第 1000 个 epoch 前后也有一段几乎平的”台阶”,然后又降下去:平台不只出现在 GD 身上,§9 再说。)
GD 和 Momentum 一样,正是 §4.3 的预言:同一个 下,Ng 写法的 momentum 并不比 GD 走得快,它的好处是”允许更大的 “,而 0.0007 小到根本没有震荡可以平均。
7.2 换学习率之后
那么,Adam 赢是因为它”更聪明”,还是因为 0.0007 对 GD 来说太小了?代码 04 演示 4 把学习率换成 0.007、0.07、0.7(3 个种子的测试准确率:平均,括号里是最低–最高;“×k”表示有 k 次停在 0.5):
| 优化器 | α = 0.0007 | α = 0.007 | α = 0.07 | α = 0.7 |
|---|---|---|---|---|
| GD | 0.860(0.849–0.871) | 0.959(0.952–0.966) | 0.963(0.957–0.966) | 0.808(0.495–0.965)×1 |
| Momentum | 0.860(0.849–0.871) | 0.959(0.953–0.967) | 0.965(0.963–0.967) | 0.941(0.883–0.971) |
| Adam | 0.967(0.965–0.971) | 0.967(0.965–0.970) | 0.965(0.964–0.967) | 0.500(0.500–0.500)×3 |
- 学习率加大 10 倍,GD 和 Momentum 就到了 0.959;再加大 10 倍,三种方法几乎一样(0.963 / 0.965 / 0.965)。作业里 Adam 的优势,主要来自”0.0007 对 GD 来说太小、对 Adam 来说刚好”。
- 为什么同一个 对两者意义不同?代码量了一下:这个网络刚初始化时梯度各元素的均方根只有 0.0030–0.0323(3 个种子)。GD 的一步是 梯度,Adam 的一步约等于 。同样写 ,Adam 的实际步子是 GD 的 31–338 倍。
- Adam 也要调学习率: 时 3 次全部停在 0.5(ReLU 全部死掉)。GD 和 Momentum 在 0.7 时也开始出问题(GD 有 1 次停在 0.5;momentum 3 次都没有,但最低只有 0.883,这和”momentum 允许更大的学习率”一致,只是 3 个种子说明不了太多)。
7.3 那到底用哪个?
把 §4–7 合起来,可以给出一个诚实的总结:
- Adam 的最大实际好处是”好调”:步长不太依赖梯度的尺度,默认的 几乎不用动, 从 0.001 附近开始试,常常一次就能用。网络里不同参数的梯度尺度差很多时(§9.4),它的优势更明显。这是它成为默认选择的原因。
- 调好学习率之后,三者在这个任务上差不多。Momentum 的价值是让更大的学习率可用、在很病态的问题上快得多;它和 GD 共用同一个 时并不更快。
- 哪一个都不是”不用调”。不同的问题上排名可能不同(§6.4 的旋转碗、§6.5 的文献)。
这也是 Ng 在课上的建议:Adam 是一个很好的默认选择,但学习率 一定要调。第 9 讲会讲怎样系统地调(在对数尺度上随机搜索)。
8. 学习率衰减 · Learning rate decay
8.1 为什么要衰减:噪声球
用 mini-batch 训练时,每一步的梯度都带着噪声(§2.3)。学习率是常数的话,参数走到最低点附近之后,会在一个”球”里随机游走,停不下来。学习率越大,球越大。Ng 的建议是:开头用大的学习率走得快,后面慢慢减小,让参数在最低点附近一个更小的范围里打转。
代码 04 演示 2 用一个能精确算出最优解的问题来看这件事:线性回归,10 个特征、1000 个样本,mini-batch 大小 10,普通梯度下降。表中是第 个 epoch 里各步的 的平均(0 = 到达最低点):
| 学习率 | epoch 1 | epoch 3 | epoch 10 | epoch 30 |
|---|---|---|---|---|
| 常数 α = 0.1 | 3.9e−01 | 6.2e−03 | 6.0e−03 | 6.4e−03 |
| 常数 α = 0.01 | 3.3e+00 | 7.0e−02 | 1.8e−04 | 1.4e−04 |
| 1/(1 + epoch),α₀ = 0.1 | 3.9e−01 | 1.3e−03 | 1.9e−04 | 1.6e−05 |
| 指数 0.9^epoch,α₀ = 0.1 | 3.9e−01 | 4.7e−03 | 1.7e−03 | 3.0e−05 |
| cosine(按步),α₀ = 0.1 | 3.9e−01 | 6.1e−03 | 4.3e−03 | 1.9e−06 |
- 常数 α = 0.1:第 3 个 epoch 就降到 6.2e−03,之后再也下不去了。不是算法坏了,是噪声球。
- 常数 α = 0.01:开头慢得多,但最后停得低(1.4e−04,是 α = 0.1 的 1/47)。
- 衰减:开头和 α = 0.1 一样快,最后比 α = 0.01 还低。前期大步走得快,后期小步停得准,两者兼得。
注意两种”停不下来”的区别:这里是 mini-batch 的噪声造成的,全批量梯度下降在这个凸问题上用常数学习率就能精确收敛;§5.2、§6.4 里 RMSprop 和 Adam 停不稳,是因为它们的步长不随梯度变小。两种情况的药方都是让学习率随时间变小。(理论上,SGD 要收敛到最优点,学习率需要满足 、,这是 Robbins & Monro 1951 的经典条件。 满足它,常数学习率不满足。)
8.2 常见的衰减公式
记 1 个 epoch = 把训练集过一遍。Ng 视频里的第一个公式:
他的例子:、decay_rate = 1 时,epoch 1、2、3、4 的学习率是 0.1、0.0667、0.05、0.04(代码 04 演示 1)。其他常见的形式:
- 指数衰减:;
- ,或者用 mini-batch 的步数 代替 epoch 数:;
- 阶梯衰减(discrete staircase):每隔一段时间学习率减半,或者除以 10;
- 手动衰减:训练一个模型要好几天时,有人会盯着学习曲线,看到它变平了就手动把学习率调小。
代码 04 演示 1 打出了几种调度在 100 个 epoch 里的样子():
| 调度 | epoch 0 | 1 | 4 | 10 | 20 | 40 | 60 | 99 |
|---|---|---|---|---|---|---|---|---|
| 1/(1 + 1·epoch) | 0.1000 | 0.0500 | 0.0200 | 0.0091 | 0.0048 | 0.0024 | 0.0016 | 0.0010 |
| 1/(1 + 0.1·epoch) | 0.1000 | 0.0909 | 0.0714 | 0.0500 | 0.0333 | 0.0200 | 0.0143 | 0.0092 |
| 每 20 epoch 衰减一次 | 0.1000 | 0.1000 | 0.1000 | 0.1000 | 0.0500 | 0.0333 | 0.0250 | 0.0200 |
| 指数 0.95^epoch | 0.1000 | 0.0950 | 0.0815 | 0.0599 | 0.0358 | 0.0129 | 0.0046 | 0.0006 |
| 阶梯:每 30 epoch 减半 | 0.1000 | 0.1000 | 0.1000 | 0.1000 | 0.1000 | 0.0500 | 0.0250 | 0.0125 |
| warmup 5 + cosine | 0.0200 | 0.0400 | 0.1000 | 0.0993 | 0.0940 | 0.0701 | 0.0377 | 0.0000 |
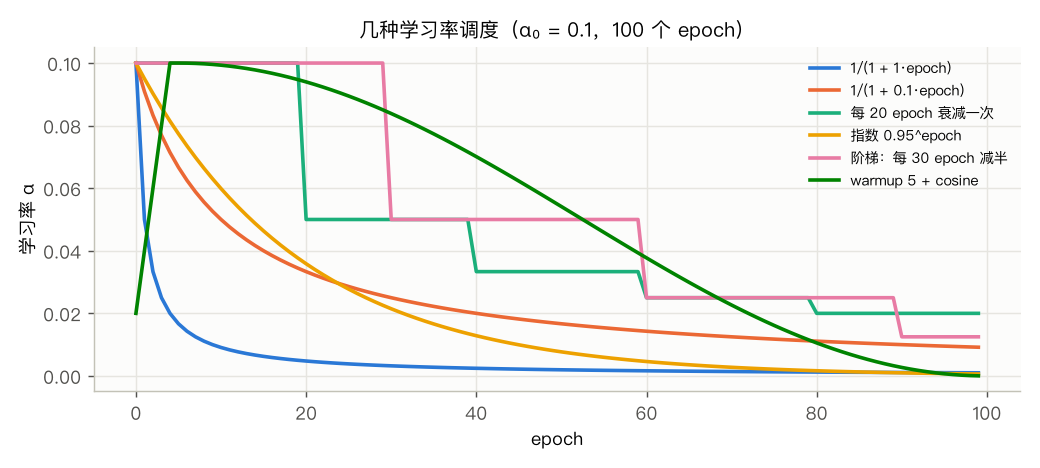
公式 (8.1) 在开头降得最猛:decay_rate = 1 时第 1 个 epoch 就砍掉一半。衰减的快慢完全由 decay_rate 决定,它本身就是一个要调的超参数。较新版本的 Coursera 作业正是从这一点出发的:先用 (8.1) 每个 epoch 衰减一次,发现 5000 个 epoch 下学习率很快就小到几乎不动;再改成”每隔 time_interval 个 epoch 才衰减一次”(fixed interval scheduling,代码里的 schedule_lr_decay):
8.3 现代做法:warmup + cosine
今天训练大模型,最常见的调度是 warmup + cosine,代码里的 warmup_cosine:
- warmup(热身):最开始的一小段(比如几百到几千步)里,学习率从接近 0 线性升到 。Goyal et al.(2017)用 batch 8192 训练 ResNet 时用它解决训练初期的不稳定;Transformer 的原论文(Vaswani et al. 2017)也用了 4000 步的 warmup。一个直觉:刚开始时参数是随机的,梯度大而且方向不稳定,Adam 的二阶矩估计 也还不准(§6.3 的表说明了开头的 有多不可靠),先走小步更安全。
- cosine:之后学习率沿余弦曲线从 降到 0(或一个很小的值):, 是训练进度(0 到 1)。前期降得慢、中间快、最后又慢慢贴近底部。来自 Loshchilov & Hutter(2017,SGDR)。
经典的 ImageNet 图像分类训练则常用阶梯衰减,比如每 30 个 epoch 把学习率除以 10。
8.4 在月牙数据上的效果,以及它排在第几位
代码 04 演示 5 在月牙数据上比较几种调度。起始学习率 ,选法是写代码时定下的规则:“演示 4 里三种优化器、所有种子都没有停在 0.5 的最大学习率”。每格是 3 个种子平均的”训练集 cost / 测试准确率”:
| 调度 | 最后的 α | GD | Momentum | Adam |
|---|---|---|---|---|
| 常数 | 0.07 | 0.0995 / 0.963 | 0.0929 / 0.965 | 0.0907 / 0.965 |
| 每个 epoch 衰减 1/(1+epoch) | 1.4e−05 | 0.6207 / 0.696 | 0.6282 / 0.690 | 0.3047 / 0.880 |
| 每 1000 epoch 衰减一次 | 0.014 | 0.0924 / 0.965 | 0.0929 / 0.966 | 0.0838 / 0.968 |
| cosine(降到 0) | 6.9e−09 | 0.0915 / 0.965 | 0.0925 / 0.966 | 0.0825 / 0.967 |
- 每个 epoch 都按 1/(1 + epoch) 衰减太快了:5000 个 epoch 后学习率只剩 的 1/5000,绝大部分时间几乎不动,GD 的训练 cost 停在 0.6207。这就是作业里演示的问题。
- 温和的衰减(每 1000 epoch 一次、cosine)比常数学习率的训练 cost 略低一点,测试准确率几乎不变。这个任务只有 300 个样本,mini-batch 噪声不大,网络也很小,学习率衰减能做的事有限。
这和 Ng 的建议一致:学习率衰减在他”要调的东西”清单里排得比较靠后,先把常数学习率 调好,衰减是锦上添花(第 9 讲会讲他的超参数重要性排序)。在大数据、训练几十到几百个 epoch 的任务上,衰减的作用要大得多,§8.1 的噪声球就是原因。
9. 局部最优的问题 · The problem of local optima
9.1 低维直觉 vs 高维现实
早年讲神经网络优化时,常见的一张图是一个二维的、坑坑洼洼的曲面,有很多局部最小值。大家担心梯度下降会卡在某个很差的局部最小里出不来。
Ng 说,这种直觉来自低维的图,在高维空间里会误导你。梯度为 0 的点,在每一个方向上可能向上弯,也可能向下弯。要成为局部最小,必须所有方向都向上弯。如果网络有 20,000 个参数,每个方向”独立地抛硬币”决定弯上还是弯下,那么全部向上的概率大约是 。所以高维空间里梯度为 0 的点,绝大多数是鞍点(saddle point):有的方向向上弯,有的方向向下弯,像马鞍。
9.2 随机对称矩阵:比抛硬币还极端
在一个梯度为 0 的点附近,, 是二阶导数矩阵(Hessian)。 的特征值全 > 0 是局部最小,全 < 0 是局部最大,有正有负是鞍点。我们不知道真实网络的 长什么样,代码 05 演示 1 用最简单的”随机”版本当作漫画:, 的元素是独立的标准正态分布(物理学里叫 GOE 随机矩阵)。每个维数生成 400,000 个:
| 局部最小 | 局部最大 | 鞍点 | (抛硬币) | 局部最小的个数 | |
|---|---|---|---|---|---|
| 1 | 5.00e−01 | 5.00e−01 | 0.0000 | 5.00e−01 | 199,951 |
| 2 | 1.46e−01 | 1.46e−01 | 0.7075 | 2.50e−01 | 58,542 |
| 3 | 2.49e−02 | 2.49e−02 | 0.9502 | 1.25e−01 | 9,955 |
| 4 | 2.56e−03 | 2.48e−03 | 0.9950 | 6.25e−02 | 1,023 |
| 5 | 1.07e−04 | 1.52e−04 | 0.9997 | 3.12e−02 | 43 |
| 6 | 2.50e−06 | 1.00e−05 | 1.0000 | 1.56e−02 | 1 |
维数每加 1,局部最小的比例掉得比抛硬币还快得多。6 维时 40 万个里只有 1 个。为什么?抛硬币的论证假设每个方向独立,可随机矩阵的特征值之间互相”排斥”。要所有特征值同时为正,是一个代价极高的集体事件。可以证明这个概率在 很大时大约按 衰减,(Dean & Majumdar 2006),比 快得多。( 的 0.146 可以手算出来,见练习 10。)
维数更高时,看特征值里负数占多少:、100、1000 时平均都是一半左右(0.499、0.499、0.500)。 的 10 个矩阵里最少 0.499、最多 0.502,离”局部最小要求的 0”差得很远。
要小心这个漫画的局限。 真实网络的 Hessian 不是随机矩阵。Dauphin et al.(2014)等人的研究(建立在 Bray & Dean 2007 的随机场理论之上)发现,临界点的”负方向个数”和它的 cost 高低有关:cost 高的临界点大多是有很多下降方向的鞍点,cost 越接近最低,负方向越少。在低 cost 的区域里确实有很多局部最小,只是它们的 cost 大多和全局最小差不多(Choromanska et al. 2015 在一个简化模型里得到类似的结论)。所以准确的说法是:对大网络,“卡在一个很差的局部最小里”很少是真正的问题。
9.3 鞍点:逃出来要多久
既然到处是鞍点,梯度下降会不会卡在鞍点上?代码 05 演示 2 用一个最简单的鞍点:
是鞍点( 方向向上弯, 方向向下弯,), 是两个最小值()。从 出发: 方向很快滑到 0,点被”吸”到鞍点旁边;能不能离开,全看 方向那一点点 。每格是”第一次 的步数 / 在鞍点附近()停留的步数”:
| δ = 0.1 | δ = 0.001 | δ = 1e−06 | δ = 1e−09 | δ = 0 | |
|---|---|---|---|---|---|
| GD,α = 0.1 | 19 / 0 | 67 / 12 | 139 / 83 | 212 / 155 | — |
| Momentum,α = 0.1 | 32 / 0 | 105 / 19 | 216 / 128 | 326 / 238 | — |
| RMSprop,α = 0.1 | 2 / 0 | 2 / 0 | 2 / 0 | 3 / 0 | — |
| Adam,α = 0.1 | 5 / 0 | 6 / 0 | 6 / 0 | 8 / 0 | — |
| RMSprop,α = 0.01 | 26 / 0 | 30 / 0 | 30 / 0 | 31 / 1 | — |
| Adam,α = 0.01 | 37 / 0 | 44 / 1 | 44 / 0 | 45 / 0 | — |
(”—“表示 5000 步内没有离开。)
- GD:鞍点附近 每步只放大 倍,从 长到 0.5 要 步。 每小 1000 倍,就多花约 70 步(67 → 139 → 212)。这段时间里 几乎不变,训练曲线上就是一段平台。 鞍点本身不会把 GD 永远困住,但会让它停很久。
- Momentum(Ng 的写法,同一个 α)比 GD 还慢(326 vs 212 步): 是梯度的平均,一个持续变大的梯度被平均之后总是”慢半拍”。换成它允许的更大学习率,它会快起来。
- RMSprop / Adam 几乎不在乎 δ: 从 到 ,Adam(α = 0.01)都是 37–45 步。 方向的梯度再小,除以它自己的均方根之后也是 1 的量级,于是 方向一开始就以约 的速度往外走。这就是 Ng 说”momentum、RMSprop、Adam 能帮你更快地离开平台”时,最直接的一个机制。(这里鞍点的方向和坐标轴对齐;斜的时候效果会打折扣,和 §6.4 同样的道理。)
- 正好在鞍点上(δ = 0):梯度恰好是 0,四种方法全都一步不动。鞍点是”不稳定的平衡”,但没有任何扰动就永远不会离开。
最后一条引出 mini-batch 噪声的一个好处。演示 2 让点正好从 出发,但给每一步的梯度加一点点噪声(模拟 mini-batch),各跑 200 次:噪声标准差 时 GD 逃出来的中位数是 159 步, 时 87 步,200 次全部逃了出来。第 1 讲 tiny_nn.train 的注释说”梯度里的随机性有时还有好处”,指的就是这一类情形。
9.4 平台:真正的麻烦,以及 Adam 怎样”部分掩盖”梯度消失
Ng 的结论是:真正拖慢训练的不是局部最优,而是平台(plateau):一大片梯度接近 0 的区域,参数要在上面挪很久才能走出去。§9.3 的鞍点附近就是一种平台。另一种我们已经见过:第 1 讲代码 04 演示 3 里,5 个 sigmoid 隐藏层的网络用普通 SGD 训练,4000 步都停在 50% 的准确率上。
代码 05 演示 3 重做这个实验(同一个”老师网络”任务、同样的网络结构、mini-batch 128、4000 步),换几种优化器:
| 优化器 | 达到 80% 验证准确率的步数 | 4000 步后的验证准确率 |
|---|---|---|
| SGD,α = 0.1 | — | 0.494 |
| SGD,α = 1.0 | 3400 | 0.828 |
| Momentum,α = 0.1 | — | 0.505 |
| Momentum,α = 1.0 | 2100 | 0.879 |
| RMSprop,α = 0.001 | 300 | 0.859 |
| Adam,α = 0.001 | 200 | 0.865 |
| Adam,α = 0.01 | 100 | 0.883 |
用默认学习率的 Adam 200 步就离开了平台。为什么?看前 100 步里每一层权重的梯度和实际更新量的均方根:
| 第 1 层 | 第 2 层 | 第 3 层 | 第 4 层 | 第 5 层 | 输出层 | 第 1 层 / 输出层 | |
|---|---|---|---|---|---|---|---|
| 梯度(SGD α = 0.1 时) | 7.1e−06 | 9.6e−06 | 2.8e−05 | 1.7e−04 | 8.9e−04 | 2.4e−02 | 2.9e−04 |
| SGD α = 0.1 的更新量 | 7.1e−07 | 9.6e−07 | 2.8e−06 | 1.7e−05 | 8.9e−05 | 2.4e−03 | 2.9e−04 |
| 梯度(Adam α = 0.001 时) | 1.2e−05 | 1.4e−05 | 4.5e−05 | 2.2e−04 | 1.1e−03 | 2.8e−02 | 4.3e−04 |
| Adam α = 0.001 的更新量 | 9.0e−04 | 6.8e−04 | 4.0e−04 | 3.5e−04 | 3.0e−04 | 3.0e−04 | 3.0 |
- SGD 的更新量 = 梯度。梯度从输出层往输入层一层层变小(梯度消失,第 1 讲 §4.4),第 1 层的更新量只有输出层的 倍,靠近输入的几层几乎不动。
- Adam 把每个参数的梯度除以它自己的均方根,各层的更新量都变成了约 的量级(第 1 层 / 输出层 = 3.0)。梯度本身仍然差了几千倍,但步子差不多大了。这正是 §6.4 说的”和坐标轴对齐的病态”:每一层自己的梯度尺度不同,Adam 按参数修正了它。
这就是第 1 讲 tiny_nn.py 里那句注释”Adam 的自适应步长会部分掩盖梯度消失”的意思。为什么说部分?
- 梯度消失本身并没有被修好:第 1 层的梯度仍然很小,里面的”信号”相对噪声可能也更弱。如果梯度小到和 一个量级,除法就失效了,Adam 也救不回来(练习 9 把 改大来模拟这种情况)。
- 从根上解决梯度消失的办法是 ReLU(第 1、3 讲)、好的初始化(第 7 讲)、Batch Norm(第 9 讲)、残差连接(第 13 讲)。
- 反过来,正因为 Adam 会掩盖它,用 Adam 训练得不错,并不说明网络里没有梯度消失。要诊断,就像这里一样直接看每一层的梯度。这也是第 1 讲代码 04 比较 sigmoid 和 ReLU 时特意用普通 SGD 的原因。
10. 小结 · Summary
- Mini-batch:每一步只用 个样本。按步数全批量最准,按样本数小 batch 更省,按耗时 mini-batch 最快(代码 01: 在 0.050 s 降到 cost ≤ 0.3,全批量 0.666 s,SGD 每个样本慢约 170 倍)。mini-batch 梯度的误差按 缩小(2.63 → 0.34 → 0.11),所以代价曲线会抖。每个 epoch 打乱;最后一块可留可丢;常用 64–512,确保放得进内存。
- 指数加权平均 ≈ 最近 个数的平均,理由是 。 越大越平滑也越滞后( 滞后 40 天)。偏差修正 修正 造成的开头偏低。
- 病态的碗:GD 的学习率被陡的方向卡住,平的方向走得慢,步数 ∝ (35 / 87 / 346 / 3454)。
- Momentum 用梯度的平均走:平均掉震荡,允许更大的学习率( 时上限是 GD 的 19 倍),在很扁的碗上快得多(:144 vs 2420 步)。但同一学习率下它不比 GD 快,会冲过谷底, 对不太扁的碗惯性太大。
- RMSprop 用梯度均方根按维度缩放步长;步长约等于 ,常数学习率下停不下来。
- Adam = momentum + RMSprop + 偏差修正,默认 、、,只调 。偏差修正必须做(不修正时前几百步步长被放大到最多 6.57 倍)。按维度缩放只对和坐标轴对齐的病态有效(旋转后 123 → 733 步)。
- 作业的复刻: 时 Adam 0.967、GD / Momentum 0.860; 时三者都在 0.963–0.965。Adam 的主要优势是”好调”,不是”终点更好”;它也会在大学习率下失败。
- 学习率衰减:mini-batch 噪声让常数学习率停在一个”噪声球”里(线性回归:常数 0.1 停在 6.4e−03,cosine 到 1.9e−06)。公式 、指数、阶梯、手动;现代常用 warmup + cosine。衰减太快会让训练停住。在 Ng 的清单里它排得比较靠后。
- 局部最优:高维空间里梯度为 0 的点几乎都是鞍点(随机矩阵:6 维时 40 万个里只有 1 个局部最小);真正的麻烦是平台。GD 离开鞍点的时间 ∝ ,Adam 几乎不受影响,梯度噪声能帮忙离开”正好的”鞍点。Adam 让各层的更新量变得一样大,从而部分掩盖梯度消失。
11. 常见误区 · Common pitfalls
- “mini-batch 训练的 cost 在抖,说明学习率太大了。” 不一定。mini-batch 的梯度和 cost 本身就有噪声(代码 01 演示 2)。要看的是趋势:用每个 epoch 的平均,或者定期在整个训练集 / 验证集上评估。持续上升或者变成 nan 才是学习率太大。
- “SGD 就是 batch = 1 的梯度下降。” 原课里的 stochastic gradient descent 指 ;但今天很多人(包括 PyTorch 的
torch.optim.SGD)把 mini-batch 梯度下降也叫 SGD。读论文和代码时,看清楚他们的 batch 是多大。 - “Momentum 让小球越滚越快,所以同一个学习率下比 GD 快。” Ng 写法里方向一致时 稳定在梯度本身那么大,同一个 下并不更快(代码 03 演示 2:83 vs 128 步;代码 04:GD 和 Momentum 结果几乎相同)。它的好处是允许更大的学习率、在很病态的问题上快得多。
- “用了 momentum,cost 就应该单调下降。” 小球会冲过谷底,cost 偶尔上升是正常的(代码 03 演示 4:150 步里 60 步在上升)。
- “Adam 不用调学习率。” 几乎不用调, 一定要调。月牙数据上 时 Adam 3 次全部失败(代码 04 演示 4)。
- “偏差修正可有可无。” 对 momentum 基本如此;对 Adam 不是:不修正时前几百步的实际学习率是设定值的 3 到 6.6 倍,学习率稍大就可能把网络训坏(代码 02 演示 4)。
- “Adam 训练得好,所以网络里没有梯度消失。” Adam 会把各层的更新量拉到同一个量级,掩盖梯度消失(代码 05 演示 3)。诊断要直接看各层的梯度。
- “学习率衰减越快越好 / 一定能提升结果。” 衰减太快会让训练提前停住(代码 04 演示 5:1/(1 + epoch) 衰减 5000 个 epoch,GD 的 cost 停在 0.62)。先调好常数学习率,衰减是锦上添花。
- “训练卡住了,一定是掉进了局部最小。” 在大网络里更可能是平台或鞍点附近(梯度很小但不为 0)。可以试试换优化器(Adam)、调大学习率、检查是不是梯度消失(各层梯度的大小),而不是换随机种子重来。
12. 练习 · Exercises
练习 1(手算指数加权平均)。三天的气温是 ,,。(a) 算出 。(b) 算出偏差修正后的 。(c) 为什么 恰好等于 ?
参考答案
(a) ;;。三个数都远小于真实气温,这就是 造成的偏差。
(b) ;;。
(c) ,修正项 ,两者一除就是 。一般地,如果 一直等于常数 ,,修正后 对所有 都成立。这就是偏差修正”把权重归一化成 1”的意思。(可以用 optimizers.ewa([10, 12, 8], 0.9, bias_correction=True) 验证。)
练习 2(权重之和与平均年龄)。(a) 证明 展开后 的权重之和是 。(b) 当 时,” 天前”的权重是 。证明平均年龄 。(c) 时这是多少天?和代码 02 演示 1 实测的滞后(40 天)比较,为什么不一样?
参考答案
(a) 权重之和 (等比数列求和)。
(b) 利用 (对 两边关于 求导再乘 ),所以 。
(c) 49 天。对一条直线 ,指数加权平均( 很大时)恰好等于 ,也就是”拖后 49 天”。季节曲线是弯的:在最热的那几天,曲线已经开始往下拐,平均里混进的”更早的日子”反而没那么热,所以峰值的滞后小一些(40 天),同时峰值也被压低(起伏只剩 84%)。
练习 3(噪声被平均掉多少)。设 是独立的噪声,方差 。证明 很大时 。、 时, 的标准差是多少?和代码 02 演示 1 的”理论值”一列对照。
参考答案
,各项独立,所以 (用了 )。
、: °C,就是表里的理论值。对比”平均最近 天”的简单平均,标准差是 。指数加权平均的”有效样本数”是 ,比 大,因为它的权重拖得更长。
练习 4(数 mini-batch)。,。(a) 用 random_mini_batches 的默认做法,每个 epoch 有多少个 mini-batch?最后一块有多少个样本?(b) 训练 20 个 epoch 一共更新多少次参数?(c) 换成 drop_last=True,每个 epoch 有多少样本没用上?
参考答案
(a) 个满的块,,剩下 64 个样本组成第 1954 块。所以每个 epoch 1954 个 mini-batch。
(b) 次。(全批量梯度下降 20 个 epoch 只更新 20 次。)
(c) 64 个(0.0064%),完全可以忽略。这就是” 远大于 时两种做法几乎没有区别”。
练习 5(先预测再看表:GD 在更扁的碗里)。。(a) GD 不发散的最大学习率是多少?(b) 最优学习率 是多少?每一步误差乘以多少?(c) 粗略估计 降到初始值的 需要多少步(提示: 每步大约乘以倍数的平方)。然后对照代码 03 演示 1 的表。
参考答案
(a) 方向曲率 100,。
(b) ,两个方向的倍数都是 。
(c) 每步乘以 ,需要 步。代码实测 346 步。这个估计对 给出约 3450 步(实测 3454)。步数正比于 :碗扁 10 倍,就要多走 10 倍的步数。
练习 6(momentum 能用的最大学习率)。heavy-ball 方法在一个曲率为 的方向上不发散的条件是 ,其中 是”heavy-ball 写法”的步长。(a) Ng 的写法 (4.1) 相当于 (§4.5)。由此推出 Ng 写法下 的上限。(b) (最陡的曲率 25)、 时是多少?是 GD 的几倍?(c) 呢?对照代码 03 演示 4(c)。
参考答案
(a) ,即 。 时退化成 GD 的 。
(b) ,是 GD()的 19 倍。代码二分查找的结果正是 1.520。
(c) ,是 GD 的 199 倍。但上限高不等于收敛快: 越大,惯性越大,在不太扁的碗里来回晃得越厉害(练习 8)。
练习 7(Adam 的第一步)。(a) 证明:做了偏差修正的 Adam,第 1 步对每个参数的更新恰好是 (忽略 ),和梯度的大小无关。(b) 不做偏差修正时,第 1 步是多少?(c) 没有偏差修正的 RMSprop, 时第 1 步是多少? 呢?
参考答案
(a) ,;修正后 ,,所以更新量 。这说明 Adam 的 直接就是”每个参数第一步走多远”,和梯度的单位无关。这也解释了代码 04 里”同样的 ,Adam 的步子是 GD 的几十到几百倍”。
(b) (代码 02 演示 4 表的第一列)。
(c) : 时约 , 时约 。这是本讲的 RMSprop 用 的原因之一。
练习 8(改代码:β 也是超参数)。在 03_optimizer_trajectories.py 的 demo_best_lr 里,momentum 默认 。把循环里的 run_grid(name, A, z0, GRID) 改成 run_grid(name, A, z0, GRID, beta=0.5)(beta 只影响 momentum,其他三种方法会忽略它)。先预测: 时 momentum 还会比 GD(39 步)慢吗? 时呢?然后运行验证。
参考答案
我运行的结果(每种 各自挑最好的学习率):
| GD | Momentum | Momentum | |
|---|---|---|---|
| 10 | 39 | 119 | 19 |
| 1000 | 2420 | 144 | 958 |
在 时只要 19 步,比 GD 还快一倍;但在 时要 958 步,远不如 。理论上最优的 大约是 : 时约 0.27, 时约 0.88。碗越扁,越需要大的惯性。深度网络通常很病态,所以 0.9 是一个合理的默认值。
练习 9(改代码:ε 太大会怎样)。在 05_saddles_and_plateaus.py 的 train_deep_sigmoid 里,把 opt = Optimizer(name, params) 改成 opt = Optimizer(name, params, epsilon=1e-3)。先预测:Adam(α = 0.001)还能 200 步离开平台吗?第 1 层的更新量会变成多少量级?
参考答案
我运行的结果:Adam 要 2400 步才到 80%(原来 200 步),第 1 层更新量的均方根从 9.0e−04 掉到约 6.4e−06。原因:第 1 层的梯度只有 量级,比 小得多,分母 ,更新量变成 量级,相当于学习率为 的普通 SGD。输出层的梯度()仍然比 大,还是被归一化。这个练习说明了 §9.4 的”部分”:梯度小到和 一个量级时,Adam 的”掩盖”就失效了。 是”防止除以 0”的,不要随便调大(有些框架和任务会把它设成 或更大,那是另外的考虑)。
练习 10(★ 二维随机 Hessian)。,、 相互独立(代码 05 演示 1 的 )。证明 两个特征值都为正的概率是 。(提示:令 、,特征值是 。)
参考答案
都是 且相互独立( 方差相同,所以和与差不相关),和 也独立。两个特征值都为正 ⇔ ,其中 服从 Rayleigh 分布,密度 ()。所以
()。分部积分:。
代码的蒙特卡洛结果是 1.46e−01(58,542 / 400,000)。比”抛两次硬币都是正面”的 0.25 小得多:两个特征值不是独立的,它们互相排斥( 要同时超过 和 )。
13. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C2M2 “Optimization Algorithms”(Andrew Ng)与编程作业 “Optimization Methods”。
- Goodfellow, Bengio & Courville (2016). Deep Learning, Chapter 8 “Optimization for Training Deep Models”(免费在线):mini-batch、momentum、自适应学习率、鞍点与平台的系统讲法。
- Ruder (2016). An overview of gradient descent optimization algorithms. arXiv:1609.04747。各种优化器的一张总表,适合查公式。
算法的原始出处
- Robbins & Monro (1951). A stochastic approximation method. Annals of Mathematical Statistics。随机梯度方法和学习率条件的源头。
- Polyak (1964). Some methods of speeding up the convergence of iteration methods.(heavy ball / momentum)
- Sutskever, Martens, Dahl & Hinton (2013). On the importance of initialization and momentum in deep learning. ICML。momentum 和 Nesterov momentum 在深度学习里的作用。
- Hinton, Srivastava & Swersky. Neural Networks for Machine Learning, Lecture 6e “rmsprop”(Coursera 课程讲义,2012)。
- Kingma & Ba (2015). Adam: A method for stochastic optimization. ICLR。
- Loshchilov & Hutter (2019). Decoupled weight decay regularization. ICLR。AdamW。
学习率调度与 batch 大小
- Loshchilov & Hutter (2017). SGDR: Stochastic gradient descent with warm restarts. ICLR。cosine 调度。
- Goyal et al. (2017). Accurate, large minibatch SGD: Training ImageNet in 1 hour. linear scaling rule 与 warmup。
- Keskar et al. (2017). On large-batch training for deep learning: Generalization gap and sharp minima. ICLR。
- McCandlish, Kaplan, Amodei et al. (2018). An empirical model of large-batch training. “梯度噪声尺度”与临界 batch 大小。
Adam 的局限
- Wilson et al. (2017). The marginal value of adaptive gradient methods in machine learning. NeurIPS。
- Reddi, Kale & Kumar (2018). On the convergence of Adam and beyond. ICLR。
鞍点与损失曲面
- Dauphin et al. (2014). Identifying and attacking the saddle point problem in high-dimensional non-convex optimization. NeurIPS。
- Bray & Dean (2007). Statistics of critical points of Gaussian fields on large-dimensional spaces. Physical Review Letters。
- Dean & Majumdar (2006). Large deviations of extreme eigenvalues of random matrices. Physical Review Letters。
- Choromanska et al. (2015). The loss surfaces of multilayer networks. AISTATS。
- Goodfellow, Vinyals & Saxe (2015). Qualitatively characterizing neural network optimization problems. ICLR。
14. 下一讲预告 · Next lecture
第 9 讲:超参数调优、Batch Normalization、Softmax 与深度学习框架。 这一讲我们多了好几个超参数:mini-batch 大小、、、、、衰减速度……再加上学习率、层数、每层单元数,到底先调哪个、怎么调?第 9 讲会讲:
- Ng 的超参数重要性排序(学习率第一;、mini-batch 大小、隐藏单元数其次……),为什么随机搜索比网格搜索好,为什么学习率和 要在对数尺度上采样;
- Batch Normalization:把每一层的输入也”归一化”,让地形更好走(第 7 讲的输入归一化推广到每一层),以及它为什么常常能让你用更大的学习率;
- softmax 与多分类;
- 框架替你做了什么:从第 9 讲起换成 PyTorch。框架里的优化器(
torch.optim.SGD(momentum=0.9)、torch.optim.Adam)的每一个超参数,都能对应到这一讲的公式上。注意 PyTorch 的 momentum 用的是 §4.5 里”不乘 “的写法。