对应 Maps to:Coursera Deep Learning Specialization C2M1 “Practical Aspects of Deep Learning” 的后半部分(Normalizing Inputs、Vanishing / Exploding Gradients、Weight Initialization for Deep Networks、Numerical Approximation of Gradients、Gradient Checking、Gradient Checking Implementation Notes);编程作业 “Initialization” 和 “Gradient Checking”;Fall 2025 TA Section 4 “Xavier Initialization and Regularization”。在 Fall 2025 的课程表里,C2M1 和第 4 次课堂讲座(10/14)在同一周,那次讲座的内容在本讲义第 18 讲。 依据说明:Coursera 的视频和作业只对注册学员开放,Section 4 的材料只对选课学生开放,所以本讲不引用其中的原文。内容依据 Andrew Ng 在 C2M1 里广为人知的讲法(线性深网 的例子、“一个神经元的输入越多权重越小”、双边差分与 的例子、梯度检验的五条实现建议)和两个作业的设定(同心圆数据、[2, 10, 5, 1] 网络、三种初始化;一维 和一个反向传播写错了两处的网络)。作业的原始数字凭记忆引用,标为”约”。初始化的推导依据原始论文(Glorot & Bengio 2010;He et al. 2015),数值差分的误差分析依据数值优化的标准教材和 CS231n 的课程笔记(§8)。Section 4 的具体讲法无法核对;它的主题(Xavier 初始化)在 §3 里完整推导。 配套代码 Code:
code/lecture07/(numpy;4 个脚本 + 2 个工具模块。01 约 11 秒,02 约 3 秒,03 约 1 分钟,04 约 1 秒) 预计阅读时间:3 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 正确地做输入归一化(减均值、除以标准差,训练集和测试集用同一组 ),并用代价函数的 Hessian 和条件数 定量解释它为什么让梯度下降快几个数量级、让能用的学习率变大;知道它在神经网络里还有一个额外的作用(让 ReLU 的”折点”落进数据里)。
- 用” 个矩阵连乘”解释梯度消失 / 爆炸:每层把信号的均方乘一个”增益”,增益略大于 1 就指数爆炸,略小于 1 就指数消失,反向传播也一样。
- 从 出发,推导 Xavier()、Glorot()和 He()初始化,说清楚 He 里的那个 2 从哪里来,以及前向和反向为什么不能同时照顾到。
- 读懂一张”逐层信号大小”的表:区分”每个样本的梯度信号在消失”和” 随层变小”;能解释第 1 讲代码 04 里 sigmoid 的 1/2000 和 ReLU 的 1/10 各是怎么来的。
- 知道初始化只能缓解、不能根治梯度问题的三个原因(有限宽度的涨落、非线性、训练中权重不再随机),以及后面几讲的解决办法(BatchNorm、残差连接、更稳的优化器)。
- 用泰勒展开推导单边 / 双边差分的误差阶,用”截断误差 + 舍入误差”解释 的选择和 U 形误差曲线,知道为什么梯度检验必须用 float64。
- 把梯度检验当成调试工具来用:相对误差公式与 1e−7 / 1e−5 / 1e−3 的经验阈值;逐参数定位 bug;正则项别漏;不能和 dropout 一起用;在随机初始化时和训练一段时间后各做一次,并能用第 3、4 讲遇到的两个陷阱解释为什么。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开 Previewed only |
|---|---|
| 第 2 讲:梯度下降、学习率与”2 / 曲率”(§4.2–4.3);单边 vs 双边差分(§5.2) | L2 正则化、dropout 本身(第 6 讲);本讲只讲它们和梯度检验的关系 |
| 第 3 讲:零初始化的对称性;一个隐藏层时初始化尺度的影响(§7);梯度检验的初次使用(§6.6) | Momentum、RMSprop、Adam(第 8 讲) |
第 4 讲:L 层网络的前向 / 反向积木 deep_nn.py;梯度检验在 ReLU 折点上的”假失败”(§4.5) | Batch Normalization(第 9 讲) |
| 方差的基本性质:独立随机变量的和的方差等于方差之和 | 残差连接(第 13 讲);RNN 里的梯度消失、LSTM 与梯度裁剪(第 15 讲) |
C2M1 的标题是 “Practical Aspects of Deep Learning”。前半部分(数据划分、偏差 / 方差、正则化)在第 6 讲;后半部分讲的是怎样把优化问题设置好(setting up your optimization problem):在按下”开始训练”之前,输入的尺度、权重的初始尺度、反向传播的正确性,这三件事决定了梯度下降能不能顺利地走下去。前面几讲已经多次碰到这三件事的现象:第 1 讲代码 04 的梯度逐层变小,第 2 讲练习 6 里不归一化时临界学习率小了六万多倍,第 3 讲代码 02 的梯度检验漏掉了 bug。这一讲给出它们背后的”为什么”,并把它们整理成可以照着用的工具。
0.3 本讲地图 Map
§1  输入归一化:Hessian 与条件数;狭长的碗;神经网络里的"折点";同一组 μ、σ   ← 代码 01 演示 1–4
§2  梯度消失与爆炸:L 个矩阵连乘;增益 c                                      ← 代码 02 演示 1
§3  方差保持的初始化:Xavier / Glorot / He 的推导;20 层网络的实测;
    回看第 1 讲的 1/2000 和 1/10;同心圆上的训练(仿作业);只能缓解不能根治     ← 代码 02 演示 2–5、代码 03
§4  梯度检验:泰勒展开;ε 与 U 形曲线;相对误差与阈值;逐参数找 bug;
    正则项、dropout;什么时候检验                                            ← 代码 04 演示 1–5
§5–9  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 |
|---|---|
| 每个特征在训练集上的均值和标准差,形状 | |
| 代价函数的 Hessian(二阶导数矩阵); 是它最大、最小的特征值 | |
| 条件数(condition number):碗有多”扁” | |
| , | 第 层的输入、输出个数(fan-in、fan-out) |
| 均方根:一个数组里的数”大概有多大” | |
| 增益(gain) | 每过一层,信号的均方乘的倍数;前向 ,反向 |
| ; | 差分步长;浮点数的单位舍入误差(float64 约 ,float32 约 ) |
| 把所有参数 摊平拼成的一个长向量(梯度检验用) |
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出(固定随机种子,每个演示用自己的随机数生成器,同一台机器上重复运行逐字相同;本讲没有计时类的数字)。数据都是合成的,网络都很小,数字只说明机制。有几处结果和我写代码前的预想不一样(最重要的一处:太大的初始化在 tanh 深网里造成的是反向的爆炸而不是消失,§3.4),讲义按实际结果来写,这些情况列在代码 README 的”关于实验结果”里。
1. 输入归一化 · Normalizing inputs
1.1 从一个问题开始
你要用两个特征预测房价:面积(几十到两百多平方米)和卧室数(1 到 6)。不做任何预处理,直接用梯度下降训练线性回归,会发生什么?
先猜一猜:模型能拟合的函数完全一样(面积的权重 可以自己变小来适应大的数),所以最后的结果应该一样好。那训练过程会有什么不同吗?
答案是:会,而且差得惊人。代码 01 演示 1 里,同一个线性回归,原始输入要走 444,615 步梯度下降才收敛,标准化之后只要 14 步。这一节回答为什么。
1.2 做法:两行代码
Ng 在 “Normalizing Inputs” 里的做法分两步。对训练集的每个特征:
做完以后每个特征的均值是 0、方差是 1。(如果你在视频的板书里看到的是”除以 “,按”让方差变成 1”这个目的,应当理解成除以标准差 。)代码只有两行(01_normalizing_inputs.py 的 fit_standardizer / apply_standardizer,和第 1 讲的 tiny_nn.Standardizer 是同一件事):
mu = X.mean(axis=1, keepdims=True)      # (n_x, 1),只在训练集上算
sd = X.std(axis=1, keepdims=True)
X_norm = (X - mu) / sd                  # 训练集、dev、test、上线后的每个样本,都用这一组 mu、sd
Ng 特别强调的一点:测试集要用训练集的 和 ,而不是自己再算一组。§1.6 会看到为什么。
1.3 为什么快:碗的形状由 Hessian 决定
线性回归的代价 是参数的二次函数。把 并进参数,,,它可以写成
是 的 Hessian(二阶导数矩阵)。 的形状就是一只”碗”: 的特征向量是碗的几个主方向,特征值 是每个方向上的曲率(有多陡)。
梯度下降每一步 。记误差 ,它满足 。沿第 个主方向,误差每一步乘以 。于是:
- 稳定的条件:每个方向都要 ,也就是 。这正是第 2 讲 §4.2 的”学习率不能超过 2 / 曲率”,只是现在”曲率”指最陡的那个方向。
- 收敛的速度:取一个安全且接近最大的学习率 ,最陡的方向一步就到位,最平的方向每步只缩小 。要把误差缩小到原来的 倍,大约需要
步。 叫条件数(condition number),它衡量碗有多”扁”。学习率被最陡的方向卡住,速度被最平的方向拖住——两者之比决定了要走多少步。
代码 01 演示 1 生成了 200 套房子:面积均值 96.0、标准差 26.2(m²);卧室数均值 2.86、标准差 0.94;两者相关系数 0.57。对五种输入,各用自己的 ,从 走到 :
| 输入 | 条件数 | 能用的最大学习率 | 梯度下降步数 | ||
|---|---|---|---|---|---|
| 原始 | 9.92e+03 | 0.0628 | 1.58e+05 | 0.000202 | 444,615 |
| 只除以标准差 | 25.1 | 0.0609 | 413 | 0.0796 | 815 |
| 只减均值 | 685 | 0.602 | 1.14e+03 | 0.00292 | 4,843 |
| 标准化(减均值、除以 ) | 1.57 | 0.431 | 3.64 | 1.27 | 14 |
| 白化(再去掉相关性) | 1 | 1 | 1 | 2 | 1 |
逐行读:
- 原始:,大约就是面积的均方 。学习率必须小于 0.0002,否则这个方向发散;可在这么小的步子下,最平的方向(曲率只有 0.06)每步只前进约 ,于是要走 44 万步。
- 只除以标准差还不够(815 步)。特征的均值不是 0 时,“所有特征一起变大”的方向和偏置 的方向几乎共线: 里会出现一个特别大的特征值(大约是 再加上相关性的贡献,这里 25.1)和一个特别小的特征值。
- 只减均值也不够(4,843 步)。中心化之后 , 是协方差矩阵,它的特征值仍然被两个特征的方差( 对 )拉得很开。
- 标准化:, 是相关系数矩阵。两个特征时 的特征值是 (这里 1.57 和 0.43),所以 。剩下的”扁”完全来自两个特征的相关性。
- 白化(whitening)把相关性也去掉,,碗变成正圆,梯度直接指向最低点,一步就到底。实践中很少做白化:高维时要算协方差矩阵的特征分解,代价大,而且标准化已经解决了最大的问题。
和第 2 讲连起来:第 2 讲 §4.3 在图像上算出 、临界学习率 ;练习 6 发现不除以 255 时 变成约 ,临界学习率小了约六万倍。那是”只缩放”的效应。这里的表说明,均值不为 0 同样会让 变大——除以 255 之后像素在 [0, 1] 之间,均值并不是 0,按这张表的道理,再减去均值通常还能让条件数更小。
1.4 把碗画出来
代码 01 演示 2 把两个参数的情形画了出来(无偏置、已中心化, 的尺度是 的 5 倍)。左右两张图用的都是二次函数上”最好的固定学习率” :
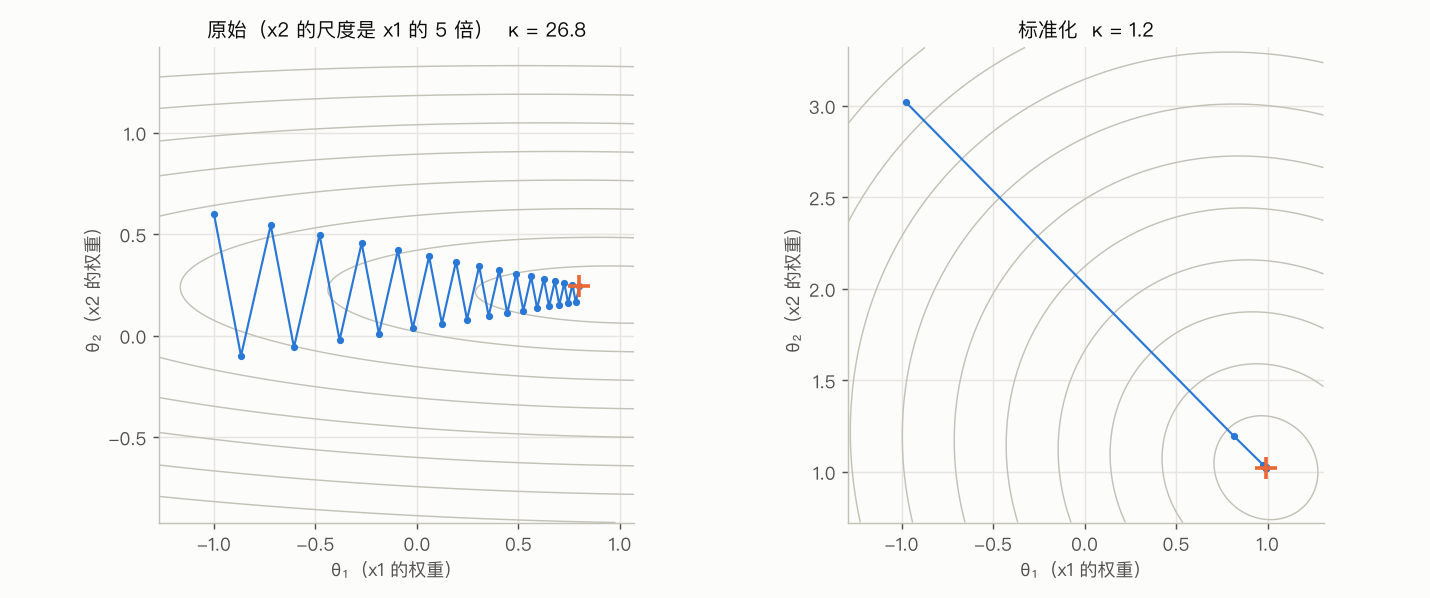
(这张图由 01_normalizing_inputs.py 生成;没装 matplotlib 时脚本只打印同样内容的字符画。)
| 特征值 | 学习率 | 误差缩小到 1/1000 的步数 | ||
|---|---|---|---|---|
| 原始( 的尺度是 的 5 倍) | 0.95 / 25.35 | 26.8 | 0.0761 | 93 |
| 标准化 | 0.91 / 1.09 | 1.19 | 1.0000 | 3 |
左图就是 Ng 画的那只”狭长的碗”。 大 5 倍, 方向的曲率就大 25 倍。梯度垂直于等高线,在狭长的碗里它几乎指向”峡谷的对面”而不是谷底,于是轨迹在 方向来回”之”字形震荡,沿 方向慢慢挪。即使用了最好的固定学习率,误差每步也只能缩小 。学习率再大, 方向就发散;再小, 方向更慢。这正是第 8 讲 Momentum 和 RMSprop 要对付的局面——它们在优化器这一侧解决同一个问题(RMSprop 甚至可以理解成”给每个参数单独做一次尺度归一化”)。
两张图是同一个模型在不同坐标下的样子(标准化后的参数 = 原参数 × ),能拟合的函数完全一样,只是优化的难易程度天差地别。这回答了 §1.1 的问题:归一化不改变模型能表示什么,只改变梯度下降走起来有多难。
1.5 神经网络里:曲率之外,还有”折点”
神经网络的代价不是二次函数,Hessian 随参数变化,§1.3 的分析只在局部近似成立。归一化在网络里的效果还一样吗?代码 01 演示 3 用同心圆数据(400 个样本)和 Coursera Initialization 作业同款的 [2, 10, 5, 1] ReLU 网络(He 初始化,§3.6 还会用到)做实验。故事是:第一个坐标换成了”厘米”(×100),原点挪到 5 米外(+5)。四种输入、十个学习率,全批量梯度下降 3000 步,看训练准确率(这里只关心优化):
| 输入 | 初始 cost | 初始 | 学得动的最大学习率 | 第 1 层”全开或全关”的单元 | 最好准确率(学习率) | |
|---|---|---|---|---|---|---|
| 原始: | 13.813 | 641 | 0.00312 | — | 100% | 0.500(0.0001) |
| 只放大: | 3.879 | 128 | 0.0156 | 0.03 | 0% | 0.733(0.03) |
| 只平移: | 0.708 | 27.9 | 0.0717 | 0.1 | 90% | 0.748(0.1) |
| 标准化 | 0.743 | 1.14 | 1.76 | 1 | 0% | 1.000(1) |
| 输入 | 0.0001 | 0.0003 | 0.001 | 0.003 | 0.01 | 0.03 | 0.1 | 0.3 | 1 | 3 |
|---|---|---|---|---|---|---|---|---|---|---|
| 原始 | 0.500 | 0.500 | 0.500 | 0.500 | 0.500 | 0.500 | 0.500 | 0.500 | 0.500 | 0.500 |
| 只放大 | 0.525 | 0.530 | 0.583 | 0.675 | 0.715 | 0.733 | 0.500 | 0.500 | 0.500 | 0.500 |
| 只平移 | 0.555 | 0.573 | 0.590 | 0.620 | 0.580 | 0.580 | 0.748 | 0.500 | 0.500 | 0.500 |
| 标准化 | 0.497 | 0.495 | 0.540 | 0.765 | 0.985 | 0.990 | 0.998 | 0.998 | 1.000 | 0.500 |
(“初始 “是在初始参数处用梯度的差分算出整个 91×91 的 Hessian 再求特征值;“学得动”指 3000 步后训练准确率 ≥ 0.55;“全开或全关”指对所有样本都 或都 的单元。)
两种不同的毛病:
- 只放大是 §1.3 的”狭长的碗”:初始点的 从 1.14 涨到 128,能用的学习率跟着缩小。学习率稍大,网络不是发散,而是”死”在 cost ≈ ln 2 上,准确率 0.500,和第 4 讲代码 05 里 ReLU 全部死掉是同一种失败。十个学习率里最好的一格只有 0.733。
- 只平移是神经网络特有的问题。 从 0 开始,第 1 层每个 ReLU 单元的”折点”(直线 )都穿过原点,而数据整体在 5 个单位之外。结果 90% 的单元对所有样本要么全开(这时它就是一个线性函数)、要么全关(死的)。网络一开始几乎是个线性模型,要先把 挪动好几个单位,折点才能落进数据里。第 1 讲 §2.2 那个”卡在线性解上”的 [5, 2, 1] 网络,就是同一种现象。
- 两者都有(原始):100% 的单元全开或全关,初始 cost 13.81(输出层一开始就”非常自信地错了”),十个学习率全部停在 0.500。
- 标准化:五个学习率(0.01 到 1)都能在 3000 步内达到 95% 以上,跨了两个数量级。
最后一点值得强调:输入归一化不只让最好的结果更好,更重要的是让能用的超参数范围变宽,调参容易得多。另外,初始点的 和”学得动的最大学习率”在同一个量级(标准化时 1.76,学习率 1 能训练、3 就死了;只放大时 0.0156 对 0.03;只平移时 0.0717 对 0.1)。神经网络的曲率随训练变化,它只能当一个粗略的参考,但第 2 讲的”2/曲率”在这里依然是对的思考方式。
1.6 训练集和测试集必须用同一组 μ、σ
代码 01 演示 4 拿演示 3 的标准化网络(学习率 0.1 训练 3000 步),在 2000 个测试样本上试几种做法:
| 做法 | 测试准确率 |
|---|---|
| 整个测试集,用训练集的 (正确) | 0.991 |
| 整个测试集,用测试集自己的 | 0.989 |
| 只有右半边的测试样本,用训练集的 (正确) | 0.984 |
| 只有右半边的测试样本,用它们自己的 | 0.833 |
| 逐个样本,用它自己的 | 0.500 |
第二行是这个 bug 最危险的地方:测试集和训练集同分布时,两组统计量本来就差不多,离线评估里根本看不出来(0.989 对 0.991)。可一旦测试数据的分布偏了一点(比如都来自某个季节、某个地区,这里用”右半边”模拟),用它们自己的统计量会把它们”挪回中间、拉伸到单位方差”,网络看到的是一批完全不同的点:0.984 掉到 0.833。上线后一个一个地预测时,“测试集的均值”根本没法算:一个样本的均值就是它自己、标准差是 0,标准化后永远是 0 向量,网络对所有输入给出同一个预测。
规则: 是模型的一部分,和 一起保存;只在训练集上算一次,之后 dev、test、线上数据都用这一组。第 9 讲的 BatchNorm 在测试时用”训练时累积的均值和方差”,是同一个道理。
1.7 实践中的几个问题
- 什么时候必须做? 特征的尺度差很多(面积 vs 卧室数、收入 vs 年龄)时必须做。尺度本来就差不多(比如都在 0 到 1 之间)时效果小一些,但做了也没有坏处,所以 Ng 的建议是:总是做。
- 图像:常见的做法是除以 255(第 2 讲),更讲究的是每个颜色通道减去训练集的均值、除以标准差(ImageNet 上训练的模型通常这样做)。
- 相关的特征:标准化不去掉相关性(演示 1 里 还剩 3.64)。真想去掉要做白化,但很少值得。
- 只对输入做够吗? 输入归一化只管住了第一层的输入。第 2 层的输入是第 1 层的输出,它的尺度由权重决定——这正是 §2–3 的问题。BatchNorm(第 9 讲)把同样的想法用到每一层的输入上,而且在训练全程都起作用。
2. 梯度消失与梯度爆炸 · Vanishing / exploding gradients
2.1 线性深网:Ng 的例子
Ng 用一个极简的网络说明问题: 层,激活函数是恒等函数 ,。于是
如果每个 都是 ,输出就是 ;如果是 0.5 倍的单位矩阵,输出就是 。代码 02 演示 1(a) 把 列成表:
| 0.5 | 9.77e−04 | 8.88e−16 | 7.01e−46 |
| 0.9 | 3.49e−01 | 5.15e−03 | 1.37e−07 |
| 1.0 | 1.00 | 1.00 | 1.00 |
| 1.1 | 2.59 | 1.17e+02 | 1.62e+06 |
| 1.5 | 5.77e+01 | 6.38e+08 | 2.59e+26 |
指数函数对底数极其敏感:即使 或 这种”只差 10%“,50 层后也差了 0.005 倍或 117 倍。Ng 在视频里提到当时微软的 152 层网络(ResNet),说的就是这个尺度。
2.2 反向传播也是一串矩阵连乘
前向信号是这样,梯度呢?把第 4 讲的反向公式 、 展开,输入端收到的梯度是
同样是 个矩阵连乘,同样会指数式地变大或变小。梯度太小,靠近输入的层几乎学不动(梯度消失,vanishing gradients);梯度太大,一步更新就把参数推到天文数字,出现 inf / nan(梯度爆炸,exploding gradients)。这个问题在 1990 年代就被认识到了(Hochreiter 1991 年的毕业论文;Bengio, Simard & Frasconi 1994),当时主要是在循环网络里——RNN 按时间展开就是一个很深的网络(第 15 讲)。
2.3 随机矩阵:增益 c
真实网络的权重是随机的,不是对角矩阵。设 的每个元素独立、均值 0、方差 。对一个固定的输入 ( 维),
(交叉项 都消失了。)所以每过一层线性层,信号的均方乘 ; 层之后 RMS 乘 。代码 02 演示 1(b) 用 的随机线性深网验证(5 个随机网络平均):
| 实测 | 理论 | 实测 | 理论 | |
|---|---|---|---|---|
| 0.5 | 3.14e−02 | 3.12e−02 | 3.38e−08 | 2.98e−08 |
| 0.9 | 5.88e−01 | 5.90e−01 | 7.28e−02 | 7.18e−02 |
| 1.0 | 9.57e−01 | 1.00 | 8.42e−01 | 1.00 |
| 1.1 | 1.57 | 1.61 | 1.16e+01 | 1.08e+01 |
| 2.0 | 3.25e+01 | 3.20e+01 | 2.91e+07 | 3.36e+07 |
理论和实测在 50 层、跨越 15 个数量级的范围内都在同一个量级。于是初始化的核心问题被归结成一句话:把每层的增益调到 1。对线性层, 就做到了。有了激活函数,事情还要再算一步。
3. 方差保持的初始化 · Weight initialization for deep networks
3.1 一个神经元:输入越多,权重越小
Ng 的讲法从一个神经元开始:(先不管 )。 越大,加起来的项越多, 就越大。想让 的尺度不随 变化,每个 就要随 变小。
定量地说,假设 独立、均值 0、方差 ,并且和输入 独立。和的方差等于方差的和,每一项 ,所以
输入已经归一化()时 ,这就是 。想让 ,就要
注意公式里是 而不是 :后面 ReLU 的输出都是非负的,均值不是 0,真正在层与层之间传递的是均方。这也是代码里用 RMS 而不是标准差来衡量”信号多大”的原因。
3.2 加上激活函数:Xavier 和 He
现在看第 层:,。上面的公式给出 ,还差一步:激活函数把均方变成多少?
- tanh:在 0 附近 ,所以 。每层的增益是 ,要它等于 1 就是 。这叫 Xavier 初始化(以 Glorot & Bengio 2010 的第一作者 Xavier Glorot 命名;LeCun 等人 1998 年的 “Efficient BackProp” 里已经推荐过 的尺度)。
- ReLU: 关于 0 对称时,ReLU 把负的一半置 0、正的一半原样保留:
每层的增益变成 ,要它等于 1 就得 。这叫 He 初始化(He, Zhang, Ren & Sun 2015)。那个 2 补的就是 ReLU 砍掉的一半。
Coursera 作业里的写法:
W[l] = np.random.randn(n[l], n[l-1]) * np.sqrt(2 / n[l-1])     # He:ReLU
W[l] = np.random.randn(n[l], n[l-1]) * np.sqrt(1 / n[l-1])     # Xavier:tanh
b[l] = np.zeros((n[l], 1))
第 1 讲 tiny_nn.initialize_parameters、第 4 讲 deep_nn.initialize_parameters_deep 一直在用这两行。Ng 还提到,这个方差也可以乘一个系数当成超参数来调,只是在他的超参数清单里优先级很低。
3.3 反向传播:Glorot 的折中
反向时 , 的每个分量是 项之和( 的一行有 个元素)。同样的推导给出
ReLU 的 ,tanh 在 0 附近约为 1。所以反向想要的是 ,和前向的 只差在 换成了 。层宽相同时两者一致;层宽不同时不可能同时满足。Glorot & Bengio (2010) 取了一个折中(两者的调和平均):
代码 02 演示 3 用一个”漏斗”网络(1024 → 512 → … → 16,6 层线性层,每层 )对比三种写法:
| 初始化 | 前向增益(实测 / 理论) | 反向增益(实测 / 理论) |
|---|---|---|
| Xavier | 0.986 / 1.000 | 0.122 / 0.125 |
| 8.192 / 8.000 | 1.027 / 1.000 | |
| Glorot | 2.361 / 2.370 | 0.296 / 0.296 |
(前向增益 = 第 6 层输出的 RMS / 输入的 RMS;反向增益 = 输入端梯度的 RMS / 输出端梯度的 RMS。)
Xavier 保住了前向,反向剩 1/8; 保住了反向,前向放大 8 倍;Glorot 两边都偏,但都偏得不多。注意那个 1/8 恰好是 :只满足前向条件时,反向的均方总增益是 (前后相消,telescoping),RMS 是它的平方根。剩下的只是”最后一层和第一层的宽度比”,不会随深度指数变化。He et al. (2015) 正是用这个理由说明只看 fan-in(或只看 fan-out)就够了。实践中最常用的是只看 fan-in 的版本(Coursera 作业;PyTorch 的 kaiming_normal_ 默认 mode='fan_in')。
3.4 实验:20 层网络里的信号
代码 02 演示 2 搭了一个 20 层、每层 256 个单元的网络(),输入 ,所有层用同一种激活函数,5 种初始化 × tanh / ReLU,逐层测前向的 RMS(),再从 往回传、测 RMS()。每格是 5 个随机网络的平均;“每层增益”和”理论”两列来自 §3.2–3.3 的公式(tanh 用线性近似 )。
前向:第 层输出的 RMS
| 激活 | 初始化 | 每层增益 | 理论 | |||||
|---|---|---|---|---|---|---|---|---|
| tanh | 全 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| tanh | 0.01·randn | 0.0256 | 1.55e−01 | 1.01e−04 | 1.07e−08 | 1.12e−12 | 1.20e−16 | 1.21e−16 |
| tanh | randn(std 1) | 256 | 9.75e−01 | 9.74e−01 | 9.74e−01 | 9.74e−01 | 9.74e−01 | 1.21e+24 |
| tanh | Xavier | 1 | 6.28e−01 | 3.22e−01 | 2.27e−01 | 1.85e−01 | 1.60e−01 | 1.00 |
| tanh | He | 2 | 7.20e−01 | 5.66e−01 | 5.56e−01 | 5.57e−01 | 5.56e−01 | 1.02e+03 |
| ReLU | 全 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| ReLU | 0.01·randn | 0.0128 | 1.13e−01 | 1.92e−05 | 3.39e−10 | 6.57e−15 | 1.21e−19 | 1.18e−19 |
| ReLU | randn(std 1) | 128 | 1.13e+01 | 1.87e+05 | 3.29e+10 | 5.63e+15 | 9.95e+20 | 1.18e+21 |
| ReLU | Xavier | 0.5 | 7.06e−01 | 1.80e−01 | 3.05e−02 | 5.15e−03 | 1.00e−03 | 9.77e−04 |
| ReLU | He | 1 | 1.00 | 9.65e−01 | 8.34e−01 | 7.86e−01 | 8.14e−01 | 1.00 |
反向:第 层收到的梯度 的 RMS(从第 20 层往回)
| 激活 | 初始化 | 理论 | |||||||
|---|---|---|---|---|---|---|---|---|---|
| tanh | 0.01·randn | 1.00 | 1.05e−04 | 1.10e−08 | 1.16e−12 | 7.59e−16 | 7.56e−16 | 8.43e−15 | 0.998 |
| tanh | randn(std 1) | 1.00 | 2.29e+02 | 5.24e+04 | 1.13e+07 | 8.40e+08 | 7.56e+22 | 2.07 | 8.42e+08 |
| tanh | Xavier | 1.00 | 8.75e−01 | 7.27e−01 | 5.19e−01 | 2.81e−01 | 1.00 | 1.82 | 1.20 |
| tanh | He | 1.00 | 1.29 | 1.66 | 2.13 | 2.17 | 7.24e+02 | 4.73 | 3.11 |
| ReLU | 0.01·randn | 0.999 | 1.87e−05 | 3.57e−10 | 6.49e−15 | 1.08e−18 | 1.04e−18 | 9.14e−18 | 0.961 |
| ReLU | randn(std 1) | 0.999 | 1.90e+05 | 3.36e+10 | 5.99e+15 | 9.76e+19 | 1.04e+20 | 7.47e+20 | 1.06 |
| ReLU | Xavier | 0.999 | 1.83e−01 | 3.15e−02 | 5.53e−03 | 1.39e−03 | 1.38e−03 | 1.14e−02 | 0.991 |
| ReLU | He | 1.00 | 1.02 | 9.91e−01 | 9.66e−01 | 9.44e−01 | 1.00 | 6.18 | 1.24 |
(全 0 的两行反向也全是 0,省略。)
先预测再看:哪几行”健康”?
- 全 0:前向全是 0(tanh(0) = ReLU(0) = 0),反向也是 0。第 3 讲的对称性问题的极端形式。
- 0.01·randn(太小):每层增益只有 0.0128(ReLU),20 层后前向 RMS 只剩 1.21e−19,反向第 1 层收到的梯度只有 1.08e−18,理论值(1.18e−19、1.04e−18)几乎分毫不差。第 3 讲 §7.4 说”一个隐藏层时越小越安全”,到 20 层就完全不成立了——那一节最后的预告(“深层网络需要刚刚好的尺度”)说的就是这件事。
- randn(太大):ReLU 每层放大 128 倍(均方),20 层后 RMS 到 9.95e+20,反向同样爆炸。
- He + ReLU:前向 1.00 → 0.814,反向 1 → 0.944,和理论(处处 1)基本一致,偏离来自有限宽度的随机波动(§3.7)。对照 Xavier + ReLU:每层只有 ½ 的增益,20 层后前向剩 1.00e−03(理论 )。这就是 He 要多乘一个 2 的原因。
- Xavier + tanh:线性近似说每层增益是 1,实测前向从 0.628 慢慢降到 0.160,反向从 1 降到 0.281。tanh 只在 0 附近像直线, 不小时它比直线”矮”,每层都打一点折扣。比 0.01 和 randn 温和得多,但不完美。
和预想不一样的一行:tanh + randn。 我原以为太大的初始化对 tanh 造成的是梯度消失:单元全部饱和,导数 ,梯度传不过去(第 3 讲 §7.4 在一个隐藏层的网络上看到的正是这样)。前向确实如此:RMS 被”压”在 0.974,没有爆炸。可反向是爆炸的:第 1 层收到的梯度 8.40e+08。代码”放大看”了第 10 层:86.4% 的单元饱和,但 仍有 0.0343——剩下那一小部分处在线性区的单元导数接近 1。而 太大,乘出来每层的反向增益是 (均方),。一个隐藏层时没有”连乘”,饱和占了上风;20 层时,256 这个系数被乘了 19 次。He + tanh(增益 2)是同一现象的温和版本:前向停在 0.556,反向慢慢变大到 2.17。ReLU 是”齐次”的(,),方差递推对它是精确的;tanh 饱和时(randn、He 两行)理论列完全不能用。
最后一列的一个细节。 ReLU 的 0.01 和 randn 两行, 都约等于 1(0.961 和 1.06)。原因是 :越靠近输入, 越小(或越大),但 正好越大(或越小),两者相乘抵消了。所以这两种初始化的问题不是”前几层比后几层学得慢”,而是所有层的梯度都一样离谱:0.01 时 = 9.14e−18,randn 时 7.47e+20。只有当前向信号被有界的激活函数”钉住”(tanh 在 ±1 以内、sigmoid 在 0 到 1 之间),反向信号却一层层变大或变小时,这个比值才远离 1:tanh + randn 是 8.42e+08,第 1 讲的 sigmoid 网络是 5.3e−4。下一节就来拆第 1 讲的那个数。
3.5 回看第 1 讲:1/2000 和 1/10 是怎么来的
第 1 讲 §4.4 的表:5 个隐藏层(每层 32 个单元)的网络,刚初始化时 ,sigmoid 是 5.3e−4(约 1/2000),ReLU 是 9.4e−2(约 1/10)。当时的解释是”sigmoid 的导数最多 0.25”。现在可以拆得更细。
由三样东西决定:① 反向的信号 有多大(§3.3 的方差递推管的就是它);② 这一层的输入 有多大、矩阵有几个元素;③ 对 个样本求平均时,各个样本的 有多少是”同向”的(方向乱的会互相抵消)。代码 02 演示 4 用和第 1 讲完全相同的数据、种子和 tiny_nn 复现了那两个数(5.3e−04、9.4e−02),并逐层测出这三样东西。“同向程度” = RMS( 的元素) / (RMS() · RMS()),在 0 到 1 之间;“下一层 / 这一层”是 RMS() 往输入方向走一层时的比值,理论值 。
sigmoid(Xavier 初始化):
| 层 | RMS() | 下一层 / 这一层 | 理论 | RMS() | 元素个数 | 同向程度 | |
|---|---|---|---|---|---|---|---|
| 输出层 | 6.74e−01 | 5.42e−01 | 0.054 | 0.042 | 0.568 | 32 | 0.387 |
| 第 5 层 | 1.91e−01 | 2.92e−02 | 0.252 | 0.234 | 0.527 | 1024 | 0.387 |
| 第 4 层 | 4.75e−02 | 7.36e−03 | 0.212 | 0.232 | 0.522 | 1024 | 0.387 |
| 第 3 层 | 1.06e−02 | 1.56e−03 | 0.292 | 0.233 | 0.549 | 1024 | 0.386 |
| 第 2 层 | 2.97e−03 | 4.57e−04 | 0.215 | 0.215 | 0.539 | 1024 | 0.377 |
| 第 1 层 | 3.55e−04 | 9.82e−05 | — | — | 0.993 | 320 | 0.204 |
ReLU(He 初始化):
| 层 | RMS() | 下一层 / 这一层 | 理论 | RMS() | 元素个数 | 同向程度 | |
|---|---|---|---|---|---|---|---|
| 输出层 | 1.80 | 5.69e−01 | 0.234 | 0.203 | 1.302 | 32 | 0.430 |
| 第 5 层 | 1.59 | 1.33e−01 | 0.906 | 0.999 | 1.036 | 1024 | 0.361 |
| 第 4 层 | 1.15 | 1.20e−01 | 0.907 | 1.003 | 1.083 | 1024 | 0.275 |
| 第 3 层 | 8.04e−01 | 1.09e−01 | 1.052 | 1.083 | 1.136 | 1024 | 0.202 |
| 第 2 层 | 4.49e−01 | 1.15e−01 | 0.927 | 1.001 | 0.964 | 1024 | 0.127 |
| 第 1 层 | 1.69e−01 | 1.07e−01 | — | — | 0.993 | 320 | 0.089 |
- sigmoid:真正的梯度消失。 RMS() 从输出层的 0.542 降到第 1 层的 9.82e−05,缩小 5523 倍。隐藏层之间每走一层乘约 0.21–0.29,和理论(约 0.23)一致。Xavier 已经让 ,剩下的就是 sigmoid 导数本身:它最大只有 1/4,任何初始化都补不回来——想补就得让 变大 16 倍,前向又会饱和。这是 sigmoid 不适合做深网隐藏层的根本原因(第 3 讲 §4.3–4.4 的结论,现在有了定量的版本)。
- ReLU:隐藏层之间没有梯度消失。 第 1–5 层的 RMS() 都在 0.107–0.133 之间,比值约为 1,和 He 的理论一致。唯一一次”缩水”在输出层 → 第 5 层:输出层只有 1 个单元,,这正是 §3.3 说的”只按 fan-in 初始化时,层宽变化处反向会有一个宽度比”。
- 那 ReLU 的 1/10 是从哪来的? 主要不是 ,而是另外两个因素:第 1 层的 只有 320 个元素(其他隐藏层 1024 个);以及”同向程度”从第 5 层的 0.361 降到第 1 层的 0.089——离输出越远,各个样本的 方向越乱,对 个样本求平均时抵消得越多。方差保持的初始化管的是每个样本的梯度信号有多大,管不了这种抵消。
教训:读”梯度大小随层变化”的表时要小心。 随层变小不一定是梯度消失,先看 RMS() 有没有逐层按比例缩小。
3.6 在同心圆上训练:仿 Coursera “Initialization” 作业
前面都是”不训练、只测量”。代码 03 把问题放进真实的训练:作业的设定是同心圆数据(sklearn 的 make_circles(noise=0.05),内圈半径是默认的 0.8;这里用第 3 讲 planar_data.make_circles 的同一个生成器,训练 300 个,测试改成 1000 个),网络 [2, 10, 5, 1](ReLU、ReLU、sigmoid),学习率 0.01,全批量梯度下降 15000 步,三种初始化:全 0、大随机数(randn * 10)、He。代码 03 演示 1(初始化种子 3,和原作业的 np.random.seed(3) 一样):
| 初始化 | 第 0 步 | 第 1000 步 | 第 2000 步 | 第 5000 步 | 第 10000 步 | 第 15000 步 | 训练准确率 | 测试准确率 |
|---|---|---|---|---|---|---|---|---|
| 全 0 | 0.6931 | 0.6931 | 0.6931 | 0.6931 | 0.6931 | 0.6931 | 0.500 | 0.500 |
| 大随机数 ×10 | 13.4471 | 0.6658 | 0.5750 | 0.5477 | 0.5406 | 0.4401 | 0.763 | 0.716 |
| He | 0.7764 | 0.6889 | 0.6798 | 0.6294 | 0.2762 | 0.1011 | 0.983 | 0.969 |
脚本还打印了三张决策边界的字符画:全 0 把整个平面判成一类;×10 的边界是一个粗糙的多边形,内圈外面一大片都被判成了内圈;He 的边界是一个很圆的圈。原作业报告的结果大约是:全 0 训练 / 测试 50% / 50%,×10 约 83% / 86%,He 约 99% / 96%。我们的 ×10 更差一些(不同的随机数),趋势一样。
- 全 0:cost 从头到尾都是 ln 2。第 0 步每层的 都是 0:ReLU(0) = 0,所以 ,; 又让传回去的梯度也是 0。输出层的偏置 本来能动,可两类各 150 个, 恰好是 0。和第 3 讲代码 04 的”全 0 + sigmoid”一模一样。
- ×10:第 0 步的 cost 是 13.45(原作业里打印出来是 inf,因为 在 很大时在浮点数里恰好等于 1,;我们的 cost 把概率裁剪到 ,每个样本最多算 )。输出层的 sigmoid 一开始就饱和,网络对很多样本”非常自信地错了”。前 1000 步 cost 掉到 0.67,之后就在 0.4–0.6 之间慢慢挪。
- He:第 0 步 cost 0.7764,接近 ln 2(“什么都不确定”)。前几千步在一个平台上慢慢挪,之后才快速下降。
一次运气好不算数。代码 03 演示 2 用 5 种初始化 × 3 个种子:
| 初始化 | 第 0 步 cost | 第 0 步 | 种子 0:训练 / 测试 | 种子 1 | 种子 2 | 测试平均 |
|---|---|---|---|---|---|---|
| 全 0 | 0.693 | 0 | 0.500 / 0.500 | 0.500 / 0.500 | 0.500 / 0.500 | 0.500 |
| 0.01·randn | 0.693 | 7.6e−06 | 0.493 / 0.489 | 0.503 / 0.511 | 0.510 / 0.507 | 0.502 |
| Xavier | 0.741 | 4.4e−02 | 0.993 / 0.970 | 0.987 / 0.967 | 0.987 / 0.967 | 0.968 |
| He | 0.930 | 1.3e−01 | 0.993 / 0.969 | 0.987 / 0.966 | 0.990 / 0.967 | 0.967 |
| 10·randn | 12.946 | 7.3e+01 | 0.923 / 0.885 | 0.760 / 0.708 | 0.807 / 0.788 | 0.794 |
- 0.01·randn(Coursera “Step by Step” 作业的写法)在这里完全学不动:第 0 步 只有 7.6e−06。第 3 讲代码 04 里 0.01 明明工作得很好——那里只有一个隐藏层、学习率 1.2;这里信号要穿过两个隐藏层(每层乘一个 0.01 量级的矩阵),学习率又只有 0.01。参数全为 0 的点是一个梯度为 0 的鞍点,0.01 的初始化等于把网络放在它旁边。
- Xavier 和 He 都很好(0.968、0.967):只有两个隐藏层时,两者每层差的那个 还不要紧。
- ×10 三个种子是 0.885、0.708、0.788:不是”一定失败”,而是不可靠,结果看运气。第 3 讲 §7.4 对一个隐藏层得出过同样的结论。
把网络加深到 10 层([2, 10, 10, 10, 10, 10, 10, 10, 10, 5, 1]),同样的数据、学习率、步数。代码 03 演示 3(“全死的层”:训练后有几层的 ReLU 对所有训练样本都输出 0):
| 初始化 | 种子 | 第 0 步 | 第 5000 步 cost | 最低 cost | 最后 cost | 训练 | 测试 | 全死的层 | 发散 | |
|---|---|---|---|---|---|---|---|---|---|---|
| 0.01·randn | 0 | 2.6e−17 | 8.5e−17 | 0.6931 | 0.6931 | 0.6931 | 0.523 | 0.526 | 0 | 否 |
| 0.01·randn | 1 | 3.6e−18 | 1.9e−18 | 0.6931 | 0.6931 | 0.6931 | 0.500 | 0.500 | 0 | 否 |
| 0.01·randn | 2 | 1.1e−17 | 5.6e−18 | 0.6931 | 0.6931 | 0.6931 | 0.487 | 0.479 | 0 | 否 |
| Xavier | 0 | 1.4e−03 | 7.4e−03 | 0.6888 | 0.0378 | 0.6932 | 0.500 | 0.500 | 1 | 否 |
| Xavier | 1 | 1.6e−04 | 1.3e−04 | 0.6930 | 0.6913 | 0.6913 | 0.520 | 0.511 | 0 | 否 |
| Xavier | 2 | 5.0e−04 | 4.1e−04 | 0.6898 | 0.0111 | 0.0115 | 0.993 | 0.960 | 0 | 否 |
| He | 0 | 1.6e−01 | 9.1e−01 | 0.6780 | 0.0114 | 0.6931 | 0.500 | 0.500 | 1 | 否 |
| He | 1 | 3.5e−03 | 2.8e−03 | 0.0108 | 0.0045 | 0.0054 | 0.997 | 0.971 | 0 | 否 |
| He | 2 | 1.7e−02 | 2.2e−02 | 0.6843 | 0.0013 | 0.0013 | 1.000 | 0.967 | 0 | 否 |
| 10·randn | 0 | 2.2e+11 | 9.1e+11 | 0.6931 | 0.6931 | 0.6931 | 0.500 | 0.500 | 6 | 否 |
| 10·randn | 1 | 1.6e+10 | 7.8e+09 | — | 13.9076 | 13.9076 | 0.500 | 0.500 | 1 | 是 |
| 10·randn | 2 | 6.5e+10 | 5.9e+10 | 0.6931 | 0.6931 | 0.6931 | 0.500 | 0.500 | 3 | 否 |
- 第 0 步第 1 层的梯度,0.01 和 ×10 之比在 3 层网络里约是 ,在 10 层网络里约是 ——每多一层就多乘一次”增益”,这就是 §2.3 的指数规律在真实训练里的样子。
- 0.01:梯度约 1e−17,cost 一动不动。注意第 1 层和第 10 层的梯度同样小(§3.4 最后一段说的”所有层一样离谱”)。
- ×10:第一步的更新量是”学习率 × 梯度” ≈ 0.01 × 1e10 的量级,参数被一下子推到天文数字:一个种子数值溢出(发散),其余的整层 ReLU 全部死掉,输出变成常数。
- He 和 Xavier:6 次训练里有 3 次达到 99% 以上,但也有失败。Xavier 种子 0 和 He 种子 0 先把 cost 降得很低(0.0378、0.0114),后来又跳回 ln 2:训练途中某一步更新太猛,有一整层(这里是只有 5 个单元的那一层)的 ReLU 全部死掉,网络再也回不来。Xavier 种子 1 则 15000 步都没离开初始的平台:Xavier 用在 ReLU 上每层信号减半,10 层后梯度只剩 1e−4 量级。
结论:网络越深,初始化尺度的”安全窗口”越窄——3 层时 Xavier、He、×10 都能(或多或少)训练,10 层时只剩 He 和 Xavier;而且它们也只保证起点合理,不保证整个训练过程稳定。
3.7 初始化只能缓解,不能根治
方差保持的初始化是一个漂亮的论证,但它有三个根本的局限:
-
它说的是期望,宽度有限时会有涨落。 代码 02 演示 5(a):He + ReLU,50 层,对每个样本算 = 第 50 层输出的均方 / 输入的均方。理论说 。每种宽度 20 个随机网络 × 200 个样本:
宽度 的平均 的中位数 10% 分位 90% 分位 的比例 10 5.00 1.13e−02 7.50e−08 2.07e−12 1.42e−03 0.023 30 1.67 2.25e−01 1.05e−02 3.36e−04 7.47e−01 0.000 100 0.50 5.49e−01 2.49e−01 3.90e−02 1.33 0.000 300 0.17 9.95e−01 6.59e−01 1.83e−01 2.25 0.000 宽度 300 时基本”保持”。宽度越窄,每层的随机波动越大,而 50 次波动是相乘的:宽度 10 时中位数只有 7.50e−08,2.3% 的样本在第 50 层已经全是 0(某一层的单元全死了),连 4000 个样本的平均值(1.13e−02)都估计不出”期望是 1”——它被极少数极大的值撑着。决定涨落大小的大致是 ,即各层宽度倒数之和(Hanin 2018;Hanin & Rolnick 2018):网络越深、越窄,初始化越”管不住”。代码 03 演示 3 那个只有 10 个单元宽的 10 层网络,就处在这个区域。
-
非线性让递推不再是简单的乘法。 代码 02 演示 5(b):tanh,宽度 256,200 层。Xavier 下 RMS 从第 1 层的 0.626 一路降到第 200 层的 0.025;He 下停在 0.556 附近,不消失,但很多单元处在饱和区。
-
最重要的一条:这些保证只在第 0 步成立。 训练开始后, 不再是独立的随机数,方差递推不再适用。代码 03 演示 3 里训练到一半”崩溃”的两次,就是训练途中的事。
所以现代网络还需要在训练全程”管住”尺度的结构和技巧:Batch Normalization(第 9 讲)每一步都把每层的输入重新标准化——相当于把 §1 的输入归一化用到每一层;残差连接(第 13 讲)给信号和梯度一条”直通”的路,,即使 的部分很小,信号也不会消失;更稳的优化器(第 8 讲)和梯度裁剪(gradient clipping,第 15 讲)对付训练中的爆炸;LSTM 的门控(第 15 讲)解决 RNN 里同样的问题。初始化方面也有更多的研究,比如正交初始化(Saxe et al. 2014)、逐层把方差调到 1 的 LSUV(Mishkin & Matas 2016),以及不用归一化层、靠初始化训练很深的残差网络的 Fixup(Zhang et al. 2019)。
实践中的一句话总结:ReLU 用 He,tanh 用 Xavier,sigmoid 别放在深网的隐藏层里;然后别指望初始化解决所有问题。另外要知道,框架的默认初始化不一定是 He:PyTorch 的 nn.Linear 默认用的是 ,方差 ,比 He 小 6 倍。浅网无所谓;很深又没有 BatchNorm、残差连接的网络,值得自己指定(第 9 讲会再提到)。
4. 梯度检验 · Gradient checking
4.1 数值导数:双边比单边准
反向传播的 bug 往往不报错:网络照样训练,只是学得慢或学得差。第 2 讲 §5.2 已经介绍过用差分近似导数,第 3、4 讲也用过。这一节把它变成一个系统的调试工具,先从”为什么双边差分更准”的推导开始。
把 在 处做泰勒展开:
于是
双边差分里,偶数次的项(、)在相减时正好抵消,误差从 降到 。Ng 的例子是 ,,:双边差分得 3.0001,误差 0.0001();单边差分得 3.0301,误差 0.0301(约 )。
4.2 ε 怎么选:截断误差 vs 舍入误差
既然误差随 变小,是不是 越小越好?第 2 讲 §5.2 的表已经看到: 时双边差分的误差反而回升了。原因是计算机里的数有精度上限。
float64 能表示的相对精度大约是 (单位舍入误差,unit roundoff)。算出来的 带着约 的误差,两个几乎相等的数相减再除以 ,这个误差被放大成约 。所以双边差分的总误差大约是
一个随 下降、一个随 上升,和是一条 U 形曲线。对 求导令其为 0,最优的 ,最好的误差 。单边差分的截断误差是 ,同样的推导给出 ,最好的误差也只有 。
代码 04 演示 1 先看作业第一部分的一维 (,)。它是直线,截断误差恰好是 0,剩下的全是舍入误差: 时相对误差 5.6e−14, 时 2.9e−10, 时 4.1e−08, 越小越糟。然后在一个小网络([4, 5, 3, 1],tanh 隐藏层,47 个参数,)上扫描 ,比较单边 float64、双边 float64、双边 float32 的相对误差(节选):
| 单边 float64 | 双边 float64 | 双边 float32 | |
|---|---|---|---|
| 1.0e−01 | 3.6e−02 | 1.2e−03 | 1.2e−03 |
| 1.0e−02 | 3.7e−03 | 1.2e−05 | 2.9e−05 |
| 1.0e−03 | 3.7e−04 | 1.2e−07 | 2.7e−04 |
| 1.0e−04 | 3.7e−05 | 1.2e−09 | 2.5e−03 |
| 1.0e−05 | 3.7e−06 | 4.4e−11 | 3.1e−02 |
| 1.0e−06 | 3.7e−07 | 5.8e−10 | 2.1e−01 |
| 1.0e−07 | 3.5e−08 | 4.7e−09 | 1.0 |
| 3.2e−08 | 2.7e−08 | 1.4e−08 | 1.0 |
| 1.0e−08 | 1.0e−07 | 4.5e−08 | 1.0 |
| 1.0e−10 | 8.3e−06 | 4.6e−06 | 1.0 |
| 1.0e−12 | 8.9e−04 | 4.9e−04 | 1.0 |
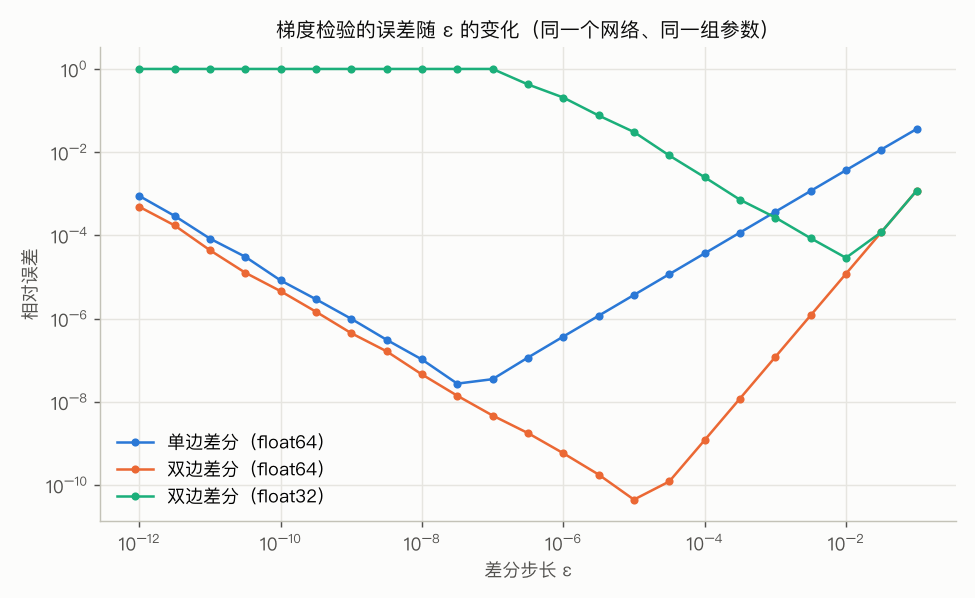
- 右半边( 大)是截断误差:单边差分 每小 10 倍误差小 10 倍(3.6e−02 → 3.7e−03 → 3.7e−04),双边小 100 倍(1.2e−03 → 1.2e−05 → 1.2e−07)。斜率 1 和 2,正是 和 。
- 左半边( 小)是舍入误差, 越小越糟,两种差分的斜率都是 −1。
- 底部:单边在 (误差 2.7e−08),双边在 (误差 4.4e−11),和理论估计(、)一致。Ng 推荐的 不是双边差分的最优点,但离 U 形底部不远,误差 4.7e−09,远低于 1e−7 的”很好”阈值。所以照着用 就行。
- float32 的单位舍入误差是 ,大了约 5 亿倍:双边差分最好也只有 2.9e−05(在 处,接近理论的 、); 时误差是 1.0——推动一下造成的 的变化(约 ,这里是 量级)比 在 float32 里能分辨的最小差别(约 )还小, 和 算出来一模一样,47 个分量的数值梯度全是 0。用 float32 做梯度检验,正确的实现也会被判成”有 bug”。 GPU 训练常用 float32 甚至更低的精度,所以梯度检验一定要切换到 float64(第 9 讲换成 PyTorch 后会看到,
torch.autograd.gradcheck的默认设置也是为双精度输入设计的,单精度输入很可能通不过)。
4.3 相对误差与经验阈值
有了每个参数的数值梯度 和反向传播的梯度 ,怎么比较?Ng 用的是
- 为什么是相对误差:梯度本身可能是 1e3 也可能是 1e−6,同样 1e−5 的绝对误差,对前者是完美、对后者是 10 倍的错。除以梯度自己的大小,结果才和梯度的尺度无关。
- 为什么分母是两个范数之和:对称(两者互换结果不变),而且只要有一个不是 0 就不会除以 0。它的取值在 [0, 1]:0 是完全相同,1 是方向相反或者其中一个为 0。
- 经验阈值( 时):约 1e−7 或更小,很好;约 1e−5,大概没问题,但值得再看看;约 1e−3 或更大,很可能有 bug。
这些阈值从哪里来?§4.2 说明,一个正确的实现用 float64、,误差主要是舍入误差,通常在 1e−10 到 1e−7 之间。而一个真正的 bug 通常让某些分量错一个”量级为 1”的比例(漏了一项、多乘了 2、用错了变量),相对误差在 1e−2 以上(演示 2 的四个 bug 是 6.2e−2 到 0.77)。中间地带(1e−5 到 1e−3)可能是只影响少数分量的小 bug,也可能是 ReLU 折点之类的数值问题(第 4 讲 §4.5),需要具体查看。另外,不同的资料用不同的公式:CS231n 的笔记逐个分量算 ,并指出网络越深误差会越大,它的阈值和这里不能直接对照。阈值是经验值,不是精确的分界线(演示 5 里会看到,梯度本身很小时,正确实现的误差也会偏大)。
4.4 实现:摊平参数,逐个推一下
作业里的实现分三步(gradcheck_tools.py 的同名函数):
dictionary_to_vector:把 摊平拼成一个长向量 ( 个分量);gradients_to_vector用同样的顺序把 拼成 。- 对每个 : 的第 个分量加 , 减 ,用
vector_to_dictionary还原成参数字典,各做一次前向传播算 ,。 - 算相对误差。
第 2 步要做 次前向传播。演示 2 的网络只有 47 个参数,要 94 次;一个 100 万参数的网络要 200 万次,而反向传播只要”一次前向 + 一次反向”。所以 Ng 的第一条建议是:梯度检验只用来调试,不在训练时用。
代码 04 演示 2 仿作业第二部分:网络 [4, 5, 3, 1](LINEAR → RELU → LINEAR → RELU → LINEAR → SIGMOID),3 个样本、4 个特征、随机标签,He 初始化, 取小随机数(避开第 4 讲 §4.5 的折点问题)。反向传播里故意写错几处:
| 反向传播 | 整体误差 | 结论 | ||||||
|---|---|---|---|---|---|---|---|---|
| 正确的实现 | 1.98e−09 | 很好 | 1.1e−08 | 1.5e−08 | 7.7e−09 | 2.1e−08 | 2.7e−09 | 1.4e−10 |
| A:dW2 ×2 且 db1 用 4/m(作业里的两个 bug) | 1.10e−01 | 很可能有 bug | 1.1e−08 | 6.0e−01 | 3.3e−01 | 2.1e−08 | 2.7e−09 | 1.4e−10 |
| B:只有 dW2 ×2 | 6.21e−02 | 很可能有 bug | 1.1e−08 | 1.5e−08 | 3.3e−01 | 2.1e−08 | 2.7e−09 | 1.4e−10 |
| C:只有 db1 用 4/m | 9.18e−02 | 很可能有 bug | 1.1e−08 | 6.0e−01 | 7.7e−09 | 2.1e−08 | 2.7e−09 | 1.4e−10 |
| D:第 2 层漏乘 | 7.73e−01 | 很可能有 bug | 9.4e−01 | 9.5e−01 | 9.4e−01 | 9.5e−01 | 2.7e−09 | 1.4e−10 |
整体误差只告诉你”有 bug”,不告诉你在哪。Ng 的第二条建议:逐个参数地看。
- A 只有 和 出错,bug 就在这两行。再看数值梯度和反向梯度的比值: 处处是 0.5000(极差 2.6e−08), 处处是 0.2500。比值是常数,说明反向梯度被乘了一个常数(2 和 4)。一个”乘了 倍”的 bug,这一块的相对误差恰好是 : 时 1/3 = 0.333, 时 3/5 = 0.600(练习 7)。
- D 是另一种 bug:出错的是 ——第 2 层以及它之前的所有层,比值也不是常数( 的极差 0.54)。从输出层往回看,第一个出错的层就是 bug 所在的地方,更前面的层只是被”传染”了; 正确,说明输出层的反向传播没问题。
4.5 正则项别漏
Ng 的第三条建议:代价里有正则项,梯度里就要有它的梯度。L2 正则化(第 6 讲)的代价是 ,对应的梯度多一项 。代码 04 演示 3(整体相对误差):
| 情形 | λ = 0.01 | λ = 0.1 | λ = 0.7 | λ = 5 | λ = 50 |
|---|---|---|---|---|---|
| 代价和反向都有 L2(正确) | 2.1e−09 | 2.4e−09 | 3.6e−09 | 2.9e−09 | 4.0e−09 |
| 反向传播忘了 L2 项 | 1.2e−02 | 1.1e−01 | 5.5e−01 | 9.1e−01 | 9.9e−01 |
| 梯度检验用的 忘了 L2 项 | 1.2e−02 | 1.1e−01 | 5.5e−01 | 9.1e−01 | 9.9e−01 |
| 正确的 L2 + “dW2 的数据项 ×2”的 bug | 1.8e−01 | 1.7e−01 | 9.6e−02 | 1.7e−02 | 1.7e−03 |
(λ = 0.7 是 Coursera 正则化作业里用的值。)
- 前两种”忘了”是对称的:不管是反向传播里忘了、还是检验用的 里忘了,误差都一样,随 λ 变大。梯度检验检验的是”反向传播算的是不是这个 的梯度”—— 写成什么,梯度就必须是它的梯度。
- 最后一行是一个更隐蔽的陷阱:λ 很大时,正则项的梯度比数据项大得多(λ = 50 时 的大小约是数据项的 174 倍),“数据项 ×2”这个 bug 就被稀释了:从没有正则化时的 1.8e−01 降到 1.7e−03,离”可疑”只差一点。bug 还在,只是看不清了。CS231n 的笔记因此建议:先关掉正则化(λ = 0)单独检验数据项,再单独检验正则项。
4.6 不能和 dropout 一起用
Ng 的第四条建议:梯度检验不能和 dropout 一起用。dropout(第 6 讲)在每次前向传播时随机丢掉一部分隐藏单元,所以 本身是随机的。代码 04 演示 4(网络 [4, 5, 3, 1],20 个样本,隐藏层 inverted dropout,keep_prob = 0.8):
| 情形 | 整体相对误差 | 结论 |
|---|---|---|
| 关掉 dropout(keep_prob = 1) | 5.84e−09 | 很好 |
| dropout 开着,每次算 都重新抽掩码 | 1.00 | 很可能有 bug |
| dropout 开着,所有计算用同一组掩码 | 4.80e−09 | 很好 |
同一组参数,dropout 开着连算 10 次 :最小 0.6354、最大 0.9370、标准差 0.0916(关掉 dropout 时 )。而把一个参数推动 , 只会变 。 和 用的是两个不同的”子网络”,它们的差别比 造成的变化大几百万倍,数值梯度完全是噪声。这不是反向传播错了。
做法:先把 keep_prob 设成 1,跑一次梯度检验,确认没有 dropout 时反向传播是对的,再打开 dropout 训练。如果担心 dropout 本身的反向传播写错(比如忘了乘同一组掩码 、忘了除以 keep_prob),可以像第三行那样固定掩码单独检查——它检验的是”这一组掩码对应的那个子网络”的梯度。
4.7 什么时候检验:两个陷阱的共同教训
Ng 的第五条建议:在随机初始化时做一次梯度检验,训练一段时间后再做一次。他给的理由是:有些实现只在 接近 0 时才是对的,参数变大以后才出错。前面几讲恰好碰到过两个相关的陷阱:
- 第 3 讲代码 02:把 tanh 的导数 错写成 ,在 的初始点上相对误差只有 4.5e−06,按阈值会被放过。
- 第 4 讲 §4.5: 时某个样本的 恰好等于 0,落在 ReLU 的折点上,正确的实现”假失败”了(8.2e−2)。
代码 04 演示 5 把第一个陷阱放到三个不同的检验点上([4, 5, 3, 1],tanh,50 个样本):
| 在哪里做检验 | 隐藏层 | 正确的实现 | 有 bug 的实现() | 结论 |
|---|---|---|---|---|
| 0.01 初始化(刚开始) | 0.009 | 5.1e−08 | 5.1e−08 | 很好 |
| Xavier 初始化(刚开始) | 0.588 | 1.3e−08 | 4.6e−01 | 很可能有 bug |
| Xavier + 训练 2000 步 | 1.971 | 9.4e−08 | 1.0 | 很可能有 bug |
在 0.01 初始化的点上,这个 bug 完全看不出来,和正确的实现几乎一样。原因是隐藏层的 平均只有 0.009,而在 0 附近 , 和 几乎相等:bug 躲在""这个特殊区域里。换成 Xavier 初始化( 约 0.59),同一个 bug 刚初始化就是 0.46;训练 2000 步之后( 约 1.97)是 1.0—— 时 甚至是负数,梯度方向都反了。
两个陷阱方向相反:第 3 讲的是有 bug 的实现在特殊点上看起来是对的,第 4 讲的是正确的实现在特殊点上看起来是错的。共同的教训是:在一个”一般”的点上检验。初始化太小()、( 可能恰好为 0)都是”特殊”的点。所以实践中:用正常的初始化(He / Xavier,而不是 0.01),把 设成小随机数,检验一次;训练一段时间、参数离开初始值以后,再检验一次。
顺便注意表里正确实现的误差:0.01 初始化的点上是 5.1e−08,比 Xavier 点上的 1.3e−08 大。那里的梯度本身很小,舍入误差相对于它就显得大了——这也是”阈值是经验值”的一个例子。
4.8 梯度检验清单
把 Ng 的五条建议和本讲的实验合在一起:
- 只用来调试,不在训练时用: 次前向传播太贵。确认反向传播正确后就关掉它。
- 失败时逐个参数地看:哪几块出错 → bug 在哪一层;比值是不是常数 → 是”乘错了系数”还是”结构性错误”;从输出层往回找第一个出错的层。
- 别忘了正则项: 里有什么,梯度里就要有什么;λ 很大时先关掉正则化单独检验数据项。
- 关掉 dropout(keep_prob = 1);需要时用固定掩码单独检验 dropout。
- 在一般的点上检验,并在训练一段时间后再做一次:别用 0.01 初始化、别让 。
再加三条本讲实验得出的:
- 用 float64, 左右;float32 下正确的实现也通不过。
- 用很少的样本(作业里 3 个):检验的是”公式写得对不对”,不需要大数据,样本少了每次前向更快。
- 梯度检验通过 ≠ 模型对了。它只检验”反向传播算的是不是 的梯度”。如果 本身写错了(比如损失函数用错、标签错位、输入没归一化),梯度检验照样通过。
5. 小结 · Summary
- 输入归一化:减均值、除以标准差,训练集和测试集用同一组 。它不改变模型能表示什么,只改变代价函数的形状:线性回归里 Hessian ,学习率被 卡住(),速度被 拖住,步数约 。代码 01:条件数从 1.58e+05 降到 3.64,步数从 444,615 降到 14;减均值和除以标准差缺一不可;剩下的 来自特征相关。
- 神经网络里,归一化还管着 ReLU 的”折点”:数据离原点远时 90%–100% 的单元一开始就”全开或全关”;标准化让 0.01 到 1 五个学习率都能训练到 95% 以上,原始单位下十个学习率全部停在 0.500。用测试集自己的统计量,离线看不出来(0.989 对 0.991),换个分布就出错(0.984 → 0.833)。
- 梯度消失 / 爆炸:前向和反向都是 个矩阵连乘。每层把均方乘一个增益 ; 略偏离 1,深网里就指数爆炸或消失(,)。
- 方差保持的初始化:。tanh 用 Xavier ;ReLU 砍掉一半,用 He ;反向要 ,Glorot 取折中 ;只按 fan-in 时反向只差一个层宽比(漏斗网络里恰好 1/8 = )。20 层网络里 He + ReLU 前向 0.814、反向 0.944;Xavier + ReLU 前向剩 1.00e−03;0.01 时 1.21e−19;太大的初始化对 tanh 造成反向爆炸(8.40e+08),不是消失。
- 回看第 1 讲:sigmoid 的 1/2000 是真正的梯度消失(RMS() 每层乘约 0.23,sigmoid 的导数补不回来);ReLU 的 1/10 不是——隐藏层之间 RMS() 几乎不变,差距来自矩阵大小和”同向程度”。
- 仿作业:同心圆上全 0 停在 0.500;×10 测试 0.716;He 0.969。0.01 在 3 层网络里就学不动了;加深到 10 层,安全窗口只剩 He 和 Xavier,而且训练途中仍可能整层 ReLU 死掉。
- 初始化只能缓解:宽度有限时”期望不变”不等于”典型值不变”(宽 10、深 50 时中位数 7.50e−08);非线性让递推变成近似;训练开始后保证就失效了。BatchNorm、残差连接、更稳的优化器负责训练全程。
- 梯度检验:双边差分误差 ,单边 ;舍入误差 ,所以误差对 是 U 形,双边最优 , 足够好;float32 下最好也只有 2.9e−05。相对误差 1e−7 / 1e−5 / 1e−3 三档;逐参数看能定位 bug(常数倍 bug 的误差是 );正则项别漏、λ 太大会淹没 bug;关掉 dropout;在一般的点上检验,训练后再检验一次。
6. 常见误区 · Common pitfalls
- “归一化只是为了数值好看,模型学到的东西都一样。” 能表示的函数确实一样,但梯度下降走的路完全不同:同一个线性回归,444,615 步对 14 步;神经网络里还可能直接训练不动(代码 01 演示 3 的”原始”一行)。
- “只除以标准差就够了”或”只减均值就够了”。 两步缺一不可(代码 01 演示 1:815 步和 4,843 步,标准化后 14 步)。神经网络里,没减均值还会让 ReLU 的折点落在数据外面。
- “测试集用它自己的均值和方差标准化。” 离线评估里看不出问题,上线后或者分布一变就出错,逐个样本预测时甚至没法算(§1.6)。 是模型的一部分。
- “初始权重越小越安全。” 只对一个隐藏层成立(第 3 讲)。深网里 0.01 让所有层的梯度都约等于 0(20 层:1e−18 量级;同心圆上 3 层网络就学不动了)。
- “Xavier 和 He 差不多,随便用。” 浅网里差不多(代码 03 演示 2:0.968 对 0.967),深网里不一样:Xavier 用在 ReLU 上每层信号减半,20 层后剩 1/1000(代码 02 演示 2),10 层网络里有一次 15000 步都没启动(代码 03 演示 3)。
- “初始化太大,tanh 只会饱和,造成梯度消失。” 一个隐藏层时是这样;深网里 的连乘会让反向爆炸(代码 02 演示 2:8.40e+08)。
- “‖dW‖ 随层变小,说明有梯度消失。” 不一定。先看每个样本的反向信号 RMS() 有没有逐层按比例缩小;第 1 讲 ReLU 网络的 1/10 主要来自矩阵大小和样本间的抵消(§3.5)。反过来,所有层的 ‖dW‖ 一样大也不代表健康——0.01 初始化时它们一样小(§3.4)。
- “用了 He 初始化,就不会有梯度问题了。” 它只管第 0 步,而且只在期望意义上;窄而深的网络涨落很大,训练途中也可能整层 ReLU 死掉(§3.7)。
- “ε 越小,数值梯度越准。” 舍入误差 会随 变小而变大(§4.2 的 U 形曲线)。float64 下双边差分用 左右;float32 根本不适合做梯度检验。
- “梯度检验通过了,代码就对了。” 它只检验反向传播和 是否一致; 本身错了它管不着。而且在特殊的点上()有 bug 的实现也能通过(§4.7)。
- “梯度检验失败,一定是反向传播错了。” 也可能是:dropout 开着、检验用的 漏了正则项、检验点恰好在 ReLU 折点上、用了 float32。
7. 练习 · Exercises
练习 1(双边 vs 单边,Ng 的例子)。,,。(a) 手算单边差分 和双边差分 ,各自误差多少?(b) 用 §4.1 的泰勒展开预测这两个误差,和 (a) 对比。(c) 把 换成 0.001,误差各变成多少?
参考答案
(a) ,。单边:,误差 0.0301;双边:,误差 0.0001。真值 。
(b) 单边误差 (精确值是 );双边误差 ,对三次多项式恰好精确(更高阶导数都是 0)。
(c) 单边约 (精确值 0.003001),缩小 10 倍;双边 ,缩小 100 倍。这就是 和 。(用 Python 算会看到双边的结果在第 10 位以后有一点舍入误差。)
练习 2(He 里的 2)。(a) 设 的分布关于 0 对称,证明 。(b) Leaky ReLU ()时, 是多少?要让前向方差保持, 应该是多少?(c) Ng 课上用的 时,和 He 的 差多少?
参考答案
(a) 。对称性给出 ,两者之和是 ,所以各占一半。
(b) 。要 ,即 。这正是 He et al. (2015) 论文里对 PReLU / Leaky ReLU 给出的一般形式; 回到 He,(线性)回到 Xavier。
(c) 时 ,只差万分之一,直接用 He 就行。(用一百万个标准正态随机数可以验证:ReLU 时比值约 0.50,Leaky ReLU 时约 0.50005。)
练习 3(条件数)。两个标准化后的特征,相关系数 ,线性回归带偏置 。(a) 写出 Hessian ,求它的三个特征值和条件数。(b) 和 时 各是多少?(c) 用 时, 要比 多走大约几倍的步数?
参考答案
(a) (标准化后 、、均值为 0 所以和偏置的交叉项是 0)。特征值 、、,。
(b) :(代码 01 演示 1 的标准化一行是 3.64,样本相关系数四舍五入的差别);:。
(c) 步数大约和 成正比,多约 倍。特征高度相关时,标准化也救不了多少——这时白化(或者干脆去掉冗余特征)才有用。
练习 4(算出初始化的尺度)。一个手写数字分类网络 layer_dims = [784, 256, 128, 10],隐藏层用 ReLU。(a) 用 He 初始化, 元素的标准差各是多少?(b) 用 Glorot 呢?(c) 如果误用 0.01,第 2 个隐藏层输出的 RMS 大约是输入 RMS 的多少倍(只看 ReLU 隐藏层,用 §3.2 的公式)?
参考答案
(a) ,,。
(b) ,,。
(c) 每层均方增益 :第 1 层 ,第 2 层 。两层后均方乘 ,RMS 乘约 0.022。只过两个隐藏层就缩小了约 45 倍;输出层再乘一次,网络的输出几乎是 0,所有梯度也都很小(代码 03 演示 2 的 0.01 行就是这样学不动的)。
练习 5(先预测再运行:更深的 Xavier + ReLU)。把 02_signal_propagation.py 里的 DEPTH 从 20 改成 50(SHOW_LAYERS 也相应改成 [1, 10, 20, 30, 40, 50])。先预测:Xavier + ReLU 那一行第 50 层的理论 RMS 是多少?He + ReLU 呢?randn + ReLU 会不会出现 inf?再运行验证(约 10 秒)。
参考答案
Xavier + ReLU:每层均方增益 ½,第 层的理论 RMS 是 ,第 50 层 (第 20 层是 ,和表里的理论列一致)。He + ReLU:理论仍是 1,实测在 1 附近随机偏离。randn + ReLU:每层均方乘 128,第 50 层 RMS 理论约 ,均方约 ,仍小于 float64 的上限(约 ),不会溢出;但反向的梯度同样是天文数字。我运行的结果:Xavier + ReLU 第 50 层 3.99e−08,He + ReLU 0.941,randn + ReLU 3.70e+52,没有 inf。(脚本的表头和观察文字会跟着 DEPTH 自动改。)
练习 6(为什么作业里打印 cost = inf)。Coursera 作业用 ×10 初始化时,第 0 步打印出来的 cost 是 inf。(a) float64 里 在 大约多大时会恰好等于 1.0?(b) 我们的 compute_cost 把概率裁剪到 ,每个样本的 loss 最多是多少?(c) 代码 03 演示 1 的初始 cost 是 13.45,大约有多少比例的样本处在”被裁剪”的状态?
参考答案
(a) ,当它小于 float64 在 1 附近能分辨的最小差别( 量级)时, 被舍入成 1.0,也就是 大于约 37。我在 上以 0.01 为步长检查过:用 计算时从 36.74 起恰好等于 1.0,用第 4 讲 deep_nn.sigmoid 的 tanh 写法时从 36.98 起。标签是 0 的样本此时 。
(b) 。
(c) 粗略估计:如果一部分样本的 loss 是 27.6、其余的接近 0,比例约 。实际上还有一些样本的 loss 在 0 到 27.6 之间,所以这只是一个上下都不严格的粗估——它说明”大约一半的样本被非常自信地判错了”。
练习 7(常数倍 bug 的相对误差)。某一块参数的反向梯度被错乘了常数 :。(a) 证明这一块的相对误差(数值梯度精确时)是 。(b) 、、 时各是多少?哪个会被 1e−3 的阈值漏掉?(c) 如果把梯度符号写反()呢?
参考答案
(a) 设 。()。
(b) :1/3 ≈ 0.333;:3/5 = 0.600(代码 04 演示 2 的 0.333 和 0.600 正是这两个数);:,低于 1e−3,只会被判成”可疑”。不过这一块只是整个 的一部分,整体误差还会被其他正确的分量再稀释。
(c) ,相对误差的最大值。
练习 8(先预测再运行:被淹没的 bug)。在 04_gradient_checking.py 的 demo_regularization 里,把 lambdas 改成 [50.0, 500.0, 5000.0]。先预测:“正确的 L2 + dW2 的数据项 ×2”那一行的整体误差会怎样随 λ 变化?λ = 500 时按 Ng 的阈值会被判成什么?再运行验证。
参考答案
λ 很大时, 几乎全是正则项 ,bug 造成的偏差(数据项那一份)相对它越来越小,误差大约和 成正比:λ = 50 时 1.7e−03,预测 λ = 500 时约 1.7e−04、λ = 5000 时约 1.7e−05。我运行的结果正是 1.68e−04 和 1.68e−05,按阈值被判成”可疑”,离”大概没问题”只差一点——一个真实存在的 bug 差点蒙混过关。另外你会看到 、 这些没有正则化的参数,误差也从 1e−9 涨到了 1e−6 量级: 被巨大的正则项撑大,舍入误差 跟着变大(§4.2)。这就是为什么要在 λ = 0 时先检验。
练习 9(思考:BatchNorm 的伏笔)。§1.6 说测试时要用训练集的 。第 9 讲的 Batch Normalization 在训练时对每个 mini-batch 用这一批数据自己的均值和方差做标准化。(a) 测试时一次只来一个样本,它该怎么办?(b) 结合代码 01 演示 4 的最后一行,说说如果测试时也用”这一批自己的统计量”会怎样。
参考答案
(a) 和输入归一化一样:用训练时积累下来的统计量(BatchNorm 用训练过程中各个 mini-batch 均值和方差的指数加权平均,第 8、9 讲),而不是测试时现算。
(b) 一个样本的”均值”就是它自己、方差是 0,标准化后变成 0 向量,网络对所有输入给出同一个输出(演示 4:准确率 0.500)。即使一批有多个样本,预测结果也会依赖”这一批里还有谁”,同一个样本放在不同的批里得到不同的预测——这在部署时是不可接受的。所以 BatchNorm 在训练和测试时的行为必须不同,这是第 9 讲的一个重点。
8. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C2M1 “Practical Aspects of Deep Learning”(Andrew Ng):Normalizing Inputs、Vanishing / Exploding Gradients、Weight Initialization for Deep Networks、Numerical Approximation of Gradients、Gradient Checking、Gradient Checking Implementation Notes;编程作业 Initialization、Gradient Checking。
- Katanforoosh & Kunin, Initializing neural networks(deeplearning.ai 的 AI Notes,2019):CS230 讲师写的交互式文章,可以拖动滑块看不同初始化下各层激活值的分布,并给出 Xavier 初始化的推导。
- Stanford CS231n 课程笔记 Neural Networks Part 2: Setting up the Data and the Loss(数据预处理、权重初始化)和 Part 3: Learning and Evaluation(梯度检验的实战注意事项:相对误差、双精度、折点、正则项、dropout)。
论文
- LeCun, Bottou, Orr & Müller (1998). Efficient BackProp. In Neural Networks: Tricks of the Trade. ——输入归一化(减均值、尺度一致、去相关)的 Hessian 分析,以及 的权重尺度。
- Bengio, Simard & Frasconi (1994). Learning long-term dependencies with gradient descent is difficult. IEEE Transactions on Neural Networks. ——梯度消失 / 爆炸的早期分析(在循环网络里)。
- Glorot & Bengio (2010). Understanding the difficulty of training deep feedforward neural networks. AISTATS. ——Xavier / Glorot 初始化,前向与反向的方差分析。
- He, Zhang, Ren & Sun (2015). Delving deep into rectifiers: Surpassing human-level performance on ImageNet classification. ICCV. ——He 初始化(以及 PReLU)。
- Saxe, McClelland & Ganguli (2014). Exact solutions to the nonlinear dynamics of learning in deep linear neural networks. ICLR. ——线性深网的学习动力学与正交初始化。
- Hanin (2018). Which neural net architectures give rise to exploding and vanishing gradients? NeurIPS;Hanin & Rolnick (2018). How to start training: The effect of initialization and architecture. NeurIPS. ——有限宽度时的涨落与 。
- Mishkin & Matas (2016). All you need is a good init. ICLR. ——LSUV 初始化。
- Zhang, Dauphin & Ma (2019). Fixup initialization: Residual learning without normalization. ICLR.
数值计算
- Nocedal & Wright, Numerical Optimization(第 2 版,2006),第 8 章 “Calculating Derivatives”:有限差分的截断误差与舍入误差、步长的选择。
- Goodfellow, Bengio & Courville (2016). Deep Learning,§8.4(参数初始化策略)和 §11.5(调试策略,包括梯度检验)。
9. 下一讲预告 · Next lecture
第 8 讲:优化算法——mini-batch、动量、RMSprop、Adam 与学习率调度。 这一讲在”起点”上下功夫:把输入归一化、把权重的初始尺度调对、确认梯度算对了。第 8 讲在”怎么走”上下功夫:
- 每一步不必用全部 个样本:mini-batch 梯度下降,以及 batch 大小的取舍;
- §1.4 那只”狭长的碗”里,梯度下降来回震荡。Momentum 用梯度的指数加权平均把震荡方向平均掉;RMSprop 给每个参数单独缩放步长,相当于在优化器里做”归一化”;Adam 把两者结合起来(第 1 讲
tiny_nn.Adam的黑盒会在那里拆开); - 学习率衰减,以及为什么高维空间里真正的麻烦是鞍点和平台,而不是局部最优——代码 03 里 0.01 初始化”停在全 0 旁边”的那个点,就是一个鞍点。