对应 Maps to:Coursera Deep Learning Specialization C2M1 “Practical Aspects of Deep Learning” 的前半部分(Train / Dev / Test Sets、Bias / Variance、Basic Recipe for Machine Learning、Regularization、Why Regularization Reduces Overfitting?、Dropout Regularization、Understanding Dropout、Other Regularization Methods);编程作业 “Regularization”(法国队守门员开球的二维数据,3 层网络,比较不加正则化 / L2 / dropout)。在 Stanford CS230 Fall 2025 的安排里,C2M1 在第 4 周(和课堂 Lecture 4 同一周);同期的 TA Section 4 题为 “Xavier Initialization and Regularization”,其中初始化的部分放在第 7 讲。 依据说明:Coursera 的视频和编程作业只对注册学员开放,Section 4 的材料不公开。本讲依据 Andrew Ng 在 C2M1 里广为人知的内容来写:数据划分的比例、四种 bias / variance 情形的例子、basic recipe 的流程、L2 正则化和 inverted dropout 的公式与实现、“为什么有效”的直觉、数据增强与 early stopping 的讨论。视频里的具体措辞是凭记忆复述的,细节可能和原视频略有出入。原作业的数据文件不公开,代码里合成了一个相似的二维数据集(
field_data.py),所以数字和原作业不同;文中提到的原作业结果来自广为流传的作业预期输出,这里无法复现核对。dropout、early stopping、double descent 等内容依据原始论文(§10)。 配套代码 Code:code/lecture06/(numpy;核心模块regularization.py+ 数据模块field_data.py+ 画图工具curves.py+ 5 个脚本;01 约 5 秒,02 约 40 秒,03 约 1 分钟,04、05 各约 50 秒) 预计阅读时间:3–3.5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说清训练集(train)、开发集(dev)、测试集(test)各自的用途;解释为什么小数据时用 60/20/20、百万级数据时 98/1/1 就够——dev / test 的大小由”要分辨多大的差别”决定,而不是由比例决定;知道 dev 和 test 为什么必须来自同一个分布,以及”只有 dev、没有 test”意味着什么。
- 只看两个数字(训练误差和 dev 误差)就诊断出 high bias / high variance / 两者都有 / 两者都没有,并且知道诊断的参照是 Bayes 错误率而不是 0。
- 按 Andrew Ng 的 basic recipe 选择下一步:先治 bias(更大的网络、训练更久、换架构),再治 variance(更多数据、正则化、换架构);解释为什么深度学习时代的 bias–variance trade-off “没那么 trade”。
- 写出 L2 正则化的 cost 和梯度(Frobenius 范数),解释它为什么叫 weight decay、为什么能减少过拟合(两个直觉),以及调试时为什么 cost 曲线要包含正则项。
- 从零实现 inverted dropout(蒙版存进 cache、除以 keep_prob),说清测试时为什么不用 dropout、“除以 keep_prob”解决了什么问题、dropout 为什么有效、为什么它让 cost 曲线不再单调。
- 了解另外两种正则化——数据增强和 early stopping,以及 early stopping 和”正交化”的冲突。
- 面对一个过拟合的模型(比如第 5 讲 32×32 的白天 / 黑夜网络),能设计一组对照实验来决定用哪种正则化,而不是凭感觉。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面几讲再展开 Previewed only |
|---|---|
第 1 讲:训练循环;第 1 讲 tiny_nn.train 里的 weight_decay 和 keep_best(当时当作黑盒) | 输入归一化、梯度消失 / 爆炸、He / Xavier 初始化、梯度检验的系统讲解(第 7 讲) |
| 第 3 讲:花朵 / 同心圆数据,Bayes 最优分类器(§8.2),隐藏单元数与过拟合的苗头(§8.4) | mini-batch、Adam(第 8 讲;本讲有几个实验借用第 1 讲的 Adam);AdamW |
第 4 讲: 层网络的积木 deep_nn.py(本讲的模块就建在它上面);参数 vs 超参数 | 超参数怎样系统地搜索、Batch Norm 的正则化效果(第 9 讲) |
| 第 5 讲:白天 / 黑夜案例,32×32 网络的过拟合(§2.4) | human-level performance、avoidable bias、数据不匹配与 train-dev set、正交化(第 10 讲) |
本讲把前几讲里反复出现、却一直没有展开的现象系统化:第 1 讲代码 03 里大网络在小数据时垫底、逻辑回归在大数据时饱和;第 2 讲 §9.3 位置一抖动,线性模板就既欠拟合又过拟合;第 3 讲 §8.4 里 80 个训练样本时 的网络训练 1.000、测试 0.821;第 5 讲 §2.4 里 32×32 的网络训练 0.966、测试 0.869。这些都是同一件事的不同侧面:训练误差和”新数据上的误差”之间的关系。
0.3 本讲地图 Map
§1  训练 / 开发 / 测试集:各管什么;dev 要多大;为什么同分布;没有 test 会怎样   ← 代码 01
§2  偏差与方差:两个数字、Bayes 错误率、四个象限                                ← 代码 02 演示 1、3
§3  basic recipe:对症下药;trade-off 为什么不再那么 trade;一点现代视角          ← 代码 02 演示 2
§4  L2 正则化:公式、weight decay、仿原作业、λ 扫描、为什么有效、cost 曲线       ← regularization.py、代码 03
§5  dropout:inverted dropout、测试时、为什么有效、实践细节                     ← regularization.py、代码 04
§6  其他正则化方法:数据增强、early stopping 与正交化;救第 5 讲的 32×32 网络     ← 代码 05
§7–11  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 | 代码里 |
|---|---|---|
| train / dev / test error | 训练集 / 开发集 / 测试集上的错误率(本讲的表格大多报告错误率,和 Ng 讲 bias / variance 时一致) | error_rate |
| Bayes error | Bayes 错误率(最优误差):任何分类器都不可能低于它;我们的合成数据可以算出来 | bayes_error、bayes_accuracy |
| L2 正则化的强度(regularization parameter),一个超参数 | lambd(lambda 是 Python 的保留字) | |
| 第 层权重矩阵的 Frobenius 范数的平方(所有元素的平方和) | frobenius_sq 求的是所有层之和 ,表格里写作 Σ‖W‖² | |
| keep_prob | dropout 时每个单元被保留的概率(不是丢掉的概率) | keep_prob |
| 第 层的 dropout 蒙版(mask),和 同形状,元素是 0 / 1(True / False) | cache 里的 D |
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出(固定随机种子;每个演示用自己的随机数生成器;同一台机器上重复运行逐字相同;本讲没有计时类的数字)。数据都是合成的:足球场数据仿原作业、花朵和同心圆来自第 3 讲、白天 / 黑夜照片来自第 5 讲,“真相”由我们写下的公式决定,所以能算出 Bayes 错误率。好几处结果和我写代码前的预想不一样——最明显的是:在足球场数据上 L2 比 dropout 好得多,在”花朵 + 噪声特征”上正好相反——讲义按实际结果来写,这些情况列在代码 README 的”关于实验结果”里。
1. 训练 / 开发 / 测试集 · Train / dev / test sets
1.1 应用深度学习是一个高度迭代的过程
C2 这门课一开头,Andrew Ng 先泼了一盆冷水:开始一个新项目时,你不可能一次就猜对网络有几层、每层几个单元、学习率多大、用什么激活函数。即使是在某个领域(比如自然语言处理)做了很多年的人,到了另一个领域(计算机视觉、语音、广告、搜索、安全、物流……)也常常发现自己的直觉不太管用——最好的超参数和数据量、输入特征、硬件都有关系。
所以实际的工作方式是第 1 讲 §4.5 的循环:Idea → Code → Experiment,一圈一圈地转。转得快不快,很大程度上取决于你能多快、多可靠地判断一个想法是好是坏。这就是数据划分要解决的问题。
1.2 三份数据各管什么
| 数据 | 用来做什么 | 别名 | 不能用来做什么 |
|---|---|---|---|
| 训练集 train | 用梯度下降拟合参数 | 评估泛化能力(模型见过它) | |
| 开发集 dev | 在多个模型 / 超参数之间做选择:哪个 λ、多少层、什么时候停 | hold-out cross-validation set、validation set(验证集) | 报告最终成绩(你按它挑过东西,它已经”被用过了”) |
| 测试集 test | 在一切选择都做完之后,给最终系统一个无偏的成绩 | 做任何选择(一旦按它挑了什么,它就变成了第二个 dev 集) |
“dev”是 development 的缩写:它是你在开发过程中天天看的那份数据。第 4 讲代码 05 里”用同一份 dev 既挑学习率又报成绩会偏乐观”、第 1 讲 tiny_nn.train 的注释里”被用来挑最好一步的验证集,就不能再用来报告最终成绩”,说的都是这张表的最后一列。§1.5 会量一量”偏乐观”到底有多少。
1.3 比例:从 60/20/20 到 98/1/1
机器学习的”老规矩”是 70/30(训练 / 测试)或 60/20/20(训练 / dev / 测试)。Ng 说这在数据只有 100、1,000、10,000 个样本时依然合理。但在大数据时代,比如有 100 万个样本,拿出 20 万个做 dev 就太浪费了:dev 只需要大到能分辨你在比较的几个模型,1 万个通常就够,于是划分变成 98/1/1;数据再多,可以是 99.5/0.25/0.25。
为什么”1 万个就够”?先想一想:一个准确率在 90% 左右的模型,用 个样本估计它的准确率,估计值会在真值附近抖动多少?
每个样本”答对 / 答错”是一次抛硬币, 个样本的平均值的标准差是
它只和样本数 有关,和总数据量、和划分比例都无关。代码 01 演示 1 用第 3 讲的花朵数据训练了 20 个不同的小网络(隐藏单元 3–50 × 2 个种子),再生成 20 万个新样本当作”整个真实世界”,每个模型在这 20 万个点上的准确率就是它的”真实准确率”。然后从这 20 万个点里反复抽 dev 集,看估计值抖动多少:
| dev 样本数 | 模型 A 的 dev 准确率的标准差(实测) | 公式 | dev 上 A 胜过 B 的比例 |
|---|---|---|---|
| 100 | 0.0253 | 0.0267 | 0.641 |
| 1,000 | 0.0081 | 0.0084 | 0.885 |
| 10,000 | 0.0026 | 0.0027 | 1.000 |
| 100,000 | 0.0008 | 0.0008 | 1.000 |
(A = 真实准确率最高的模型,0.9228;B = 真实准确率比它低 0.0053 的模型,0.9174。每种大小随机抽 400 次。)
- 实测和公式几乎一样:估计的误差约为 量级。
- 两个模型只差半个百分点时,100 个样本的 dev 集只有 64% 的机会挑对(50% 就是抛硬币),1,000 个时 88%,10,000 个时每次都挑对。
所以 dev 集要多大,取决于你关心多小的差别。把这个换算到两种划分方式上(准确率 0.9 时的 95% 误差范围 ±1.96·SE):
| 总数据量 | 60/20/20 的 dev | 误差范围 | 98/1/1 的 dev | 误差范围 |
|---|---|---|---|---|
| 1,000 | 200 | ±4.16% | 10 | ±18.59% |
| 10,000 | 2,000 | ±1.31% | 100 | ±5.88% |
| 1,000,000 | 200,000 | ±0.13% | 10,000 | ±0.59% |
| 10,000,000 | 2,000,000 | ±0.04% | 100,000 | ±0.19% |
100 万个样本时,98/1/1 的 dev 已经能分辨 0.6 个百分点的差别;多给 dev 的 19 万个样本拿去训练更划算。反过来,1,000 个样本时套用 98/1/1,dev 只有 10 个样本,几乎什么都分辨不了。比例是结果,不是原则。测试集的道理一样:它只需要大到让你对最终系统的成绩有足够的信心。
一个细节:两个模型在同一份 dev 集上比较时,它们在大多数样本上同对同错,真正决定胜负的只是”意见不同”的那一小部分样本。这种配对比较(paired comparison)比”两个独立估计相减”更灵敏,所以上表”A 胜过 B”的比例比单看标准差估计的要好一些。
本讲后面的实验都按这个原则定数据大小:足球场数据的 dev 集 2,000 个、测试集 5,000 个(原作业的测试集只有 200 个,按上表第一行,误差范围约 ±4%,不足以分辨 L2 和 dropout 之间一两个百分点的差别)。
1.4 dev 和 test 必须来自同一个分布
Ng 举的例子:你做一个”上传照片、识别猫”的 app。训练数据是从网上爬来的猫图——构图好、分辨率高;而 dev / test 来自用户用手机拍的照片——模糊、光线差。这时训练集和 dev / test 分布不同(mismatched train/test distribution),这在今天的深度学习里非常普遍,因为能大量获取的数据往往不是你最终要处理的数据。Ng 给的规则是:
dev 和 test 要来自同一个分布——而且是你将来真正要在上面表现好的那个分布。训练集可以来自别的分布。
为什么?dev 集是你的”靶子”:你接下来几个月的每一次改进,都是在让 dev 上的数字变好。如果 test 来自另一个分布,你很可能瞄了几个月的是另一个靶子。代码 01 演示 3 还是用那 20 个模型,在三种情形下”按 dev 挑模型、看它在 test 的分布上表现如何”(dev 集 2000 个样本,重复 1000 次取平均):
| 情形 | dev 分布上的准确率范围 | 按 dev 挑中的模型在 test 分布上 | test 分布上最好的模型 | 差距 |
|---|---|---|---|---|
| 同分布:dev、test 都来自下半场 | 0.8914–0.9260 | 0.9253 | 0.9260 | 0.0007 |
| dev 来自上半场,test 来自下半场 | 0.8799–0.9263 | 0.9028 | 0.9260 | 0.0232 |
| dev 来自外圈(容易),test 来自内圈(难) | 0.9400–0.9716 | 0.8062 | 0.8245 | 0.0183 |
(“上半场 / 下半场”:花朵数据里 / 的点;“外圈 / 内圈”:离原点的距离 ≥ 2 / < 2。)
- 同分布时,按 dev 挑出的模型几乎就是 test 上最好的(只差 0.0007)。
- dev 来自上半场、test 来自下半场:两个”地区”难度差不多(准确率范围几乎一样),但”哪个模型最好”不一样——在上半场真实准确率最高的模型,在下半场的 20 个模型里排第 18。差距变成同分布时的 33 倍。Ng 在讲机器学习策略时(本讲义第 10 讲)举过一个类似的例子:dev 用美国、英国、欧洲等地区的数据,test 用印度、亚洲其他地区、澳大利亚的数据。
- dev 来自容易的外圈:有 11 个模型在外圈上的真实准确率并列第一,dev 集分不出它们,而它们在真正关心的内圈上从 0.7874 到 0.8245 不等。dev 用”清晰的专业照片”、用户上传”模糊的手机照片”,就是这种情况。
如果训练集和 dev / test 不得不来自不同的分布,怎么判断问题出在”分布不同”还是”过拟合”?那需要再切出一份 train-dev 集,是第 10 讲”数据不匹配”的内容。
1.5 没有测试集行不行?
Ng 的回答是:可以,如果你不需要一个无偏的最终成绩。很多团队只有 train 和 dev,在 dev 上迭代、在 dev 上挑模型。但他提醒了一个常见的说法问题:有人把这份数据叫做”test set”,可它实际上是被用来做选择的 dev set。那么,“在 dev 上挑最好的、再报告它的 dev 分数”到底偏乐观多少?
代码 01 演示 2:20 个模型,每次随机抽一份 dev 集,挑出 dev 上最好的那个,记下它的 dev 准确率(“报告的成绩”)和它的真实准确率;再另抽一份没参与挑选的 test 集估计一次。重复 1000 次取平均:
| dev 样本数 | 报告的 dev 准确率 | 它的真实准确率 | 高估 | 比最好的模型差 | 另抽一份 test 的估计 − 真值 |
|---|---|---|---|---|---|
| 100 | 0.9356 | 0.9142 | 0.0214 | 0.0086 | −0.0004 |
| 500 | 0.9255 | 0.9191 | 0.0064 | 0.0037 | 0.0001 |
| 2,000 | 0.9235 | 0.9219 | 0.0016 | 0.0008 | −0.0001 |
| 10,000 | 0.9228 | 0.9227 | 0.0002 | 0.0001 | −0.0000 |
- 20 个模型的真实准确率都在 0.8874–0.9228 之间,可是 dev 集只有 100 个时,“挑出来的最好的那个”平均报告 0.9356,比任何一个模型的真实准确率都高。你挑的恰恰是在这份 dev 上运气最好的那个——这叫赢家的诅咒(winner’s curse)。
- 一份没参与挑选的 test 集给出的估计没有偏差(最后一列在 0 附近)。这就是测试集存在的意义:它是对最终系统的无偏估计(unbiased estimate)。
- dev 越大,高估越小;10,000 个时几乎可以忽略。
所以”只有 dev、没有 test”在 dev 很大、候选不多时问题不大;在 dev 小、候选多(比如扫了几百组超参数)时,dev 上的分数会明显偏高。第 4 讲代码 05 演示 4 已经提醒过这一点,这里把它量了出来。
2. 偏差与方差 · Bias & variance
2.1 二维图上的直觉
Ng 用三张二维分类图引入这两个词:一条直线去分一个需要弯曲边界的数据集(欠拟合);一条适度弯曲的曲线(刚好);一条为了把每个训练点都分对而扭来扭去的曲线(过拟合)。这三种样子你在前几讲和本讲的图里都见过:
| 样子 | 本讲义里的例子 | |
|---|---|---|
| 欠拟合 underfitting | 一条直线,连训练集都分不好 | 第 3 讲 §1.3:逻辑回归在花朵数据上,训练准确率 0.51 |
| 刚好 just right | 平滑地跟着真实规律走 | §4.4 的图:L2 正则化的网络,几乎和真实分界线重合 |
| 过拟合 overfitting | 为了包住个别噪声点,画出飞地和尖角 | §4.4 的图:不加正则化的网络,下方伸出一条”舌头” |
- high bias(偏差大):模型太简单,连训练数据的规律都抓不住。逻辑回归在花朵数据上(第 3 讲 §1.3)就是这样。
- high variance(方差大):模型太灵活,把训练数据里的偶然细节(噪声)也当成规律记住了,换一批数据就不灵。第 3 讲 §8.4 里 80 个样本、 的网络就是这样。
“偏差”和”方差”这两个词来自统计学里对预测误差的分解:偏差衡量”模型的平均预测离真相有多远”,方差衡量”换一份训练集,模型会变多少”。在高维的真实问题里,我们画不出决策边界,所以需要一个不用画图的诊断方法。
2.2 两个数字:训练误差和 dev 误差
Ng 的方法只看两个数:训练误差(反映模型在见过的数据上学得怎样)和 dev 误差(反映在没见过的数据上怎样)。他举了四个例子(假设人几乎不会认错猫,即最优误差约 0%,并且训练集和 dev 集来自同一个分布):
| 训练误差 | dev 误差 | 诊断 | 读法 |
|---|---|---|---|
| 1% | 11% | high variance | 训练集上很好,dev 上差了一大截:过拟合 |
| 15% | 16% | high bias | 训练集上就不好(比最优误差高 15 个点),dev 只比它差一点:欠拟合 |
| 15% | 30% | 两者都有 | 训练集上不好,dev 上更差 |
| 0.5% | 1% | 两者都没有 | 好模型 |
规则可以写成两个差值:
哪个大就先治哪个。注意这里没有一个”多少算大”的统一门槛:它取决于你的目标,也取决于两个差值谁更大(代码 02 为了打印诊断用了 3 个百分点的门槛,那只是一个教学约定)。
2.3 参照物:Bayes 错误率
上面的四个例子都假设”最优误差约 0%“。如果图片本身就很模糊,模糊到人也只能认对 85%,那么”训练 15% / dev 16%“就不是 high bias,而是已经接近天花板了。任何模型在这个任务上都不可能低于的那个误差,叫 Bayes 错误率(Bayes error,最优误差)——第 1 讲 §2.1 里”任何模型都消不掉的噪声”、第 3 讲 §8.2 里”Bayes 最优分类器”,说的都是它。
代码 02 演示 3 用第 3 讲的同心圆数据(两圈间距 0.5、噪声 0.3,很多点本来就落在对方的地盘里)展示参照物选错的后果:
| 网络 | 训练误差 | dev 误差 | 以为最优误差 = 0 时的诊断 | 以 Bayes 错误率为参照 |
|---|---|---|---|---|
| [2, 8, 1] | 0.2166 | 0.2194 | high bias | 两者都没有 |
| [2, 64, 64, 1] | 0.2197 | 0.2240 | high bias | 两者都没有 |
| [2, 256, 256, 1] | 0.2407 | 0.2460 | high bias | 两者都没有 |
同心圆的 Bayes 错误率约 0.2144。如果你以为最优误差是 0,22% 的训练误差看起来是严重的 high bias,basic recipe(§3)会让你去加大网络——表里加大了两次,一点没好,最大的那个还更差了一点(它的训练误差也更高,看起来是同样的 6000 步 Adam 没把这么大的网络训练好)。以 Bayes 错误率为参照,[2, 8, 1] 的训练误差只比它高 0.0022:模型已经到顶了,要再进步只能换更有信息量的输入。
真实任务里不知道 Bayes 错误率,常用”人类水平”(human-level performance)来估计它,“训练误差 − 人类水平”叫 avoidable bias(可避免的偏差)。这是第 10 讲的主题;本讲的合成数据都能直接算出 Bayes 错误率,所以可以先用它当尺子。
2.4 实验:同一个任务上的四个象限
能不能在同一个任务上把四种情况都造出来?代码 02 演示 1 用第 3 讲的花朵数据(Bayes 错误率约 5.6%),但给每个样本附加 8 个纯噪声特征:输入变成 10 维,只有 2 维有用——模拟真实数据里”输入很多、真正有用的很少”(一张图片里大部分像素和标签无关)。然后在”小网络 / 大网络”ד200 / 50,000 个训练样本”上各训练一次:
| 模型 / 训练样本数 | 训练误差 | dev 误差 | 训练 − Bayes | dev − 训练 | 诊断 |
|---|---|---|---|---|---|
| 小网络 [10, 2, 1],50,000 个样本 | 0.3366 | 0.3392 | 0.2806 | 0.0026 | high bias |
| 大网络 [10, 64, 64, 1],200 个样本 | 0.0000 | 0.4180 | −0.0560 | 0.4180 | high variance |
| 小网络,200 个样本 | 0.2950 | 0.4698 | 0.2390 | 0.1748 | 两者都有 |
| 大网络,50,000 个样本 | 0.0616 | 0.0734 | 0.0057 | 0.0118 | 两者都没有 |
- 小网络 + 大量数据 → high bias:2 个隐藏单元画不出花朵的 6 个扇形(第 3 讲:至少要 3 个),训练和 dev 一样差。
- 大网络 + 很少数据 → high variance:4,929 个参数对 200 个样本,训练误差 0——连标签噪声都背下来了(训练误差比 Bayes 错误率还低,本身就是过拟合的信号),dev 误差 0.4180。
- 小网络 + 很少数据 → 两者都有:没学会花朵的形状(bias),却用噪声特征记住了一部分训练点(variance)。Ng 画过一条”大部分地方是直线、个别地方为了几个点急转弯”的紫色边界来说明这种情况;在高维输入里,“有的方向太简单、有的方向太灵活”的模型并不少见。
- 大网络 + 大量数据 → 两者都没有:离 Bayes 只差 0.0174。想要它,需要足够大的模型和足够多的数据。
同一个任务、同一个训练程序,四种诊断完全不同。“下一步该做什么”取决于诊断,而不是取决于任务。
2.5 回头看前几讲
有了这套语言,前几讲里的几个现象可以重新读一遍:
| 前文 | 训练 / 测试 | 诊断 |
|---|---|---|
| 第 1 讲代码 03:逻辑回归从 起停在 0.834 | 训练、测试都停在一个水平 | high bias(模型表达不了老师网络) |
| 第 1 讲代码 03:大网络在 –300 时垫底 | 18,049 个参数对 240 个训练样本 | high variance |
| 第 2 讲 §9.3:抖动 ±2 以上,线性模板连训练集都只有 0.87–0.90,测试差得更多 | 两者都有 | |
| 第 3 讲 §8.4:80 个样本, 训练 1.000、测试 0.821 | 训练比 Bayes(0.9500)还准 | high variance |
| 第 4 讲代码 04:条纹图像 3,000 个样本时两种网络都只会背 | 训练近乎全对,测试约 0.5 | high variance(数据是瓶颈) |
| 第 5 讲 §2.4:32×32 网络训练 0.966、测试 0.869 | high variance(§6.4 会救它) |
3. 机器学习的基本配方 · Basic recipe for machine learning
3.1 流程
Ng 把诊断之后”该做什么”总结成一个流程(他称之为 basic recipe):
                ┌──────────────────────────────────────────────┐
                ↓                                              │
     high bias?(看训练集表现)  ── 是 ──→  更大的网络(更多单元 / 更多层)
                │                          训练更久 / 更好的优化算法(第 8 讲)
                │ 否                        (换一种网络架构)
                ↓
     high variance?(看 dev 集表现) ── 是 ──→  更多数据
                │                          正则化(L2、dropout、数据增强……,§4–§6)
                │ 否                        (换一种网络架构)  ──→ 回到第一步
                ↓
              完成
两个要点:
- 先看 bias,再看 variance。连训练集都没学好时,加数据、加正则化都没用;先让模型至少能拟合训练集。
- 药要对症。high bias 时加数据是白费功夫(数据很贵);high variance 时加大网络也不解决问题。“换架构”在两边都出现,因为一个更合适的架构(比如图像用卷积,第 12 讲)可能同时降低两者,但它不像前几项那样系统,要靠试。
3.2 实验:对症下药
代码 02 演示 2 拿演示 1 里两个”有病”的模型,把每一种药都试一遍:
【A】high bias 的模型(小网络 [10, 2, 1],50,000 个样本,Bayes 0.0560):
| 做法 | 训练误差 | dev 误差 | 诊断 |
|---|---|---|---|
| (起点) | 0.3366 | 0.3392 | high bias |
| 训练久一倍(12,000 步) | 0.3272 | 0.3312 | high bias |
| 数据多 4 倍(200,000 个样本) | 0.3372 | 0.3482 | high bias |
| 网络加大到 [10, 3, 1] | 0.0812 | 0.0824 | 两者都没有 |
| 网络加大到 [10, 8, 1] | 0.0836 | 0.0836 | 两者都没有 |
| 网络加大到 [10, 64, 64, 1] | 0.0616 | 0.0734 | 两者都没有 |
【B】high variance 的模型(大网络 [10, 64, 64, 1],200 个样本):
| 做法 | 训练误差 | dev 误差 | 诊断 |
|---|---|---|---|
| (起点) | 0.0000 | 0.4180 | high variance |
| 网络再加大到 [10, 256, 256, 1] | 0.0000 | 0.3792 | high variance |
| 数据多 5 倍(1,000 个样本) | 0.0000 | 0.1742 | high variance |
| 数据多 25 倍(5,000 个样本) | 0.0000 | 0.1176 | high variance |
| L2,λ = 1 | 0.0000 | 0.3930 | high variance |
| L2,λ = 3 | 0.0050 | 0.3964 | high variance |
| L2,λ = 10 | 0.3900 | 0.4358 | 两者都有 |
| dropout,keep_prob = 0.8 | 0.0000 | 0.3308 | high variance |
| dropout,keep_prob = 0.5 | 0.0000 | 0.2192 | high variance |
| 对照:小网络 [10, 2, 1],200 个样本 | 0.2950 | 0.4698 | 两者都有 |
- 【A】“训练更久”和”加数据”几乎没用,只多 1 个隐藏单元,dev 误差就从 0.3392 掉到 0.0824。模型已经尽力了,它只是表示不了花朵的形状。
- 【B】加大网络治不了过拟合(dev 略好,但训练误差仍是 0、差距仍然巨大)。最有效的是更多数据:5,000 个样本时 dev 0.1176,而训练误差一直是 0——加数据只降 variance,不碰 bias。
- 【B】正则化:dropout 很有效(keep_prob = 0.5 时 dev 0.2192),L2 却几乎没用:λ = 1、3 时训练误差还是 0,λ = 10 时一下子压过了头。这个结果和 §4、§5 的足球场数据正好相反(那里 L2 好、dropout 差)。一个可能的原因是这里的过拟合来自 8 个噪声特征,L2 一视同仁地缩小所有权重,分不清哪些输入有用——这只是猜测,没有专门验证。哪种正则化对你的问题有效,要在 dev 上试。
3.3 为什么深度学习时代的 trade-off 不再那么”trade”
传统机器学习里常说 bias–variance trade-off(偏差–方差权衡):模型简单一点,bias 升、variance 降;复杂一点,反过来。你只能在两者之间找一个平衡点。
表【B】里正好能看到这个经典的 trade-off:200 个样本时,从小网络换成大网络,训练误差从 0.2950 降到 0(bias 降了),dev − 训练的差距却从 0.1748 涨到 0.4180(variance 涨了)。但再加上 dropout,差距回到 0.2192(只比小网络略大),bias 仍然几乎为 0,dev 误差 0.2192,远好于小网络的 0.4698。
Ng 的总结是:在深度学习、大数据的时代,我们有了两个只动一边的工具——
- 更大的网络(配合合适的正则化):几乎总是降低 bias,而不太伤 variance;
- 更多的数据:几乎总是降低 variance,而不伤 bias。
只要这两样你都拿得到,就不必在 bias 和 variance 之间二选一:先用大网络把 bias 压下去,再用数据和正则化把 variance 压下去。这也是为什么 Ng 说”训练一个更大的网络几乎从来不会有坏处(只要正则化得当),主要的代价是计算时间”。这是深度学习在有数据的问题上表现这么好的原因之一。
3.4 一点现代视角
“大网络 + 正则化”的经验,后来的研究又往前推了几步,这里只点到为止:
- 大网络能背下任何东西:Zhang et al. (2017) 发现,常见的图像分类网络能把随机打乱的标签也拟合到训练误差 0。所以”参数多少”本身不能解释为什么它们在真实标签上泛化得好;L2、dropout 这类显式正则化有帮助,但不是好的泛化的全部原因(训练方法本身,比如 SGD,也起作用)。
- double descent(双下降):Belkin et al. (2019)、Nakkiran et al. (2020) 观察到,当模型大到刚好能拟合训练集(“插值阈值”附近)时,测试误差会出现一个峰;模型继续变大,测试误差又降下来。经典的 U 形曲线只是这条曲线的左半边。这和”大网络几乎不伤 variance”的经验是一致的;但峰的位置和高低受数据量、噪声、正则化影响,不是所有设置下都看得到。
对做项目来说,结论仍然是 Ng 的配方:用训练误差和 dev 误差诊断,对症下药。
4. L2 正则化 · L2 regularization
4.1 从逻辑回归开始
high variance 时最直接的药是更多数据,但数据常常很贵或者拿不到。正则化(regularization)是另一条路:在 cost 里加一项,惩罚”过于复杂”的模型。
以逻辑回归为例,L2 正则化把 cost 改成
几个设计选择:
- 只惩罚 ,不惩罚 。 有 个数, 只有一个,加不加对结果几乎没有影响,所以 Ng 通常省掉。
- 是一个超参数(正则化参数),要在 dev 集上调(§4.5)。Python 里
lambda是保留字,Coursera 作业写成lambd。 - 除以 :除以 2 让求导后的系数干净;除以 让正则项和交叉熵( 个样本的平均)同一个尺度。
- L1 正则化 会让 变得稀疏(很多分量恰好为 0),有人用它来压缩模型。Ng 说实践中这点压缩作用不大,L2 用得多得多。
4.2 神经网络:Frobenius 范数
对 层网络,把每一层的权重矩阵都惩罚一遍:
是矩阵所有元素的平方和(§0.4)。线性代数里矩阵的这种范数叫 Frobenius 范数(不叫”矩阵的 L2 范数”,后者另有所指)。代码里就是一行:
def frobenius_sq(parameters):
return float(sum(np.sum(v ** 2) for k, v in parameters.items() if k.startswith("W")))compute_cost_with_regularization(和作业同名)= 第 4 讲的 compute_cost + × 上面这个数。
4.3 反向传播多一项,以及 “weight decay” 这个名字
正则项对 的导数是 ,所以反向传播只要在每层的 上加一项:
regularization.py 的 L_model_backward_reg 里就是一行 grads[f"dW{l}"] = dW + (lambd / m_reg) * W。 不变。代入梯度下降:
每一步先把权重乘以一个略小于 1 的数,再按原来的梯度走一步。所以 L2 正则化又叫 weight decay(权重衰减)。代码 03 演示 2 在 α = 0.3、λ = 0.7、m = 211 时验证了两种写法:衰减系数 ,两种写法更新后的 最大差别在 量级(浮点舍入)。训练过程中权重平方和 Σ‖W‖² 的变化(种子 1):
| 第几步 | 0 | 1,000 | 3,000 | 10,000 | 20,000 | 30,000 |
|---|---|---|---|---|---|---|
| 不加正则化 | 19.6 | 61.3 | 94.4 | 146.7 | 253.9 | 320.6 |
| L2,λ = 0.7 | 19.6 | 29.8 | 36.3 | 36.5 | 36.6 | 36.6 |
不加正则化时权重一路变大:交叉熵总能靠”把 放大、让预测更自信”再降一点(第 2 讲 §4.4:在可分的数据上,交叉熵没有有限的最低点)。加了 L2,衰减的”往里拉”和交叉熵梯度的”往外推”在 36.6 附近达到平衡。
两个和后面几讲有关的注释:
- 第 1 讲
tiny_nn.train的weight_decay参数,就是在梯度里加weight_decay * W,即这里的 。第 5 讲用的weight_decay = 1e-4、,相当于 。 - 用 Adam 这类自适应优化器(第 8 讲)时,“在梯度里加 “和”每步把 乘以一个系数”不再等价:前者会被 Adam 的逐参数缩放改变。Loshchilov & Hutter (2019) 因此提出把两者分开的 AdamW(decoupled weight decay),它是今天训练大模型的标准选择。
4.4 实验:仿原作业
原作业的设定:你是法国足球队请来的 AI 专家,要建议守门员把球开到哪里。数据集里每个点是守门员开球后有球员头球触球的位置,标签是”碰到球的是法国队员还是对方队员”。作业用 3 层网络 [2, 20, 3, 1](ReLU,学习率 0.3,30,000 步普通梯度下降)比较三种做法。
原作业的数据不公开,field_data.py 合成了一个类似的数据集:场地 ,真实分界线 ,线的上方是法国队的”地盘”;分界线附近有一条模糊带(两队都可能抢到球),场上任何地方还有 4% 的”意外”(远离分界线、标签却是另一队)。训练集 211 个点(和原作业一样),dev 集 2,000 个、测试集 5,000 个(§1.3)。因为生成过程是我们写的,Bayes 错误率可以算出来:期望约 0.0675;在这三份具体的数据上,Bayes 最优分类器分别错 0.0521 / 0.0615 / 0.0756(每份数据里”意外点”的多少不同)。
代码 03 演示 1(网络、学习率、步数、Xavier 初始化都照原作业,3 个初始化种子):
| 模型 | 训练误差 | dev 误差 | 测试误差 | Σ‖W‖² | 和真实分界线不一致的面积 |
|---|---|---|---|---|---|
| 不加正则化(3 个种子平均) | 0.0284 | 0.0762 | 0.0920 | 329.9 | 0.0382 |
| L2,λ = 0.7(3 个种子平均) | 0.0490 | 0.0640 | 0.0805 | 37.0 | 0.0249 |
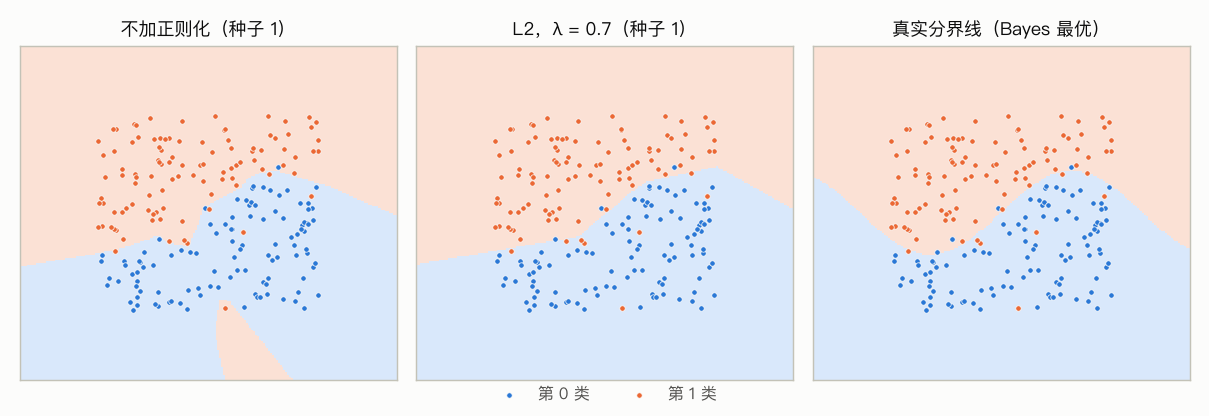
(这张图由 03_l2_regularization.py 生成,对应种子 1;终端里打印的是同样内容的字符画。图里的浅色背景是网络的预测区域。)
- 不加正则化:训练误差 0.0284,比”上帝视角”的 Bayes 分类器在同样 211 个点上的 0.0521 还低——网络背下了一部分”意外点”。图里最明显的是下方伸出的那条”舌头”:为了包住一个落在对方地盘里的训练点,网络把一大片区域划给了法国队。dev 和测试误差都比训练误差高出一截:high variance。
- L2(λ = 0.7):训练误差升到 0.0490,和 Bayes 分类器的 0.0521 差不多,不再死记噪声;dev 误差降到 0.0640、测试误差降到 0.0805;边界平滑,“和真实分界线不一致的面积”从 0.0382 降到 0.0249。权重平方和从 330 降到 37。
- 3 个种子的结论一致。但两者在测试集上只差约 1.2 个百分点——这正是 §1.3 说的,测试集要有几千个点才看得清这样的差别。
作为对照,原作业广为流传的结果是:不加正则化训练约 95%、测试约 91.5%;L2(λ = 0.7)约 94% / 93%;dropout(keep_prob = 0.86)约 93% / 95%。趋势和我们的一样(L2 让训练准确率略降、测试准确率上升),但 dropout 那一行的结论在我们的数据上不成立(§5.6)。
4.5 λ 怎么选:扫描
λ 是一个超参数,要在 dev 上挑。代码 03 演示 3 对 8 个 λ 各训练 3 次(种子 1、2、3),“比最优多错多少”的参照是 Bayes 分类器在训练集上的 0.0521 和在 dev 集上的 0.0615:
| λ | 训练误差 | dev 误差 | 训练 − 最优 | dev − 最优 | Σ‖W‖² |
|---|---|---|---|---|---|
| 0 | 0.0284 | 0.0762 | −0.0237 | 0.0147 | 329.9 |
| 0.03 | 0.0332 | 0.0725 | −0.0190 | 0.0110 | 155.7 |
| 0.1 | 0.0506 | 0.0627 | −0.0016 | 0.0012 | 77.4 |
| 0.3 | 0.0379 | 0.0655 | −0.0142 | 0.0040 | 53.0 |
| 0.7 | 0.0490 | 0.0640 | −0.0032 | 0.0025 | 37.0 |
| 2 | 0.0616 | 0.0835 | 0.0095 | 0.0220 | 16.1 |
| 6 | 0.0632 | 0.0848 | 0.0111 | 0.0233 | 11.8 |
| 25 | 0.4929 | 0.4895 | 0.4408 | 0.4280 | 0.0 |
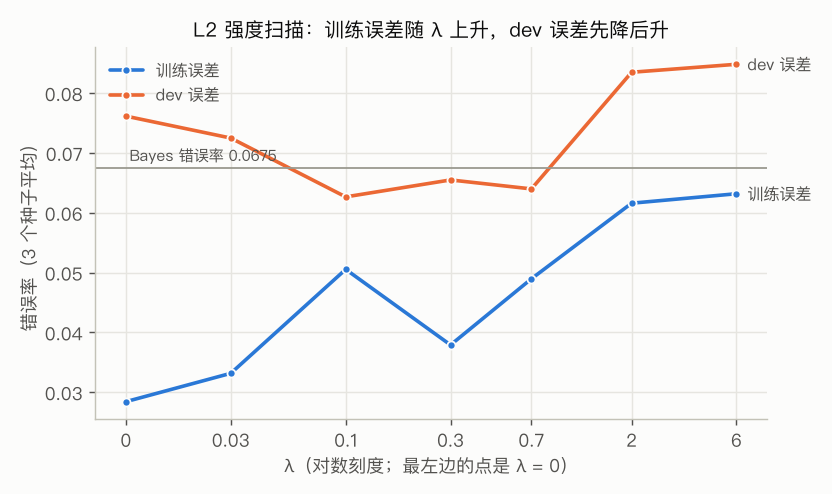
- 训练误差随 λ 大体上升(0.0284 → 0.0632):λ 越大,模型越”不许”用大权重去迁就训练点。(λ = 0.1 和 0.3 之间的起伏是 3 个种子也抹不平的随机波动。)
- dev 误差先降后升:λ = 0 时训练误差比最优还低 0.0237(在背噪声)、dev 多错 0.0147——high variance;λ = 0.1 时两个差值都几乎为 0;λ = 6 时训练误差反过来比最优高 0.0111(边界被压得太平,跟不上那条正弦形的分界线),dev 多错 0.0233——开始 high bias。这就是正则化强度从”variance 一侧”滑到”bias 一侧”的样子。
- λ = 25:权重被压到几乎为 0,网络退化成”永远猜同一类”的常数,训练和 dev 误差都是 0.49 左右。
- 最好的 λ 是一个区间:0.1–0.7 之间 dev 误差相差不到半个百分点,和 dev 集本身的随机误差(2,000 个点约 ±0.5%)差不多。按 dev 选出的是 λ = 0.1;选完以后才在测试集上看一次:测试误差 0.0804(不加正则化 0.0920;Bayes 分类器在这份测试集上 0.0756)。
4.6 为什么 L2 能减少过拟合:两个直觉
Ng 给了两个直觉。
直觉一:λ 很大 → 很多权重接近 0 → 网络像一个小得多的网络。 把 λ 设得非常大,为了让 cost 小, 会被压到接近 0,很多隐藏单元的影响几乎消失,网络退化成一个很简单的模型,从 high variance 一路滑向 high bias。中间存在一个”刚好”的 λ。(Ng 特别说明:实际上并不是把单元”清零”,而是每个单元的影响都变小了。)演示 3 的 λ = 25 就是推过头的极端:网络变成了常数。
直觉二:权重小 → 小 → tanh 工作在近似线性的区域。 设隐藏层用 tanh。λ 大时 小, 也小;而 tanh 在 0 附近几乎是一条直线(,和 0.5 只差 8%)。如果每一层都近似线性,整个网络就近似一个线性函数(第 1 讲 §2.4:线性叠线性还是线性),画不出为了包住几个噪声点而急转弯的边界。
代码 03 演示 4 把这个直觉量化:同一个网络换成 tanh 隐藏层(种子 1),看 λ 增大时三件事怎样变化——第 1 层的 有多少落在 的近似线性区;网络的 logit(sigmoid 之前的值)离”最好的线性函数”有多远(非线性程度 = 1 − R²);logit 对输入的梯度有多大(“坡有多陡”)。
| λ | 训练误差 | dev 误差 | Σ‖W‖² | 的比例 | 非线性程度 | 平均斜率 | 最大斜率 |
|---|---|---|---|---|---|---|---|
| 0 | 0.0332 | 0.0790 | 533.9 | 0.375 | 0.234 | 20.4 | 203.9 |
| 0.1 | 0.0474 | 0.0650 | 90.2 | 0.683 | 0.167 | 13.3 | 54.5 |
| 0.7 | 0.0474 | 0.0670 | 31.4 | 0.964 | 0.088 | 8.0 | 20.6 |
| 6 | 0.0664 | 0.0850 | 12.4 | 1.000 | 0.030 | 5.0 | 8.3 |
- λ 从 0 到 6,第 1 层落在近似线性区的比例从 0.375 升到 1.000,网络整体的非线性程度从 0.234 降到 0.030——直觉二被数字证实了。
- 最大斜率的变化最明显(203.9 → 8.3):不加正则化的网络在某些地方有非常陡的”悬崖”,那正是飞地的边缘。L2 把函数变得平滑:输入挪一点,输出也只变一点。
- 但 λ = 6 时非线性程度还有 0.030,网络并没有变成真正的线性函数。“每一层都线性”是帮助理解的极端情形;L2 做的是连续地把函数往”更简单、更平滑”的方向推,λ 是推的力度。
4.7 调试时,cost 曲线要包含正则项
Ng 的一个实用提醒:用 L2 时,你画来检查”梯度下降是否在下降”的 cost 曲线,要用包含正则项的新 J。如果只画交叉熵那一部分,你可能看不到它单调下降。
代码 03 演示 5 造了一个最容易看出差别的场景:接着演示 1 里过拟合的网络(种子 1,Σ‖W‖² = 320.6)继续训练,同时打开 L2(λ = 2,学习率 0.1,3000 步):
| 第几步 | 完整的 J | 其中:交叉熵 | L2 项 | Σ‖W‖² | 训练误差 |
|---|---|---|---|---|---|
| 0 | 1.5841 | 0.0647 | 1.5194 | 320.6 | 0.0284 |
| 100 | 1.3373 | 0.0660 | 1.2714 | 268.3 | 0.0332 |
| 300 | 0.9848 | 0.0790 | 0.9058 | 191.1 | 0.0332 |
| 1000 | 0.4421 | 0.1219 | 0.3202 | 67.6 | 0.0521 |
| 3000 | 0.2677 | 0.1673 | 0.1004 | 21.2 | 0.0521 |
3000 步里,完整的 J 一步都没有上升;而交叉熵从 0.0647 一路升到 0.1673,3000 步里升了 2866 步。只看交叉熵,你会以为训练出了 bug;其实一切正常——L2 正在用”训练集上的交叉熵变大一点”换”权重小得多”,这正是我们要的取舍。
一个诚实的补充:“J 每一步都应该下降”只在学习率足够小时严格成立。原作业的学习率 0.3 对这个网络来说偏大:即使不加正则化,从头训练时第 914 步以后 J 就开始不规则地上下抖动,30,000 步里有 17,202 步是上升的(每次上升的中位数只有 0.0009,总趋势仍在下降:0.7026 → 0.0647)。所以演示 5 用了 0.1 的学习率;换成 0.3,同样的实验里完整的 J 也有 506 步是上升的(总趋势仍从 1.5841 降到 0.2603)。实用的读法是看整体趋势和”有没有持续上升”,而不是死盯每一步。(大学习率下梯度下降的这种”边振荡边下降”的行为,Cohen et al. (2021) 称之为 edge of stability。)
5. Dropout
5.1 想法:每次随机”关掉”一部分单元
dropout(随机失活)是另一种非常常用的正则化方法,来自 Hinton 等人 2012 年的工作(Srivastava et al., 2014 的期刊论文给出了完整的版本)。想法简单得出奇:
训练时,对每个样本、每一步,让每个隐藏单元以概率 被”关掉”(输出置 0),也就是以 keep_prob 的概率保留。
Ng 的图:一个每层几个单元的网络,每个单元抛一次硬币(比如 keep_prob = 0.5),被抛掉的单元连同它的进出连线一起删掉,剩下一个”瘦身版”的网络,在这一个样本上做前向和反向传播。下一个样本、下一步,再重新抛硬币,删掉另一批单元。于是每一步训练的其实是一个不同的、更小的网络。
5.2 inverted dropout 的实现
Ng 讲的标准实现叫 inverted dropout。以第 3 层为例,keep_prob = 0.8:
d3 = np.random.rand(a3.shape[0], a3.shape[1]) < keep_prob   # 1. 和 a3 同形状的蒙版:每个元素以 0.8 的概率为 True
a3 = np.multiply(a3, d3)                                     # 2. 关掉的单元输出 0
a3 /= keep_prob                                              # 3. 保留下来的放大 1/0.8 倍("inverted")
注意 d3 和 a3 同形状 :每个样本关掉的单元都不一样。反向传播时,用同一个蒙版处理梯度:
前向时被关掉的单元,反向时梯度也是 0(这一步它”不在网络里”,不该被更新);保留下来的单元,梯度也放大同样的倍数。所以蒙版必须存进 cache。regularization.py 里对应的是:
dropout_forward(A, keep_prob, rng):上面的三行,返回(A_out, D);L_model_forward_dropout:逐层调用第 4 讲的linear_activation_forward,每个隐藏层算完激活值以后做一次dropout_forward,把D和keep_prob一起存进 cache(输出层不做 dropout);L_model_backward_reg:第 层收到的 先过dropout_backward(乘以同一个D再除以 keep_prob),再穿过激活函数——顺序和前向正好相反。L2 的那一项也在这里。
一个细节:下一层 linear_forward 存下的 是 dropout 之后的激活值,所以 自动只更新”这一步被保留的单元”连出来的权重。
5.3 为什么要除以 keep_prob
先想一想:如果不做第 3 步,会发生什么?
下一层算的是 。keep_prob = 0.8 时,平均有 20% 的 被置 0, 的期望就变成原来的约 0.8 倍。除以 0.8 恰好补回来:
代码 04 演示 1 拿一个训练好的网络的第 1 层激活值 (形状 (20, 211)),抽 2000 次蒙版(keep_prob = 0.8),看平均值:
| 平均值 / 原值(整体) | 和原值的相对差别 | |
|---|---|---|
| ,除以 keep_prob | 0.9999 | 0.0088 |
| ,不除 | 0.7999 | 0.2001 |
| 下一层 ,除以 keep_prob | — | 0.0126 |
| 下一层 ,不除 | — | 0.2303 |
除以 keep_prob 时,每个激活值和下一层 的期望都不变(剩下的 1% 左右是 2000 次抽样的随机误差);不除时整体变成 keep_prob 倍。
为什么在乎期望不变?因为测试时不做 dropout(§5.4),所有单元都在。只有训练时的平均输入和测试时的输入一样大,下一层在训练中学到的” 大概多大”才在测试时继续成立。inverted dropout 把补偿放在训练时,测试时的代码就和没有 dropout 的网络一模一样。
5.4 测试时:不用 dropout;以及 dropout 在近似什么
测试(预测)时不用 dropout:你不希望同一张图片每次预测的结果都不一样。Ng 指出,如果训练时没有除以 keep_prob(2012 年最初的写法),测试时就必须记得手动补偿(把激活值或下一层的权重乘以 keep_prob,叫 weight scaling)。代码 04 演示 2 看看忘了补偿会怎样(keep_prob = 0.5,两个隐藏层,dev 集):
| 做法 | dev 错误率 | dev 交叉熵 | 平均 |
|---|---|---|---|
| inverted dropout,测试时什么都不做 | 0.0755 | 0.3710 | 0.4234 |
| 不除以 keep_prob 训练,测试时什么都不做 | 0.0755 | 0.6364 | 0.4793 |
| 不除以 keep_prob 训练,测试时权重 × keep_prob | 0.0765 | 0.3157 | 0.4208 |
忘了补偿时,错误率几乎不变(这个网络里激活值整体放大基本不改变 logit 的符号),但预测概率变得过分自信,交叉熵翻了一倍(0.3157 → 0.6364)。如果你要用这个概率做决策(“概率 > 0.9 才报警”),这是一个不报错的真 bug。inverted dropout 让你根本不用操心这件事。
dropout ≈ 集成。 每一步训练一个随机子网络,这些子网络共享同一组权重; 个可以被关掉的单元,就有 个可能的子网络。测试时一次”全开”的前向传播,可以看作把这一大群子网络的预测平均起来的廉价近似。演示 2 的后半部分在测试时故意打开 dropout、抽 1000 个随机子网络:
- 单个随机子网络的 dev 错误率平均 0.1906(最好 0.1690,最差 0.2125),比全开的网络差得多——所以测试时不能开着 dropout 只算一次;
- 1000 个子网络的预测概率取平均:dev 错误率 0.0735;一次全开的前向传播:0.0755。两者预测的类别 99.8% 相同;
- 但只是近似:两者的概率平均相差 0.1459,全开网络的概率更”尖”(平均 0.4234 vs 0.2776)。对单层的 sigmoid 单元,权重缩放恰好对应子网络的(归一化的)几何平均(Baldi & Sadowski, 2013);对多层 ReLU 网络,它只是一个近似。
(把 dropout 开着做很多次预测再平均,后来被发展成一种估计模型不确定性的方法,叫 MC dropout(Gal & Ghahramani, 2016)。那是另一个话题。)
5.5 为什么有效:不能依赖任何一个特征
Ng 给了两个角度。
角度一:每次训练一个更小的网络。 小网络的过拟合能力弱,像是一种正则化。
角度二(更深入):从单个单元的视角看。 设想下一层的某个单元,它有 4 个输入。训练时,这 4 个输入中的任何一个都可能随时消失。于是它不能把宝押在任何一个输入上,只能把权重摊在所有输入上,每个都不太大。摊开的权重平方和更小——这和 L2 的效果类似。Ng 提到,可以严格地证明 dropout 相当于一种自适应的 L2 正则化:每个权重受到的惩罚大小,取决于和它相乘的激活值有多大(Wager et al., 2013 在广义线性模型上给出了这个结果)。
代码 04 演示 4 用一个最直接的方法检验”不能依赖任何一个特征”:把训练好的网络第 1 层的 20 个隐藏单元逐个拿掉(把它的输出权重置 0),看 dev 误差涨多少(3 个种子):
| 做法 | 拿掉一个单元:最多涨(3 个种子) | 平均涨 | 第 2 层权重的有效输入数(满分 20) |
|---|---|---|---|
| 不用 dropout | 0.3105 / 0.1170 / 0.3090 | 0.0370 | 4.9 / 6.6 / 6.1 |
| keep_prob = 0.86 | 0.0065 / 0.0015 / 0.0050 | 0.0004 | 8.6 / 6.4 / 4.7 |
| keep_prob = 0.5 | 0.0075 / 0.0060 / 0.0035 | 0.0003 | 7.4 / 10.2 / 8.1 |
(“有效输入数”:第 2 层每个单元的 participation ratio 的平均,读作”这个单元实际上依赖第 1 层的几个单元”。)
- 不用 dropout 的网络里有”顶梁柱”:拿掉其中一个单元,dev 误差最多涨 0.3105——网络把某一段边界完全押在了这一个单元上。用 dropout 训练的网络,拿掉任何一个单元,dev 误差最多只涨 0.0065。这是”不能依赖任何一个特征”最直接的证据。
- 权重的”摊开”程度:keep_prob = 0.86 时,有效输入数的平均只从 5.9 升到 6.5,而且三个种子并不一致;keep_prob = 0.5 时到 8.6,才比较明显。另外,演示 3 会看到,dropout 网络的权重平方和并没有变小(330 → 401)。所以在这个小网络上,“dropout 类似 L2”更多体现在”冗余、摊开”上,而不是”总的权重变小”。
5.6 实验:仿原作业
代码 04 演示 3:和代码 03 完全相同的数据和网络,dropout 加在两个隐藏层上(每行 3 个种子的平均):
| 做法 | 训练误差 | dev 误差 | 测试误差 | Σ‖W‖² |
|---|---|---|---|---|
| 不用 dropout | 0.0284 | 0.0762 | 0.0920 | 329.9 |
| keep_prob = 0.95 | 0.0284 | 0.0707 | 0.0879 | 344.3 |
| keep_prob = 0.86(原作业) | 0.0316 | 0.0737 | 0.0902 | 400.8 |
| keep_prob = 0.7 | 0.0363 | 0.0738 | 0.0905 | 395.7 |
| keep_prob = 0.5 | 0.0427 | 0.0765 | 0.0963 | 217.9 |
| 第 1 层 0.7,第 2 层 1 | 0.0316 | 0.0743 | 0.0891 | 408.1 |
这和我预想的不一样。 原作业里 dropout 的测试准确率最高(约 95%,L2 约 93%);在我们的合成数据上,dropout 只帮了一点点(dev 0.0762 → 最好 0.0707),远不如 L2(λ = 0.7 时 dev 0.0640,§4.4)。训练误差一直低于 Bayes 分类器在训练集上的 0.0521:dropout 没能阻止网络”背”噪声点,字符画里 keep_prob = 0.86 的边界仍有为了包住个别点画出的弯折。
一个可能的原因:这个网络很小,第 2 个隐藏层只有 3 个单元,keep_prob = 0.86 时它经常整整少掉三分之一,这种噪声对一个本来就很窄的层很”粗暴”;而 dropout 通常用在宽的、参数多的层上。这只是猜测,我没有专门做实验验证。再加上 §3.2 的结果(“花朵 + 噪声特征”上 dropout 很有效、L2 没用),结论只能是:哪种正则化更好,取决于具体的数据和网络,要在 dev 上比。不要因为某个作业、某篇文章里 dropout 赢了,就默认它在你的问题上也赢。
5.7 实践细节
- 不同的层可以用不同的 keep_prob。参数多、容易过拟合的层(比如 Ng 举例里 7×7 的大权重矩阵)用小一点的 keep_prob(如 0.5);参数少的层用大一点(0.7);不担心过拟合的层用 1.0(不做 dropout)。代价是多了几个要调的超参数;另一种做法是只对部分层做 dropout、共用一个 keep_prob。演示 3 最后一行”只对 20 个单元的那一层做 dropout”就是这种做法。
- 输入层通常不做 dropout,或者 keep_prob 很接近 1(比如 0.9),很少用 0.5。
- 计算机视觉里 dropout 用得很多:输入维度太大(每个像素一个特征),数据几乎永远不够,几乎总在过拟合。但 Ng 强调,dropout 是一种正则化手段,没有过拟合就不需要它;在其他领域,不要因为”CV 的人都在用”就默认打开。
- cost 不再有明确的定义,调试时先关掉。有 dropout 时,每一步的 是在一个不同的随机子网络上算的。代码 04 演示 5(种子 1):相邻两步的 相差的中位数是 0.0175,是不用 dropout 时(0.00092)的 19 倍,第 20000–20005 步的 6 个值在 0.10 和 0.21 之间乱跳;关掉 dropout、在整个训练集上算的 才有清楚的趋势(0.7026 → 0.0701)。Ng 的建议:先把 keep_prob 设成 1,确认 在单调下降、代码没有 bug,再打开 dropout。(上升的步数两者差不多,14,868 vs 17,202,都接近一半:不用 dropout 时学习率 0.3 偏大带来的小抖动,见 §4.7。区别在幅度。)
- 梯度检验时关掉 dropout。dropout 让 成了随机的: 和 用的是两个不同的子网络,差分里主要是蒙版的差别而不是 的变化。演示 5 和
regularization.py的自检都量了一下:每次重新抽蒙版时相对误差 1.00e+00(完全对不上);固定蒙版(4.75e−09)或关掉 dropout(4.19e−09)就没问题。固定蒙版之所以可行,是因为蒙版固定后 就是”某一个子网络的 cost”,一个确定的函数,反向传播算的正是它的梯度。第 7 讲会系统地讲梯度检验。
6. 其他正则化方法 · Other regularization methods
6.1 数据增强 data augmentation
治 variance 最好的药是更多数据,但数据可能很贵。数据增强是一种廉价的替代:对训练样本做不改变标签的随机变换,“造出”新样本。Ng 举的例子:
- 猫的图片左右翻转以后还是猫,训练集一下子翻倍;
- 随机裁剪、缩放、轻微旋转以后还是猫;
- 手写数字(OCR)可以加随机的旋转和扭曲(幅度要小——扭得太厉害,“4”可能就不像”4”了)。
增强出来的样本和原样本高度相关,所以它们的信息量不如同样多的、真正独立的新样本;但它们几乎免费。关键的设计问题是:哪些变换不改变标签? 这需要领域知识:左右翻转对猫没问题,对”识别字母 b 和 d”就不行;上下翻转对卫星图像没问题,对街景就不行。§6.4 会在第 5 讲的白天 / 黑夜照片上看到,选对了变换,效果可以比 L2、dropout 都好得多。
6.2 early stopping
训练时同时画两条曲线:训练误差(或训练集上的 )和 dev 误差,横轴是迭代次数。训练误差通常一路下降;dev 误差往往先降后升。early stopping 就是在 dev 误差最低的地方停下来,取那时的参数。第 1 讲 tiny_nn.train 的 keep_best、第 3 讲 §8.4 里”测试准确率在第 300–500 步就到了最高点”,说的都是它。
代码 05 演示 1:代码 03 里不加正则化的足球场网络,每 250 步量一次 dev 误差(3 个种子):
| 种子 | dev 最低在第几步 | 那时 dev | 那时测试 | 那时 Σ‖W‖² | 那时训练 J | 训练到底:dev | 测试 | Σ‖W‖² | 训练 J | patience 停在 |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 750 | 0.0615 | 0.0798 | 50.7 | 0.1285 | 0.0690 | 0.0878 | 320.6 | 0.0647 | 5750 |
| 2 | 500 | 0.0640 | 0.0818 | 43.8 | 0.1348 | 0.0830 | 0.0986 | 406.3 | 0.0571 | 5500 |
| 3 | 1250 | 0.0645 | 0.0800 | 73.5 | 0.1061 | 0.0765 | 0.0896 | 262.8 | 0.0820 | 6250 |
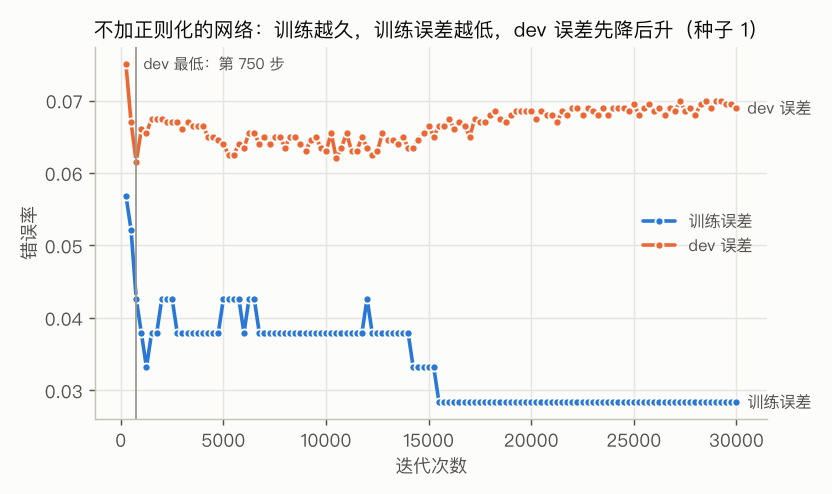
- dev 误差在很早的时候(第 500–1250 步)就到了最低。停在那里的网络,测试误差平均 0.0805;训练到底是 0.0920。early stopping 的效果和调好的 L2(0.0805)差不多,而且只训练了一次,不用扫描 λ——这是它最大的优点。
- 为什么它像 L2?权重从很小的初始值开始,随训练一路变大(§4.3 的表)。停下来的那一刻,Σ‖W‖² 只有 44–74(训练到底是 263–406),和 λ = 0.1、0.3 时的 77、53 相当。early stopping = 在”中等大小的 ‖W‖“处停下。
- patience(耐心):实践中不会真的训练到底再回头找最低点,而是”连续若干次没有创新低就停”。这里设成 20 次(5000 步),训练在第 5500–6250 步就停了,省下了约 80% 的计算。
regularization.model(..., patience=20)实现了这个规则。 - 用 dev 挑停在哪一步,同样会有 §1.5 的乐观偏差:挑出来那一步的 dev 误差(0.0615–0.0645)比它的测试误差乐观。曲线本身也很嘈杂(图里 dev 误差在 0.062–0.07 之间来回跳),“最低点”有一部分是运气。
6.3 early stopping 和正交化的冲突
Ng 指出了 early stopping 的一个缺点。他把机器学习的工作分成两件独立的事:
- 优化 cost (梯度下降、Adam……,第 8 讲);
- 不要过拟合(正则化、更多数据……,本讲)。
最好每个”旋钮”只管一件事,这样调起来互不干扰——这个思想叫正交化(orthogonalization),第 10 讲会把它作为整个 ML 策略的基础。early stopping 用同一个旋钮(迭代次数)同时管两件事:停下的那一刻, 还远没优化好(演示 1 里训练集上的 只降到 0.106–0.135,训练到底是 0.057–0.082),你没法单独改进其中一件。
替代方案是 L2:把 优化到底(只管优化),再单独调 λ(只管过拟合)。代价是要多训练几次——代码 03 为了画 λ 曲线训练了 8 × 3 = 24 次,early stopping 每个种子只训练了一次。Ng 说他自己如果算力允许,更倾向于用 L2 并尝试不同的 λ;但很多人用 early stopping,因为它便宜。两者也可以一起用。
6.4 把工具用起来:救一救第 5 讲的 32×32 网络
第 5 讲 §2.4 里,32×32 输入的白天 / 黑夜网络 [3072, 64, 1] 训练准确率 0.966、测试只有 0.869;第 5 讲的预告说”第 6 讲会知道这一行该怎么救”。代码 05 演示 2 用同样的数据(训练 8000 张、dev 1000 张、测试 3000 张,同样的种子),依次试本讲的每一种工具(每一行:Adam,学习率 0.001,mini-batch 128,3000 步,用 dev 集做 early stopping):
| 做法 | 训练误差 | dev 误差 | 测试误差 | 城市夜景认对 |
|---|---|---|---|---|
| 32×32,第 5 讲的设置(λ = 0.8) | 0.0001 | 0.1200 | 0.1227 | 0.665 |
| + L2 加强 10 倍(λ = 8) | 0.0011 | 0.1170 | 0.1240 | 0.641 |
| + dropout(keep_prob 0.5) | 0.0305 | 0.0890 | 0.1047 | 0.756 |
| + 随机水平翻转 | 0.0219 | 0.0810 | 0.0913 | 0.819 |
| + 翻转 + 平移 ±2 像素 | 0.0541 | 0.0540 | 0.0623 | 0.975 |
| + 翻转 + 平移 + dropout | 0.0655 | 0.0510 | 0.0740 | 0.940 |
| 降到 16×16(第 5 讲的办法) | 0.0248 | 0.0600 | 0.0730 | 0.915 |
(这个世界的 Bayes 错误率是 0.05:10% 的黄昏照片标签是随机的。“城市夜景认对”:最难的那一类——只能靠 1 个像素的小路灯和阴天区分——被判对的比例。这里用的是本讲的训练函数,和第 5 讲的 tiny_nn 随机数用法不同,第一行的数字和第 5 讲不会逐位相同。)
- 起点:训练集几乎全对、测试错一成多,典型的 high variance。
- L2 加强 10 倍几乎没用;dropout 有一些帮助。
- 数据增强最有效:只加随机水平翻转(白天 / 黑夜照片左右翻转后标签不变),测试误差降到 0.0913;再加上 ±2 像素的随机平移(四周用边缘像素补 2 圈,再随机裁出 32×32,即常见的 padding + random crop),降到 0.0623,离下限 0.05 只差一点点,城市夜景认对的比例从 0.665 升到 0.975。原因是:城市夜景的线索是位置随机的小亮点,全连接网络要在每个位置分别学”这里有个亮点”;平移把同一个亮点挪到不同的位置,等于免费给了它更多”别处有亮点”的例子。(第 12 讲的卷积网络会把”平移不变”直接写进架构里。)
- 再叠加 dropout:dev 误差略好(0.0510 vs 0.0540),测试误差反而更差(0.0740 vs 0.0623)。1000 张的 dev 集分不出零点几个百分点的差别(§1.3);按 dev 选,你会选到它。正则化手段不是叠得越多越好,而 dev 集要大到能分辨你关心的差别,才靠得住。
- 和第 5 讲的办法比:降到 16×16 测试误差 0.0730;在 32×32 上做数据增强(0.0623)比它还好——高分辨率里的信息是有用的,前提是有足够的数据(或者足够好的增强)喂饱它。这就是那一行”该怎么救”的答案:先诊断(high variance),再按 basic recipe 试”更多数据”一类的药,用 dev 集做对照。
- 训练误差反而升高了(0.0001 → 0.0541):增强后的训练集更难背。正则化就是这样——牺牲一点训练集上的表现,换来 dev / 测试上的进步。
7. 小结 · Summary
- 三份数据:train 拟合参数,dev 做选择,test 给无偏的最终成绩。准确率估计的误差约为 ,只取决于 dev / test 的样本数:两个模型差 0.5 个百分点时,100 个样本的 dev 只有 64% 的机会挑对,10,000 个时每次都对。所以小数据用 60/20/20,百万级数据 98/1/1 就够(代码 01)。
- dev 和 test 必须同分布,而且是你将来要面对的分布:dev 来自上半场时,“上半场最好的模型”在下半场排第 18 / 20。只有 dev 没有 test时,dev 上挑出来的分数偏乐观(100 个样本时高估 0.0214),一份没参与挑选的 test 集没有偏差。
- bias / variance 的诊断:训练误差 − 最优误差(bias),dev 误差 − 训练误差(variance)。参照是 Bayes 错误率而不是 0:同心圆上 22% 的训练误差已经到顶,以为是 high bias 去加大网络,一点用都没有。同一个任务上可以造出四个象限(代码 02)。
- basic recipe:先治 bias(更大的网络、训练更久、换架构),再治 variance(更多数据、正则化、换架构)。药要对症:high bias 时加数据没用,只多 1 个隐藏单元 dev 就从 0.3392 降到 0.0824。大网络 + 正则化几乎只降 bias,更多数据几乎只降 variance,所以 trade-off 不再那么紧。
- L2 正则化: 加 , 加 ,等价于每步把 乘以 (weight decay)。仿原作业:λ = 0.7 让测试误差从 0.0920 降到 0.0805;dev 误差随 λ 先降后升,最好的 λ 是一个区间。为什么有效:权重小 → 网络更简单、更接近线性、更平滑(最大斜率 203.9 → 8.3)。调试时画包含正则项的 。
- dropout:训练时每个单元以 keep_prob 保留,除以 keep_prob 让期望不变、测试时不用任何补偿;测试时不用 dropout,一次全开的前向传播近似一大群子网络的平均。“不能依赖任何一个特征”:拿掉一个单元,不用 dropout 的网络 dev 误差最多涨 0.3105,用 dropout 的只涨 0.0065。cost 曲线不再单调,调试和梯度检验时先关掉。
- 哪种正则化更好是经验问题:足球场数据上 L2 明显好于 dropout,“花朵 + 噪声特征”上正好相反,白天 / 黑夜照片上数据增强最好。
- 数据增强是便宜的更多数据(32×32 网络测试误差 0.1227 → 0.0623);early stopping 一次训练就能得到和调好的 L2 差不多的效果(0.0805),但把”优化 J”和”不过拟合”绑在一个旋钮上,违背正交化。
8. 常见误区 · Common pitfalls
- “dev 和 test 应该各占 20%。” 比例是结果,不是原则。dev / test 只要大到能分辨你关心的差别;百万级数据时 1% 就够(§1.3)。反过来,小数据时套用 98/1/1 会让 dev 小到没用。
- “dev 上最好的那个分数就是我的模型在新数据上的表现。” 不是。你按 dev 挑过东西,挑出来的分数偏乐观(赢家的诅咒,§1.5);要无偏的成绩,用一份没参与任何选择的 test 集。
- “训练数据和 dev / test 来源不同没关系,反正都是猫。” dev 和 test 之间必须同分布,否则你优化的是错的靶子(§1.4)。训练集和 dev / test 不同分布时的诊断方法见第 10 讲。
- “训练误差 15% 就是 high bias。” 要和最优误差比。如果连人都只能做到 85%,15% 已经到顶了(§2.3)。
- “模型表现不好,先多收集些数据。” 先诊断。high bias 时加数据几乎没用(§3.2【A】:数据多 4 倍,dev 从 0.3392 到 0.3482)。
- “正则化越强越好 / 正则化手段叠得越多越好。” λ 太大会把模型推到 high bias(λ = 25 时变成常数);在白天 / 黑夜上再叠一个 dropout,测试误差反而变差(§6.4)。
- “L2 正则化之后 cost 曲线上升了,说明有 bug。” 先看你画的是哪个 。只看交叉熵,它确实可能一直升(§4.7);完整的 才应该下降。
- “测试时也要做 dropout”/“测试时要乘以 keep_prob”。 测试时不做 dropout;用 inverted dropout 时,测试时也不需要任何缩放(§5.3–5.4)。只有用了”不除以 keep_prob”的旧写法,测试时才需要乘以 keep_prob——而忘了这一步,交叉熵翻倍、不报错。
- “dropout 比 L2 先进,应该优先用。” 没有普遍的优劣,要在 dev 上比(§5.6、§3.2)。dropout 是正则化手段,没有过拟合就不需要它。
- “开着 dropout 做梯度检验,误差大说明反向传播错了。” dropout 让 变成随机的,梯度检验必然失败。关掉它,或者固定蒙版再查(§5.7)。
9. 练习 · Exercises
练习 1(dev 集要多大)。你的两个模型在 dev 上的准确率分别是 93.2% 和 93.6%。(a) 如果 dev 集有 500 个样本,单个准确率估计的标准差大约是多少?这 0.4 个百分点的差距可信吗?(b) 要让标准差降到 0.1 个百分点,dev 集大约需要多少个样本?(c) 你总共有 300 万个样本,按 98/1/1 划分,dev 有多少个?够不够用?
参考答案
(a) ,约 1.1 个百分点。0.4 个百分点的差距远小于一个标准差,不可信——可能只是这 500 个样本的运气(代码 01 演示 1:dev 100 个时,差 0.5 个百分点的两个模型只有 64% 的机会排对顺序)。 (b) 。 (c) 30,000 个。标准差约 ,0.4 个百分点的差距约是它的 2.7 倍,比较可信(配对比较时更灵敏,§1.3 的注)。如果你关心的是 0.1 个百分点量级的改进,30,000 个还不够。
练习 2(诊断)。假设人类在下面几个任务上的错误率约为最优误差。诊断每种情况,并说出下一步最该做什么: (a) 人类 1%,训练 8%,dev 9%;(b) 人类 1%,训练 1.5%,dev 12%;(c) 人类 1%,训练 8%,dev 20%;(d) 人类 10%,训练 10.5%,dev 11%。
参考答案
(a) 训练 − 最优 = 7%,dev − 训练 = 1%:high bias。更大的网络、训练更久、换架构;加数据没用。 (b) 0.5% 和 10.5%:high variance。更多数据、正则化(L2、dropout、数据增强)、换架构。 (c) 7% 和 12%:两者都有。按 basic recipe 先治 bias(让训练集先学好),再治 variance;“大网络 + 正则化”可以同时改善两者。 (d) 0.5% 和 0.5%:两者都没有,已经接近最优。如果最优误差真的是 10%,再改进模型几乎没有空间;要么接受,要么改进输入(更清晰的数据、更多的信息)。如果没有”人类 10%“这个参照,你可能把 (d) 误诊成 high bias(§2.3)。
练习 3(L2 的梯度)。(a) 从 出发,推导 中正则项贡献的部分。(b) α = 0.3、λ = 0.7、m = 211 时,衰减系数 是多少?如果交叉熵的梯度恰好为 0,30,000 步之后权重剩下原来的多少倍?(c) 把 m 换成 2110(数据多 10 倍),同一个 λ 的”衰减力度”怎样变化?这和”数据多时不太需要正则化”有什么关系?
参考答案
(a) ,对 求导得 ,乘以 得 。写成矩阵就是 多一项 。 (b) (和代码 03 演示 2 一致)。。 (c) ,每步的衰减小了 10 倍。正则项 前面有 ,数据越多,同一个 λ 的正则化作用越弱、交叉熵(数据)的话语权越大——数据多时本来就不容易过拟合,正好需要更少的正则化。(这也意味着换了数据量以后,最好的 λ 可能要重新调。)
练习 4(dropout 的期望)。某个隐藏单元的激活值 ,keep_prob = 0.75。(a) inverted dropout 之后,它可能取哪两个值?各自的概率?期望是多少?(b) 不除以 keep_prob 时期望是多少?(c) 求 inverted dropout 之后这个值的方差。keep_prob 越小,方差怎样变化?这和”keep_prob 越小,正则化越强”有什么关系?
参考答案
(a) 以 0.75 的概率为 ,以 0.25 的概率为 0。期望 ,和原值相同。 (b) ,变成原来的 keep_prob 倍。 (c) ,方差 。一般地,方差 :keep_prob = 0.5 时是 ,0.9 时只有 。keep_prob 越小,训练时注入的噪声越大,网络越”不敢”依赖单个单元——正则化越强;太小则噪声大到学不好,滑向 high bias(代码 04 演示 3:keep_prob = 0.5 时训练误差升到 0.0427、dev 误差回到不用 dropout 的水平)。
练习 5(反向传播与蒙版)。(a) 为什么 dropout 的反向传播必须用前向时同一个蒙版 ,而不是重新抽一个?(b) 第 层前向是”先激活、再 dropout”,反向时 dropout_backward 和”穿过激活函数”哪个在前?(c) 被关掉的单元,它的输入权重 的那一行在这一步会被更新吗?它的输出权重 的那一列呢?
参考答案
(a) 反向传播算的是”这一次前向传播所对应的那个函数”的梯度。前向用的是蒙版 定义的那个子网络;换一个蒙版,就是另一个函数的梯度,对不上(代码 04 演示 5:每次重新抽蒙版时梯度检验的相对误差是 1.00e+00)。
(b) 反向的顺序和前向相反:先 dropout_backward(乘以 ),再穿过激活函数(乘以 )。
(c) 被关掉的单元 :dropout_backward 让 ,于是 ,它的输入权重( 的第 行)的梯度只剩 L2 项(不加 L2 时为 0),这一步只有衰减、没有学习。它的输出权重( 的第 列):,而 的第 行(dropout 之后)是 0,所以那一列的梯度也只剩 L2 项。注意蒙版是逐样本的:一个 mini-batch 里,单元 只在被关掉的那些样本上没有贡献,在其他样本上照常贡献梯度。
练习 6(先预测再运行:dropout 加在更宽的网络上)。§5.6 猜测”dropout 在这个任务上效果不好,可能是因为网络太窄”。把 04_dropout.py 里的 DIMS 改成 [2, 100, 100, 1],只运行演示 3(可以把 main 里其他演示注释掉;每次训练会慢几倍)。先预测:不用 dropout 时 dev 误差会比 [2, 20, 3, 1] 更高还是更低?keep_prob = 0.86 和 0.5 时呢?然后运行验证。
参考答案
预期(具体数字以你运行的结果为准):更宽的网络不加正则化时更容易过拟合,训练误差可能更低、dev 误差可能更高;dropout 在宽层上”关掉一部分单元”不再那么粗暴(100 个单元关掉 14 个,剩下的仍然很多),所以 dropout 的相对收益可能更大。但这只是一个假设——如果结果显示 dropout 依然不如 L2,那就说明原因不在宽度,可能在数据本身(比如噪声集中在少数”意外点”上,L2 的”压平”正好对症)。无论结果如何,这个练习的重点是:对”为什么”的猜测,要用一个只改一个变量的对照实验去检验。
练习 7(先预测再运行:early stopping 的 patience)。在 05_early_stopping_and_augmentation.py 里把 PATIENCE 从 20 改成 4(只等 1000 步)和 60(等 15,000 步)。先预测:停下的位置、返回的”最好的一步”、以及测试误差会怎样变化?patience 太小有什么风险?
参考答案
预期:patience = 4 时会停得更早(dev 误差最低点在第 500–1250 步,之后 1000 步内没有创新低就停);返回的”最好的一步”多半不变,因为这几个种子的最低点出现得很早。patience = 60 时停得更晚甚至训练到底,最好的一步也大概率不变。风险:dev 曲线很嘈杂(§6.2 的图),如果 dev 误差在某个平台上停留一段时间后才继续下降(第 1 讲代码 04 里 sigmoid 深网的训练曲线就先卡在平台上、过很久才冲出来),太小的 patience 会在平台上提前放弃。实践中 patience 要和 dev 曲线的噪声、评估间隔一起考虑;具体数字以你运行的结果为准。
练习 8(设计数据增强)。对下面每个任务,说出两种你认为不改变标签的变换,和一种会改变标签(不能用)的变换:(a) 识别照片里有没有猫;(b) 识别手写数字 0–9;(c) 从胸部 X 光片判断是否有肺炎;(d) 第 5 讲的触发词检测(10 秒音频)。
参考答案
(a) 可以:左右翻转、随机裁剪 / 缩放、轻微的亮度和颜色变化。不能:裁剪到把猫切掉(标签会变成”没有猫”)。上下翻转也要小心(真实照片里猫很少倒立,会引入不存在的样本)。 (b) 可以:小角度旋转(±10° 左右)、轻微的弹性扭曲、小幅平移。不能:左右翻转(2、3、5、7 会变成不像任何数字的东西)、旋转 180°(6 和 9 互换)。 (c) 可以:轻微的亮度 / 对比度变化、小幅平移和缩放。要小心:左右翻转——心脏通常在左侧,翻转会造出解剖上不存在的图像;是否可用要和放射科医生讨论。这说明增强需要领域知识。 (d) 可以:混入不同的背景噪声、轻微改变音量和语速(第 5 讲 §5.3 的合成数据本身就是一种增强)。不能:把音频倒放(“activate”倒放以后不再是触发词);在”activate”刚结束的位置截断,会改变哪些帧该标 1。
练习 9(early stopping 与 L2 的对应)。代码 05 演示 1 里,early stopping 停下时 Σ‖W‖² 在 44–74 之间;代码 03 演示 3 里,λ = 0.1、0.3 时 Σ‖W‖² 是 77.4、53.0。(a) 为什么说 early stopping 和”选一个中等的 λ”效果类似?(b) 两者在”需要训练几次”上有什么区别?(c) 结合正交化,说说你在一个新项目里会怎样选择。
参考答案
(a) 权重从很小的初始值开始,随训练逐渐变大;在中途停下,等于把 ‖W‖ 限制在一个中等的大小。L2 用 λ 直接惩罚 ‖W‖,λ 中等时得到的 ‖W‖ 也是中等的。两者都在”‖W‖ 太小(high bias)“和”‖W‖ 太大(high variance)“之间取一个中间值。代码里两者的测试误差也几乎一样(0.0805 vs 0.0805)。 (b) early stopping:每个种子训练一次,就”顺便”试遍了从小到大的 ‖W‖。L2:每个 λ 都要单独训练到收敛(代码 03 扫了 8 个 λ × 3 个种子 = 24 次)。 (c) 一种合理的做法:算力宽裕时用 L2(或 L2 + 训练到收敛),把”优化”和”正则化”两个旋钮分开调,出了问题容易定位;算力紧张或者只是快速试一个想法时,用 early stopping 当作便宜的默认选项。实践中两者也常常一起用(比如很多框架默认保留 dev 上最好的检查点)。
10. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C2M1 “Practical Aspects of Deep Learning”(Andrew Ng)——本讲的技术内容;编程作业 “Regularization”。
- Andrew Ng, Machine Learning Yearning(免费电子书)——关于 dev / test 集怎么建、多大、为什么同分布,以及 bias / variance 的章节,是本讲 §1–§3 的展开版,也是第 10 讲的前身。
- Goodfellow, Bengio & Courville (2016). Deep Learning, 第 5.2–5.4 节(容量、过拟合、欠拟合、bias / variance)和第 7 章 “Regularization for Deep Learning”(L2、数据增强、early stopping、dropout 都在里面)。
正则化方法的原始论文
- Krogh & Hertz (1992). A simple weight decay can improve generalization. NeurIPS 4. ——weight decay 的经典分析。
- Hinton, Srivastava, Krizhevsky, Sutskever & Salakhutdinov (2012). Improving neural networks by preventing co-adaptation of feature detectors. arXiv:1207.0580. ——dropout 的第一篇论文。
- Srivastava, Hinton, Krizhevsky, Sutskever & Salakhutdinov (2014). Dropout: A simple way to prevent neural networks from overfitting. JMLR 15. ——dropout 的完整版本,包括测试时的权重缩放和”集成”的解释。
- Baldi & Sadowski (2013). Understanding dropout. NeurIPS. ——证明了单层 sigmoid 单元上”权重缩放 = 子网络的归一化几何平均”(§5.4)。
- Wager, Wang & Liang (2013). Dropout training as adaptive regularization. NeurIPS. ——dropout ≈ 自适应的 L2(§5.5)。
- Gal & Ghahramani (2016). Dropout as a Bayesian approximation: Representing model uncertainty in deep learning. ICML. ——MC dropout(§5.4 的括号)。
- Prechelt (1998). Early stopping — but when? In Neural Networks: Tricks of the Trade. ——early stopping 的停止准则(patience 一类的规则)。
- Simard, Steinkraus & Platt (2003). Best practices for convolutional neural networks applied to visual document analysis. ICDAR. ——手写字符上的数据增强(弹性扭曲)。
- Loshchilov & Hutter (2019). Decoupled weight decay regularization. ICLR. ——AdamW:为什么在 Adam 里 L2 ≠ weight decay(§4.3)。
现代视角
- Zhang, Bengio, Hardt, Recht & Vinyals (2017). Understanding deep learning requires rethinking generalization. ICLR. ——网络能拟合随机标签。
- Belkin, Hsu, Ma & Mandal (2019). Reconciling modern machine-learning practice and the classical bias–variance trade-off. PNAS. ——double descent。
- Nakkiran, Kaplun, Bansal, Yang, Barak & Sutskever (2020). Deep double descent: Where bigger models and more data hurt. ICLR.
- Cohen, Kaur, Li, Kolter & Talwalkar (2021). Gradient descent on neural networks typically occurs at the edge of stability. ICLR. ——§4.7 里大学习率时 cost 的上下抖动。
11. 下一讲预告 · Next lecture
本讲解决的是”模型学到的东西能不能推广到新数据”:怎样划分数据来衡量它、怎样诊断 bias 和 variance、怎样用正则化控制 variance。但还有一类问题出现在更早的地方——优化本身能不能顺利进行。第 1 讲代码 04 里 sigmoid 深网的梯度传到第 1 层只剩输出层的 1/2000,第 4 讲代码 05 里大学习率让 ReLU 全部死掉;本讲 §4.7 里,学习率 0.3 让 cost 一直在上下抖动。
第 7 讲:实践要点 II——输入归一化、梯度消失 / 爆炸、初始化与梯度检验。 这是 C2M1 的后半部分:
- 输入归一化:为什么把每个特征减去均值、除以标准差,能让损失曲面”更圆”、梯度下降快得多(第 1 讲
Standardizer的来历); - 梯度消失 / 爆炸:深网里激活值和梯度为什么会随层数指数级地变大或变小;
- Xavier / He 初始化:从”保持每层方差不变”推出 和 (本讲的足球场网络用的就是前者);
- 梯度检验:双边差分、相对误差,以及几条实战注意事项——其中两条你已经在本讲见过:正则项别漏(§4.7、
gradient_check_reg),和 dropout 一起用时先关掉 dropout(§5.7)。