对应 Maps to:Stanford CS230 Fall 2025 Lecture 2(9/30,“Key AI Concepts Through Case Studies”);Autumn 2018 Lecture 2 “Deep Learning Intuition”(Kian Katanforoosh,YouTube 公开录像);Fall 2017 的课堂课件 “CS230: Lecture 3 – Various Deep Learning Topics”(Kian Katanforoosh、Andrew Ng,CS230 网站上的公开 PDF)。相关的 Coursera 编程作业:Face Recognition、Art Generation with Neural Style Transfer(C4 第 4 周)、Trigger Word Detection(C5 第 3 周)。 依据说明:Fall 2025 的 slides 和录像只对选课学生开放,本讲没有用到它们。2018 年的录像是公开的,但本讲义没有逐字核对录像,开场回顾(多标签 vs softmax、encoding)和触发词案例的安排,参考的是这一讲的内容提纲,细节可能和录像有出入。具体的设计数字来自 Fall 2017 的公开课件:白天 / 黑夜用 10,000 张图、输入 (64, 64, 3);人脸验证输入 (412, 412, 3)、128 维编码、triplet loss、K 近邻、K-means;风格迁移”学的是一张图,不是参数”。触发词的数字来自 Coursera C5 的编程作业:10 秒音频、5511 × 101 的频谱、1375 个输出时间步、结束后标 50 个 1。技术细节以原始论文为准(FaceNet、Gatys et al.,见 §10)。§6.2 “今天的例子”是本讲义的补充,不是原课内容。 配套代码 Code:
code/lecture05/(numpy;4 个脚本 + 2 个共享模块;最慢的01_day_night_resolution.py约 20 秒,其余都在 10 秒左右或更快) 预计阅读时间:2.5–3 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 拿到一个新问题时,用 Kian 的五问(数据?输入?输出?架构?损失?)把它拆开,并且知道每一问通常在哪里”埋着坑”。
- 用”把图缩小,看人还能不能分辨”的办法估计输入分辨率;解释为什么分辨率、数据量和模型三者要一起决定,以及为什么”人类水平”可以当作不可避免误差(Bayes error)的估计。
- 说清楚人脸验证为什么不能直接比像素,也不该当成”每个学生一类”的分类问题;解释编码(encoding / embedding)+ 距离的方案,写出 triplet loss 和它的梯度,说出 margin 和”推开负样本”那一项各防止了什么。
- 解释风格迁移里”内容”和”风格”分别用什么表示(激活值 vs Gram 矩阵),以及”固定参数、优化输入”这个想法还能用在哪里(可视化、对抗样本)。
- 为触发词检测设计输出和标签:为什么输出是一个序列;为什么”结束后标 k 个 1”比”只标 1 个”好;为什么逐帧准确率会骗人,产品该看什么指标;怎样用数据合成几乎免费地得到大量标注。
- 认出”编码”这个贯穿所有案例的概念,并能用五问去设计一个今天常见的 embedding 检索 / 推荐系统。
- 记住这一讲最重要的一句话:损失函数定义了任务。标签怎么标、损失怎么写,往往比换一个更大的架构更重要。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开 Previewed only |
|---|---|
| 第 1 讲:神经元、网络、、记号、训练四步 | 逻辑回归、交叉熵、梯度下降的推导(第 2 讲) |
二元交叉熵是什么(第 1 讲 tiny_nn 用过) | 隐藏层、反向传播的完整推导(第 3、4 讲) |
| 一点线性代数:向量、距离、矩阵乘法 | 训练 / 开发 / 测试集划分,偏差与方差(第 6 讲) |
| Python 基础;numpy 不熟也没关系 | softmax 与多分类交叉熵的完整讲解(第 9 讲) |
| precision / recall、Bayes error、误差分析、数据不匹配(第 10 讲) | |
| 卷积、人脸识别和风格迁移的网络细节(第 12–14 讲) | |
| RNN / GRU、触发词检测的模型细节(第 15–16 讲) | |
| 对抗样本(第 18 讲)、可解释性与特征可视化(第 21 讲) |
这是一节”设计问题”的直觉课。前四讲(和后面的大部分技术讲次)回答”网络怎么算、怎么训练”;这一讲回答一个更早的问题:在写第一行代码之前,你要决定什么? 每个案例的技术细节都只讲到”够理解设计”为止,并标出后面哪一讲会展开。
0.3 本讲地图 Map
§1  开场:模型 = 架构 + 参数;改输出就是改任务;"编码";五问
§2  案例 1 白天还是黑夜:数据要多少?输入分辨率选多大?            ← 代码 01
§3  案例 2 学校门禁的人脸验证:编码 + 距离;triplet loss;识别与聚类   ← 代码 02
§4  案例 3 艺术风格迁移:内容 vs 风格;优化的是像素,不是参数         ← 代码 03
§5  案例 4 触发词检测:序列输出;标签怎么标;数据合成;指标           ← 代码 04
§6  贯穿始终的"编码";用五问设计一个今天的 embedding 系统(补充)
§7–11  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation
沿用第 1 讲 §0.4 的全部记号(、、、、、 ……)。本讲新增:
| 符号 | 含义 | 出现在 |
|---|---|---|
| 编码器(encoder):把输入映射成一个向量,叫编码 / 嵌入(encoding / embedding) | §1.4、§3 | |
| 两个输入的编码之间的平方距离 | §3 | |
| triplet 里的 anchor(锚)、positive(同一个人)、negative(另一个人) | §3.4 | |
| (本讲) | triplet loss 的 margin(间隔)。注意:第 1 讲里 是学习率,本讲沿用 FaceNet 的写法把 留给 margin,学习率改写成 | §3.4 |
| 输入 在第 层的激活值(特征图) | §4 | |
| 第 层激活值的 Gram 矩阵(风格表示) | §4.2 | |
| 、、 | 内容损失、风格损失、风格损失的权重 | §4.3 |
| 、 | 第 个时间步的标签(Ng 在序列模型里用尖括号上标表示时间步)、输出序列的长度 | §5 |
| 触发词结束后标几个 1 | §5.4 |
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出。种子是固定的,同一台机器上重复运行,输出逐字相同。四个案例的数据都是合成的,“真相”由我们写下的公式决定(daynight_world.py,以及 02、04 文件开头的说明),所以能精确地说出”最多能做到多好”。为了让现象清楚,有些世界的设定是刻意选的,比如白天 / 黑夜世界里”阴天”和”城市夜景”的亮度分布完全一样。这些设定都在代码开头写明了。有好几处结果和我写代码前的预想不一样,讲义按实际结果写,这些情况列在代码 README 的”关于实验结果”里。数字只说明机制,不代表任何真实系统的性能。
1. 开场:模型、输出与”五问” · Recap & the five questions
1.1 模型 = 架构 + 参数
先把第 1 讲的骨架换一种说法,这一讲会反复用到:
架构是你设计的”形状”:几层、每层多宽、用什么激活函数、输出是什么。参数是训练学出来的数。训练的循环是:
 输入 x ──→ 模型 f(x; θ) ──→ 输出 ŷ ──→ 损失 L(ŷ, y) ──→ 梯度 ∂L/∂θ ──→ 更新 θ ← θ − η·∂L/∂θ
   ↑                                        ↑
你决定"喂什么" 你决定"什么叫错"在这个循环里,你能直接设计的是这几样东西:数据(喂进去哪些样本、配什么标签 )、输入 的形式、输出的形式、架构,以及损失函数。参数是梯度下降替你找的,而它找到的只会是”在你给的数据上、按你写的损失、最好的参数”。数据不对,或者损失写得不对,梯度下降会非常认真地学会一件错误的事。本讲的四个案例会一次次看到这一点。
1.2 一个熟悉的例子:猫识别
Coursera C1 第 2 周的编程作业(Logistic Regression with a Neural Network Mindset):判断一张 64×64 的彩色照片里有没有猫。训练集只有 209 张图。
- 输入:一张 (64, 64, 3) 的图,拉平成 维的列向量(第 1 讲 §3.4)。
- 输出:一个数 ,表示”有猫”的概率。
- 架构:逻辑回归,也就是没有隐藏层的神经网络(第 2 讲)。参数是 12,288 个权重加 1 个偏置。
- 损失:二元交叉熵 。
这四个选择看起来”理所当然”,但每一个都是决定。比如为什么是 64×64 而不是 256×256?§2 会专门讨论。
1.3 改输出,就是改任务:多标签 vs softmax
现在要识别三种动物:猫、狗、长颈鹿。输出层该怎么改?取决于你到底想问什么:
| 你想问的问题 | 标签 的样子 | 输出层 | 损失 |
|---|---|---|---|
| “照片里有哪些动物?“(可以同时有猫和狗) | multi-hot,比如 | 3 个独立的 sigmoid,每类一个 | 3 个二元交叉熵相加 |
| “这是哪一种动物?“(恰好一种) | one-hot,比如 | 1 个 softmax: | 多分类交叉熵 |
同一组输出层的原始分数(logits),在两种输出层下给出完全不同的答案:
- 三个 sigmoid:。猫和狗都”很可能有”,三个数加起来不等于 1,也不需要等于 1。
- softmax:。三个数加起来等于 1,表示”三选一”。
前者叫多标签分类(multi-label),后者叫多类别分类(multi-class)。网络的其余部分可以一模一样,差别只在最后一层和损失函数,但它们回答的是两个不同的问题。选错了,模型就会认真地学一个你不想要的东西。比如用 softmax 做”照片里有哪些动物”,它会被迫在猫和狗之间二选一。softmax 的完整推导在第 9 讲。
1.4 编码:隐藏层在”重新描述”输入
第 1 讲 §2.3 用线性探针看到,网络的隐藏层自己学出了”步行便利度”这种输入里没有的中间特征。把这个观察推广一下:每一个隐藏层的激活值 ,都是输入的一种新的描述,叫做编码(encoding)或表示(representation)。
在图像上,这种描述逐层变得越来越抽象。经典的可视化研究(如 Zeiler & Fergus, 2014)显示,卷积网络的第一层学出边缘和颜色斑块的检测器,中间层学出纹理和部件(眼睛、轮子),更深的层对整个物体(人脸、狗)有反应。所以网络倒数第二层的输出,往往就是一个”把图像里和任务有关的信息浓缩起来”的向量。
记住这个词,它是整讲的主线:
- §2 白天 / 黑夜:有了隐藏层,网络才能感受到”有没有小亮点”(逻辑回归做不到);
- §3 人脸验证:编码本身就是产品,我们直接比较两张脸的编码;
- §4 风格迁移:用一个训练好的网络的编码,来定义什么叫”内容”、什么叫”风格”;
- §5 触发词:网络对”最近 1.6 秒声音”的编码,决定此刻要不要响应;
- §6:今天几乎所有的检索、推荐、多模态系统,核心都是一个编码器。
1.5 Kian 的五问
CS230 的课堂案例都按同一个模板来分析。Fall 2017 的课件在每个案例里都列出这五个问题:
- 数据 Data? 要多少?从哪里来?标签怎么得到?怎么划分?有没有偏差(bias)?
- 输入 Input? 是什么、多大(分辨率、长度)?要不要预处理?
- 输出 Output? 是一个数、一个向量、还是一个序列?最后一层用什么激活函数?
- 架构 Architecture? 浅还是深?全连接、卷积还是循环?要不要用预训练的网络?
- 损失 Loss? 怎样衡量”错了多少”?它真的衡量了你在乎的东西吗?
先看一眼四个案例的答案(后面逐个展开)。注意每个案例”难点”所在的那一问都不一样:
| 案例 | 数据 | 输入 | 输出 | 架构 | 损失 | 难点在哪一问 |
|---|---|---|---|---|---|---|
| 白天 / 黑夜 | 约 1 万张带标签的图 | 小图(多小?) | 0 / 1 | 浅层网络 | 二元交叉熵 | 输入的分辨率、数据量 |
| 人脸验证 | 公开人脸库(很多人,每人多张) | 两张脸 | 同一人?→ 先输出编码 | 深层 CNN 编码器 | triplet loss | 输出(编码而非类别)和损失 |
| 风格迁移 | 两张图 + 一个预训练网络 | 内容图、风格图 | 一张新图 | 预训练 CNN(固定) | 内容 + 风格损失 | 损失(而且优化的是输入) |
| 触发词 | 合成的 10 秒音频 | 频谱图序列 | 每个时间步 0 / 1 | 卷积 + RNN | 逐时间步交叉熵 | 数据来源和标签怎么标 |
2. 案例 1:白天还是黑夜 · Day’n’Night classification(热身)
2.1 五问的快速回答
任务:给一张照片,判断它是白天()还是夜晚()拍的。Fall 2017 课件给的参考答案是:
- 数据:约 10,000 张图(课件上还追问了两句:“怎么划分?有没有偏差?”);
- 输入:(64, 64, 3);
- 输出:,最后一层用 sigmoid;
- 架构:“浅层网络应该就能做得很好”;
- 损失:二元交叉熵。课件的评价只有一个词:“Easy”。
看起来像送分题。但”64×64”和”1 万张”这两个数是怎么来的?如果你的老板问”为什么不用 512×512 的原图,信息不是更多吗?“,你怎么回答?这一节就来回答这两个问题。
2.2 数据:要多少?怎么分?有没有偏差?
要多少? 一个粗略但有用的思路是和你做过的任务比。白天 / 黑夜比”有没有猫”简单得多:线索很粗(整体亮度、天空的颜色),不需要识别任何具体的物体。所以如果猫识别需要几万张图,白天 / 黑夜大概几千到一万张就够。这只是起点,真正的答案要靠实验(§2.5)。
怎么分? 训练、开发、测试三份(第 6 讲),而且开发集和测试集要来自你真正要用的分布。
有没有偏差? 这是课件特意追问的一句,值得停下来想:假设你从网上搜”夜晚”得到的照片大多是城市夜景,搜”白天”得到的大多是郊外风景,模型会学到什么?它很可能学会了”城市 vs 郊外”,而不是”白天 vs 夜晚”。到了真实使用时,碰到一张城市白天的照片,它就会说”夜晚”。数据里任何和标签”碰巧相关”的东西,都可能变成模型的捷径。
2.3 输入:分辨率选多大?“缩小了人还能分辨吗”
分辨率是一个真实的取舍:
- 太大:输入维度 。从 64×64 到 512×512, 从 12,288 涨到 786,432,第一层的参数和计算量也涨 64 倍。参数越多,需要的数据越多(§2.5)。如果要在手机上运行,模型越小越好(§2.6)。
- 太小:细节被平均掉了,谁也分不出来。
Kian 在课上给的办法(据 2018 年录像的提纲)非常朴素:把图片缩小到不同的分辨率,看人还能不能分辨。 人还能分辨的最小分辨率,大致就是”信息还在”的最小分辨率。这背后的道理是:在图像、语音这类人类很擅长的任务上,人的表现接近”这些信息里最多能读出多少”的上限。
为了能把这个办法完整地走一遍,代码 01 用了一个合成的照片世界(daynight_world.py)。图片是 32×32 的彩色小照片,有五种场景:
| 场景 | 占比 | 标签 | 画面 |
|---|---|---|---|
| 晴天 | 30% | 白天 | 明亮的蓝天,有时有太阳 |
| 阴天 | 20% | 白天 | 灰蒙蒙,光线均匀,没有点光源 |
| 晴朗的夜晚 | 20% | 夜晚 | 很暗,有星星、月亮、几盏灯 |
| 城市夜景 | 20% | 夜晚 | 天空被灯光照成灰色,亮度分布和阴天完全一样;地面上有很多盏只占 1 个像素的极亮路灯 |
| 黄昏 | 10% | 随机 | 橙色的天空;标签由”日落前还是日落后”决定,画面本身看不出来 |
两个刻意设计的难点:阴天 vs 城市夜景只能靠很小的亮点区分;黄昏谁来都只能猜。所以这个世界的准确率上限(Bayes 最优)是 。
代码 01 演示 1 把一张阴天和一张城市夜景并排画成字符画,分辨率依次降低。32×32 和 16×16 时,城市夜景的地面上能看到一个个比周围亮的小点;到了 8×8,一个 1 像素的路灯被平均进了 4×4 = 16 个像素的块里,“凸起”只剩原来的 1/16,两张图已经很难分辨。你可以自己先看一遍那张字符画,当一次”人”。
代码 01 演示 2 用一个手写的”人类代理”(human proxy)代替人去看 3000 张测试图。这个规则先看天空:又亮又蓝就判白天,很暗就判夜晚。拿不准时,再找”比周围每个邻居都亮 0.1 以上”的孤立小亮点,至少 2 个就判夜晚,否则判白天。
| 分辨率 | 准确率 | 晴天 | 阴天 | 晴朗的夜晚 | 城市夜景 | 黄昏 | |
|---|---|---|---|---|---|---|---|
| 32×32 | 3072 | 0.943 | 1.000 | 1.000 | 1.000 | 1.000 | 0.511 |
| 16×16 | 768 | 0.901 | 1.000 | 1.000 | 1.000 | 0.779 | 0.506 |
| 8×8 | 192 | 0.754 | 1.000 | 1.000 | 1.000 | 0.000 | 0.494 |
| 4×4 | 48 | 0.754 | 1.000 | 1.000 | 1.000 | 0.000 | 0.494 |
| 2×2 | 12 | 0.754 | 1.000 | 1.000 | 1.000 | 0.000 | 0.494 |
| 1×1 | 3 | 0.753 | 1.000 | 1.000 | 1.000 | 0.000 | 0.486 |
读这张表:
- 晴天和晴朗的夜晚在任何分辨率下都能分对,连 1×1 都够(整张图平均成一个颜色,)。如果世界里只有这两种场景,输入只要 3 个数。
- 城市夜景那一列决定了曲线的形状:32×32 全对,16×16 认出 78%,8×8 及以下全错(都被判成阴天)。准确率掉得最多的一步是 16×16 → 8×8(0.901 → 0.754)。这就是悬崖。按 Kian 的办法,这个任务”人还能分辨”的最小分辨率是 16×16,比全分辨率的输入小 4 倍。
- 全分辨率下人类代理是 0.943,和上限 0.95 几乎一样,剩下的误差全来自黄昏。这就是第 10 讲要讲的 Bayes error(不可避免的误差):标签本身就不确定,任何模型都消不掉。在真实任务里我们不知道 Bayes error 是多少,常用”人类水平”(human-level performance)当作它的估计。
真实项目里怎么做? 你不需要写规则。把几十张验证图缩小到三四个分辨率,自己看,或者请两三个同学标一下,花一个下午就够了。Fall 2017 的课件选了 64×64。课件没有写理由,合理的推测是:对真实照片来说,这个分辨率下人还能可靠地分辨白天和黑夜,输入又比原图小两个数量级。
2.4 模型怎么说:分辨率、架构和过拟合
人类代理告诉我们”信息在哪个分辨率还在”。那真正训练出来的模型呢?代码 01 演示 3 在 6 个分辨率上各训练两个模型:逻辑回归和一层隐藏层的网络 。训练集 8000 张,测试集 3000 张,全部用第 1 讲的 tiny_nn.train:
| 分辨率 | 模型 | 参数个数 | 训练准确率 | 测试准确率 | 城市夜景 | 人类代理 |
|---|---|---|---|---|---|---|
| 32×32 | 逻辑回归 | 3,073 | 0.779 | 0.735 | 0.664 | 0.943 |
| 32×32 | 网络 | 196,737 | 0.966 | 0.869 | 0.674 | 0.943 |
| 16×16 | 逻辑回归 | 769 | 0.775 | 0.740 | 0.521 | 0.901 |
| 16×16 | 网络 | 49,281 | 0.978 | 0.924 | 0.915 | 0.901 |
| 8×8 | 逻辑回归 | 193 | 0.753 | 0.735 | 0.569 | 0.754 |
| 8×8 | 网络 | 12,417 | 0.947 | 0.916 | 0.913 | 0.754 |
| 4×4 | 网络 | 3,201 | 0.823 | 0.798 | 0.633 | 0.754 |
| 1×1 | 网络 | 321 | 0.764 | 0.746 | 0.584 | 0.753 |
(4×4、2×2、1×1 的逻辑回归都在 0.738–0.750 之间,完整的表见脚本输出。)
先预测一下:逻辑回归在 32×32 上会比在 1×1 上好吗?
结果是不会。逻辑回归在所有分辨率上都差不多(0.735–0.750),和 1×1 的人类代理一个水平,城市夜景基本在猜。原因不在分辨率,而在模型:逻辑回归只能对像素做加权求和 ,而”某处有个小亮点”是一个位置不固定的特征。亮点出现在哪里都行,加权求和只能感受到它对整体亮度贡献的那一点点。给它再多像素也没用,信息在输入里,但模型够不着。
网络(一层 ReLU 隐藏层)好得多,而且出现了三个值得记住的现象:
- 最好的分辨率不是最大的。16×16 的网络 0.924,8×8 是 0.916,32×32 反而只有 0.869。32×32 的网络有 196,737 个参数,训练准确率 0.966、测试只有 0.869,这是典型的过拟合(第 6 讲):输入维度越大,同样 8000 张图”摊”到每个参数上的信息就越少。(8×8 和 16×16 之间相差 0.008,在随机波动范围内。草稿里换一组数据种子时,8×8 略好。)
- 8×8 的网络认出了 91.3% 的城市夜景,而 8×8 的人类代理一张都认不出。小亮点被平均后只剩 1/16 的凸起,人眼(阈值 0.1)看不出来,但网络能把很多像素上的微弱统计差异”攒”起来。所以人类代理是一个保守的参考,不是硬性的下限:它告诉你”在这个分辨率以上,信息肯定够”,但模型有时在更低的分辨率上也能做到。
- 计算量:分辨率每翻一倍,、第一层参数和每张图的乘加次数都变成 4 倍。从 32×32 降到 16×16 或 8×8,模型大小依次只剩 1/4、1/16,准确率反而都更高。
2.5 数据量和分辨率要一起决定
代码 01 演示 4 让网络只用前 500 / 2000 张训练图:
| 训练图张数 | 32×32 | 16×16 | 8×8 | 4×4 |
|---|---|---|---|---|
| 500 | 0.768 | 0.765 | 0.756 | 0.751 |
| 2,000 | 0.795 | 0.826 | 0.780 | 0.770 |
| 8,000 | 0.869 | 0.924 | 0.916 | 0.798 |
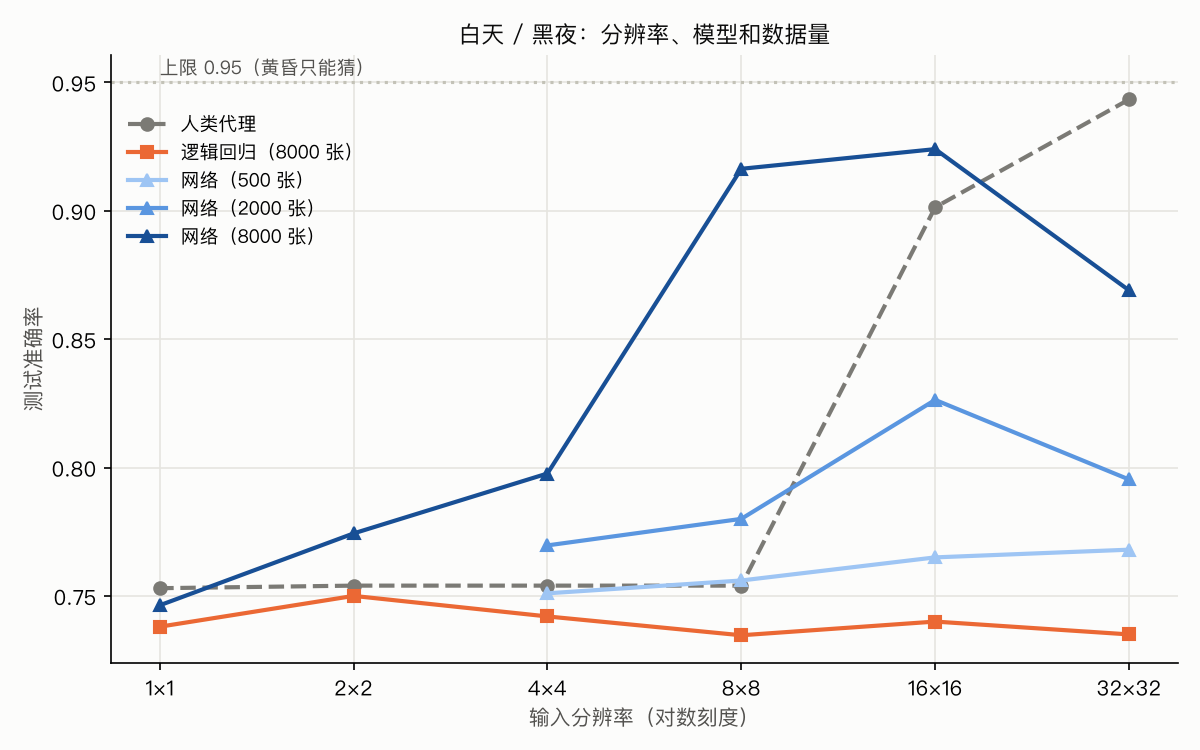
(这张图由 01_day_night_resolution.py 生成;没装 matplotlib 时脚本只打印表格。)
- 数据少的时候,分辨率高也是浪费。500 张图时四个分辨率都在 0.75–0.77,网络连”小亮点”这条线索都学不出来,只学会了”看天空亮不亮”。
- 数据越多,高分辨率越能发挥作用。从 500 张到 8000 张,32×32 涨了 0.101,4×4 只涨了 0.047。4×4 的图里小亮点的凸起只剩 1/64,几乎没有信息,数据再多也学不到多少。
- 但即使有 8000 张,32×32 仍然不如 16×16 和 8×8。“需要多少数据”和”输入多大”是同一个问题的两面:输入越大,要喂饱它的数据越多。五问里”数据”和”输入”挨在一起,道理就在这里。
实际做项目的顺序:先用”人眼看缩小的图”定一个候选范围(这里是 ≥ 16×16,再往下人就看不出了),再在这个范围附近做实验,比较两三个分辨率(这里发现 8×8 对模型也几乎一样好)。直觉给起点,实验做决定。
2.6 放在服务器上,还是放在手机上?
Fall 2017 课件在这个案例里还问了一个部署问题:模型(架构 + 训练好的参数)放在哪里运行?
| 放在服务器上(server-based) | 放在设备上(on-device) | |
|---|---|---|
| 好处 | App 很轻,模型可以很大 | 预测更快(不用上传图片),没网也能用,图片不离开手机 |
| 代价 | 每次都要上传图片,要联网、有延迟 | 模型必须小,手机的内存、算力和电量都有限 |
如果选择放在手机上,§2.4 那张表里的”参数个数”就成了硬约束。16×16 的网络有 49,281 个参数,32×32 的有 196,737 个:模型小了 4 倍,准确率反而更高。输入的设计不只影响准确率,也决定了模型能不能部署。 第 11 讲会把部署作为项目全周期的一部分来讲。
3. 案例 2:学校门禁的人脸验证 · Face verification
3.1 问题
Fall 2017 课件的场景:学校想在食堂、体育馆、游泳池门口用人脸验证学生证。 学生刷卡后,门口的摄像头拍一张照片,系统判断”这是不是学生证上的那个人”。
- 数据:每个学生一张照片,标着姓名(学生证照片);
- 输入:门口拍的照片 + 学生证上的照片。课件选的分辨率是 (412, 412, 3),比白天 / 黑夜大得多。想想为什么:区分两个人要靠五官的细节,而区分白天黑夜只要看整体亮度;
- 输出:(是本人)或 (不是)。
这种问题叫人脸验证(face verification):一对一,“是不是这个人”。另一个相关的问题叫人脸识别(face recognition / identification):一对多,“这是谁”(§3.6)。
3.2 最简单的办法:比像素
最直接的想法:把两张照片相减,算像素距离,小于某个阈值就算同一个人。课件立刻列出了它的问题:
- 背景、光照不同;
- 人会化妆、留胡子……
- 学生证照片可能是几年前拍的。
代码 02 造了一个能把这些问题量化的玩具人脸世界。每个人有一个 6 维的”身份向量” (脸型、五官)。每张照片还有一个 6 维的”干扰向量” (光照、姿态、表情),拍每张照片时都重新抽。照片的 100 个”像素”由一个固定的随机非线性函数生成:。模型只看得到 。
代码 02 演示 1 先做了一个方差分解:像素的总方差里,来自”是谁”的只占 33.3%,来自光照、姿态、表情的占 66.7%。 然后在 100 个新同学身上抽 2000 对”同一个人”和 2000 对”不同的人”,比较像素的平方距离:
| 平均 | 中位数 | 25% 分位 | 75% 分位 | |
|---|---|---|---|---|
| 同一个人 | 142.3 | 135.6 | 94.4 | 180.7 |
| 不同的人 | 197.8 | 192.9 | 149.7 | 240.9 |
两种配对的距离分布大面积重叠:20.9% 的”同一个人”配对,比一半以上的”不同人”配对离得还远。 无论阈值放在哪里,都会把很多本人拒之门外,或者把很多别人放进来。用最好的阈值,验证准确率只有 0.668(瞎猜是 0.5)。
问题的本质是:像素距离衡量的是”两张图长得像不像”,而我们要的是”是不是同一个人”。 我们需要另一种描述照片的方式,它只保留身份,扔掉干扰。
3.3 想法:把脸编码成一个向量
课件的方案:用一个深层 CNN 把每张照片编码成一个向量(课件里是 128 维),然后比较编码之间的距离:
  学生证照片 ──→ [深层 CNN] ──→ f(x₁) = (0.931, 0.433, 0.331, …, 0.039)   ← 128 维,提前算好存进数据库
                                                  ↘
                                                    距离 d = ‖f(x₁) − f(x₂)‖²  ──→  d < 阈值 ? → y = 1
                                                  ↗
门口拍的照片 ──→ [同一个 CNN] ──→ f(x₂) = (0.922, 0.343, 0.312, …, 0.024)两张照片过的是同一个网络(共享参数)。这种结构叫 Siamese network(孪生网络),最早用于签名验证(Bromley et al., 1993)。我们希望 满足:
注意这里输出的设计变了:网络的直接输出不再是”0 / 1”,而是一个编码。“是不是同一个人”由编码之间的距离和一个阈值决定。这就是 §1.4 说的”编码本身就是产品”。
3.4 怎样训练编码器:triplet loss
我们没有”每张脸的正确编码应该是多少”这种标签,只知道”哪些照片是同一个人”。Kian 的问题是:怎样把”同一个人近、不同人远”写成一个损失函数?
数据:学生证照片每人只有一张,不够教会网络”怎样编码一张脸”。所以要用公开的人脸数据集:很多人,每人多张照片,在不同光照、姿态、年龄下拍摄。编码器在这些人身上学会的是一种通用的本领,以后用在学校的学生身上(§3.5)。
三元组(triplet):每次取三张照片:
- A(anchor,锚):某个人的一张照片;
- P(positive):同一个人的另一张照片;
- N(negative):另一个人的照片。
我们想要 :负样本至少比正样本远一个间隔 。把”违反了多少”当成损失:
这就是 triplet loss(FaceNet,Schroff et al., 2015)。 的意思是:已经分开够了的三元组损失为 0,不再管它。
梯度是理解它在”推拉”什么的最好方式。记 、、,当损失大于 0 时:
梯度下降沿着负梯度走: 被拉向 , 被推离 , 往”离 近、离 远”的方向挪。这三个梯度再通过反向传播传回编码器的参数(代码 02 的 encoder_backward)。
两个容易忽略的细节,都和”网络会钻空子”有关:
- 为什么要 margin ? 如果 ,网络只要做到”负样本比正样本远一点点”就满足了。更糟的是,把所有编码都变成同一个点,,损失也是 0。这是一个零损失的”作弊解”:梯度下降不一定会走到那里,但损失函数里没有任何东西阻止它。
- 为什么要把编码归一化到单位长度? FaceNet 把每个编码都除以它的长度,放在单位球面上。如果不这样做,网络可以把所有编码一起放大 倍,距离就放大 倍,固定的 相对来说越来越小。损失就能靠”放大”而不是”分得更开”降下来(练习 5)。
代码 02 演示 2 训练了一个小编码器:100 → 64(ReLU)→ 16 → 归一化。训练数据是 300 个人、每人 8 张,用随机三元组,margin (FaceNet 用的值)。训练前先做梯度检验,相对误差是 6.55e-11,说明手写的反向传播是对的。然后在训练时从没见过的 100 个新同学上测试(每人 6 张):
| 表示 | 训练人群验证 | 新同学验证 | 新同学 one-shot 识别 | 不同人 / 同一人距离 |
|---|---|---|---|---|
| 像素距离(100 维) | 0.696 | 0.668 | 0.106 | 1.39 |
| 随机初始化的编码器(训练前) | 0.632 | 0.603 | 0.080 | 1.27 |
| triplet loss 训练后的编码器 | 0.986 | 0.965 | 0.800 | 10.07 |
| 上限:真实身份向量 | 1.000 | 1.000 | 1.000 | ∞ |
(验证的阈值在训练人群上选好,原封不动地用到新同学身上。one-shot 识别:每个新同学的第 1 张照片当”学生证照片”,其余照片去库里找最近的。100 个人里瞎猜的准确率是 1%。)
- 验证从 0.668 提到 0.965,识别从 0.106 提到 0.800。每个新同学只有一张注册照片,也没有重新训练任何东西。
- 对照组很重要:随机初始化的编码器(0.603 / 0.080)比像素还差一点。随机的非线性变换不会自己”扔掉光照”,是 triplet loss 教会了它哪些变化该忽略。
- 编码器在训练人群上(0.986)比新同学(0.965)好一点,但差距不大。说明它学到的是”怎样从照片里读出身份”这种通用的本领,而不是记住了 300 个人。
随机三元组很快就”太容易”了。 训练记录显示:第 0 步时一批里有 47.7% 的三元组有梯度,第 500 步时是 0.0%。随便抽的”另一个人”通常本来就离得很远,损失为 0,什么也学不到。FaceNet 因此提出 semi-hard 负样本挖掘:用当前的编码器算一下距离,专门挑”比正样本远、但还没远出 margin”的负样本。代码 02 演示 3 比较了它和损失函数的几种改法:
| 损失函数 / 三元组 | 新同学验证 | 识别 top-1 | 编码的分散程度 | 训练结束时仍有梯度 |
|---|---|---|---|---|
| 完整的 triplet loss(,随机三元组) | 0.965 | 0.800 | 0.241 | 1.1% |
| 同上,但用 semi-hard 负样本 | 0.961 | 0.844 | 0.244 | 5.4% |
| 去掉 margin() | 0.952 | 0.652 | 0.092 | 0.6% |
| 只拉近同一个人: | 0.567 | 0.032 | 0.003 | 100.0% |
- semi-hard 挖掘让更多三元组提供梯度(5.4% 对 1.1%),识别从 0.800 升到 0.844,验证基本不变。在这个只有 300 人的小世界里差别不大。FaceNet 的训练集有约 800 万个不同的人,论文强调在那样的规模下,怎样挑三元组对收敛至关重要。
- 去掉 margin:验证几乎不变,但 one-shot 识别从 0.800 掉到 0.652,编码也挤在一起(分散程度 0.092)。识别要在 100 个人里挑最近的那个,人和人之间需要留出余量。
- 只拉近、不推开:网络找到了一个”作弊”的解,把所有照片都映射到几乎同一个点。损失几乎为 0,编码的分散程度塌缩到 0.003,验证 0.567、识别 0.032,和瞎猜差不多。这叫表示坍缩(representation collapse)。
最后一行是整讲最重要的一个例子:损失函数定义了任务。 你写下的每一项都在告诉网络”什么是好”。少了”推开”那一项,“所有人都一样”就成了完美答案,梯度下降一定会找到它。
3.5 为什么不把它当成”每个学生一类”的分类问题?
一个自然的想法:学校有 2000 个学生,就训练一个 2000 类的 softmax 分类器,看门口的照片属于哪一类。为什么不这样做?
- 每类只有一两张照片:学生证照片每人一张,训练一个 2000 类的分类器远远不够(这叫 one-shot learning 问题)。
- 类别会变:每年有新生入学、老生毕业。分类器的输出层是”每个学生一个单元”,每来一个新生,就要改网络结构、重新训练。编码的方案只需要把新生的照片过一遍编码器、存下一个向量。代码 02 里 100 个新同学就是这样”入学”的。
- 我们真正想要的是”距离”:验证问的是”这两张照片是不是同一个人”,不管这个人是谁。编码 + 距离直接回答这个问题。
不过有一个细节要说清楚:训练编码器时,用”分类”其实是可以的,而且很常用。在公开人脸库的几万个训练用的人上训练一个分类器(比如 ArcFace,Deng et al., 2019,就是在分类损失上加了角度间隔),然后拿掉最后的分类层,用倒数第二层当编码。部署时永远是”编码 + 距离”,因为部署时遇到的人不在训练的类别里。triplet loss 和分类式的损失,是训练编码器的两条路线。
3.6 延伸:识别、聚类,以及无处不在的编码
同一个编码器 ,后面接不同的”小算法”,就是不同的产品(课件里的三个场景):
- 验证(verification): 阈值?
- 识别(identification):门口没有刷卡,只拍了一张照片,“这是谁?“在数据库里找编码最近的人,也就是 K 近邻(K-nearest neighbors)。
- 聚类(clustering):手机相册里有几千张照片,没有任何标签,想把同一个人的照片归到一起。对所有编码做 K-means。
代码 02 演示 4 把 10 个新同学的 60 张照片用 k-means 分成 10 簇:
| 表示 | 纯度(每簇按多数人算对) |
|---|---|
| 像素 | 0.583 |
| triplet 编码 | 0.983 |
| 上限:真实身份向量 | 1.000 |
用像素聚类,簇是按”光照、姿态相似”聚起来的;用编码聚类,几乎完美地按人分组。没有任何新标签,也没有重新训练。课件在这一页还加了一句很实际的提醒:“也许我们需要先检测出人脸?“真实的照片里人脸只占一小块,真实系统是一条流水线:先用检测器把脸找出来、裁剪、对齐(第 14 讲),再送进编码器。
“学一个编码,让相似的东西靠近、不同的东西远离”后来成了深度学习最通用的套路之一。它的名字叫度量学习(metric learning)或对比学习(contrastive learning):
- SimCLR(Chen et al., 2020)把同一张图的两种随机变换当作”正样本对”,不需要任何标签就能学到好的图像编码;
- CLIP(Radford et al., 2021)把图片和描述它的文字当作正样本对,学出图片和文字共享的编码空间;
- 句子、商品、用户、歌曲……今天的检索和推荐系统几乎都建立在编码上(§6.2)。
这些方法都要面对 §3.4 里的那个敌人:坍缩。需要负样本(或者别的机制)来防止”所有东西都一样”。
一个不能省略的提醒:人脸识别是最容易被滥用的技术之一。它涉及隐私和知情同意;而且已有研究发现,商业人脸分析系统在不同肤色、性别的人群上错误率差别很大(如 Buolamwini & Gebru, 2018,研究的是性别分类)。如果你的项目用到人脸,“数据从哪里来、征得同意了吗、在不同人群上表现一样吗”本身就属于五问里的”数据”那一问。
3.7 五问回顾
| 问题 | 人脸验证的答案 |
|---|---|
| 数据 | 公开人脸库(很多人、每人多张)训练编码器;学生证照片只用来”注册” |
| 输入 | 一张人脸(课件:412×412×3;实际系统先检测、裁剪、对齐) |
| 输出 | 一个编码向量;“是不是同一个人”由编码的距离 + 阈值决定 |
| 架构 | 深层 CNN(第 12–14 讲),两张照片共享同一个编码器 |
| 损失 | triplet loss(margin + 推开负样本 + 归一化),或分类式损失(ArcFace) |
4. 案例 3:艺术风格迁移 · Neural style transfer
4.1 问题:没有标签,只有两张图
任务:给一张内容图(比如你拍的一张照片)和一张风格图(比如梵高的《星月夜》),生成一张新图:内容是你的照片,“画法”是梵高的。这是 Gatys、Ecker 和 Bethge 在 2015 年提出的方法(A Neural Algorithm of Artistic Style)。
先用五问试试:
- 数据? 课件的回答很有意思:“随便什么数据都行”。我们没有”这张照片画成梵高风格应该长什么样”的标签,也不需要。
- 输入?输出? 输入是内容图 和风格图 ,输出是生成图 。
- 架构? 我们需要一个”很懂图像”的网络,于是拿一个在 ImageNet 上训练好的分类网络来用(Gatys 用的是 VGG-19)。图像在这个网络里前向传播时,查看各层的激活值,就能得到它的内容和风格信息。
- 损失? 这是整个方法的核心。
4.2 什么是”内容”,什么是”风格”?
内容:某一层的激活值 ,记录的是”图里哪里有什么”。较深的层描述的是物体和布局,不太关心精确的像素值。
风格:同一层激活值的 Gram 矩阵。设第 层有 个通道,每个通道是一张 的特征图:
第 个元素衡量的是:第 种图案和第 种图案,在同一个位置同时出现的平均程度。比如”短的斜线”和”橙色”总是一起出现,这就是一种笔触。关键在于,对所有位置 求和之后,“在哪里”的信息被扔掉了,只剩下”有哪些图案、哪些图案经常一起出现”。这正是我们直觉里的”风格”或”纹理”。
代码 03 演示 1 验证了这一点。代码里没有 VGG,“预训练网络”是一个固定的、随机初始化的小卷积层:8 个 3×3 滤波器加 ReLU。研究表明,随机滤波器的特征统计已经能抓住不少纹理信息(Ustyuzhaninov et al., 2016)。内容表示取这一层特征的 4×4 平均池化,用来代替”更深的一层”。
| 比较 | 内容表示的相对距离 | 风格表示(Gram)的相对距离 |
|---|---|---|
| 房子 vs 右移 6 像素的房子 | 0.960 | 0.028 |
| 房子 vs 斜条纹 | 0.879 | 0.317 |
同一座房子平移 6 个像素:内容表示几乎完全变了(“哪里有什么”变了),风格表示只变了 0.028。房子和条纹:两种表示都差得很远。
4.3 损失函数,以及那个反转
有了两种表示,损失就很自然了:
(注意有两个 : 是 Gram 矩阵,括号里的 是生成图。Coursera 作业也是这样写的,读公式时别混。Gatys 的原文写成 ,并在多个层上算风格损失。各种实现的归一化常数不同,Coursera 作业里的也不一样,但结构都是这样。)
然后是这个案例最重要的一点。课件上的原话是:“We are not learning parameters by minimizing L. We are learning an image!”
| 训练一个网络 | 风格迁移 | |
|---|---|---|
| 固定不动的 | 数据 | 网络参数(预训练好的) |
| 用梯度下降改的 | 参数 | 生成图的像素 |
| 更新公式 |
梯度下降并不关心它在改什么。给它一个变量和”损失对这个变量的梯度”,它就去改那个变量。反向传播也一样:平时它停在第一层的 ,这里多走一步,走到 (对输入像素的梯度)。
4.4 实验:从噪声画出一座带条纹的房子
代码 03 演示 2 从一张灰色噪声图出发,用 Adam 改像素 800 步。每一步之后把像素裁剪回 [0, 1](像素必须是合法的亮度)。对像素的梯度先做了数值检验,最大相对误差 4.12e-08。
| 损失函数 | :开始 → 结束 | :开始 → 结束 |
|---|---|---|
| 只用内容损失 | 1.1682 → 0.0001 | 0.4185 → 0.5312 |
| 只用风格损失 | 1.1682 → 1.2337 | 0.4185 → 0.0039 |
| 内容 + 风格() | 1.1682 → 0.0560 | 0.4185 → 0.1617 |
| 内容 + 风格() | 1.1682 → 0.4361 | 0.4185 → 0.0364 |
| 内容 + 风格() | 1.1682 → 1.0892 | 0.4185 → 0.0047 |
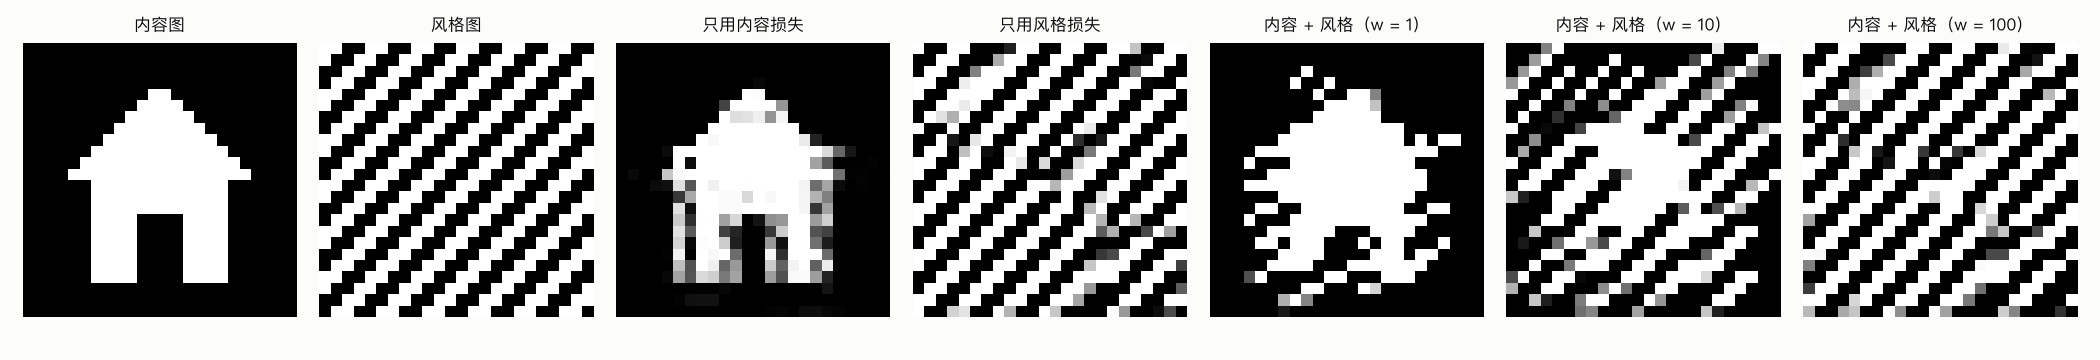
(这张图由 03_optimize_the_input.py 生成;终端里也会打印同样内容的字符画。)
- 只用内容损失:从噪声重建出了房子(边缘毛糙,因为内容表示是 6×6 的粗粒度)。
- 只用风格损失:满屏的斜条纹,但没有房子。Gram 矩阵不记录位置,只要求”斜线图案的统计”对得上。条纹在哪里断开、在哪里拐弯,取决于初始噪声。
- 两者都用:权重 决定了”像房子”和”像条纹”之间的取舍。 时基本是房子; 时房子的轮廓还在,到处都长出了条纹; 时几乎只剩条纹。没有”正确”的权重,损失函数里的权重就是你对”想要什么”的定义。(老实说: 的这三个值,是我在草稿里看到 几乎看不出条纹之后才选的,见代码 README。)
- 程序最后检查了:8 个滤波器在 5 次优化前后完全相同。
Gatys 的方法每生成一张图都要跑几百上千步优化(课件上写的是”2000 次迭代之后”),很慢。后来 Johnson、Alahi 和 Fei-Fei(2016)把问题又”翻”了回去:训练一个网络,输入内容图、一次前向传播直接输出风格化的图,损失用的仍然是上面的 (他们叫 perceptual loss)。这样每种风格要训练一次,但之后生成一张图只要一次前向传播。“优化输入”还是”训练参数”,本身就是一个设计选择。
4.5 同一招的其他用法:可视化与对抗样本
“固定参数、对输入求梯度、改输入”还有两个重要的用法。代码 03 演示 3 先训练一个白天 / 黑夜分类器:8×8 输入,网络 [192, 16, 1],验证准确率 0.844。然后:
(a) 网络心中的”夜晚”长什么样? 从一张全灰的图出发,改像素让网络输出”夜晚”的 logit 最大(再反过来做一次”白天”)。
- “最像夜晚”的图,天空亮度 0.31;“最像白天”的图,天空亮度 0.89。“天空暗不暗”正是这个世界里最强的线索。
- 但两张图都满是亮暗相间的斑点(亮度标准差 0.34 和 0.36),“最像白天”的天空还是黄白色的,不像任何一张真实的照片。网络却给出了接近 0 和 1 的概率。分类器只学会了”往哪边推概率”,没有学会”真实的照片长什么样”。这种可视化方法叫特征可视化(feature visualization)。实际使用时要加正则项让图保持”自然”(第 21 讲)。
(b) 对抗样本:取 473 张被正确判为白天的验证图,每个像素沿梯度的符号方向改 ():
| (像素值 0–1) | 约等于 0–255 里的 | 被翻成”夜晚”的比例 |
|---|---|---|
| 0.01 | 2.6 | 33.0% |
| 0.02 | 5.1 | 62.8% |
| 0.05 | 12.8 | 95.6% |
每个像素只改约 5 个灰度级,肉眼几乎看不出来,就有 62.8% 的白天照片被判成夜晚。这就是对抗样本(adversarial examples;Szegedy et al., 2014;Goodfellow et al., 2015)。第 18 讲会解释它为什么存在、怎样防御。
风格迁移、可视化、对抗样本,三者的数学是同一个:固定参数,对输入求梯度,改输入。区别只在于损失函数写的是什么。又一次,损失函数定义了任务。
4.6 五问回顾
| 问题 | 风格迁移的答案 |
|---|---|
| 数据 | 不需要标注数据:一张内容图、一张风格图,加一个预训练好的网络 |
| 输入 / 输出 | 内容图 + 风格图 → 生成图。被优化的”变量”是生成图本身 |
| 架构 | 预训练 CNN(VGG),参数固定,只用来提取特征 |
| 损失 | 内容损失(激活值之差)+ × 风格损失(Gram 矩阵之差) |
5. 案例 4:触发词检测 · Trigger word detection
5.1 问题
“Hey Siri”、“OK Google”、“Alexa”:设备一直在听,听到某个触发词(trigger word / wake word)就醒来。Coursera C5 的编程作业用的触发词是 “activate”。
这个任务有几个特点,会直接影响五问的答案:
- 一直在运行:必须小、快、省电,通常在设备上运行(§2.6 的取舍又来了);
- 两种错误的代价不同:说了”activate”没反应(漏检)很烦人;没说却醒了(误唤醒,false alarm)更烦人,而且可能涉及隐私;
- 正样本极少:一天 24 小时的声音里,触发词只占几秒钟。
5.2 输入和输出:为什么输出是一个序列
输入:一段 10 秒的音频,转成频谱图(spectrogram):每个时间片上各个频率的能量。在 Coursera 作业里,它是 个时间步 × 101 个频率。
输出:一个直觉的设计是”这 10 秒里有没有 activate”,一个 0 / 1。但设备需要知道什么时候响应。所以作业的设计是每个输出时间步一个 0 / 1:,。在线运行时,网络每处理一小段音频,就输出一个”刚才是不是说完了 activate”的概率。
损失:每个时间步一个二元交叉熵,对所有时间步取平均(或求和):
架构:作业用的是一维卷积加两层 GRU(一种 RNN),第 15–16 讲会讲。代码 04 用了一个简单得多的替代品:在每个时间步看过去 16 帧 × 8 个频带,送进一层隐藏层的网络 [128, 32, 1],所有时间步共享参数。这相当于最简单的一维卷积。“标签怎么标”的道理是一样的。
5.3 数据:录一点,合成很多
带逐帧标签的音频从哪里来? 请人一段段地听,标出”activate 在第几毫秒结束”,又慢又贵。Coursera 作业的做法是合成:
- 录一些”activate”(来自不同的人);
- 录一些别的词(负样本),特别是听起来有点像的;
- 录一些背景噪声(咖啡馆、街道、家里),每段 10 秒;
- 随机把几个正样本词和负样本词叠加到背景上,位置互不重叠。
因为词是我们自己放进去的,每个词在哪一帧结束是精确知道的,标签免费且精确。想要多少段都可以。
代码 04 的玩具音频世界是这样的:一段 10 秒 = 100 帧,每帧 8 个频带。activate 有 7 帧,另有 12 种别的词,其中 3 种的前 3 帧和 activate 一模一样(像 “active”、“actually” 这种开头相同的词)。每次”录音”都有说话人差异、语速变化、音量变化、渐入渐出。背景噪声和词的能量差不多大。训练用 30 个 activate 录音和 48 个别的词,测试用另一批说话人。
代码 04 演示 1 把一段合成音频画了出来(A = activate,n = 别的词):
  能量        :.==.::..:.-.-=:::::+-.-.:-.-----=:=:-- .-:=--==:=+*:-+:= .:+::::-: .-::::-....:*@@+:-:---.=:-=:+::=
  放了什么词  ................................................AAAAAAAA........................nnnn................
  标签 k = 1  ........................................................1...........................................
  标签 k = 5  ........................................................11111.......................................
  标签 k = 10 ........................................................1111111111..................................
合成 800 段(2.2 小时)训练音频,里面一共有 1234 个 activate、80,000 个带标签的时间步。所有这些都来自 30 + 48 个录音。
5.4 标签:只标 1 个,还是标 k 个?
上面那张图里有三种标签方式。最”准确”的似乎是 :只在 activate 结束后的那一个时间步标 1,毕竟”刚说完”只发生在一个时刻。Coursera 作业却在结束后连续标 50 个 1(共 1375 个输出时间步)。为什么?
先看正样本比例(代码 04 演示 1):
| 标签方式 | 正样本比例 | “永远输出 0”的逐帧准确率 |
|---|---|---|
| 结束后 个时间步标 1 | 1.54% | 98.46% |
| 结束后 个 | 7.52% | 92.48% |
| 结束后 个 | 14.57% | 85.43% |
时,一个”永远输出 0”、什么都没学会的模型,逐帧准确率有 98.46%。这是第一个警报:在这种任务上,准确率几乎没有意义。
代码 04 演示 2 用三种标签分别训练(800 段训练音频),在 1 小时(360 段)新说话人的音频上测试:
| 逐帧准确率 | “永远输出 0” | 预测为 1 的比例 | precision | recall | 词后最大概率(平均) | |
|---|---|---|---|---|---|---|
| 1 | 99.12% | 98.60% | 1.07% | 0.745 | 0.568 | 0.555 |
| 5 | 97.10% | 93.14% | 6.21% | 0.819 | 0.741 | 0.897 |
| 10 | 94.91% | 86.71% | 12.05% | 0.840 | 0.762 | 0.916 |
如果只看逐帧准确率, 最好(99.12%)。但它只比”永远输出 0”高 0.5 个百分点。而且 不同,“永远输出 0”的基准也不同,三个准确率根本没法直接比。正样本很少时,要看 precision(预测为 1 的里面有多少真是 1)和 recall(真的 1 里有多少被找到了)。这是第 10 讲的内容。
的模型对很多 activate 没反应:每个 activate 之后,它给出的最大概率平均只有 0.555( 时 0.897)。为什么?我原以为原因是”词的结尾是模糊的,概率摊在相邻几帧上”。但代码打印的”结束前后每一帧的平均概率”并不支持这个猜测:
| −1 | +0 | +1 | +2 | +3 | +4 | +5 | +6 | +7 | +8 | |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 0.05 | 0.03 | 0.55 | 0.07 | 0.01 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| 5 | 0.07 | 0.13 | 0.63 | 0.74 | 0.80 | 0.75 | 0.68 | 0.12 | 0.02 | 0.00 |
的平均概率集中在 +1 那一帧,相邻帧都很低。真正的情况是两极分化:57% 的 activate 最大概率 > 0.5,29% 的 < 0.2。模型学会了一个很”窄”的检测器,只在”这个词恰好在 1 帧之前结束”时响应,换了说话人(长度、音量不同)就常常对不上。同一个模型在训练用的说话人上有 76% 的 activate 能过 0.5,到了新说话人只剩 57%; 的模型两边都是 94%。
好在哪里?每个词贡献 5 个正样本(训练集一共 6,014 个, 只有 1,234 个),而且是 5 个不同的对齐位置。模型学到的是”最近说过这个词”这种更宽容的模式,对新说话人也稳得多。
产品真正在乎的指标:说了 activate 之后 1.5 秒内有没有反应(唤醒召回率),以及每小时误唤醒几次:
| 阈值 0.5:召回率 | 误唤醒 / 小时 | 误唤醒 ≤ 10 / 小时的阈值(验证集上选) | 召回率 | 误唤醒 / 小时(测试) | |
|---|---|---|---|---|---|
| 1 | 0.612 | 63 | 0.82 | 0.428 | 29 |
| 5 | 0.941 | 190 | 0.96 | 0.669 | 20 |
| 10 | 0.958 | 248 | 0.98 | 0.570 | 14 |
- 阈值 0.5 下的比较会误导人: 召回率高很多,误唤醒也多了 3 倍,看起来像一个取舍。但 大的模型整体输出更高的概率,同一个阈值对它们意味着不同的东西。公平的比较是固定误唤醒次数:在验证集上把阈值调到”每小时误唤醒 ≤ 10 次”, 的召回率只有 0.428,而且误唤醒(29 次)比 (20 次)还多。 全面胜出。
- 也不是越大越好:模型只看 16 帧, 时,对较长的录音,结束后第 8–10 帧的窗口里已经装不下整个词了。 越大,“反应”也可能来得越晚。 召回率低一些(0.570),误唤醒也少一些(14),大致在同一条权衡曲线上。重要的是别只标 1 个。
- 测试集上的误唤醒都超过了预算:在验证集上定的是 10 次,到测试集变成了 29、20、14 次。阈值是在”训练用的说话人”上调的,换成新的说话人就不一定满足了。这是第 10 讲”数据不匹配”的一个小例子。
- 这个玩具模型的误唤醒仍然很多,真实产品要求远低于每小时 1 次。真实系统用更大的模型、多得多的数据,还会专门收集难的负样本。
5.5 数据越多越好,而且几乎免费
代码 04 演示 3 只改合成的训练段数(“召回率 @ ≤10” 是”误唤醒 ≤ 10 次 / 小时”时的召回率):
| 训练段数 | 小时 | 预测为 1 的比例 | 召回率 @ 0.5 | 召回率 @ ≤10 | |
|---|---|---|---|---|---|
| 25 | 0.07 | 1 | 0.45% | 0.259 | 0.168 |
| 25 | 0.07 | 5 | 4.36% | 0.796 | 0.244 |
| 100 | 0.28 | 1 | 0.72% | 0.406 | 0.261 |
| 100 | 0.28 | 5 | 5.17% | 0.867 | 0.519 |
| 400 | 1.11 | 5 | 5.99% | 0.931 | 0.638 |
| 800 | 2.22 | 1 | 1.07% | 0.612 | 0.428 |
| 800 | 2.22 | 5 | 6.21% | 0.941 | 0.669 |
| 1600 | 4.44 | 1 | 1.06% | 0.606 | 0.461 |
| 1600 | 4.44 | 5 | 6.14% | 0.945 | 0.699 |
- 数据少时,“只标 1 个”的问题最严重:25 段、 的模型只在 0.45% 的时间步上输出 1(真实约 1.5%),阈值 0.5 下的召回率只有 0.259,明显偏向”永远输出 0”。同样 25 段, 的召回率是 0.796。
- 合成的数据越多越好: 时,从 25 段到 1600 段,召回率(误唤醒 ≤ 10 次)从 0.244 涨到 0.699。所有训练音频都来自同一批 30 个 activate 录音:同一个词被放到不同的背景、不同的位置,模型就学会了”不管背景是什么,认的是这个词”。不过 800 → 1600 段已经涨得很慢了,再合成也造不出新的说话人。
- 标签策略比多收一倍数据更值钱:在 800 段时,把 换成 ,召回率涨 0.242; 时把数据从 800 段翻倍到 1600 段,只涨 0.034。
5.6 “专家的建议能省下几个月”
据 2018 年录像的提纲,Kian 讲这个案例时强调过一个观点:有经验的人的一句建议,可能省下你几个月的摸索。(本讲义没有逐字核对录像,这里只转述大意。)放到这个案例里,这样的建议就是”在词后标一串 1”、“用合成造数据”、“测试集要用真实录音”。代码 04 把这个观点变成了数字:一个标签上的改动,效果超过把数据翻倍。
这也是为什么第 10、11 讲会花大量篇幅讲”怎样决定下一步做什么”。在深度学习项目里,最贵的资源是时间。知道”该在哪里使劲”,比”使更大的劲”重要。
5.7 五问回顾
| 问题 | 触发词检测的答案 |
|---|---|
| 数据 | 合成:正样本词 + 负样本词 + 背景噪声,随机叠加,标签自动生成。测试最好用真实录音 |
| 输入 | 10 秒音频的频谱图(作业里是 5511 × 101) |
| 输出 | 每个时间步一个 0 / 1(作业里 ),触发词结束后连续标 k 个 1(作业里 50 个) |
| 架构 | 一维卷积 + GRU(第 15–16 讲),必须能在设备上实时运行 |
| 损失 | 每个时间步的二元交叉熵求平均;评估看唤醒召回率和每小时误唤醒,而不是逐帧准确率 |
6. 贯穿始终的”编码”,以及今天的五问 · Encodings everywhere
6.1 四个案例里的编码
| 案例 | 编码是什么 | 它的作用 |
|---|---|---|
| 白天 / 黑夜 | 隐藏层的 64 个激活值 | 把”某处有小亮点”这种位置不固定的线索变成可以线性读出的特征(逻辑回归做不到) |
| 人脸验证 | ,单位长度的 16 维(FaceNet 128 维)向量 | 编码本身就是产品:验证、识别、聚类都只是”编码 + 距离” |
| 风格迁移 | 预训练网络各层的激活值,以及它们的 Gram 矩阵 | 用一个”很懂图像”的网络的编码,来定义什么叫内容、什么叫风格 |
| 触发词 | 网络对”最近 1.6 秒声音”的隐藏层表示 | 把一段有噪声、语速不定的声音,变成”刚才说没说 activate” |
一个好的编码有两个特点。第一,它保留了和任务有关的信息,扔掉了无关的变化(光照、背景、说话人)。第二,它常常可以复用:同一个人脸编码器用于验证、识别、聚类;同一个 ImageNet 网络的编码可以用于风格迁移,也可以用于迁移学习(第 13 讲)。
6.2 补充:用五问设计一个 embedding 检索系统
本小节是本讲义的补充,不是原课内容。Fall 2025 的这一讲标题是 “Key AI Concepts Through Case Studies”,可能加入了更新的案例,但具体内容不公开,这里不做猜测。
假设你要给一个在线课程平台做”用一句话搜索课程笔记”的功能。用户输入”为什么深层网络的梯度会消失”,系统要找出最相关的几段笔记,哪怕笔记里没有出现”梯度会消失”这几个字。
| 问题 | 设计 | 和本讲的哪个案例相似 |
|---|---|---|
| 数据 | (查询, 相关段落) 配对:可以来自用户的点击日志,也可以请人标几百对做评估;还可以用大模型为每段笔记生成可能的问题(合成数据) | 触发词:合成标签 |
| 输入 | 一段文字(查询或笔记段落),切成 token | |
| 输出 | 一个编码向量;检索 = 在所有笔记的编码里找离查询最近的 个 | 人脸识别:K 近邻 |
| 架构 | 一个预训练的文本编码器(Transformer,第 17 讲)在这些配对上微调;查询和段落可以共用一个编码器,也可以用两个(“双塔”,two-tower) | 人脸:Siamese 网络;风格迁移:用预训练网络 |
| 损失 | 对比损失:一个查询和它的相关段落要近,和同一批里其他查询的段落要远(in-batch negatives,Karpukhin et al., 2020 的 DPR 就是这样做的),本质上和 triplet loss 是一家 | 人脸:triplet loss;防止坍缩 |
| 评估 | recall@K:相关段落有没有出现在前 个结果里。不要用”编码之间的平均距离”这类和产品无关的数 | 触发词:看产品指标,不看逐帧准确率 |
你会发现,五问里几乎每一个答案,都能在本讲的四个老案例里找到”原型”。这就是这一讲想教的直觉:工具在变(CNN → Transformer,triplet → in-batch 对比学习),但”数据从哪来、输出是什么、损失是不是在衡量你在乎的东西”这些问题没有变。
6.3 一张随身清单
拿到一个新问题,在写代码之前问自己:
- 数据:从哪来?标签怎么得到,能不能合成?有没有”碰巧和标签相关”的偏差?测试数据和真实使用时的数据一样吗?
- 输入:人在多小的分辨率 / 多短的片段下还能完成任务?更大的输入需要更多的数据。
- 输出:真正的问题是”有哪些”、“哪一个”、“是不是同一个”、还是”什么时候”?输出是一个数、一个编码、还是一个序列?
- 架构:输入有什么结构(局部性、顺序)?有没有现成的预训练网络可以用?要在哪里运行?
- 损失:它有没有”作弊”的解(坍缩、永远输出 0)?它的权重是不是反映了你的偏好?
- 评估(第六问):用什么数字判断好坏?这个数字和产品真正在乎的东西一致吗?
7. 小结 · Summary
- 模型 = 架构 + 参数。参数由梯度下降去找,你能设计的是数据、输入、输出、架构、损失。Kian 的五问就是把这五样逐一想清楚。
- 改输出就是改任务:三个 sigmoid(“有哪些”)和一个 softmax(“哪一个”)用的是同样的网络,回答的是不同的问题。
- 白天 / 黑夜:用”缩小了人还能不能分辨”估计分辨率。人类代理在 16×16 → 8×8 之间跌下悬崖(0.901 → 0.754),全分辨率时接近上限 0.95(黄昏只能猜,这就是 Bayes error)。模型方面有两点:逻辑回归在所有分辨率上都停在 0.735–0.750,因为它够不着位置不固定的线索;网络在 16×16 最好(0.924),32×32 过拟合(0.869)。分辨率、数据量和模型要一起决定,直觉给起点,实验做决定。
- 人脸验证:像素距离不行,像素方差里身份只占 33.3%。改为学一个编码 ,比较编码之间的距离。用 triplet loss 训练:。在新同学上,验证从 0.668 提到 0.965,one-shot 识别从 0.106 提到 0.800,而且不需要重新训练。去掉”推开”那一项,编码会坍缩(识别 0.032)。部署时不当分类问题做;训练编码器时可以用 triplet,也可以用分类式损失。
- 风格迁移:内容 = 激活值,风格 = Gram 矩阵(平移 6 像素只变 0.028)。固定参数、优化像素;损失里的权重就是你对”想要什么”的定义。同一招还能用来做特征可视化和构造对抗样本(每像素改 0.02 就翻转 62.8% 的预测)。
- 触发词检测:输出是一个序列。数据靠合成,标签免费且精确。“只标 1 个”时,模型的反应两极分化,换了说话人就不稳。逐帧准确率会骗人(“永远输出 0”就有 98.6%)。要在固定误唤醒次数下比较召回率: 是 0.669, 是 0.428。改标签的收益比把数据翻倍还大。
- 编码 / embedding 贯穿所有案例,也是今天检索、推荐、多模态系统的核心。损失函数定义了任务:网络会认真地学会你写下的东西,包括你没想到的捷径。
8. 常见误区 · Common pitfalls
- “输入分辨率越高越好,信息更多。” 信息多了,参数和需要的数据也多了。代码 01 里 32×32 的网络(0.869)不如 16×16(0.924),因为同样 8000 张图喂不饱 196,737 个参数。
- “人在这个分辨率下看不出来,模型一定也不行。” 人类代理是保守的参考。8×8 的网络认出了 91.3% 的城市夜景,人类代理一张都没认出来。反过来,人能看出来,模型也不一定行:逻辑回归在任何分辨率下认城市夜景的准确率都只有 0.34–0.66,接近瞎猜。
- “准确率 99% 就是好模型。” 正样本只有 1.5% 时,“永远输出 0”就有 98.5%。要看 precision / recall,或者产品指标(召回率、每小时误唤醒),并且在相同的误唤醒次数下比较(第 10 讲)。
- “人脸识别就是一个类别很多的分类问题。” 部署时类别会变、每类只有一两张照片,所以用”编码 + 距离”。(训练编码器时用分类式损失是可以的,§3.5。)
- “损失降到 0 就说明学好了。” “只拉近同一个人”的损失几乎为 0,模型却把所有人映射到同一个点。先问自己:这个损失有没有作弊的解?
- “训练就是改参数。” 风格迁移、特征可视化、对抗样本改的都是输入。梯度下降只需要”一个变量 + 损失对它的梯度”。
- “标签就是事实,越精确越好。” 触发词”只在结束的那一帧标 1”最”精确”,却让模型学得最差。标签是你和模型之间的约定,要设计成模型能学、而且对产品有用的样子。
- “合成数据是’假’数据,不值得用。” 合成数据给了触发词检测精确的标签和几乎无限的数量(25 → 1600 段,召回率 0.244 → 0.699)。要注意的是它和真实数据的差距:开发集 / 测试集最好用真实数据(第 10 讲)。
9. 练习 · Exercises
练习 1(五问练习)。一家停车场想用安装在灯杆上的摄像头判断每个车位是否有车,结果显示在手机 App 上。用五问设计一个方案:数据从哪来、标签怎么得到?输入是整张图还是每个车位裁出来的小图?多大?输出是什么?用什么架构、什么损失?有没有你预见到的偏差?
参考答案
(开放题,下面是一种合理的设计。)
- 数据:从现有的摄像头录像里每隔几分钟截一帧,覆盖白天 / 夜晚、晴天 / 雨雪、不同季节。标签可以半自动得到:先人工标少量帧,再利用”车停着时画面在几分钟内几乎不变”这一点,把一个标签传播到相邻的帧。偏差:只在晴天白天采集,模型到了夜晚和雨天就不行(§2.2 的”城市夜景”问题)。
- 输入:每个车位位置固定,可以按事先画好的框把车位裁出来,每个车位一张小图。用 §2.3 的办法定分辨率:缩小到几种尺寸,看人还能不能分辨”有车 / 没车”。这类问题通常几十像素见方就够了,远小于整张图。
- 输出:每个车位一个 sigmoid(0 / 1)。如果一次输入整张图,就是”每个车位一个 sigmoid”,即 §1.3 的多标签。
- 架构:小的 CNN(第 12 讲),或在预训练网络上做迁移学习(第 13 讲)。如果要在摄像头端运行,就要小模型。
- 损失:二元交叉熵。评估:每个车位的准确率之外,还要看”App 显示有空位但其实没有”的比例,那才是用户最在乎的。
练习 2(数参数和计算量)。输入是 64×64×3 的图。(a) 逻辑回归有多少个参数?(b) 网络 有多少个参数?每张图的前向传播大约要做多少次乘加?(c) 把输入换成 16×16×3,(a)(b) 的数字分别是多少?参数个数缩小了几倍?(d) 人脸验证用的 412×412×3 输入, 是多少?
参考答案
(a) ,参数 。 (b) 个参数;乘加次数约为权重个数, 次。 (c) :逻辑回归 769 个参数;网络 个参数(和代码 01 的表一致),乘加 49,216 次。边长缩小 4 倍, 和参数都缩小约 倍。 (d) 。如果用全连接网络,第一层就有几千万个参数,这是第 12 讲用卷积的动机之一。
练习 3(多标签 vs softmax)。一个网络对 (猫, 狗, 长颈鹿) 的输出层 logits 是 。(a) 分别用三个 sigmoid 和一个 softmax,算出三个输出。(b) 下面两个产品各该用哪种输出层?“给相册里的照片自动打标签(可以同时有好几个)”;“动物园的 App,拍一只动物告诉你它是什么”。(c) 如果把 softmax 用在 (b) 的第一个产品上,一张”猫和狗在一起”的照片会出什么问题?
参考答案
(a) sigmoid:,,。softmax:,,,和为 10.475,所以是 。 (b) 相册标签:多标签,三个 sigmoid + 三个二元交叉熵。动物园:恰好一种,softmax + 多分类交叉熵。 (c) softmax 的输出加起来必须等于 1,“猫”和”狗”在争同一份概率。训练时标签是 (1, 1, 0) 也没法表示(one-hot 只能有一个 1)。模型会被迫在猫和狗之间犹豫,比如各给 0.5 左右,用阈值 0.5 去判断时可能两个都判不出来。
练习 4(手算 triplet loss 和梯度)。三个已经归一化的二维编码:,,。(a) 算出 、。(b) 时损失是多少?这个三元组还会提供梯度吗?(c) 时呢?算出 、、,并说明梯度下降会怎样移动这三个点。
参考答案
(a) ,。
(b) 。负样本已经比正样本远了 0.4,超过了 margin 0.2,这个三元组”太容易”,没有梯度。这正是代码 02 里随机三元组在第 500 步就 0% 有梯度的原因。
(c) ,损失 0.1。梯度:;;。梯度下降沿负梯度走: 往 方向移,也就是朝 靠近; 往 方向移,也就是远离 ; 往 方向移。(在单位球面上,归一化的反向传播还会去掉沿着编码自身方向的分量,见代码 02 的 encoder_backward。)可以用数值梯度验证: 的数值结果约为 。
练习 5(推导:为什么要归一化)。假设编码没有归一化,某个三元组满足 。证明:把编码器的最后一层权重和偏置都乘以 (所有编码都放大 倍),这个三元组的损失会单调不增,并且 足够大时变成 0。这说明了什么?为什么归一化能堵住这个漏洞?
参考答案
最后一层乘以 ,所有编码都变成 ,所以 变成 。损失变成 。因为方括号里是负数, 越大,第一项越负,损失单调不增;当 时损失为 0。 这说明网络可以不改变任何”谁和谁近”的关系,只靠把编码整体放大就降低损失,margin 形同虚设。(对于 的三元组,放大反而会让损失变大,所以实际训练中网络会在两者之间找一个尺度,但 margin 的含义已经被尺度”稀释”了。)归一化后所有编码都在单位球面上,平方距离被限制在 [0, 4],没法靠放大作弊, 才有固定的含义。
练习 6(Gram 矩阵为什么不管位置)。某一层有 2 个通道、3 个位置,激活值是 (每行一个通道,每列一个位置)。(a) 算出 Gram 矩阵 。(b) 把三个位置的顺序打乱(比如列的顺序变成 3, 1, 2), 变了吗?证明对任意的列置换都成立。(c) 这和代码 03 演示 1 里”平移 6 像素只变 0.028”有什么关系?为什么不是正好 0?
参考答案
(a) ,除以 3 得 。
(b) 不变。 是对所有位置 求和,加法和顺序无关。用矩阵写:列置换是右乘一个置换矩阵 ,,因为置换矩阵满足 。
(c) 平移是一种(近似的)位置置换,所以 Gram 矩阵几乎不变。不是正好 0 的原因有两个:一是图像边缘补了 0(padding),房子移动后,靠近边缘的那些 3×3 小方块变了;二是 np.roll 是循环平移,平移本身也会改变边界附近的内容。
练习 7(触发词的标签和指标)。Coursera 作业的输出有 个时间步,每个 activate 结束后标 50 个 1。(a) 一段只含 1 个 activate 的音频,正样本比例是多少?如果只标 1 个呢?“永远输出 0”的逐帧准确率各是多少?(b) 除了”标一串 1”,另一个对付类别不平衡的办法是在损失里给正样本加权(比如正样本的交叉熵乘以 50)。这两种做法有什么不同?(提示:想想代码 04 里”不同的对齐位置”那一点。)(c) 为什么评估触发词检测时要在”相同的每小时误唤醒次数”下比较召回率?
参考答案
(a) 标 50 个:,“永远输出 0”的准确率 96.4%。标 1 个:,“永远输出 0”的准确率 99.93%。 (b) 加权只是让那一个正样本在损失里”更响”。模型看到的仍然只有”恰好在结束后 1 帧”这一种对齐位置,学到的检测器依然很窄(代码 04 里 换了说话人就对不上的问题)。标一串 1 则同时增加了正样本的个数(不只是权重),而且给了模型很多不同的对齐位置,让它学”最近说过这个词”这种更宽容的模式。另外,加权会改变输出概率的含义(整体偏高),阈值也要跟着重新调。实践中两种方法也可以一起用。 (c) 阈值是部署时可以调的旋钮:调低阈值,召回率升高、误唤醒也增多。两个模型在同一个阈值下的输出概率尺度可能完全不同(代码 04 里 大的模型整体输出更高),直接比较”阈值 0.5 下的召回率”不公平。产品的约束通常是”误唤醒不能超过每小时 X 次”,所以应该在这个约束下比较谁的召回率高。这就是第 10 讲的”satisficing(满足型)指标 + optimizing(优化型)指标”。
练习 8(改代码:先预测,再运行)。(a) 把 daynight_world.py 里的 POINT_TAU = 0.10 改成 0.05(人类代理对亮点更敏感),然后运行 01_day_night_resolution.py。预测:32×32、16×16、8×8 的人类代理准确率会怎样变?“悬崖”会移动吗?(b) 把 02_face_verification_triplet.py 里的 NUISANCE_SCALE = 1.5 改成 3.0(光照、姿态的变化更大),预测像素距离和 triplet 编码器的验证、识别准确率会怎样变,然后运行验证。
参考答案
(下面是我运行的结果,改完后记得改回原值。) (a) 16×16 从 0.901 升到 0.937(城市夜景从 0.779 升到 0.968),因为凸起只剩 1/4 的路灯现在也能看出来了。但 32×32 反而从 0.943 降到 0.933:全分辨率下像素噪声偶尔也能比邻居亮 0.05,阴天的准确率从 1.000 降到 0.963,出现了”假亮点”。8×8 几乎不变(0.755,城市夜景 0.004),1/16 的凸起仍然看不出来。悬崖的位置不变,还是在 16 → 8 之间。阈值是在”漏掉真亮点”和”看到假亮点”之间做取舍,和第 10 讲的 precision / recall 是同一回事。 (b) 像素距离:验证 0.668 → 0.557,识别 0.106 → 0.028,几乎和瞎猜一样。编码器:验证 0.965 → 0.858,识别 0.800 → 0.360。两者都变差了,但编码器仍然远好于像素。干扰越强,“扔掉干扰”越难:要么需要更多的人、更多张照片,要么需要更大的编码器。
练习 9(改代码:模型的视野)。把 04_trigger_word_labels.py 里的 WINDOW = 16 改成 8(模型只看过去 0.8 秒;activate 的录音长 5–9 帧)。预测: 和 哪个受的影响更大?为什么?然后运行,看演示 2 的”误唤醒 ≤ 10 / 小时”那一列。
参考答案
我运行的结果(800 段训练音频,误唤醒 ≤ 10 次 / 小时下的召回率): 从 0.428 变成 0.416,几乎不变; 从 0.669 降到 0.590,受影响更大。 原因: 的标签在结束后第 1 帧,此时 8 帧的窗口刚好还能装下大部分词。 的标签一直延续到结束后第 5 帧,这时 8 帧的窗口里只剩词的后半段甚至一点点尾巴,很多”1”已经无法从窗口里判断,变成了难学的标签。标签的设计要和模型能”看到”的范围匹配:标签说”现在应该响”,那么在这个时刻,输入里必须还有足以判断的信息。真实系统用 RNN / GRU 带着”记忆”往前走(第 15 讲),就是为了让模型能看到更长的过去。
10. 延伸阅读 · Further reading
课程材料
- CS230 Autumn 2018 Lecture 2 “Deep Learning Intuition”(Kian Katanforoosh,YouTube,Stanford Online 频道;cs230.stanford.edu 的 lecture 页面有链接)。
- CS230 Fall 2017 课件 “CS230: Lecture 3 – Various Deep Learning Topics”(Kian Katanforoosh、Andrew Ng;web.stanford.edu/class/cs230/fall2017/files/CS230_Handout4.pdf)。本讲的白天 / 黑夜、人脸验证、风格迁移就来自这里,课件还讲了目标检测和图像分割(第 14 讲)。
- Coursera Deep Learning Specialization:C4 第 4 周 “Special Applications: Face Recognition & Neural Style Transfer”(及编程作业 Face Recognition、Art Generation with Neural Style Transfer);C5 第 3 周(Sequence Models & Attention Mechanism)里的 Speech Recognition、Trigger Word Detection 两个视频(及编程作业 Trigger Word Detection)。
人脸验证与度量学习
- Bromley, Guyon, LeCun, Säckinger & Shah (1993). Signature verification using a “Siamese” time delay neural network. NeurIPS. ——Siamese 网络。
- Chopra, Hadsell & LeCun (2005). Learning a similarity metric discriminatively, with application to face verification. CVPR.
- Schroff, Kalenichenko & Philbin (2015). FaceNet: A unified embedding for face recognition and clustering. CVPR. ——triplet loss、semi-hard 挖掘、128 维归一化编码。
- Deng, Guo, Xue & Zafeiriou (2019). ArcFace: Additive angular margin loss for deep face recognition. CVPR. ——分类式的编码训练。
- Buolamwini & Gebru (2018). Gender Shades: Intersectional accuracy disparities in commercial gender classification. FAT*.
风格迁移与”优化输入”
- Gatys, Ecker & Bethge (2015). A neural algorithm of artistic style. arXiv:1508.06576(CVPR 2016 版题为 Image style transfer using convolutional neural networks)。
- Johnson, Alahi & Fei-Fei (2016). Perceptual losses for real-time style transfer and super-resolution. ECCV.
- Ustyuzhaninov, Brendel, Gatys & Bethge (2016). Texture synthesis using shallow convolutional networks with random filters. arXiv:1606.00021.
- Zeiler & Fergus (2014). Visualizing and understanding convolutional networks. ECCV.
- Olah, Mordvintsev & Schubert (2017). Feature visualization. Distill.
- Szegedy et al. (2014). Intriguing properties of neural networks. ICLR;Goodfellow, Shlens & Szegedy (2015). Explaining and harnessing adversarial examples. ICLR.
- Nguyen, Yosinski & Clune (2015). Deep neural networks are easily fooled: High confidence predictions for unrecognizable images. CVPR.
触发词 / 关键词检测
- Chen, Parada & Heigold (2014). Small-footprint keyword spotting using deep neural networks. ICASSP.
- Sainath & Parada (2015). Convolutional neural networks for small-footprint keyword spotting. Interspeech.
- Apple Siri Team (2017). Hey Siri: An on-device DNN-powered voice trigger for Apple’s personal assistant. Apple Machine Learning Research.
对比学习与 embedding 检索(§3.6、§6.2)
- Chen, Kornblith, Norouzi & Hinton (2020). A simple framework for contrastive learning of visual representations (SimCLR). ICML.
- Radford et al. (2021). Learning transferable visual models from natural language supervision (CLIP). ICML.
- Karpukhin et al. (2020). Dense passage retrieval for open-domain question answering. EMNLP.
11. 下一讲预告 · Next lecture
第 6 讲:实践要点 I——数据划分、偏差与方差、正则化。 这一讲里好几次出现了同一个现象,只是没有展开:
- 32×32 的网络训练准确率 0.966、测试只有 0.869(§2.4);
- 人脸编码器在训练人群上比在新同学上好(§3.4);
- 阈值在验证集上选好,到了测试集上误唤醒超标了(§5.4)。
第 6 讲会把这些现象系统化:
- 训练 / 开发 / 测试集怎样划分,为什么开发集和测试集必须来自同一个分布;
- 用训练误差和开发误差诊断 high bias(欠拟合)和 high variance(过拟合),以及各自该怎么办;
- 正则化:L2(weight decay)、dropout、数据增强、early stopping。它们怎样让 32×32 那样”参数比数据多”的网络不再过拟合。
到第 6 讲结束时,你会知道代码 01 里 32×32 那一行”该怎么救”,也会明白第 1 讲 tiny_nn.train 里的 weight_decay 和 keep_best 两个参数在做什么。