对应 Maps to:Coursera Deep Learning Specialization C1M4 “Deep Neural Networks”(Deep L-layer Neural Network、Forward Propagation in a Deep Network、Getting your Matrix Dimensions Right、Why Deep Representations?、Building Blocks of Deep Neural Networks、Forward and Backward Propagation、Parameters vs Hyperparameters、What does this have to do with the brain?);编程作业 “Building your Deep Neural Network: Step by Step” 和 “Deep Neural Network - Application”。在 Stanford CS230 Fall 2025 的安排里,C1M4 和 C1M3 一起放在第 3 周(和课堂 Lecture 3 同一周)。 依据说明:Coursera 的视频和编程作业不对外公开。本讲依据 Andrew Ng 这门课里广为人知的内容来写:L 层网络的记号、前向 / 反向公式、“积木”图、矩阵维度规则、作业里的函数名和分工、“为什么要深”的两个论证(层次化特征、电路理论)、参数与超参数的区分、对大脑类比的看法。视频里的具体例子(比如两个示例网络的层宽)是凭记忆复述的,细节可能和原视频略有出入。“为什么要深”一节另外依据了电路复杂度和深度分离的原始论文(Håstad 1986;Telgarsky 2016),以及关于梯度方法学 parity 的研究(Shalev-Shwartz et al. 2017),见 §11。 配套代码 Code:
code/lecture04/(numpy;1 个核心模块deep_nn.py+ 5 个脚本;最慢的05_hyperparameters.py约 35 秒,其余几秒到半分钟) 预计阅读时间:2.5–3 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 用 Ng 的记号(、、、、、)描述任意一个 层全连接网络,写出它对 个样本的向量化前向传播,并解释为什么”对层的 for 循环”去不掉。
- 不看书写出每个量的形状: 是 , 是 , 是 ,每个梯度和它对应的量同形状;会用”维度检查 + 梯度检验”两道防线抓 bug,并知道各自抓不住什么。
- 从两层网络的反向传播推广出第 层的四个反向公式,说清每个公式里的 、转置从哪里来;推导输出层的 ,以及它和 的关系。
- 用”积木”(building blocks)的眼光看网络:每层一个前向函数(输出 + cache)、一个反向函数(用 cache 算梯度);说清 cache 为什么必要、它存了什么、为什么它的大小和 batch 成正比。
- 讲清 “为什么要深” 的两个论证(层次化特征;电路理论),并且知道它们的边界:parity 的指数差距只对逻辑门电路严格成立,对 ReLU 网络要换成锯齿函数;而且 能表示 ≠ 能学到。
- 区分参数和超参数,知道为什么 Ng 说应用深度学习是一个”经验过程”,会用学习曲线、网格和多个种子来判断一组超参数好不好。
- 对”神经网络像大脑”这个说法有一个准确的态度。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面几讲再展开 Previewed only |
|---|---|
| 第 1 讲的记号( 按列堆样本)、广播与 rank-1 数组的陷阱(第 1 讲 §3.4–3.5) | He / Xavier 初始化为什么是那几个数、梯度检验的系统讲解(第 7 讲) |
| 第 2 讲:逻辑回归、交叉熵、计算图、、向量化 | mini-batch、Adam 等优化器(第 8 讲;本讲 03、04 借用第 1 讲的 Adam) |
| 第 3 讲:两层网络的前向 / 反向推导、激活函数及其导数、为什么不能零初始化 | 超参数的系统搜索(随机搜索、对数尺度)、框架的自动微分(第 9 讲) |
| 矩阵乘法、转置、链式法则 | 卷积为什么比全连接更适合图像(第 12 讲);残差连接让很深的网络能训练(第 13 讲) |
本讲是第 2、3 讲的推广和收尾:第 2 讲是 1 层网络(逻辑回归),第 3 讲是 2 层网络,本讲是任意 层。数学上没有新东西——还是链式法则——新的是组织方式:把网络写成可以任意堆叠的积木。学完本讲,第 1 讲当作黑盒的 tiny_nn.py 里的 forward / backward 就完全拆开了(代码 01 会逐数字对照)。
0.3 本讲地图 Map
§1  从浅到深:L 层网络与记号
§2  L 层的前向传播:单样本 → 向量化;对层的循环                  ← 代码 01 演示 1
§3  把矩阵维度弄对:规则表;广播;维度检查 vs 梯度检验           ← 代码 01 演示 3
§4  积木:每层的前向 / 反向;四个反向公式;输出层;cache;验证   ← deep_nn.py、代码 01 演示 2
§5  为什么要"深":层次化特征;电路理论;能表示 ≠ 能学到          ← 代码 04、02、03
§6  参数 vs 超参数:深度学习是一个经验过程                       ← 代码 05
§7  这和大脑有什么关系?
§8–12  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,补充本讲新增的)
| 符号 | 含义 | 形状 |
|---|---|---|
| 网络的层数(输入层不算) | ||
| 第 层的单元数; | 代码里是 layer_dims[l] | |
| 第 层的激活函数(本讲:隐藏层 ReLU,输出层 sigmoid) | ||
| , | 个样本一起算的线性输出和激活值;, | |
| 、 | 逐样本损失 对 、 的导数,按列堆起来(不含 ) | 和 、 相同 |
| 、 | cost 对 、 的导数(含 ) | 和 、 相同 |
| cache | 第 层前向时存下、反向时要用的东西: | |
逐元素乘法(numpy 的 *);矩阵乘法写成并排(numpy 的 @) |
” 前缀”是 Coursera 的约定:dW1 就是 。、 不含 、、 含 ,这个区别在 §4.2 会解释,它是很多手写反向传播 bug 的来源。
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出(固定随机种子,每个演示用自己的随机数生成器,同一台机器上重复运行逐字相同;本讲没有计时类的数字)。§5 的几个实验结果和我写代码前的预想很不一样(比如”4 层网络输给了 2 层”),讲义按实际结果来写,这些情况列在代码 README 的”关于实验结果”里。数据都是合成的,网络都很小,数字只说明机制,不代表真实任务上的大小。
1. 从浅到深:L 层网络 · Deep L-layer neural network
1.1 “深”是一个程度问题
先回顾一下我们已经见过的网络,按层数排一排:
逻辑回归(第 2 讲)        x ──────────────────────→ ŷ                    1 层("很浅")
一个隐藏层(第 3 讲)      x ──→ [隐藏层] ──────────→ ŷ                    2 层
两个隐藏层                 x ──→ [ ] ──→ [ ] ──────→ ŷ                    3 层
五个隐藏层                 x ──→ [ ] → [ ] → [ ] → [ ] → [ ] ──→ ŷ        6 层("比较深")
Ng 在 C1M4 的第一个视频里说:浅和深是一个程度问题。逻辑回归是”非常浅”的模型,五个隐藏层的网络算”比较深”。过去十几年,大家逐渐发现有些函数深网能学好、浅网学不好;但对一个具体问题,事先很难知道要多深。Ng 的建议是:从逻辑回归开始,再试一两个隐藏层,把”隐藏层的个数”当作一个超参数,在验证集上比较(§5.5、§6)。
那为什么要专门讲” 层”?因为到第 3 讲为止,我们为每一种网络都单独推了一遍公式:逻辑回归一套,两层网络又一套。三层、五层、一百层呢?我们需要一种写一次、对任意 都成立的写法。这就是本讲的主线。
1.2 记号
Ng 在视频里用的例子是一个 4 层网络:3 个输入,三个隐藏层各有 5、5、3 个单元,1 个输出。用本讲的记号:
在代码里就是 layer_dims = [3, 5, 5, 3, 1]。第 层做的事,对一个样本是:
这个式子你在第 3 讲已经见过 的情形。本讲的全部内容,都是在说”把这一行重复 次”的前向、反向、形状和意义。
1.3 从黑盒到积木
第 1 讲的 tiny_nn.py 有一个 forward(params, X) 和一个 backward(params, caches, Y),当时我们只知道它们”能用”。本讲的核心模块 deep_nn.py 把它们拆成和 Coursera 作业 “Building your Deep Neural Network: Step by Step” 同名、同分工的小函数:
| 作用 | deep_nn.py 里的函数 | 一句话 |
|---|---|---|
| 初始化 | initialize_parameters_deep(layer_dims, rng, init) | 每层一个随机的 、一个全 0 的 |
| 前向积木(线性) | linear_forward(A_prev, W, b) | ,cache = |
| 前向积木(一整层) | linear_activation_forward(A_prev, W, b, activation) | 再加上 ,cache 里再存 |
| 整个前向 | L_model_forward(X, parameters) | 把 块积木串起来 |
| 损失 | compute_cost(AL, Y) | 交叉熵 |
| 反向积木(线性) | linear_backward(dZ, cache) | 用 cache 算 |
| 反向积木(一整层) | linear_activation_backward(dA, cache, activation) | 先 ,再调上一个 |
| 整个反向 | L_model_backward(AL, Y, caches) | 从输出层往回串 |
| 更新 / 训练 / 预测 | update_parameters、L_layer_model、predict | 梯度下降;训练循环;按 0.5 判类 |
| 检查工具 | check_dimensions、gradient_check | 维度检查;双边差分梯度检验 |
接下来三节分别讲前向(§2)、形状(§3)、反向和 cache(§4)。
2. L 层的前向传播 · Forward propagation in a deep network
2.1 先看一个样本
对一个样本 ,前向传播就是从 出发,一层一层往后算:
每一行的形式完全一样,只是上标变了。
2.2 再把 m 个样本一起算
第 2、3 讲已经讲过向量化:把 个样本按列排成矩阵,小写换成大写,公式不变:
的每一列是一个样本在第 层的激活值, 的每一列就是 乘这个样本; 是一个列向量,numpy 把它”复制”到 列上再加(广播)。
先想一想:向量化让我们去掉了”对样本的 for 循环”。那”对层的 for 循环”()能不能也用矩阵运算去掉?
答案是不能,而且也不需要。第 层的输入是第 层的输出,必须等它算完才能开始——这是一个串行的依赖,不是”很多件互不相关的事”。Ng 在视频里特意说明:在 L_model_forward 里写一个对层的 for 循环是完全正当的。(不同样本之间没有依赖,所以能并行;不同层之间有依赖,所以只能一层一层来。这也是为什么非常深的网络在 GPU 上”每一层都很快,但层数多了总时间还是长”。)
2.3 代码:三块前向积木
deep_nn.py 里,前向分成三层函数,越往上越”大”:
def linear_forward(A_prev, W, b):
    Z = W @ A_prev + b                       # (n[l], n[l-1]) @ (n[l-1], m) + (n[l], 1) → (n[l], m)
    return Z, (A_prev, W, b)                 # cache:反向时算 dW 要 A_prev,算 dA_prev 要 W

def linear_activation_forward(A_prev, W, b, activation):
    Z, linear_cache = linear_forward(A_prev, W, b)
    A, activation_cache = relu(Z) if activation == "relu" else sigmoid(Z)   # activation_cache 就是 Z
    return A, (linear_cache, activation_cache)

def L_model_forward(X, parameters):
    A, caches = X, []
    for l in range(1, L + 1):                # 对层的循环:去不掉,也不必去
        A, cache = linear_activation_forward(A, W[l], b[l], "relu" if l < L else "sigmoid")
        caches.append(cache)
    return A, caches
(这里是简化过的示意;真实代码里激活函数按名字查表,并且对 的形状做了 assert。)
2.4 实验:一层一层看形状
代码 01 演示 1 用 Ng 讲矩阵维度时用的那个 5 层网络 layer_dims = [2, 3, 5, 4, 2, 1],取 个样本(故意选一个和所有 都不同的数,这样 不会和别的形状混淆),逐层打印:
| 层 | 激活 | cache 里存了什么 | cache 里的激活值个数 | ||||
|---|---|---|---|---|---|---|---|
| 1 | relu | (3, 2) | (3, 1) | (3, 7) | (3, 7) | (2, 7), W, b, (3, 7) | 35 |
| 2 | relu | (5, 3) | (5, 1) | (5, 7) | (5, 7) | (3, 7), W, b, (5, 7) | 56 |
| 3 | relu | (4, 5) | (4, 1) | (4, 7) | (4, 7) | (5, 7), W, b, (4, 7) | 63 |
| 4 | relu | (2, 4) | (2, 1) | (2, 7) | (2, 7) | (4, 7), W, b, (2, 7) | 42 |
| 5 | sigmoid | (1, 2) | (1, 1) | (1, 7) | (1, 7) | (2, 7), W, b, (1, 7) | 21 |
几个值得看的数:
- 参数总数 66;cache 里的激活值一共 217 个 。除去输入 本身(14 个),前向传播新算出、为反向传播留着的有 203 个——已经是参数个数的 3 倍。 越大,这个比例越大(§4.4)。
- “逐个样本做前向传播、再拼起来”和”7 个样本一起算”的输出 最大差 0.0e+00:向量化只是换了一种算法,不改变任何数。
- 输出 是 0.509、0.513、0.506、0.432、0.515、0.502、0.470——刚初始化的网络对每个样本都”拿不准”,都在 0.5 附近,这是正常的。
3. 把矩阵维度弄对 · Getting your matrix dimensions right
3.1 规则表
Ng 有一个很朴素的调试习惯:写深度学习代码时,手边放一张纸,把每个矩阵的形状写下来逐一核对。下面这张表就是那张纸:
| 量 | 形状 | 怎么记 |
|---|---|---|
| “输出个数 × 输入个数”: 要把 维变成 维 | ||
| 每个单元一个偏置,列向量 | ||
| 、 | 每列一个样本; 是 | |
| 和 一样(更新 要求同形状) | ||
| 和 一样 | ||
| 、 | 和 、 一样 | |
| 和 一样(二分类时 ) |
为什么 是 而不是反过来? 从单样本的式子倒推: 是 , 是 。矩阵乘法 ,要从 得到 ,左边的矩阵只能是 。用 Ng 那个网络验算一下第 1 层: 是 (3, 2), 是 (2, 1), 是 (3, 1), 是 (3, 1),加起来 是 (3, 1)。对得上。
向量化之后哪些形状变了? 只有和样本有关的量()从”1 列”变成” 列”;参数和参数的梯度()不随 变——不管一次喂多少个样本,网络还是那个网络。 仍然是 ,加到 上时靠广播复制到每一列。
一个记梯度形状的窍门:每个梯度都和它对应的量同形状。反向公式里的转置放在哪里,往往由”形状必须凑对”唯一决定(§4.2)。
代码 01 演示 2 把这张表变成了一个自动检查:check_dimensions 按规则逐层核对每个量,前向和反向之后各跑一次。Ng 那个 5 层网络的结果是每一行都打 ✓(第 1 层: (3, 2)、 (3, 1)、 (3, 7)、 (3, 2)、 (3, 1)、 (2, 7)……)。
3.2 维度检查能抓住哪些 bug?
先预测:下面五个 bug 里,哪些会让 numpy 报错?哪些会”不报错、悄悄算错”?
代码 01 演示 3 在同一个网络上故意写错五个地方:
| 故意写的 bug | numpy 报错吗 | 维度检查 | 梯度检验的相对误差 |
|---|---|---|---|
| A 形状写反,(3, 5) | 是(ValueError) | 抓住 | — |
| B 写成一维 (5,) | 时是; 时否 | 抓住 | — |
C 忘了 keepdims | 更新时否( 变成 (5, 5)) | 抓住 | — |
| D 标签 写成 | 否(cost 0.7078 → 34.7722) | 抓住 | — |
| E 忘了除以 | 否 | 没抓住 | 8.9e−02(正确时 9.8e−09) |
逐个看:
- A 是”好”的 bug: 的内维对不上((3, 5) 乘 (3, 7)),numpy 立刻报错。但如果某一层恰好 (方阵),写反了照样能乘,就变成悄悄出错。
- B、C、D 都是广播惹的祸(第 1 讲 §3.5 的陷阱在深网里的翻版):
- (5,) 的 加到 (5, 7) 上时,numpy 从最后一维对齐,5 ≠ 7,报错;但当 恰好等于 5 时,它会按”列”而不是按”行”相加——不报错,输出和正确结果差 0.021。
np.sum(dZ, axis=1)忘了keepdims=True,得到 (5,);接着 是 (5, 1) 减 (5,),广播成 (5, 5) 的矩阵。下一次前向传播 才会报错——错误出现的地方离真正的 bug 很远。- 是 (7, 1)、 是 (1, 7),
Y * np.log(AL)广播成 7 × 7,cost 从 0.7078 变成 34.7722。不报错,训练也能”跑”。
- E 的形状完全正确,维度检查无能为力;但梯度检验的相对误差从 1e−8 量级跳到 8.9e−2,一眼就能看出来。
结论:两道防线分工明确——维度检查抓”形状错”,梯度检验抓”数值错”。在 deep_nn.py 里,linear_forward、linear_backward、update_parameters 都在关键处加了 assert,就是为了让 B、C 这类 bug 在发生的地方就报错,而不是在三步之后。
4. 积木:每一层的前向和反向 · Building blocks of deep neural networks
4.1 一张图
Ng 在 “Building blocks of deep neural networks” 里画了一张图,本讲的代码就是照着它写的:
            前向(forward)                                      反向(backward)
  A[l-1] ──→ ┌───────────────────┐ ──→ A[l]          dA[l-1] ←── ┌───────────────────┐ ←── dA[l]
             │ 第 l 层            │                               │ 第 l 层            │
  W[l],b[l]→ │ Z = W A[l-1] + b  │                    dW[l] ←──── │ dZ = dA * g'(Z)    │
             │ A = g(Z)          │ ──→ cache[l] ────────────────→ │ dW、db、dA[l-1]    │
             └───────────────────┘   (A[l-1],W,b,Z)   db[l] ←──── └───────────────────┘

  整个网络:
  X=A[0] → [1] → A[1] → [2] → A[2] → … → [L] → A[L] → 损失 J
                                                         │
  dW[1],db[1] ← [1] ← dA[1] ← [2] ← dA[2] ← … ← [L] ← dA[L](由损失函数给出)
每一层是一个”盒子”,有两个方向的接口:
- 前向盒子:输入 ,输出 ,顺手把反向要用的东西存进 cache;
- 反向盒子:输入 和 cache,输出 (交给前一层)以及这一层的 、(交给优化器)。
有了这两个盒子, 层网络 = 把同一对盒子摆 次。训练的一次迭代就是:从左到右走一遍前向盒子,在最右边算损失和 ,从右到左走一遍反向盒子,最后用所有的 更新参数。
这种”每层只关心自己的输入输出”的设计,正是 PyTorch 等框架的做法:每种层(全连接、卷积、注意力……)实现自己的 forward 和 backward,框架负责把它们串起来(第 9 讲)。你可以在不改动其他层的情况下,换掉某一层的激活函数,甚至插入一种全新的层。
4.2 第 层的四个反向公式
回顾:第 3 讲推导了两层网络的反向传播:
仔细看 那一项:它其实是两步——先把梯度”传过线性部分” ,再”穿过激活函数” 。把这两步拆开、把上标换成一般的 ,就得到第 层的反向积木:
这四个式子从哪里来? 先看一个样本。 写成分量是 ,。用链式法则:
- 只依赖 ,所以 ,即 (逐元素乘)。
- 只通过 影响损失,,所以 。把所有 排成矩阵,就是外积 (形状 )。
- 对 的导数是 1,所以 。
- 通过所有的 影响损失,要把各条路径加起来:,即 。
再把 个样本放在一起。cost 是平均值 ,而参数 被所有样本共用,所以它们的梯度要对样本求平均:
(” 个外积之和”正好等于矩阵乘法 ——这是向量化里最常用的一个恒等式。) 同理是 按行求和再除以 。而 是每个样本自己的量(第 列只和第 个样本有关),不需要平均,所以没有 : 只在”多个样本共用的东西”(参数)上出现一次。如果你在 上也除以 ,那么每往前传一层就多除一次 ,越靠前的层梯度越小——一个不报错的 bug(练习 3)。
形状核对: 是 ,和 一样 ✓; 是 ,和 一样 ✓。如果把转置放错位置,形状就凑不上——这就是 §3.1 说的”形状唯一决定转置的位置”。
4.3 输出层:反向传播从哪里起步
反向积木需要输入 。最右边那块(第 层)的 由损失函数给出。对交叉熵 求导:
Coursera 作业里就是这样起步的:先算 dAL = -(np.divide(Y, AL) - np.divide(1 - Y, 1 - AL)),再交给输出层(sigmoid)的反向积木。穿过 sigmoid 时乘以 :
分母恰好约掉——这就是第 2 讲那个简洁的 。L_model_backward 提供两种起步方式:
output_grad="chain"(默认,Coursera 的写法):先算 再穿过 sigmoid。好处是通用:换一个损失函数,只要改 这一行,其余积木一个字不用动。output_grad="fused":直接用 。
两者数学上相同,平时数值上也只差舍入误差。但 代码 01 演示 2 构造了一个极端情形:、标签 (网络”非常自信地错了”)。
| 结果 | |
|---|---|
| float64 里 恰好等于 1.0 吗? | 是 |
| chain:( 被裁剪成 ) | 1.0e+12 |
| chain: | 0 |
| chain: | 0.0 |
| fused: | 1.0 |
cost:compute_cost(裁剪后) vs 真实值 | 27.6 vs 约 40.0 |
chain 写法里, 本该是一个巨大的数、 本该是一个极小的数,两者相乘才是 1;可浮点数先把 舍成了 0,梯度就没了——网络错得最离谱的样本反而收不到任何纠正信号。fused 写法从不计算这两个极端的数,所以不受影响。因此 L_layer_model 训练时用 fused;PyTorch 的 BCEWithLogitsLoss(“sigmoid + 交叉熵”合在一起)也是出于同样的考虑(第 9 讲)。教训是:数学上等价的写法,数值上不一定等价。
4.4 cache:为什么要存,存了什么,代价是什么
先想一想:反向积木的四个公式,分别需要哪些前向时的量?
- 需要 (算 );
- 需要 ;
- 需要 。
这正好就是 cache 里存的东西:。( 其实用不到,Coursera 的作业为了方便一起存了。)
不存会怎样? 反向走到第 层时,如果手里没有 和 ,就只能从输入 开始重新前向算 层。对 每层都这样做,总共要算 层,而存下来只要 层。网络越深,差距越大。cache 是典型的用内存换时间。
代价是内存。cache 里的激活值和 batch 大小 成正比:演示 1 里 时已经有 203 个,是参数(66 个)的 3 倍。在真实的大网络里,训练时的显存大头往往不是参数,而是这些为反向传播留着的激活值;batch 一大、网络一深,显存就不够了。研究者因此发明了 gradient checkpointing(Chen et al. 2016):只存一部分层的激活值,其余的在反向时重新算——用一点额外的计算换大量的内存。它就是在”全存”和”全不存”之间取了一个折中。
另外两个和 cache 有关的事实:
- 推理(inference)时不需要 cache:只做预测时没有反向传播,算完一层就可以扔掉上一层的激活值。所以同一个网络,训练比推理占的内存多得多。
- 反向的计算量大约是前向的两倍:前向每层一次矩阵乘法(),反向每层两次( 和 )。所以”一次训练迭代 ≈ 三次前向传播”是一个常用的粗略估计。
4.5 验证:梯度检验,以及和第 1 讲黑盒的对照
写完反向传播,怎么知道它对?代码 01 演示 2 做了两件事。
① 梯度检验(gradient checking):对每个参数 ,用双边差分
算一个”数值梯度”,和反向传播的结果比较相对误差 。它很慢(每个参数要做两次前向),但几乎不可能写错,所以拿它当标准答案。第 7 讲会系统地讲它;这里只当工具用。
| 网络 | 参数个数 | 的初始点 | 的项 | 为小随机数时 | 的项 |
|---|---|---|---|---|---|
| [2, 3, 5, 4, 2, 1](演示 1 的网络) | 66 | 2.33e−09 | 0 | 2.60e−09 | 0 |
[4, 5, 3, 1](deep_nn.py 自检用的网络) | 47 | 8.21e−02 | 3 | 4.10e−09 | 0 |
第二行在初始点上”失败”了,但反向传播没有错。原因是:初始化时 ;某个样本在第 1 层的 ReLU 恰好全部输出 0,于是它在第 2 层的 ,恰好落在 ReLU 不可导的折点上。双边差分 跨过了折点,左右两边的斜率不同,差分就不准了。把 换成小随机数后误差回到 4.1e−9。这是梯度检验的一个真实陷阱(我写代码时就踩到了):要在一个”一般的点”上做检验,而不是在全 0 偏置这种特殊点上。
② 和第 1 讲的黑盒对照:同样的参数、同样的数据,deep_nn 和 tiny_nn 的输出最大差 0.0e+00;梯度最大差:chain 写法 1.1e−16(只差浮点舍入),fused 写法 0.0e+00(逐位相同——tiny_nn.backward 本来就是用 起步的)。第 1 讲的黑盒,现在完全拆开了。
4.6 把积木串成训练循环
有了积木,训练一个 层网络就是 Coursera 作业里 L_layer_model 的那几行:
parameters = initialize_parameters_deep(layer_dims, rng)
for i in range(num_iterations):
    AL, caches = L_model_forward(X, parameters)          # 前向:存 cache
    cost = compute_cost(AL, Y)                           # 损失
    grads = L_model_backward(AL, Y, caches)              # 反向:用 cache
    parameters = update_parameters(parameters, grads, learning_rate)   # 更新
和第 1 讲 §2.1 那”四步”一模一样,只是每一步都能处理任意 层了。本讲的 L_layer_model 在此基础上只多了两样东西:每一步用 np.isfinite 检查输出和 cost 是否有限(第 1 讲 §6.3 的教训:BLAS 里产生的 nan 不会触发 numpy 的浮点警告),以及一个 optimizer="adam" 的选项(借用第 1 讲的 Adam,第 8 讲推导)。
Ng 在讲完前向和反向的公式之后说过一句很实在的话(大意):这些公式第一次看会觉得抽象,但实现出来你会发现它真的能工作;一个学习算法的”复杂”,很大程度上来自数据,而不是你写了几千行代码。本讲的整个网络——前向、反向、更新、检查——加起来也就两百多行(不算注释)。
5. 为什么要”深” · Why deep representations?
第 1 讲 §2.5 留了一个问题:万能近似定理说一个隐藏层”够用”,为什么还要深?Ng 在 “Why deep representations?” 里给了两个论证:一个是直觉的(层次化特征),一个是理论的(电路理论)。本节把两个论证都放到实验里检验,并且会看到它们各自的边界。
5.1 直觉:从简单到复杂,一层层组合
Ng 用人脸识别举例。把一张人脸照片交给一个很多层的网络:
第 1 层            第 2 层                  第 3 层               ……
小块的边缘检测器 → 把边缘组合成脸的部件  → 把部件组合成整张脸
(横的、竖的、     (眼睛、鼻子、嘴角)     (不同的人脸)
  斜的边缘)
看图像的一小块 看稍大一点的区域 看整张图早期的层计算的是简单的函数,每个单元只”看”输入的一小部分;后面的层把前面的结果组合起来,表示越来越复杂、越来越全局的东西。这类可视化最早来自卷积网络的研究(例如 Lee, Grosse, Ranganath & Ng 2009 的卷积深度信念网络;Zeiler & Fergus 2014 对 AlexNet 一类卷积网络各层的可视化,第 21 讲会讲怎样做这种可视化)。
语音也一样:
原始波形 → 低层的声音特征(音调升降、是不是白噪声……)→ 音素(cat 里的 c、a、t)→ 词 → 短语和句子Ng 也提到,这和神经科学家对视觉皮层的描述有些相似(早期区域对边缘敏感,后面的区域对更复杂的形状敏感)——但他同时提醒,这种类比不要太当真(§7)。
为什么”组合”需要”深”? 第 1 讲 §2.4 说过,没有非线性,叠多少层都是一层。有了非线性,每一层都在前一层已经算好的特征上再做一次非线性变换。“眼睛”是若干条边缘按特定方式排在一起;如果网络只有一层,它就得直接从像素一步算出”眼睛”,没法复用”边缘”这个中间结果。深网的每一层都在复用前面层的成果——这就是 §5.3 里”指数级节省”的来源。
5.2 在合成图像上看一看
这个直觉能在实验里看到吗?Coursera 的 “Deep Neural Network - Application” 作业在猫图上比较了一个 2 层网络和一个 4 层网络(4 层更好)。我们没有猫图,就自己造一个”需要组合局部图案才能判断”的任务(代码 04):
- 8 × 8 的灰度图,分成 4 个 4 × 4 的象限。每个象限里有一根长度为 3 的横条或竖条,位置在象限内随机;每个像素再加标准差 0.3 的噪声。
- 标签:左上和右下两个象限的条纹方向是否相同(相同为 1)。右上、左下是干扰项。
要判断它,网络得先在像素里找出条纹(不管它在象限的哪个位置)→ 判断每个象限是横是竖 → 再比较两个象限。这正是”像素 → 局部图案 → 部件 → 关系”的层次结构。演示 0 在终端里画了几张样本(█ 是亮像素):
样本 1:y = 1     样本 2:y = 0
(竖横竖竖)        (竖竖竖横)
·█·· ····         ···· ·█··
·██· ····         ·█·· ·█··
·█·· ·███         ···· ·█··
···· ····         ·█·· ····

···· █···         ···· ····
···█ █·██         ···█ ███·
···█ █···         █··█ ····
···█ ····         ···█ ····
(样本 1 的左上和右下都是竖条,;样本 2 的右下是横条,。噪声偶尔会多画出一个亮点(样本 1 的左上),或者让条纹上的一个像素暗下去(样本 2 的左上,竖条中间那一格)。)
先预测:参数量几乎相同的 2 层网络 [64, 32, 1] 和 4 层网络 [64, 24, 16, 8, 1],谁的测试准确率更高?
代码 04 演示 1(Adam,学习率 0.005,2000 步,每种设置 3 个种子,测试集 5,000 张):
| 对比 | 网络 | 参数 | 训练样本 | 训练准确率 | 测试准确率(平均) | 各种子 |
|---|---|---|---|---|---|---|
| 参数相同 | [64, 32, 1] | 2113 | 3,000 | 1.000 | 0.508 | 0.505 0.508 0.510 |
| 参数相同 | [64, 24, 16, 8, 1] | 2105 | 3,000 | 0.994 | 0.516 | 0.508 0.523 0.515 |
| 参数相同 | [64, 32, 1] | 2113 | 10,000 | 1.000 | 0.858 | 0.866 0.837 0.872 |
| 参数相同 | [64, 24, 16, 8, 1] | 2105 | 10,000 | 0.994 | 0.790 | 0.785 0.815 0.771 |
| 仿 Coursera | [64, 7, 1] | 463 | 10,000 | 0.740 | 0.697 | 0.752 0.658 0.681 |
| 仿 Coursera | [64, 20, 7, 5, 1] | 1493 | 10,000 | 0.796 | 0.605 | 0.732 0.508 0.576 |
(测试集上”永远猜多数类”的准确率是 0.504。)
这张表和”深的更好”的直觉不一致,值得逐行读:
- 3,000 个样本时,深度帮不上忙,数据才是瓶颈。两种网络都把训练集背得几乎一个不错,测试却只有 0.51 左右——约 2,100 个参数足够记住 3,000 张图,却没学到”比较两个象限”这条规律。
- 10,000 个样本时,参数相同的 4 层网络输给了 2 层(0.790 vs 0.858),而且两者的训练准确率差不多,差在泛化上。
- “仿 Coursera”那一组:4 层网络参数多了约 3 倍,测试反而更差(0.605),三个种子之间从 0.508 到 0.732,很不稳定。Coursera 作业里 4 层胜过 2 层,但那里的 4 层网络参数也多得多——“深”和”大”是两件事,比较结构时要把参数量写出来。
为什么 4 层在这里不占优?我没有专门去查,几个可能的原因:两种网络用了同一组学习率和步数,而深网的最佳学习率往往不同(§6 的代码 05 就看到了这一点);[64, 24, 16, 8, 1] 越往后越窄,信息可能被挤掉;全连接网络不知道”同一个条纹检测器可以在每个位置复用”,这个先验要到第 12 讲的卷积才写进结构里。
那”层次化的特征”还在吗? 这是另一个问题。代码 04 演示 2 用第 1 讲 §2.3 的线性探针(linear probe)看每一层里能线性地读出什么(测试集准确率,0.5 = 读不出来):
| 特征 | 读”左上方向” | 读”右下方向” | 读”是否相同”(标签) |
|---|---|---|---|
| 原始像素(64 维) | 0.571 | 0.562 | 0.509 |
| 4 层网络 (24 维),训练前 | 0.595 | 0.562 | 0.502 |
| 4 层网络 (8 维),训练前 | 0.541 | 0.518 | 0.500 |
| 4 层网络 (24 维),训练后 | 0.826 | 0.866 | 0.546 |
| 4 层网络 (16 维),训练后 | 0.808 | 0.803 | 0.763 |
| 4 层网络 (8 维),训练后 | 0.700 | 0.729 | 0.774 |
| 2 层网络 (32 维),训练后 | 0.942 | 0.814 | 0.868 |
- 从原始像素几乎读不出方向(0.571):条纹位置随机,没有一个固定的像素模板能区分横竖;“是否相同”更是 0.509——它是 XOR 型的关系,任何线性组合都表示不了。
- 训练后的 4 层网络呈现出清楚的层次:第 1 层已经能读出方向(0.83–0.87),但读不出关系(0.546);第 3 层读关系 0.774,单个象限的方向反而淡了(0.70–0.73)。越往后,表示越接近任务需要的那个量,无关的细节被逐渐丢掉。
- 对照组:训练前的同一个网络各层都读不出什么(第 3 层读关系 0.500)。层次结构是训练出来的,不是随机网络自带的。
- 2 层网络的唯一隐藏层同时能读出方向和关系,而且读关系的准确率(0.868)比 4 层网络的任何一层都高。浅网把”部件”和”关系”挤在同一层里完成,在这个任务上完成得更好。
所以要区分两个命题:“深网内部是分层组织的”和”深网的准确率更高”。在这个实验里,前者成立,后者不成立。深度可能带来好处,但它不是免费的;要不要深、深多少,是一个要靠实验回答的问题(§5.5、§6)。
5.3 电路理论:parity 与锯齿函数
Ng 给的第二个论证来自电路理论(circuit theory)。他的说法大意是:有些函数,用一个”小的”深层网络就能算,而浅层网络需要指数多个隐藏单元才能算。他举的例子是 个输入的 XOR,也叫 parity(奇偶校验):
深层构造:XOR 二叉树。 第 1 讲 §1.3 说过,单层感知机连一个 XOR 都表示不了。但两个 ReLU 单元加一个线性组合就够了:对 ,
( 时,。)XOR 的结果只是这一层单元的线性组合,可以直接并进下一层的 。于是像比赛的淘汰赛一样两两组合:第 1 层算 个 XOR,第 2 层把它们再两两 XOR…… 层后只剩一个信号。代码 02 演示 1 手工构造了这个网络(不训练),并在全部 个输入上逐一验证:
| layer_dims | 隐藏层数 | 隐藏单元 | 参数个数 | 全部 个输入正确? | |
|---|---|---|---|---|---|
| 8 | [8, 8, 4, 2, 1] | 3 | 14 | 121 | 是 |
| 10 | [10, 10, 5, 3, 2, 1] | 4 | 20 | 194 | 是 |
| 16 | [16, 16, 8, 4, 2, 1] | 4 | 30 | 457 | 是(65,536 个输入) |
是 2 的幂时隐藏单元恰好 个;否则落单的信号每层要多占一个单元”传下去”。总之是 个单元、 层。注意它的结构:第 1 层看 2 位,第 2 层看 4 位,第 层看 位——和 §5.1 里”感受野逐层变大”是同一个结构。
浅层构造(一):枚举。 如果只允许一个隐藏层呢?Ng 的说法是,你得”枚举”所有可能的输入组合。具体做法:给每个含奇数个 1 的输入模式 配一个”模式检测器”——令 ( 中的 1 变 +1、0 变 −1),单元 只在 时输出 1,否则输出 0(相当于一个 AND 门);输出层把所有检测器加起来(一个 OR 门)。奇数模式一共 个。
浅层构造(二):计数。 但写代码时我发现了一个问题:parity 只取决于 1 的个数 ,而 ReLU 单元会做加法。一个隐藏层、 个单元 (),配上输出权重 ,就能画出一条在 处取值 的之字形折线:
代码 02 演示 2 把三种构造放在一起( 时三者都在全部输入上验证过;“枚举”只构造到 ,再大就只计数):
| 深层树:隐藏层 / 单元 | 枚举(DNF):单元 | 枚举:参数 | 计数:单元 | 计数:参数 | |
|---|---|---|---|---|---|
| 8 | 3 / 14 | 128 | 1,281 | 8 | 81 |
| 12 | 4 / 23 | 2,048 | 28,673 | 12 | 169 |
| 16 | 4 / 30 | 32,768 | 589,825 | 16 | 289 |
| 20 | 5 / 40 | 524,288 | 11,534,337 | 20 | 441 |
| 32 | 5 / 62 | 2,147,483,648 | 73,014,444,033 | 32 | 1089 |
这张表要读两遍:
- “枚举”就是 Ng 说的那个浅网:单元数 , 时约 21 亿个单元、730 亿个参数,而深层树只要 62 个单元。对 AND / OR 逻辑门组成的两层电路,这是一个可以严格证明的下界:任何”OR of ANDs”形式(析取范式,DNF)的 parity 电路都至少需要 个 AND 项。证明只有一句话——每个 AND 项都必须用到全部 个变量,否则翻转一个它没用到的变量,parity 变了而这个项的值不变,矛盾。更一般地,Håstad(1986)证明了:深度固定为 的 AND / OR 电路计算 parity 需要 个门——层数越少,代价越是指数级地爆炸。
- 但”计数”构造只用 个 ReLU 单元、一个隐藏层,同样精确正确。ReLU(以及阈值单元)比逻辑门强:它能做加法和比较。所以要把话说准确:Ng 的 parity 例子来自逻辑门电路,在那里深浅的指数差距是严格的定理;对 ReLU 网络,parity 本身并不需要指数宽的浅层网络。 它是一个帮助理解”深度能带来指数级节省”的好类比,但不是 ReLU 网络的证明。
对 ReLU 网络真正成立的例子:锯齿函数。 那么,ReLU 网络里有没有严格的”深浅指数差距”?有。最干净的例子来自 Telgarsky(2016)。在 上定义”帐篷映射”(tent map):
它把 对折一次,只要 2 个 ReLU 单元。把它复合 次,,每复合一次折痕翻一倍,得到一个有 段的锯齿。用网络实现就是 个隐藏层、每层 2 个单元。另一方面,一个隐藏层的网络在一维输入上,每个单元 最多贡献一个折点, 个单元加起来最多 段——加法不会让折点变多,复合才会。所以要精确表示 段的锯齿,浅网至少需要 个单元。代码 02 演示 3:
| 深网 layer_dims | 深网单元数 | 段数 | 浅网精确表示至少需要 | 浅网 个单元(均匀折点)RMSE | 常数预测 RMSE | |
|---|---|---|---|---|---|---|
| 2 | [1, 2, 2, 1] | 4 | 4 | 3 个单元 | 0.0000 | 0.2887 |
| 4 | [1, 2, 2, 2, 2, 1] | 8 | 16 | 15 个单元 | 0.2887 | 0.2887 |
| 8 | [1, 2 × 8, 1] | 16 | 256 | 255 个单元 | 0.2887 | 0.2887 |
| 12 | [1, 2 × 12, 1] | 24 | 4,096 | 4,095 个单元 | 0.2898 | 0.2898 |
时,24 个单元的深网画出了 4,096 段;给浅网同样多的单元(折点均匀排开、输出层用最小二乘),它的误差和”永远预测平均值”一样——完全跟不上锯齿的震荡。(均匀折点不是最聪明的放法,换一种放法能好一些;但无论怎么放, 个单元最多 段,盖不住 段。)下图是 的情形:
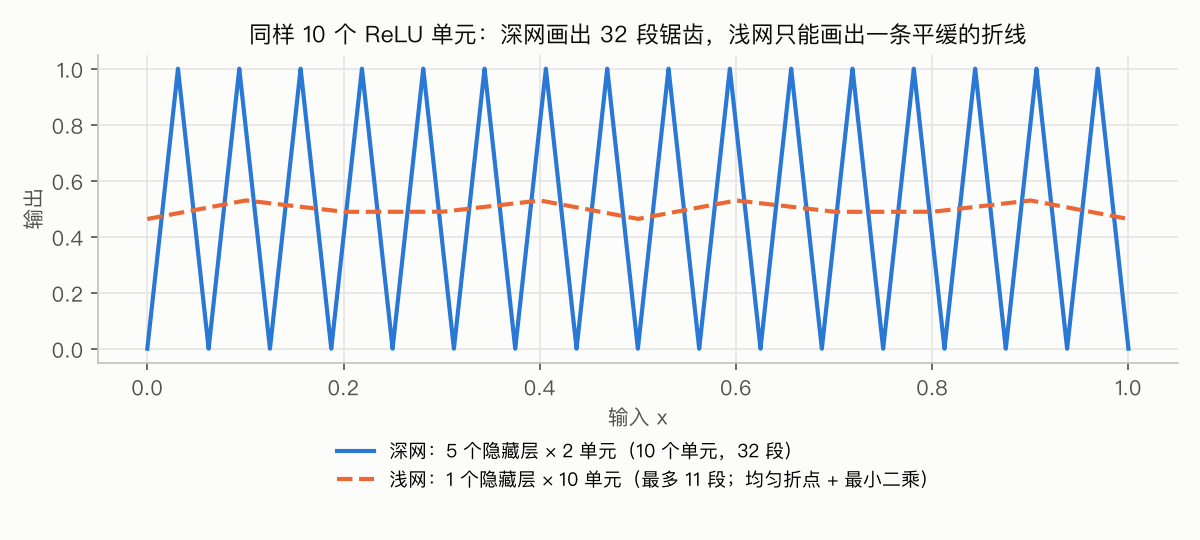
(这张图由 02_why_deep_circuits.py 生成;没装 matplotlib 时脚本只打印表格。)
更一般的结论(Montúfar et al. 2014 等)是:ReLU 网络能表示的”线性区域”个数可以随深度指数增长,而随宽度只是多项式增长。这才是”深度带来指数级表达能力”在 ReLU 网络上的准确说法。
5.4 能表示 ≠ 能学到
§5.3 的网络都是手工构造的:参数是我们直接写进去的。可训练时我们并不知道这组参数,只能从随机初始化出发,用梯度下降去找。第 1 讲 §2.5 提醒过万能近似定理”只说了存在,没说找不找得到”。现在来看 parity 上找不找得到。
代码 03 演示 1:能拟合 8 位 parity 的全部 256 个输入吗? 这里没有测试集——训练集就是全部可能的输入,所以这是一个纯粹的优化问题:
| 网络 | 参数 | 存在精确解? | 训练 5 次的准确率:平均 | 最低 | 最高 | 达到 100% 的次数 |
|---|---|---|---|---|---|---|
| 手工构造的深层树(代码 02) | 121 | — | 1.000 | |||
| [8, 8, 4, 2, 1](和深层树同形状) | 121 | 是 | 0.732 | 0.547 | 0.875 | 0 / 5 |
| [8, 12, 1] | 121 | 是(“计数”只要 8 个单元) | 0.857 | 0.707 | 0.949 | 0 / 5 |
| [8, 16, 16, 16, 1] | 705 | 是 | 1.000 | 1.000 | 1.000 | 5 / 5 |
| [8, 70, 1] | 701 | 是 | 1.000 | 1.000 | 1.000 | 5 / 5 |
(Adam,学习率 0.01,3000 步,He 初始化。这些设置在写代码前就定下了。)
和深层树一模一样的形状,从随机初始化开始训练,5 次里一次也没找到精确解。浅网 [8, 12, 1] 也一样。这就是能表示 ≠ 能学到:解存在,梯度下降没找到。参数多约 6 倍之后,两种网络都 5 / 5 次拟合了全部输入——多余的参数让优化变容易了(“网络稍微大一点”的又一个理由,和第 1 讲 §2.2 里 [5, 2, 1] 卡在线性解上是同一个教训)。
代码 03 演示 2:能泛化到没见过的输入吗? 10 位输入共 1024 个,随机 512 个训练、另外 512 个测试;对照任务 majority(1 的个数是否超过一半)用完全相同的网络和设置:
| 任务 | 网络 | 参数 | 训练准确率 | 测试准确率(平均) | 最低 | 最高 |
|---|---|---|---|---|---|---|
| parity | [10, 16, 16, 16, 1] | 737 | 1.000 | 0.602 | 0.428 | 0.801 |
| parity | [10, 61, 1] | 733 | 1.000 | 0.716 | 0.605 | 0.789 |
| majority | [10, 16, 16, 16, 1] | 737 | 1.000 | 0.998 | 0.994 | 1.000 |
| majority | [10, 61, 1] | 733 | 1.000 | 1.000 | 1.000 | 1.000 |
- majority 两种网络都近乎完美——训练流程本身没问题。
- parity 上两种网络都把训练集背得一个不错,测试准确率却很差、很不稳定:深网 5 个种子从 0.428 到 0.801,浅网平均 0.716。深网没有比浅网学得更好,平均还差一些。有的种子到了 0.8,说明网络从一半的输入里学到了一部分结构,但换一个初始化就可能不如瞎猜。
为什么 parity 这么难学?代码 03 演示 3 给了一个直观的解释:
| 任务 | 和任意 1 位的最大相关 | 任意 2 位的 XOR | 任意 3 位 | 任意 9 位 | 全部 10 位 |
|---|---|---|---|---|---|
| parity | 0.000 | 0.000 | 0.000 | 0.000 | 1.000 |
| majority | 0.254 | 0.028 | 0.028 | 0.028 | 0.254 |
| 随机标签 | 0.072 | 0.072 | 0.084 | 0.057 | 0.022 |
parity 和任何单独一位、任何两位、甚至任何 9 位输入的 XOR 都完全不相关,只有全部 10 位放在一起才是 1。它没有”部分正确”的线索:看对 9 位、错 1 位,和完全瞎猜一样。而梯度下降恰恰是靠”部分线索”一步步往上爬的。初始化时,梯度里和标签有关的部分(,5 个种子的平均):
| 网络 | parity | majority | 随机标签 | majority / parity |
|---|---|---|---|---|
| [10, 16, 16, 16, 1] | 0.0283 | 0.3733 | 0.0712 | 13 |
| [10, 61, 1] | 0.0128 | 0.4652 | 0.0735 | 36 |
parity 的”标签信号”比 majority 小一两个数量级,甚至比随机标签还小——梯度几乎不知道该往哪儿走。这不是我们实现的问题,而是一个已知的现象:parity 这类函数对一大类基于梯度的学习方法都很难(Shalev-Shwartz, Shamir & Shammah 2017, “Failures of gradient-based deep learning”)。
所以”为什么要深”的完整答案有两半:
- 表达:对某些有组合结构的函数,深网能用指数级更少的单元表示它(锯齿函数是 ReLU 网络上的严格例子;parity 是逻辑门电路上的严格例子)。
- 学习:表示得出来不等于学得出来。深网要发挥作用,还需要任务本身有可以逐层积累的”部分线索”(边缘的一部分也像边缘,猫的一只耳朵也有点像猫)、足够的数据、合适的结构和超参数。现实中的图像、语音、语言恰好有大量这样的结构,这是深度学习在这些领域成功的原因;但这一点只能靠经验验证,不能从电路理论推出来。
5.5 那到底要多深?
Ng 的建议很务实:从简单的开始。先试逻辑回归,再试一两个隐藏层,然后把隐藏层的个数当作一个超参数,在开发集上比较(§6)。本讲的实验也支持这个建议:代码 04 和代码 05 里,在小型全连接网络上更深都没有带来好处。
另一方面,今天最好的模型确实非常深:第 1 讲 §1.3 的表里,2015 年的 ResNet 有 152 层,现在的大语言模型有几十到上百个 Transformer 层。能把网络做到这么深,靠的是一系列让深网可训练的技术——ReLU(第 1 讲代码 04)、好的初始化(第 7 讲)、Adam(第 8 讲)、Batch Normalization(第 9 讲)、残差连接(第 13 讲)——以及匹配数据结构的架构(卷积、注意力)。本讲的全连接网络还没有这些”装备”,所以深度的好处体现得不明显,这一点在后面几讲会逐步改变。
Ng 还半开玩笑地说过,“深度学习”这个名字本身就是一次很成功的品牌重塑:以前叫”有很多隐藏层的神经网络”,听起来平淡;“深度学习”听起来就很深刻。名字好听不代表越深越好。
6. 参数 vs 超参数 · Parameters vs hyperparameters
6.1 什么是超参数
网络的参数(parameters)是 ——梯度下降自动学出来的数。而下面这些设置,梯度下降不会帮你选,需要你在训练开始前定下来:
- 学习率 (learning rate)
- 迭代次数(number of iterations)
- 隐藏层的个数
- 每层的单元数
- 激活函数的选择(ReLU、tanh、sigmoid……)
- (后面几讲还会加进来)初始化方式、mini-batch 大小、动量、正则化强度、dropout 比例……
它们控制着参数最后变成什么样,所以叫超参数(hyperparameters)。代码 05 演示 1 数了一下:一个 [10, 16, 16, 16, 16, 1] 的网络有 1009 个参数,而决定这次训练的超参数只有 8 个——但正是这 8 个数,决定了梯度下降最后把那 1009 个参数带到哪里。
6.2 深度学习是一个经验过程
超参数能不能事先算出来?大多数情况下不能。Ng 的原话大意是:应用深度学习是一个非常经验化的过程(a very empirical process)。你有一个想法(“学习率用 0.01 吧”),写代码、跑实验、看结果,再根据结果修改——就是第 1 讲 §4.5 的 Idea → Code → Experiment 循环。
代码 05 演示 2 在第 1 讲的”老师网络”任务上做了一次这样的循环:1 / 2 / 4 / 8 个隐藏层(每层 16 个单元)× 7 个学习率,普通梯度下降,2000 步,看 dev(开发集)准确率:
| 隐藏层数 | 参数 | α=0.003 | α=0.01 | α=0.03 | α=0.1 | α=0.3 | α=1 | α=3 | 最好的 α |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 193 | 0.787 | 0.824 | 0.825 | 0.836 | 0.839 | 0.825 | 0.827 | 0.3 |
| 2 | 465 | 0.781 | 0.819 | 0.830 | 0.825 | 0.812 | 0.824 | 0.835 | 3 |
| 4 | 1009 | 0.778 | 0.819 | 0.832 | 0.815 | 0.807 | 0.771 | 0.484 | 0.03 |
| 8 | 2097 | 0.794 | 0.821 | 0.814 | 0.815 | 0.792 | 0.804 | 0.484 | 0.01 |
- 可用的学习率范围随深度变窄:α = 3 时 1、2 个隐藏层还能训练(0.827、0.835),4、8 个隐藏层彻底失败(0.484,等于把所有样本都猜成同一类)。在浅网上调好的学习率,搬到深网上不一定能用。
- 学习率太小,2000 步远远不够:α = 0.003 时四种深度都只有 0.78–0.79。
- 各深度”最好的 α”大致是越深越小。但别把某一格看得太重:2 层时 α 从 0.03 到 3 的准确率都在 0.812–0.835 之间,差别和换一个种子的波动差不多(下面的演示 4)。
- 在各自最好的学习率下,dev 准确率最高的是 1 个隐藏层(0.839)。在这个任务上,更深并没有更好。
α = 3 时深网为什么失败? 我原以为是数值发散(第 1 讲代码 04 里 ReLU 深网在大学习率下就发散过),但这 28 次训练里没有一次出现 inf / nan。代码 05 演示 3 看了 4 个隐藏层时的学习曲线(训练 cost)和每层”死掉”的 ReLU 单元个数(对所有训练样本都输出 0 的单元):
| α | 第 0 步 | 第 100 步 | 第 500 步 | 第 1000 步 | 第 2000 步 | 最大回升 | 死单元(每层 16 个) |
|---|---|---|---|---|---|---|---|
| 0.003 | 0.7132 | 0.6959 | 0.6591 | 0.6190 | 0.5188 | 0.0000 | 0 / 0 / 0 / 1 |
| 0.03 | 0.7132 | 0.6193 | 0.3963 | 0.3449 | 0.2995 | 0.0000 | 0 / 0 / 0 / 2 |
| 0.3 | 0.7132 | 0.3585 | 0.2908 | 0.2645 | 0.1137 | 0.0730 | 0 / 0 / 0 / 0 |
| 1 | 0.7132 | 0.3435 | 0.2060 | 0.1155 | 0.2645 | 0.4615 | 0 / 0 / 0 / 0 |
| 3 | 0.7132 | 0.6930 | 0.6930 | 0.6930 | 0.6930 | 0.0000 | 0 / 6 / 13 / 16 |
(“最大回升”:每 100 步记录一次 cost,相邻两次之间 cost 最多涨了多少。)
学习曲线是调学习率最直接的工具,四种典型形状都在表里:
- 太小(α = 0.003):一路下降,但慢,2000 步后还在降——不是学不会,是太慢。真实项目里这意味着要么多等很久,要么误以为”这个模型不行”。
- 合适(α = 0.03–0.3):前几百步就降下来,之后稳步下降。
- 偏大(α = 1):第 1000 步降到 0.1155,第 2000 步又回到 0.2645——步子太大,在谷底附近来回震荡。
- 太大(α = 3):cost 从第 100 步起就停在 0.6930 ≈ ln 2,再也不动。最后一列给出了原因:最后一个隐藏层 16 个单元全部死掉,网络的输出变成常数。头几步过大的更新把很多单元的 推到了负半轴,它们的梯度从此为 0(第 3 讲的 dead ReLU)。这种失败不报错、不出 nan,只是 cost 停在一个”可疑的数”上——二分类时的 ln 2 等于把每个样本都猜成 0.5 左右。看到 cost 卡在 0.693,就该怀疑网络”死”了。
代码 05 演示 4:换种子的波动有多大? 用每个深度”最好的 α”,换 5 个初始化种子:
| 隐藏层数 | α | dev 平均 | 最低 | 最高 |
|---|---|---|---|---|
| 1 | 0.3 | 0.839 | 0.833 | 0.848 |
| 2 | 3 | 0.813 | 0.806 | 0.821 |
| 4 | 0.03 | 0.829 | 0.825 | 0.831 |
| 8 | 0.01 | 0.807 | 0.786 | 0.814 |
- 同一组超参数,只换种子,dev 准确率的最高和最低相差 0.006–0.027。1 层和 4 层的平均差距约 0.01,和种子间的波动是同一个量级——“1 层比 4 层好”最多只能说得很弱。
- 单个种子选出来的”最好”带着运气:演示 2 里 2 层网络在 α = 3 时是 0.835(那一行最高),换 5 个种子平均只有 0.813。
- 这里的学习率是在 dev 上选的,又在同一个 dev 上报告成绩,会偏乐观。正式的结论要在一个没参与任何选择的 test set 上报告(第 6 讲讲数据划分)。
§5 的几个实验也是同样的道理:代码 03 的 parity 实验里,同一个网络换一个种子,测试准确率能差 0.3 以上。比较两种结构或两组超参数,至少要跑几个种子,并且看差距是否大于种子间的波动。
6.3 Ng 的几条实践建议
- 多试几个值,看结果。比如学习率按约 3 倍的间隔在对数尺度上扫一遍(0.001、0.003、0.01、0.03……),画出 cost 曲线,挑一个降得又快又稳的。第 9 讲会讲更系统的方法(随机搜索、在合适的尺度上采样、“熊猫 vs 鱼子酱”两种调参方式)。
- 一个领域里的直觉不一定能迁移到另一个领域。在视觉上调好的超参数,搬到语音、NLP、推荐系统上未必合适。代码 05 显示,即使在同一个任务上只改深度,最好的学习率就已经变了。
- 最好的超参数会随时间变化。数据变了、硬件(CPU / GPU)变了,过去调好的值可能不再最好;做一个长期项目时,隔几个月值得重新扫一遍。
- Ng 也承认,超参数要靠试,这是深度学习目前”不那么令人满意”的一面;也许将来研究会给出更好的指导。但在那之前,迭代得越快,进步越快(第 1 讲 §4.5),这也是 CS230 后半部分反复强调的。
7. 这和大脑有什么关系? · What does this have to do with the brain?
C1M4 的最后一个视频,Ng 专门讨论了这个问题。他的回答可以概括成:关系不大。
- 类比是怎么来的:一个逻辑回归单元(sigmoid 神经元)接收输入,加权求和,过一个非线性函数,输出一个数——这和”生物神经元接收电信号,累积到阈值就发放”在形式上有点像。前向传播、反向传播这些公式不太容易向外行解释,于是”它像大脑”成了一个好用的比喻,也让神经网络在媒体上显得很神奇。
- 为什么类比很松散:
- 一个真实的神经元本身就是一个极其复杂的系统(树突上的非线性计算、脉冲的时间编码、各种化学过程),远不止”加权求和 + 一个非线性”;神经科学家至今也没完全搞清楚单个神经元在做什么。
- 大脑怎样学习还不清楚。它是否在用类似反向传播的算法、还是用完全不同的学习原理,是一个开放的研究问题(例如 Lillicrap et al. 2020 的综述讨论了大脑里可能存在的”近似反向传播”)。我们的网络依赖精确的反向传播:需要 cache、需要把误差信号沿着同样的权重()传回去,这在生物上很难直接对应。
- Ng 自己的态度:他说这个类比过去常被用,但现在他自己用得越来越少;在计算机视觉等领域,大脑也许给过一些启发,但深度学习本质上是一个非常灵活的函数拟合器——从 到 的复杂映射,用梯度下降学出来。
第 1 讲 §2.6 已经预告过这个结论。本讲的实验又给了它两个具体的注脚:§5.3 的 ReLU 单元比”逻辑门式的神经元”能做更多的事(会加法和比较),§5.4 的网络能表示 parity 却学不会它——这些性质来自数学和优化,而不是来自”它像大脑”。
8. 小结 · Summary
- 层网络 = 同一块积木重复 次。前向:,;对样本的循环被向量化消掉,对层的循环消不掉、也不必消(代码 01:逐样本和整批算的输出差 0.0)。
- 形状规则: , , ,每个梯度和它对应的量同形状。维度检查抓形状错(代码 01:5 个 bug 里抓住 4 个形状 bug,其中 3 个 numpy 可能不报错),梯度检验抓数值错(忘了除以 :8.9e−2 vs 9.8e−9)。
- 反向积木的四个公式:,,,。 只出现在被所有样本共用的参数上。输出层 ,穿过 sigmoid 后约成 ;后者数值更稳( 时 chain 写法的梯度变成 0)。
- cache 存 :反向需要它们;不存就要 次重算;代价是和 batch 成正比的内存( 时已是参数的 3 倍),gradient checkpointing 在两者之间折中。
- 验证:本讲的
deep_nn和第 1 讲的tiny_nn逐数字一致;梯度检验要在”一般的点”上做——b = 0 时恰好落在 ReLU 折点上会”假失败”(8.2e−2)。 - 为什么要深:层次化特征(边缘 → 部件 → 物体)——代码 04 的探针看到了这种层次(4 层网络第 1 层读方向、第 3 层读关系),但参数相同的 4 层网络准确率反而低于 2 层(0.790 vs 0.858)。电路理论——parity 对逻辑门电路有严格的指数差距(DNF 需要 项),对 ReLU 网络却只要 个单元的浅网;ReLU 网络上的严格例子是锯齿函数(24 个单元的深网画出 4,096 段,浅网至少要 4,095 个单元)。
- 能表示 ≠ 能学到:存在精确解的小网络 5 次训练都没拟合 parity;parity 和任何少于 位的特征都不相关,初始化时的梯度信号比 majority 小 13–36 倍。
- 超参数(学习率、迭代次数、层数、单元数、激活函数……)要靠实验找。可用的学习率范围随深度变窄;太大的学习率可能让 ReLU 全部死掉(cost 卡在 ln 2);换种子的波动(0.006–0.027)和不同配置之间的差距同一量级,比较时要多跑几个种子。
- 和大脑的类比很松散:深度学习是一个灵活的、用梯度下降拟合的函数,而不是对大脑的模拟。
9. 常见误区 · Common pitfalls
- “向量化之后,对层的 for 循环也应该去掉。” 去不掉:第 层要等第 层算完。向量化消的是”对样本”的循环(§2.2)。
- ” 的形状是 (输入个数, 输出个数)。” 反了。 要求 是 (输出, 输入),即 。如果某层恰好是方阵,写反了不会报错(§3.2)。
- “程序没报错,形状就是对的。” 广播会让 (5,) 的偏置、忘了
keepdims的db、(m, 1) 的标签都”悄悄”通过(代码 01 演示 3)。在关键位置写assert。 - ” 也要除以 。” 不要。 只在参数的梯度 上出现一次;在 上再除,每往前一层梯度就多缩小 倍(§4.2、练习 3)。
- “数学上等价的写法,用哪个都一样。” 数值上不一定:输出饱和时,先算 再乘 会得到 0,直接用 得到正确的 1(§4.3)。
- “梯度检验失败 = 反向传播写错了。” 不一定。ReLU 折点附近(比如 导致 恰好为 0)差分会不准(代码 01:8.2e−2,换个点就是 4.1e−9)。
- “深网一定比浅网好”/“万能近似定理说明一层就够了”。 两个都不对。深网对某些函数有指数级的表达优势,但能不能学到、在你的任务和数据上是否更好,要靠实验(代码 03、04、05 里深网都没有赢)。
- “parity 证明了 ReLU 浅网需要指数多个单元。” 不对。那是逻辑门电路的定理;ReLU 浅网用 个单元就能算 parity。ReLU 网络的严格例子是锯齿函数(§5.3)。
- “cost 不动了,说明收敛了。” 先看它停在哪:停在 ln 2 ≈ 0.693(二分类)往往说明网络”死”了或什么都没学到(代码 05,α = 3)。
- “跑一次就能比较两个配置。” 种子带来的波动可能和配置之间的差距一样大(代码 05 演示 4:0.006–0.027;代码 03:同一网络换种子差 0.3 以上)。
10. 练习 · Exercises
练习 1(维度)。Ng 讲矩阵维度时用的网络是 layer_dims = [2, 3, 5, 4, 2, 1]。设 。写出 的形状,并算出参数总数。如果把 改成 1000,哪些形状会变?
参考答案
:(4, 5);:(4, 1);、:(4, 100);:(4, 5);:(4, 1);:(5, 100)(和 同形状)。
参数总数 (和代码 01 演示 1 一致;也可以用 deep_nn.count_parameters 验证)。
改成 1000 时,只有和样本有关的量()的第二维变成 1000; 不变。
练习 2(手算一次前向和反向)。一个 layer_dims = [1, 1, 1] 的网络:隐藏层 ReLU,输出层 sigmoid。参数 ,,,。一个样本 ,。
(a) 算出 和损失。(b) 用 §4.2–4.3 的公式算出 。(c) 用 deep_nn 验证。
参考答案
(a) ,;,;损失 。 (b) ;;;;;;。(,所以 不影响数值。) (c)
p = {"W1": np.array([[0.5]]), "b1": np.array([[0.0]]), "W2": np.array([[1.0]]), "b2": np.array([[-1.0]])}
AL, caches = L_model_forward(np.array([[2.0]]), p)
grads = L_model_backward(AL, np.array([[1.0]]), caches)
得到 AL = 0.5,cost 0.6931,dW2 = -0.5、db2 = -0.5、dA1 = -0.5、dW1 = -1.0、db1 = -0.5(还有 dA0 = -0.25,是对输入 的梯度)。所有梯度都是负的:预测偏低(0.5 < 1),所以要把每个参数往上调。
练习 3(推导:1/m 放在哪里)。(a) 证明 (其中 的第 列是 , 的第 列是 )。(b) 如果有人把 也除以 ,在一个 、 的网络里,第 1 层的 会比正确值小多少倍?梯度检验能发现吗?维度检查呢?
参考答案
(a) 看 元素:左边 ;右边 。相等。所以”对样本求和的外积”可以写成一次矩阵乘法,这是向量化 的关键。 (b) 从第 层传到第 1 层要经过 次 的计算,每次多除一个 ,所以 小 倍(第 层小 倍)。梯度检验一定能发现(相对误差接近 1);维度检查发现不了(形状全对)。训练时的症状像极了”梯度消失”:靠前的层几乎不动——这就是为什么不能只凭训练曲线判断反向传播写没写对。
练习 4(输出层)。(a) 从 和 推导 。(b) 本讲的 sigmoid 用 计算。大约从多大的 开始,float64 里 恰好等于 1.0?用 numpy 找一找。(c) 为什么 Coursera 作业里 chain 写法在作业的数据上不会出问题?
参考答案
(a) ,,相乘得 。
(b) 用 z = np.linspace(30, 40, 100001) 扫一遍,本讲的写法在 处第一次恰好等于 1.0(直接写 1 / (1 + np.exp(-z)) 是 36.74)。原因:,当它小于 float64 在 1 附近的间距的一半(约 )时就被舍掉了。
(c) 作业的网络在正常训练中 很少超过 30 多,不会走到这个极端。但在学习率过大、输入没有归一化、或训练很久后过度自信时就可能遇到,所以框架默认用”合并”的写法。
练习 5(cache 的内存)。第 1 讲练习 2 数过 Coursera 识猫网络 [12288, 20, 7, 5, 1] 的参数:245,973 个。作业的训练集有 张图。(a) 按本讲 deep_nn 的 cache 结构,cache 里一共引用了多少个激活值(各层的 和 )?(b) 其中多少是输入 本身、多少是前向传播新算出来的?(c) 和参数个数比,说明什么?
参考答案
(a) 个。 (b) 是 个(它本来就在内存里);新算出来的只有 个。 (c) 这个网络的隐藏层很窄(20、7、5),新增的激活值(13,585)比参数(245,973)少得多,大头是输入本身。“激活值内存超过参数”发生在隐藏层宽、batch 大的网络里:比如隐藏层有 4096 个单元、batch 是 256 时,每一层就要存 万个数。所以内存账要具体算,不能一概而论。
练习 6(parity 网络的规模)。用 §5.3 的三种构造,分别估计 和 时的隐藏单元个数。然后用 02_why_deep_circuits.py 里的 build_parity_tree 和 params_to_dims 验证深层树的答案。
参考答案
- 深层树: 是 2 的幂, 个隐藏层、 个单元。:每层的信号数是 1000 → 500 → 250 → 125 → 63 → 32 → 16 → 8 → 4 → 2 → 1,共 10 个隐藏层;单元数 (信号数为奇数的那两层各多 1 个传递单元)。代码验证:
params_to_dims(build_parity_tree(1000))的隐藏层之和是 2000,层数 10; 时 126 个、6 层。 - 枚举: 和 ——后者比可观测宇宙里的原子数(约 )还多得多。
- 计数:64 和 1000 个。
教训:同样是”能精确计算 parity 的网络”,结构不同,规模可以从几十差到天文数字;而 ReLU 的计数构造说明,“浅网一定要指数多”只对逻辑门成立。
练习 7(证明:浅网的段数上限,深网的段数翻倍)。(a) 证明:一维输入、一个隐藏层、 个 ReLU 单元的网络 在 上最多有 段线性函数。(b) 设 由 段组成,每段都是从 0 单调走到 1 或从 1 单调走到 0。证明 (先 再帐篷映射)由 段组成。由此说明 有 段。
参考答案
(a) 每个单元 是一个分段线性函数,只在 处可能有一个折点( 时没有)。线性组合不会产生新的折点,所以 最多有 个折点,把直线分成最多 段。 (b) 在 的每一段上, 单调地扫过整个 ,途中恰好经过一次 ; 在 处折一次,所以 在这一段上变成两段(先上后下或先下后上),而且每一段仍然从 0 走到 1 或从 1 走到 0。 段变成 段。 本身是 2 段,满足条件,归纳得 有 段。 关键区别:(a) 里折点是加起来的( 个单元 → 个折点),(b) 里折点是乘起来的(每复合一层翻倍)。这就是深度带来指数级表达能力的机制。
练习 8(参数还是超参数?)。把下面每一项归类为”参数""超参数”或”都不是”:;学习率 ;隐藏层个数;;cache 里的 ;每层单元数;mini-batch 大小;激活函数用 ReLU 还是 tanh;;初始化的随机种子;迭代次数。
参考答案
- 参数:、(梯度下降学出来的)。
- 超参数:学习率、隐藏层个数、每层单元数、mini-batch 大小、激活函数的选择、迭代次数。初始化的随机种子严格说也是训练前定下的设置,但我们一般不”调”它,而是用多个种子来估计结果的波动(代码 05 演示 4)。
- 都不是:(中间结果,每次前向都重新算)、(梯度,每次反向都重新算)。 判断标准:参数是训练要学的;超参数是训练开始前你定的、控制参数怎样被学出来;其余是训练过程中的临时量。
练习 9(改代码:先预测再运行)。把 01_building_blocks.py 里的 M = 7 改成 M = 5,然后运行。先预测:演示 3 的表里,bug B 那一行会怎样变?维度检查还能抓住 bug B、C、D 吗?为什么本讲一开始要特意选一个”和所有 都不同”的 ?
参考答案
我运行的结果:bug B 那一行变成”m=5 时否;m=5 时否”——整批数据()上 (5,) 的偏置也能广播,numpy 不再报错,输出悄悄算错(和正确结果最大差 0.006)。bug D 的 cost 从 0.6807 变成 17.0396(数字和 时不同,因为数据变了)。维度检查仍然抓住了 A、B、C、D——它比较的是”形状是否等于规则给出的那个元组”,不依赖 numpy 报不报错。 但 时有一个隐患:第 2 层 的形状 (5, 5) 和”一个 的矩阵”长得一样。如果某个 bug 恰好产生了 (5, 5)(比如 bug C 里被广播成 (5, 5) 的 在前向时加到 (5, 5) 的 上),numpy 照样不报错,单看形状也更容易看走眼。调试时选一个”奇怪”的 (比如 7)能让形状错误更快暴露——Ng 推荐的”在纸上写形状”也是同一个道理。
11. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C1M4 “Deep Neural Networks”(Andrew Ng)——本讲的全部技术内容;编程作业 “Building your Deep Neural Network: Step by Step” 和 “Deep Neural Network - Application”。
- Michael Nielsen, Neural Networks and Deep Learning(免费在线书),第 2 章 “How the backpropagation algorithm works”——用另一套记号把反向传播的四个方程讲得很清楚,适合和本讲 §4.2 对照着读。
- Goodfellow, Bengio & Courville (2016). Deep Learning, 第 6.4 节(架构设计:深度与宽度)、第 6.5 节(反向传播与计算图)。
为什么要深:表达能力
- Håstad (1986). Almost optimal lower bounds for small depth circuits. STOC. ——常数深度的 AND / OR 电路计算 parity 需要指数多个门。
- Montúfar, Pascanu, Cho & Bengio (2014). On the number of linear regions of deep neural networks. NeurIPS. ——ReLU 网络的线性区域个数随深度指数增长。
- Telgarsky (2016). Benefits of depth in neural networks. COLT. ——锯齿函数的深度分离(本讲 §5.3、代码 02 演示 3)。
- Eldan & Shamir (2016). The power of depth for feedforward neural networks. COLT. ——三层网络能表示、两层网络需要指数宽度的函数。
为什么要深:层次化特征
- Lee, Grosse, Ranganath & Ng (2009). Convolutional deep belief networks for scalable unsupervised learning of hierarchical representations. ICML. ——“边缘 → 部件 → 人脸”那类可视化的早期来源之一。
- Zeiler & Fergus (2014). Visualizing and understanding convolutional networks. ECCV. ——逐层可视化 CNN 学到的特征(第 21 讲)。
能表示 ≠ 能学到
- Shalev-Shwartz, Shamir & Shammah (2017). Failures of gradient-based deep learning. ICML. ——parity 等函数为什么难以用梯度方法学到。
工程
- Chen, Xu, Zhang & Guestrin (2016). Training deep nets with sublinear memory cost. ——gradient checkpointing:少存激活值、反向时重算(§4.4)。
大脑
- Lillicrap, Santoro, Marris, Akerman & Hinton (2020). Backpropagation and the brain. Nature Reviews Neuroscience. ——大脑里是否、以及怎样可能实现类似反向传播的学习。
12. 下一讲预告 · Next lecture
到这里,Part I 的”工具”部分就搭完了:从一个神经元(第 1 讲)、逻辑回归(第 2 讲)、两层网络(第 3 讲)到任意 层(本讲),你已经能从零写出一个完整的深层网络,并且知道每个梯度从哪里来、每个形状为什么是那样。
但本讲的实验也反复提醒我们:网络能不能学好,很大程度上取决于任务本身怎么定义——数据是什么、输入给多少信息、输出是什么、损失函数怎么设计。代码 04 里,3,000 个样本时任何结构都学不会;代码 03 里,换一个标签(majority 而不是 parity),同一个网络就从”学不会”变成”近乎完美”。
第 5 讲:深度学习直觉——用案例学会设计输入、输出、数据与损失函数。 这一讲来自 CS230 的课堂讲座(Kian Katanforoosh 的 “Deep Learning Intuition”),用一连串案例练习”设计一个深度学习方案”的手艺:
- 白天 / 黑夜分类:输入图片要多大的分辨率才够?怎样用”人能不能分辨”来估计?
- 触发词检测(“Hey Siri”):标签怎么标?正样本太少怎么办?
- 人脸验证与人脸识别:为什么不能当普通分类问题做?编码(encoding)与 triplet loss;
- 艺术风格迁移:损失函数怎样定义了任务,以及”优化输入图像而不是参数”。
从下一讲开始,你会发现”写出网络”只是第一步;“想清楚要让网络学什么”往往更难,也更重要。