对应 Maps to:Coursera Deep Learning Specialization C1M3 “Shallow Neural Networks”(Neural Networks Overview、Neural Network Representation、Computing a Neural Network’s Output、Vectorizing Across Multiple Examples、Explanation for Vectorized Implementation、Activation Functions、Why do you need Non-Linear Activation Functions?、Derivatives of Activation Functions、Gradient Descent for Neural Networks、Backpropagation Intuition、Random Initialization);编程作业 Planar Data Classification with One Hidden Layer。在 Fall 2025 的课程表里,C1M3 和第 3 次课堂讲座(10/7,Full Cycle of a DL Project)在同一周,那次课堂讲座的内容放在本讲义第 11 讲。 依据说明:Coursera 的视频和编程作业只对注册学员开放,不能公开引用。本讲按 Andrew Ng 在 C1M3 里广为人知的内容来写:记号、公式和推导顺序,“花朵”数据的生成公式,以及作业里”隐藏单元数 1–50”的实验设计。作业的数据生成器照原公式用 numpy 重写,具体的点和原作业不同,所以数字也不同。激活函数的历史与性质依据原始论文(§13)。所有实验数字都来自配套代码。 配套代码 Code:
code/lecture03/(numpy;5 个脚本 + 3 个工具模块。01、02 约 1 秒,04 约 27 秒,03、05 各约 45–50 秒) 预计阅读时间:3 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 用 Andrew Ng 的记号(上标 表示层、上标 表示样本、下标 表示层内第几个单元)写出一个两层网络,说出每个量的形状,并解释为什么”一个隐藏层的网络”叫两层网络。
- 从”一个样本、一个单元”的公式出发,推出向量化的前向传播 ……,并说清楚为什么把样本按列堆起来以后公式不变。
- 画出 sigmoid、tanh、ReLU、Leaky ReLU 的形状,推导它们的导数,说出各自的优缺点,以及隐藏层和输出层分别该怎么选。
- 证明并用实验验证:没有非线性激活,网络叠多少层都等于一层线性函数。线性激活的两层网络就是逻辑回归。
- 独立推导两层网络反向传播的 6 个公式,做维度检查,并会用数值梯度检查自己的实现。
- 解释为什么不能把权重初始化成 0(对称性),以及为什么初始权重要小(饱和)。
- 看懂隐藏层大小怎样影响决策边界,认出过拟合(overfitting)的苗头。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面几讲再展开 Previewed only |
|---|---|
| 第 1 讲:神经元 = 线性 + 非线性;训练四步(前向 → 损失 → 反向 → 更新); 按列堆样本 | 层网络的通用实现、“为什么要深”(第 4 讲) |
| 第 2 讲:sigmoid 输出 + 交叉熵损失;计算图与链式法则;逻辑回归的反向传播 、;向量化与广播 | Xavier / He 初始化的推导;梯度检验的系统用法(第 7 讲) |
| 矩阵乘法、转置;求导的链式法则 | 偏差与方差、正则化、用验证集选超参数(第 6 讲) |
| mini-batch、Adam(第 8 讲);多分类的 softmax 输出层(第 9 讲) |
第 1 讲的 tiny_nn.py 是一个能处理任意层数的”黑盒”。本讲只看一个隐藏层的情形,把这个黑盒里的每一个公式摊开、推导、用实验验证。配套的 shallow_nn.py 从零实现了这个网络,函数划分和 Coursera 编程作业一样;代码 02 会验证它和 tiny_nn 算出的梯度完全一致。
0.3 本讲地图 Map
§1  为什么需要隐藏层:花朵数据上,逻辑回归 ≈ 抛硬币,4 个 tanh 单元 ≈ 94%      ← 代码 01 演示 1–2
§2  网络的表示:记号、形状、每个隐藏单元在做什么                                ← 代码 01 演示 3–4
§3  向量化:从一个样本到 m 个样本,为什么公式不变                                ← 代码 01 演示 3
§4  激活函数:sigmoid / tanh / ReLU / Leaky ReLU 的形状、导数与选择               ← 代码 03 演示 1、3
§5  为什么必须有非线性:线性激活的两层网络 = 逻辑回归                            ← 代码 03 演示 2
§6  梯度下降与反向传播:6 个公式的推导、维度检查、梯度检验                        ← 代码 02
§7  随机初始化:对称性,以及为什么要"小"                                        ← 代码 04
§8  隐藏层大小:决策边界、Bayes 上限、过拟合的苗头                               ← 代码 05
§9  拼起来:一个完整的训练流程(nn_model)                                       ← shallow_nn.py
§10–14  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 | 例子 |
|---|---|---|
| 第 1 层第 个单元的激活值(下标 = 层内第几个单元) | :第 2 个隐藏单元的输出 | |
| 第 个样本在第 1 层的激活值(一个列向量) | 方括号是层,圆括号是样本 | |
| 第 1 层第 个单元的权重(列向量); 的第 行是 | ||
| 隐藏单元个数 | 花朵数据上常用 | |
| 第 层的激活函数; 是它的导数 | , | |
| Ng 的简写: 表示 ,其余类推 | 和对应的量形状相同 | |
逐元素乘法(numpy 里的 *),区别于矩阵乘法(numpy 里的 @) |
数层数:输入层记作第 0 层(),不计入层数。所以”输入 → 一个隐藏层 → 输出层”是一个两层网络(2-layer neural network),。代码里写作 [n_x, n_h, 1]。
0.5 关于数字 · About the numbers
讲义里的实验数字都来自配套代码的实际输出(固定随机种子;每个演示用自己的随机数生成器;同一台机器上重复运行逐字相同,本讲没有计时类的数字)。数据是按 Coursera 作业的公式重新生成的,所以和原作业的数字不同。原作业报告的训练集准确率大约是:逻辑回归 47%,4 个隐藏单元 90%;我们这里是 51.0% 和 94.0%,趋势一致。代码 05 的准确率打印 4 位小数,其他脚本打印 3 位。有几处结果和我写代码前的预想不一样,讲义按实际结果来写,这些情况列在代码 README 的”关于实验结果”里。
1. 为什么需要一个隐藏层 · Why a hidden layer?
1.1 从第 2 讲出发
第 2 讲推导了逻辑回归:一个样本 进来,算 ,再算 作为”是正类的概率”;损失用交叉熵;反向传播时有一个漂亮的结果 ; 个样本一起算时是 、、。第 2 讲还强调:逻辑回归就是一个没有隐藏层的神经网络,只有一个 sigmoid 单元。
逻辑回归的决策边界是 ,在二维平面上是一条直线(高维时是一个超平面)。直线一侧判为 1,另一侧判为 0。那么问题来了:如果两类数据不能用一条直线分开呢?
1.2 花朵数据
Coursera 的编程作业用了一个专门为此设计的数据集,因为点排成一朵花的形状,大家叫它”花朵”数据(load_planar_dataset)。生成方法是这样的(planar_data.py):每类 200 个点,对第 类():
其中 是标准正态噪声。 是角度, 是半径。 让半径随角度起伏,形成”花瓣”。 可以是负数,负半径相当于把点翻到原点的另一侧。正因为这个翻转,两类的花瓣交替出现:第 0 类本来只占 的”上半圈”,但有一半花瓣被翻到了另一半。两个 0.2 的噪声让花瓣有了宽度,也让两类在花心附近和花瓣边缘互相重叠。所以这个数据集没有 100% 正确的分类器(§8.2 会算出最好能做到多少)。
仔细算一下还会发现一个细节(代码 01 演示 4 用到它):8 片花瓣每片占 45°,但有两处是相邻的两片同色,所以绕原点一圈,颜色只变 6 次,而不是 8 次。
我们用这个生成器生成 400 个训练样本(和原作业一样),再用另一个种子独立生成 2000 个测试样本。测试集取 2000 个是为了让测试准确率更稳:400 个样本时,准确率本身就有约 ±1.5 个百分点的随机误差。
1.3 逻辑回归 vs 4 个隐藏单元
代码 01 演示 1–2 在花朵数据上训练了两个模型,都用学习率 1.2、10000 步全批量梯度下降(作业的设定):
| 模型 | 参数个数 | 训练准确率 | 测试准确率 |
|---|---|---|---|
| 逻辑回归 [2, 1] | 3 | 0.510 | 0.501 |
| 两层网络 [2, 4, 1],tanh 隐藏层 | 17 | 0.940 | 0.906 |
终端字符画(plot_tools.py)画出了两个模型的决策边界。背景 ' ' 表示模型预测第 0 类,'.' 表示预测第 1 类;o、x 是两类训练样本,大写的 O、X 是分错的点:
逻辑回归:训练 51.0%                         4 个 tanh 隐藏单元:训练 94.0%
+----------------------------------------+   +----------------------------------------+
|                                        |   |                                        |
|           oooX          oo             |   |           oooX          oo           ..|
|           oooXXo      oooo             |   |..         oooXXo      oooo         ....|
|            o  oo    oo   oo            |   |....        o  oo    oo   oo      ......|
|                 oo  o    o             |   |.......          oo  o    o    .........|
|    X        o    o oX   o        XX    |   |....x....    o    o oX   o   .....xx....|
|  XXXX X XXX oo   Xoo   ooXX XX XXX XX  |   |..xxxx.x.xxx oo   Xoo   ooXx.xx.xxx.xx..|
|    X       X Xo   Xo   * X      XXX X  |   |....x.......x.Xo   Xo   *.x......xxx.x..|
|     X XX      Xoo X o*X      XXXX  ....|   |.....x.xx......xOo X o*x......xxxx......|
|          X   XXXoX*oXXXXx.x.x..........|   |..........x...xxxOx*Oxxxxx.x.x..........|
|         ooooooO.x.OxxOO.O.OOOO.........|   |         ooooooo X OxXoo o oooo         |
|    OOOO......OO*x......O.....O.OO......|   |    oooo      oo*x..... o     o oo      |
|...O.O.....O.OOx...O...x.OOO.......O....|   |   o o     o oOx...O...x.Ooo       o    |
|..OOOOOOO.OO..x...x.x...x..OOO.OOOOOO...|   |  ooooooo oo..x...x.x...x..Ooo oooooo   |
|....................x....xx.............|   |          ..........x....xx....         |
|............x....xO..x....x.............|   |        ....x....xO..x....x......       |
|............x....x....x....x............|   |     .......x....x....x....x........    |
|...........xxxxx.......x.xxx............|   |   ........xxxxx.......x.xxx..........  |
|...........xxxxx........xxxx............|   | ..........xxxxx........xxxx............|
|........................................|   |........................................|
+----------------------------------------+   +----------------------------------------+
左边满屏的大写字母:逻辑回归学到的边界是 ,一条几乎水平的直线。花瓣绕着中心交替排列,任何一条直线两侧都是两类各占一半,所以 51% 并不是梯度下降没收敛,而是模型本身只能画直线。这种”模型太简单、再多数据和训练也没用”的情况叫 high bias(偏差大),第 6 讲会系统地诊断它。
右边只多了 4 个隐藏单元(参数从 3 个变成 17 个),'.' 区域就被切成了几块扇形,大致贴合了花瓣,训练准确率 94.0%,测试准确率 90.6%。
训练过程(每 1000 步记录一次,节选):
| 步数 | cost | 训练准确率 | 测试准确率 |
|---|---|---|---|
| 0 | 0.6932 | 0.320 | 0.301 |
| 1000 | 0.2154 | 0.930 | 0.909 |
| 5000 | 0.1878 | 0.940 | 0.905 |
| 10000 | 0.1799 | 0.940 | 0.906 |
第 0 步的 cost 是 :权重很小时网络对每个样本都输出约 0.5,“完全没把握”时的交叉熵就是 。前 1000 步就学会了大部分东西,之后 cost 还在慢慢降,准确率基本不动。
一个隐藏层到底多做了什么? 这是 §2 的问题。先给答案:每个隐藏单元本身就是一个”小逻辑回归”,各自画一条直线;输出层再把这几条直线的判断组合起来。4 条直线组合起来,就能围出直线画不出的形状。
2. 网络的表示 · Neural network representation
2.1 输入层、隐藏层、输出层
   输入层(第 0 层)        隐藏层(第 1 层)              输出层(第 2 层)

        x₁ ─────────┬──────→ ○  a₁[1] ─┐
              ╲   ╱ ├──────→ ○  a₂[1] ─┤
               ╲ ╱  │                   ├──────→ ○  a[2] = ŷ
               ╱ ╲  ├──────→ ○  a₃[1] ─┤
        x₂ ───╱───╲─┴──────→ ○  a₄[1] ─┘
(每个输入连到每个隐藏单元:全连接)- 输入层就是 本身,记作 。它不做任何计算,所以不算一层。
- 隐藏层(hidden layer):“隐藏”的意思是:训练集里有 也有 ,但没有隐藏单元”应该输出什么”的标准答案。它们的值由网络自己在训练中决定(第 1 讲 §2.3 的”自动学出中间特征”)。
- 输出层输出 。二分类时它是一个 sigmoid 单元。
2.2 每个圆圈做两件事
Andrew Ng 讲”Computing a Neural Network’s Output”时,先只看一个圆圈。每个圆圈都做和逻辑回归一模一样的两件事:
隐藏层的 4 个单元各有自己的 和 ,各自算一遍:
写 4 遍太啰嗦。把 4 个 竖着叠成一个矩阵的 4 行,4 个 叠成一个列向量:
于是一个样本的前向传播只要四行:
后两行就是”以 为输入的逻辑回归”。所以一个两层网络 = 4 个并排的逻辑回归(隐藏层)+ 一个以它们的输出为输入的逻辑回归(输出层)。区别只在于:隐藏层的 4 个”逻辑回归”没有自己的标签,它们的参数由输出层的误差反向传回来决定(§6)。
代码 01 演示 3 的函数 forward_loop_units 就是照这个”每个圆圈做两件事”的方式,用两重 for 循环一个单元、一个样本地算,结果和矩阵写法一样(§3.4)。
2.3 形状
代码 01 演示 3 打印了花朵数据上(、、)每个量的形状:
| 量 | 实际形状 | 一般形状 | 说明 |
|---|---|---|---|
| (2, 400) | 每列一个样本 | ||
| (4, 2) | 第 行 = 第 个隐藏单元的 | ||
| (4, 1) | 广播到 列 | ||
| (4, 400) | 行 = 隐藏单元,列 = 样本 | ||
| (1, 4) | 输出单元对 4 个隐藏单元的权重 | ||
| (1, 1) | |||
| (1, 400) | 每个样本一个概率 |
规律只有一条: 的形状是(本层单元数, 上一层单元数)。参数个数是 , 时 。
2.4 每个隐藏单元在做什么
隐藏单元算的是 :在直线 的一侧接近 +1,另一侧接近 −1,越过直线时平滑地翻转。可以把它想成一个**“软开关”**。 越大,翻转得越陡,越接近一个硬开关。
代码 01 演示 4 把训练好的 4 个单元逐个拿出来看:
| 单元 | 直线 | 离原点 | 输出权重 | 的样本 |
|---|---|---|---|---|
| #0 | 0.01 | 7.70 | 92.8% | |
| #1 | 0.00 | 5.59 | 93.5% | |
| #2 | 0.00 | 11.88 | 90.0% | |
| #3 | 2.72 | −3.33 | 0.0% |
单元 #0:a > 0 处为 '.'  单元 #1:a > 0 处为 '.'  单元 #2:a > 0 处为 '.'  单元 #3:a > 0 处为 '.'
+--------------------+  +--------------------+  +--------------------+  +--------------------+
|                    |  |                    |  |....................|  |    ................|
|.                   |  |                 ...|  |....................|  |         ...........|
|....                |  |               .....|  |....................|  |              ......|
|......              |  |             .......|  |....................|  |                  ..|
|.........           |  |           .........|  |....................|  |                    |
|...........         |  |         ...........|  |                    |  |                    |
|..............      |  |      ..............|  |                    |  |                    |
|................    |  |    ................|  |                    |  |                    |
|................... |  |  ..................|  |                    |  |                    |
|....................|  |....................|  |                    |  |                    |
+--------------------+  +--------------------+  +--------------------+  +--------------------+
这张表比准确率更能说明网络学到了什么:
- 3 个单元(#0、#1、#2)是几乎穿过原点的直线,权重很大,90% 以上的样本上”开关拨到了底”。花朵的花瓣从中心辐射出去,有用的分界线自然也从中心出发。
- 3 条过原点的直线把平面切成 6 个扇形,正好对应 §1.2 说的”绕一圈颜色变 6 次”。
- 单元 #3 几乎没被用上:权重小得多、从不饱和,在整个数据范围内输出只在 −0.84 到 0.22 之间平缓变化,是一个”斜坡”而不是”开关”。4 个单元里有 1 个是多余的。这预告了 §8 的结果: 就够了。
- 输出层在”投票”:。每跨过一条直线,就有一个开关从 −1 翻到 +1(或反过来),投票结果随之改变,于是拼出了扇形相间的边界。
没有人告诉网络”要用过原点的直线”或者”要切成 6 个扇形”。这是梯度下降为了降低 cost 自己找到的中间特征,和第 1 讲 §2.3 里网络自己学出 walkability 是同一件事,只不过这里能直接画出来看。
3. 向量化:从一个样本到 m 个样本 · Vectorizing across examples
3.1 对样本循环
§2.2 的四行公式只处理一个样本。 个样本最直接的写法是循环:
for i = 1 to m:
    z[1](i) = W[1] x(i) + b[1]
    a[1](i) = g(z[1](i))
    z[2](i) = W[2] a[1](i) + b[2]
    a[2](i) = σ(z[2](i))
第 1 讲 §4.4 和第 2 讲都讲过,Python 循环比矩阵运算慢几百到几千倍。我们想要一次算完所有样本。
3.2 把样本横着堆起来
把 个样本的列向量横着排成矩阵(第 1 讲的约定),中间结果也一样横着排:
于是四行公式变成:
和单个样本的公式一模一样,只是小写换成了大写。在矩阵 、 里:
- 横着走(换列)= 换样本:第 列是第 个样本在所有隐藏单元上的值;
- 竖着走(换行)= 换隐藏单元:第 行是第 个隐藏单元对所有样本的输出。
代码 01 演示 3 打印了一个例子: 的第 7 列是 ,即第 7 个样本在 4 个隐藏单元上的输出(竖着读);第 0 行的前 5 个是 ,即第 0 个单元对前 5 个样本的输出(横着读)。
3.3 为什么公式不变?
这是 Ng 的视频 “Explanation for Vectorized Implementation” 要回答的问题。为了简单,先假设 。矩阵乘法可以按列拆开看:
的第 列只和 的第 列有关,恰好就是第 个样本的 。再加上 :它的形状是 ,加到 的矩阵上时,numpy 把它复制到每一列(广播),等于给每个样本都加上同一个 。激活函数是逐元素的,不在乎有几列。第二层同理。
所以向量化不是近似,它和逐个样本算是同一个计算,只是把循环交给了 numpy 底层的线性代数库。
3.4 代码验证
代码 01 演示 3 用三种写法算同一个 :
| 写法 | 和矩阵写法的最大差别 |
|---|---|
| (a) 对样本循环 × 对隐藏单元循环(两重 for) | 4.4e−16 |
| (b) 对样本循环,单元用矩阵 | 4.4e−16 |
| (c) 一次矩阵乘法 | — |
4.4e−16 是浮点数的舍入误差(加法的顺序不同,最后一位可能不同),数学上三者完全相等。
4. 激活函数 · Activation functions
到目前为止隐藏层用的都是 tanh。为什么不用 sigmoid?为什么现代网络大多用 ReLU?输出层又该用什么?
4.1 四个候选
| 名字 | 公式 | 输出范围 | 一句话 |
|---|---|---|---|
| sigmoid | (0, 1) | 可以解释成概率;二分类输出层的标准选择 | |
| tanh | (−1, 1) | sigmoid 平移、拉伸后的版本,以 0 为中心 | |
| ReLU | [0, ∞) | 正半轴是恒等函数,负半轴是 0;现代网络的默认选择 | |
| Leaky ReLU | (−∞, ∞) | 负半轴留一个很小的斜率 |
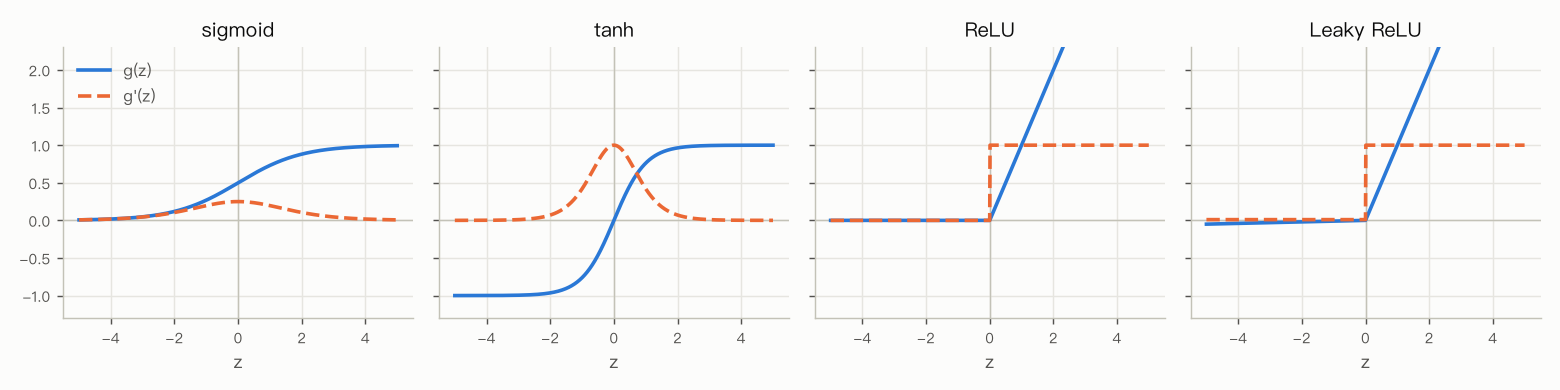
(这张图由 03_activation_functions.py 生成;没装 matplotlib 时脚本只打印下面的表。)
代码 03 演示 1 在一排 上算出了取值和导数(节选):
| −4 | −1 | 0 | 1 | 4 | |
|---|---|---|---|---|---|
| 0.018 | 0.269 | 0.500 | 0.731 | 0.982 | |
| 0.018 | 0.197 | 0.250 | 0.197 | 0.018 | |
| −0.999 | −0.762 | 0.000 | 0.762 | 0.999 | |
| 0.001 | 0.420 | 1.000 | 0.420 | 0.001 | |
| ReLU | 0.000 | 0.000 | 0.000 | 1.000 | 4.000 |
| ReLU | 0.000 | 0.000 | 0.000 | 1.000 | 1.000 |
| Leaky ReLU | 0.010 | 0.010 | 0.010 | 1.000 | 1.000 |
4.2 导数的推导 · Derivatives of activation functions
反向传播要用到 (§6),所以先把四个导数推出来。
sigmoid。,用链式法则:
最后一步用了 。记 ,则 。 在 (即 )时最大,等于 1/4。
tanh。用商的求导法则,记 、,注意 、:
记 ,则 ,在 处最大,等于 1。
ReLU: 时导数是 1, 时是 0。Leaky ReLU: 时是 1, 时是 0.01。
两个实现细节:
- sigmoid 和 tanh 的导数都能用前向时已经算好的 表示。反向传播时不用再算一次指数,直接用缓存里的 :
dZ1 = dA1 * (1 - A1**2)。这也是它们好用的原因之一。 - ReLU 在 处严格来说不可导(左导数 0、右导数 1)。实践中随便约定一边就行(代码里归到 0),因为浮点数恰好等于 0 的概率几乎为零,对训练没有影响。数学上这叫取一个”次梯度”(subgradient)。
代码 03 演示 1 用数值导数 在 上核对了这四个公式,最大误差分别是 8.5e−11、7.4e−11、1.4e−10、1.4e−10(跳过了 )。
4.3 为什么隐藏层里 tanh 通常比 sigmoid 好
Ng 在视频里说得很直接:隐藏层几乎总是用 tanh 比 sigmoid 好,sigmoid 只留给二分类的输出层。理由有两个,第三点是一个常被忽略的事实。
① 导数大 4 倍。 最大 0.25, 最大 1。反向传播时梯度要乘上 (§6.2),用 sigmoid 时每穿过一层至少打 4 折。第 1 讲代码 04 已经看到,在 5 层 sigmoid 网络里这会让第 1 层的梯度只剩输出层的约 1/2000。
② 以 0 为中心(zero-centered)。 当 来自标准正态分布时,代码 03 演示 1 算出的平均输出是:tanh 0.000,sigmoid 0.500,ReLU 0.400,Leaky ReLU 0.396。为什么”平均值在 0 附近”重要?看下一层的权重梯度。单个样本对 的梯度是
是一个数, 是一个向量。如果 的分量全是正的(sigmoid 的输出在 (0, 1)),那么这个样本给 的每个分量的梯度符号都一样:要么全部往上推,要么全部往下推。想让一个权重变大、另一个变小,就只能靠不同样本之间互相抵消,走”之”字形的路线。这个论证最早出自 LeCun 等人的 Efficient BackProp(1998)。代码 03 演示 1 在花朵数据上直接数了一下:
| 隐藏层激活 | 一个样本给 的 4 个梯度分量全部同号的样本比例 |
|---|---|
| sigmoid | 100.0% |
| tanh | 2.2% |
| ReLU | 100.0% |
| Leaky ReLU | 2.2% |
(Leaky ReLU 的负输出 虽然小,符号却是负的,所以”全部同号”的比例也低。但它的平均值是 0.396,离零中心还远。这个统计只看符号,不看大小。)
③ 两者能表示的函数完全一样。 有一个恒等式:
所以任何 sigmoid 隐藏层的网络,都可以精确地改写成 tanh 隐藏层的网络:把 减半, 加上 (练习 3)。代码 03 演示 3 末尾验证了,改写前后的输出最大差别是 2.2e−16。这说明 sigmoid 和 tanh 的差别不在”能表示什么”,而在”梯度下降走得顺不顺”。代码 03 演示 3 的实验(§4.6)也是这样:两者最终准确率几乎一样,tanh 只是快得多。
4.4 为什么 ReLU 成了默认选择
sigmoid 和 tanh 有一个共同的毛病:饱和(saturation)。代码 03 演示 1: 时 , 时 。 一旦跑到这些区域,“推一下几乎没反应”,梯度传不回去,学习就停滞了。
ReLU 在 时导数恒等于 1,不会饱和。它的好处:
- 梯度不衰减:正半轴上梯度原样通过,深层网络里不会一层层被打折(第 1 讲代码 04:ReLU 深网在很宽的学习率范围内 100–200 步就学会了,sigmoid 深网只在很窄的范围内能训练);
- 计算便宜:一个比较和一次取最大值,没有指数运算;
- 稀疏:负半轴的输出恰好是 0,一部分单元对某个样本”完全不激活”。
它也有缺点:
- dead ReLU:如果某个单元对所有训练样本都有 ,它的梯度永远是 0,再也学不动了(第 1 讲练习 1(d) 已经见过这个现象)。学习率太大或者初始化不好时容易出现。Leaky ReLU 在负半轴保留 0.01 的斜率,就是为了让这些单元还能”活过来”。它由 Maas、Hannun 和 Ng(2013)在语音识别网络里提出。
- 不是零中心的:§4.3 的”全部同号”问题它也有(100%),但它照样是最常用的激活函数。可见零中心是一个加分项,不是决定性的。
历史上,ReLU 在 2010–2012 年间流行起来:Nair & Hinton(2010)、Glorot、Bordes & Bengio(2011)展示了它在深层网络里好训练;AlexNet(2012)报告用 ReLU 的卷积网络在 CIFAR-10 上达到 25% 训练误差的速度是 tanh 的约 6 倍。今天的 Transformer 大多用 ReLU 的平滑变体,比如 GELU(BERT、GPT 系列)或 SwiGLU(LLaMA 等)。
4.5 输出层用什么
输出层的激活函数由输出 是什么决定,和隐藏层的选择是两回事:
| 任务 | 输出层激活 | 例子 |
|---|---|---|
| 二分类, | sigmoid | 猫 / 非猫、本讲的花朵 |
| 回归, 可正可负 | 线性() | 预测温度变化 |
| 回归, | 线性或 ReLU | 房价(第 1 讲) |
| 多分类 | softmax | 第 9 讲 |
这几乎是唯一应该用线性激活的地方。隐藏层用线性激活会怎样?那是 §5 的主题。
4.6 实验:同一个任务上,谁学得快?
代码 03 演示 3 用五种隐藏层激活,在三个数据集(花朵;§8 会用到的同心圆、两个月牙)上各训练一个 [2, 20, 1] 网络。学习率 1.2,10000 步,每种组合 3 个初始化种子(2、3、4)。“达到门槛”指训练准确率第一次达到:花朵 85%、同心圆 75%、月牙 95%(明显好于逻辑回归、接近该数据集能达到的水平)。
(a) 作业的设定: 随机数
| 达到门槛的步数(3 个种子) | 花朵(≥85%) | 同心圆(≥75%) | 月牙(≥95%) |
|---|---|---|---|
| linear | —/—/— | —/—/— | —/—/— |
| sigmoid | 300/400/400 | 4500/4500/4400 | —/—/9200 |
| tanh | 100/100/100 | 1100/1000/1000 | 1800/1800/1700 |
| ReLU | 600/400/— | 200/100/200 | —/—/— |
| Leaky ReLU | 400/300/— | 200/100/200 | —/—/— |
| 最终测试准确率(3 个种子平均,括号里是范围) | 花朵 | 同心圆 | 月牙 |
|---|---|---|---|
| linear | 0.501 | 0.483 | 0.868 |
| sigmoid | 0.908(0.902–0.911) | 0.783 | 0.906(0.879–0.961) |
| tanh | 0.902(0.896–0.907) | 0.783 | 0.963 |
| ReLU | 0.820(0.783–0.855) | 0.789 | 0.882 |
| Leaky ReLU | 0.808(0.765–0.845) | 0.789 | 0.882 |
(b) 只换初始化: 的标准差改成 1(对 2 个输入的 ReLU 层,这正好是第 7 讲 He 初始化给出的 )
| 花朵 | 同心圆 | 月牙 | |
|---|---|---|---|
| ReLU:步数 / 测试准确率 | 100/200/200,0.835 | 100/100/100,0.766 | 100/100/100,0.963 |
| Leaky ReLU | 100/100/200,0.837 | 100/100/100,0.767 | 100/100/100,0.960 |
| tanh | 100/100/100,0.895 | 100/100/100,0.763 | 100/100/100,0.964 |
读这两张表时,我原本预想的是”ReLU 最快、准确率不输 tanh”。实际结果更复杂:
- linear 永远达不到门槛,三个数据集上都等于逻辑回归(§5)。非线性是必需品。
- sigmoid vs tanh:最终准确率几乎一样(花朵 0.908 vs 0.902),这和 §4.3 的第 ③ 点吻合:两者能表示的函数相同。差别在速度:同样的学习率下,tanh 达到门槛的步数少得多(花朵中位数 100 vs 400,同心圆 1000 vs 4500)。sigmoid 在月牙上还有 2 个种子停在了 0.88 左右的差解上。
- ReLU / Leaky ReLU 的表现取决于数据集和初始化:同心圆上它们最快(200 步)。但在作业的 0.01 初始化下,花朵和月牙上它们停在明显更差的解(测试 0.820、0.882,tanh 是 0.902、0.963)。换成更大的初始化(表 b)后,月牙上 ReLU 追平了 tanh(0.963 vs 0.964),花朵上仍然落后(0.835 vs 0.895)。我在写代码的原型阶段还试过学习率 0.1 和 0.3、训练 30000 步,花朵上 ReLU 也一直落后。
为什么花朵上 tanh 更好?一个可能的解释(我没有专门做实验验证):§2.4 看到,花朵需要的是几条过原点的”开关”,每个开关的输出和点离原点多远无关。tanh 单元饱和以后正好是这样的有界开关;ReLU 单元却是一个随距离线性增长的”斜坡”,离中心越远输出越大,要拼出”扇形”就别扭得多。初始化太小对 ReLU 尤其不利,这一点第 7 讲会从”信号的方差”角度解释。
所以”隐藏层默认用 ReLU”是针对深层网络的经验法则:它的主要优势是梯度穿过很多层时不衰减、计算便宜,这些在只有一个隐藏层、输入只有 2 维的小问题上都不重要。Ng 自己的建议也不是”永远用 ReLU”,而是:拿不准的时候,几种都试一试,在验证集上比较(第 6 讲讲怎样建立验证集)。
4.7 选择建议
| 位置 | 建议 | 理由 |
|---|---|---|
| 隐藏层(默认) | ReLU | 不饱和、便宜,深层网络好训练 |
| 隐藏层(ReLU 出现很多 dead unit 时) | Leaky ReLU | 负半轴也有梯度 |
| 隐藏层(浅层网络、小问题) | tanh 也值得一试 | 本讲的花朵、月牙上 tanh 更好(§4.6) |
| 隐藏层 | 几乎不用 sigmoid | 导数小、不以 0 为中心;能表示的函数和 tanh 一样,却学得更慢 |
| 隐藏层 | 不用线性 | 等于没有这一层(§5) |
| 输出层 | 由 决定 | 二分类 sigmoid、回归线性、多分类 softmax(§4.5) |
5. 为什么必须有非线性 · Why non-linear activations?
5.1 线性的叠加还是线性
第 1 讲 §2.4 用一行公式说明过:两层没有激活函数的线性变换合起来还是一个线性变换。现在把它说完整。设隐藏层用线性激活 :
的形状是 ,和逻辑回归的 一样。所以
这就是一个逻辑回归。不管 是 4 还是 4000,不管叠多少个线性层(用归纳法:每多一层,就多乘一个矩阵、多加一个向量,结果仍是”矩阵 × x + 向量”),整个网络能表示的函数都和一个线性层(再加一个输出激活)完全相同。隐藏层的意义就在于它的非线性。
5.2 实验:线性激活的两层网络 = 逻辑回归
代码 03 演示 2 把隐藏层激活换成 ,用和 §1.3 一样的设定训练:
| 模型 | 参数个数 | 训练准确率 | 测试准确率 | 最终 cost | 测试集上和逻辑回归预测相同 |
|---|---|---|---|---|---|
| 逻辑回归 [2, 1] | 3 | 0.510 | 0.501 | 0.6571 | 100.0% |
| 线性激活 [2, 4, 1] | 17 | 0.510 | 0.501 | 0.6571 | 100.0% |
| 线性激活 [2, 50, 1] | 201 | 0.510 | 0.501 | 0.6571 | 100.0% |
再把训练好的 [2, 4, 1] “压扁”:
- 网络:,;
- 单独训练的逻辑回归:,;
- 网络输出 和 在测试集上的最大差别:1.1e−16。
线性激活的网络不只是”准确率和逻辑回归差不多”:它的决策边界就是逻辑回归那条直线(代码里的字符画两张图都是 §1.3 左边那张),参数压扁以后和逻辑回归在 3 位小数上相同。[2, 50, 1] 多出来的 198 个参数一个都没用上,只是把同一个线性函数用更啰嗦的方式写了一遍。
我原本以为,换成""这种乘积形式的参数化以后(它对参数不再是凸的),梯度下降可能停在别的地方。实际上它找到的正是逻辑回归的那个最优解。
5.3 线性激活什么时候可以用
- 回归任务的输出层(§4.5):输出本来就是一个实数,不需要再压缩。
- 隐藏层几乎从不用线性激活。偶尔会看到不带激活函数的线性层,比如把向量投影到另一个维度(第 17 讲 Transformer 里的 投影),但它们前后总有别的非线性(比如 softmax 注意力),整体仍是非线性的。
6. 梯度下降与反向传播 · Gradient descent & backpropagation
这是本讲的核心:两层网络的梯度到底怎么算。
6.1 要算什么
参数:,,,。Cost:
梯度下降(Ng 的 “Gradient Descent for Neural Networks”):
随机初始化参数(§7)
重复:
    前向传播:算出所有样本的预测 A[2]
    反向传播:算出 dW[1], db[1], dW[2], db[2]
    更新:W[1] ← W[1] − α dW[1],b[1] ← b[1] − α db[1],W[2]、b[2] 同理
前向传播 §3 已经有了。下面推导反向传播:先推一个样本的,再向量化。
6.2 一个样本的推导
计算图(第 2 讲的工具):
x ──┐
W[1]─┼─→ z[1] = W[1]x + b[1] ─→ a[1] = g(z[1]) ──┐
b[1]─┘                                          W[2]─┼─→ z[2] = W[2]a[1] + b[2] ─→ a[2] = σ(z[2]) ─→ L(a[2], y)
                                                b[2]─┘
     ←─────────── 反向传播:从右往左,每一步乘上"局部导数" ───────────
从最右边往左走,每一步只用链式法则:
第 ① 步:。 第 2 讲推导过 sigmoid + 交叉熵的组合:,乘上 ,化简后
第 ② 步:、。 ( 只有一行, 是它的第 个元素)。 对 的偏导是 ,所以
和逻辑回归的 完全一样,只是”输入”换成了 。( 是行向量,所以写成 而不是 。)
第 ③ 步:把误差传回隐藏层,。 对 的偏导是 ,所以
这一步是反向传播和逻辑回归真正不同的地方:输出的误差按输出权重分配给每个隐藏单元。输出权重大的单元,对 的影响大,分到的”责任”也大;输出权重是负的单元,被要求往反方向变。
第 ④ 步:穿过激活函数,。 ,每个单元只依赖自己的 ,所以是逐元素相乘:
在这里起”阀门”的作用:tanh 单元饱和时 ,不管输出层传回多大的误差,这个单元都几乎收不到梯度。§4.4 的”饱和”、§7.4 的”初始化太大”,问题都出在这里。
第 ⑤ 步:、。 和第 ② 步一样,只是输入换成 :
这一步是一个外积:,即”第 个单元该改多少” × “第 个输入有多大”。
6.3 向量化:m 个样本的 6 个公式
把样本按列堆起来,对 ( 个损失的平均)求导:
shallow_nn.py 的 backward_propagation 就是这 6 行,旁边标着”公式 (1)–(6)“。几个值得想清楚的地方:
- 放在哪里? Ng 的约定是: 存的是”每个样本自己的”,不带 ; 只在算 、 时出现,因为 是 个样本的平均。
- 矩阵乘法自动完成了对样本的求和。 本该是 。按”列 × 行”展开矩阵乘法,,正好就是这个求和。 没有可以乘的输入,所以显式地
np.sum(..., axis=1)。 keepdims=True让 保持 的二维形状。忘了它会怎样,见 §6.4。- 公式 (4) 里的 是逐元素乘法: 是 , 也是 ,两者对应位置相乘。tanh 时 ,用缓存里的 直接算。
把这 6 行和 §1.1 回顾的逻辑回归对比:公式 (1)–(3) 就是”输入为 的逻辑回归”;公式 (5)–(6) 就是”误差为 的逻辑回归”;新东西只有公式 (4),它把误差从输出层传回了隐藏层。第 4 讲会看到, 层网络无非是把公式 (4)–(6) 重复 次。
6.4 维度检查 · Getting the dimensions right
Ng 在 “Backpropagation Intuition” 里说,实现反向传播时最容易出错的就是维度。规则只有两条:
和 同形状, 和 同形状( 和 同形状)。
代码 02 演示 2 在花朵数据上逐个检查:
| 前向的量 | 形状 | 反向的量 | 形状 |
|---|---|---|---|
| (4, 2) | (4, 2) | ||
| (4, 1) | (4, 1) | ||
| (4, 400) | (4, 400) | ||
| (1, 4) | (1, 4) | ||
| (1, 1) | (1, 1) | ||
| (1, 400) | (1, 400) |
形状还能告诉你转置放在哪里: 必须是 ,手里有 和 ,唯一能凑出 的乘法就是 。
演示 2 还故意制造了两个形状 bug:
- 把公式 (4) 的 写成矩阵乘法
@:@维度对不上,numpy 立刻报错。这是”幸运”的 bug。 - 求 时忘了
keepdims=True: 变成形状 的一维数组, 被悄悄广播成 ,更新这一步不报错。错误要到下一次前向传播 才暴露,而报错信息指向的是前向传播函数,离真正写错的那一行很远。更糟的是 碰巧没事(),这种”有时对、有时错”的 bug 最难查。这是第 1 讲 §3.5 的 rank-1 数组陷阱在反向传播里的样子。
6.5 手算一遍
公式推完了,用一个能手算的例子把每个数都过一遍。代码 02 演示 1:2 个输入、2 个 tanh 隐藏单元、1 个样本。,,,,,。(,所以没有 。)
| 公式 | 数值 | |
|---|---|---|
| 前向 | ||
| 反向 | ||
逐行读一下,这就是 “Backpropagation Intuition” 想传达的东西:
- 网络预测 0.3083,真实答案是 1,预测偏低。 表示” 应该变大”(梯度下降沿负梯度方向走)。
- 把误差按输出权重分回去:单元 0 的输出权重是 +1,它被要求”变大”();单元 1 的输出权重是 −2,它反而被要求”变小”(),而且责任是单元 0 的两倍。
- 再乘上 :单元 1 的 更大、更接近饱和,斜率只有 0.5966(单元 0 是 0.7864),所以它分到的梯度被打了更大的折扣。
- 数值导数逐项核对,四个参数的相对误差都不超过 4.4e−10。用学习率 0.5 走一步, 从 0.3083 升到 0.8311,损失从 1.1768 降到 0.1850,方向是对的。
6.6 梯度检验:点到为止 · Gradient checking (preview)
推导和代码都可能出错,而反向传播的 bug 往往不报错:网络照样训练,只是学得慢或者学得差。最可靠的检查办法是数值梯度:把某个参数推一下,看 变多少。
用双边差分是因为它的误差是 ,单边差分 的误差是 。Ng 的经验标准:相对误差约 1e−7 很好;约 1e−5 大概没问题,但要再看看;约 1e−3 很可能有 bug。(第 7 讲会系统地讲梯度检验的用法和注意事项,比如不要和 dropout 一起用。)
代码 02 演示 3 用 gradient_check 检查了正确的实现和三个故意写错的版本:
| 版本 | 刚初始化() | 训练 1000 步之后 | 训练后各参数的相对误差 |
|---|---|---|---|
| 正确的版本 | 1.4e−07 | 1.6e−09 | 4e−09 / 6e−10 / 9e−09 / 4e−11 |
| A: 忘了乘 | 8.7e−04 | 9.1e−01 | 1e+00 / 1e+00 / 9e−09 / 4e−11 |
| B:tanh′ 写成 | 4.5e−06 | 1.0e+00 | 1e+00 / 1e+00 / 9e−09 / 4e−11 |
| C: 忘了除以 | 8.4e−01 | 7.8e−01 | 9e−01 / 6e−10 / 9e−09 / 4e−11 |
(五种激活函数的正确实现,训练后的相对误差在 1.6e−09 到 9.0e−09 之间。)
两个收获:
- 按参数分开算相对误差,能定位 bug。 三个 bug 的 梯度都是对的,错误只出现在 (和 )上;bug C 只动了 ,所以 那一项也是对的。
- 一个陷阱:在刚初始化的参数上,有的 bug 会躲过去。 bug B 的相对误差只有 4.5e−06,按经验标准会被当成”大概没问题”;bug A 是 8.7e−04,处在”值得担心”的边缘,也容易被忽视。原因是 时 ,而 、:在 0 附近,漏乘 、把 写成 几乎没有区别。训练 1000 步、参数离开 0 附近之后,它们就原形毕露了。这正是 Ng 的建议:梯度检验在随机初始化后做一次,训练一段时间后再做一次。
6.7 和第 1 讲的黑盒对答案
代码 02 演示 4 把同一组参数分别交给本讲的 shallow_nn 和第 1 讲的 tiny_nn:前向输出完全相同(差别 0),四个梯度的最大差别是 0 到 2.8e−17。第 1 讲当作黑盒的 tiny_nn.backward,在一个隐藏层的情况下算的就是这 6 个公式,只是它用一个从最后一层往前走的 for 循环来处理任意层数(第 4 讲拆开这个循环)。
7. 随机初始化 · Random initialization
逻辑回归可以把 、 都初始化成 0(第 2 讲就是这样做的,代码里的 logistic_regression 也是),因为它只有一个单元。神经网络为什么不行?
7.1 对称性论证
假设把 和 都初始化成 0。更一般地,假设某一步时:
- 的各行相同、 的各分量相同(所有隐藏单元的参数一样);
- 的各分量相同(输出层对所有隐藏单元一视同仁)。
那么:
- 对每个样本,所有隐藏单元的 相同 → 相同,即 的各行相同;
- 的各分量相同;
- 的各行相同( 各分量相同), 的各行相同 → 的各行相同 → 的各行相同、 的各分量相同;
- 更新以后,上面两个条件仍然成立。
由归纳法,这些条件永远成立: 个隐藏单元从头到尾计算同一个函数,等于只有 1 个隐藏单元,再大的隐藏层也是浪费。这叫对称性问题(symmetry problem)。随机初始化 的作用就是打破对称(symmetry breaking):从第 0 步起,每个单元就和别的单元不同,梯度也不同,它们会朝不同的方向发展,学出不同的特征。
可以初始化成 0:只要 的各行不同,各单元就已经不同了。
7.2 实验
代码 04 演示 1 在花朵数据上用 4 个隐藏单元、学习率 1.2、10000 步,比较四种初始化:
| 初始化 | 第 0 步 | 第 0 步 | 训练后 各行最大差别 | 训练准确率 | 测试准确率 |
|---|---|---|---|---|---|
| 全 0(tanh) | 0.0e+00 | 0.0e+00 | 0.00e+00 | 0.500 | 0.500 |
| 全 0(sigmoid) | 0.0e+00 | 0.0e+00 | 0.00e+00 | 0.500 | 0.500 |
| 全是 0.5,(tanh) | 1.9e−01 | 6.4e−01 | 0.00e+00 | 0.680 | 0.688 |
| 随机数(tanh) | 3.3e−03 | 7.2e−03 | 2.21e+01 | 0.940 | 0.906 |
| 对照:只有 1 个隐藏单元 | 0.713 | 0.668 |
每一行都值得看:
-
全 0 + tanh:一步也不动。 ,所以 → ;又因为 → → 。所有梯度恰好为 0,10000 步后所有参数仍是 0,网络永远输出 0.5。这是一个鞍点(saddle point):梯度为 0,但离最优解很远。
-
全 0 + sigmoid:也一步不动,但原因不同。 ,按理 能收到梯度 。但花朵数据两类各 200 个,第 0 步 ,于是所有梯度又恰好为 0。(我原以为这里会看到”各行相同但不为 0”,实际结果是全卡死。类别不平衡时会怎样,见练习 6。)
-
全是 0.5:能动,但 4 个单元永远一样。 训练 10000 步之后的 :
              W 全是 0.5                                  0.01 × 随机数
  单元 #0     [ +4.9984  +5.3033]  b=-0.2082              [-11.1400 -14.1951]  b=+0.1901
  单元 #1     [ +4.9984  +5.3033]  b=-0.2082              [+10.2964 -11.6952]  b=-0.0762
  单元 #2     [ +4.9984  +5.3033]  b=-0.2082              [ +0.2797  +7.8789]  b=+0.0062
  单元 #3     [ +4.9984  +5.3033]  b=-0.2082              [ +0.0676  +0.1623]  b=-0.4779
  W2          [-0.185 -0.185 -0.185 -0.185]               [ 7.6983  5.5939 11.877  -3.3257]
左边 4 行逐位相同, 的 4 个分量也相同。这个网络实际上只有 1 个隐藏单元,准确率 0.680 也和真正只有 1 个隐藏单元的网络(0.713)差不多。两者停在了不同的局部解,所以不完全相等。
-
随机初始化:4 行各不相同,就是 §2.4 分析过的那个网络。
7.3 对称是一个”不稳定的平衡”
如果初始值几乎对称,只差一点点呢?代码 04 演示 2 在 ” 全是 0.5” 上加了 1e−8 或 1e−4 的随机扰动:
| 步数 | 无扰动(精确对称) | 扰动 1e−08 | 扰动 1e−04 |
|---|---|---|---|
| 0 | 0.0e+00(0.323) | 1.2e−08(0.323) | 1.2e−04(0.323) |
| 100 | 0.0e+00(0.675) | 3.0e−07(0.675) | 3.0e−03(0.675) |
| 1000 | 0.0e+00(0.675) | 1.9e−03(0.675) | 6.1e+00(0.915) |
| 3000 | 0.0e+00(0.680) | 4.1e+00(0.715) | 1.3e+01(0.932) |
| 10000 | 0.0e+00(0.680) | 1.1e+01(0.730) | 2.2e+01(0.943) |
(表中是 各行之间的最大差别,括号里是训练准确率。)
- 精确对称时,差别永远是精确的 0。在计算机里,相同的输入做相同的浮点运算,结果逐位相同。§7.1 的归纳法在浮点数下也严格成立。
- 一旦有一点点不同,差别会指数式地长大:1e−8 在 1000 步后变成 1.9e−03。对称点像一支立在笔尖上的铅笔:理论上能立住,稍有偏差就会倒。
- 但”会倒”不等于”倒得好”:1e−8 的扰动花了几千步才把单元分开,最后只有 0.730;1e−4 的扰动 1000 步内就分开了,最后 0.943,和正常的随机初始化差不多。实践中没有人这样微调,直接用随机数初始化就行。
7.4 为什么初始权重要”小”
Ng 的作业用的是 W1 = np.random.randn(n_h, n_x) * 0.01。为什么乘 0.01,而不是 1 或 100?
如果 很大, 就很大,tanh / sigmoid 一开始就饱和:,梯度传不过去(§6.2 第 ④ 步的”阀门”几乎关死)。代码 04 演示 3 把尺度从 0.001 扫到 100,每个尺度 10 个种子:
| scale | 初始时 的比例 | 初始时平均 | 初始 cost | 10 次里达到 90% 训练准确率 | 平均测试准确率 |
|---|---|---|---|---|---|
| 0.001 | 0.0% | 1.000 | 0.69 | 10 / 10 | 0.910 |
| 0.01 | 0.0% | 0.999 | 0.69 | 10 / 10 | 0.911 |
| 0.1 | 0.0% | 0.928 | 0.69 | 10 / 10 | 0.908 |
| 1 | 30.3% | 0.355 | 0.87 | 8 / 10 | 0.860 |
| 10 | 86.1% | 0.062 | 6.07 | 4 / 10 | 0.768 |
| 100 | 98.1% | 0.008 | 12.56 | 1 / 10 | 0.681 |
- scale ≤ 0.1:几乎没有饱和,初始 cost ≈ ln 2(“什么都不确定”),10 次全部成功。对一个隐藏层的网络,0.001、0.01、0.1 差别很小,作业用 0.01 是合理的。
- scale = 10、100:86%、98% 的(单元, 样本)组合一开始就饱和,平均斜率只有 0.062、0.008。初始 cost 高达 6.07、12.56:输出层的 sigmoid 也饱和了,网络一开始就”非常自信地错了”。10 次里只有 4 次、1 次能达到 90%,平均测试准确率掉到 0.681。
- 机制:饱和的单元对绝大多数样本”开关已经拨到底”,只能从少数靠近它那条直线的样本里学习,很容易停在差的解上。注意大初始化不是每次都失败(scale = 10 时有 4 次成功),它是让训练变得不可靠。这在实践中同样糟糕:你没法分辨失败是因为想法不对,还是因为运气不好。
7.5 预告:深层网络需要”刚刚好”的尺度
既然小一点更好,是不是越小越好?对一个隐藏层,是的。但在很深的网络里,每一层都把信号乘上一个很小的数(),几十层之后前向的激活值和反向的梯度都会缩到几乎为 0;反过来,尺度太大又会一层层爆炸。第 7 讲会推导”刚刚好”的尺度:让每一层输出的方差保持不变,得到 Xavier 初始化(,适合 tanh)和 He 初始化(,适合 ReLU)。§4.6 的表 (b) 已经让你看到,换成 He 尺度后,ReLU 在月牙数据上从 0.882 升到了 0.963。
8. 隐藏层大小 · Hidden layer size
8.1 从 1 到 50 个隐藏单元
隐藏单元数 是我们自己选的。作业的最后一部分就是把 从 1 调到 50,看决策边界怎样变化。代码 05 演示 1(tanh,学习率 1.2,10000 步,种子 2 / 3 / 4):
| 模型 | 参数 | 训练准确率(3 个种子) | 测试准确率(3 个种子) | 测试平均 | 训练 − 测试 |
|---|---|---|---|---|---|
| 逻辑回归 | 3 | 0.5100 | 0.5010 | 0.5010 | 0.0090 |
| 5 | 0.7125 / 0.7125 / 0.7125 | 0.6680 / 0.6680 / 0.6680 | 0.6680 | 0.0445 | |
| 9 | 0.6925 / 0.6925 / 0.6925 | 0.6610 / 0.6610 / 0.6610 | 0.6610 | 0.0315 | |
| 13 | 0.9400 / 0.9400 / 0.9400 | 0.9075 / 0.9075 / 0.9075 | 0.9075 | 0.0325 | |
| 17 | 0.9400 / 0.9400 / 0.9400 | 0.9065 / 0.9065 / 0.9070 | 0.9067 | 0.0333 | |
| 21 | 0.9475 / 0.9400 / 0.9450 | 0.8985 / 0.9055 / 0.9070 | 0.9037 | 0.0405 | |
| 81 | 0.9625 / 0.9650 / 0.9650 | 0.9020 / 0.8965 / 0.9075 | 0.9020 | 0.0622 | |
| 201 | 0.9650 / 0.9750 / 0.9650 | 0.8890 / 0.8890 / 0.9000 | 0.8927 | 0.0757 | |
| Bayes 最优(§8.2) | — | 0.9375 | 0.9375 | 0.9375 | 0.0000 |
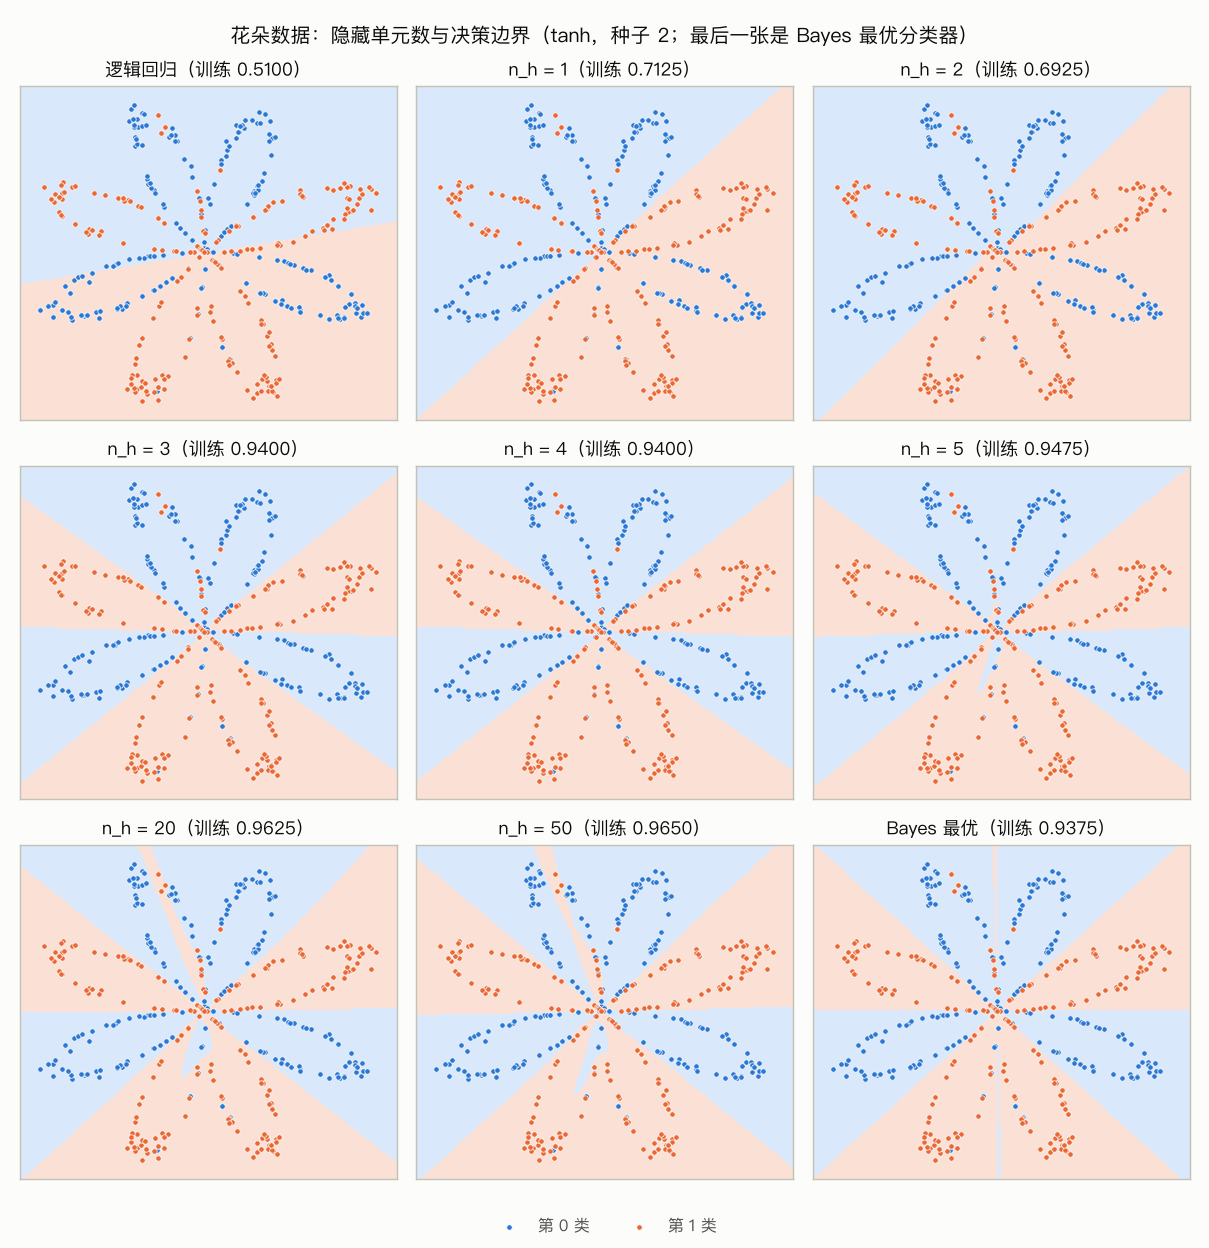
(这张图由 05_hidden_layer_size.py 生成,对应种子 2;终端里打印的是同样内容的字符画。)
从表和图里能读出四件事:
- 不够:1 条或 2 条”软直线”最多把平面切成 2 块或 4 块,而花朵绕一圈要变 6 次颜色。它们的训练准确率 0.71、0.69,比逻辑回归好,但远远不够。
- 是一个台阶:训练准确率跳到 0.9400。3 条过原点的直线正好切出 6 个扇形(§2.4)。图里 和 的边界几乎一模一样, 多出的那个单元没被用上。(原作业里也是从 3 个单元开始跳到 90% 左右。)
- 之后测试准确率不再上升: 到 50 的测试平均都在 0.8927–0.9075 之间,差别和种子之间的波动差不多大。最好的反而是最小的 。
- 训练准确率却在继续上升:、50 到了 0.96–0.975,“训练 − 测试”的差距从 0.0325 扩大到 0.0757。图里 、50 的边界在花心附近和上方多出了几个细小的”尖刺”,是为了包住个别训练点画出来的。
注意第 1 点里 比 还略差(训练 0.6925 vs 0.7125):两个单元的网络停在了一个局部解上,并没有用好多出来的那条直线。小网络对初始化和优化都更敏感,第 1 讲 §2.2 的 [5, 2, 1] 也是这样。
8.2 一把尺子:Bayes 最优分类器
测试准确率停在 0.90 左右,是不是已经到顶了?真实任务里我们无法回答这个问题,但花朵数据是我们自己生成的,知道真相。
已知生成过程时,可以算出每个点属于每一类的真实概率 。“哪一类概率大就猜哪一类”的分类器叫 Bayes 最优分类器,它的期望准确率是任何模型都不可能超过的上限(第 10 讲会把”上限对应的错误”叫做 Bayes error,真实任务里常用人类水平来近似它)。planar_data.py 的 class_likelihoods 推导了花朵的真实后验:给定一个点 ,能生成它的只有 、 这几组角度和半径( 是 的极角),把它们的概率加起来即可。我用另一种方法(在几百万个样本上按极坐标分格、数每一格里哪一类多)独立核对过这个公式,两者给出的上限一致。
在 20000 个新样本上,花朵的 Bayes 上限约 0.944;在我们那 2000 个测试样本上是 0.9375。对照 §8.1 的表:
- 的网络在训练集上已经和 Bayes 一样准(0.9400 vs 0.9375),到了测试集上却差了 0.0300(0.9075 vs 0.9375)。网络的边界是照着这 400 个点画的,换一批点就没那么准了。这段差距加隐藏单元补不上(、50 的测试反而更低),要靠更多数据或者正则化。第 6 讲把这种”训练好、测试差”叫做 variance(方差)。
- 、50 在训练集上比 Bayes 还准(高出 0.0267、0.0308)。比”上帝视角”还准,只能说明它们在拟合这 400 个点里的噪声。
图的最后一张是 Bayes 最优分类器的边界:6 个干净的扇形,没有任何尖刺。(它下方有一条竖直的细缝,那里没有任何数据,怎么分都无所谓。)
8.3 换两个数据集
“3 个单元就够”是花朵数据的特点,还是普遍规律?代码 05 演示 2 在同心圆(Coursera 作业的附加数据集 noisy_circles,用 numpy 仿照 make_circles(factor=0.5, noise=0.3) 重写)和两个月牙(仿照 make_moons(noise=0.2))上重复了一遍(3 个种子的平均):
| 逻辑回归 | Bayes 最优 | |||||||
|---|---|---|---|---|---|---|---|---|
| 同心圆(测试) | 0.4830 | 0.5845 | 0.6770 | 0.7695 | 0.7788 | 0.7830 | 0.7753 | 0.7920 |
| 同心圆(训练) | 0.5150 | 0.6025 | 0.7050 | 0.7825 | 0.7817 | 0.7817 | 0.7858 | 0.7775 |
| 月牙(测试) | 0.8675 | 0.8682 | 0.8673 | 0.9635 | 0.9627 | 0.9628 | 0.9643 | 0.9735 |
| 月牙(训练) | 0.8775 | 0.8775 | 0.8750 | 0.9725 | 0.9733 | 0.9733 | 0.9733 | 0.9675 |
- 同心圆:一条直线对一个圈无能为力(0.4830)。 从 1 到 3,测试准确率逐步上升到 0.7695(3 条直线可以围出一个三角形,粗略地”圈住”内圈),之后基本持平。这个数据集噪声很大(两圈的间距 0.5,噪声标准差 0.3),Bayes 上限在测试集上只有 0.7920,大量的点本来就落在对方的地盘里。 的网络离上限只差一两个百分点。
- 两个月牙:逻辑回归已经有 0.8675,因为月牙的主体在两侧,一条斜线能分对大部分。 几乎没有提高, 跳到 0.9635,接近上限 0.9735。要把两个月牙的尖端也分对,边界得弯成 S 形。
三个数据集都有一个”够用”的大小(这里碰巧都是 3 左右),之后测试准确率不再明显提高。够用的大小取决于决策边界的形状有多复杂,而这个事先通常不知道。
8.4 过拟合的苗头
400 个训练样本时,大网络只是”略微”过拟合。数据更少时呢?代码 05 演示 3 从 400 个训练样本里固定地挑出 80 个(这 80 个点上 Bayes 最优分类器的准确率是 0.9500):
| 参数 | 训练准确率(80 个,3 个种子) | 测试准确率(2000 个) | 测试准确率的最高点 @ 第几步 | |
|---|---|---|---|---|
| 3 | 13 | 0.9625 / 0.9625 / 0.9625 | 0.8610 / 0.8610 / 0.8610 | 0.8920@300 / 0.8915@300 / 0.8920@300 |
| 5 | 21 | 0.9500 / 0.9875 / 0.9875 | 0.8375 / 0.8300 / 0.8300 | 0.8840@300 / 0.8810@500 / 0.8795@300 |
| 20 | 81 | 1.0000 / 1.0000 / 1.0000 | 0.8120 / 0.7950 / 0.8165 | 0.8765@300 / 0.8735@300 / 0.8690@400 |
| 50 | 201 | 1.0000 / 1.0000 / 1.0000 | 0.8275 / 0.8225 / 0.8130 | 0.8725@300 / 0.8730@300 / 0.8715@300 |
n_h = 3:训练 0.9625,测试 0.8610            n_h = 50:训练 1.0000,测试 0.8275
+----------------------------------------+   +----------------------------------------+
|                                       .|   |                                       .|
|            oo                       ...|   |            oo                      ....|
|.          o o  o                  .....|   |.          o o  o        ..       ...   |
|....        o         o    o    ........|   |....        o         o... o            |
|......                        ..........|   |......                ...      .........|
|.........    o    o oX   o  ............|   |.........    o    o ox.. o  ............|
|...x.......         o   o....x....x..x..|   |...x........        o.. o ...x....x..x..|
|............x.      o  ...x.......xx....|   |............x.      O. ...x.......xx....|
|.......xx.......   X ...........x.......|   |.......xx.......   x............x.......|
|................x.x*O......X X          |   |................x.x*o .....x.x..........|
|...      oo       .xx  o    o o         |   |         oo     ...xx  o    o o  .......|
|                .x.....                 |   |                .x  ....                |
|     o        O....O......              |   |     o        o.   o ....               |
|   o o  o  ................O      oo    |   |   o o  o     .     .......o      oo    |
|         ......................         |   |            ...    ...........          |
|       ..............x....x......       |   |      ...............x....x......       |
|    .............x....x.............    |   |   ..............x....x.............    |
|  ..........x..x.........xxx..........  |   |............x..x.........xxx..........  |
|............xxx............x............|   |............xxx............x............|
|........................................|   |........................................|
+----------------------------------------+ +----------------------------------------+- 、50 把训练集背了下来:训练准确率 1.0000,比 Bayes 在这 80 个点上的 0.9500 还高,连落在”对方花瓣”里的噪声点都分对了。但测试准确率平均只有 0.8078、0.8210,比 (0.8610)还低。右边的字符画里, 为了包住个别训练点画出了一些”飞地”和弯折(比如右上角和中间偏上的几块
'.'),这些地方在测试集上大多是错的。这就是过拟合:模型的灵活性被用来记住训练集的偶然细节,而不是学到真正的规律。 - 测试准确率在训练早期就到了最高点(第 300–500 步),之后一路下降到最终值。“在验证集上表现最好的时候停下来”叫 early stopping(第 6 讲)。
- 数据越少,大网络越容易过拟合:同样的 ,400 个训练样本时训练 − 测试的差距是 0.0757,80 个时变成 0.1790。
反过来,数据多了会怎样?演示 3 的最后一张表(种子 2,同一个测试集):
| 训练样本数 | 训练 / 测试 | 训练 / 测试 | Bayes 在训练集上 |
|---|---|---|---|
| 80 | 0.9625 / 0.8610 | 1.0000 / 0.8275 | 0.9500 |
| 400 | 0.9400 / 0.9075 | 0.9650 / 0.8890 | 0.9375 |
| 2000(另外生成) | 0.9330 / 0.9225 | 0.9370 / 0.9225 | 0.9465 |
训练样本加到 2000 个时, 的训练准确率降到了 Bayes 之下(不再拟合噪声),训练 − 测试的差距缩小到 0.0145,测试准确率升到 0.9225,和 一样好,大网络不再吃亏。两个网络的测试准确率也都比 400 个样本时高了,向 Bayes 上限又靠近了一步。
8.5 小结: 是一个超参数
太小(这里是 1、2),训练准确率就上不去(high bias);“够用”之后测试准确率不再上升,再大就开始拟合噪声,数据越少越明显(high variance)。隐藏单元数、激活函数、学习率、迭代次数、初始化尺度这些由你决定、不由梯度下降学出来的量叫超参数(hyperparameters),以区别于 、 这些参数(第 4 讲)。选超参数要靠验证集,不能看测试集(第 6 讲)。实践中更常见的做法不是精确地找”刚好够用”的大小,而是网络稍微大一点,再用正则化控制过拟合:第 1 讲 §2.2 的 [5, 2, 1] 和本讲的 都提醒过,太小的网络还容易卡在差的解上。
9. 拼起来:一个完整的训练流程 · Putting it together
Coursera 作业把一个隐藏层的网络拆成几个小函数,shallow_nn.py 照搬了这个结构。把它们串起来,就是第 1 讲 §2.1 的”训练四步”:
nn_model(X, Y, n_h):
    n_x, n_h, n_y = layer_sizes(X, Y, n_h)                       # 网络结构
    params = initialize_parameters(n_x, n_h, n_y, rng)           # §7:W 随机且小,b = 0
    重复 num_iterations 次:
        A2, cache = forward_propagation(X, params)               # §3:前向
        cost = compute_cost(A2, Y)                               # 交叉熵(第 2 讲)
        grads = backward_propagation(params, cache, X, Y)        # §6:6 个公式
        params = update_parameters(params, grads, learning_rate) # 梯度下降一步
    return params

predict(params, X) = (A2 > 0.5)两个实现细节值得记住:compute_cost 先把 裁剪到 再取 log(大初始化时 sigmoid 会饱和到恰好 0 或 1);nn_model 每一步都检查 cost 是否是有限的数,因为矩阵乘法里产生的 inf / nan 不会触发 numpy 的警告(第 1 讲踩过的坑)。函数和讲义各节的对应关系见代码 README。
10. 小结 · Summary
- 两层网络 = 并排的几个逻辑回归(隐藏层)+ 一个以它们的输出为输入的逻辑回归(输出层)。记号: 是层, 是样本,下标 是层内的单元;输入层不算一层。
- 前向传播:,,,。样本按列堆叠后公式不变,因为 的第 列就是 (代码 01:三种写法差 4.4e−16)。
- 隐藏单元在花朵上学成了”过原点的直线开关”:4 个单元里 3 个在干活,切出 6 个扇形;输出层给它们投票。逻辑回归 0.510 / 0.501 → 4 个 tanh 单元 0.940 / 0.906。
- 激活函数:,,ReLU。tanh 在隐藏层通常优于 sigmoid(导数大、零中心;两者能表示的函数完全相同,差别只在训练速度)。ReLU 是深层网络的默认选择;但在本讲的小问题上,tanh 在花朵、月牙上更好(代码 03),所以拿不准时要在验证集上比较。输出层由 决定:二分类用 sigmoid,回归用线性。
- 必须有非线性:线性激活的两层网络就是逻辑回归。准确率、cost 都相同,压扁后的 和逻辑回归的 在 3 位小数上一致。
- 反向传播 6 个公式:;;;;;。新东西只有第 4 个:误差按输出权重分回隐藏单元,再经 这个”阀门”。维度规则: 和 同形状, 和 同形状。
- 梯度检验:双边差分,正确实现的相对误差在 1e−9 量级;按参数分开算能定位 bug;在 时有的 bug 会躲过去,训练一段时间后要再查一次。
- 初始化:全 0 → 对称性(全 0 + tanh 时梯度恰好为 0,一步不动;常数初始化时 4 个单元永远相同);随机数打破对称, 可以是 0。尺度太大 → 饱和,scale = 100 时 98% 饱和、10 次只有 1 次成功。对一个隐藏层,0.01 很好;深层网络需要 Xavier / He(第 7 讲)。
- 隐藏层大小:花朵上 是台阶,之后测试准确率停在 0.89–0.91,比 Bayes 上限(0.9375)低 0.03,这段差距是方差,加单元补不上。大网络在训练集上超过 Bayes,说明在拟合噪声;80 个训练样本时过拟合很明显(训练 1.0000、测试 0.82),2000 个时大网络不再吃亏。
11. 常见误区 · Common pitfalls
- “一个隐藏层的网络是一层网络。” 按 Ng 的数法,输入层是第 0 层、不算数,有一个隐藏层的网络是两层网络()。读论文和代码时注意别人用的是哪种数法。
- “矩阵写法是对循环写法的近似。” 两者是同一个计算(§3.3),差别只在浮点舍入(4.4e−16)。如果两者结果差得多,说明你的某个形状错了。
- “sigmoid 和 tanh 差不多,用哪个都行。” 它们能表示的函数确实相同,但在隐藏层里 tanh 学得快得多(代码 03:花朵上同学习率下 100 vs 400 步,同心圆上 1000 vs 4500 步)。sigmoid 只留给二分类的输出层。
- “ReLU 在任何问题上都最好。” 它是深层网络的默认选择,理由是梯度不衰减、计算便宜。在一个隐藏层、低维输入的小问题上不一定(代码 03:花朵上 ReLU 0.820 / 0.835,tanh 0.902 / 0.895)。不确定时在验证集上比较。
- “多加几个线性层,网络就更强。” 线性层叠多少都等于一层(§5)。没有非线性激活,[2, 50, 1] 和逻辑回归一模一样。
- “
dZ1 = W2.T @ dZ2 @ g'(Z1)。” 公式 (4) 里是逐元素乘法*,不是矩阵乘法。求db时忘了keepdims=True更危险:不报错, 悄悄变成矩阵(§6.4)。 - “梯度检验通过了,反向传播就一定对。” 在 的初始参数上,漏乘 这样的 bug 可能只给出 1e−6 到 1e−3 的相对误差(§6.6)。训练一段时间后要再查一次。
- “把权重初始化成 0 只是训练慢一点。” 不是慢,是根本学不出不同的隐藏单元:全 0 + tanh 时梯度恰好为 0,一步不动;常数初始化时 个单元永远是同一个单元(§7.2)。注意逻辑回归可以零初始化,因为它只有一个单元。
- “初始权重越大,网络’起步’越有力。” 正相反:大权重让 tanh / sigmoid 饱和,梯度几乎为 0,初始 cost 也很高(scale = 100 时 12.56),训练变得不可靠(§7.4)。
- “隐藏单元越多越好。” 花朵上 之后测试准确率不再上升, 反而最差(0.8927);训练集越小,大网络过拟合越严重(§8)。不过答案也取决于数据量:2000 个训练样本时 和 一样好。
12. 练习 · Exercises
练习 1(形状与参数个数)。一个两层网络:,,输出 1 个单元, 个样本。写出 的形状,以及参数总数。
参考答案
:(5, 3);:(5, 1);:(5, 100);:(1, 5);:(1, 1);:(1, 100);:(5, 100)(和 相同);:(5, 3)(和 相同);:(1, 1)。
参数总数 。注意 不影响参数个数:参数是”每个样本共用的”, 只出现在 、、 的列数里。
练习 2(手算一遍前向和反向)。tanh 隐藏层,一个样本:,,,,,。
(a) 算出 和损失 。(b) 算出 。(c) 两个隐藏单元里,哪个的 那一行梯度大?为什么?单元 1 的输出权重 的梯度为什么是 0?
提示:,。可以用 shallow_nn.forward_propagation 和 backward_propagation 验证。
参考答案
(a) ;;;;,所以 。
(b) (预测偏高, 应该变小)。。;;。。
(c) 单元 1(第一行)的梯度大得多。两个单元从输出层分到的误差一样(),但单元 2 的 已经饱和,,阀门几乎关死,它的梯度只有单元 1 的约 1/38。单元 1 的 ,斜率最大(1)。而 的梯度是 :单元 1 现在输出 0,改变它的输出权重对预测没有任何影响。
练习 3(sigmoid 网络 = tanh 网络)。(a) 证明 。(b) 一个 sigmoid 隐藏层的网络参数是 。证明 tanh 隐藏层、参数为 的网络对任何输入都给出相同的输出。(c) 既然两者能表示的函数相同,为什么代码 03 里 tanh 学得更快?
参考答案
(a) ,分子分母同乘 得 。于是 。
(b) sigmoid 网络的隐藏层输出 。代入输出层:,正是 tanh 网络在新参数下的 。代码 03 演示 3 末尾验证了,输出的最大差别是 2.2e−16。
(c) 梯度下降不是在”函数空间”里走,而是在参数空间里走。同一个函数在两种参数化下,梯度的大小和方向不同:sigmoid 的导数最大 0.25,输出不以 0 为中心(§4.3)。直观地说,sigmoid 网络相当于”同一个 tanh 网络,但隐藏层的参数被缩放了一半、输出又多了一个偏移”,同样的学习率在它身上走得更慢、更曲折。可以自己验证:把 03_activation_functions.py 里 sigmoid 的学习率调大(比如 2.5 倍),看达到门槛的步数是否接近 tanh。具体数字以你运行的结果为准。
练习 4(输出层用什么)。下面每个任务,输出层用什么激活函数?隐藏层呢?(a) 根据病人的化验指标判断是否患病;(b) 预测明天的气温(摄氏度,可能是负数);(c) 预测一套房子的价格;(d) 预测一张图片里有几个人。
参考答案
隐藏层:四个任务都可以默认用 ReLU(网络小、输入维度低时 tanh 也值得一试,§4.6)。输出层由 决定: (a) 二分类 → sigmoid,损失用交叉熵。 (b) 实数,可正可负 → 线性,损失用均方误差(第 1 讲)。如果用 sigmoid 或 ReLU,就表示不了负的温度。 (c) 非负实数 → 线性或 ReLU(Ng 在视频里举的就是这个例子)。用 ReLU 能保证不预测出负价格,但要小心:如果输出单元的 一直是负的,它会”死掉”、梯度为 0。 (d) 非负整数(计数)→ 常见做法是线性 / ReLU 输出加均方误差,或者把它当成多分类(0 人、1 人、……,softmax,第 9 讲),或者用泊松回归那样的输出(指数函数)。这个问题没有唯一答案,“输出层和损失函数怎样设计”是第 5 讲的主题。
练习 5(对称性,变形版)。把 随机初始化(0.01 × 随机数),但 初始化成 0。还有对称性问题吗?第 0 步的 是多少?先推理,再改代码验证(在 nn_model 之外自己写一个训练循环,或者在 initialize_parameters 之后把 params["W2"] 设成 0)。
参考答案
没有对称性问题。第 0 步时 ,所以 ,:隐藏层这一步不动。但 不是 0,而且因为 的各行不同、 的各行不同, 的 4 个分量也各不相同。更新一步后 的分量就各不相同了,从第 1 步起 也不再是 0,而且各行不同。
我验证的结果(花朵数据、种子 2、学习率 1.2):第 0 步 、;第 1 步后 ,;10000 步后训练 / 测试准确率 0.940 / 0.907,和正常初始化一样。打破对称只需要某一层是随机的,而且要能让各单元收到不同的梯度。 随机就够了。
练习 6(不平衡数据上的零初始化)。代码 04 里全 0 + sigmoid 一步不动,原因是两类正好各一半。现在只保留花朵训练集里第 0 类的全部 200 个和第 1 类的前 100 个(keep = np.concatenate([np.arange(200), np.arange(200, 300)])),用全 0 + sigmoid、4 个隐藏单元训练 10000 步。先预测:(a) 参数会动吗?(b) 训练后 的 4 行一样吗?(c) 准确率大概和什么网络差不多?然后运行验证。
参考答案
(a) 会。第 0 步 ,,,所以 和 不为 0( 的 4 个分量相同)。下一步 , 也就不为 0 了。
(b) 一样。§7.1 的归纳法条件( 各行相同、 各分量相同、 各分量相同)在第 0 步成立,所以永远成立。我运行的结果:10000 步后 的 4 行都是 ,。
(c) 和只有 1 个隐藏单元的网络差不多:训练准确率 0.7367;同样的数据上 1 个 sigmoid 隐藏单元(随机初始化)是 0.7467。这批数据里第 0 类占 2/3,所以”全部猜第 0 类”就有 0.667,网络只比它好一点。
练习 7(梯度检验的陷阱)。代码 02 的 bug B 把 tanh 的导数写成了 。(a) 分别在 、、、 处比较 和正确的 。(b) 用 (a) 解释为什么 bug B 在 时几乎查不出来、训练后却错得很离谱。(c) 你会怎样设计梯度检验,避免这类问题?
参考答案
(a) :0.9984 vs 0.9984(前 4 位相同);:0.75 vs 0.7864;:0 vs 0.4200;:−3 vs 0.0707(符号都反了)。
(b) 时花朵数据的 只有百分之几, 和 几乎相等,所以相对误差只有 4.5e−06。训练后 常常大于 1,两者天差地别,甚至符号相反,相对误差变成 1.0。
(c) Ng 的建议:在随机初始化后检查一次,训练一段时间后再检查一次。也可以直接用较大的随机参数(比如 shallow_nn.py 的自检用 scale = 1.0)或者若干组不同的参数检查,让 覆盖激活函数的各个区域(包括饱和区)。
练习 8(直线能把平面切成几块)。 个 tanh 单元饱和以后,近似于 条直线的”开关”。(a) 条过同一点的直线最多把平面分成几块?(b) 条一般位置的直线(没有两条平行、没有三条交于一点)呢?(c) 用 (a) 解释为什么花朵数据上 不够、 够了。(d) 区域数够了,是不是就一定能分对?
参考答案
(a) 块( 条过原点的直线把一圈切成 个扇形)。 (b) 块。用归纳法:第 条直线和前 条各交于一点,被分成 段,每段把一个区域一分为二,所以多出 块。。 时是 7 块。 (c) 花朵绕一圈颜色变 6 次,需要 6 个扇形。2 条过原点的直线只有 4 个扇形,3 条正好 6 个。所以 的训练准确率卡在 0.69, 跳到 0.94。 (d) 不一定。输出层只能做”加权投票再过 sigmoid”,即各开关读数的线性组合,不是任意的”区域 → 类别”查表。比如用 3 条过原点的直线时,6 个扇形的类别必须能由 表示(),花朵恰好满足(§2.4 的网络就找到了这样的 )。一般情况下,区域数只是必要条件。第 4 讲会看到,有些函数(比如 parity)用一个隐藏层需要非常多的单元,加深网络才能高效表示。
练习 9(改代码,先预测再运行)。把 05_hidden_layer_size.py 演示 3 里的 [:80] 改成 [:200](训练样本从 80 个变成 200 个)。先预测: 和 的训练准确率、测试准确率大概在什么范围?和 80 个、400 个时比,“训练 − 测试”的差距怎样变化?然后运行验证。
参考答案
预测:两种网络的测试准确率都应该介于 80 个和 400 个训练样本之间; 的训练准确率仍然很高(接近 1),但不一定全对;差距介于 0.18 和 0.08 之间。
我运行的结果(3 个种子): 训练 0.945、测试 0.9015(3 个种子相同); 训练 0.995 / 0.985 / 0.990,测试 0.865 / 0.877 / 0.872,差距约 0.12。趋势和预测一致:数据越多,大网络的过拟合越轻,但 200 个样本时 仍明显不如 。(演示 3 里其他行的数字也会变,因为它们都用这 200 个样本。)
13. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C1M3 “Shallow Neural Networks”(Andrew Ng)及编程作业 “Planar Data Classification with One Hidden Layer”:本讲的主要依据。
- Stanford CS231n 课程笔记 “Neural Networks Part 1: Setting up the Architecture”(激活函数的比较)和 “Optimization 2: Backpropagation, Intuitions”(反向传播的直觉)。
- Michael Nielsen, Neural Networks and Deep Learning(免费在线书),第 2 章 “How the backpropagation algorithm works”。
教材
- Goodfellow, Bengio & Courville (2016). Deep Learning,第 6 章 “Deep Feedforward Networks”(6.3 隐藏单元,6.5 反向传播)。
激活函数与初始化的原始论文
- LeCun, Bottou, Orr & Müller (1998). Efficient BackProp. ——为什么输入和激活要以 0 为中心、为什么对称的 tanh 型函数优于 logistic sigmoid(§4.3)。
- Glorot & Bengio (2010). Understanding the difficulty of training deep feedforward neural networks. AISTATS. ——sigmoid 在深层网络里的饱和问题;Xavier 初始化(第 7 讲)。
- Nair & Hinton (2010). Rectified linear units improve restricted Boltzmann machines. ICML.
- Glorot, Bordes & Bengio (2011). Deep sparse rectifier neural networks. AISTATS.
- Krizhevsky, Sutskever & Hinton (2012). ImageNet classification with deep convolutional neural networks. NeurIPS. ——ReLU 比 tanh 快约 6 倍的那张图。
- Maas, Hannun & Ng (2013). Rectifier nonlinearities improve neural network acoustic models. ICML Workshop on Deep Learning for Audio, Speech and Language Processing. ——Leaky ReLU。
- He, Zhang, Ren & Sun (2015). Delving deep into rectifiers: Surpassing human-level performance on ImageNet classification. ICCV. ——He 初始化与 PReLU(第 7 讲)。
- Hendrycks & Gimpel (2016). Gaussian Error Linear Units (GELUs). ——BERT、GPT 系列使用的激活函数。
反向传播
- Rumelhart, Hinton & Williams (1986). Learning representations by back-propagating errors. Nature.
14. 下一讲预告 · Next lecture
第 4 讲:深层神经网络——L 层网络的前向与反向传播。 本讲把一个隐藏层的网络完全拆开了。下一讲把它推广到任意层数:
- 本讲的 6 个公式里,(4)–(6) 会变成一个可以重复 次的”模块”:
linear_forward/activation_forward/linear_backward/activation_backward,再加一个 cache; - §2.3 的形状规则 会变成一条自动检查维度的工具;
- 为什么要”深”:练习 8 留下的问题会变成一个实验,在同样的参数量下比较深而窄、浅而宽的网络(parity 函数);
- §8.5 提到的”参数 vs 超参数”会正式定义。
到第 4 讲结束时,第 1 讲 tiny_nn.py 里 forward 和 backward 那两个循环,你就能一行一行地写出来了。