对应 Maps to:Coursera Deep Learning Specialization C1M2 “Neural Networks Basics” 的全部视频——Logistic Regression as a Neural Network 部分(Binary Classification、Logistic Regression、Logistic Regression Cost Function、Gradient Descent、Derivatives、More Derivative Examples、Computation Graph、Derivatives with a Computation Graph、Logistic Regression Gradient Descent、Gradient Descent on m Examples)与 Python and Vectorization 部分(Vectorization、More Vectorization Examples、Vectorizing Logistic Regression、Vectorizing Logistic Regression’s Gradient Output、Broadcasting in Python、A Note on Python/Numpy Vectors、Explanation of Logistic Regression Cost Function (Optional));编程作业 “Python Basics with Numpy”(选做)与 “Logistic Regression with a Neural Network Mindset”;Fall 2025 TA Section 2 “Understanding Gradient Descent and Backpropagation”。 依据说明:Coursera 的视频、测验和编程作业要注册才能看,Fall 2025 的 section 材料只对选课学生开放,所以本讲不引用其中的原文。内容依据 Andrew Ng 在 C1M2 里广为人知的讲法:记号、 的计算图例子、“食物热量”的广播例子、“猫 / 非猫”作业的流程。逻辑回归的概率解释和凸性依据标准教材(见 §13)。Section 2 的具体讲法无法核对,§4–§6 按它的标题(梯度下降与反向传播的直觉)来组织。作业里的”猫 / 非猫”数据集换成了我们自己合成的”橙色十字”图像(§1.3),因为我们知道它的真相,可以检查模型到底学到了什么。 配套代码 Code:
code/lecture02/(numpy 从零实现;4 个脚本 + 3 个工具模块;每个脚本几秒内跑完) 预计阅读时间:2.5–3 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 把一个二分类问题写成逻辑回归:。说清楚为什么输出要过 sigmoid,以及 为什么可以读成”是正类的概率”。
- 说出为什么损失函数用交叉熵(cross-entropy)而不用平方误差,有三个理由:交叉熵来自最大似然;它是凸的;“自信地错”时平方误差的梯度会消失,交叉熵不会。还要能区分 loss 和 cost。
- 用”下山”的图像解释梯度下降,知道学习率太小、刚好、太大时分别会发生什么,以及临界学习率和曲率的关系。
- 用”推一点,动多少”理解导数;能在计算图上用链式法则倒着走一遍,手算 和逻辑回归的全部梯度,并用双边差分验证。
- 推导并记住逻辑回归的反向传播:单样本 、、;向量化后 、、。
- 把 for 循环改写成向量化的矩阵运算,并用广播(broadcasting)的规则预测任意两个形状运算后的结果。
- 理解”神经网络思维”:逻辑回归就是
layer_dims = [n_x, 1]的神经网络。第 1 讲的黑盒tiny_nn.py的输出层,你现在能逐行写出来。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开 Previewed only |
|---|---|
| 第 1 讲:训练的四步(前向 → 损失 → 反向 → 更新)、 约定、rank-1 数组与广播陷阱的现象 | 隐藏层、激活函数的比较、两层网络的反向传播、随机初始化(第 3 讲) |
| 高中数学:函数、导数是”斜率”、 和 | 层网络的模块化实现(第 4 讲) |
| 一点概率:概率、独立事件的概率相乘 | 过拟合与正则化(第 6 讲) |
Python 基础;numpy 的 @、.T、reshape(第 1 讲代码里见过) | 输入归一化、系统的梯度检验(第 7 讲) |
| mini-batch、Adam 等优化算法(第 8 讲) |
本讲是第一个把数学推到底的一讲。第 1 讲 §2.1 说训练有四步,第 3 步”反向传播”当时一笔带过。这一讲在最小的神经网络(只有一个 sigmoid 输出单元)上把四步全部推导出来,再写成没有 for 循环的 numpy 代码。第 3、4 讲只是把同样的推导用到更多的层上。
0.3 本讲地图 Map
§1  二分类:猫 / 非猫的设定;我们的合成数据"橙色十字"            ← 代码 04 演示 1
§2  模型:为什么输出要过 sigmoid                                  ← 代码 01 演示 1
§3  损失:为什么是交叉熵(最大似然;凸;"自信地错"时的梯度)      ← 代码 01 演示 2–4
§4  梯度下降:下山、学习率、临界学习率                            ← 代码 04 演示 2
§5  导数与计算图:推一点动多少;J = 3(a + bc);链式法则           ← 代码 02 演示 1–2
§6  逻辑回归的反向传播:单样本 → m 个样本                         ← 代码 02 演示 3–4
§7  向量化:从两重 for 循环到 dZ = A − Y                          ← 代码 03 演示 1–2
§8  广播的规则与陷阱                                              ← 代码 03 演示 3–4
§9  神经网络思维:完整训练、学到的模板、线性模板的极限、
    逻辑回归 = layer_dims = [n_x, 1]                              ← 代码 04 演示 3–5
§10–14  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 | 形状 |
|---|---|---|
| 逻辑回归的权重,列向量 | ||
| 偏置,一个实数 | 标量(代码里是 Python float) | |
| 线性部分(“打分”) | 标量(一个样本) | |
| 预测”是正类”的概率 | 标量 | |
| sigmoid 函数 | 逐元素 | |
| 单个样本的损失(loss) | 标量 | |
| 所有样本的平均损失(cost) | 标量 | |
| , | 所有样本一起算 | |
dvar | 代码里的变量名约定:最终输出对 var 的导数,例如 dz 、dw | 和 var 形状相同 |
| 学习率 |
和第 1 讲 / tiny_nn.py 的对应:Coursera 讲逻辑回归时把 写成列向量、。讲神经网络时(第 3 讲起),每一层的权重写成矩阵 ,形状是(这一层的单元数, 上一层的单元数)。逻辑回归只有一层、一个单元,所以 的形状是 ,正好等于 。tiny_nn.py 里的 W1 就是 (§9.4 用代码验证)。
另外,Ng 在课上特意说明:有些教材把 并进 ,写成 ,再给 加一个恒为 1 的分量 。本课程始终把 和 分开写,因为到了神经网络里分开更方便。
0.5 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出。随机种子是固定的,同一台机器上重复运行逐字相同,只有代码 03 演示 1 的计时每次都不一样。图像数据是合成的,“真相”由 image_data.py 里的规则决定。数字只说明机制,不代表任何真实任务。有几处结果和我写代码前的预想不一样,讲义按实际结果来写,这些情况都列在代码 README 的”关于实验结果”里。最重要的一处在 §4.3:学习率太大时并没有发散。
1. 二分类:从一张图片到一个 0/1 · Binary classification
1.1 猫 / 非猫
C1M2 的第一个视频用一个具体问题开场:给一张图片,判断里面是不是猫。输出 ,1 表示”是猫”。这叫二分类(binary classification)。
按第 1 讲 §3.4 的做法,一张 64×64 的彩色图片是 个 0–255 的整数。拉平成一个列向量 ,就有 个特征。 张训练图按列堆成 ,标签堆成 。编程作业 “Logistic Regression with a Neural Network Mindset” 用的就是这样一个数据集:209 张训练图、50 张测试图。
1.2 为什么从逻辑回归开始
逻辑回归是一个很老的统计模型,为什么一门深度学习课要花一整讲在它上面?
因为它就是最小的神经网络:只有一个神经元,没有隐藏层,激活函数是 sigmoid。神经网络的骨架在它身上都能看到:前向传播、损失函数、反向传播、梯度下降、向量化、参数初始化。而且它足够小,每一个梯度都能在纸上推出来。作业的标题 with a Neural Network Mindset(用神经网络的思维)说的就是这个意思:不要把它当成统计课里的回归模型,而是当成一个小网络来实现,代码结构要和以后的深度网络一模一样(initialize → propagate → optimize → predict → model)。第 3、4 讲只是往这个结构里加层。
1.3 本讲的数据:“橙色十字” vs 其他
我们没有那个猫数据集,而且就算有,逻辑回归在上面学到的东西也很难看懂:真实的猫姿态、颜色、位置千变万化。所以我造了一个格式相同、但真相已知的数据集(image_data.py):
- 每张图 16×16 像素、RGB 三通道、像素值 0–255,所以 ;
- 正类():图里有一个橙色的十字(7×7 的外框,笔画 3 像素宽,33 个像素);
- 负类():三种干扰项各占约三分之一。橙色方块和十字颜色相同、形状不同,模型必须看形状。其他颜色的十字(黄、绿、蓝、紫)形状相同、颜色不同,模型必须看颜色。第三种只有背景;
- 背景是随机底色、随机明暗渐变和像素噪声的叠加;图案的位置上下左右各有 ±1 像素的随机抖动。
代码 04 演示 1 打印了数据的概况:训练集 1000 张(正类 493 张)、测试集 500 张(正类 246 张)。正类比例约 0.49,所以”全猜 0”的准确率约 0.51,这是任何模型都要超过的最低基线。终端里看不到彩色像素,代码就按”离哪种图案颜色最近”把每个像素画成一个字母(O 橙、Y 黄、G 绿、B 蓝、P 紫,. 表示都不近)。下面是一张正类图和一张橙色方块图:
    #0 橙色十字(正类)                 #15 橙色方块
    . . . . . . . . . . . O . O . .     . . . . . . . . . . . . . . . .
    . . . O . . . . . . . . . . . .     . . . . . . . . . . . . . . . .
    . . . . . . . . . . O . . . . .     . . . . . . . . . . . . . . . .
    . . . . . O . . . . . . . . . .     . . . . . . . . . . . . . . . .
    . . . . . . . . O . . . . . . .     . . . . . . . . . . . . . . . .
    . . . . . . O O O . . . . . . .     . . . O O O O O O O . . . . . .
    . . . . . . O O O . . . . . . O     . . . . O O O O O O . . . . . .
    . . . . O O O O O O O . . . . .     . . . O O . O O O O . . . . . .
    . . . . O O O O O O O . . . . .     . . . O O . O O O O . . . . . .
    . . . . O O O O O O O . . . . .     . . . O O O O O O O . . . . . .
    . . . . . . O O O O . . . . . .     . . . O O O O O O O . . . . . .
    . . . . . . O O O . . . . . . .     . . . O O O O O O O . . . . . .
(下面四行全是背景,这里省略了。)十字图背景里零星的 O 是噪声碰巧接近了橙色;方块里的两个 . 是噪声让像素偏离了橙色。这正是模型要面对的干扰。
为什么这样设计? 逻辑回归的打分 是”每个像素的每个通道乘一个权重再相加”,所以学到的 可以还原成一张 16×16×3 的模板图(§9.2)。要分开十字和其他颜色的十字,模板要在十字的位置上偏爱橙色;要分开十字和方块,模板必须用到空间结构,因为方块的橙色像素(49 个)比十字(33 个)还多,“橙色越多越像正类”这种规则行不通。图案大小、颜色、噪声强度和 ±1 的抖动,是我先在草稿里试了几组值之后选的:模板要清楚可见,准确率既不能是 100%,也不能接近瞎猜。§9.3 会把抖动从 0 调到 4,看看这个选择对结果的影响有多大。
预处理就是作业里的两行:
X = train_x_orig.reshape(m_train, -1).T     # (m, 16, 16, 3) → (m, 768) → (768, m)
X = X / 255.                                # 像素缩放到 [0, 1]
reshape(m, -1) 把每张图拉成一行,-1 让 numpy 自己算出 768;.T 再把行变成列,符合 约定。演示 1 还演示了一个不报错的 bug:写成 train_x_orig.reshape(-1, m_train),得到的形状同样是 (768, 1000),但每一列混进了好几张不同图片的像素,和标签对不上了。用它训练,训练准确率 0.780(768 个参数在 1000 个样本上”硬记”住了一部分),测试准确率 0.498,和”全猜 0”差不多。用正确的写法训练,测试准确率是 0.958。检查办法很简单:拉平之后随便取一列,reshape 回 (16, 16, 3),看它是不是原来那张图。
2. 逻辑回归模型:为什么输出要过 sigmoid · The logistic regression model
2.1 先试最简单的:直接用线性函数
我们想要的输出是 ,即”给定这张图,它是正类的概率”。最简单的模型是线性函数 ,但它有一个硬伤: 可以是任何实数,比如 −37 或 5.2,而概率必须在 0 和 1 之间。把 −37 解释成概率没有意义。
2.2 sigmoid:把任意实数压进 (0, 1)
解决办法是在线性部分后面再接一个函数,把实数压到 (0, 1) 里:
代码 01 演示 1 打印了 sigmoid 的几个值:
| −10 | 0.000045 | 0.000045 | −10.0000 |
| −2 | 0.119203 | 0.104994 | −2.0000 |
| 0 | 0.500000 | 0.250000 | 0.0000 |
| 2 | 0.880797 | 0.104994 | 2.0000 |
| 10 | 0.999955 | 0.000045 | 10.0000 |
三个性质要记住:
- 很大时 , 很负时 , 时恰好 0.5。 所以”预测为正类”()等价于 ,也就是 。逻辑回归的决策边界是一个超平面,它是一个线性分类器,§9.3 会看到这个限制的后果。
- 导数的形式很简单:。 它在 处最大,也只有 0.25; 时只剩约 4.5e−5。sigmoid 在两端几乎是平的,叫做饱和(saturation)。这个性质会在 §3.4 害惨平方误差,在第 1 讲代码 04 里也造成了深层网络的梯度消失。
- 最后一列:。 叫几率(odds),它的对数叫对数几率(log-odds,也叫 logit)。所以逻辑回归的假设是:正类的对数几率是输入的线性函数。名字里的 logistic 就来自 logistic 函数(即 sigmoid)。虽然名字里有”回归”,它做的却是分类。
2.3 一个实现细节:数值稳定
直接写 1 / (1 + np.exp(-z)) 在 时会出问题: 超出了浮点数能表示的范围(约 )。代码 01 演示 1 在 np.errstate(over="raise") 下运行这个朴素写法,得到 FloatingPointError: overflow encountered in exp。本讲义的代码一律用恒等式
它在数学上和原式完全相同,而 永远不会溢出( 时直接得到 0.0)。这类”公式没错、但浮点数撑不住”的问题,在深度学习代码里非常常见。
3. 损失函数:为什么是交叉熵 · The cost function
3.1 Loss 和 cost
有了模型,还需要一个数来衡量”预测错了多少”。Ng 区分两个词:
- 损失(loss) :衡量一个样本错了多少;
- 代价(cost) :所有训练样本损失的平均。训练就是找让 最小的 。
逻辑回归用的损失叫交叉熵(cross-entropy,二分类时也叫 binary cross-entropy、log loss):
只能是 0 或 1,所以方括号里两项总有一项是 0:
- 时,。 越接近 1,损失越接近 0; 时损失 。
- 时,。 越接近 0 越好。
3.2 直觉:给”正确答案”的概率取负对数
时 是模型给正确答案的概率; 时 是模型给正确答案的概率。两种情况合起来,交叉熵就是模型给正确答案的概率取负对数。代码 01 演示 2 固定 ,让预测 越来越错:
| 预测 | 交叉熵 | 平方误差 | ||
|---|---|---|---|---|
| 0.99 | 0.010 | 0.0001 | −0.010 | −0.000099 |
| 0.9 | 0.105 | 0.0050 | −0.100 | −0.009000 |
| 0.5 | 0.693 | 0.1250 | −0.500 | −0.125000 |
| 0.3 | 1.204 | 0.2450 | −0.700 | −0.147000 |
| 0.1 | 2.303 | 0.4050 | −0.900 | −0.081000 |
| 0.01 | 4.605 | 0.4900 | −0.990 | −0.009801 |
| 0.001 | 6.908 | 0.4990 | −0.999 | −0.000998 |
先看损失本身。交叉熵对”自信地错”()罚 6.908,而且还会继续增长;平方误差最多只有 ½,对 (0.4050)和 (0.4990)罚得差不多。
更关键的是最后两列,也就是梯度。 先停下来想一想:模型越错,梯度应该越大还是越小?我们当然希望越错推得越用力。交叉熵做到了:它对 的梯度恰好是 ,从 −0.010 一路增大到 −0.999(§6.1 推导)。平方误差的梯度多了一个因子 ,也就是 sigmoid 的导数。 接近 0 或 1 时这个因子接近 0,于是梯度先增大、后减小: 时最大(−0.147),到 时只剩 −0.000998,比交叉熵小约 1000 倍。模型越自信地错,平方误差越推不动它。
3.3 从最大似然推出交叉熵
交叉熵不是拍脑袋想出来的。C1M2 的选修视频 “Explanation of Logistic Regression Cost Function” 给了它的来历:最大似然估计(maximum likelihood estimation)。
模型说 ,。两个式子可以合写成一个:
(代入 得 ,代入 得 。)取对数:
所以单个样本的损失就是负的对数似然。如果 个训练样本相互独立,模型给整个训练集标签的概率(似然,likelihood)是各个样本概率的乘积:
最大化似然 ⇔ 最大化对数似然 ⇔ 最小化 。 取对数把乘积变成求和(数值上也更稳定,几千个小于 1 的数相乘很快就下溢成 0),除以 让代价的大小不随样本数变化。代码 01 演示 2 用 4 个样本验证:预测 ,标签 ,模型给真实标签的概率是 ,乘积 0.3024。交叉熵代价 ,而 ,正好等于似然。
这个”负对数似然”的视角是通用的:第 9 讲的多分类 softmax 用的交叉熵,第 15–17 讲语言模型”预测下一个词”的损失,都是同一个东西。
3.4 为什么不用平方误差
线性回归用平方误差 ,为什么逻辑回归不用?Ng 在视频里给的理由是:sigmoid 配平方误差,优化问题会变成非凸的,梯度下降可能找不到全局最优。下面把这件事画出来,同时看第二个、实践中往往更要命的问题。
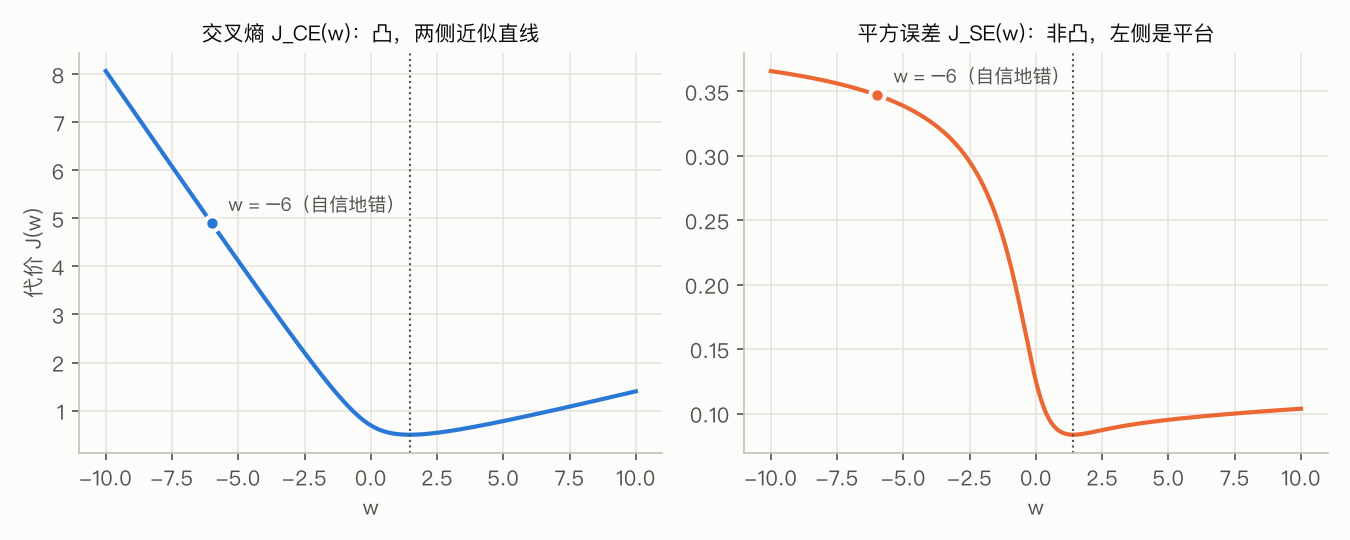
代码 01 演示 3 用一个最简单的设定:40 个一维样本(,),模型只有一个参数 ( 固定为 0)。这样代价就是一条曲线 ,可以把 从 −10 扫到 10:
| 准确率 | |||||
|---|---|---|---|---|---|
| −10 | 8.0644 | 0.3658 | −0.79587 | −0.00295 | 0.225 |
| −6 | 4.8966 | 0.3473 | −0.78591 | −0.00725 | 0.225 |
| −3 | 2.5763 | 0.3087 | −0.75109 | −0.02307 | 0.225 |
| 0 | 0.6931 | 0.1250 | −0.33312 | −0.08328 | — |
| 2 | 0.5106 | 0.0850 | 0.04322 | 0.00399 | 0.775 |
| 10 | 1.4020 | 0.1037 | 0.12963 | 0.00129 | 0.775 |
-
凸性。 在 2001 个等间距的 上数一数曲线”向下弯”(二阶差分 < 0)的点:交叉熵 0 个,平方误差 1725 个(共 1999 个)。交叉熵处处向上弯,是一只碗,叫凸(convex)函数,梯度下降从哪里出发都会走到同一个最低点()。平方误差的曲线大部分在向下弯,不是凸的。
诚实地说,在这个一维例子里平方误差碰巧只有 1 个局部极小值,没有出现”多个局部最优”。在多维、多样本的情况下,sigmoid 配平方误差确实可以有很多个局部极小值(Auer、Herbster 和 Warmuth 1996 年构造过局部极小值个数随维度指数增长的例子),但这个一维演示里看到的主要问题是下一条。
-
平台。 时模型把 77.5% 的样本判反了(准确率 0.225), 越负,判反得越”自信”。这时交叉熵的曲线是一条陡峭的斜线,平方误差的曲线却是一个几乎水平的平台: 从 −10 走到 −3, 只从 0.3658 降到 0.3087。在 处,交叉熵的梯度是平方误差的 108 倍,原因正是 §3.2 那个因子 。
代码 01 演示 4 从 出发做梯度下降,看平台的实际后果:
| 第 0 步 | 第 50 步 | 第 100 步 | 第 500 步 | 第 1000 步 | 到达最低点 | |
|---|---|---|---|---|---|---|
| 交叉熵,lr = 0.5 | −6.000 | 1.334 | 1.462 | 1.471 | 1.471 | 68 步 |
| 平方误差,lr = 0.5 | −6.000 | −5.814 | −5.617 | −3.222 | 1.371 | 968 步 |
| 平方误差,lr = 5(10 倍) | −6.000 | −3.268 | 1.374 | 1.412 | 1.412 | 96 步 |
(表中是参数 ;“到达最低点”指第一次满足 , 是这种代价自己的最低点。)
同样的学习率下,平方误差在平台上爬了几百步, 几乎不动,总共要 968 步,交叉熵只要 68 步。把平方误差的学习率加大 10 倍,它要 96 步,仍然比交叉熵慢。学习率能调,但同一个学习率要在整条路上都合适:平台上嫌小,到了碗底附近又可能嫌大(§4)。换一个没有平台的损失函数,才是根本的办法。
3.5 小结:交叉熵 + sigmoid 是”天生一对”
把 §3.2–3.4 合起来,交叉熵有三个好处:
- 它来自最大似然,有清楚的概率含义;
- 它对 是凸的(§4.4 给出一行证明),梯度下降不会卡在局部最优;
- 它和 sigmoid 组合后,:错多少推多少,sigmoid 的饱和被抵消了。
这个”输出层激活函数 + 对应的负对数似然损失”的搭配会反复出现:sigmoid 配二元交叉熵、softmax 配多分类交叉熵(第 9 讲)、线性输出配平方误差(回归,第 1 讲代码 01)。三种搭配的输出层梯度都是”预测 − 标签”这种简洁形式,这不是巧合。它们都属于统计里的”广义线性模型 + 正则连接函数”(canonical link),CS229 的讲义里有推导。
4. 梯度下降:下山 · Gradient descent
4.1 几何直觉
现在问题变成:找 让 最小。想象 是一片地形,水平方向是参数,高度是代价。交叉熵的地形是一只碗(凸)。你站在碗壁上某一点,眼睛被蒙住,只能感觉到脚下的坡度。怎样走到碗底?
沿着最陡的下坡方向迈一小步,然后重复。 坡度就是导数(梯度),它指向上坡最陡的方向,所以要往反方向走:
用 dw、db 的记号,就是 w = w - alpha * dw。一维时看得最清楚:
- 在最低点右边,导数 > 0(往右走会上坡),更新让 减小,即往左走;
- 在最低点左边,导数 < 0,更新让 增大,即往右走。
不管从哪边出发,都会朝最低点走。而且离最低点越远,坡度越陡,步子越大;越近越平,步子越小。
4.2 学习率:步子迈多大
叫学习率(learning rate),它决定每一步走多远。代码 04 演示 2(a) 在最简单的碗 上,从 出发:
| 学习率 | 第 1 步 | 第 2 步 | 第 3 步 | 第 5 步 | 第 10 步 | 第 20 步 | 结果 |
|---|---|---|---|---|---|---|---|
| 0.05 | 0.300 | 0.570 | 0.813 | 1.229 | 1.954 | 2.635 | 太小:每步只走剩余距离的 10% |
| 0.5 | 3.000 | 3.000 | 3.000 | 3.000 | 3.000 | 3.000 | 刚好:一步到位 |
| 0.9 | 5.400 | 1.080 | 4.536 | 3.983 | 2.678 | 2.965 | 偏大:来回震荡,但越震越小 |
| 1.1 | 6.600 | −1.320 | 8.184 | 10.465 | −15.575 | −112.013 | 太大:越震越大,发散 |
为什么是这几个数?对这个二次函数,,代入更新公式:
每走一步,到最低点的距离乘以 。 才会收敛,也就是 。一般地,学习率超过 就会发散(这里曲率 )。直觉是:碗越陡(曲率越大),步子就得越小,否则一步会跨到对面的碗壁上,而且落点比出发点还高。
4.3 在图像数据上扫描学习率
真实的代价函数不是一维的,但同样的道理在”最弯的方向”上成立。逻辑回归的代价对 的二阶导数(Hessian)是
因为 ,最大曲率不超过 。代码 04 演示 2(b) 算出我们的图像数据上 ,临界学习率 。然后从 出发,用五个学习率各走 2000 步(作业里也是 2000 步):
| 学习率 | 第 0 步 | 第 2 步 | 第 5 步 | 第 100 步 | 第 500 步 | 第 2000 步 | 最大 | 上升次数 | 训练准确率 | 测试准确率 |
|---|---|---|---|---|---|---|---|---|---|---|
| 0.0005 | 0.6931 | 0.6929 | 0.6926 | 0.6834 | 0.6496 | 0.5701 | 0.69 | 0 | 0.812 | 0.780 |
| 0.005 | 0.6931 | 0.6911 | 0.6882 | 0.6164 | 0.4988 | 0.3713 | 0.69 | 0 | 0.866 | 0.840 |
| 0.05 | 0.6931 | 0.6740 | 0.6491 | 0.4403 | 0.2644 | 0.1316 | 0.69 | 0 | 0.984 | 0.958 |
| 0.5 | 0.6931 | 2.3588 | 13.60 | 1.5416 | 0.0689 | 0.0210 | 13.66 | 183 | 0.996 | 0.962 |
| 5 | 0.6931 | 13.62 | 14.01 | 7.2531 | 0.4030 | 0.0008 | 14.01 | 634 | 1.000 | 0.952 |
(“上升次数”是 2000 步里代价比上一步高的次数。)
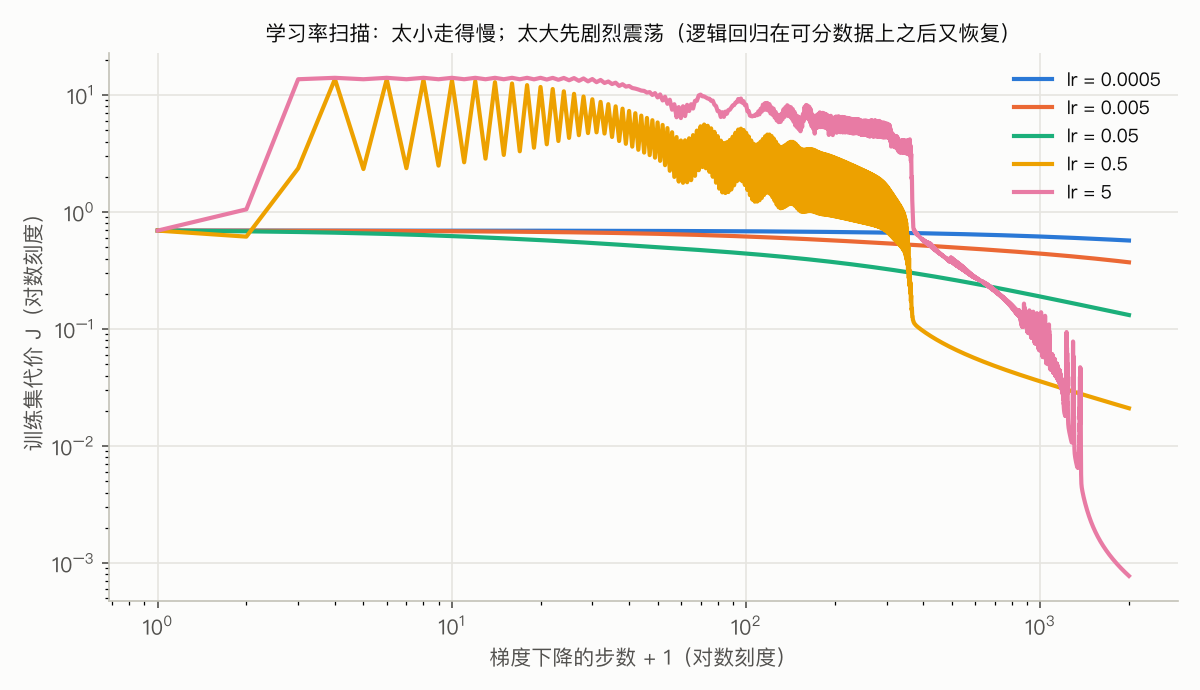
- 太小(0.0005、0.005):代价单调下降,但像蜗牛一样慢,2000 步后还停在 0.570 和 0.371,测试准确率只有 0.780 和 0.840。
- 合适(0.05):代价平稳下降,一次都没有上升,测试准确率 0.958。它其实比 还略大一点,却没出问题,原因是一离开 ,sigmoid 就开始饱和,,实际曲率随训练下降。代码打印了训练过程中的实际最大曲率:第 20 步 40.77(对应 ),第 2000 步 14.49。
- 太大(0.5,约 10 倍临界值):这就是”跨到对面山坡上”。代价在第 3 步冲到 13.66,比起点 0.693 差了 20 倍,然后剧烈震荡,直到第 298 步才回到起点以下。
和预想不一样的地方。 我原以为学习率太大会像二次函数那样发散到无穷大。实际上 lr = 0.5 甚至 lr = 5 都没有发散:前几百步一片混乱,之后代价突然掉下来,2000 步后训练代价反而最低(0.0210 和 0.0008),测试准确率(0.962、0.952)也不比 lr = 0.05 差。原因是逻辑回归配交叉熵有两个特殊性质:
- 梯度有界:,所以 永远不会超过输入向量的平均长度,一步最多只能走那么远,不会越推越大。平方误差的线性回归没有这个上限。
- 我们的训练集是线性可分的(lr = 5 时训练准确率达到 1.000)。在可分的数据上,代价可以随 变大一直降低(§4.4),大步子只是让 长得更快。
最近的理论研究也发现了这一点:在可分数据上,逻辑回归的梯度下降用很大的步长也能收敛,代价会先不单调、后下降(Wu et al. 2024,见 §13)。但不要把这个特例推广:换成平方误差,或者有隐藏层的网络,学习率太大常常真的会发散成 inf / nan(第 1 讲代码 04:ReLU 深网在 lr = 3 时发散)。即使在这里,前几百步的混乱也意味着白白浪费了计算。
实践中怎么选学习率? 看代价曲线。代价应该大体上单调下降;一开始就往上跳,说明太大;下降得像蜗牛,说明太小。学习率通常在对数尺度上试(0.001、0.01、0.1……),作业里也比较了 0.01、0.001、0.0001 三个值。第 8 讲讲学习率衰减,第 9 讲讲系统的超参数搜索。
4.4 凸,但可能没有最低点
§3.4 说交叉熵是凸的。一行证明:上面的 Hessian 是一堆 (半正定矩阵)乘上非负的系数 再相加,所以半正定,函数是凸的。这意味着不存在”坏的局部最优”:梯度下降只要步子不太大,就会一直下降。
但”凸”不等于”有一个最低点”。如果训练集线性可分,即存在一个超平面把正负类完全分开,那么沿着这个方向把 放大,所有样本的 都离 0 更远,预测越来越自信,代价就一直降向 0,却永远到不了 0。最优的 在”无穷远”处。代码 02 演示 4 的 4 个样本就是这样:50 步后代价降到 0.0705, 还在不断变大。§4.3 里 lr = 5 把代价降到了 0.0008,也是因为 长得很大。
这带来两个实际问题:模型对训练数据过度自信,以及权重变得越来越大。它们是过拟合的一种表现,第 6 讲的 L2 正则化和早停(early stopping)就是解决办法。有一个有趣的理论结果:在可分数据上,梯度下降的 虽然长度趋于无穷,方向却会收敛到最大间隔(max-margin)的分类方向,和支持向量机一样(Soudry et al. 2018)。
5. 导数与计算图 · Derivatives & the computation graph
梯度下降需要 和 。这一节先建立两个工具:导数的直觉、计算图上的链式法则。C1M2 用了整整四个视频讲它们,因为后面所有网络的反向传播都建立在这里。
5.1 导数 = “把输入推一点,输出动多少”
Ng 讲导数时没有从极限的定义出发,而是用一个很直观的问法:把 推一点点(比如 0.001), 动了多少?两者的比值就是导数。 代码 02 演示 1 把 C1M2 视频里的几个例子真的推了一遍:
| 函数 | 变化量 / 0.001 | 手算导数 | |||
|---|---|---|---|---|---|
| 2 | 6.00000 | 6.003000 | 3.0000 | 3 | |
| 5 | 15.00000 | 15.003000 | 3.0000 | 3 | |
| 2 | 4.00000 | 4.004001 | 4.0010 | 4 | |
| 5 | 25.00000 | 25.010001 | 10.0010 | 10 | |
| 2 | 8.00000 | 8.012006 | 12.0060 | 12 | |
| 2 | 0.69315 | 0.693647 | 0.4999 | 0.5 |
- 是直线,在哪里推,输出都变 3 倍,导数处处是 3。
- 是曲线:在 处推 0.001,输出变约 0.004;在 处变约 0.010。导数是”在这一点附近,输出对输入有多敏感”,位置不同,敏感程度不同。
- 表里的比值是 4.0010 而不是 4,因为 0.001 不是无穷小,曲线在这一小段里还在弯。
5.2 单边推 vs 双边推
既然”推一点”就能估计导数,能不能干脆不推导公式,全靠推?可以,但有两个问题:不够准,而且太慢。演示 1 的第二张表比较了两种推法,估计 在 处的导数(真值 12):
| 推动幅度 | 单边 的误差 | 双边 的误差 |
|---|---|---|
| 1e−1 | 6.1e−01 | 1.0e−02 |
| 1e−2 | 6.0e−02 | 1.0e−04 |
| 1e−3 | 6.0e−03 | 1.0e−06 |
| 1e−4 | 6.0e−04 | 1.0e−08 |
| 1e−6 | 6.0e−06 | 7.9e−10 |
| 1e−8 | 7.3e−08 | 1.2e−07 |
单边差分的误差和 成正比,双边差分的误差和 成正比(对 恰好等于 )。所以用差分来检查梯度时,用双边差分。最后一行还说明 不是越小越好: 时 和 几乎相等,相减时浮点舍入误差被放大,双边差分的误差反而回升到 1.2e−07。
至于”太慢”:差分法对每个参数都要把 重新算两遍。一张 768 个像素通道的图就要算 1536 遍,而一个大网络有上亿个参数。所以差分只用来验证手推的梯度,训练时用的是下面的反向传播。本讲用双边差分做验证工具,系统的梯度检验(gradient checking)在第 7 讲。
5.3 计算图:J = 3(a + bc)
把一个复杂的计算拆成一串简单的步骤,每一步画成一个节点,就得到计算图(computation graph)。C1M2 的例子是 ,拆成三步:,,。代码 02 演示 2 取 :
    b ─┐
       ├─→ u = bc ─┐
    c ─┘           ├─→ v = a + u ─→ J = 3v
a ─────────────┘前向(从左到右):,,。
反向(从右到左):要求 对每个变量的导数。从最右边开始,每一步只做一件小事:本节点的局部导数 × 从右边传回来的导数。
| 导数 | 链式法则 | 值 | 把这个变量推 0.001 后的 | |
|---|---|---|---|---|
dv | 3 | 33.003 | 3.000 | |
da | 3 | 33.003 | 3.000 | |
du | 3 | 33.003 | 3.000 | |
db | 6 | 33.006 | 6.000 | |
dc | 9 | 33.009 | 9.000 |
最后两列是”真的推一推”的验证:把 从 3 推到 3.001, 变了 倍(0.002), 跟着变 0.002, 再放大 3 倍,变了 0.006。链式法则(chain rule)说的就是这件事:变化沿着计算图一节一节地传过去,每过一个节点就乘一次局部导数。
5.4 为什么要”倒着走”
你可能会问:为什么不从左往右算导数?
看 da 和 du,它们都用到了 dv;db 和 dc 都用到了 du。从右往左走,每个中间节点的导数只算一次,然后被它左边的所有节点复用。如果对每个参数单独从头推一遍,这些中间结果会被重复计算很多次。
这就是反向传播(backpropagation)高效的秘密:一次反向传播的计算量和一次前向传播差不多,不管有多少个参数。相比之下,§5.2 的差分法要做”参数个数 × 2”次前向传播。对一个有一亿个参数的网络,这是”两次”和”两亿次”的区别。反向传播本质上是一种叫”反向模式自动微分”(reverse-mode automatic differentiation)的通用技术,PyTorch 的 loss.backward() 做的就是这件事(第 9 讲)。
代码里的记号:Ng 在代码里用 dvar 表示”最终输出( 或 )对 var 的导数”。所以 dv 是 ,da 是 。这个约定在整个 Deep Learning Specialization 的作业里都通用。
6. 逻辑回归的反向传播 · Backpropagation for logistic regression
6.1 单个样本
现在把计算图用到逻辑回归上。先看一个样本、两个特征的情况:
    x1, w1 ─┐
    x2, w2 ─┼─→ z = w1·x1 + w2·x2 + b ─→ a = σ(z) ─→ L(a, y)
    b ──────┘
从右往左,一步一步来。
第 1 步: 对 。 ,对 求导:
第 2 步: 对 。 先推 sigmoid 的导数。,所以
第 3 步:链式法则合起来。
那个有点乱的式子,乘上 之后约掉了分母,只剩下 ,也就是”预测 − 标签”。这就是 §3.5 说的”天生一对”:sigmoid 的导数 正好被交叉熵的 、 抵消了。平方误差没有这个抵消,所以它的 带着饱和因子。
第 4 步: 对参数。 ,所以 ,:
代码 02 演示 3 取 ,,,,前向得 、、,然后逐项和双边差分对照:
| 导数 | 公式 | 链式法则的结果 | 双边差分 |
|---|---|---|---|
da | −2.105171 | −2.105171 | |
dz | −0.524979 | −0.524979 | |
dw1 | −0.787469 | −0.787469 | |
dw2 | 1.049958 | 1.049958 | |
db | −0.524979 | −0.524979 |
两列在 6 位小数上完全一致。沿负梯度走一步(),损失从 0.7444 降到 0.1525。看看参数怎么动: 从 0.4 变成 0.7937, 从 0.3 变成 −0.2250, 从 −0.1 变成 0.1625。 是负的,所以减小 反而让 变大。三个参数都在把 往正方向推,让 更接近正确答案 1。 越大的特征,它的权重被推得越多,因为那个权重对 的影响越大。
6.2 m 个样本:代价是平均,梯度也是平均
代价 。求导是线性运算,平均的导数等于导数的平均:
先对每个样本算梯度,再取平均。 视频 “Gradient Descent on m Examples” 把它写成这样一段伪代码():
J = 0; dw1 = 0; dw2 = 0; db = 0
for i = 1 to m:
    z(i)  = wᵀx(i) + b
    a(i)  = σ(z(i))
    J    += −[y(i) log a(i) + (1 − y(i)) log(1 − a(i))]
    dz(i) = a(i) − y(i)
    dw1  += x1(i) · dz(i)
    dw2  += x2(i) · dz(i)
    db   += dz(i)
J /= m; dw1 /= m; dw2 /= m; db /= m
w1 := w1 − α·dw1;  w2 := w2 − α·dw2;  b := b − α·db
代码 02 演示 4 在 4 个样本上照着实现。每个样本的 是 (−0.525, 0.5, −0.2994, 0.4158),平均后得到 、、、。和双边差分的相对误差是 5.5e−11,和下一节向量化的 propagate 也完全一致。用它做 50 步梯度下降(),代价从 0.5827 降到 0.0705,每一步都在下降。
这段代码有两个 for 循环:一个遍历样本 ,写在明面上;另一个遍历特征,藏在 dw1、dw2 的手写里。 时还能手写,一张 64×64 的图有 12288 个特征,就只能再写一个循环。下一节把两个循环都去掉。
7. 向量化 · Vectorization
7.1 为什么要去掉 for 循环
第 1 讲 §4.4 已经看到,同一个点积,用 Python 循环和用 np.dot 速度差几百倍。原因是 numpy 把整个运算交给用 C 写的、针对 CPU 优化过的线性代数库(BLAS),能用上 SIMD 指令(一条指令同时算好几个数)和多个 CPU 核心;Python 循环则要为每一次乘法解释一行代码、检查类型、创建对象。Ng 给的经验法则是:只要有可能,就避免显式的 for 循环。 深度学习的数据量很大,这条法则决定了一个实验要跑几分钟还是几天。
7.2 前向的向量化
逐样本算 ,再拼起来。因为 的第 列就是 ,这个过程恰好是一次矩阵乘法:
numpy 里写成 Z = w.T @ X + b(或 np.dot(w.T, X) + b)。 是一个数,加到 的矩阵上时会被自动复制到每一列,这就是广播(§8)。然后 A = sigmoid(Z),sigmoid 对每个元素分别计算。
7.3 反向的向量化
对每个样本都成立,所以 ,形状 。
的第 个分量是 ,即 的第 行和 对应元素相乘再求和。对所有 同时做,正好是矩阵乘法 :
一次完整的梯度下降迭代,没有任何对样本或特征的循环:
Z = w.T @ X + b            # (1, m)
A = sigmoid(Z)             # (1, m)
dZ = A - Y                 # (1, m)
dw = X @ dZ.T / m          # (n_x, 1)
db = np.sum(dZ) / m        # 标量
w = w - alpha * dw
b = b - alpha * db
这几行就是 logreg.py 里 propagate 和 optimize 的核心。唯一去不掉的循环是”迭代多少步”,因为第 步要用第 步的结果。
代码 03 演示 2 把每一项的形状列成了表(、 的图像数据):
| Ng 的公式 | numpy 代码 | 形状 | 说明 |
|---|---|---|---|
X | (768, 1000) | 每一列是一张图 | |
w | (768, 1) | 列向量 | |
w.T @ X + b | (1, 1000) | 广播到每一列 | |
sigmoid(Z) | (1, 1000) | 逐元素,形状不变 | |
A - Y | (1, 1000) | 第 列是第 个样本的 | |
X @ dZ.T / m | (768, 1) | 和 形状相同 | |
np.sum(dZ) / m | () | 标量 |
演示 2 还用循环单独算了 的第 100 个分量(0.2154483550),和矩阵乘法的结果一致。维度检查是防 bug 的第一道关:dw 的形状必须和 w 相同,db 必须和 b 相同。logreg.propagate 里用一行 assert 检查这一点,第 4 讲会把这条规则推广到每一层。
7.4 三种写法,结果一样吗?快多少?
代码 03 演示 1 把同一个逻辑回归写成三个版本:两重循环(样本 × 特征,§6.2 的伪代码推广到任意 )、一重循环(去掉对特征的循环,dw += x_i * dz)、完全向量化。在 1000 张合成图像上,从 、 出发,学习率 0.05,都走 5 步。我运行的一次结果如下(计时每次运行都不同):
| 写法 | 每步用时 | 比向量化慢 | 5 步后的代价 | |
|---|---|---|---|---|
| 两重循环(样本 × 特征) | 206 ms | 约 4000 倍 | 0.6491258808 | 3.5e−18 |
| 一重循环(只对样本) | 2.85 ms | 约 56 倍 | 0.6491258808 | 3.5e−18 |
| 完全向量化 | 0.05 ms | 1 | 0.6491258808 | 0 |
- 结果一样:三者的参数差异只有 1e−18 量级,远小于 1e−10。它们是同一个算法,差别只在浮点数加法的先后顺序。
- 速度差了三个多数量级:两重循环每步约 206 ms,向量化约 0.05 ms。我原以为会是”几百倍”(课程大纲里也是这么写的),实际是几千倍:每一步有 次乘加,对 BLAS 来说这是一个小矩阵乘法,对 Python 来说是上百万次解释执行(前向和
dw各一遍)。去掉一层循环(一重循环版)就快了约 70 倍,全部去掉又快了约 56 倍。
换算一下:用向量化写法,2000 步训练在我的电脑上不到 1 秒;用两重循环,要将近 7 分钟。如果换成 Coursera 作业的 64×64 猫图,特征数是 16 倍,两重循环的耗时会成倍增加(练习 8)。
8. 广播 · Broadcasting
8.1 Coursera 的例子:食物热量的百分比
Z = w.T @ X + b 里,一个数 加到了一个 的矩阵上。numpy 怎么知道要把 加到每一列?这就是广播。C1M2 用了一个和机器学习无关的例子来讲它。代码 03 演示 3 复现了这个例子:矩阵 是四种食物(苹果、牛肉、鸡蛋、土豆)每 100 克里来自碳水、蛋白质、脂肪的热量,形状 (3, 4)。问题是:每种食物的热量有百分之多少来自碳水、蛋白质和脂肪?
cal = A.sum(axis=0)                       # 每一列求和 → 形状 (4,):[59.0, 239.0, 155.4, 76.9]
percentage = 100 * A / cal.reshape(1, 4) # (3, 4) / (1, 4) → (3, 4)| 苹果 | 牛肉 | 鸡蛋 | 土豆 | |
|---|---|---|---|---|
| 碳水 | 94.9% | 0.0% | 2.8% | 88.4% |
| 蛋白质 | 2.0% | 43.5% | 33.5% | 10.4% |
| 脂肪 | 3.1% | 56.5% | 63.7% | 1.2% |
A / cal.reshape(1, 4) 里,(1, 4) 的行向量被”复制”成 3 行,再和 逐元素相除,于是每一列都除以了这种食物自己的总热量。numpy 并不真的复制内存,只是在计算时当作复制了,所以广播既方便又不浪费内存。
Ng 在视频里特意写了 cal.reshape(1, 4),尽管 cal(形状 (4,))本来就能广播。他的理由是:把形状写清楚,读代码的人就不用猜。reshape 几乎不花时间。
8.2 规则
第 1 讲 §3.5 看到了广播”出事”的现象。现在把规则本身讲清楚,这样任何两个形状你都能事先预测结果:
把两个形状右对齐,从最后一维往前逐维比较。每一维要么相等,要么其中一个是 1(长度为 1 的那个会被复制)。维度少的那个,在前面补 1。所有维度都满足才能广播,否则报错。
先自己试一试:(3, 4) 和 (3,) 能广播吗?(2, 3, 4) 和 (3, 1) 呢?然后对照演示 3 打印的表:
| 形状 1 | 形状 2 | 结果 | 说明 |
|---|---|---|---|
| (3, 4) | (1, 4) | (3, 4) | 每一行都加 / 除以同一个行向量 |
| (3, 4) | (3, 1) | (3, 4) | 每一列都加同一个列向量(如 里的 ) |
| (3, 4) | (4,) | (3, 4) | (4,) 当作 (1, 4),同第一行 |
| (1, 1000) | () | (1, 1000) | 加一个标量( 里的 ) |
| (3, 1) | (1, 4) | (3, 4) | 两边都被复制:得到 3×4 的”外积”式表格 |
| (3, 4) | (3,) | 报错 | (3,) 当作 (1, 3),最后一维 4 ≠ 3 |
| (3, 4) | (2, 4) | 报错 | 第一维 3 ≠ 2,且都不是 1 |
| (2, 3, 4) | (3, 1) | (2, 3, 4) | (3, 1) 当作 (1, 3, 1),三维也一样 |
Ng 在视频里总结的几种常见情况( 矩阵和 行向量、 列向量或一个实数做加减乘除),都是这条规则的特例。
8.3 一个新的陷阱:按特征中心化时写错 axis
广播最危险的情况是”本来该报错,却碰巧能广播”。第 1 讲的 (4,) − (4, 1) → (4, 4) 是一个例子。代码 03 演示 4 是另一个,而且在预处理数据时很常见:让每个特征减去它在所有样本上的均值(中心化,第 7 讲的输入归一化的第一步)。
的形状是 ,三个特征的均值分别约为 10、0、−5(实际是 9.971、−0.369、−4.771)。三种写法:
| 写法 | 减数的形状 | 结果中每个特征的均值 |
|---|---|---|
X - X.mean(axis=1, keepdims=True) | (3, 1) | [0.0, 0.0, 0.0] ✔ |
X - X.mean(axis=0) | (5,) | [8.361, −1.98, −6.381] ✘ 不报错! |
X - X.mean(axis=1) | (3,) | ValueError(3 ≠ 5) |
- 在我们的约定里,axis=1 是样本维。沿 axis=1 求均值,再用
keepdims=True保持 的列向量形状,减法时它被广播到每一列,结果正确。 - 写成
axis=0,求的是”每个样本的所有特征的平均”,形状 。按规则它被当作 ,和 完美兼容,不报错,但减掉的是完全不同的东西。三个特征的均值只是整体平移了一点,并没有被中心化。 - 忘了
keepdims时得到 ,右对齐后要和最后一维 比较。 时报错,这反而是好事。但如果 恰好等于 ,比如调试时用了一个 3×3 的小例子,它又会悄悄算错:演示 4 里的 3×3 例子,“中心化”后每行的均值是 [8.905, −2.197, −6.708]。
8.4 防御的习惯
C1M2 的最后一个视频 “A Note on Python/Numpy Vectors” 讲的就是这类问题(rank-1 数组的现象见第 1 讲 §3.5)。Ng 的建议可以总结成三条,本讲义的代码都照做了:
- 不用 rank-1 数组:
np.zeros((n, 1))而不是np.zeros(n);求和、求均值时加keepdims=True。 - 写下每个量应有的形状(代码注释里到处是”形状 (n_x, m)”),在关键处
assert,比如assert dw.shape == w.shape。 - 拿不准就
reshape:它几乎不花时间,却能让形状一目了然。
9. 神经网络思维:把它们组装起来 · Putting it together
9.1 完整的流程
作业的最后一步是把前面的函数串成一个 model()。logreg.py 照着作业的接口实现:
| 函数 | 做什么 | 对应本讲 |
|---|---|---|
sigmoid(z) | ,用 tanh 的稳定写法 | §2 |
initialize_with_zeros(dim) | (形状 (dim, 1)), | §9.4 |
propagate(w, b, X, Y) | 向量化的前向 + 反向,返回 dw、db、cost | §6–7 |
optimize(...) | 重复 propagate → 更新,记录每一步的代价 | §4 |
predict(w, b, X) | 判为 1 | §2.2 |
model(...) | 初始化 → 训练 → 在训练集和测试集上预测 | — |
用 lr = 0.05 训练 2000 步,训练准确率 0.984,测试准确率 0.958(§4.3)。下面看它学到了什么。
9.2 学到的 w 是一个”模板”
:每个像素通道乘一个权重再相加。把 768 个权重按拉平的顺序 reshape 回 (16, 16, 3),就能看见模型在找什么。代码 04 演示 3 把三个通道画成字符热力图,同时保存了一张图(红 = 正权重,蓝 = 负权重):
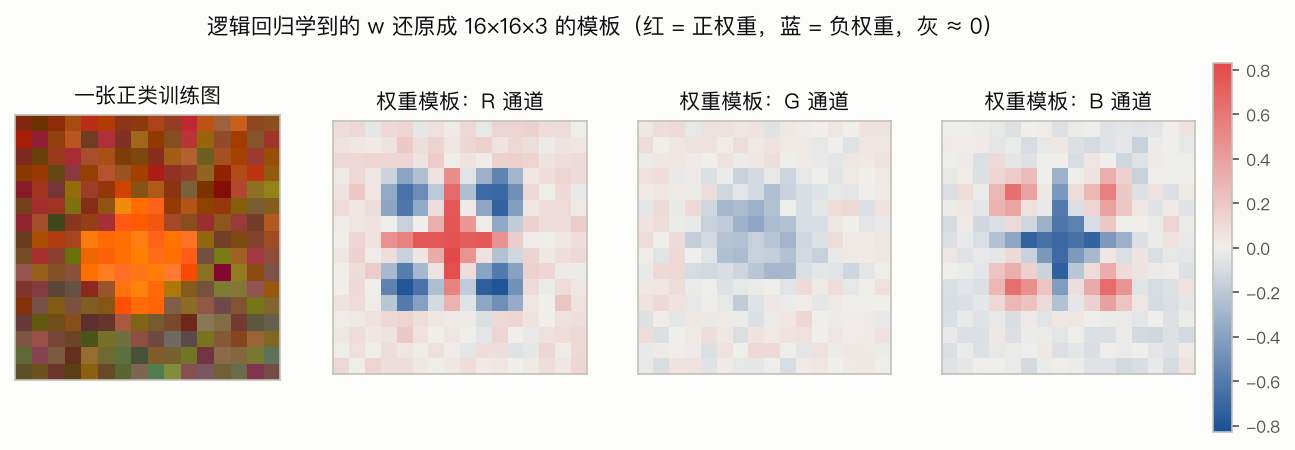
先自己看图,猜一猜模型的”判断规则”是什么。然后对照代码打印的区域统计。代码把像素分成四类:十字核心是不管十字怎么抖(±1)都会被覆盖的 9 个像素;十字边缘是有时被十字覆盖的像素;四角区是只有方块会覆盖的像素;其余是外围区。
| 区域 | 像素数 | R | G | B | 对橙色像素的响应 |
|---|---|---|---|---|---|
| 十字核心 | 9 | 0.763 | −0.242 | −0.675 | +0.492 |
| 十字边缘 | 56 | −0.107 | −0.119 | −0.003 | −0.157 |
| 四角区 | 16 | −0.490 | −0.009 | 0.340 | −0.410 |
| 外围区 | 175 | 0.066 | 0.020 | −0.031 | +0.067 |
(“对橙色像素的响应”= 区域平均权重 · (235, 125, 35)/255,即这个区域里一个橙色像素对 的平均贡献。)
模型学到的规则可以读出来:
- 十字核心是一个”橙色探测器”:R 正、B 负、G 略负,对橙色像素响应 +0.492。在 R 通道的图里,它就是中间那个红色的小十字;在 B 通道里是蓝色的小十字。
- 四角区正好反过来:R 负、B 正,对橙色像素响应 −0.410。模型学会了”四个角是橙色的就扣分”,这就是它区分十字和方块的办法。图里是 R 通道四角的蓝色块、B 通道四角的红色块。
- 十字边缘略微偏负(−0.157):方块几乎总会盖住这些像素,十字只是有时盖住,所以”这里是橙色”反而稍微更像方块。这些像素的含义随抖动而变,固定位置的模板只能给一个折中的权重。
- 外围区接近 0 但不是 0:模型从 1000 张训练图的背景噪声里”记住”了一些东西,对测试集没有帮助。训练准确率 0.984 高于测试准确率 0.958,这是过拟合(第 6 讲)。
十字核心对五种图案颜色的响应是:橙 +0.492、黄 +0.346、绿 −0.137、蓝 −0.485、紫 −0.121。黄色最接近橙色,两者的 R、B 分量很像,只差在 G。这预测了模型会在哪里犯错:
| 测试集上的种类 | 张数 | 平均打分 | 准确率 |
|---|---|---|---|
| 橙色十字(正类) | 246 | 2.34 | 0.992 |
| 橙色方块 | 80 | −1.55 | 0.912 |
| 其他颜色的十字 | 100 | −4.25 | 0.900 |
| 只有背景 | 74 | −3.40 | 0.973 |
其他颜色的十字里,被误判为正类的全是黄色的(黄 10 / 32,绿、蓝、紫都是 0)。橙色方块的平均打分(−1.55)离决策边界 最近,它是另一类主要的错误来源。
这就是”逻辑回归 = 一个线性模板”的含义:模型给每个像素一个固定的权重,打分就是”这张图和模板有多像”。
9.3 线性模板的极限:位置一变就不灵了
模板是固定位置的。如果图案的位置变化更大,会怎样?先预测一下,再看 代码 04 演示 4:每个抖动幅度都重新生成数据,其他设置不变。
| 抖动(像素) | 位置数 | 训练准确率 | 测试准确率 | 橙色十字 | 橙色方块 | 其他色十字 | 只有背景 |
|---|---|---|---|---|---|---|---|
| ±0 | 1 | 0.987 | 0.986 | 0.996 | 0.978 | 0.962 | 0.989 |
| ±1 | 9 | 0.984 | 0.958 | 0.992 | 0.912 | 0.900 | 0.973 |
| ±2 | 25 | 0.891 | 0.806 | 0.862 | 0.338 | 0.940 | 0.946 |
| ±3 | 49 | 0.895 | 0.792 | 0.837 | 0.312 | 0.930 | 0.973 |
| ±4 | 81 | 0.872 | 0.764 | 0.821 | 0.225 | 0.900 | 0.973 |
(后四列是测试集上各类图片的准确率。)
- 图案不动时,一个模板几乎完美(测试 0.986),连橙色方块都能分对 0.978:位置固定,“十字的四个角在哪”是确定的。
- 抖动越大,测试准确率一路下降,掉得最多的正是橙色方块(±4 时只有 0.225,比瞎猜还差,因为模型把大部分方块判成了十字)。颜色线索不依赖位置,“其他颜色的十字”那一列在 0.90–0.96 之间波动,没有随抖动变差。
- 抖动到 ±2 以上,连训练准确率都掉到 0.87–0.90:线性模型连训练集都拟合不好,表达能力不够(第 6 讲叫 high bias)。同时训练和测试的差距从 ±0 的 0.001 拉大到 ±4 的 0.108,它在用 768 个权重记住训练图,而不是学到”十字”这个概念。
这张表说明了后面几讲为什么要存在。要识别”任何位置的十字”,需要 (1) 隐藏层:先检测”这里有一段橙色的横杠""那里有一段竖杠”,再组合起来(第 3、4 讲);或者 (2) 卷积:同一个小模板在整张图上滑动,在哪里都能检测到同一个图案(第 12 讲)。Coursera 作业里的逻辑回归在猫图上的结果大约是训练 99%、测试 70%,原因相同:真实的猫比我们的十字变化多得多,一个模板远远不够。C1M4 的编程作业会在同一个数据集上用一个 4 层网络把测试准确率提高到 80% 左右(第 4 讲)。
9.4 逻辑回归 = layer_dims = [n_x, 1] 的神经网络
第 1 讲把 tiny_nn.py 当作黑盒,并预告第 2 讲会拆开”只有输出层”的情况。现在拆开它。代码 04 演示 5 做了两个对照:
- 同一组参数:把我们的 ((768, 1))转置成
W1((1, 768)), 包成b1((1, 1)),交给tiny_nn.forward和tiny_nn.backward。前向输出、dW1和dw.T、db1和db的差异全部是 0,两边的代价都是 0.7151366727。tiny_nn.backward的第一行就是dZ = AL - Y,接着dW1 = dZ @ A_prev.T / m。它和我们的dw = X @ dZ.T / m是同一个式子的转置。 - 同一个起点、同样的步数:
tiny_nn.train(..., layer_dims=[768, 1], optimizer="sgd", batch_size=m)和我们的optimize,从同一个随机初始化出发,lr = 0.05 训练 2000 步。参数的最大差异 6.7e−16(tiny_nn每步把样本顺序打乱,加法顺序不同),测试准确率都是 0.962。
所以,逻辑回归就是一个没有隐藏层、只有一个 sigmoid 输出单元的神经网络。 记号上唯一的差别是 §0.4 说的 。第 3 讲有 个隐藏单元时, 是 的矩阵,每一行就是一个单元自己的 。每个隐藏单元都是一个小逻辑回归,输出层再把它们的结果组合起来。
为什么逻辑回归可以从 开始,tiny_nn 却用随机初始化? 演示 5 还比较了两个起点:从全 0 和从随机出发各训练 2000 步,两个 的余弦相似度 0.977,测试集上 98.8% 的预测相同,全 0 起点的测试准确率 0.958,随机起点是 0.962。代价是凸的,起点不太重要。因为训练集可分、没有有限的最低点(§4.4),2000 步后两者并不完全相同。有了隐藏层就不一样了:如果同一层的所有单元从相同的值出发,它们算出的梯度也相同,更新后仍然相同,永远学不出不同的特征。这叫”对称性”问题,是第 3 讲的内容。
9.5 从这里到深度网络
| 逻辑回归(本讲) | 浅层网络(第 3 讲) | 深层网络(第 4 讲) | |
|---|---|---|---|
| 结构 | [n_x, 1] | [n_x, n1, 1] | [n_x, n1, ..., nL] |
| 前向 | 每层 | 同左, 层 | |
| 输出层梯度 | 同左 | 同左 | |
| 参数梯度 | 同左 | ||
| 新增的一步 | — | 同左,循环 次 | |
| 代价函数 | 凸 | 非凸 | 非凸 |
| 初始化 | 0 也行 | 必须随机 | 必须随机,而且尺度要对(第 7 讲) |
表里的”新增的一步”,就是把 §5.3 计算图上的链式法则再往左多走一层。本讲的推导,后面几讲都会原样复用。
10. 小结 · Summary
- 二分类: 是拉平的图像( 或 12288),。预处理是
reshape(m, -1).T / 255;写成reshape(-1, m)不报错,但测试准确率会掉到 0.498。 - 模型:。sigmoid 把打分压成概率;,决策边界是超平面;,两端饱和。
- 损失:交叉熵 就是负对数似然;cost 是 loss 的平均。不用平方误差的原因:它是非凸的(一维扫描里 1725/1999 个点向下弯),“自信地错”时梯度被 吃掉( 处小 108 倍,梯度下降要 968 步,交叉熵只要 68 步)。
- 梯度下降:。学习率超过 就会震荡或发散。图像数据上 ,lr = 0.05 平稳下降;lr = 0.5 的代价先冲到 13.66。逻辑回归梯度有界、训练集又可分,所以大学习率最后没有发散,这是特例。
- 导数与计算图:导数 = “推一点,动多少”;反向传播 = 在计算图上从右往左,每一步乘一个局部导数。中间结果被复用,所以一次反向传播的代价和一次前向传播差不多。差分法(用双边差分)只用来验证。
- 逻辑回归的梯度:,,; 个样本取平均;向量化后 ,,。
- 向量化:三种写法的结果相同(差异 1e−18),向量化比两重循环快约 4000 倍。唯一保留的循环是迭代步数。
- 广播:右对齐,逐维比较,相等或其中一个为 1。最危险的是”碰巧能广播”:
X - X.mean(axis=0)不报错但减错了东西。养成keepdims=True+assert形状的习惯。 - 神经网络思维:学到的 是一个线性模板(十字核心是橙色探测器,四角区反过来)。位置抖动从 ±0 到 ±4,测试准确率从 0.986 掉到 0.764。逻辑回归和
tiny_nn的[768, 1]网络给出完全相同的梯度。
11. 常见误区 · Common pitfalls
- “逻辑回归是回归。” 它是分类器。名字里的 regression 来自它对对数几率做线性回归(§2.2);输出概率,再按 0.5 的阈值分类。
- “损失函数随便选一个能衡量误差的就行。” sigmoid 输出配平方误差会制造平台和非凸性(§3.4)。输出层激活函数和损失函数要配对:sigmoid 配交叉熵,softmax 配多分类交叉熵,线性输出配平方误差。
- “loss 和 cost 是一回事。” loss 是一个样本的,cost 是所有样本的平均。代码里打印的、梯度下降最小化的都是 cost。
- “学习率越大训练越快。” 超过 后代价会不降反升(§4.2–4.3)。逻辑回归在可分数据上碰巧能恢复,深度网络通常不能。
- “凸函数一定有最低点。” 在线性可分的数据上,交叉熵没有有限的最低点, 会一直变大(§4.4)。这是需要正则化的原因之一(第 6 讲)。
- “反向传播是一种特殊的、只属于神经网络的算法。” 它就是链式法则加上”倒着算、复用中间结果”。任何能画成计算图的计算都能这样求导(§5.4)。
- “用数值差分训练也可以。” 可以,但每个参数要多算两遍前向,参数一多就慢得不可接受。差分只用来验证(§5.2;第 7 讲)。
- “向量化只是为了代码好看。” 它决定速度:同样的计算,Python 两重循环比矩阵乘法慢约 4000 倍(§7.4)。
- “不报错就说明形状对了。”
reshape(-1, m)(§1.3)、X.mean(axis=0)(§8.3)、第 1 讲的 (4,) − (4, 1),都不报错,都给出错误的结果。 - “所有网络都可以像逻辑回归一样用 0 初始化。” 只有一个单元时可以;有隐藏层时会出现对称性问题(§9.4;第 3 讲)。
12. 练习 · Exercises
练习 1(手算一次前向和反向)。,,,标签 。(a) 算 、、。(b) 算 、、。(c) 如果标签是 ,损失和 变成多少?(d) 用 对 (b) 的情况更新一步, 会变大还是变小?为什么这是对的?
参考答案
(a) ;; 时 。
(b) ;;。
(c) ,。
(d) 变成 , 变成 ,新的 ,变小了。标签是 0,我们希望 变小,也就是 变小,所以方向是对的。这一步走得很大( 从 0.4 一下到 −3.19),因为 而 也不小,§4.2 的”学习率 × 曲率”在这里也适用。
练习 2(计算图)。,,,。(a) 画出计算图(,,),算出前向的值。(b) 从右往左,算出 dv、du、dc、da、db。(c) 用”推 0.001”的方法验证 da。
参考答案
(a) ,,。
(b) ;;;;。
(c) 时 ,,,。(用双边差分会得到 12.000。)
练习 3(推导 dz)。(a) 从 出发,证明 。(b) 证明交叉熵配 sigmoid 时 。(c) 如果损失换成 , 是什么?、 时两者各是多少?
参考答案
(a)、(b) 见 §6.1 的推导。
(c) 。、 时:交叉熵 ;平方误差 ,小约 100 倍(代码 01 演示 2 的表里正是 −0.990 和 −0.009801)。
练习 4(凸性)。只有一个参数 ()时,。(a) 证明 ,所以 是凸的。(b) 这个二阶导数在 很大时会怎样?它和 §4.3 里”实际曲率随训练下降”有什么关系?
参考答案
(a) (§6.2)。再对 求导, 是常数,,所以二阶导数是 。每一项都是非负数乘平方,总和 ≥ 0。
(b) 很大时,大多数样本的 很大, 接近 0 或 1,,曲率变小,曲线变得接近直线(代码 01 的图里交叉熵两侧近似直线)。多维的情况完全一样:训练越久,sigmoid 越饱和,Hessian 越小,所以 §4.3 里实际最大曲率从 43.36 降到 14.49,允许的学习率越来越大。
练习 5(广播)。先预测下面每个表达式结果的形状(或是否报错),再运行验证:(a) np.ones((4, 1)) * np.ones((1, 3));(b) np.ones((2, 3, 4)) + np.ones((4,));(c) np.ones((2, 3, 4)) + np.ones((2, 1));(d) np.ones((2, 3, 4)) + np.ones((3, 1))。(e) “Python Basics with Numpy” 作业里有一个函数 normalize_rows(x):把矩阵 的每一行除以这一行的长度(L2 范数)。用 np.linalg.norm 和广播写出来,并说明 keepdims=True 为什么必不可少。
参考答案
(a) (4, 1) 和 (1, 3) → (4, 3),“外积”式表格。 (b) (4,) 补成 (1, 1, 4) → (2, 3, 4)。 (c) (2, 1) 补成 (1, 2, 1),和 (2, 3, 4) 的中间一维比较:3 ≠ 2 → 报错。注意:(2, 1) 的 “2” 对齐的是倒数第二维,不是第一维。 (d) (3, 1) 补成 (1, 3, 1) → (2, 3, 4)。
(e) x / np.linalg.norm(x, axis=1, keepdims=True)。norm(..., axis=1) 对每一行求长度。keepdims=True 时结果是 的列向量,除法时被广播到每一列,每一行除以自己的长度。没有 keepdims 时得到 ,会被当作 ,变成按列去除: ≠ 列数时报错, 恰好等于列数时悄悄算错(§8.3 同样的陷阱)。
练习 6(学习率与曲率)。(a) ,临界学习率是多少?哪个学习率能一步到位?(b) 如果图像不除以 255,§4.3 的 大约会变成原来的多少倍?临界学习率变成多少?(c) 先预测:不除以 255、仍然用 lr = 0.05 训练 2000 步,会发生什么?再改代码验证。
参考答案
(a) 曲率 ,临界学习率 。 时一步到位:。
(b) 像素部分放大 255 倍, 的像素部分放大 倍(偏置那一行不变,所以是”约”)。我把 04_train_on_images.py 的 curvature_bound 用在 X * 255 上,得到 ,是原来的约 64665 倍,临界学习率约 。
(c) lr = 0.05 是新临界值的约七万倍,代价一开始就会冲到上限附近(裁剪后约 14),然后剧烈震荡。我运行的结果:最大代价 14.01;因为训练集可分(§4.3),2000 步后训练准确率 1.000、测试准确率 0.946,比 lr = 0.05 配归一化数据的 0.958 差。把学习率降到 (新的临界值附近),测试准确率是 0.956。所以不归一化,合适的学习率会差好几个数量级,这是第 7 讲”输入归一化”的动机之一。具体数字以你运行的结果为准。
练习 7(先预测再运行:训练更久)。把 04_train_on_images.py 的 NUM_ITERATIONS 从 2000 改成 10000(只看演示 3 的输出即可)。先预测:训练代价、训练准确率、测试准确率分别会怎样变化?模板的外围区会变得更”干净”还是更”嘈杂”?
参考答案
我运行的结果:训练代价从 0.1316 降到 0.0529,训练准确率从 0.984 升到 0.994,测试准确率从 0.958 升到 0.962。训练集是可分的,代价会随训练一直下降, 一直变大(§4.4)。测试准确率只涨了一点,训练和测试的差距没有消失。外围区的权重会随 一起变大:模型对背景噪声”记”得更牢了。这些权重对测试集没有帮助,这正是第 6 讲 L2 正则化和早停要处理的问题。具体数字以你运行的结果为准。
练习 8(估算向量化的价值)。Coursera 作业的猫图是 64×64×3(),,训练 2000 步。用 §7.4 的计时(两重循环每步约 206 ms,处理 768 × 1000 个”像素 × 样本”)估算:两重循环版大约要训练多久?向量化版呢?
参考答案
两重循环的时间大致和”特征数 × 样本数”成正比。猫图是 ,是我们的 的约 3.3 倍,所以每步约 0.69 秒,2000 步约 23 分钟。向量化版每步约 毫秒(小矩阵时计时不完全按比例,只是数量级),2000 步不到 1 秒。这只是一个最小的模型。深度网络的计算量是它的成千上万倍,不向量化(以及不用 GPU)根本无法训练。你的电脑上的数字会不同。
练习 9(神经网络思维)。(a) 第 3 讲的网络 layer_dims = [768, 4, 1] 里, 的形状是什么?它的第 2 行和本讲的 有什么关系?(b) 为什么本讲可以把 初始化成 0,而第 3 讲不行?用”如果所有隐藏单元一开始一样,梯度会怎样”来回答。
参考答案
(a) 。每一行是一个隐藏单元的 :第 2 个隐藏单元计算 ,就是一个独立的”小逻辑回归”(只是激活函数可能换成 ReLU 或 tanh),它的输出再交给下一层。
(b) 逻辑回归只有一个单元,代价是凸的,从 0 出发也能走到最低点(§9.4:全 0 和随机起点的结果几乎相同)。有隐藏层时,如果 全为 0,所有隐藏单元的输出相同。反向传播时它们收到的梯度也相同(每个单元在输出层的权重也相同),更新后仍然相同。不管训练多久,4 个隐藏单元都是同一个单元的 4 份拷贝,等于只有 1 个隐藏单元。随机初始化打破了这种对称性。第 3 讲会用实验演示。
13. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C1M2 “Neural Networks Basics”(Andrew Ng):本讲的全部技术内容,包括选修视频 “Explanation of Logistic Regression Cost Function”。
- Stanford CS229 Lecture Notes(Andrew Ng、Tengyu Ma)第 2 章 “Classification and logistic regression”,以及广义线性模型一章:逻辑回归的概率解释,以及为什么”预测 − 标签”的梯度形式不是巧合。
- Stanford CS231n 课程笔记 “Backpropagation, Intuitions”(Andrej Karpathy):计算图和”门”的直觉,适合与 §5 对照阅读。
- Christopher Olah (2015). Calculus on Computational Graphs: Backpropagation.(colah’s blog):为什么反向模式求导比正向模式高效。
- NumPy 官方文档 “Broadcasting”:广播规则的权威说明,含图示。
教材
- Goodfellow, Bengio & Courville (2016). Deep Learning. 第 4.3 节(基于梯度的优化);第 6.2.2.2 节(sigmoid 输出单元与最大似然:为什么配平方误差会饱和);第 6.5 节(反向传播与计算图)。
- Bishop (2006). Pattern Recognition and Machine Learning. 第 4.3.2 节 Logistic regression。
论文
- Rumelhart, Hinton & Williams (1986). Learning representations by back-propagating errors. Nature 323:让反向传播流行起来的论文。
- Auer, Herbster & Warmuth (1996). Exponentially many local minima for single neurons. NIPS 8:sigmoid 配平方误差可以有指数多个局部极小值(§3.4)。
- Baydin, Pearlmutter, Radul & Siskind (2018). Automatic differentiation in machine learning: a survey. JMLR:反向传播在自动微分里的位置。
- Soudry, Hoffer, Nacson, Gunasekar & Srebro (2018). The implicit bias of gradient descent on separable data. JMLR:可分数据上 的方向收敛到最大间隔方向(§4.4)。
- Wu, Bartlett, Telgarsky & Yu (2024). Large stepsize gradient descent for logistic loss: Non-monotonicity of the loss improves optimization efficiency. COLT:大学习率下逻辑回归的代价先不单调、后收敛(§4.3)。
14. 下一讲预告 · Next lecture
第 3 讲:浅层神经网络——隐藏层、激活函数与反向传播。 本讲的模型只能画一个超平面,只能匹配一个固定位置的模板。第 3 讲在输入和输出之间加一层隐藏单元:
- 每个隐藏单元都是一个”小逻辑回归”(§9.4),输出层把它们组合起来,于是能画出弯曲的决策边界;
- 隐藏层用什么激活函数?sigmoid、tanh、ReLU、Leaky ReLU 各有什么优缺点?为什么必须有非线性?
- 反向传播多走一层:。推导用的还是 §5 的计算图和链式法则;
- 为什么不能把 初始化成 0(练习 9 的答案会在实验里出现)。
到第 3 讲结束时,tiny_nn.py 里带一个隐藏层的那部分你也能逐行写出来。