对应 Maps to:Stanford CS230 Fall 2025 Lecture 1(9/23:class introduction、examples of deep learning projects、course details);Autumn 2018 Lecture 1 “Class Introduction & Logistics”(Andrew Ng、Kian Katanforoosh,YouTube 公开录像);Coursera Deep Learning Specialization C1M1 “Introduction to Deep Learning”(What is a Neural Network?、Supervised Learning with Neural Networks、Why is Deep Learning taking off?、About this Course)。 依据说明:Fall 2025 的课堂 slides 和录像只对选课学生开放。本讲的课堂部分依据 2018 年的公开录像、Fall 2025 syllabus 上的主题和 Andrew Ng 的公开演讲;技术部分依据 C1M1 的内容;历史与前沿部分依据原始论文(见 §11)。 配套代码 Code:
code/lecture01/(numpy;4 个脚本 + 2 个共享模块;最慢的03_why_scale.py约 45 秒,其余几秒) 预计阅读时间:2.5–3 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 用自己的话说清楚一个神经元做了什么(线性函数 + 非线性”折一下”),以及把神经元叠成网络为什么能表示复杂得多的函数;知道”隐藏层自动学出中间特征”是什么意思,以及这句话在什么程度上是对的。
- 把任何一个监督学习应用写成 的形式,说出 和 是什么形状的数组;区分结构化数据和非结构化数据,知道它们各自对应哪类网络架构。
- 熟练使用全课的记号约定: 个样本按列堆成 ,上标 表示样本、 表示层;知道 rank-1 数组和广播(broadcasting)这两个”不报错只给错数字”的陷阱。
- 解释为什么深度学习在 2010 年代才起飞:数据、算力、算法三个驱动力分别起了什么作用;能读懂 Andrew Ng 的”规模”那张图,包括它的左半边(小数据时谁好谁坏不确定)。
- 说出一个深度学习项目的组成要素(数据、输入输出、架构、损失、优化、评估),以及训练循环的四步:前向 → 损失 → 反向 → 更新。
- 了解 CS230 的结构(翻转课堂 + 课程项目)和本讲义 21 讲的路线图;知道在”基础模型”时代,这门课的哪些内容依然是核心。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉,后面几讲再展开 Previewed only |
|---|---|
| 高中数学:函数、导数的含义(“斜率”) | 逻辑回归、损失函数、梯度下降的推导(第 2 讲) |
| 一点线性代数:向量、矩阵乘法 | 反向传播的完整推导(第 2–4 讲) |
| 一点概率:概率、平均值 | 激活函数的比较与选择(第 3 讲) |
| Python 基础(变量、函数、循环);numpy 不会也没关系,代码里有解释 | 初始化、正则化、优化算法(第 6–8 讲) |
| CNN、RNN、Transformer(第 12–17 讲) |
本讲是总论。它的任务是让你看清”深度学习到底在做什么”以及”为什么是现在”。所有公式本讲只给出形状,推导留给第 2–4 讲。配套代码里的 tiny_nn.py 是一个完整的小型神经网络库,本讲把它当作黑盒,第 2–8 讲会一块一块拆开它。
0.3 本讲地图 Map
§1  为什么学深度学习:AI 是新的电力;AI / ML / DL 的关系;三起两落的历史
§2  什么是神经网络:从一个 ReLU 神经元到一个网络;隐藏层学到了什么        ← 代码 01
§3  用神经网络做监督学习:x → y;结构化 vs 非结构化;数据就是数组;记号    ← 代码 02
§4  为什么现在起飞:规模那张图;三个驱动力;迭代循环;scaling laws          ← 代码 03、04
§5  一个深度学习项目由什么组成;CS230 的课程项目
§6  基础模型时代:变了什么,没变什么
§7  CS230 的结构与本讲义地图
§8–12  小结、常见误区、练习、延伸阅读、下一讲预告
0.4 记号 Notation(全课统一)
CS230 和 Deep Learning Specialization 用的是 Andrew Ng 的一套记号。它和一些教材、和 PyTorch 的习惯不完全一样,所以第一讲就把它定下来:
| 符号 | 含义 | 例子 |
|---|---|---|
| 训练样本的个数(number of examples) | 2000 套房子 | |
| 每个样本的输入特征个数(input size) | 房价例子里 ;64×64 的彩色图片 | |
| 第 个样本的输入,一个列向量 | 圆括号上标 = 第几个样本 | |
| 第 个样本的标签 | 价格、0/1、类别编号 | |
| 把 个样本按列叠起来 | X.shape == (n_x, m) | |
| 标签按列叠起来 | Y.shape == (1, m) | |
| 方括号上标 = 第几层 | 是第 2 层的权重 | |
| 第 层的单元(神经元)个数; | ||
| , | 第 层的权重矩阵和偏置向量 | |
| , | 第 层的线性部分和激活值; | 是激活函数(ReLU、sigmoid……) |
| 网络的输出(预测), 是层数 | ||
| ; | 单个样本的损失(loss);所有样本的平均损失(cost) | |
| 学习率(learning rate) |
“数层数”的约定:输入层不算一层。 这样的网络(5 个输入、16 个隐藏单元、1 个输出)叫做两层网络(一个隐藏层 + 一个输出层)。本讲义的代码里用 layer_dims = [n_x, n^{[1]}, ..., n^{[L]}] 这样的列表描述网络结构。
0.5 关于这门课 · Which CS230?
CS230 是翻转课堂(flipped classroom):技术内容在 Coursera 上的 Deep Learning Specialization(C1–C5 五门课、16 个模块)里自学,课堂讲座讲直觉、案例、项目方法论和前沿话题,另外还有 TA 带的 section 和一个占成绩 45% 的课程项目。只看课堂讲座会缺掉大部分技术细节;只看 Coursera 又会缺掉”怎么把深度学习用起来”。所以这份讲义把两条线合成了一门 21 讲、按技术难度递进的课程(§7、SYLLABUS.md)。
0.6 关于数字 · About the numbers
讲义里所有实验数字都来自配套代码的实际输出(固定随机种子,同一台机器上重复运行逐字相同;只有代码 04 演示 1 的计时每次不同)。数据是合成的,“真相”由我们写下的公式决定(dl_data.py),所以我们能检查网络到底学到了什么。数字只说明机制,不代表任何真实的房价或真实的任务。有几处实验结果和我写代码前的预想不一样,讲义按实际结果来写,这些情况列在代码 README 的”关于实验结果”里。
1. 为什么学深度学习 · Why deep learning?
1.1 “AI is the new electricity”
Andrew Ng 在很多场合用过一个比喻:AI 是新的电力。 大约一百年前,电力改变了几乎每一个行业——交通、制造、农业、医疗、通讯。今天很难想象有哪个行业,不会在未来若干年里被 AI 改变。
这个比喻有两层意思,值得想清楚:
- 通用技术(general-purpose technology):电力不是某一个产品,而是一种”什么都能用上”的基础能力。AI,特别是深度学习,也是这样——同一套方法(用梯度下降训练一个大网络)被用在图像、语音、语言、推荐、科学、医疗上。
- 价值主要来自”把它用起来”:电力的价值不在发电机本身,而在于无数个把它用到具体问题上的应用。Ng 一直强调,过去十多年 AI 创造的经济价值,绝大部分来自监督学习(supervised learning)——给定输入 ,预测输出 ——被用到一个个具体的业务问题上(§3)。CS230 的定位因此也很明确:不只教你”网络怎么工作”,更要教你”怎样把一个深度学习项目做成”。
1.2 AI、机器学习、深度学习是什么关系
┌──────────────────────────────────────────────────────────────┐
│  人工智能 Artificial Intelligence:让机器表现出"智能"的一切方法 │
│  ┌────────────────────────────────────────────────────────┐  │
│  │  机器学习 Machine Learning:从数据中学习规律,而不是人写规则 │  │
│  │  ┌──────────────────────────────────────────────────┐  │  │
│  │  │  深度学习 Deep Learning:用多层神经网络,            │  │  │
│  │  │  从原始数据中**自动学出特征**                       │  │  │
│  │  │  ┌────────────────────────────────────────────┐  │  │  │
│  │  │  │  生成式 AI、大语言模型(LLM)……              │  │  │  │
│  │  │  └────────────────────────────────────────────┘  │  │  │
│  │  └──────────────────────────────────────────────────┘  │  │
│  └────────────────────────────────────────────────────────┘  │
└──────────────────────────────────────────────────────────────┘- 传统编程:人写规则(“如果邮件里有’中奖’两个字,就是垃圾邮件”)。
- 传统机器学习:人设计特征(“‘中奖’出现的次数""发件人是否在通讯录里”),算法从数据里学这些特征的权重。逻辑回归、SVM、决策树都属于这一类。效果好坏很大程度上取决于特征设计得好不好。
- 深度学习:直接把原始数据(像素、声波、字符)交给一个很多层的神经网络,网络自己学出有用的特征。“深”指的是层数多;每一层在前一层的基础上构造更抽象的特征(第 4 讲:边缘 → 部件 → 物体)。
“自动学出特征”是深度学习和传统机器学习最本质的区别,也叫表示学习(representation learning)。§2.3 和代码 01 会在一个小例子里亲眼看到它。
1.3 一部简短的历史:想法很老,规模很新
神经网络不是新东西。它经历了”三起两落”:
| 年份 | 事件 | 当时缺什么 / 带来了什么 |
|---|---|---|
| 1943 | McCulloch & Pitts 提出人工神经元的数学模型 | 只是逻辑电路,不会”学” |
| 1958 | Rosenblatt 的感知机(perceptron):第一个能从数据中学习的神经元 | 第一次热潮 |
| 1969 | Minsky & Papert 的书 Perceptrons 证明单层感知机连 XOR 都表示不了 | 没有训练多层网络的办法 → 第一次寒冬 |
| 1986 | Rumelhart、Hinton、Williams 推广反向传播(backpropagation),多层网络可以训练了 | 第二次热潮 |
| 1989 | LeCun 用卷积网络识别手写邮编(后来的 LeNet) | 第一个大规模实用的深度网络 |
| 1990s | SVM、核方法、随机森林在多数任务上更好用;神经网络难训练、数据少、算力弱 | 第二次寒冬(“神经网络”一度成了不受欢迎的词) |
| 1997 | Hochreiter & Schmidhuber 提出 LSTM | 为序列建模打下基础(第 15 讲) |
| 2006 | Hinton 等人用逐层预训练训练深层网络,“deep learning”这个名字开始流行 | 重新点燃兴趣 |
| 2009 | ImageNet 数据集(Fei-Fei Li 等,千万级标注图片);Raina、Madhavan、Ng 用 GPU 训练大规模网络,速度提升可达约 70 倍 | 数据和算力就位 |
| 2012 | AlexNet 在 ImageNet 比赛中 top-5 错误率 15.3%,第二名 26.2% | 深度学习”起飞”的标志性时刻 |
| 2014–15 | GAN;seq2seq 与注意力机制;ResNet(152 层,ImageNet top-5 错误率 3.6%) | 生成模型、机器翻译、极深网络 |
| 2016 | AlphaGo 击败李世石 | 深度强化学习(第 19 讲) |
| 2017 | Transformer(“Attention Is All You Need”) | 后来几乎所有大模型的基础(第 17 讲) |
| 2018–20 | BERT、GPT 系列;GPT-3(1750 亿参数);scaling laws 的系统研究 | 预训练 + 规模 |
| 2022 | ChatGPT;扩散模型生成图像(Stable Diffusion 等) | 生成式 AI 进入大众视野 |
| 2023–25 | 多模态大模型;“推理模型”(推理时用更多计算);AI agents | 前沿(第 20 讲) |
几个注脚:2018 年的图灵奖授予了 Bengio、Hinton、LeCun 三人,表彰他们对深度学习的奠基性贡献;2024 年诺贝尔物理学奖授予 Hopfield 和 Hinton(神经网络的物理与统计基础),化学奖的一半授予 DeepMind 的 Hassabis 和 Jumper(用深度学习预测蛋白质结构的 AlphaFold)。
这张表最重要的一个观察:今天深度学习的核心想法——多层网络、反向传播、卷积、LSTM——在 1990 年代末之前几乎都已经有了。那为什么要到 2012 年才起飞?答案是:缺的不是想法,而是规模——足够多的数据、足够快的计算,以及几个让大网络”训得动”的算法小改进。这是 §4 的主题,也是理解整个深度学习领域最关键的一把钥匙。
1.4 今天深度学习在哪里
- 视觉:手机相册里的人脸分组、医学影像辅助诊断、工业质检、自动驾驶的感知系统;
- 语音:语音识别、语音合成、“Hey Siri / OK Google”这样的唤醒词检测(第 5、11 讲会用它做案例);
- 语言:机器翻译、搜索、对话助手、代码生成;
- 推荐与广告:你看到的视频、商品、新闻,背后几乎都有深度学习模型在排序;
- 科学:蛋白质结构预测、天气预报、材料发现;
- 生成:图像、音乐、视频、文本的生成。
这些应用看起来五花八门,但它们的核心都可以写成同一种形式:学一个函数,把输入 映射成输出 。下面先从最简单的函数说起。
2. 什么是神经网络 · What is a neural network?
2.1 从一条直线开始:一个神经元
Andrew Ng 讲神经网络用的第一个例子是房价预测。假设你只知道房子的面积,想预测它的价格。
最简单的想法:画一条直线,。这就是线性回归。但直线有一个问题:它会一路往下延伸,对很小的房子预测出负的价格——而价格不可能是负的。Ng 的处理是把直线在 0 处”折”一下:价格先贴着 0,过了某个面积再往上涨。这个”先平后升”的函数形状叫做 ReLU(Rectified Linear Unit,整流线性单元):
一个神经元(neuron)就是这样一个东西:
输入 (面积),输出 (预测的价格)。参数是 和 ,从数据里学出来。
代码 01 演示 1 生成了这样一个世界:真实规律是 (单位 $k,面积 m²),再加上噪声。用 200 套房子训练:
| 学到的函数 | 测试集均方误差 | |
|---|---|---|
| 直线(线性回归) | 478.9 | |
| 一个 ReLU 神经元 | 369.9 | |
| 真实规律(误差下限) | 362.0 |
| 面积 m² | 真实规律 | 直线 | ReLU 神经元 |
|---|---|---|---|
| 12 | 0.0 | −33.8 | 0.0 |
| 20 | 0.0 | −11.1 | 0.0 |
| 30 | 0.0 | 17.3 | 7.7 |
| 80 | 150.0 | 159.4 | 154.3 |
| 195 | 495.0 | 486.3 | 491.4 |
直线为了同时照顾小房子和大房子,斜率被拉平、截距被压成负数,于是对小房子预测出负价格,对中等面积系统性高估。ReLU 神经元的”折”几乎完美地恢复了真实规律,它的测试误差(369.9)和”用真实规律去预测”的误差(362.0)几乎一样——剩下的误差是数据本身的随机性(同样面积的房子卖价不同),任何模型都消不掉。这个”误差下限”的概念在第 10 讲会以 Bayes error 的名字再次出现。
这个神经元是怎么”学”出 和 的? 代码 01 里只用了几行,但这几行就是整门课的核心循环:
- 前向传播(forward):用当前的 算出预测 ;
- 算损失(loss):,衡量预测错了多少;
- 反向传播(backward):用链式法则算出 、——” 往哪边调一点, 会变小”;
- 更新(update):,。
重复几百次。演示 1 里损失从 4.19 降到 0.035,前 50 步就降到了底。从这个神经元到 ChatGPT,所有神经网络的训练都是这四步的放大版:参数从 2 个变成几千亿个,数据从 200 条变成几万亿个 token,但循环本身没有变。第 2 讲会把第 3 步(梯度怎么算)仔细推导一遍。
为什么非要”折一下”? 你可能觉得这只是为了”价格不能为负”这个小细节。其实它是整个深度学习的关键:§2.4 会看到,如果每个神经元都只做线性运算,那么叠多少层都只等于一层线性函数。非线性激活函数让叠层有了意义。
2.2 把神经元叠起来:一个网络
真实的房价不只取决于面积。Ng 的第二张图是这样的:
  输入 x(能观测到)                 中间因素(看不见)              输出 y
  size(面积)         ─┐
  bedrooms(卧室数)   ─┴──→  family size(能住几口人)    ─┐
  zip code(位置)     ─────→  walkability(步行便利度)    ─┼──→  price(价格)
zip code + wealth ─────→ school quality(学区质量) ─┘每个”中间因素”可以看成一个小神经元,它看一部分输入,算出一个有意义的量;价格再由这几个中间量决定。把很多神经元这样叠起来,就是一个神经网络。
但实际的神经网络和这张图有一个关键区别:我们不告诉网络中间那一层代表什么。实际的网络是”全连接”的(densely connected)——每个输入连到每一个隐藏单元,由网络自己在训练中决定每个隐藏单元该算什么。写成公式,一个有一个隐藏层的网络(“两层网络”)是:
其中 是 5 维输入, 是 的矩阵( 个隐藏单元,每个对 5 个输入各有一个权重), 是隐藏层的输出(“中间特征”), 是 的矩阵,把中间特征组合成价格。参数总数是 。
代码 01 演示 2 把 Ng 的这张图变成了一个可以运行的世界(dl_data.make_housing):5 个输入是面积、卧室数、位置坐标 (代替邮编)、街区财富;价格由三个看不见的因素决定,其中 walkability 是到市中心距离的”山峰形”函数(市中心最高,往四周衰减),school quality 是财富的 S 形函数。网络只看得到 5 个输入和价格,看不到中间因素。
| 模型 | 参数个数 | 训练 R² | 测试 R² |
|---|---|---|---|
| 线性回归(没有隐藏层) | 6 | 0.872 | 0.858 |
| 网络 [5, 2, 1] | 15 | 0.872 | 0.858 |
| 网络 [5, 4, 1] | 29 | 0.958 | 0.953 |
| 网络 [5, 16, 1] | 113 | 0.978 | 0.972 |
| 网络 [5, 64, 1] | 449 | 0.987 | 0.979 |
| 上限:没有噪声的真实价格 | — | 0.985 |
(R² 衡量”预测解释了价格变化的多少”:1 是完美预测,0 相当于永远猜平均值。)
几个值得停下来想的地方:
- 线性回归已经不差(0.858),因为价格里有两项本来就几乎是输入的线性函数。它漏掉的主要是 walkability:任何线性组合 都只能表示一个”斜坡”,表示不了”中间高、四周低”的山峰。
- 加隐藏单元,R² 一路逼近上限:4 个单元 0.953,16 个 0.972,64 个 0.979。均方根误差从线性回归的 30.8 k(噪声本身是 10 $k)。收益递减:从 16 到 64,参数多了 4 倍,R² 只涨 0.007。64 个单元的训练 R²(0.987)甚至超过了上限 0.985——这意味着它开始拟合噪声了,这就是过拟合的苗头(第 6 讲)。
- 意外的一行:[5, 2, 1] 和线性回归一模一样。 我原以为 2 个隐藏单元就够超过线性回归。代码”放大看”了这个网络:两个 ReLU 单元分别在 99.3% 和 99.2% 的样本上处于激活状态()。而 ReLU 在 时就是恒等函数——折点落在了数据范围之外,网络退化成了线性模型。换 4 个初始化种子重新训练,测试 R² 分别是 0.901、0.897、0.901、0.901。
最后这一条是一个很有价值的真实教训:非常小的网络对初始化很敏感,可能卡在很差的解上。单元多一些时,“总有一些单元的折点落在有用的地方”,结果就稳定得多。这是实践中”宁可网络大一点、再用正则化控制过拟合”的原因之一(第 6 讲)。
2.3 隐藏层学到了什么?
我们从来没有告诉网络”步行便利度”是什么。那它到底学到了什么?代码 01 演示 3 用一个叫线性探针(linear probe)的工具来回答:拿一组特征(比如隐藏层的 16 个输出),用线性回归去预测某个看不见的因素,看能预测得多准(R²)。如果 R² 高,说明这组特征里”已经算好了”这个因素——后面的层只需要做一个线性组合就能用上它。
| 看不见的因素 | 从原始 5 个输入读 | 从训练前的隐藏层读 | 从训练后的隐藏层读 | 最像它的单个隐藏单元 |corr| |
|---|---|---|---|---|
| family_size | 1.000 | 0.993 | 0.982 | 0.894 |
| walkability | −0.003 | 0.403 | 0.827 | 0.274 |
| school_quality | 0.944 | 0.936 | 0.983 | 0.936 |
这张表值得逐行读:
- walkability 从原始输入里完全读不出来(R² ≈ 0),因为它是”山峰形”的;但从训练后的隐藏层里能读出八成以上(0.827)。网络为了预测价格,自己算出了一个”离市中心有多近”的中间特征——这正是 Ng 那张图想表达的意思。
- 对照组:训练前的同一个隐藏层(随机权重)也能读出 0.403。随机的 ReLU 特征本身就是非线性的,已经能粗略地”拼”出山峰形。所以准确的说法是:非线性让学出这类特征成为可能,训练让它变得有用(0.40 → 0.83)。做实验时永远要有对照组,否则你会把”随机特征就能做到的事”归功于训练。
- family_size 本来就是输入的线性函数,从原始输入读是 1.000,从隐藏层读反而略低(0.982)。网络只需要保留”对预测价格有用”的信息,没有义务把每个因素都原样保存。
- 最后一列:没有哪一个隐藏单元单独等于 walkability(最大相关系数只有 0.274)。网络把这个概念分散地存放在很多单元的组合里,这叫分布式表示(distributed representation)。“一个神经元 = 一个概念”是讲课时的简化图像,真实网络很少这么整齐。
这个小实验是整个深度学习的缩影:深度学习的威力在于自动学出好的中间表示。在图像上,第一层学出边缘检测器,后面几层学出纹理、部件、物体(第 4、12、21 讲);在语言上,网络学出词的含义、语法关系、甚至一些”事实”(第 16、17 讲)。线性探针也是研究”网络内部发生了什么”的标准工具之一(第 21 讲)。
2.4 为什么必须有非线性
假设我们去掉激活函数,每一层都只做线性变换:
两层线性变换合起来还是一个线性变换。叠 100 层也一样。也就是说,没有非线性,“深度”毫无意义——网络的表达能力和一个线性回归完全相同。ReLU 那个看似不起眼的”折”,是让多层网络能表示复杂函数的关键。第 3 讲会比较各种激活函数(sigmoid、tanh、ReLU、Leaky ReLU),并解释为什么现代网络的隐藏层几乎都用 ReLU 一族。
2.5 一个隐藏层就够了吗?
有一个著名的定理叫万能近似定理(universal approximation theorem,Cybenko 1989、Hornik 1991):只要隐藏单元足够多,一个隐藏层的网络就能以任意精度近似任何”好”的连续函数。那为什么还要”深”?
因为这个定理只说了”存在”,没说三件更重要的事:
- 需要多少个单元:有些函数用浅网络表示需要指数多个单元,而用深网络只需要很少(第 4 讲会用 parity 函数做实验);
- 梯度下降能不能找到这组参数:存在 ≠ 找得到(演示 2 的 [5, 2, 1] 就是一个”找不到”的小例子);
- 从有限的数据能不能学到:存在 ≠ 泛化得好。
实践中,深而窄的网络往往比浅而宽的网络用更少的参数、更少的数据学得更好,因为现实世界的函数大多有层次结构(像素 → 边缘 → 部件 → 物体;字母 → 词 → 短语 → 句子),而深网络的结构恰好匹配这种层次。这是第 4 讲”Why deep representations?”的主题。
2.6 神经网络和大脑有多像?
“神经网络”这个名字来自生物神经元的类比:神经元接收来自其他神经元的信号,加权求和,超过阈值就”激发”。早期的研究者确实是受大脑启发的。
但 Andrew Ng 在课上明确提醒,这个类比很松散。今天的人工神经网络和大脑的相似之处,大概也就停留在”很多简单单元连在一起”这个层面。一个真实的生物神经元本身就是一个复杂的系统,大脑怎样学习至今也没有完全搞清楚(它几乎肯定不是用反向传播)。把神经网络理解成”一个很灵活的、由简单运算拼成的、可以用梯度下降调参数的函数”,比理解成”模拟大脑”更准确,也更有用。第 4 讲末尾会再回到这个话题。
3. 用神经网络做监督学习 · Supervised learning with neural networks
3.1 x → y:六个经典例子
Ng 在 C1M1 里列了一张表,代码 02 演示 1 把每个例子的 、 做成了真正的数组,打印出它们的形状:
| 应用 | 输入 | 的形状 | 输出 | 典型架构 |
|---|---|---|---|---|
| 房价预测 | 房屋特征 | (5,) | 价格(实数) | Standard NN |
| 在线广告 | 广告 + 用户特征 | (20,) | 是否点击(0/1) | Standard NN |
| 图像识别 | 64×64 RGB 照片 | (64, 64, 3) | 类别编号(0–999) | CNN |
| 语音识别 | 1 秒录音 @16 kHz | (16000,) | 文字(token 序列) | RNN / Transformer |
| 机器翻译 | 英文句子(token 编号) | (9,),长度可变 | 中文句子(token 编号) | Transformer |
| 自动驾驶 | 摄像头图像 + 雷达 | (128, 256, 3) + … | 其他车辆的位置 | Custom / Hybrid |
(Ng 的原表里机器翻译用的是 RNN;2017 年以后的主流是 Transformer。)
六个看起来毫不相干的应用,在网络眼里是同一件事:学一个函数 ,把数组 映射成数组 。训练数据是很多个 对,网络要学会”看到 就给出 “。这就是监督学习——“监督”指的是每个训练样本都带着正确答案。
做一个深度学习应用,第一个、也往往是最重要的决定就是:你的 是什么, 是什么? 这听起来简单,实际上大有讲究——输入用多大的分辨率?输出是一个类别还是一个框?标签由谁来标、怎么标?第 5 讲会用一整讲的案例来练习这个”问题定义”的功夫。
3.2 结构化数据 vs 非结构化数据
- 结构化数据(structured data):每一列有明确含义(“面积""年龄""点击次数”),通常存在数据库的表格里。广告、推荐、金融风控的大部分数据都是这样的。
- 非结构化数据(unstructured data):图像的像素、音频的采样点、文本的字符。单个数字几乎没有含义——第 (17, 42) 个像素的红色分量是 183,这说明不了什么——含义藏在大量数字的组合里。
人类天生擅长理解非结构化数据(看一眼就知道照片里有只猫),计算机过去非常不擅长。深度学习最大的突破正是在非结构化数据上:它让计算机第一次能比较好地”看懂”图像、“听懂”语音、“读懂”文字。这也是媒体报道里深度学习最常出现的场景。
不过 Ng 也指出:深度学习在结构化数据上同样创造了巨大的经济价值(广告点击率预测、推荐系统),只是这些应用不那么”上镜”。(公平地说,在中小规模的表格数据上,梯度提升树这类传统方法至今仍然常常和神经网络不相上下,甚至更好;这和 §4.3 讲的”小数据区间”是同一个道理。)
3.3 不同的数据,不同的架构
为什么图像用 CNN、序列用 RNN / Transformer?因为好的架构把我们对数据的先验知识写进了网络的形状:
- 图像有局部性(相邻像素相关)和平移不变性(猫在左上角还是右下角都是猫)→ 卷积:一个小的特征检测器在整张图上滑动,参数共享(第 12 讲);
- 序列有顺序,长度可变,前后有依赖 → 循环网络按顺序处理、共享参数(第 15 讲);注意力机制让任意两个位置直接交互(第 16、17 讲);
- 固定长度的特征向量没有这些结构 → 标准的全连接网络(第 2–4 讲)。
这种”写进架构里的假设”叫做归纳偏置(inductive bias)。归纳偏置对了,网络用更少的数据就能学会;错了,就会白白浪费数据和参数。§4 会看到,数据越多,归纳偏置的重要性越小——这也是为什么在超大规模的数据上,通用性很强的 Transformer 几乎统一了所有模态。
3.4 数据就是数组
神经网络只认识数字。代码 02 演示 2 把一张图片拆开来看:
- 一张 8×8 的灰度图是一个 8×8 的整数矩阵,0 是黑、255 是白。你一眼看出”笑脸”,计算机看到的只是 64 个数字;“眼睛”不是任何一个数字,而是数字之间的空间关系。
- 一张彩色图有三个通道(红、绿、蓝),形状是 (高, 宽, 3)。64×64 的彩色照片有 64 × 64 × 3 = 12,288 个数。
- 全连接网络要求输入是一个向量,所以要把图片拉平(flatten):
image.reshape(-1, 1)得到一个 (12288, 1) 的列向量。拉平不改变任何数字,可以完全恢复;但它丢掉了”哪些像素是邻居”的信息——这是 CNN 要解决的问题。 - 喂给网络前,像素通常除以 255 缩放到 [0, 1],因为网络更喜欢尺度在 1 左右的输入(第 7 讲)。
把 个样本叠成矩阵(代码 02 演示 3)。Ng 的约定是每一列一个样本:
这样约定的好处是:单个样本的公式 和所有样本一起算的公式 长得一模一样,只是小写换成了大写。代码 02 验证了”逐样本循环算 再拼起来”和”一次矩阵乘法 “的结果完全相同——后者快得多(§4.4)。 是 的列向量,加到 的矩阵上时,numpy 会自动把它复制到每一列,这叫广播(broadcasting)。
注意:scikit-learn、PyTorch、pandas 的习惯正好相反——每一行一个样本,形状 ,公式写成 。两种约定只差一个转置。本讲义第 1–8 讲的 numpy 代码用 Ng 的约定,第 9 讲换成 PyTorch 时切换。
3.5 两个不报错的形状陷阱
代码 02 演示 4 展示了初学者调试深度学习代码时最常踩的两个坑。它们的共同点是:程序不报错,只给出错误的数字。
- rank-1 数组:
a = np.random.randn(5)的形状是(5,)——既不是行向量也不是列向量。对它转置没有任何作用(a.T.shape仍是(5,)),a @ a.T得到的是一个数(内积)而不是 5×5 的矩阵。Ng 在课上的建议:不要用 rank-1 数组,一律写成(5, 1)或(1, 5)。 - 悄悄发生的广播:如果
y_pred的形状是(4,)、y_true是(4, 1),那么y_pred - y_true的形状是(4, 4)——每个预测减去了每个标签。用它算的均方误差是 0.2750,正确值是 0.0750。没有任何报错。
为什么这类 bug 在深度学习里格外危险?因为网络”总能学到点什么”。损失函数算错了,训练照样能跑,损失照样会下降,只是学到的东西不对——你可能很久都发现不了。防御办法很朴素:写下每个变量应该的形状,在关键位置 assert 检查。本讲义代码的注释里到处是”形状 “,就是这个原因。
3.6 监督学习之外:生成式 AI 也是 x → y 吗?
你可能会问:ChatGPT 这样的生成式模型,好像不是”给定 预测 ”?
其实在训练层面,它们也是。大语言模型的预训练任务是预测下一个 token: = 前面的文字, = 下一个 token。标签不需要人来标——它就是文本本身的下一个词。这叫自监督学习(self-supervised learning):监督学习的形式,只是标签从数据本身自动构造出来。因为不需要人工标注,它可以用上互联网规模的文本,这正是”规模”能发挥作用的前提(§4)。扩散模型(第 18 讲)的训练任务是”给一张加了噪声的图,预测噪声”,也是 。
所以 Ng 那句话在生成式 AI 时代依然成立:学会把问题写成 ,并且为它准备好数据,是深度学习最核心的手艺。 当然,生成式模型也带来了新的用法——你可以不训练任何模型,直接用提示词(prompt)让一个预训练好的大模型完成任务(第 20 讲)。§6 会讨论这对 CS230 意味着什么。
4. 为什么深度学习现在才起飞 · Why is deep learning taking off now?
4.1 规模那张图
回到 §1.3 的问题:想法在 1990 年代就有了,为什么要到 2012 年才起飞?Andrew Ng 用一张图回答(C1M1 “Why is Deep Learning taking off?”):
 性能 ↑                                            ______ 大网络
      |                                  ____----
      |                          ___----        ______ 中网络
      |                    __---         ____---
      |               _--      _____----            ______ 小网络
      |           _-     ___---              ______
      |        _-   __---          ______----            ______ 传统算法
      |      /  _--    ______------                            (SVM、逻辑回归……)
      |    / /____-----
      +--------------------------------------------------→ 有标签的数据量 m
       ↑ 小数据区间:排序不确定
这张图讲了三件事:
- 传统算法会饱和:数据多到一定程度后,逻辑回归、SVM 这类方法的性能就不再上升。不是数据不够,而是模型本身的表达能力到头了。
- 网络越大,饱和得越晚:更大的网络能从更多数据里榨出更多的性能。要达到最高的性能,需要同时有一个大网络和大量的数据。
- 小数据区间里谁好谁坏不确定:在图的最左边,各种方法挤在一起,排名取决于具体问题、取决于谁的手工特征做得好。
于是答案是:过去 20 年,社会的数字化让我们有了海量的数据(横轴往右走了很远),GPU 让我们能训练很大的网络(能用上更高的那条曲线)——两者叠加,深度学习就从”图的左边”走到了”图的右边”,在那里它把传统方法远远甩在了后面。
注意横轴是有标签的数据量。Ng 用 表示训练样本数,这里的”规模”同时指数据的规模( 大)和网络的规模(参数多)。
4.2 亲手画一遍这张图
Ng 的图是一张示意图,不是某个具体实验的结果。代码 03 在一个合成任务上真的跑了一遍:
- 任务:
dl_data.py的”老师网络”分类任务。一个随机初始化的网络(10 维输入 → 64 → 64 → 1,tanh)充当”老师”,标签 = 老师的输出是否大于中位数。这个决策边界很复杂,但没有标签噪声——理论上存在 100% 正确的分类器。 - 五个模型:逻辑回归 [10, 1];逻辑回归 + 专家特征(专家知道老师第一层 64 个中间特征中的 32 个);小网络 [10, 4, 1];中网络 [10, 32, 1];大网络 [10, 128, 128, 1](参数个数分别为 11、43、49、385、18,049)。
- 数据量:100 到 100,000,每个数据量重复 3 次取平均,在独立的 20,000 个样本上测试。
结果(测试准确率):
| n | 逻辑回归 | 逻辑回归 + 专家特征 | 小网络 | 中网络 | 大网络 |
|---|---|---|---|---|---|
| 100 | 0.794 | 0.779 | 0.779 | 0.771 | 0.775 |
| 300 | 0.824 | 0.834 | 0.810 | 0.811 | 0.800 |
| 1,000 | 0.832 | 0.855 | 0.825 | 0.826 | 0.840 |
| 3,000 | 0.833 | 0.862 | 0.833 | 0.839 | 0.857 |
| 10,000 | 0.834 | 0.865 | 0.837 | 0.849 | 0.876 |
| 30,000 | 0.834 | 0.869 | 0.839 | 0.868 | 0.895 |
| 100,000 | 0.834 | 0.870 | 0.843 | 0.887 | 0.909 |
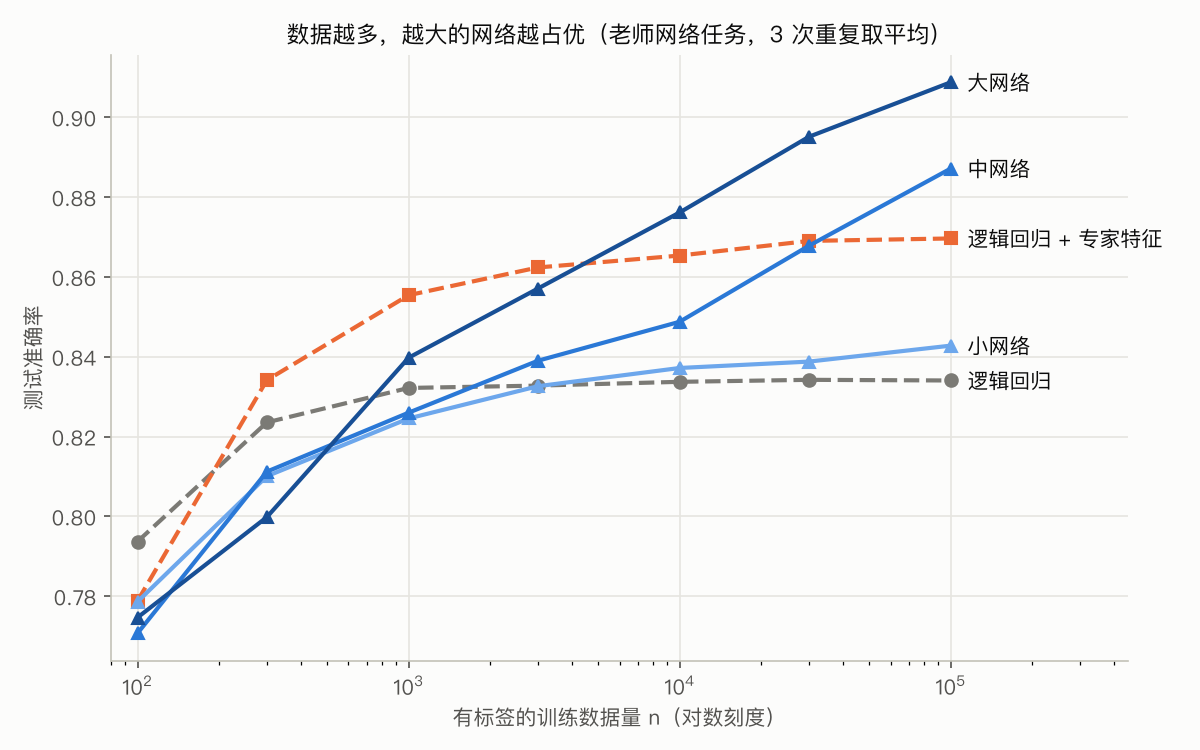
(这张图由 03_why_scale.py 生成;如果你没装 matplotlib,脚本只打印表格。)
右半边复现了 Ng 的图:
- 逻辑回归从 起就饱和在 0.834。之后数据多了 100 倍,它一动不动——它只能画一个超平面,表达能力是瓶颈。
- 网络越大,饱和得越晚:小网络(4 个隐藏单元)在 0.84 附近爬得很慢;中网络到 100,000 时 0.887;大网络 0.909,而且两者都还在上升。
- 大模型 + 大数据,缺一不可:小模型给再多数据也会饱和;大模型在数据少时并不占优(下一节)。
4.3 左半边:小数据区间
图的左半边同样重要,而且常常被忽略:
- 时,最好的是最简单的逻辑回归(0.794),大网络和中网络垫底。五个模型之间的差距(约 0.02)和同一个模型重复 3 次之间的波动(最多约 0.03)一样大——在这个区间,“哪个模型更好”本身就没有稳定的答案。
- 到 3,000,“逻辑回归 + 专家特征”一直第一。它不需要从数据里学那 32 个中间特征,专家已经免费给了它。这就是 Ng 说的:在小数据区间,性能更多取决于手工设计特征的功力。
- 但专家特征也会饱和(0.870):专家只知道一半的中间特征,也不知道它们怎样组合。 时大网络超过了它, 时中网络也超过了它。网络从数据里自己学出的特征,最终胜过了专家手工给的特征。
这几行数字把过去十几年计算机视觉、语音识别、自然语言处理里发生的事压缩进了一个玩具任务:在数据少的年代,研究者花大量精力设计特征(图像的 SIFT、HOG,语音的 MFCC),配上 SVM 之类的模型;当数据和算力足够时,端到端训练的深度网络超过了所有手工设计的流水线。
对你做项目的启示:如果你只有几百个有标签的样本,不要指望”换一个更大的网络”能解决问题。这时更有用的是:领域知识和特征设计、利用在别的大数据集上预训练好的模型(迁移学习,第 10、13 讲)、想办法获取更多数据,或者把问题改写成数据更容易获得的形式(第 5 讲)。
诚实的说明:这是一个对神经网络”友好”的玩具任务——老师本身就是一个网络,没有标签噪声;专家特征的个数(32)也是我先在草稿里试了几组值、为了让”小数据时专家领先、大数据时大网络领先”都落在 100–100,000 的范围里而选的。真实任务的曲线形状类似,但具体数字、交叉点在哪儿都因任务而异。
4.4 三个驱动力:数据、算力、算法
Ng 把深度学习起飞归结为三个驱动力。
① 数据(data)。社会的数字化——互联网、智能手机、传感器、电子病历——产生了前所未有的数据量。ImageNet(2009)把有标注的图片做到了千万级。代码 03 里,从 到 ,大网络的准确率从 0.840 涨到 0.909,而逻辑回归一点没涨:数据的价值取决于你有没有一个能消化它的模型。
② 算力(computation)。代码 04 演示 1 比较了同一个计算的不同写法(计时数字因电脑而异,下面是我运行的一次):
| 计算 | Python 循环 | numpy 向量化 | 倍数 |
|---|---|---|---|
| 两个长度 100 万的向量做点积 | 17.7 ms | 0.05 ms(np.dot) | 约 340 倍 |
| 一层前向传播 (128 万次乘加) | 28.3 ms(三重循环) | 0.01 ms(W @ X) | 约 4000 倍 |
numpy 把整个运算交给用 C 和汇编写的、针对 CPU 优化过的线性代数库,一次处理一批数,还能用上多个 CPU 核心;Python 循环则要为每一次乘法做类型检查、创建对象。这就是第 2 讲要专门讲向量化(vectorization)的原因:深度学习代码里几乎不应该出现”对样本的 for 循环”。
GPU 把同样的思路推得更远:几千个简单的计算核心同时做乘加,而神经网络的计算恰好几乎全是矩阵乘法。2009 年 Raina、Madhavan、Ng 报告用 GPU 训练大规模网络能快约 70 倍;2012 年的 AlexNet 在两块游戏显卡(GTX 580)上训练了五六天。此后的十几年,专用硬件(数据中心 GPU、TPU)又把可用的算力提高了好几个数量级。
③ 算法(algorithms)。很多算法改进的作用不是”让模型更聪明”,而是让大网络训得动、训得快。最简单、影响最大的例子之一,是把激活函数从 sigmoid 换成 ReLU。
代码 04 演示 2 在一个有 5 个隐藏层的网络里,看刚初始化时每一层权重梯度的大小:
| 激活函数 | 第 1 层 | 第 2 层 | 第 3 层 | 第 4 层 | 第 5 层 | 输出层 | 第 1 层 / 输出层 |
|---|---|---|---|---|---|---|---|
| sigmoid | 3.5e−4 | 3.0e−3 | 1.1e−2 | 4.8e−2 | 1.9e−1 | 6.7e−1 | 5.3e−4 |
| ReLU | 1.7e−1 | 4.5e−1 | 8.0e−1 | 1.1 | 1.6 | 1.8 | 9.4e−2 |
反向传播时,梯度从输出层往输入层传,每穿过一层就要乘一次激活函数的导数。sigmoid 的导数最大只有 0.25(在 处),通常更小,所以梯度每往前一层就被”打几折”:这里每层缩小 3.5–9 倍,传到第 1 层时只剩输出层的约 1/2000。这叫梯度消失(vanishing gradients)。ReLU 在激活区的导数恰好是 1,梯度不被打折;ReLU 网络各层的梯度也有差别(第 1 层约为输出层的 1/10),但比 sigmoid 温和两个数量级。
梯度消失的后果是什么?代码 04 演示 3 用最朴素的 SGD 训练,记录”多少步能达到 80% 的验证准确率”(”——“表示 4000 步内没达到,括号里是 4000 步后的测试准确率):
| 网络 | lr = 0.03 | lr = 0.1 | lr = 0.3 | lr = 1.0 | lr = 3.0 |
|---|---|---|---|---|---|
| 1 层隐藏层 + sigmoid | 300(0.835) | 100(0.840) | 100(0.866) | 100(0.881) | 100(0.877) |
| 1 层隐藏层 + ReLU | 200(0.839) | 100(0.849) | 100(0.861) | 100(0.847) | 100(0.865) |
| 5 层隐藏层 + sigmoid | ——(0.499) | ——(0.499) | ——(0.500) | 3400(0.842) | 1100(0.879) |
| 5 层隐藏层 + ReLU | 200(0.848) | 100(0.856) | 100(0.852) | 100(0.858) | 发散 |
- 浅网里两者差别不大:梯度只穿过一层,“打折”还不严重。
- 深网 + sigmoid:学习率 0.03–0.3 时,4000 步后准确率仍是 0.50(= 瞎猜),网络卡在”什么都没学会”的平台上。学习率加大到 1 和 3 时才能冲出平台,但要 1100–3400 步。
- 深网 + ReLU:学习率从 0.03 到 1 都只要 100–200 步。学习率 3 时发散(步子太大,数值溢出)。
结论要说得准确:sigmoid 深网不是不能训练——它一旦冲出平台,最终准确率并不差(lr = 3 时 0.879)。问题在于启动慢得多,而且只在很窄的学习率范围内能训练。后者在实践中更要命:你得花大量时间试学习率,而每次尝试都要等很久。ReLU 让深网对超参数”宽容”得多。(AlexNet 的论文里也报告过类似的观察:在 CIFAR-10 上,用 ReLU 的网络达到同样训练误差的速度是用 tanh 的约 6 倍。)
ReLU 只是其中一个。He / Xavier 初始化(第 7 讲)、Adam(第 8 讲)、Batch Normalization(第 9 讲)、残差连接(第 13 讲)、注意力与 Transformer(第 16–17 讲)……这些算法改进的共同作用是:让更大、更深的网络能够被稳定、快速地训练,从而把数据和算力真正转化成性能。
4.5 迭代循环:为什么”快”本身就是一种能力
Ng 特别强调算力和算法对研究节奏的影响。做深度学习是一个高度经验化的过程:
        ┌──────────→  Idea(想法)  ──────────┐
        │                                     ↓
   Experiment(实验)  ←──────────  Code(实现)
        │
└─→ 看结果,形成新的想法,再来一轮你很少能事先知道哪种架构、哪个学习率、哪种数据处理最好,只能试。一个实验 10 分钟出结果,你一天能试几十个想法;要等一天,你一个月只能试二三十个;要等一个月,一年只能试十几个。在我的电脑上,代码 04 的换算是:一个用矩阵运算要跑 10 分钟的实验,用三重 Python 循环要跑约 27 天。
所以”算得快”不只是省时间,它直接决定了你能多快地学到东西、多快地改进模型。这也是 CS230 后半部分(第 10、11 讲)反复强调的:提高迭代速度——用小数据集先调通、先做一个简单的 baseline、用合适的评估指标快速判断好坏——是做好深度学习项目最重要的习惯之一。
4.6 从”规模”到 scaling laws
Ng 的图是定性的。2020 年前后,研究者开始在大语言模型上定量地测量这条曲线,发现了被称为 scaling laws 的规律(Kaplan et al., 2020):在很大的范围内,模型的测试损失随参数量 、数据量 、计算量 的增加,近似按幂律(power law)下降:
在对数坐标里是一条直线,没有明显的饱和点。这条规律给了业界一个可以预测的”配方”:要更好的模型,就按比例加大模型、数据和计算。后来的研究(Hoffmann et al., 2022,“Chinchilla”)进一步发现,给定计算预算时,模型参数量和训练数据量应该大致同比例增加——此前的很多大模型”参数太多、数据太少”;按他们的估计,计算最优时每个参数大约对应 20 个训练 token。
Rich Sutton 2019 年的短文 The Bitter Lesson 把这段历史总结成一句很”苦”的话:AI 研究 70 年的最大教训是,能够随算力扩展的通用方法(搜索和学习),最终总会胜过依赖人类知识精心设计的方法。代码 03 里”专家特征”被大网络超过,就是这个教训的一个缩影。
但也要看到另一面:
- 幂律意味着收益递减:损失每降低一点,需要的计算量成倍增加;
- 高质量的数据并不是无限的,“数据墙”是当前的热门话题;
- 2024–2025 年出现的”推理模型”把一部分规模从训练时转到了推理时(让模型”想得更久”);
- 对绝大多数实际项目(包括 CS230 的课程项目),你没有无限的数据和算力。§4.3 讲的小数据区间的智慧——问题定义、数据质量、迁移学习、误差分析——才是日常工作中最有用的。
5. 一个深度学习项目由什么组成 · Anatomy of a deep learning project
5.1 五个要素(加一个评估)
把前面的内容合起来,一个深度学习项目有这几个要素:
| 要素 | 要回答的问题 | 本讲的例子 | 详细讲解 |
|---|---|---|---|
| 数据 Data | 有多少?从哪里来?标签怎么得到?质量如何? | 2000 套房子;100–100,000 个样本 | 第 5、10、11 讲 |
| 输入 / 输出 Input / Output | 是什么、什么形状? 是什么? | 5 个特征 → 价格 | 第 5 讲 |
| 架构 Architecture | 多少层、多宽、什么激活函数、什么类型的层? | [5, 16, 1],ReLU | 第 3–4、12–17 讲 |
| 损失函数 Loss | 怎样衡量”错了多少”? | 均方误差;交叉熵 | 第 2、5 讲 |
| 优化 Optimization | 怎样找到让损失最小的参数? | Adam / SGD,学习率 | 第 2、7–9 讲 |
| 评估 Evaluation | 在没见过的数据上表现如何?怎样知道下一步该改什么? | 测试集 R²、准确率 | 第 6、10 讲 |
一个有用的说法是:模型 = 架构 + 参数。架构是你设计的”形状”([5, 16, 1]、用 ReLU);参数是训练学出来的数( 里的 113 个数)。训练就是在给定的数据和损失函数下,寻找让损失最小的参数:
用的方法就是 §2.1 那四步:前向、损失、反向、更新,即梯度下降 。
5.2 Kian 的”五问”(预告)
CS230 的另一位讲师 Kian Katanforoosh 在课堂上用一系列案例来练习”设计一个深度学习方案”,每个案例都问同一组问题:数据是什么?输入是什么?输出是什么?用什么架构?损失函数是什么? 比如:
- 判断一张照片是白天还是黑夜,输入图片需要多大的分辨率?(太大浪费算力,太小信息不够;可以用”人类在这个分辨率下还能不能分辨”来估计。)
- 做”Hey Siri”这样的唤醒词检测,标签怎么标?正样本太少怎么办?
- 人脸验证为什么不能当成普通的分类问题来做?
这些问题没有公式可以套,靠的是对数据和任务的理解。第 5 讲会用一整讲来练习。
5.3 CS230 的课程项目
课程项目是 CS230 最重要的部分(占成绩的 45%)。Fall 2025 的时间线大致是:第 4 周交项目提案(proposal),第 8 周交中期报告(milestone),学期末交最终报告并参加海报展示(poster session)。项目可以是:
- 应用型:把深度学习用到你感兴趣的领域(医疗、科学、艺术、金融、体育、教育……);
- 算法型:改进某个模型或训练方法;
- 理论 / 分析型:研究网络的某种行为。
往届项目覆盖视觉、语言、语音、医疗、科学、游戏与强化学习、生成式艺术等各个方向。选题时最实际的建议是:先确认你能拿到数据。很多项目失败不是因为模型不好,而是因为数据拿不到、太少或者质量太差。第 11 讲会完整地走一遍”从想法到部署”的流程,包括怎样快速做出一个 baseline、怎样调试一个不收敛的网络。
6. 基础模型时代:变了什么,没变什么 · Deep learning in the era of foundation models
2022 年以后,深度学习的使用方式发生了明显变化。CS230 的课程也随之加入了”增强 LLM 应用”这样的内容(Fall 2025 Lecture 8,本讲义第 20 讲)。学这门课之前,值得想清楚哪些东西变了、哪些没变。
6.1 变了什么
- “先预训练、再适配”成为主流:很多应用不再从零训练模型,而是拿一个在海量数据上预训练好的基础模型(foundation model),通过提示词(prompting)、检索增强(RAG)、微调(fine-tuning)等方式适配到具体任务。
- 原型开发快了很多:过去需要收集数据、训练模型几周才能做出的原型,现在可能用几个提示词就能做出来;AI 编程助手也让写代码本身快了很多。Andrew Ng 近两年在公开演讲中反复强调 agentic workflows(让模型分步骤地规划、使用工具、自我检查)的潜力。
- 规模的门槛变高了:训练最前沿的基础模型需要的算力和数据,只有少数机构负担得起。
6.2 没变什么
- 基础模型本身就是深度网络,用的就是这门课讲的东西:反向传播、Adam、残差连接、LayerNorm、注意力、交叉熵损失、大规模数据。不懂这些,你就只能把它当黑盒用。
- 问题定义、数据和评估依然是核心:用基础模型做应用,你仍然要回答” 和 是什么”、“怎样衡量好坏”、“错在哪里、下一步改什么”。第 10 讲的误差分析方法几乎原封不动地适用于 LLM 应用(第 20 讲)。
- 迭代循环依然是核心:Idea → Code → Experiment,只是”Code”那一步有时变成了”写提示词”。
- 很多任务仍然需要训练自己的模型:数据是私有的、延迟要求高、成本敏感、需要在设备上运行……这些场景比比皆是。
6.3 为什么还要从零手写神经网络?
既然有 PyTorch,甚至有能帮你写代码的大模型,为什么第 1–8 讲还要用 numpy 从零实现?
因为理解是调试的前提。举一个写本讲代码时真实遇到的例子:tiny_nn.py 的训练函数原本靠 numpy 的浮点异常机制检测”训练发散”。在代码 04 演示 3 里,ReLU 深网在学习率 3 下数值溢出,但溢出发生在矩阵乘法的底层库(BLAS)内部,numpy 没有报异常——训练”安静地”带着 nan(not a number)跑完了 4000 步,准确率停在 0.50。表面上看,这和”sigmoid 网络卡在平台上”一模一样!如果不知道 nan 和任何数比较都是 False、不知道准确率 0.50 意味着什么,很可能会得出”ReLU 在大学习率下学不会”这样的错误结论。(修复办法是每一步显式检查输出是否有限,见代码 README。)
深度学习里大量的 bug 都是这种”不报错、只给出看似合理的错误结果”的类型:形状广播(§3.5)、数据泄露、训练集和测试集用了不同的预处理、标签错位……能发现它们的,只有真正理解每一步在做什么的人。这就是 CS230 和 Deep Learning Specialization 坚持”先从零实现,再用框架”的原因。
7. CS230 的结构与本讲义地图 · Course structure & map
7.1 原课的结构
| 组成部分 | 内容 | Fall 2025 成绩占比 |
|---|---|---|
| Coursera 模块(C1–C5) | 视频 + 测验 + 编程作业:神经网络基础、改进深度网络、构建 ML 项目、CNN、序列模型 | 编程作业 12%,测验 8%(按完成度给分) |
| 课堂讲座(每周一次) | 直觉、案例、项目方法论、前沿话题、职业建议 | — |
| TA sections | 反向传播、初始化与正则化、PyTorch、调试、评估指标、写报告 | — |
| 期中考试 | 笔试 | 35% |
| 课程项目 | 提案、中期报告、最终报告、海报展示 | 45% |
7.2 本讲义的 21 讲
Part I   神经网络与深度学习      1 导论 → 2 逻辑回归 → 3 浅层网络 → 4 深层网络 → 5 深度学习直觉(案例)
Part II  改进深度神经网络        6 偏差/方差与正则化 → 7 归一化、初始化、梯度检验 → 8 优化算法 → 9 调参、BatchNorm、框架
Part III 构建机器学习项目        10 ML 策略与误差分析 → 11 项目全周期
Part IV  卷积神经网络            12 卷积基础 → 13 经典架构与迁移学习 → 14 检测、分割、人脸识别、风格迁移
Part V   序列模型                15 RNN / LSTM → 16 词嵌入与注意力 → 17 Transformer
Part VI  前沿专题                18 对抗样本与生成模型 → 19 深度强化学习 → 20 LLM 应用 → 21 可解释性与总结
本讲的 tiny_nn.py 是一个贯穿 Part I–II 的”黑盒”:第 2 讲拆开输出层(逻辑回归),第 3 讲拆开隐藏层和激活函数,第 4 讲拆开 L 层的前向 / 反向,第 6–8 讲拆开正则化、初始化和优化器。到第 9 讲换成 PyTorch 时,你会清楚地知道框架替你做了哪些事。每一讲的详细内容见 SYLLABUS.md。
7.3 怎样学
- 先读讲义,遇到”代码 0X 演示 Y”时去运行对应的脚本,看输出和”观察 Observations”。
- 再读代码:先看文件开头的说明和每个函数的文档字符串,再看实现。第一次读
tiny_nn.py时不必看懂每一行。 - 改代码:把隐藏单元数、学习率、数据量改一改,预测会发生什么,再运行验证。练习里有一些这样的题目。
- 做练习,先自己想,再展开参考答案。
8. 小结 · Summary
- 一个神经元 = 线性函数 + 非线性激活:。ReLU 的”折”让它能表示”先平后升”的关系(代码 01:直线预测出负价格,ReLU 神经元恢复了真实规律)。
- 训练的四步:前向 → 损失 → 反向(链式法则算梯度)→ 更新(梯度下降)。从一个神经元到 ChatGPT,循环本身没有变。
- 网络 = 把神经元叠起来,而且不告诉隐藏层代表什么。代码 01 中,walkability 从原始输入读不出(R² ≈ 0),从训练后的隐藏层能读出 0.83(训练前 0.40)——深度学习的本质是自动学出中间表示,而且这种表示往往是分布式的。
- 没有非线性,叠多少层都等于一层线性函数。万能近似定理说一个隐藏层”够用”,但没说需要多少单元、找不找得到、能不能泛化——这是”深”的理由。
- 监督学习就是学 ;结构化 vs 非结构化数据;架构要匹配数据的结构(归纳偏置)。生成式 AI 的训练(预测下一个 token)也是 的一种,标签来自数据本身。
- 数据就是数组:图片是 (高, 宽, 通道); 个样本按列堆成 ,。小心 rank-1 数组和悄悄发生的广播:(4,) − (4, 1) = (4, 4)。
- 为什么现在起飞:规模。传统算法会饱和,网络越大饱和越晚(代码 03:逻辑回归停在 0.834,大网络在 100,000 个样本时 0.909 且仍在上升);小数据区间排序不确定,特征工程和先验知识更重要。
- 三个驱动力:数据(数字化)、算力(向量化快几百到几千倍,GPU 再快一两个数量级)、算法(ReLU 等让深网训得动:sigmoid 深网第 1 层梯度只有输出层的 1/2000,只在窄学习率范围内能训练)。迭代速度本身就是竞争力。
- 基础模型时代,用法变了(预训练 + 适配),但问题定义、数据、评估、误差分析、调试这些核心能力没变,而且更重要了。
9. 常见误区 · Common pitfalls
- “神经网络就是模拟大脑。” 只是一个松散的类比。把它理解成”一个由简单运算拼成、可以用梯度下降调参数的灵活函数”更准确(§2.6)。
- “隐藏层的每个神经元对应一个人能理解的概念。” 通常不是。代码 01 里没有哪个单元单独等于 walkability(最大相关系数 0.274),概念是分散存储的(§2.3)。
- “网络越大越好。” 只在数据足够多时成立。数据少时,大网络可能还不如逻辑回归(代码 03,);而太小的网络又可能卡在很差的解上(代码 01,[5, 2, 1])。
- “深度学习不需要特征工程和领域知识。” 在大数据区间基本如此;在小数据区间,领域知识往往是决定性的(代码 03 的”专家特征”在 –3,000 时第一)。
- “有了数据就一定能提升性能。” 只有当模型有足够的容量去消化它时才成立。逻辑回归从 1,000 到 100,000 个样本一动不动(代码 03)。
- “sigmoid 深网训练不了。” 不准确。它启动慢、可用学习率范围窄,但在合适的学习率下能训练,最终准确率也不差(代码 04)。真正的问题是对超参数太敏感、迭代太慢。
- “没报错就说明代码对了。” 深度学习里最危险的 bug 恰恰不报错:形状广播(§3.5)、nan 悄悄传播(§6.3)。写下形状、加 assert、检查损失和准确率是否合理。
- “有了大模型,就不需要学这些基础了。” 基础模型本身就是用这些基础构建和训练的;用它做应用时,问题定义、评估和误差分析的能力更加重要(§6)。
10. 练习 · Exercises
练习 1(手算一个神经元的梯度)。一个 ReLU 神经元 ,损失 。三个样本 ,,当前参数 、。 (a) 算出 。(b) 算出 和 。(c) 用学习率 更新一步,新的 是多少?(d) 第一个样本对梯度有贡献吗?为什么?
参考答案
(a) ,,,。
(b) 。 ; 。
(c) ,。两个参数都变大了——预测偏低,所以要把直线往上抬、变陡。
(d) 没有。第一个样本 ,落在 ReLU 的”平”的区域,导数是 0,梯度传不过去。如果所有样本都落在这个区域,神经元就永远学不动了——这叫 dead ReLU(第 3 讲)。代码 01 的 train_single_relu_neuron 从 开始,正是为了避免这种情况。
练习 2(数参数)。Coursera 编程作业里有一个识别猫的网络:输入是 64×64 的 RGB 图片(拉平),结构是 layer_dims = [12288, 20, 7, 5, 1]。它有几层?一共有多少个参数?哪一层的参数最多?
参考答案
4 层(3 个隐藏层 + 1 个输出层;输入层不算)。
第 1 层:;第 2 层:;第 3 层:;第 4 层:。合计 245,973,其中 99.9% 在第 1 层。
这说明全连接网络处理图像的问题:输入维度太大,第一层的参数爆炸。可以用 tiny_nn.count_parameters([12288, 20, 7, 5, 1]) 验证。第 12 讲的卷积通过”局部连接 + 参数共享”解决这个问题。
练习 3(为什么要非线性)。(a) 证明:两个没有激活函数的线性层 等价于一个线性层。(b) 如果隐藏层用 ReLU,这个等价还成立吗?用一个一维的例子说明。
参考答案
(a) 展开得 ,令 、,就是一个线性层 。 (b) 不成立。一维例子:(两个隐藏单元,、,、)。 是 V 字形,任何直线 都表示不了。这正是代码 01 里网络能拼出 walkability(“山峰形”)、而线性回归不能的原因。
练习 4(形状)。不运行代码,说出下面每个表达式结果的形状(或者是否报错)。然后运行验证。
(a) np.zeros((3, 1)) + np.zeros((1, 4));(b) np.zeros(4) - np.zeros((1, 4));(c) np.zeros(4) - np.zeros((4, 1));(d) np.zeros((3, 4)) @ np.zeros(4);(e) np.zeros((3, 4)) + np.zeros((3,))。
参考答案
广播规则:从最后一个维度开始对齐,每个维度要么相等、要么其中一个是 1(会被复制),缺少的维度在前面补 1。
(a) (3, 1) 和 (1, 4) → (3, 4)。
(b) (4,) 被看作 (1, 4),和 (1, 4) 相减 → (1, 4)。结果是对的——rank-1 数组碰上行向量时恰好没事。
(c) (4,) 被看作 (1, 4),和 (4, 1) 广播 → (4, 4)。这就是代码 02 演示 4 的陷阱。
(d) 矩阵乘以 rank-1 数组 → (3,),又一个 rank-1 数组,后面的运算可能出问题。
(e) (3,) 被看作 (1, 3),和 (3, 4) 的最后一维 4 ≠ 3 → 报错。如果你本意是”每一行加一个数”,应该用 np.zeros((3, 1))。
(b) 和 (c) 对比说明:同样的 rank-1 数组,有时结果对、有时结果错,这正是 Ng 建议”干脆不要用 rank-1 数组”的原因。
练习 5(问题定义)。对下面每个应用,说出 和 是什么(形状、类型),属于结构化还是非结构化数据,你会选哪类架构:(a) 根据过去 30 天的每日用电量预测明天的用电量;(b) 根据胸部 X 光片判断是否有肺炎;(c) 根据用户的年龄、所在城市、历史购买次数预测是否会流失;(d) 把一段会议录音转成文字。
参考答案
(a) :30 个数(一个长度 30 的序列,或当作 30 维特征向量);:一个实数。可以看作结构化的时间序列。长度固定且不长时,全连接网络就能用;想利用时间顺序可以用 RNN / 一维卷积 / Transformer。 (b) :一张灰度图,比如 (224, 224, 1);:0/1。非结构化,用 CNN(实践中通常用在大数据集上预训练过的 CNN 做迁移学习,第 13 讲)。 (c) :几个表格特征(城市需要编码成数字,比如 one-hot);:0/1。结构化,标准全连接网络(或者梯度提升树作为强 baseline)。 (d) :音频采样序列(长度随录音时长变化);:token 序列(长度也可变)。非结构化,序列到序列的模型(RNN / Transformer,第 15–17 讲)。
练习 6(读规模那张表)。根据 §4.2 的表回答:(a) 如果你只有 500 个有标签的样本,你会选哪个模型?还有什么比”换模型”更有用的做法?(b) 如果你有 100,000 个样本,但老板只允许用逻辑回归,再收集 100 万个样本有用吗?(c) 为什么大网络在 时排最后,却在 时排第一?
参考答案
(a) 表里没有 ,但介于 300 和 1,000 之间,“逻辑回归 + 专家特征”都是第一,所以如果有领域知识,就用它把知识编码成特征。比换模型更有用的做法:利用预训练模型做迁移学习;收集或标注更多数据;数据增强(第 6 讲);重新定义问题让数据更容易获得(第 5 讲)。另外 很小时,结果的波动和模型之间的差距一样大,挑模型本身就不可靠。 (b) 几乎没用。逻辑回归从 起就饱和在 0.834,瓶颈是模型的表达能力而不是数据量。这种情况叫 high bias(偏差大),第 6 讲会讲怎样诊断:训练误差和测试误差都高、而且接近。 (c) 大网络有 18,049 个参数, 时只有 240 个训练样本,严重过拟合(记住了训练样本的噪声,泛化差)——这叫 high variance(方差大)。数据变多以后,过拟合的空间被压缩,大网络的表达能力开始发挥作用。第 6 讲会把这两种情况系统化。
练习 7(改代码,预测再验证)。把 03_why_scale.py 里的 EXPERT_K = 32 分别改成 64 和 8。先预测:“逻辑回归 + 专家特征”那条曲线会怎样变化?和大网络的交叉点会往哪边移?然后运行验证(用 --quick 只看左半边,或者完整运行)。
参考答案
预期趋势(具体数字以你运行的结果为准):
- :专家知道了老师第一层的全部中间特征,逻辑回归在这些特征上能表示的函数更接近真相,平台会更高,可能在整个 100–100,000 范围内都和大网络不相上下甚至更好,交叉点往右移甚至消失。但它仍然不知道第二层怎样组合,所以不会达到 100%。
- :专家知道得太少,平台会降低到接近普通逻辑回归,小数据时的领先优势也会缩小,交叉点往左移。 这个练习说明:“手工特征 vs 学出的特征”谁赢,取决于专家知道得有多全。现实中,在图像、语音这类任务上,专家知道的往往远不如数据能告诉网络的多。
练习 8(梯度消失的估算)。sigmoid 的导数 。(a) 证明 。(b) 如果只考虑激活函数的导数、忽略权重的影响,梯度穿过 5 个 sigmoid 隐藏层最多还剩多少?(c) 代码 04 实测第 1 层 / 输出层 ≈ 1/2000,为什么比 (b) 的估计还小?
参考答案
(a) 令 , 是开口向下的抛物线,在 (即 )时取最大值 。 (b) 每层最多乘 1/4,5 层最多剩 。 (c) 两个原因:一是大多数 并不恰好在 0 处, 通常比 1/4 小;二是梯度还要乘以权重矩阵 ,Xavier 初始化下它的尺度并不能弥补激活函数的衰减,而且 的大小还取决于该层输入 的大小(sigmoid 的输出都在 (0, 1) 之间、且都为正,这也有影响)。第 7 讲会推导初始化怎样让信号在前向和反向时都保持尺度。
练习 9(迭代速度)。假设你的项目还剩 4 周,每个实验要跑 12 小时,每次实验后你需要 1 小时分析结果、决定下一步。(a) 你最多能做多少轮”想法 → 实验”?(b) 如果你先在 10% 的数据上调通(每个实验 1.2 小时),这个数字变成多少?(c) 这样做有什么风险?
参考答案
(a) 4 周 × 7 天 × 24 小时 = 672 小时,每轮 13 小时,最多约 51 轮——这还假设你不睡觉、实验一个接一个无缝衔接。现实中可能只有 20–30 轮。 (b) 每轮 2.2 小时,最多约 305 轮,多了约 6 倍。 (c) 风险:小数据上的结论不一定能推广到全量数据(代码 03 显示,最优模型会随数据量变化!)。实践中的做法是:用小数据快速排除明显不行的想法、调通代码,再把少数有希望的方案放到全量数据上验证。另外,也可以用多台机器并行跑多个实验。这些都是第 10、11 讲的内容。
11. 延伸阅读 · Further reading
课程材料
- Coursera Deep Learning Specialization,C1M1 “Introduction to Deep Learning”(Andrew Ng)——本讲的技术部分。
- CS230 Autumn 2018 Lecture 1 “Class Introduction & Logistics”(YouTube,Stanford Online 频道)。
- Andrew Ng, Machine Learning Yearning(免费电子书)——第 10、11 讲”ML 策略”的前身,现在就可以开始读前几章。
综述与教材
- LeCun, Bengio & Hinton (2015). Deep learning. Nature 521. ——三位图灵奖得主写的综述,很适合作为第一篇读的论文。
- Goodfellow, Bengio & Courville (2016). Deep Learning. MIT Press,第 1 章(免费在线)。
历史上的关键论文
- Rosenblatt (1958). The perceptron: a probabilistic model for information storage and organization in the brain.
- Rumelhart, Hinton & Williams (1986). Learning representations by back-propagating errors. Nature.
- LeCun et al. (1989). Backpropagation applied to handwritten zip code recognition.
- Cybenko (1989). Approximation by superpositions of a sigmoidal function. ——万能近似定理。
- Raina, Madhavan & Ng (2009). Large-scale deep unsupervised learning using graphics processors. ICML.
- Deng et al. (2009). ImageNet: A large-scale hierarchical image database. CVPR.
- Glorot, Bordes & Bengio (2011). Deep sparse rectifier neural networks. AISTATS. ——ReLU 为什么好训练。
- Krizhevsky, Sutskever & Hinton (2012). ImageNet classification with deep convolutional neural networks. NeurIPS. ——AlexNet。
规模与 scaling laws
- Sutton (2019). The Bitter Lesson.(一页短文)
- Kaplan et al. (2020). Scaling laws for neural language models.
- Hoffmann et al. (2022). Training compute-optimal large language models. ——“Chinchilla”。
12. 下一讲预告 · Next lecture
第 2 讲:把逻辑回归看作神经网络——计算图、梯度下降与向量化。 我们从最小的神经网络开始:没有隐藏层,只有一个 sigmoid 输出单元,也就是逻辑回归。你会看到:
- 为什么二分类的输出要过 sigmoid,为什么损失函数用交叉熵而不是平方误差;
- 梯度下降的几何直觉,以及学习率太大、太小时会发生什么;
- 计算图和链式法则:反向传播就是在计算图上倒着走一遍——本讲 §2.1 那”四步”里的第 3 步会被完整推导;
- 向量化:从逐样本的 for 循环到 、 这样的矩阵公式,以及广播的规则。
到第 2 讲结束时,你会亲手实现 tiny_nn.py 里 layer_dims = [n_x, 1] 的那一部分,并且知道它每一行为什么这样写。