对应 Maps to:MIT 6.S184 的先修要求”熟悉 Python,用过一点 PyTorch”,以及原课三个 Lab 里反复出现的代码模式(
(batch, dim)的形状约定、nn.Module、Trainer.train训练循环、torch.func.vmap/jacrev求得分、在网格上画密度与向量场)。 依据说明:原课没有单独讲 PyTorch,Lab 默认你已经会。本讲按”这门课的代码真正会用到什么”组织:张量形状与广播、自动求导、训练循环、可复现性与批量化、画向量场。所有例子都是本讲义设计的;第 3 部分的”带噪声目标的回归”刻意做成第 2 讲流匹配训练的缩小版。 配套代码 Code:code/prereq2/(5 个脚本;PyTorch + matplotlib;每个脚本 1–6 秒) 建议阅读时间:第 2 讲之前(第 2 讲开始训练神经网络)。已经熟悉 PyTorch 的读者可以只看 §1.2(广播 bug)、§3.3(损失为什么不降)和 §5(怎样画向量场)。预计 2 小时。
0. 本讲导航 · How to read this lecture
0.1 学习目标
学完这一讲,你应该能够:
- 按”批量维度在前”的约定组织张量:样本
(n, d)、时间(n, 1);说出广播的规则,并识别”(n, 1)减(n,)变成(n, n)”这个不报错的严重 bug。 - 知道 float32 和 float64 的精度差别,以及什么时候该用哪个;理解切片、view 和原地修改的共享内存问题。
- 会用自动求导:
backward与梯度累加、zero_grad、no_grad、detach;会用”对总和求导”一次算出整批样本的梯度;会用三种方法算得分函数;知道散度的精确计算和 Hutchinson 估计。 - 写出标准的训练循环;理解在带噪声的目标上训练时,损失会停在一个正数上,而且损失值看不出模型是否在变好。
- 用独立的随机数流保证实验可复现;把逐样本的循环改写成批量运算。
- 在网格上计算一个向量场,并用箭头图、流线图把它和密度、轨迹画在一起。
0.2 本讲地图
§1  张量:形状约定、广播(及其陷阱)、精度、视图与原地修改     ← 代码 01
§2  自动求导:backward、逐样本梯度、得分函数、散度             ← 代码 02
§3  nn.Module 与训练循环:带噪声目标的回归                    ← 代码 03
§4  可复现性与速度:随机数流、单线程、批量化、no_grad          ← 代码 04
§5  画图:网格计算、箭头图、流线图                            ← 代码 05
§6  小结   §7  常见误区   §8  练习   §9  延伸阅读   §10 下一讲预告
1. 张量 · Tensors
1.1 形状约定:批量维度在前
这门课的代码(包括原课 Lab)遵守同一个约定:
| 对象 | 形状 | 说明 |
|---|---|---|
| 一批样本 | (n, d) | 个样本,每个 维 |
| 每个样本的时间 | (n, 1) | 训练时每个样本有自己的随机时间 |
| 网络的输入 | (n, d + 1) | torch.cat([x, t], dim=1) |
| 网络的输出(向量场) | (n, d) | 和 同形状 |
| 每个样本的对数密度、损失 | (n,) 或 (n, 1) | 要心里有数是哪一种 |
把时间写成 (n, 1) 而不是 (n,) 有一个具体的好处:计算 时,(n, 1) 和 (n, d) 相乘,会自动沿着 那一维复制,第 行乘以自己的 ,正是我们想要的(01 号脚本第 1 部分逐行核对,差为 0)。求和时加 keepdim=True 也是同一个道理:x.sum(dim=1) 是 (n,),x.sum(dim=1, keepdim=True) 是 (n, 1),后者再参与广播时不容易出错。
1.2 广播,以及它怎样悄悄出错
广播规则:两个张量做逐元素运算时,从最后一维往前对齐;每一维要么相等,要么其中一个是 1(会被复制);缺的维当作 1。
| 形状 A | 形状 B | A + B 的形状 |
|---|---|---|
| (3, 1) | (1, 4) | (3, 4) |
| (5, 2) | (2,) | (5, 2) |
| (5, 1) | (5,) | (5, 5) |
| (5, 2) | (5,) | 报错 |
第三行是这门课里最危险的 bug 之一。网络的输出习惯带一个尾维 (n, 1),而目标如果是从别处拿来的一维张量 (n,),那么 pred - target 会变成 (n, n) 的矩阵:它比较的是”每个预测 vs 每个目标”的所有 对。01 号脚本第 2 部分:真实噪声方差 0.01,正确的均方误差 0.0097,错误的写法却给出 1.9266(约等于两个独立标准高斯之差的方差 2)。不报错、能”训练”,只是学的东西完全不对。
防御办法:在关键位置写 assert pred.shape == target.shape(第 2 讲的训练循环就这么写);全程统一用 (n, 1) 或统一用 (n,);F.mse_loss 遇到形状不同时会发出警告,这个警告千万不要忽略。
1.3 float32 与 float64
| 类型 | 机器精度 eps | 大小 | 1 + 1e-8 == 1? |
|---|---|---|---|
| float32 | 1.19e−7 | 32 位 | True |
| float64 | 2.22e−16 | 64 位 | False |
float32 只有约 7 位有效数字。01 号脚本第 3 部分用欧拉法模拟 :10 万步时 float32 的舍入误差累积到 (float64 几乎没有)。训练神经网络用 float32 完全够(梯度本身就带噪声);但要”逐位比较两种算法是否相同”(比如第 1 讲比较欧拉–丸山和欧拉、P1 比较解析得分和自动求导),讲义的脚本都改用 float64,避免把舍入误差误认为算法差异。
1.4 视图与原地修改
切片 a[0] 和 view 不复制数据,与原张量共享同一块内存:改切片就改了原张量。.clone() 才真正复制一份。带下划线的方法(x.add_(1))是原地修改,会改动所有指向这块内存的变量;y = y + 1 则创建新张量。01 号脚本第 4 部分演示了这几种情况。
这就是为什么第 1 讲的模拟器写 x = x + h * u 而不是 x += h * u:不改动调用者传进来的初始噪声。记录轨迹时用 x.clone() 也是同一个原因。原地修改还可能破坏自动求导需要保存的中间值,初学时尽量不用。
📌 代码 01:
python3 01_tensors_and_broadcasting.py。
2. 自动求导 · Autograd
2.1 backward、梯度累加、no_grad、detach
w = torch.tensor([1.0, -2.0], requires_grad=True)   # 告诉 PyTorch:记录对 w 的所有运算
loss = (w * x).sum() ** 2
loss.backward()                                      # 沿计算图反向传播,把 ∂loss/∂w 加到 w.grad 上
02 号脚本第 1 部分:第一次 backward 后 w.grad = [12, 2](公式 ),不清零再来一次就变成 [24, 4]。backward() 把梯度加到 .grad 上,而不是覆盖,所以训练循环每一步都要先 optimizer.zero_grad()。(有时故意不清零,就是”梯度累积”,用来在内存不够时模拟大批量。)
torch.no_grad():块内的运算不记录计算图。生成样本(模拟 ODE / SDE)永远不需要梯度,第 1 讲的Simulator.simulate因此加了@torch.no_grad()。x.detach():返回一个”切断了计算图”的张量,把它当常数用。
2.2 一次算出整批样本各自的梯度
对一批独立样本 ,如果 只依赖 ,那么
所以对总和做一次反向传播,结果的第 行就是第 个样本自己的梯度(02 号脚本第 2 部分,与手推公式的差为 0)。第 1 讲 Density.score 就是这样写的。前提是样本之间没有”串话”:如果网络里有跨样本的运算(例如 BatchNorm),这个技巧就不成立。
2.3 得分函数的三种算法
02 号脚本第 3 部分在五峰分布的 1000 个点上比较了三种计算 的方法:
- 解析公式:按后验加权的”指向各中心的箭头”(
GaussianMixture.score)。最快,但要自己推导。 torch.autograd.grad(log_p(x).sum(), x):只要会写 就行。vmap(jacrev(f))(x):原课 Lab 1 的写法。jacrev对”单个样本”的函数求雅可比矩阵,vmap把它自动扩展到整批。它不依赖”对总和求导”的技巧,所以即使函数不是逐样本独立的也能用。
三者的最大差都是 。
2.4 散度:精确计算与 Hutchinson 估计
散度 是雅可比矩阵的迹(P1 §5.2)。对神经网络向量场:
- 精确计算:对每个坐标 做一次反向传播,取 的第 个分量,共 次。 时无所谓, 是图像的几万维时就太贵了。
- Hutchinson 估计:, 的各分量独立、均值 0、方差 1(如随机 ±1)。 只需一次反向传播(对 求导)。它是无偏的,但有噪声。
02 号脚本第 4 部分(随机初始化的小网络,200 个点):
| 维数 | 探针数 | Hutchinson 的平均绝对误差 | 散度 的平均 |
|---|---|---|---|
| 2 | 1 / 10 / 100 | 0.091 / 0.025 / 0.0066 | 0.049 |
| 32 | 1 / 10 / 100 | 0.706 / 0.237 / 0.071 | 0.145 |
误差约按 缩小,维数越高单个探针越吵。这正是”连续归一化流”计算精确似然时的难处(P1 §6.4)。流匹配训练时完全不需要散度,这门课只在验证理论(第 2 讲的连续性方程)时才算它。
📌 代码 02:
python3 02_autograd.py。
3. nn.Module 与训练循环 · Modules & the training loop
3.1 一个 nn.Module 里有什么
class TinyField(nn.Module):
    def __init__(self, dim=2, hidden=64):
        super().__init__()                                  # 必须先调用
        self.net = nn.Sequential(nn.Linear(dim + 1, hidden), nn.SiLU(),
                                 nn.Linear(hidden, hidden), nn.SiLU(),
                                 nn.Linear(hidden, dim))
        self.register_buffer("time_scale", torch.tensor(2.0))   # 不训练、但随模型保存的常数

    def forward(self, x, t):
return self.net(torch.cat([x, self.time_scale * t], dim=1))- 赋值给属性的子模块(
self.net)会被自动登记,它的参数出现在model.parameters()里,优化器据此更新。nn.Linear(a, b)有weight (b, a)和bias (b,)两个参数(03号脚本第 1 部分列出了全部 6 个参数张量,共 4,546 个参数)。 register_buffer登记一个不训练但要随模型一起保存、一起.to(设备)的张量(比如第 5 讲时间嵌入里的固定频率表)。state_dict()是”参数 + 缓冲区”的字典;保存 / 加载模型就是保存 / 加载它(03号脚本第 4 部分:保存、加载后输出逐位相同)。- 调用
model(x, t)会自动转到forward(x, t)(中间还会运行 PyTorch 的钩子,所以不要直接调用forward)。
3.2 训练循环的五个动作
for step in range(steps):
    x, t, target = sample_batch(batch, g)      # 1. 取一批数据
    pred = model(x, t)
    assert pred.shape == target.shape          #    (防止 §1.2 的广播 bug)
    loss = ((pred - target) ** 2).sum(dim=1).mean()   # 2. 前向,算损失
    opt.zero_grad()                            # 3. 清空旧梯度
    loss.backward()                            # 4. 反向传播
    opt.step()                                 # 5. 按梯度更新参数
原课 Lab 2 的 Trainer.train 就是这五行,只是把”取数据 + 算损失”封装进了 get_train_loss。
3.3 带噪声的目标:损失为什么”不降了”
03 号脚本第 2 部分刻意做了第 2 讲流匹配训练的缩小版:输入是 ,目标是一个随时间变化的向量场加上标准差 0.5 的噪声。网络学到的是目标的条件均值(P1 §4.2)。我们同时记录训练损失和”真实误差”(网络输出到真实条件均值的均方距离,训练时看不到):
| 步数 | 500 | 1000 | 1500 | 2000 | 2500 | 3000 |
|---|---|---|---|---|---|---|
| 训练损失 | 1.019 | 0.536 | 0.514 | 0.510 | 0.508 | 0.508 |
| 减去噪声地板 0.5 | +0.519 | +0.036 | +0.014 | +0.010 | +0.008 | +0.008 |
| 真实误差 | 0.054 | 0.020 | 0.011 | 0.008 | 0.011 | 0.007 |
训练损失在 1000 步左右就降到噪声地板 附近,之后几乎”不动了”;真实误差却总体还在下降(中间有波动)。原因就是 P1 §4.3 的分解:损失 = 常数(噪声)+ 真实误差,常数部分大得多,还带着批量的随机波动,真实误差的改进淹没在里面。
第 2 讲的流匹配损失正是如此。所以评估流匹配模型时,要看生成样本的质量(第 1 讲的那几把尺子),而不是损失的数值。
3.4 学习率与批大小
03 号脚本第 3 部分(都训练 2000 步,看真实误差):
| 设置 | 真实误差 |
|---|---|
| Adam,lr = 1e−4,批大小 256 | 0.394 |
| Adam,lr = 1e−3,批大小 256 | 0.008 |
| Adam,lr = 1e−2,批大小 256 | 0.012 |
| Adam,lr = 1e−1,批大小 256 | 0.061 |
| Adam,lr = 1e−3,批大小 8 | 0.054 |
| Adam,lr = 1e−3,批大小 64 | 0.018 |
| Adam,lr = 1e−3,批大小 1024 | 0.004 |
学习率太小走不到;太大在最优点附近震荡、停不到底。批越大,每步的梯度噪声越小(梯度是一个蒙特卡洛估计,误差 )。目标噪声越大,批大小越重要:流匹配的目标噪声很大(P1 §4.2),所以实践中常用大批量(原课 Lab 2 用 1000)。
📌 代码 03:
python3 03_nn_module_and_training.py。
4. 可复现性与速度 · Reproducibility & speed
4.1 全局种子 vs 独立的随机数流
torch.manual_seed(0) 设置的是全局随机数流:脚本里所有不指定 generator 的随机函数共用它。这样做有一个隐患(04 号脚本第 1 部分):演示 A 里多加一行随机代码,演示 B 的结果就全变了,两个毫不相干的实验被”串”在了一起。
讲义的脚本因此让每个演示用自己的 torch.Generator().manual_seed(...):torch.randn(n, d, generator=g)。改一个演示,不会让整份讲义里别的数字过时。(网络参数的初始化用 torch.manual_seed,因为 nn.Linear 不接受 generator 参数;只要在每次建模型之前重新设定即可。)
4.2 逐位可复现
CPU 上、单线程(torch.set_num_threads(1))、固定种子时,PyTorch 的结果逐位可复现:04 号脚本第 2 部分用种子 0 训练两次,所有参数逐位相同。多线程或 GPU 上,浮点加法的顺序可能变化,结果会有极小的差别(结论不变)。所以本课所有脚本开头都有 torch.set_num_threads(1)。
4.3 批量化
04 号脚本第 3 部分用欧拉法模拟 500 个粒子 100 步:Python 循环逐个粒子算约 300 ms,整批张量运算约 1–2 ms,结果完全相同,速度相差约两个数量级(具体数字随机器而变)。每次调用 PyTorch 运算都有固定开销,批量化把 500 次开销合并成 1 次,真正的计算交给底层的 C++ 和向量指令。GPU 上这个差距更大。
4.4 no_grad
同一个 50 步的采样循环(4000 个粒子、256 宽的网络),默认模式约 170 ms,torch.no_grad() 下约 100 ms,数值完全相同。省下的是保存中间结果(用于反向传播)的时间和内存。
📌 代码 04:
python3 04_reproducibility_and_speed.py(第 3、4 部分是计时,每次运行都不同)。
5. 画向量场 · Plotting vector fields
5.1 在网格上计算
我们的函数(向量场、对数密度)都”吃 (N, 2)、吐 (N, ...)”。在网格上计算它们的标准套路:
xs = torch.linspace(-lim, lim, n)
X, Y = torch.meshgrid(xs, xs, indexing="xy")          # 两个 (n, n) 的坐标矩阵
pts = torch.stack([X.reshape(-1), Y.reshape(-1)], dim=1)   # (n², 2)
vals = fn(pts).reshape(n, n, -1)                      # 变回网格形状
indexing="xy" 让下标 [i, j] 对应坐标 (xs[j], ys[i]):行是 、列是 ,和 imshow、quiver、streamplot 的约定一致。写成 "ij",图会沿对角线翻转,而且不报错。05 号脚本第 1 部分在三个格点上核对了”网格计算”和”单点直接计算”的结果完全相同。
5.2 箭头图、流线图与轨迹
- 箭头图(
quiver):每个格点画一支箭头,长度表示速度大小。适合看”这一刻每个地方往哪走、多快”。 - 流线图(
streamplot):沿向量场画连续的曲线。它表示”如果时间冻结在 ,粒子会怎样流动”。 - 轨迹:真正的 ODE 解,是随时间变化的向量场的积分。流线和轨迹一般不相同。
05 号脚本把第 1 讲的理想向量场在 四个时刻画了出来,底色是概率路径 的对数密度:
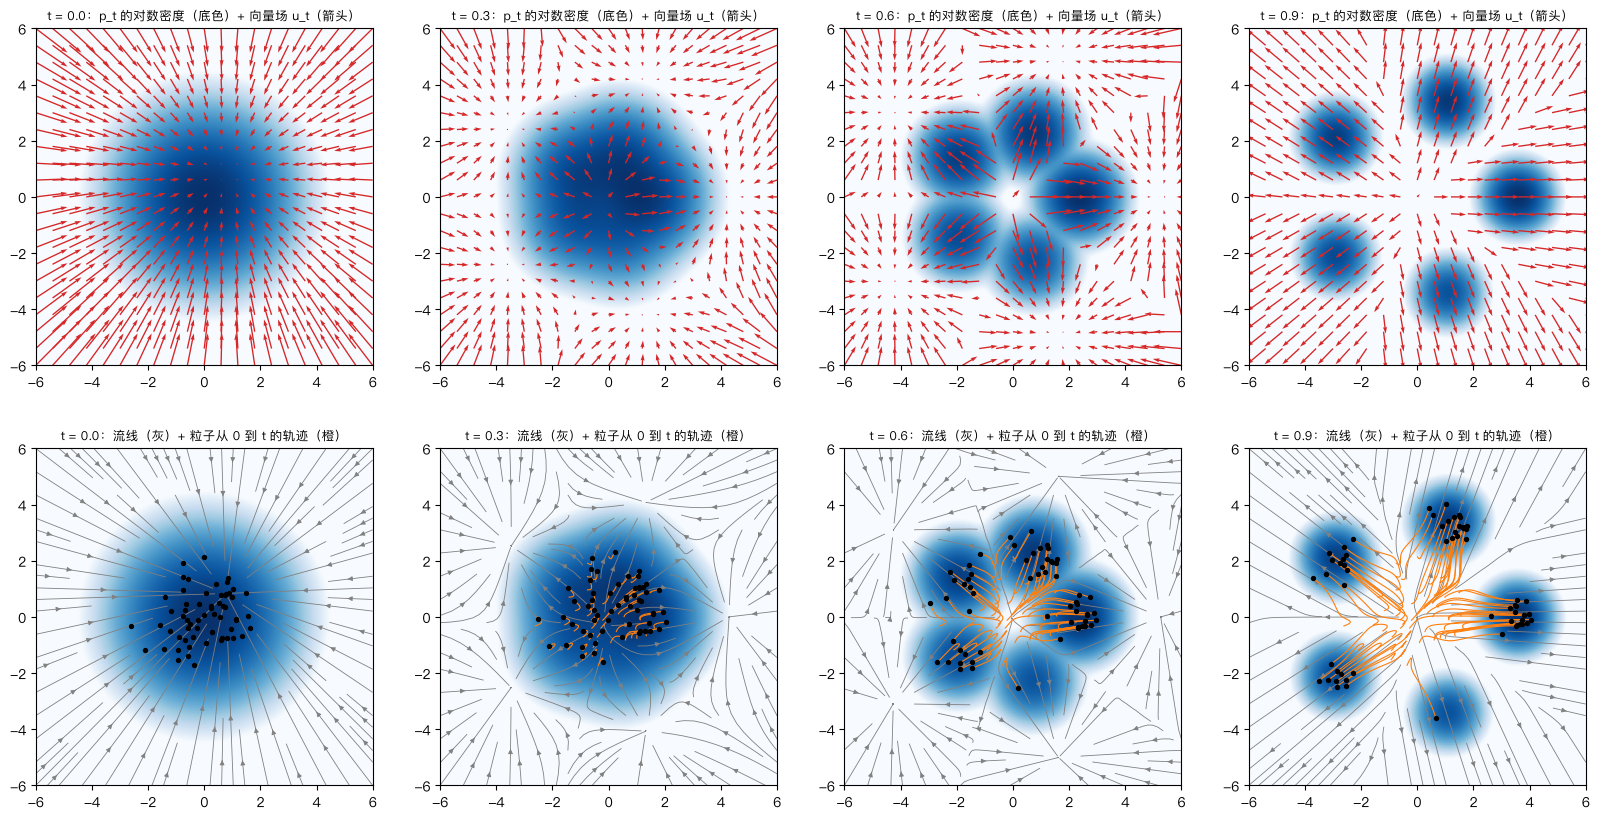
- :,所有箭头都指向数据的均值附近(,第 1 讲 §3.6)。
- 增大:底色从一团变成五团,箭头分化成”各奔各的峰”;两个峰之间的箭头向两边分开,那里的粒子还在”决定”去哪个峰。
- 下排的橙色轨迹和黑点表明:粒子始终待在 的高密度区域里,这正是第 2 讲要证明的”向量场沿着概率路径走”。
📌 代码 05:
python3 05_plotting_vector_fields.py。
6. 小结 · Summary
- 形状约定:样本
(n, d)、时间(n, 1)。广播会把(n, 1) − (n,)悄悄变成(n, n),在损失函数里加assert pred.shape == target.shape。 - float32 训练够用;逐位比较算法时用 float64。切片共享内存,原地修改会改动原张量,初学时用
x = x + ...。 backward()累加梯度,每步要zero_grad();采样用no_grad()。对总和求导一次得到整批的逐样本梯度;得分函数可以解析算、用autograd.grad算、或用vmap(jacrev)算。精确散度要 次反向传播,Hutchinson 估计只要一次但有噪声。- 训练循环五个动作:取数据、算损失、清梯度、反向传播、更新。在带噪声的目标上,损失会停在噪声地板附近,损失值看不出模型是否在变好;要用别的方式评估。噪声越大,越需要大批量。
- 每个演示用独立的
torch.Generator;单线程 + 固定种子 → 逐位可复现。批量化能快两个数量级。 - 在网格上计算:
meshgrid(indexing="xy")→ 展平 → 计算 → reshape;箭头图看瞬时速度,流线图看”冻结时间”的流动,轨迹是真正的 ODE 解。
7. 常见误区 · Common pitfalls
- “形状不对 PyTorch 会报错。” 广播会让很多形状错误静默通过(§1.2)。
- “
loss.backward()会覆盖旧的梯度。” 它是累加(§2.1)。 - “训练损失不降了,说明模型已经训练好了 / 训练出问题了。” 在带噪声的目标上,损失有一个不可约的下限,损失曲线变平不代表任何一种结论(§3.3)。
- “同一个种子就一定能复现。” 用全局种子时,任何地方多一次随机调用都会改变后面所有的随机数;多线程 / GPU 也会引入极小的差别(§4.1–4.2)。
- “流线就是粒子的轨迹。” 只有向量场不随时间变化时才是(§5.2)。
- “
meshgrid的两种索引方式没区别。”"ij"和"xy"会让画出来的图沿对角线翻转(§5.1)。
8. 练习 · Exercises
练习 1(找 bug)。下面这段”按时间加权”的流匹配损失有一个广播 bug。指出它,并说明算出来的是什么:
t = torch.rand(n)                                          # (n,)
xt = t[:, None] * z + (1 - t[:, None]) * eps
pred = model(xt, t[:, None])                               # (n, d)
w = ((pred - (z - eps)) ** 2).mean(dim=1, keepdim=True)    # (n, 1):每个样本的误差
loss = (w * t).mean()                                      # 想让每个样本的误差乘以它自己的 t
参考答案
w 是 (n, 1),t 是 (n,),相乘得到 (n, n):第 个元素是”样本 的误差 × 样本 的时间”。取平均后等于 w.mean() * t.mean(),即”不加权的平均误差 × 约 0.5”——按时间加权的意图完全落空,而且不报错。改法:(w.squeeze(1) * t).mean(),或者一开始就把 t 存成 (n, 1)。教训:同一个变量在一段代码里既以 (n,)、又以 (n, 1) 出现,是最容易出错的地方;在关键位置加 assert。
练习 2(梯度累积)。用”梯度累积”模拟大批量:把一个批大小 1024 的训练步,改写成 4 次批大小 256 的 backward()、只在最后 step() 一次。损失要怎样缩放才能让梯度和原来一样?
参考答案
每个小批量的损失除以 4(或者说:用 loss / 4 做 backward),因为 1024 个样本的平均 = 4 个 256 平均的平均。4 次 backward 把梯度累加起来,等于大批量损失的梯度;然后 opt.step()、opt.zero_grad()。
练习 3(Hutchinson 的方差)。证明当 的分量独立、取 ±1 时,,并且 。为什么维数越高,单个探针的方差往往越大?
参考答案
。,所以期望是 。对角项 没有随机性;方差来自 的项,计算得 。非对角元的个数是 ,随维数平方增长,所以高维时方差通常更大。
练习 4(编程:真实误差 vs 损失)。在 03_nn_module_and_training.py 第 2 部分里,把噪声 NOISE 从 0.5 改成 0 和 1.5,重新运行。训练损失的”地板”变成多少?3000 步后的真实误差怎样变化?这对第 2 讲有什么启示?
参考答案(提示)
地板是 :0 和 4.5。噪声为 0 时训练损失就是真实误差,会一直下降;噪声为 1.5 时损失几乎从一开始就是一条水平线,真实误差下降得更慢、最终更大(同样的批大小下梯度更吵)。作者机器上 3000 步后的真实误差:σ = 0 时约 0.001,σ = 0.5 时约 0.007,σ = 1.5 时约 0.037。启示:流匹配的”条件目标”噪声很大,所以训练要更多步、更大的批,而且只能用生成质量来判断模型好坏。
练习 5(编程:画第 1 讲的朗之万场)。仿照 05_plotting_vector_fields.py,把五峰分布的得分函数 画成箭头图。与 时的理想向量场相比,两者在峰与峰之间有什么不同?
参考答案(提示)
得分函数在每个峰附近都指向那个峰的中心,在峰与峰之间指向最近的峰(分界线两侧方向相反),远处则都指向某个峰——这就是第 1 讲 §5.3 “吸引域”的来源。理想向量场则在每个时刻都和 配套: 小时它还没把粒子分开,所以质量能按权重分配。
9. 延伸阅读 · Further reading
- PyTorch 官方教程:Learn the Basics(张量、自动求导、
nn.Module、训练循环);Autograd mechanics(梯度累加、no_grad、原地操作);torch.func的文档(vmap、jacrev、grad)。 - 可复现性:PyTorch 文档 Reproducibility 一页,列出了哪些操作在 GPU 上不确定以及如何设置。
- Hutchinson 估计与连续归一化流:Grathwohl et al., FFJORD: Free-form Continuous Dynamics for Scalable Reversible Generative Models(ICLR 2019)。
- matplotlib:官方示例库里的
quiver、streamplot、imshow页面。 - 原课 Lab:https://github.com/eje24/iap-diffusion-labs (2026 分支)。读完本讲后,Lab 1–2 里的工具代码(
Density.score的vmap(jacrev(...))、Trainer.train、imshow_density)应该都能看懂。
10. 下一讲预告 · Next lecture
工具都齐了。第 2 讲要回答第 1 讲留下的问题:没有 的公式,怎样训练向量场 ?我们会用 P1 的条件期望和均方误差分解,推导出条件流匹配:对每个数据点构造一条从噪声到它的条件概率路径,对着它的条件向量场 做回归——正是本讲 §3.3 那种”带噪声目标的回归”。训练完成后,用第 1 讲的 Algorithm 1 采样,就得到一个真正从数据中学出来的生成模型。