对应 Maps to:MIT 6.S184 Generative AI with Stochastic Differential Equations(IAP 2026;Peter Holderrieth 主讲,Ron Shprints、Ezra Erives 负责 Lab,Tommi Jaakkola 指导),Lecture 1 · 20-Jan-2026 · Flow and Diffusion Models;Lab 1 · Working with ODEs and SDEs。 阅读材料:原课讲义 Holderrieth & Erives, An Introduction to Flow Matching and Diffusion Models(2026 版,arXiv:2506.02070)第 1、2 章;Lecture 1 slides(20260120_Lecture_01.pdf)。 依据说明:本讲以原课讲义第 1–2 章和 Lecture 1 的 slides 为主线:生成即采样、ODE 与流、欧拉法、流模型、布朗运动、SDE、欧拉–丸山法、OU 过程、扩散模型。原课 Lab 1 的内容(布朗运动与 OU 过程的模拟、朗之万动力学、“OU 过程是高斯的朗之万动力学”)放在 §4–§5。五峰玩具数据、“理想向量场”(提前用第 2 讲的公式算出)以及全部实验是本讲义自己设计的,不代表课堂上讲了什么。 配套代码 Code:
code/lecture01/(6 个脚本 + 5 个模块;numpy + PyTorch CPU 版 + matplotlib;每个脚本 1–10 秒) 预计阅读时间:4–5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 解释为什么可以把”生成一张图”形式化为从数据分布 里采样,并说清楚数据分布、数据集、条件生成、生成模型这几个概念各指什么;理解为什么”只输出最可能的那张图”不是好的生成。
- 区分向量场、ODE、流这三种描述,写出线性向量场的流,说出存在唯一性定理的条件及其在机器学习里的含义(流可逆、轨迹不交叉)。
- 会用欧拉法和 Heun 法模拟 ODE,知道它们的误差阶、每步的计算代价,以及步长太大时会出现什么问题。
- 写出流模型的定义和采样算法(原课 Algorithm 1),理解”神经网络参数化的是向量场而不是流”以及”随机性只来自初始噪声”。
- 说出布朗运动的定义,解释为什么每一步的噪声要乘以 ,理解”二次变差等于时间”这个让随机微积分与普通微积分不同的事实。
- 从”无穷小更新”的角度理解 SDE ,会用欧拉–丸山法模拟它;能推导 OU 过程的均值、方差和平稳分布。
- 写出扩散模型的定义和采样算法(原课 Algorithm 2);理解朗之万动力学为什么能采样一个已知得分函数的分布、又为什么在分得很开的多峰分布上会失败;知道”给流模型加噪声”需要一个修正项(第 3 讲展开)。
0.2 先修与本讲范围 Prerequisites & scope
原课的先修是线性代数、多元微积分、基础概率论,以及一点 Python 和 PyTorch。本讲需要的背景都会就地补上。
| 默认你已经会 Assumed | 本讲只给直觉,后面再展开 Previewed only |
|---|---|
| 导数、偏导数、梯度、链式法则 | 向量场的训练目标从哪来:流匹配(第 2 讲) |
| 概率密度、期望、方差;高斯分布 | 得分函数、Fokker–Planck 方程、SDE 扩展技巧(第 3 讲) |
| 方差的性质:独立随机变量之和的方差 = 方差之和 | 条件期望与”边缘向量场”(前置讲 P1 §4;第 2 讲) |
| Python 基础(不熟悉的写法代码注释里都有解释) | 神经网络的训练循环(前置讲 P2、第 2 讲) |
0.3 本讲地图 Map
§1  生成即采样:对象是向量;数据分布;数据集;条件生成;生成模型        ← 代码 01
§2  ODE 与流:向量场、轨迹、流;存在唯一性;欧拉法与 Heun 法            ← 代码 02
§3  流模型:随机初始化 + ODE;Algorithm 1;理想向量场的实验;步数        ← 代码 03
§4  布朗运动与 SDE:√h;粗糙的路径;欧拉–丸山法;OU 过程                ← 代码 04、05
§5  扩散模型:Algorithm 2;朗之万动力学;"给流模型加噪声"的陷阱         ← 代码 06
§6  全景:本讲在整门课里的位置;和其他生成模型的比较
§7  小结   §8  常见误区   §9  练习   §10 延伸阅读   §11 下一讲预告
建议的阅读顺序:§1 → 运行 01;§2 → 运行 02;§3 → 运行 03;§4 → 运行 04、05;§5 → 运行 06。每节结尾都标了对应的脚本。
0.4 记号 Notation(全课统一,沿用原课讲义)
| 记号 | 意思 |
|---|---|
| 一个数据点(一张图展平后的向量) | |
| 数据分布(我们看不见它的公式,只能看到从中抽出的样本) | |
| 初始分布,生成的起点;默认是标准高斯 | |
| 时间。 是噪声, 是数据 | |
| , | 向量场:在位置 、时间 的速度;带 的是神经网络 |
| 时间 时粒子的位置(一般是随机变量) | |
| 流:从 出发、沿向量场走到时间 时的位置 | |
| 布朗运动 | |
| 扩散系数(噪声的强度) | |
| 数值模拟的步长; 是步数 | |
| 得分函数(score):对数密度的梯度,指向”密度增加最快”的方向 |
0.5 关于这门课 · About 6.S184
6.S184 是 MIT 在一月独立活动期(IAP,寒假里的短学期)开的一门短课:两周多、五六次课,配三个 Lab。2025 年由 Peter Holderrieth 和 Ezra Erives 合讲,共 6 讲(最后两讲是客座讲座:生成式机器人和蛋白质设计);2026 年由 Holderrieth 主讲,共 5 讲,课表上新增了”潜空间”和”离散扩散模型”两个主题。
这门课有两个鲜明的特点:
- 讲义是主干。课程主页说讲义”是课程的骨架,对所有内容给出了自洽的解释”,slides 只是配合讲课的可视化,“本身并不自洽”。所以本讲义每一讲都以原课讲义的对应章节为主线。
- Lab 是”及格的必要条件”。第一讲的 slides 在”怎样通过这门课”里只写了两条:来上课、做 Lab(“necessary to pass”)。三个 Lab 一步步带你从零写出一个流匹配 / 扩散模型。本讲义的代码借鉴了 Lab 的类设计(
ODE、SDE、Simulator、Density),但全部重写,并补了 Lab 里没有的对照实验。建议你也把原课的 Lab 做一遍(地址见 §10)。
原课的数学风格是”必要而最少”:slides 开宗明义,这门课要教的是”从第一性原理出发的流模型和扩散模型""理解它们所需的最少但必要的数学""怎样实现和应用这些算法”。凡是严格的随机分析(例如怎样从头构造布朗运动、伊藤积分),课上都只给结论、留给专门的课程。本讲义沿用这个取舍。
0.6 本讲的玩具数据:五峰圆环 · The five-mode ring
真实的图像分布写不出公式,所以本讲和后面几讲先用一个二维的玩具分布当 (distributions.five_modes()):
五个标准差 0.4 的小高斯排在半径 4 的圆上(第 0 个峰在正右方,逆时针编号),权重不相等。这样设计有三个原因:
- 能画出来,真相已知。密度 、得分函数 都有公式,我们能精确判断”生成得对不对”。
- 峰与峰分得很开(相邻中心距离约 4.7,是标准差的 11 倍多),峰之间几乎没有概率:生成的样本”落在峰之间”一眼就能看出是错误。真实图像分布也是这样:介于”猫”和”狗”之间的像素组合,几乎都不是一张合理的照片。
- 权重不相等。一个生成器把五个峰的形状画对还不够,每个峰占多少也要对。这一点在 §5.3 的朗之万动力学实验里会变得非常关键。
为了检查一批生成样本,我们用几把”尺子”(distributions.py):
| 尺子 | 衡量什么 | 理想值 |
|---|---|---|
| 能量距离 energy distance | 两堆样本的分布差异(不需要密度,不用调参数) | 0(两批真样本之间约 ±0.003,这是”噪声地板”) |
| 权重误差 TV | 每个峰分到的样本比例和真实权重的总变差距离 | 0 |
| 峰内散度 spread | 峰内的散开程度 / 理论值 | 1(>1 太散、<1 太挤) |
| 落在峰之间 far rate | 离所有峰都超过 4 个标准差的样本比例 | 约 0.03%(二维高斯的理论值) |
1. 生成即采样 · Generative modeling as sampling
1.1 从”预测”到”创造”
过去十多年的大部分 AI 系统做的是预测:给一张图,说出里面是猫还是狗;给一句话,判断情绪是正面还是负面。最近几年的这一波 AI 浪潮则有一种新能力:生成。图像生成器能按文字描述画出写实或艺术风格的图,视频模型能生成以假乱真的电影片段,语言模型能写出像人一样的回答。原课讲义的说法是,这些系统是”有创造力的”:它们会根据用户的输入,“梦”出新的对象。
这门课只讲两种生成算法:去噪扩散模型(denoising diffusion models)和流匹配(flow matching)。原课讲义列举的例子有:图像生成的 Nano Banana、Stable Diffusion 3、FLUX,视频生成的 Veo 3、Sora、Meta Movie Gen,以及蛋白质结构预测的 AlphaFold3(它的结构生成模块就是一个扩散模型)。这些模型背后几乎都是同一个想法:
从噪声出发,通过模拟一个常微分方程(ODE)或随机微分方程(SDE),一步步把噪声变成数据。
原课讲义开篇引用了 Song et al. 的一句话:“Creating noise from data is easy; creating data from noise is generative modeling.”(从数据造出噪声很容易,从噪声造出数据才是生成式建模。)往一张照片上不断加高斯噪声,任何人都会做;本讲要搭建的,是把这个过程反过来的机器。
这类模型实现起来并不复杂,难的是理解:SDE 的技术细节会让人望而生畏。所以原课先用两讲的篇幅,把需要的微分方程工具从头讲清楚。本讲是第一步:先把机器造出来(怎样用 ODE / SDE 生成),第 2、3 讲再讲怎样训练这台机器。
1.2 对象就是向量
第一步是把”图像""视频""分子”变成数学对象。
- 图像:高 、宽 个像素,每个像素有红绿蓝三个通道的强度值,所以一张图是 。
- 视频: 帧图像,。
- 分子结构: 个原子,每个原子有三维坐标,(这是最朴素的表示,还有更精巧的)。
把这些张量展平(flatten),它们都只是一个很长的向量。原课讲义把这称为 Key Idea 1(对象即向量):我们把要生成的对象等同于 。
01 号脚本第 1 部分列出了几种对象的维数:
| 对象 | 张量形状 | 向量维数 |
|---|---|---|
| 一张 MNIST 手写数字 | 28×28×1 | 784 |
| 一张 256×256 彩色图 | 256×256×3 | 196,608 |
| 一张 1024×1024 彩色图 | 1024×1024×3 | 3,145,728 |
| 5 秒视频(24 帧/秒,512×512) | 120×512×512×3 | 94,371,840 |
| 300 个原子的分子 | 3×300 | 900 |
| Stable Diffusion 的潜空间 | 4×32×32 | 4,096 |
两点值得注意。第一,形状只是”怎样排列这些数”,展平和还原都不丢信息,所以后面所有算法都只在 里讲,对 没有任何特殊要求;本讲先用 ,是为了能画出来。第二,最后一行预告了第 5 讲:真实的大模型先用一个自编码器把图压缩到小得多的潜空间里,再在那里做生成,否则几百万维的向量场无论算力还是学习难度都吃不消。
一个重要的例外是文本。语言模型处理的是离散的 token 序列,不是 里的连续向量。这门课前五讲只讲连续数据;第 6 讲再把同样的思路搬到离散数据上(扩散语言模型)。
1.3 “好的生成”怎样定义:从主观判断到概率
假设我们想生成”一只狗的照片”。Lecture 1 的 slides 画了一排图:一张完全无意义的噪声(“没用”)、一张画糊了的狗(“差”)、一只猫(“动物不对”)、一张清晰的狗的照片(“很好”)。这些都是主观评价,怎样让它们变得可以计算?
slides 的回答是换一个问题:在互联网上找到这张图的可能性有多大? 噪声图”不可能”出现,画糊的狗”很少见”,猫的照片在”狗的照片”里”不太可能”,清晰的狗的照片”非常可能”。于是”一张图好不好”这个主观判断,被替换成了”这张图在数据分布下的可能性有多大”。
在机器学习里,我们把所有可能的狗的图像的”合理程度”描述成一个概率分布,叫数据分布 。数学上可以把它看成一个概率密度 ,越像狗的图,密度越高。注意,世界上不存在”唯一最好的狗的照片”,而是有一整片同样好的照片,它们在 下都有较高的密度。于是:
Key Idea 2(生成即采样):生成一个对象 ,就是从数据分布中抽一个样本 。
slides 特意标注了一句:“Note: We don’t know the probability density!”——我们并不知道 的公式。要是知道,生成问题就简单多了。
01 号脚本第 2 部分在五峰分布上算了几个点的对数密度:
| 位置 | ||
|---|---|---|
| 第 0 个峰的中心 (4, 0) | −1.06 | 3.5e−1 |
| 第 0、1 个峰之间 (2.6, 1.9) | −17.79 | 1.9e−8 |
| 原点 (0, 0) | −50.01 | 1.9e−22 |
| 远处 (8, 8) | −199.38 | 2.6e−87 |
峰中心和峰之间差了约 倍。高维图像空间里这种悬殊只会更极端:随机撒一把像素得到一张”像狗的照片”的概率,可以认为就是零。生成模型要做的,是在这样一个绝大部分地方都几乎为零的分布里,准确地落到那些”有东西”的地方。
1.4 为什么不是”生成最可能的那张图”
既然密度高 = 好,为什么不干脆输出密度最高的那张图?01 号脚本第 3 部分比较了四个”生成器”,每个生成 2000 个样本:
| 生成器 | 平均 | 能量距离 | 权重误差 TV | 峰内散度 | 落在峰之间 | 照抄训练样本 |
|---|---|---|---|---|---|---|
| A 真正的采样器 | −2.46 | −0.0002 | 0.014 | 0.98 | 0.0% | 0% |
| B 只输出最可能的点 | −1.06 | 3.6112 | 0.650 | 0.00 | 0.0% | 0% |
| C 背下训练集(500 个) | −2.49 | 0.0120 | 0.044 | 0.98 | 0.0% | 100% |
| D 拟合一个高斯 | −19.03 | 0.2393 | 0.059 | 4.18 | 70.0% | 0% |
(能量距离的噪声地板:两批真样本之间的 能量距离 平均约 0.0026。)
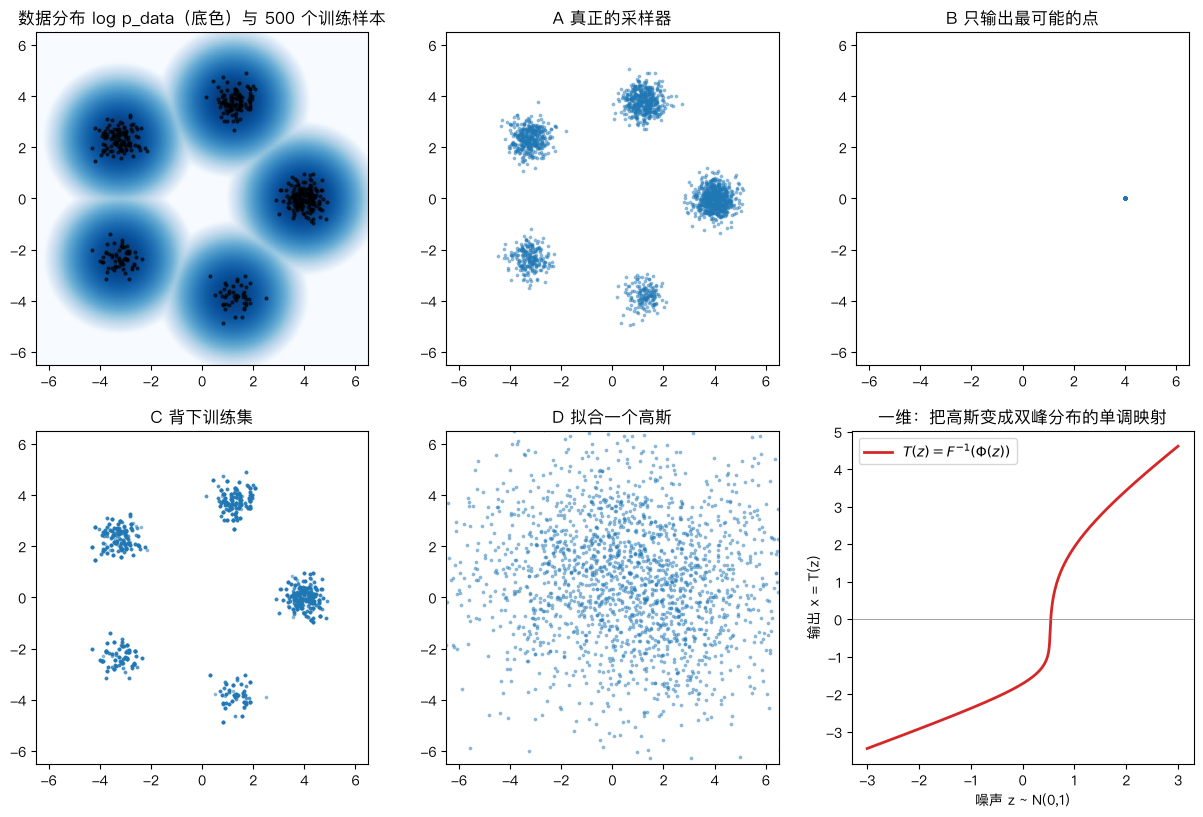
- B 的平均对数密度最高:每个样本都在密度最大的点上。但它永远只画同一张图,能量距离和权重误差都是最差的。“最可能”≠“好的生成”。好的生成要同时满足两点:像(落在高密度区域)和多样(按 的比例覆盖所有高密度区域)。“从 里采样”这个定义天然把两者都包含了:采样得到的样本,出现在每个区域的频率恰好等于该区域的概率。
- D 拟合了一个高斯:它足够多样,但一个高斯只有一个峰,70% 的样本落在峰之间。它对应真实世界里的”模糊的平均图”。这类模型在高维空间里很常见:当模型的表达能力不够时,它会把几个模式”平均”成一个不像任何一个模式的东西。
- C 背下了训练集:分布层面的尺子几乎看不出它的问题(能量距离 0.012,略差一点,只是因为 500 个训练样本本身有抽样误差),但它 100% 的输出都是照抄。分布层面的指标看不出”背诵”,需要另外检查。我们希望生成模型产生训练集里没有的新样本。(真实的扩散模型在训练数据少、模型很大时确实会背下训练样本,这是一个活跃的研究方向。)
1.5 数据集:我们真正拥有的东西
训练任何机器学习模型都需要数据。生成式建模里,通常假设我们有一批从 独立抽出的样本:
Key Idea 3(数据集):数据集由有限个样本 组成。
图像可以从互联网上收集,视频可以来自 YouTube,蛋白质结构可以来自蛋白质数据库(PDB)。数据集越大,它就越能代表背后的 。01 号脚本第 2 部分量化了这一点:对每个 ,抽 20 次大小为 的数据集,看各峰样本比例和真实权重的误差:
| 误差 TV(20 次平均) | TV × | |
|---|---|---|
| 50 | 0.1190 | 0.84 |
| 500 | 0.0402 | 0.90 |
| 5,000 | 0.0128 | 0.90 |
| 50,000 | 0.0032 | 0.71 |
误差按 缩小(最后一列大致不变):数据量翻 10 倍,误差只缩小约 3 倍。这是所有”从样本估计”的方法共同的命运。
请牢记:训练时我们只有数据集,没有 的公式。本讲为了检查结果,会”作弊”用到五峰分布的公式;第 2 讲开始训练模型时,算法本身只能看到样本。
1.6 条件生成:按提示生成
很多时候我们想按某个条件 来生成,比如 = “一只在覆盖着雪的山坡上奔跑的狗,背景是群山”。这可以写成从一个条件分布里采样:
Key Idea 4(引导 / 条件生成):引导生成就是从 中采样, 是条件变量。
我们要的不是”每个提示训练一个模型”,而是一个模型,能对任意提示 条件生成。01 号脚本第 4 部分把”属于第几个峰”当作标签 :从 采样,样本 100% 落在第 个峰;无条件分布则是各条件分布按 的混合:
原课讲义指出,无条件生成的技术很容易推广到条件生成。所以第 1–3 讲几乎只讲无条件生成,第 4 讲再讲怎样加上条件(以及怎样用”无分类器引导”让模型更听话)。
1.7 生成模型:把简单分布变成复杂分布
抽象地说,生成模型就是一个返回 样本(至少是近似样本)的算法。怎样构造这样的算法?几乎所有现代生成模型都采用同一个思路:
从一个容易采样的简单分布 (通常是标准高斯 )出发,把它的样本变换成 的样本。
为什么要从噪声出发?因为生成必须有随机性:同一个提示每次应该生成不同的图。随机性得有一个来源,最简单的就是一个我们会采样的分布。
这样的变换存在吗?一维时答案很具体。设目标分布的累积分布函数(CDF)是 ,标准高斯的 CDF 是 ,那么
道理是: 服从 上的均匀分布,再用目标分布的分位数函数 把均匀分布”摊”成目标分布。01 号脚本第 5 部分把 变成一个左高右矮的双峰分布 :2 万个样本的经验 CDF 和目标 CDF 的最大差只有 0.0040(纯随机波动的范围约 0.0096)。映射本身长这样:
| 噪声 | −2.0 | −1.0 | 0.0 | +0.5 | +0.8 | +1.0 | +2.0 |
|---|---|---|---|---|---|---|---|
| −2.92 | −2.37 | −1.72 | −0.89 | +1.46 | +1.93 | +3.43 |
(图见上面那张图的右下角。) 是单调的: 从 0.5 走到 0.8 这一小段,被拉伸到两个峰之间的一大片(−0.89 到 +1.46)。目标密度低的地方,映射就把噪声”拉稀”;目标密度高的地方,映射就把噪声”挤密”。
这个例子告诉我们三件事:
- 一个确定性的函数就足够了:所有随机性都来自输入的噪声 。
- 高维时没有这样的公式:逆 CDF 只在一维有意义;二维以上,满足”把高斯变成 “的映射有无穷多个,也写不出来。
- 所以我们需要学习一个变换。直接学一个”一步到位”的映射 是一种思路(GAN、VAE 的解码器、归一化流都是这么做的),但这条路各有各的难处(§6.2 会比较)。流模型和扩散模型选了另一条路:不直接学 ,而是让粒子沿一个向量场一小步一小步地走。每一小步都只需要做一点点”修正”,许多小步叠加起来,完成从噪声到数据的复杂变换。走法由一个微分方程规定,这就是下一节的主角。
1.8 小结:生成即采样(原课 Summary 2)
- 我们要生成的对象(图像、视频、分子结构)都表示为向量 。
- 生成 = 从数据分布 中采样;训练时我们只有一个数据集 。
- 条件生成 = 从 中采样;训练时有成对的数据 。
- 目标是构造一个生成模型:训练好以后,它把简单分布 的样本变成 的样本。
📌 代码 01:
python3 01_generation_as_sampling.py。
2. 常微分方程与流 · ODEs and flows
2.1 向量场:每一点、每一时刻的速度
想象一条河。河面上每一点都有一个水流的速度(方向 + 大小),而且这个速度可能随时间变化(上游放水了)。把一片树叶放在河面某处,它就会被水流带着走,画出一条轨迹。
数学上,“河水的速度”就是一个随时间变化的向量场:
对每个位置 和时间 , 给出一个 维的速度向量。原课讲义的 Figure 1 和 slides 里那些蓝色箭头图,画的就是二维向量场。
2.2 ODE:沿着箭头走
“树叶被水流带着走”这句话写成方程,就是一个常微分方程(ordinary differential equation, ODE):
第一个式子说:轨迹 在每个时刻的速度,等于它所在位置的向量场 。第二个式子说:它从 出发。满足这两个条件的函数 叫做 ODE 的一个解或一条轨迹(trajectory)。
2.3 流:把所有起点一起搬运
一条轨迹只回答”从 出发会到哪里”。如果对所有起点同时问这个问题,答案是一个函数
它满足
这个 叫做向量场 的流(flow)。给定起点 ,轨迹就是 。
于是我们有了同一个对象的三种描述:
- 向量场 :局部的、瞬时的描述(“此处此刻往哪走”);
- ODE:一个要求(“轨迹要顺着向量场走”);
- 流 :整体的描述(“整个空间在 时刻被变形成了什么样子”)。
向量场定义 ODE,ODE 的解是流。在 slides 的动画里,一张方格网被流”扭曲”:流是对整个空间的一个连续变形。后面我们会看到,神经网络学的是第一种描述,而生成时我们需要的是第三种;从第一种到第三种,要靠模拟。
2.4 例子:线性向量场(原课 Example 4)
取 ():每个点的速度都指向原点,离得越远速度越大。它的流是
验证只需两步: 满足初始条件;对 求导, 满足 ODE。所有轨迹都以相同的比例 指数收缩到原点。
02 号脚本第 1 部分在 时对三个起点比较了精确解和欧拉法(),并用中心差分验证了 ,两者一致到小数点后六位。
2.5 解一定存在吗?唯一吗?
对任何方程,都应该先问这两个问题。原课讲义的回答是”是的”,只要向量场满足一个很弱的条件:
定理 3(流的存在唯一性):如果 连续可微且导数有界,那么 ODE 有唯一解,由一个流 给出。而且每个 都是一个微分同胚(diffeomorphism):连续可微,并且有连续可微的逆。
slides 给出了更一般的版本(Picard–Lindelöf 定理):只要向量场Lipschitz 连续(存在常数 使 ,即”不能太陡”),解就存在且唯一。证明用的是 Picard 迭代,属于数学课的内容,这里只看它的条件为什么重要。
条件不满足时会出什么事? 02 号脚本第 5 部分给了两个经典反例:
(a) 解在有限时间内爆炸。,,精确解是 ,在 时跑到无穷大。 的导数 无界。欧拉法的结果:
| 步数 | (精确值 10) | (精确值 ∞) |
|---|---|---|
| 10 | 4.47 | 6.1 |
| 100 | 8.41 | 30.4 |
| 1,000 | 9.80 | 193.1 |
| 10,000 | 9.98 | 1393.6 |
在 处数值解收敛到 10;在 处它随 无限增大,不收敛到任何数。
(b) 解不唯一。,。 是解, 也是解(还有无穷多个”先停一会儿再出发”的解)。 在 0 处斜率无穷大,不满足 Lipschitz 条件。数值上的后果是对起点极度敏感:
| 起点 | 0 | |||
|---|---|---|---|---|
| 欧拉 1000 步的 | 0.0000 | 0.9886 | 0.9913 | 1.0154 |
起点只差 ,终点就从 0 跳到约 1。
为什么在机器学习里不用担心? 神经网络是线性层和激活函数(ReLU、SiLU、tanh……)的复合,每一层都是 Lipschitz 的,复合起来仍然是 Lipschitz 的。所以用神经网络当向量场时,解总是存在且唯一。原课讲义说得很直白:定理 3”不应该是你的顾虑,而是好消息”。(细节:ReLU 网络是 Lipschitz 的但不处处可微,此时流仍然存在、唯一、可逆,只是不一定处处可微。)
唯一性带来的两个推论,对生成模型非常重要(02 号脚本第 4 部分):
- 流是可逆的。从 正着走到 ,再用同一个向量场倒着走回来(步长取负),就能回到起点。在一个弯曲的二维向量场上,Heun 法 50 / 200 / 1000 步的往返误差分别是 、、,随步数减小。 就是”倒着走同一个 ODE”。
- 轨迹不会交叉。如果两条轨迹在同一时刻到达同一点,那么从这一点出发就有两个解,和唯一性矛盾。一维时这意味着粒子的先后顺序永远不变:400 个从小到大排好的起点,模拟到 后顺序完全保持;相邻点的间距从 0.015 变成最小 、最大 2.49。空间被挤压、被拉伸,但从不被撕开或折叠。
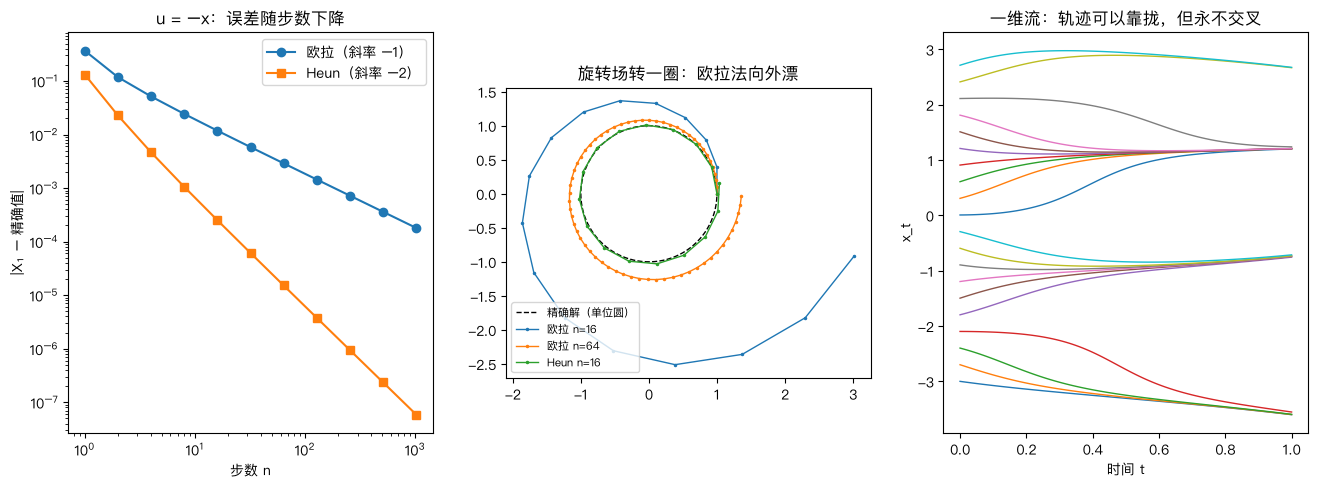
(左:误差随步数下降;中:旋转场上的欧拉法与 Heun 法;右:一维流的轨迹可以靠拢,但永不交叉。)
2.6 数值模拟:欧拉法
除了线性向量场这样的特例,流一般写不出公式,只能数值模拟。这是数值分析里一个成熟的领域,方法很多。最简单、最直观的是欧拉法:
其中 是步长, 是步数。意思是”按当前位置的速度,直直地走一小段”。原课说:“对这门课来说,欧拉法就够用了。”
为什么它是对的? 由泰勒展开,真实轨迹满足 。欧拉法丢掉了 的项。每一步犯 的错,走 步累积成 :步数翻倍,误差减半。这叫一阶方法。
02 号脚本第 2 部分在 上验证了这一点(精确值 ):
| 步数 | 1 | 2 | 4 | 8 | 16 | 32 | 64 | 256 | 1024 |
|---|---|---|---|---|---|---|---|---|---|
| 欧拉误差 | 3.68e−1 | 1.18e−1 | 5.15e−2 | 2.43e−2 | 1.18e−2 | 5.82e−3 | 2.89e−3 | 7.20e−4 | 1.80e−4 |
| Heun 误差 | 1.32e−1 | 2.27e−2 | 4.65e−3 | 1.05e−3 | 2.51e−4 | 6.13e−5 | 1.51e−5 | 9.38e−7 | 5.85e−8 |
相邻两列(步数翻倍)的误差比:欧拉法趋于 2.00,Heun 法趋于 4.00。
步长太大会怎样? 对 ,欧拉法每一步是 。如果 ,每一步都会放大而不是缩小。02 号脚本取 (一个”很陡”的向量场,精确值 ):
| 步数 | 10 | 14 | 16 | 30 | 100 |
|---|---|---|---|---|---|
| 放大因子 | −2.000 | −1.143 | −0.875 | 0.000 | 0.700 |
| 欧拉法的 | 1024 | 6.49 | 0.118 | 0 | 3.2e−16 |
时数值解变成 1024,完全发散。步长必须和向量场的”陡峭程度”相匹配。这在扩散模型里是个实际问题:越接近数据(),学到的向量场往往越陡,所以很多采样器在接近 时会用更小的步长。
2.7 Heun 法与”调用次数”
原课讲义还介绍了 Heun 法,让你”尝一尝更复杂的方法”:
直觉:欧拉法只看起点的速度,遇到弯道就会冲出去;Heun 法往前看了一眼,用平均速度修正方向。它是二阶方法:步数翻倍,误差变成四分之一(上表最后一行)。
旋转场 是一个很好的试金石:精确解永远在单位圆上转圈。欧拉法每一步沿切线走出去,而切线总在圆外,所以每步半径乘以 (因为 ),粒子越转越远。02 号脚本第 3 部分(转一整圈):
| 步数 | 8 | 16 | 32 | 64 | 256 | 1024 |
|---|---|---|---|---|---|---|
| 欧拉:终点半径 | 6.83 | 3.15 | 1.83 | 1.36 | 1.08 | 1.0195 |
| Heun:终点半径 | 1.438 | 1.049 | 1.006 | 1.0007 | 1.00001 | 1.000000 |
欧拉法的误差是系统性的(总是往外),不会互相抵消。生成模型里的对应现象是:步数太少时,样本会系统性地偏离数据分布(§3.6)。
但高阶方法不是免费的:Heun 法每步要算两次向量场。对一个几十亿参数的网络来说,算一次向量场就是一次完整的前向传播,向量场的调用次数(number of function evaluations, NFE)才是生成的真正成本。同样调用 64 次,欧拉法()误差 ,Heun 法()误差 :在光滑的问题上,高阶方法通常更划算。实践中,扩散模型的采样器(DDIM、DPM-Solver、EDM 的 Heun 采样器等)正是在”用尽量少的调用次数达到足够的精度”这件事上做文章。这门课用欧拉法就够了。
📌 代码 02:
python3 02_odes_and_flows.py。
3. 流模型 · Flow models
3.1 把 ODE 变成生成模型:随机性从哪来?
现在我们可以用 ODE 来造生成模型了。目标是把一个简单分布 变成 。
一个问题马上出现:生成必须是随机的,而 ODE 是完全确定的,同一个起点永远走到同一个终点。解决办法很简单:让起点随机。从 里抽一个起点,然后确定性地沿 ODE 走:
这就是流模型(flow model)。其中 是一个以 为参数的神经网络向量场 (具体的网络结构第 5 讲再讲;现在只需要知道它吃进 、吐出一个 维速度)。我们的目标是让轨迹的终点服从数据分布:
其中 是 的流。 选什么都行,唯一的要求是推理时容易采样;几乎总是取 。
3.2 网络参数化的是向量场,不是流
原课讲义特意提醒:虽然叫”流模型”,神经网络参数化的是向量场,不是流。要得到流,必须模拟 ODE。为什么要绕这个弯,而不直接让网络输出 ?
- 可逆性自动成立。§2.5 说过,只要向量场 Lipschitz(任何普通的神经网络都满足),它的流就是一个可逆的、连续的变形。如果直接学 ,就必须专门设计可逆的网络结构(归一化流就是这么做的),这会严重限制网络的表达能力。用向量场参数化,任何网络都是合法的。
- 复杂的变换由简单的步骤叠加而成。每一步只需要做一点点移动;网络只需要回答”此时此地往哪走”,而不必一次性想清楚整个变换。
- 训练可以不模拟。这是第 2 讲的核心发现:流匹配可以直接对向量场做回归,训练时根本不用模拟 ODE。如果学的是流 ,就做不到这一点。
- 推理时可以灵活地选步数。连续时间的模型训练好以后,可以用 10 步、50 步或 1000 步去模拟,在速度和质量之间自由权衡。
3.3 采样算法(原课 Algorithm 1)
Algorithm 1  用欧拉法从流模型采样
输入:神经网络向量场 u^θ,步数 n
1: t ← 0,h ← 1/n
2: 抽一个样本 X_0 ~ p_init
3: for i = 1, ..., n:
4:     X_{t+h} ← X_t + h · u^θ_t(X_t)
5:     t ← t + h
6: return X_1
对应的 Python(sde_lib.py,节选):
class EulerSimulator(Simulator):
    def step(self, x, t, h):
        return x + h * self.ode.drift(x, t)        # X_{t+h} = X_t + h·u_t(X_t)

    # Simulator.simulate:沿时间网格 ts 一步步走
    def simulate(self, x, ts):
        for i in range(len(ts) - 1):
            x = self.step(x, ts[i].item(), (ts[i + 1] - ts[i]).item())
        return x
这就是生成。Stable Diffusion 3 的采样循环本质上就是这几行:向量场换成一个几十亿参数的 Transformer, 换成潜空间里的一张”图”,步数取几十。
3.4 实验一:未训练的网络
03 号脚本第 1 部分用一个随机初始化的 MLP(输入 共 3 维 → 3 个 64 宽的隐藏层 → 输出 2 维速度,共 8,706 个参数)当向量场,从 出发,欧拉法 100 步:
| 生成方式 | 到 的能量距离 | 权重误差 TV | 峰内散度 | 落在峰之间 |
|---|---|---|---|---|
| 什么都不做() | 1.7439 | 0.209 | 5.19 | 97.2% |
| 未训练网络(种子 0,平均位移 0.02) | 1.7351 | 0.208 | 5.18 | 97.1% |
| 未训练网络(种子 1,平均位移 0.05) | 1.7683 | 0.229 | 5.19 | 97.2% |
| 未训练网络(种子 2,平均位移 0.19) | 1.6370 | 0.141 | 5.17 | 97.1% |
采样算法完全正确,但向量场是随机的:输出只是把高斯团挪了挪、扭了扭,和”什么都不做”几乎没有区别。slides 说得好:没有训练,模型只会产生”无意义的东西”(non-sense)。生成质量完全由向量场决定。
3.5 实验二:如果向量场是”对的”
那么,到底存不存在一个向量场,能把 精确地搬运成五峰分布?存在,而且对我们这个玩具问题能写出公式。第 2 讲会推导出:对”直线”概率路径 (,),向量场
就是我们要的那个。当 是高斯混合时,这个条件期望有闭式解(oracle_fields.py)。现在你只需要把它当作一个”神谕”(oracle),第 2 讲会从头推一遍。
03 号脚本第 2 部分把它代入 Algorithm 1(欧拉法 500 步),记录粒子在各个时刻的分布:
| 时刻 | 到原点的平均距离 | 与 的能量距离 | 与 的能量距离 |
|---|---|---|---|
| 1.27 | 0.0008 | 1.7414 | |
| 1.34 | −0.0011 | 1.5597 | |
| 2.08 | −0.0007 | 0.9043 | |
| 3.03 | −0.0016 | 0.2939 | |
| 3.63 | −0.0025 | 0.0553 | |
| 4.03 | −0.0037 | 0.0072 |
终点的各项指标:能量距离 0.0072、权重误差 TV 0.020、峰内散度 1.00、落在峰之间 0.1%,各峰比例 0.33/0.26/0.21/0.13/0.08;作为对照,直接从 抽 2000 个样本是 0.0017、0.018、1.01、0.1%。
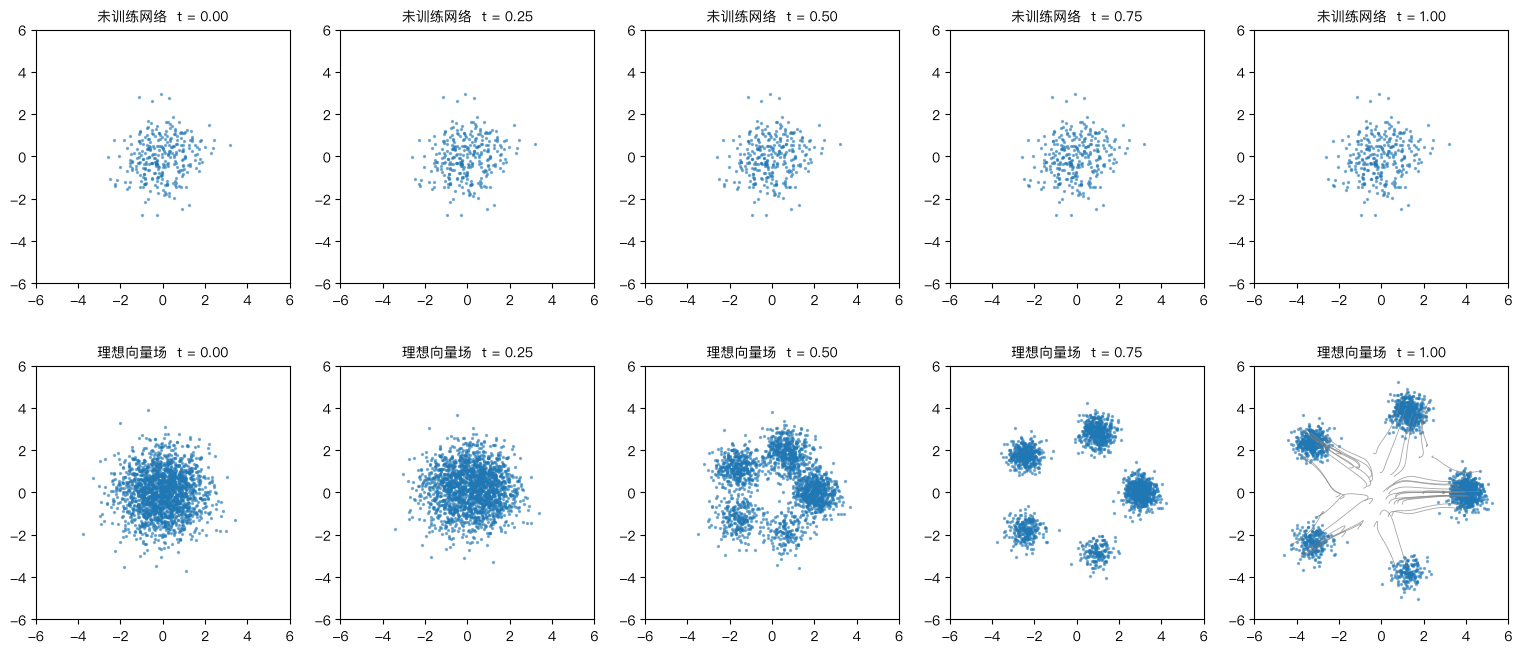
(上排:未训练的网络,什么也没发生;下排:理想向量场,高斯团先”鼓起来”,再分裂成五团、各自收紧。最后一张叠加了 40 条轨迹。)
两个观察:
- 向量场对了,同一个采样循环就把噪声变成了数据,连五个峰的权重都对。
- 更重要的是第三列:每个中间时刻,粒子的分布都和一个预先规定的分布 吻合(能量距离都在噪声地板 ±0.003 附近)。 是”直线路径 在 时刻的分布”,它从 连续地变到 。也就是说,ODE 不只是”终点对”,而是沿着一条分布的路径在走。第 2 讲把这条路径叫做边缘概率路径,而”让 ODE 沿着一条指定的概率路径走”正是流匹配的核心思想。
3.6 步数与样本质量
03 号脚本第 3 部分改变模拟的步数(同一批 2000 个起点):
| 生成方式 | 调用次数 | 能量距离 | 权重误差 TV | 峰内散度 | 落在峰之间 |
|---|---|---|---|---|---|
| 欧拉 | 1 | 2.7753 | 0.750 | 5.31 | 100.0% |
| 欧拉 | 2 | 0.5194 | 0.229 | 2.30 | 25.6% |
| 欧拉 | 4 | 0.0721 | 0.058 | 1.34 | 3.0% |
| 欧拉 | 8 | 0.0136 | 0.025 | 1.10 | 0.8% |
| 欧拉 | 16 | 0.0030 | 0.016 | 1.02 | 0.2% |
| 欧拉 | 32 | 0.0013 | 0.011 | 1.01 | 0.2% |
| 欧拉 | 512 | 0.0026 | 0.013 | 1.00 | 0.1% |
| Heun | 4 | 0.2344 | 0.181 | 1.47 | 7.1% |
| Heun | 8 | 0.0011 | 0.020 | 1.07 | 0.2% |
| Heun | 16 | 0.0011 | 0.011 | 1.04 | 0.3% |
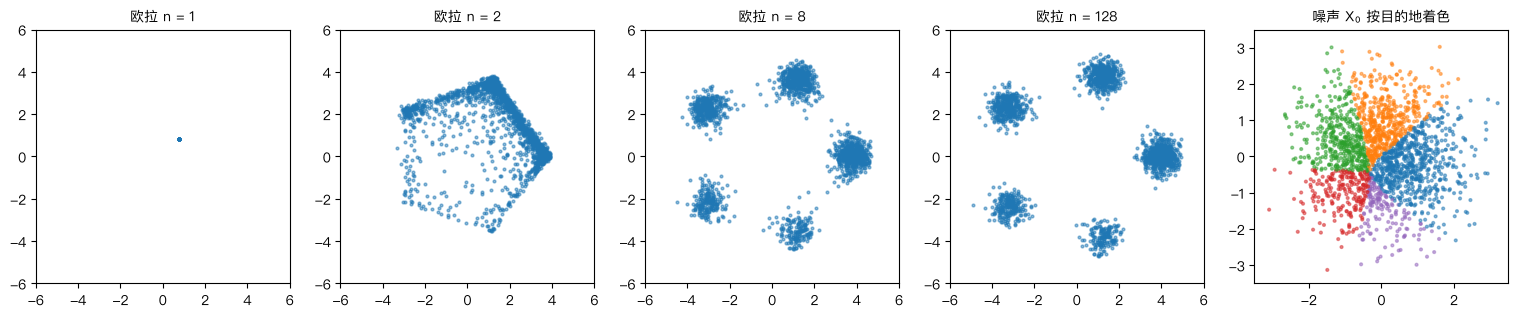
只走 1 步时,所有样本塌缩到同一个点:数据的均值 ,2000 个样本与它的最大差只有 。原因藏在理想向量场的公式里: 时 与 独立,所以
走一整步 :。这是”一步生成得到模糊的平均图”在二维里的精确版本:在 处,向量场只知道”数据平均在哪”,还不知道”这个粒子该去哪个峰”。只有一步一步地往前走,后验才会越来越确定,箭头才会分别指向各个峰。
其余几行的趋势: 时样本已被分向五个方向,但连成了一个五边形(见上图第二张),四分之一落在峰之间; 到 8 迅速变好; 以后能量距离已进入噪声地板,和 512 步没有可分辨的差别。至于欧拉和 Heun 谁更划算,要看预算:8 次调用时 Heun()比欧拉()好一个数量级,但只有 4 次调用时,欧拉()反而胜过 Heun()。每一步都太大时,“往前看一眼”也救不回来。
“能不能只用一两步就生成好的样本”是一个独立的研究方向(蒸馏、一致性模型、平均流……),留到扩展讲第 7 讲。
3.7 确定性的映射,与噪声空间的划分
流模型生成的随机性只来自 。03 号脚本第 4 部分验证了几件事:
- 同一批噪声模拟两次,结果完全相同(最大差 0.0)。流模型就是一个确定性映射 ,和 §1.7 里一维的 是同一类东西,只是这次它由 ODE 定义。
- 把噪声空间切成了五块,大致是五个扇形,各自朝向自己的峰(上图最右:噪声按”最终去了哪个峰”着色)。每块的概率质量恰好等于对应峰的权重:0.35/0.25/0.20/0.12/0.08,与真实权重一致到小数点后两位。
- 把每个噪声挪动约 0.01,98.8% 的样本仍去同一个峰,终点位移的中位数 0.0095(几乎原样挪动);但最大位移有 2.99:那些恰好落在分界线附近的噪声,会被分到另一个峰去。流是连续的,但从”一团”变成”五团”,就必须在分界线附近把空间剧烈地拉伸。
📌 代码 03:
python3 03_flow_models.py。
4. 布朗运动与随机微分方程 · Brownian motion and SDEs
流模型的随机性只在起点。扩散模型更进一步:让整个运动过程都带随机性。为此需要一个”随机的轨迹”的基本构件:布朗运动。
4.1 布朗运动:连续的随机游走
1827 年,植物学家 Robert Brown 在显微镜下看到水中的花粉颗粒在不停地无规则抖动。1905 年,爱因斯坦解释了原因:颗粒被周围的水分子从各个方向随机撞击,大量微小的独立撞击累积起来,就形成了这种运动。后来数学家 Norbert Wiener(他在 MIT 任教,原课讲义的脚注说 MIT 数学系还挂着他的画像)给出了严格的数学构造,所以布朗运动也叫维纳过程,记作 。
一个随机过程 是一族随机变量:每个 都是随机变量,每抽一次,就得到一整条随机轨迹 。同一个随机过程模拟两次,会得到两条不同的轨迹。
布朗运动 是这样一个随机过程:,轨迹 连续,并且
- 正态增量:对任意 ,,增量的方差随时间间隔线性增长;
- 独立增量:对任意 ,增量 相互独立。
模拟它很容易:取步长 ,令 ,
由于高斯增量的和仍是高斯、方差恰好相加,这个模拟在格点上是精确的,不是近似。04 号脚本第 1 部分用 2 万条路径()检查定义:
| 时刻 | 均值(应为 0) | 方差 | 理论方差 |
|---|---|---|---|
| −0.0008 | 0.0990 | 0.1 | |
| −0.0004 | 0.2513 | 0.25 | |
| −0.0069 | 0.4981 | 0.5 | |
| −0.0083 | 0.9958 | 1 |
另外,(理论值 : 等于 加上一段独立的新增量,两者共享的只有前 0.3 的部分);前后两半增量的相关系数 (理论值 0)。
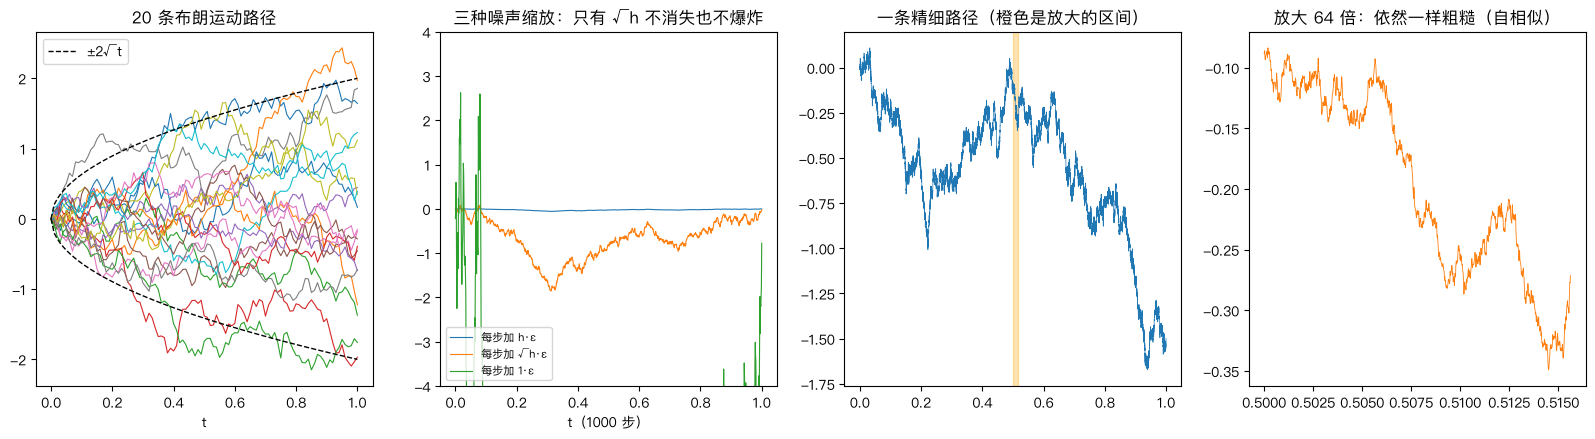
(左一:20 条路径与 包络;左二:三种噪声缩放;右两张:一条精细路径和它被放大 64 倍的一小段。)
原课讲义说:“布朗运动之于随机过程,就像高斯分布之于概率分布。“它的应用远远超出机器学习:金融里用它给复杂金融产品定价,统计物理、流行病学里也处处是它。
4.2 为什么噪声要乘以
这是初学者最常问的问题:为什么是 ,而不是 ?04 号脚本第 2 部分做了一个对照:用 步走完 ,每步加 ,比较三种 :
| 步数 | : | : | : |
|---|---|---|---|
| 10 | 0.0982 | 0.9818 | 9.8 |
| 100 | 0.0099 | 0.9944 | 99.4 |
| 1,000 | 0.0010 | 1.0142 | 1014.2 |
| 10,000 | 0.0001 | 1.0300 | 10299.6 |
道理一句话:独立噪声相加时,方差相加。 步、每步方差 ,总方差 。
- :总方差 。步长越小,噪声被平均得越干净,极限下什么也不剩,退化成 ODE。
- :总方差 。步长越小,噪声越大,极限下爆炸。
- 只有 ,即 ,才能让”单位时间内的噪声总量”与步长无关。这是唯一”既不消失也不爆炸”的缩放。
确定性的漂移按 缩放,随机的噪声按 缩放:这是整个随机微积分的起点。
4.3 粗糙的路径:处处不可导,长度无限
缩放有一个惊人的推论:每一小段的增量 远大于 ,所以”速度” 。布朗运动的路径处处连续,却处处不可导。
04 号脚本第 3 部分在一条非常精细的路径( 步)上,用越来越细的网格测量两个量,并和光滑曲线 对照:
| 小段数 | 布朗: | 理论 | 布朗: | : | : |
|---|---|---|---|---|---|
| 16 | 3.75 | 3.19 | 1.2579 | 4.0000 | 1.2 |
| 256 | 13.04 | 12.77 | 1.0099 | 4.0000 | 7.7e−2 |
| 4,096 | 51.88 | 51.06 | 1.0319 | 4.0000 | 4.8e−3 |
| 65,536 | 204.29 | 204.26 | 0.9975 | 4.0000 | 3.0e−4 |
- 总长度(总变差) 按 无限增长:原课讲义的说法是,布朗运动的路径连续(你可以一笔画出它),却无限长(你永远画不完)。光滑曲线的总长度则收敛到 4。
- 平方和(二次变差) 收敛到 ;光滑曲线的平方和收敛到 0。
第二条可以简写成 ""。普通微积分里 是可以忽略的高阶小量,但对布朗运动, 和 同阶,不能忽略。这就是伊藤公式比普通链式法则多出一项的根源,也是第 3 讲 Fokker–Planck 方程里那个二阶导数项(扩散项)的来历。这门课不会系统地讲伊藤积分,但请记住这个直觉。
4.4 布朗运动是”一切微小独立扰动”的极限
为什么说布朗运动是”连续的随机游走”?04 号脚本第 4 部分让每一步只能是 (抛硬币,各一半概率),看 的分布:
| 步数 | 1 | 4 | 16 | 64 | 256 | 4096 |
|---|---|---|---|---|---|---|
| 与 的 KS 距离 | 0.342 | 0.189 | 0.099 | 0.050 | 0.026 | 0.0075 |
每一步根本不是高斯,但走很多步以后, 的分布越来越接近 (中心极限定理)。Donsker 定理进一步说,整条路径都收敛到布朗运动。不管单步的扰动长什么样,只要它们独立、均值为零、方差按 缩放,累积起来都是布朗运动。这就是它在物理、金融和生成模型里无处不在的原因。
4.5 从 ODE 到 SDE
现在把随机性加进 ODE。困难在于:布朗运动处处不可导,所以 SDE 不能像 ODE 那样用导数 来写。原课讲义的办法是:先把 ODE 改写成不用导数的形式。
由导数的定义,
其中 (当 )。最后这种”无穷小更新”的写法只是换了一种说法:ODE 的轨迹在每个时刻都朝 方向走一小步。现在给这一小步加上一份布朗运动的贡献:
这里 叫扩散系数(diffusion coefficient), 叫漂移系数(drift coefficient);误差项满足 时其标准差趋于零。这就是一个随机微分方程(stochastic differential equation, SDE),通常写成符号形式:
请始终记住,""只是上面那个无穷小更新式的简写,不是对 求导。和 ODE 一样,SDE 的解也存在且唯一:
定理 5(SDE 解的存在唯一性):如果 连续可微且导数有界, 连续,那么 SDE 有唯一的解,即满足上面无穷小更新式的随机过程 。
如果这是一门随机微积分课,证明这个定理要花好几讲(从头构造布朗运动、构造伊藤积分)。这门课把它当作工具直接用。
两点重要区别:
- SDE 没有流映射。 不再由 唯一决定,因为演化过程本身是随机的。
05号脚本第 5 部分:5 个粒子都从 出发(OU 过程,见 §4.7), 时分别在 +0.25、−0.50、+0.52、+1.16、+0.24;400 个排好序的起点,ODE 的终点顺序一对都没变,SDE 的 399 对相邻粒子里有 200 对颠倒,几乎完全打乱。轨迹可以交叉,但分布仍然是确定的。 - 每个 ODE 都是 的 SDE。所以从现在起说”SDE”时,总把 ODE 当作特例包含在内。
4.6 欧拉–丸山法
如果你觉得 SDE 的抽象定义难以捉摸,原课讲义建议换个角度:它怎样模拟? 最简单的方法叫欧拉–丸山法(Euler–Maruyama),它之于 SDE 就像欧拉法之于 ODE:
也就是:朝 走一小步,再加一点按 缩放的高斯噪声。这门课(包括 Lab)模拟 SDE 时基本都用它。
class EulerMaruyamaSimulator(Simulator):
    def step(self, x, t, h):
        eps = torch.randn(x.shape, generator=self.generator, dtype=x.dtype)
        return x + h * self.sde.drift(x, t) + math.sqrt(abs(h)) * self.sde.diffusion(x, t) * eps
05 号脚本第 1 部分验证: 时,欧拉–丸山法和欧拉法的结果逐位相同。代码上它只比欧拉法多了一项。
离散化误差。和欧拉法一样,步长太大时欧拉–丸山法也有偏差,§4.7 会在 OU 过程上精确地算出它。
4.7 Ornstein–Uhlenbeck 过程(原课 Example 6)
取常数扩散系数 和线性漂移 :
它的解叫 Ornstein–Uhlenbeck(OU)过程。直觉上,漂移 像一根弹簧,总把粒子拉回原点;噪声 不停地把它踢开。 时就是 §2.4 的线性流。
均值与方差。从 出发:
均值的公式很好理解:对 SDE 两边取期望,噪声项的期望为零,剩下的就是 ODE 。方差的公式可以用”被弹簧衰减的踢击”来理解:时刻 的一小份噪声 (方差 ),到时刻 被弹簧衰减成原来的 倍,方差变成 ;各个时刻的踢击相互独立,方差相加:
05 号脚本第 2 部分(,,从 出发,2 万条路径,):
| 时刻 | 模拟均值 | 闭式 | 模拟方差 | 闭式方差 |
|---|---|---|---|---|
| 6.2321 | 6.2304 | 0.7905 | 0.7869 | |
| 4.8542 | 4.8522 | 1.2430 | 1.2642 | |
| 2.2798 | 2.2920 | 1.8561 | 1.8358 | |
| 0.6554 | 0.6567 | 1.9874 | 1.9865 | |
| 0.0584 | 0.0539 | 2.0142 | 1.9999 |
平稳分布。 时,均值衰减到 0,方差饱和在 :不管从哪里出发,OU 过程最终都”忘掉”了起点,收敛到同一个分布
一个分布如果”从它出发,永远服从它”,就叫平稳分布。早期( 小)方差 ,和布朗运动一样增长;后期弹簧的回拉抵消了噪声的扩散,方差不再增长。
平稳分布只由 决定(原课 Lab 1 第 2.2 题的提示)。05 号脚本第 3 部分让起点均匀铺在 ,在 9 种 组合下模拟 的时间:
| 弛豫时间 | 终点标准差 | ||||
|---|---|---|---|---|---|
| 0.25 | 1 / 2 / 10 | 2 / 8 / 200 | 0.5 / 0.125 / 0.005 | 0.503 | 0.500 |
| 1 | 1 / 2 / 10 | 0.5 / 2 / 50 | 2 / 0.5 / 0.02 | 1.007 | 1.000 |
| 4 | 1 / 2 / 10 | 0.125 / 0.5 / 12.5 | 8 / 2 / 0.08 | 2.013 | 2.000 |
同一个 下,三种 的终点标准差完全相同,都 。 和 同时变大,只是让过程更快地到达同一个平稳分布(弛豫时间 变短)。三行数字完全相同并非巧合:把时间按 缩放后,三个过程就是同一个过程。脚本取步长 ,欧拉–丸山的递推式都化成 ,又用了同一串随机数。
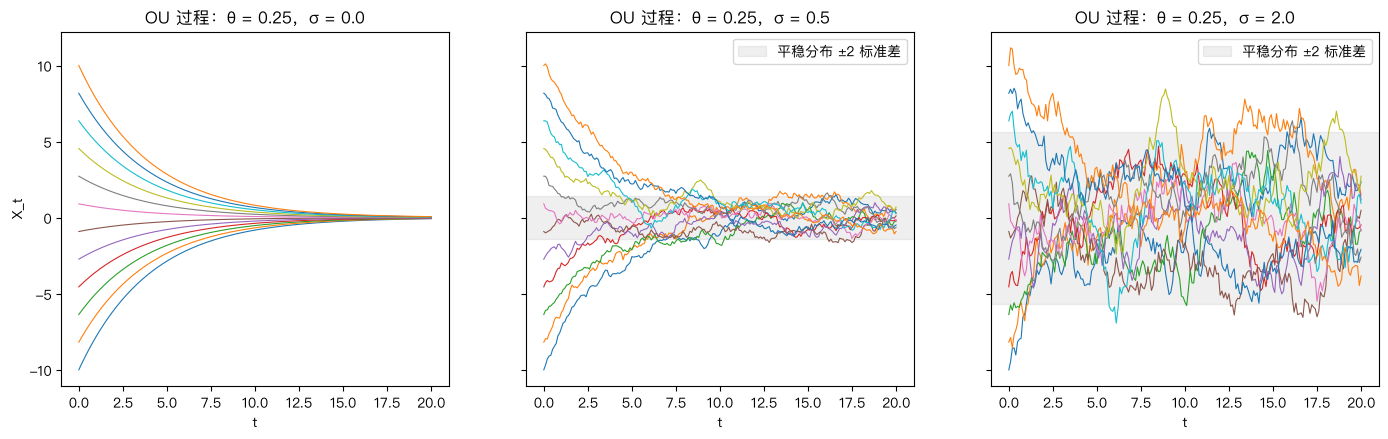
(仿原课讲义 Figure 3:, 从左到右增大。 是光滑的确定性轨迹,收敛到原点; 时轨迹随机,最终在平稳分布的范围内游走。)
欧拉–丸山法的离散化误差。对 OU 过程,欧拉–丸山的递推是 。设它的平稳方差为 ,两边取方差得 ,解出
比真值大一个约 的相对误差。另一方面,线性 SDE 的转移分布 是高斯,均值和方差有闭式,所以可以精确模拟:。05 号脚本第 4 部分(,,真值 ):
| 步长 | 1 | 0.5 | 0.2 | 0.1 | 0.01 |
|---|---|---|---|---|---|
| 欧拉–丸山:平稳方差 | 2.030 | 1.350 | 1.110 | 1.054 | 0.996 |
| 公式 | 2.000 | 1.333 | 1.111 | 1.053 | 1.005 |
| 精确转移:平稳方差 | 1.013 | 1.015 | 0.998 | 1.002 | 0.991 |
(最后一行与 1 的差别、以及 时欧拉–丸山与公式的差别,都是 2 万个样本的抽样误差,量级约 0.01。)
“线性 SDE 可以一步到位、毫无误差地采样”这件事,在第 2 讲会变得至关重要:高斯概率路径让我们在训练时直接写出任意时刻的 ,完全不用模拟微分方程。
📌 代码 04、05:
python3 04_brownian_motion.py、python3 05_sde_and_ou.py。
5. 扩散模型 · Diffusion models
5.1 定义(原课 Summary 7)
现在可以像流模型那样,用 SDE 构造生成模型了:从 随机初始化,模拟一个 SDE,并用神经网络参数化它的核心部分,即漂移(向量场):
原课讲义把它总结成:扩散模型由一个参数化向量场的神经网络 和一个固定的扩散系数 组成:
- 神经网络:,,参数为 ;
- 固定(不学习):,。
目标仍然是 。 的扩散模型就是流模型。
5.2 采样算法(原课 Algorithm 2)
Algorithm 2  用欧拉–丸山法从扩散模型采样
输入:神经网络 u^θ,步数 n,扩散系数 σ_t
1: t ← 0,h ← 1/n
2: 抽一个样本 X_0 ~ p_init
3: for i = 1, ..., n:
4:     抽一个样本 ε ~ N(0, I_d)
5:     X_{t+h} ← X_t + h · u^θ_t(X_t) + σ_t · √h · ε
6:     t ← t + h
7: return X_1
和 Algorithm 1 相比只多了第 4 行和第 5 行末尾的噪声项。和流模型一样,向量场没训练时它只会产生胡言乱语:06 号脚本第 3 部分里,“未训练网络 + 噪声 “的能量距离是 1.2771,88.6% 的样本落在峰之间。
到这里,本讲的”机器”就造好了。剩下两个问题留给后面几讲:向量场怎样训练(第 2、3 讲),以及** 该怎样选、为什么要选非零的 **(第 3 讲)。本节余下的部分做两件事:用原课 Lab 1 的朗之万动力学,看看”漂移 + 噪声”到底能把分布带到哪里;再用一个预告实验,说明”给流模型加噪声”为什么不能随便加。
5.3 朗之万动力学:用得分函数采样
得分函数(score function)是对数密度的梯度 。它指向”密度增加最快”的方向:在一个高斯 里,,是一支指向均值的箭头;在高斯混合里,它是各成分箭头按”这个点属于哪个成分”的后验概率加权平均(distributions.GaussianMixture.score)。原课 Lab 1 的第 3 部分用它构造了**(过阻尼)朗之万动力学**(Langevin dynamics):
漂移沿着得分函数往”密度更高”的方向爬坡,噪声防止所有粒子都挤到峰顶。两者的比例恰好是 时, 就是这个 SDE 的平稳分布:从 出发的粒子永远服从 ,从别的分布出发的粒子(在一定条件下)会逐渐接近 。第 3 讲会用 Fokker–Planck 方程证明这一点;这里先用实验来感受。
OU 过程就是高斯分布的朗之万动力学(原课 Lab 1 第 3.2 题)。取 ,它的得分是 ,乘以 恰好是 。所以朗之万动力学就是 OU 过程,§4.7 的平稳分布 就是 本身。06 号脚本第 1 部分用自动求导验证:得分与公式的最大差 ,两种漂移的最大差 。
一个有用的观察:令 ,朗之万动力学变成 。 只决定时钟走多快,不改变粒子经过的分布序列。这和 §4.7 里”同一个 、不同 只是时间缩放”是同一回事。
实验:朗之万动力学采样五峰分布。06 号脚本第 2 部分从一团宽高斯 出发(,步长 0.005),用五峰分布的精确得分函数做朗之万动力学:
| 时刻 | 能量距离 | 权重误差 TV | 峰内散度 | 落在峰之间 | 各峰比例 |
|---|---|---|---|---|---|
| 0.5976 | 0.197 | 5.83 | 76.9% | 0.19/0.22/0.20/0.20/0.20 | |
| 0.3254 | 0.193 | 1.53 | 4.6% | 0.19/0.22/0.20/0.19/0.20 | |
| 0.3019 | 0.193 | 1.00 | 0.1% | 0.19/0.22/0.20/0.19/0.20 | |
| 0.2983 | 0.193 | 0.99 | 0.1% | 0.19/0.22/0.20/0.19/0.20 | |
| 0.3014 | 0.193 | 0.98 | 0.1% | 0.19/0.22/0.20/0.19/0.20 |
(真实权重 0.35/0.25/0.20/0.12/0.08。)
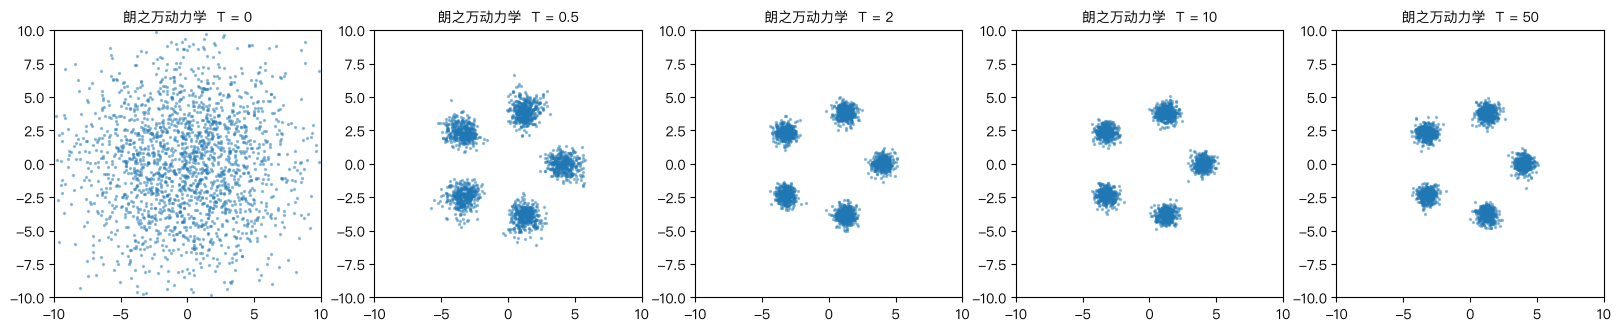
形状对了,权重错了,而且等多久都不会变好。 时,每个峰的形状已经完美(峰内散度 1.00,峰之间几乎没有样本),但五个峰各分到约 1/5 的样本,权重误差 0.193;一直到 都纹丝不动。
为什么?把噪声去掉、只沿得分函数爬坡,看初始粒子各落进哪个峰的”吸引域”:比例是 0.19/0.22/0.20/0.20/0.20,和朗之万动力学的最终比例(0.19/0.22/0.20/0.19/0.20)几乎一模一样,只差一个舍入位。也就是说,每个粒子基本就待在一开始所在的吸引域里。要从一个峰跳到另一个峰,粒子得逆着得分函数爬过峰与峰之间的”势垒”:那里的密度比峰顶低约 倍(§1.3),而跨越势垒的速率大致正比于 ( 是对数密度的落差),即约 量级。由上面” 只是时钟”的观察,把 调大也无济于事。
作为对照,两个互相重叠的峰(中心相距 1.6、标准差 0.6、权重 0.7/0.3),同样的朗之万动力学在 、2、10 时左峰的比例是 0.528、0.604、0.706,能量距离从 0.64 降到噪声水平:没有势垒时,它很快就把权重调对。
教训:朗之万动力学理论上总会收敛到 ,但对分得很开的多峰分布,需要的时间长到不现实。真实图像分布正是高度多峰、峰与峰之间几乎为零的。这就是为什么扩散模型不直接对 做朗之万动力学,而是走一条随时间变化的路径。
5.4 预告:给流模型加噪声,需要一个修正项
假设我们已经有一个完美的流模型(这里用 §3.5 的理想向量场 )。能不能直接给它加点噪声,变成一个扩散模型?06 号脚本第 3 部分从同一批 噪声出发,用 1000 步从 模拟到 :
| 采样方式 | 能量距离 | 权重误差 TV | 峰内散度 | 落在峰之间 | 各峰比例 |
|---|---|---|---|---|---|
| 未训练网络 + 噪声 | 1.2771 | 0.213 | 4.56 | 88.6% | 0.20/0.19/0.21/0.19/0.21 |
| 理想流模型(ODE,) | 0.0026 | 0.013 | 1.00 | 0.1% | 0.34/0.24/0.21/0.12/0.09 |
| 理想流模型 + 噪声 (不修正) | 0.0637 | 0.053 | 2.11 | 17.3% | 0.31/0.24/0.21/0.14/0.11 |
| 理想流模型 + 噪声 + 修正项 | 0.0069 | 0.016 | 1.00 | 0.1% | 0.34/0.25/0.21/0.12/0.08 |
| 理想流模型 + 噪声 + 修正项 | 0.0019 | 0.015 | 0.99 | 0.1% | 0.34/0.25/0.20/0.13/0.09 |
| 理想流模型 + 噪声 + 修正项 | 0.0043 | 0.018 | 1.01 | 0.0% | 0.35/0.24/0.20/0.14/0.08 |
| 朗之万 ,只用 的得分 | 0.2818 | 0.187 | 0.99 | 0.0% | 0.21/0.20/0.20/0.20/0.18 |
其中”修正项”是 , 是 §3.5 那条分布路径在 时刻的分布。也就是说,修正后的 SDE 是
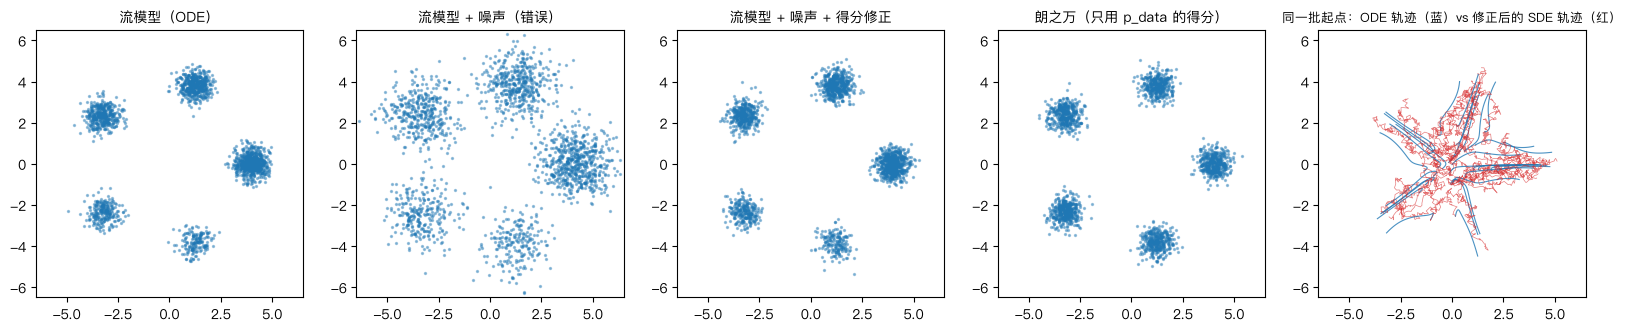
(从左到右:理想流模型;直接加噪声(错误,样本被吹散);加噪声并修正;对 做朗之万动力学(形状对、权重错);同一批起点的 ODE 轨迹(蓝)和修正后的 SDE 轨迹(红)。)
三个观察:
- 直接加噪声是错的。样本被吹散:峰内散度 2.11,17% 落在峰之间。噪声把粒子推离了预定的分布路径 ,而向量场 只会”按 的样子”搬运粒子,不会把跑偏的粒子拉回来。
- 加上沿得分函数的修正项后,、1、2 都重新得到正确的分布,连权重都对。修正项的形式和朗之万动力学的漂移一模一样(),只是把固定的 换成了随时间变化的 :它恰好抵消噪声的扩散效应,把粒子”留在”路径上。同一个终点分布,可以由无穷多个 SDE 实现,这就是第 3 讲的 SDE 扩展技巧(SDE extension trick),它的证明要用到 Fokker–Planck 方程。
- 和 §5.3 对比:同样是”漂移 + 噪声”,对 做朗之万动力学得不到正确的权重,而沿着 走却能。原因是 从一个单峰的高斯出发:在 较小、“五个峰还连在一起”的时候,质量就已经按权重分配好了,之后再逐渐把峰分开。朗之万动力学一上来就面对五个分得很开的峰,再也没有机会重新分配质量。“沿一条从简单到复杂的路径逐步变形”,正是流模型和扩散模型比朗之万动力学高明的地方。
5.5 ODE 还是 SDE?
既然 ODE()已经能精确采样,为什么还要 SDE?原课第 3 讲的 slides 给了几个理由,这里先列出来:理论上所有 都给出同一个分布,但实践中网络有训练误差(学到的 不完美),数值模拟有离散化误差;适当的噪声有时能纠正这些误差。另外,一些下游应用(微调、推理时优化)需要随机的演化过程。不过 slides 也强调了一个好消息:ODE 采样往往就能得到最好的结果,SDE 采样是一个选项,而不是必需品。
📌 代码 06:
python3 06_langevin_and_diffusion_models.py。
6. 全景 · The big picture
6.1 本讲在整门课里的位置
本讲造好了”机器”:
问号是整门课要解决的问题:怎样训练 ,使问号变成等号?本讲的实验已经透露了答案的轮廓:
- 存在一条从 到 的分布路径 ,以及一个让粒子沿着它走的向量场(§3.5)。
- 那个向量场的形式是 :一个条件期望。条件期望可以用回归来学(最小化均方误差的函数就是条件期望),所以训练可以变成一个简单的回归问题,而且不用模拟 ODE。这就是第 2 讲的流匹配。
- 加噪声需要得分函数 (§5.4),它也可以用回归来学。这就是第 3 讲的得分匹配,也是”去噪扩散模型”这个名字的来历。
| 讲次 | 回答的问题 |
|---|---|
| 第 1 讲(本讲) | 有了向量场,怎样生成?(ODE / SDE、模拟) |
| 第 2 讲 | 向量场的训练目标从哪来?(概率路径、边缘化技巧、流匹配) |
| 第 3 讲 | 能不能加噪声?去噪扩散模型是什么?(得分函数、Fokker–Planck、得分匹配) |
| 第 4 讲 | 怎样按提示生成?(无分类器引导) |
| 第 5 讲 | 怎样做出真正的图像生成器?(U-Net、DiT、潜空间、VAE) |
| 第 6 讲 | 离散数据怎么办?(CTMC、掩码扩散语言模型) |
6.2 和其他生成模型的比较
流模型和扩散模型不是唯一的生成模型。原课讲义提醒,“还有许多别的生成模型被提出过(未来也许会有更多)“。从”怎样把噪声变成数据”的角度,可以这样比较:
| 模型 | 从噪声到数据的方式 | 训练目标 | 主要难点 |
|---|---|---|---|
| GAN(生成对抗网络) | 一个网络一步到位 | 和判别器博弈 | 训练不稳定、模式崩塌(只学会几个峰) |
| VAE(变分自编码器) | 解码器一步到位(带隐变量) | 证据下界 ELBO | 样本偏模糊(第 5 讲把它用作压缩器) |
| 归一化流(normalizing flow) | 可逆网络一步到位 | 精确似然(需要雅可比行列式) | 网络必须可逆,表达能力受限 |
| 自回归模型 | 逐个维度 / token 地生成 | 精确似然(交叉熵) | 生成慢;对连续高维数据不自然 |
| 流模型 / 扩散模型 | 沿向量场多步迭代(ODE / SDE) | 对向量场 / 得分做回归(第 2、3 讲) | 采样要调用很多次网络(第 7 讲) |
流模型和扩散模型的优势在于:训练是一个稳定的回归问题(不像 GAN 那样要博弈),网络结构没有限制(不像归一化流那样必须可逆),并且”一步步修正”的生成方式非常适合高维的连续数据。代价是采样要多次调用网络,所以”少步生成”是一个重要的研究方向。
7. 小结 · Summary
- 生成即采样:对象是向量 ;生成就是从 采样;我们只有数据集,没有 的公式。“最可能的样本”不是好的生成:好的生成要同时满足像和多样,“按 采样”把两者都包含了。条件生成就是从 采样。
- 生成模型把简单分布 的样本变成 的样本。一维时这样的映射有公式(逆 CDF),高维时只能学习。
- 向量场、ODE、流是同一个对象的三种描述。向量场 Lipschitz 时,流存在、唯一、可逆,轨迹不交叉;条件不满足时解会爆炸或不唯一。神经网络总满足这个条件。
- 欧拉法是一阶的,Heun 法是二阶的;步长要和向量场的陡峭程度匹配;生成的真正成本是向量场的调用次数。
- 流模型:,。网络参数化的是向量场,不是流;随机性只来自 ;采样就是 Algorithm 1。向量场对了,ODE 就沿着一条分布路径把噪声变成数据;只走一步会塌缩到数据均值。
- 布朗运动:正态独立增量、方差等于时间;噪声必须按 缩放;路径处处不可导、长度无限,但二次变差等于 。
- SDE 是”无穷小更新 + 布朗噪声”的简写;用欧拉–丸山法模拟;SDE 没有流映射,轨迹会交叉,但分布是确定的。OU 过程收敛到 ,平稳分布只由 决定。
- 扩散模型:,, 固定;采样就是 Algorithm 2。朗之万动力学沿得分函数采样,但在分得很开的多峰分布上权重会错。给流模型加噪声需要修正项 (第 3 讲)。
8. 常见误区 · Common pitfalls
- “流模型里的神经网络输出的是生成结果。” 不是。网络输出的是速度(向量场),生成结果要通过多步模拟得到。“流”是模拟出来的,不是网络直接给出的。
- “ODE 是确定的,所以流模型每次生成同一张图。” 流模型的随机性来自随机的起点 :不同的噪声生成不同的样本,同一个噪声永远生成同一个样本。
- “SDE 的噪声项和漂移项一样,按 缩放。” 噪声按 缩放。按 缩放的话,步长趋于零时噪声会消失,SDE 退化成 ODE(§4.2)。
- ” 两边除以 就是导数。” 布朗运动处处不可导, 没有意义。这个式子只是无穷小更新式 的简写。
- “步数越多一定越好。” 步数多到一定程度后,离散化误差就小于其他误差(网络的训练误差、样本的随机波动),再加步数只是浪费算力。§3.6 里 以后的差别已经在噪声地板以内。
- “往一个好的流模型上加噪声,最多让样本稍微模糊一点,不影响大局。” 不加修正项的话,噪声会把粒子系统性地推离概率路径,而且在接近数据时,向量场还会放大这种偏离(§5.4:17% 的样本落在峰之间)。
- “朗之万动力学的平稳分布就是目标分布,所以跑得够久就能采样任何分布。” 理论上是,实践中对分得很开的多峰分布,所需时间长到不现实,粒子困在初始的吸引域里,权重会错(§5.3)。调大 只是让时钟走得快,不解决问题。
- “欧拉–丸山法只要步长小就没有误差。” 它有 的偏差(OU 过程的平稳方差偏大约 );对线性 SDE,可以用精确的高斯转移公式完全避免离散化误差(§4.7)。
9. 练习 · Exercises
练习 1(一般的线性向量场)。设 , 是一个连续函数。写出它的流 ,并验证。如果 , 服从什么分布?
参考答案
。验证:;。所以 ,,。线性向量场只能把高斯缩放成另一个高斯,永远变不出多峰分布:要生成复杂的分布,向量场必须是非线性的。
练习 2(常数向量场)。(常向量)的流是什么?用它做流模型, 会变成什么?
参考答案
,是一个平移。。欧拉法对这个向量场是精确的( 就没有误差),因为轨迹是直线。第 2 讲你会看到,流匹配用的”直线路径”正是想让轨迹尽量直,以减少离散化误差。
练习 3(欧拉法的局部误差)。对 ,计算欧拉法一步的误差 的主项,并据此解释为什么全局误差是 。
参考答案
,所以一步的误差 ,是 。走完 要 步,误差大致累加成 (严格的论证要考虑误差在后续步骤中的传播,对 Lipschitz 向量场它最多被放大 倍,不改变阶数)。
练习 4(旋转场上的欧拉法)。证明对 ,欧拉法每步把半径乘以 。用 步转一整圈(),终点半径是多少? 时呢?Heun 法每步把半径乘以多少?
参考答案
。终点半径 。 时是 6.83(与 02 号脚本一致)。Heun 法一步是 ,其中 ,所以 ,半径的平方乘以 ,每步误差小得多。
练习 5(OU 过程的方差)。用 §4.7 “被衰减的踢击”的思路,推导 OU 过程从 出发时 的公式。再推导:如果 , 是多少? 取多少时它不随时间变化?
参考答案
第一问见 §4.7。第二问:,所以 。它对所有 都等于 ,当且仅当 :这就是平稳分布的方差。
练习 6(欧拉–丸山法的稳定性)。由 §4.7 的公式 ,当 时会发生什么?这和 §2.6 里欧拉法的不稳定性是什么关系?
参考答案
时 ,递推 的确定性部分不再收缩,方差不会收敛到有限值(公式给出负数或无穷大,说明”平稳方差”不存在),数值解发散。它和欧拉法的不稳定是同一个原因:欧拉–丸山法的漂移部分就是欧拉法。
练习 7(高斯的朗之万动力学)。设 。写出它的朗之万动力学,说明它是一个以 为中心的 OU 过程,并求它的平稳分布和弛豫时间。 越大收敛越快吗?
参考答案
,朗之万动力学 ,令 ,就是 的 OU 过程。平稳方差 ,所以平稳分布是 ,与 无关。弛豫时间 : 越大,按”物理时间 “收敛越快;但模拟时为了数值稳定,步长要满足 较小,即 ,所以按步数计并没有变快。这就是” 只是时钟”的含义。
练习 8(最简单的 SDE 扩展技巧)。设 ,于是 (什么都不做)的流模型就是一个”完美”的生成模型, 对所有 成立。(a) 直接加噪声:, 服从什么分布?(b) 加上修正项 后,SDE 是什么? 服从什么分布?
参考答案
(a) :分布被吹散了,错误。(b) ,SDE 变成 ,即 的 OU 过程,它的平稳分布是 。 已经是平稳分布,所以 对所有 成立,。这就是 §5.4 的现象在一维的精确版本:修正项把”加噪声”变成了”在 上做朗之万动力学”。
练习 9(一步生成的塌缩)。§3.6 说欧拉法一步就塌缩到 。(a) 用 验证。(b) 如果改用 Heun 法一步(,两次调用),结果是什么?需要知道 :§3.5 的理想向量场在 时等于 (提示: 时 与 独立)。
参考答案
(a) 。(b) 猜测点 ,;Heun 的结果 :一个以数据均值为中心、标准差减半的高斯。仍然完全没有五峰结构。一两步之内,单纯靠数值方法救不回来,需要第 7 讲那些专门的少步生成方法。
练习 10(编程:四阶龙格–库塔法)。在 sde_lib.py 里仿照 HeunSimulator 写一个 RK4Simulator(经典四阶龙格–库塔法:,,,,)。在 02 号脚本第 2 部分的表格里加一列,验证误差比趋于 16。在 03 号脚本里,同样 16 次调用的 RK4()和 Heun()、欧拉()谁更好?
参考答案(提示)
class RK4Simulator(Simulator):
    def __init__(self, ode):
        self.ode = ode

    def step(self, x, t, h):
        k1 = self.ode.drift(x, t)
        k2 = self.ode.drift(x + 0.5 * h * k1, t + 0.5 * h)
        k3 = self.ode.drift(x + 0.5 * h * k2, t + 0.5 * h)
        k4 = self.ode.drift(x + h * k3, t + h)
        return x + h / 6 * (k1 + 2 * k2 + 2 * k3 + k4)
在 上误差比趋于 16(四阶)。在五峰问题上,同样调用次数时三者都已接近噪声地板,具体谁好请以你的运行结果为准;一般规律是,向量场越光滑、精度要求越高,高阶方法越划算。
练习 11(编程:朗之万动力学的初始化)。修改 06 号脚本第 2 部分,让初始分布换成”全部粒子都在第 4 个峰(权重 0.08)附近”。 时各峰的比例是多少?再把初始分布换成”按真实权重从五个峰里采样”,结果又如何?这说明了什么?
参考答案(提示)
第一种情况,粒子几乎全部留在第 4 个峰,比例约为 0/0/0/0/1:朗之万动力学没能把质量运到其他峰。第二种情况,初始分布已经是 (平稳分布),比例保持在真实权重附近。说明朗之万动力学在多峰分布上的最终结果,主要由初始的质量分配决定,而不是由目标分布决定。流模型 / 扩散模型的概率路径恰好解决了”质量分配”这件事(§5.4 第 3 点)。
10. 延伸阅读 · Further reading
- 原课讲义:Holderrieth & Erives, An Introduction to Flow Matching and Diffusion Models(arXiv:2506.02070;2026 版见课程主页 https://diffusion.csail.mit.edu/ )第 1、2 章,附录 A(概率回顾)。
- 原课 Lab 1:https://github.com/eje24/iap-diffusion-labs (2026 分支,
labs/lab_one.ipynb;答案在solutions/)。强烈建议自己做一遍:欧拉 / 欧拉–丸山模拟器、布朗运动、OU 过程、朗之万动力学。 - 流匹配的系统性综述:Lipman et al., Flow Matching Guide and Code(2024,arXiv:2412.06264),Meta 的流匹配作者们写的教程,配有开源代码库。
- 扩散模型的开山之作:Sohl-Dickstein et al., Deep Unsupervised Learning using Nonequilibrium Thermodynamics(ICML 2015);Ho, Jain & Abbeel, Denoising Diffusion Probabilistic Models(NeurIPS 2020);Song et al., Score-Based Generative Modeling through Stochastic Differential Equations(ICLR 2021,把扩散模型统一到 SDE 框架下)。
- 流匹配的三篇奠基论文(2022–2023 年同时出现):Lipman et al., Flow Matching for Generative Modeling;Liu, Gong & Liu, Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow;Albergo & Vanden-Eijnden, Building Normalizing Flows with Stochastic Interpolants。
- 神经 ODE:Chen et al., Neural Ordinary Differential Equations(NeurIPS 2018),“用神经网络参数化向量场”在深度学习里的起点之一。
- SDE 的入门教材:Särkkä & Solin, Applied Stochastic Differential Equations(Cambridge, 2019,作者主页有免费 PDF),面向工程师,侧重直觉和数值方法;Øksendal, Stochastic Differential Equations(第 6 版,Springer),数学上更严格(原课讲义引用的 SDE 参考书)。
- ODE 数值方法:Hairer, Nørsett & Wanner, Solving Ordinary Differential Equations I(Springer),欧拉、Heun、龙格–库塔与步长控制的经典参考。
- 交互式可视化:slides 里很多动画来自 Mario Gemoll 的 https://mariogemoll.com/flow-matching ,可以在浏览器里拖动参数看流和概率路径的变化。
- 本仓库的相关讲义:CMU10-423 第 7–8 讲从离散时间(DDPM、ELBO)的角度讲扩散模型,CMU10-423 前置讲 P2有 MCMC 与朗之万动力学的另一种讲法。读完本课第 3 讲后再对照阅读,会看到两种视角是同一件事。
11. 下一讲预告 · Next lecture
本讲用一个”作弊”的理想向量场证明了:只要向量场对了,ODE 就能把噪声变成数据;而且那个向量场让粒子沿着一条分布路径 从 走到 。但真实世界里我们不知道 的公式,那个向量场也就算不出来。
第 2 讲流匹配要回答:只有一堆数据样本时,怎样训练 ?答案出奇地简单:
- 对单个数据点 ,构造一条从噪声到 的”条件概率路径”,它对应的”条件向量场”有公式(对直线路径,就是 );
- 边缘化技巧保证:把条件向量场对数据做平均,就得到那个让粒子沿边缘路径 走的向量场(本讲的”理想向量场”就是这么来的);
- 于是训练变成一个回归问题:让 去拟合 。不用模拟 ODE,不用知道 的公式,Stable Diffusion 3 和 Meta Movie Gen 用的就是这个算法。
我们还会认识连续性方程:它是”粒子沿向量场走”和”分布沿概率路径变”之间的桥梁,也是本讲 §3.5 那张表”与 的能量距离始终在噪声地板”背后的数学原因。