对应 Maps to:MIT 6.S184 2025 年 Lecture 5 客座讲座(Benjamin Burchfiel,丰田研究院 TRI)。这次讲座没有公开 slides,本讲依据公开论文写成。 阅读材料:Chi et al. (2023) Diffusion Policy;Florence et al. (2021) Implicit Behavioral Cloning;Shafiullah et al. (2022) Behavior Transformers;Zhao et al. (2023) ACT / ALOHA;Brohan et al. (2023) RT-2;Black et al. (2024) π0;Ross et al. (2011) DAgger。 依据说明:本讲没有原课讲义作为依据。行为克隆、多峰示范、Diffusion Policy 的动作块与滚动执行、π0 的流匹配动作专家,来自上述论文;机器人系统的数字写成”某某报告”。二维”绕障碍”任务、三种策略的对比、观测噪声下的动作块实验是本讲义设计的。结论依赖于这个玩具设定:例如在二维动作上离散化策略表现最好(§2.3),在高维动作上就不是这样(§2.4);有几处结果和我原先的预期不一致(§1.3、§3.2),如实报告。 配套代码 Code:
code/lecture08/(2 个脚本 + 1 个模块;PyTorch + matplotlib;每个脚本 20–26 秒,都完整运行过) 预计阅读时间:3 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 把”模仿人类示范”表述成条件生成:数据是动作,条件是观测;说清行为克隆和它的误差累积问题。
- 解释为什么多峰示范会让均方误差回归失败,以及它只在”观测分辨不出峰”的地方失败。
- 比较表示多峰动作分布的几种办法(离散化、混合高斯、能量模型、扩散 / 流),知道它们在低维和高维动作上的取舍。
- 实现一个流策略,理解”积分一步 = 条件均值 = 回归”。
- 说清 Diffusion Policy 的动作块和滚动执行:一次生成未来 步、执行 步再重新规划;它解决了什么、代价是什么。
- 读懂 π0 这类视觉–语言–动作模型的结构,知道真实机器人评估的难点。
0.2 先修与本讲范围
| 需要的背景 | 在哪里 |
|---|---|
| 条件流匹配、条件生成(类别 → 任意条件) | 第 2 讲 §4、第 4 讲 §1 |
| 一步欧拉 = 条件均值;分界线附近的”中间”样本 | 第 7 讲 §1.1、§1.3 |
| 离散化 + 分类(token)的思路 | 第 6 讲 |
| 回归的最优解是条件期望 | 前置讲 P1 §4.2 |
本讲不涉及机器人学的控制理论(动力学、逆运动学、阻抗控制等),也不涉及强化学习;只讲”从示范中学一个策略”这一件事里生成模型扮演的角色。
0.3 本讲地图 Map
§1  行为克隆:把控制当成条件生成;多峰示范与回归的失败          ← 代码 01
§2  生成式策略:离散化、混合模型、能量模型、扩散 / 流;积分步数    ← 代码 01
§3  动作块与闭环执行:Diffusion Policy                          ← 代码 02
§4  走向大规模:视觉–语言–动作模型、π0、大行为模型;评估
§5  小结   §6  常见误区   §7  练习   §8  延伸阅读   §9  下一讲预告
0.4 任务与记号
| 记号 | 意思 |
|---|---|
| 观测(这里是机器人的位置,可能带噪声;真实系统里是图像、关节角、语言指令) | |
| 动作(这里是一步的位移,长度约 0.15) | |
| 策略:给定观测的动作分布 | |
| , | 动作块的长度(一次生成几步);执行长度(执行几步后重新规划) |
玩具任务(robot_lib.py):一个点状机器人从 出发(),要走到 (距离 < 0.3 算成功),中间有一个半径 1 的圆形障碍。每步移动一个动作,最多 80 步,进入障碍算碰撞。200 条人类示范:一半从左边绕、一半从右边绕,路径是随机宽度的 Bézier 曲线,加一点手抖的噪声。
1. 行为克隆 · Behavior cloning
1.1 把控制当成条件生成
教机器人做事,最直接的办法是示范:人遥控机器人做几百遍,记录下每个时刻的观测 和动作 ,然后训练一个策略去模仿。这叫行为克隆(behavior cloning)。它就是一个监督学习问题:数据集是 对,学 。
换成本课的语言:动作是”数据”,观测是”条件”。第 4 讲里我们学 , 是图像、 是类别;这里学 , 是动作、 是观测。前七讲的全部工具都能直接用。
行为克隆有一个经典的问题:误差累积。策略只在示范走过的状态上训练过;一旦执行时走偏一点,就到了没见过的状态,在那里可能犯更大的错,越走越偏(Ross et al. 2011 证明了误差可以随时间二次增长,并提出用 DAgger——让专家在策略走到的新状态上补充示范——来缓解)。本讲关注另一个问题:示范本身是多峰的。
1.2 多峰示范与回归的失败
人类示范者不是一台确定的机器:同一个情形,这次从左边绕,下次从右边绕。在我们的任务里,起点几乎都在中线上,往左还是往右完全由示范者随机决定:
示范的第一个动作:往左 55%、中间 0%、往右 46%(相对正上方约 ±55°)最常见的做法是用均方误差回归 。它的最优解是条件均值 (P1 §4.2)——两个峰的平均,指向正上方,正对障碍。01 号脚本在起点处向每种策略要 2000 个动作:
| 策略 | 往左(< −20°) | 中间(±20°) | 往右(> 20°) |
|---|---|---|---|
| 回归(均方误差) | 0% | 100% | 0% |
| 离散化 + 分类(24 格) | 56% | 0% | 44% |
| 流策略(积分 10 步) | 53% | 3% | 45% |
回归输出唯一的动作(夹角 −9.8°),另外两种策略都抽出了两个峰。闭环执行 500 次:
| 策略 | 成功 | 碰撞 |
|---|---|---|
| 回归 | 80.2% | 19.8% |
| 离散化 + 分类 | 99.2% | 0.8% |
| 流策略(10 步) | 94.2% | 5.8% |
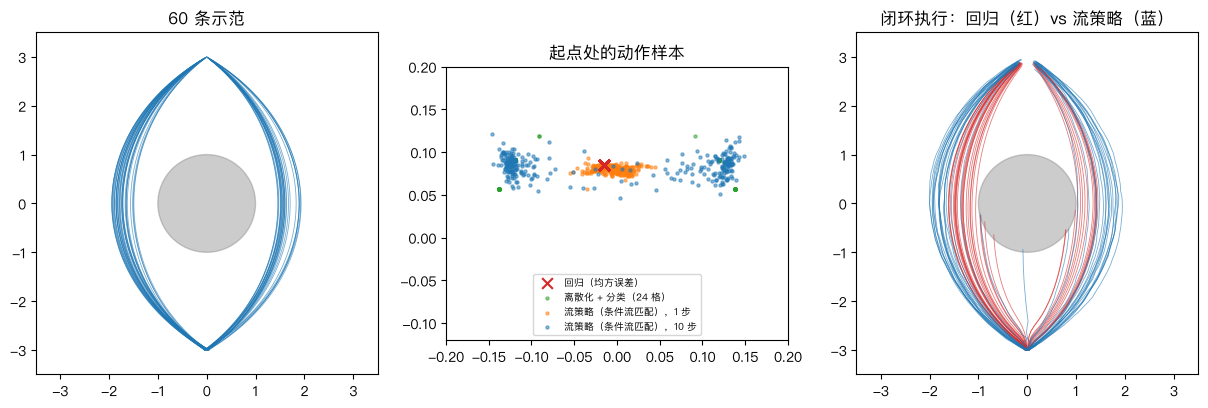
1.3 回归什么时候不失败
一个让我意外的结果:第一版实验让起点在 里随机,回归策略的成功率是 99% 以上(脚本里保留了这个对照:99.8%)。原因是:起点一偏离中线,位置本身就告诉了策略该往哪边绕——右侧起点附近的示范大多往右,条件均值就指向右上方。回归策略的场在中线两侧”分叉”,只要不正好在中线上,就会被推向一边。
所以准确的说法是:多峰只在观测分辨不出峰的地方伤害回归。在真实任务里,这样的地方很多:同一张图像下”先拿杯子还是先拿碗”、“从哪一侧抓”,观测里没有任何线索。把起点收窄到 就是在模拟这种情况。§3 会看到另一种来源:观测有噪声时,“在中线哪一边”本身就是不确定的。
2. 生成式策略 · Generative policies
2.1 怎样表示多峰的动作分布
| 方法 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 离散化 + 分类 | 把动作切成格子,交叉熵学”选哪一格”(RT-1、RT-2 把每一维切成 256 格,当 token 自回归生成) | 简单;天然多峰;能接到语言模型上 | 量化误差;高维时格子数组合爆炸,按维度自回归则 token 很多 |
| 混合高斯 / k-means + 偏移 | 输出 个高斯的权重、均值、方差(BeT 用 k-means 聚类 + 连续偏移) | 一次前向就能采样 | 要预先选;高维时难训练 |
| 能量模型 | 学 ,(Implicit BC) | 任意形状 | 采样要优化 / MCMC,训练不稳定 |
| 扩散 / 流 | 条件生成 (Diffusion Policy、π0) | 任意形状;高维连续动作(动作块)很自然;训练稳定 | 采样要多步积分(推理慢) |
2.2 流策略
流策略就是第 4 讲的条件流匹配,条件换成观测(代码 robot_lib.FlowPolicy):
Algorithm  训练流策略
for 每一步:
    从示范里抽一批 (o, a);ε ~ N(0, I);t ~ U[0, 1]
    x_t = (1 − t) ε + t a
    loss = ‖ u_θ(x_t, t, o) − (a − ε) ‖²

执行:给定观测 o,从 ε ~ N(0, I) 出发,用欧拉法积分 dx/dt = u_θ(x, t, o) 到 t = 1,得到动作
网络就是一个 MLP,输入是”带噪的动作 + 时间 + 观测”。和第 4 讲不同的只有两点:条件 是连续的(不需要类别嵌入);“数据” 是低维的。
2.3 积分步数:一步就是回归
| 流策略的积分步数 | 1 | 2 | 5 | 10 | 50 |
|---|---|---|---|---|---|
| 成功 | 48.4% | 75.6% | 92.8% | 94.2% | 95.8% |
| 碰撞 | 51.6% | 24.4% | 7.2% | 5.8% | 4.2% |
积分 1 步时,流策略就是回归策略: 时 和动作独立,,一步走完是 (第 7 讲 §1.1 的”一步塌缩到均值”)。起点处 89% 的一步样本落在”中间”。实际上它比回归还差(48% vs 80%):网络在 处的误差直接变成了动作误差,而回归网络专门学的就是这个均值。
步数加到 50,成功率 96%。剩下 4% 的碰撞来自”落在两个峰之间”的动作——10 步时起点处仍有 3% 的样本在中间。这正是第 7 讲 §1.3 的分界线问题:从噪声到”左峰 / 右峰”的映射在分界线上是跳变的,有限步的积分和光滑的网络把它抹成了斜坡。
离散化在这里最好(99.2%):它抽出的永远是 24 个方向之一,没有”中间”。在二维动作上,离散化简单又有效。
2.4 为什么大系统还是用扩散 / 流
二维动作只要 24 个格子。真实机器人呢?一个双臂机器人(ALOHA)每一步有 14 个关节;Diffusion Policy、π0 一次生成未来几十步的动作块(§3)——π0 报告的是 50 步。一个动作块是 维。
- 离散化:联合离散化不可能(每维 24 格就是 类);按维度当 token 自回归(RT-2 的做法)要生成 700 个 token,推理慢,而且”先生成第 1 维、再生成第 2 维”的顺序是人为的。
- 混合高斯:700 维的协方差矩阵、要多少个成分?
- 扩散 / 流:维度高一点只是网络的输入输出宽一点,训练目标不变;多峰、维度间的相关性都由生成模型自动处理。
所以 §2.3 的排序(离散化 > 流)是二维玩具的结论,不要推广到高维。
3. 动作块与闭环执行 · Action chunking and receding-horizon control
3.1 Diffusion Policy 的设计
Diffusion Policy(Chi et al. 2023)在”用扩散模型生成动作”之外,还有两个关键设计:
- 动作块(action chunk):一次生成未来 步的动作序列 ,而不是一步。
- 滚动执行(receding horizon):执行动作块的前 步(),然后用新的观测重新生成。论文的典型设置是预测 16 步、执行 8 步。
为什么要一次生成一段?论文给出的主要理由是时间上的一致性:如果每一步独立地从多峰分布里抽样,相邻两步可能抽到不同的峰——这一步”往左”,下一步”往右”,机器人在两个选择之间摇摆。一次抽一整段,这一段属于同一个峰。ACT(Zhao et al. 2023)也独立地提出了动作块,用来减少误差累积。
3.2 实验:观测噪声下的摇摆
02 号脚本让策略看到的位置带有标准差 0.2 的噪声(训练和执行时都有)。起点在中线附近时,策略”看不清自己在中线的哪一边”。动作块策略 ,执行长度 从 1 到 8:
| 策略 | 成功 | 碰撞 | 超时 | 摇摆次数 | 抖动 | 每条轨迹调用策略 |
|---|---|---|---|---|---|---|
| 回归 | 84.2% | 15.8% | 0.0% | 2.52 | 0.025 | 43.6 次 |
| 离散化 + 分类 | 90.8% | 7.4% | 1.8% | 1.60 | 0.034 | 45.7 次 |
| 流策略(单步) | 93.6% | 6.2% | 0.2% | 1.90 | 0.037 | 46.5 次 |
| 动作块, | 90.0% | 9.8% | 0.2% | 2.09 | 0.039 | 45.6 次 |
| 动作块, | 93.2% | 5.6% | 1.2% | 0.66 | 0.025 | 23.9 次 |
| 动作块, | 93.0% | 3.4% | 3.6% | 0.14 | 0.019 | 12.5 次 |
| 动作块, | 88.6% | 2.0% | 9.4% | 0.05 | 0.017 | 6.7 次 |
(“摇摆次数” = 在中线附近、障碍下方时,横向动作改变方向的次数;“抖动” = 相邻两步动作之差的平均长度。)
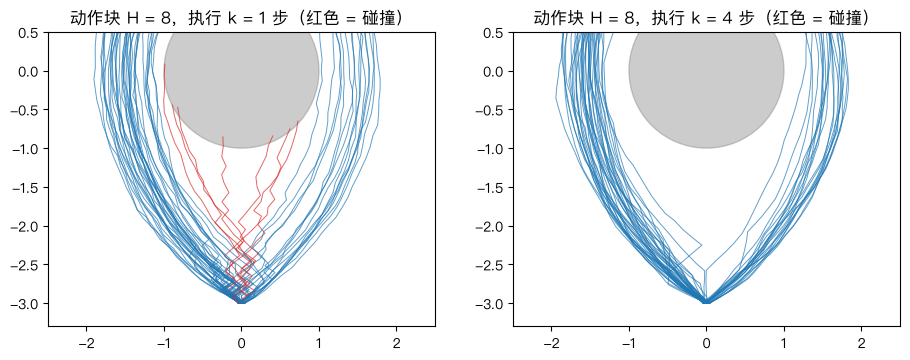
- 动作块消除了摇摆。 从 1 到 8,摇摆从 2.1 次降到 0.05 次,碰撞从 9.8% 降到 2.0%,抖动减半。上图左边()红色的轨迹在障碍正下方来回折返,越靠越近,最后撞上;右边()一出发就决定了方向。
- 开环太久有代价。 时整块开环执行,这 8 步里的新观测被忽略,噪声带来的偏差累积,超时升到 9.4%。–4 的成功率最高,和 Diffusion Policy 的经验(执行一半再重新规划)一致。
- 成功率并没有提高——这一点和我的预期不一样。单步的流策略成功率是 93.6%,动作块最好也是 93.2%。动作块改变的是失败的方式:碰撞从 6.2% 降到 3.4%(),超时从 0.2% 升到 3.6%。对真实机器人,“撞上去”和”慢了一点”的代价完全不同。另外,500 次试验的成功率标准误约 1.1 个百分点(练习 3),93.6% 和 93.0% 之间的差别不显著。
- 推理代价: 时每条轨迹只调用策略约 12 次( 约 46 次),每次 10 步积分。机器人要实时控制,这很重要。
- 没有观测噪声时(脚本第 2 部分), 的摇摆本来就少(0.51 次), 仍然最好(93.0%, 和 约 89%)。还要注意: 的动作块策略在 时(89.6%)比单步流策略(94.2%)差——一次预测 8 步(16 维)更难学,同样的网络和训练步数下每一步都学得差一点。
4. 走向大规模 · Scaling up
4.1 视觉–语言–动作模型
真实机器人的观测是摄像头图像、关节角,还有一句语言指令(“把杯子放进水槽”)。近几年的做法是借用预训练的视觉–语言模型(VLM)来理解观测和指令,再接一个输出动作的”头”:
- RT-2(Brohan et al. 2023):把动作离散化成 token,直接让 VLM 像生成文字一样生成动作(§2.1 第一行)。
- π0(Black et al. 2024,Physical Intelligence):VLM 骨干 + 一个用流匹配训练的”动作专家”。论文报告的设计:动作块长度 50,推理时积分 10 步,训练时对时间 的采样偏向噪声大的一端,数据来自多种机器人、上万小时的示范。这正是本讲的流策略,只是条件从”位置”换成了”VLM 对图像和指令的表示”,动作从 2 维换成了几十维 × 50 步。
π0 的作者解释选择流匹配的理由,和 §2.4 一样:高频、灵巧的控制需要连续、高维的动作块,离散 token 难以胜任。
4.2 大行为模型与评估
TRI(本次客座讲座讲者所在的机构)把 Diffusion Policy 扩展成在大量任务上联合训练的”大行为模型”(LBM),并且特别强调评估的难度:
- 真实机器人上的每一次试验都要人工重置场景,几十次试验就要几个小时;
- 成功率是二项分布的估计,几十次试验的置信区间很宽(练习 3:500 次时标准误约 1 个百分点,50 次时约 3.6 个百分点);
- 场景的微小变化(光照、物体位置)会显著影响结果,需要盲测、随机化顺序等统计设计。
本讲的玩具实验每个设置跑了 500 次,所以能看出 1–2 个百分点的差别是否显著;真实机器人很少有这样的条件。
5. 小结 · Summary
- 行为克隆 = 条件生成:动作是数据,观测是条件。前几讲的条件流匹配可以直接用。
- 多峰示范:均方误差回归输出条件均值,在观测分辨不出峰的地方(起点在中线上)平均出一个错误的动作(20% 碰撞);观测能分辨时(起点范围放宽)回归也能成功。
- 表示多峰分布:离散化(低维时简单有效,本讲 99%)、混合模型、能量模型、扩散 / 流(高维动作块的首选)。
- 流策略积分 1 步 = 条件均值 = 回归;步数越多越好,剩下的错误来自”两个峰之间”的样本。
- 动作块 + 滚动执行(Diffusion Policy):一次生成 步、执行 步。消除了观测不确定时的摇摆,降低了碰撞和推理次数; 太大则对新观测反应迟钝。它改变的是失败的方式,未必提高成功率。
- 大规模:VLM + 离散动作 token(RT-2)或 VLM + 流匹配动作专家(π0);真实世界的评估需要严谨的统计设计。
6. 常见误区 · Common pitfalls
- “多峰示范一定会让回归失败。” 只在观测分辨不出峰的地方失败(§1.3)。
- “生成式策略总比回归好。” 积分 1 步的流策略比回归还差(48% vs 80%,§2.3)。
- “扩散 / 流策略在任何问题上都最好。” 二维动作上离散化更好(§2.3);扩散 / 流的优势在高维动作块(§2.4)。
- “动作块越长、执行越久越好。” 开环太久会忽略新的观测( 超时 9.4%,§3.2)。
- “动作块提高了成功率。” 本讲的实验里它主要把碰撞换成了超时,成功率的差别在噪声内(§3.2)。
- “几十次真实试验的成功率差 5 个百分点就说明方法更好。” 50 次试验的标准误约 3.6 个百分点(§4.2、练习 3)。
7. 练习 · Exercises
练习 1(回归的平均动作)。起点处的示范动作 54.5% 是”往左上 55°“、45.5% 是”往右上 55°“,长度相同。均方误差回归的最优动作指向哪里?和脚本里回归的 −9.8° 对照。
参考答案
条件均值 。横向分量 ,纵向 ,夹角 。脚本里是 −9.8°:示范的绕行宽度、速度、起点都有随机性,“55°“只是近似。无论哪个数,都是”几乎正上方”,正对障碍;动作的长度也只有 倍——平均把动作”缩短”了,因为两个方向的横向分量互相抵消。
练习 2(一步流策略 = 回归)。证明 CondOT 流策略积分 1 步的输出是 。为什么实际训练出来的一步流策略比专门训练的回归策略还差?
参考答案
时 与 独立(给定 ),条件向量场 的条件期望是 ,一步欧拉 。实际中:流匹配网络要在所有 上学向量场, 只是其中一小部分,那里的精度不如专门回归 的网络;而且一步时网络的任何误差都没有后续步骤来修正。起点处一步样本的方向分布(往左 9%、中间 89%、往右 2%)说明网络在 处还残留着对 的依赖。
练习 3(成功率的置信区间)。500 次试验成功 465 次(93.0%)。成功率的标准误是多少?93.0% 和 93.6% 的差别显著吗?如果只做 50 次试验呢?
参考答案
标准误 ,95% 置信区间约 ±2.2 个百分点;两个成功率的差 0.6 个百分点远在噪声内(差的标准误约 个百分点)。50 次试验时标准误约 3.6 个百分点,95% 置信区间约 ±7 个百分点——真实机器人论文里常见的”20 次试验,成功率 85% vs 75%“往往不能说明什么。
练习 4(编程:示范的数量)。用 25、50、100、200 条示范分别训练回归策略和流策略(无观测噪声),比较成功率。
参考答案(作者机器上的结果)
| 示范条数 | 25 | 50 | 100 | 200 |
|---|---|---|---|---|
| 回归:成功 | 78.8% | 83.0% | 73.2% | 80.2% |
| 流策略(10 步):成功 | 96.4% | 96.8% | 95.2% | 94.2% |
更多的示范救不了回归:它的问题是”偏差”(最优解本身就是两个峰的平均),不是”方差”(数据不够);成功率在 73–83% 之间随机波动。流策略 25 条示范就够了——这个任务太简单。在真实任务里,示范的数量当然重要,但这个实验说明:表示能力不对时,加数据没有用。
练习 5(编程:Diffusion Policy 的默认设置)。在 02_action_chunks.py 的观测噪声设置下,用 的动作块,执行 。和 比呢?
参考答案(作者机器上的结果)
| ,执行 | 1 | 4 | 8 | 16 |
|---|---|---|---|---|
| 成功 | 82.8% | 89.0% | 84.6% | 74.2% |
| 碰撞 / 超时 | 16.0% / 1.2% | 7.2% / 3.8% | 6.6% / 8.8% | 14.8% / 11.0% |
| 摇摆次数 | 2.25 | 0.25 | 0.12 | 0.25 |
每个 都比 差(、:93.0%)。一次预测 16 步(32 维)更难学; 时开环 16 步,噪声带来的偏差累积得更多。Diffusion Policy 的”预测 16、执行 8”是在真实机器人、更大的网络和更多数据上调出来的;在这个小问题和小网络上, 更合适。 和 都是要按任务调的超参数。
练习 6(思考:推理延迟)。一个机器人以 50 Hz 控制(每 20 毫秒一个动作)。策略每次推理要 10 步积分,每步网络前向 15 毫秒。单步策略()能实时运行吗?动作块()呢?第 7 讲的哪些方法能帮忙?
参考答案
单步策略每个动作要 150 毫秒推理,远超 20 毫秒,不能实时。动作块 每次推理覆盖 1 秒的动作;执行前 25 步(0.5 秒)再重新规划,推理有 0.5 秒的预算,绰绰有余(还可以在执行当前块时并行计算下一块)。第 7 讲的少步方法(一致性蒸馏、MeanFlow、reflow)能把 10 步降到 1–2 步,让更小的 (更强的闭环)也能实时;代价是 §2.3 那样的”中间”样本可能增多。
练习 7(思考:误差累积)。行为克隆的误差为什么会随时间累积?动作块对误差累积是有利还是有害?
参考答案
策略只在示范的状态分布上训练;执行时一步走偏,就进入示范很少覆盖的状态,那里策略更不准,下一步偏得更多——误差可以随步数二次增长(Ross et al. 2011)。动作块的作用是双向的:一段动作内部是连贯的(不会因为每步独立抽样而摇摆进奇怪的状态),ACT 的作者认为这减少了”有效的决策次数”,从而减轻累积;但开环执行期间无法纠正偏差, 太大时偏差会在块内累积(§3.2 的超时)。
8. 延伸阅读 · Further reading
- Chi et al., Diffusion Policy: Visuomotor Policy Learning via Action Diffusion(RSS 2023;IJRR 2024 扩展版)。
- Florence et al., Implicit Behavioral Cloning(CoRL 2021):能量模型策略,以及多峰示范对回归的伤害。
- Shafiullah et al., Behavior Transformers: Cloning k Modes with One Stone(NeurIPS 2022)。
- Zhao, Kumar, Levine & Finn, Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(ACT / ALOHA,RSS 2023):动作块。
- Brohan et al., RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control(2023)。
- Black et al., π0: A Vision-Language-Action Flow Model for General Robot Control(2024)。
- Octo Model Team, Octo: An Open-Source Generalist Robot Policy(2024):开源的扩散动作头。
- Ross, Gordon & Bagnell, A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning(DAgger,AISTATS 2011)。
- TRI LBM Team, A Careful Examination of Large Behavior Models for Multitask Dexterous Manipulation(2025):大规模扩散策略与评估方法。
9. 下一讲预告 · Next lecture
到这里,数据都”住在”欧氏空间或离散空间里。有些数据不是:一个旋转不能”加一半”,角度绕一圈回到原处,蛋白质骨架的每个残基是一个”刚体框架”(旋转 + 平移)。第 9 讲问:
- 数据在一个弯曲的空间(流形)上时,“从噪声到数据的直线路径”是什么?——测地线。
- 流匹配怎样推广到圆周 、旋转群 ?——黎曼流匹配:速度在切空间里,沿测地线插值,用指数映射走一步。
- 以蛋白质结构生成为例,看这些数学工具在 FrameDiff、FoldFlow 等方法里怎样用(只讲生成建模的数学,不涉及具体的生物功能设计)。