对应 Maps to:本讲不对应原课的某一次正课。MIT 6.S184 2026 年的课程概览里预告过”distilled models”,但最后一讲实际只讲了离散扩散(第 6 讲),这一部分没有讲。这里按公开论文补上。 阅读材料:Liu, Gong & Liu (2023) Rectified Flow;Luhman & Luhman (2021) Knowledge Distillation in Iterative Generative Models;Salimans & Ho (2022) Progressive Distillation;Song et al. (2023) Consistency Models;Frans et al. (2025) Shortcut Models;Geng et al. (2025) Mean Flows;Yin et al. (2024) Distribution Matching Distillation;Boffi, Albergo & Vanden-Eijnden (2025) Flow Map Matching。 依据说明:本讲没有原课讲义作为依据。各方法的定义和算法来自上述论文,并统一翻译成本课的记号( 是噪声、 是数据;一致性模型和 MeanFlow 的论文用的是相反的方向,§3.3、§4.1 写明了翻译方法)。“精确流映射与局部拉伸""不直度按时间分布""按离分界线的远近分析一步错误""完美老师 vs 网络老师""MeanFlow 的 s ≠ t 比例”等实验是本讲义设计的。它们都在二维五峰分布上做,结论依赖于这个玩具设定:例如”一步方法的错误集中在峰与峰的分界线附近”在多峰分得很开的数据上最明显;论文里的大规模结论写成”某某报告”。 配套代码 Code:
code/lecture07/(4 个脚本 + 1 个模块;PyTorch + matplotlib;每个脚本 5–42 秒,都完整运行过) 预计阅读时间:4 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 解释为什么即使向量场完美,少步采样也会出错:一步欧拉塌缩到数据均值;高阶求解器在步数极少时反而更差;轨迹的弯曲集中在开头。
- 说清流映射 是什么、为什么所有少步方法都在学它的一部分;理解它在多峰数据上是”分片”的,在分界线附近拉伸极大。
- 写出 Rectified Flow / reflow 的算法,解释为什么在 ODE 配对上重新做流匹配能把轨迹拉直。
- 写出直接蒸馏、渐进式蒸馏、一致性蒸馏 / 一致性训练的损失,理解一致性模型的多步采样。
- 从平均速度的定义推导 MeanFlow 恒等式,用雅可比–向量积实现它的训练目标。
- 比较各种少步方法:要不要老师、训练代价、一步和多步的质量;知道分布层面的蒸馏(DMD、对抗蒸馏)是另一条路线。
0.2 先修与本讲范围
| 需要的背景 | 在哪里 |
|---|---|
| 流模型、欧拉法、“一步塌缩到数据均值” | 第 1 讲 §3 |
| CondOT 路径、条件 / 边缘向量场、条件轨迹交叉而边缘轨迹不交叉 | 第 2 讲 §2–§3 |
| 调度与轨迹弯曲、少步质量的比较 | 第 2 讲 §6.2 |
| 高斯混合的精确边缘向量场(oracle) | 第 2 讲 gmm_oracle.py |
| 雅可比矩阵、方向导数 | 前置讲 P1 §5 |
本讲只讲连续空间(流模型)的少步方法。第 6 讲的掩码扩散也有”步数少就出错”的问题,原因不同(并行解码),不在这里重复。
0.3 本讲地图 Map
§1  为什么少步会错:一步塌缩、高阶求解器、流映射、轨迹的弯曲           ← 代码 01
§2  把轨迹拉直:Rectified Flow 与 reflow                                ← 代码 02
§3  学流映射(一):直接蒸馏、渐进式蒸馏、一致性模型                     ← 代码 03
§4  学流映射(二):平均速度与 MeanFlow;Shortcut 模型                   ← 代码 04
§5  另一条路线:分布层面的蒸馏(DMD、对抗蒸馏)
§6  全景
§7  小结   §8  常见误区   §9  练习   §10 延伸阅读   §11 下一讲预告
0.4 记号 Notation(新增的部分)
| 记号 | 意思 |
|---|---|
| 流映射:在时刻 位于 的粒子,沿 ODE 走到时刻 的位置 | |
| 一步映射:“无穷多步”会把噪声 送到哪里 | |
| 不直度 | |
| 一致性函数:(轨迹的终点) | |
| 平均速度:,于是 | |
| NFE | 网络前向次数(number of function evaluations) |
考场。全讲用第 1 讲的五峰分布(五个标准差 0.4 的小高斯排在半径 4 的圆上,权重 0.35 / 0.25 / 0.20 / 0.12 / 0.08)和 CondOT 路径。它的边缘向量场有闭式解,所以能算出精确的流映射——这是所有少步方法想逼近的东西。三把尺子:能量距离(越小越好;真样本之间约 −0.0015)、峰权重的 TV(真样本 0.011)、落在峰之间的比例(真样本 0.1%)。
1. 为什么少步会错 · Why few steps fail
1.1 一步欧拉:沿切线走一整步
流模型的采样是解 ODE 。欧拉法每一步沿当前的速度走一条直线。如果真实轨迹是弯的,直线就会偏离。步数越少,偏离越大。
最极端的情况是一步。对 CondOT 路径, 时 和数据 独立,所以边缘速度
一步走完就是 :所有样本都落在数据的均值上。01 号脚本用精确的向量场验证:4000 个样本的均值 (0.7724, 0.8348) 等于数据均值,标准差 。向量场是完美的,错的是”沿 的切线走一整步”——这时粒子还没”决定”去哪个峰,速度指向所有峰的平均。
1.2 高阶求解器救不了”步数极少”
把欧拉换成二阶的 Heun 法(每步 2 次前向)。同样的前向次数下(01 号脚本第 1 部分;能量距离 / TV / 峰之间):
| 前向次数 | 欧拉 | Heun |
|---|---|---|
| 2 | 0.593 / 0.253 / 25.9% | 1.980 / 0.400 / 99.8%(1 步) |
| 4 | 0.098 / 0.078 / 2.8% | 0.2975 / 0.203 / 6.6%(2 步) |
| 8 | 0.026 / 0.040 / 0.9% | 0.0095 / 0.035 / 0.2%(4 步) |
| 16 | 0.0083 / 0.025 / 0.2% | 0.0022 / 0.018 / 0.1%(8 步) |
前向次数够多时 Heun 好得多;只有 2、4 次时 Heun 反而更差。高阶方法的误差估计 建立在”步长足够小、轨迹在一步之内近似为抛物线”之上;步长大到跨过整段弯曲时,它的修正项反而把样本带偏。DPM-Solver 等专门的高阶求解器能把需要的步数从几百降到十几到二十几,但要降到 1–2 步,必须改变学什么,而不只是改变怎么解 ODE。
1.3 少步方法真正想要的东西:流映射
ODE 定义了一族映射 :时刻 位于 的粒子,到时刻 在哪里。它满足”半群”性质 。采样只需要 :如果一个网络直接学会了 ,一次前向就能生成。本讲的所有方法,都可以看成用不同的办法学 的一部分(Boffi et al. 把这叫做”流映射匹配”):
| 方法 | 学的是 |
|---|---|
| 直接蒸馏 | |
| 一致性模型 | ,所有 |
| MeanFlow、Shortcut | ,所有 (以平均速度的形式) |
| reflow | 不学映射;改造 ODE 本身,让 变成直线,欧拉一步就精确 |
长什么样。01 号脚本用精确的向量场和 Heun 200 步算 (以 800 步为参照,误差中位数 ),再用有限差分算雅可比矩阵 的最大奇异值——“起点挪动一点,终点挪动几倍”:
| 分位数 | 10% | 50% | 90% | 99% | 99.9% |
|---|---|---|---|---|---|
| 局部拉伸 | 0.57 | 0.96 | 3.61 | 24.05 | 144.23 |
大部分地方 是压缩的(一个 被压成五个标准差 0.4 的小峰)。但有 2.8% 的起点拉伸超过 10,最大的超过 100。把起点按 落在哪个峰着色,噪声平面被切成五块扇形;拉伸大的点恰好排在扇形的分界线上(下图左、中)。往左挪一点去这个峰,往右挪一点去那个峰—— 是分片的,在分界线上几乎是跳变的。
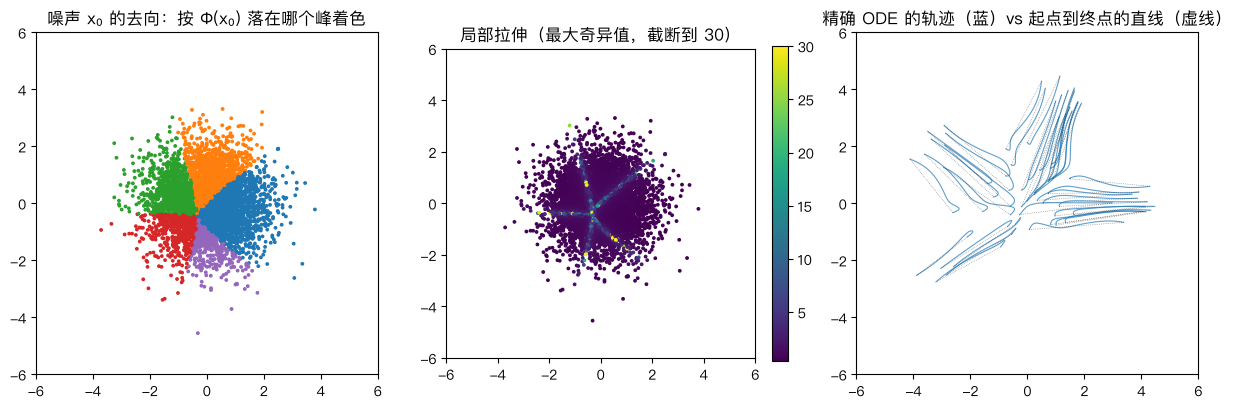
这对所有”一步学 “的方法都是坏消息:神经网络是光滑函数,只能把跳变抹成一个有宽度的斜坡,坡上的起点会被送到两个峰之间。§2–§4 的每个一步方法都有几个百分点的样本落在峰之间,几乎全部来自分界线附近——根源就在这里。(多峰分得越开,跳变越陡;图像这样的高维数据里,对应的现象是”两种模式之间的混合”,例如模糊或结构错误。)
1.4 轨迹弯在哪里
不直度 衡量轨迹离”匀速直线”有多远; 时欧拉一步就是精确的。精确向量场的 ,按时间段拆开:
| 时间段 | [0, 0.2) | [0.2, 0.4) | [0.4, 0.6) | [0.6, 0.8) | [0.8, 1) |
|---|---|---|---|---|---|
| 对 的贡献 | 1.706 | 0.228 | 0.278 | 0.317 | 0.318 |
60% 的弯曲发生在前 20% 的时间里:粒子先要”决定”去哪个峰,速度方向在这段时间里变化最大;决定之后基本是直线(上图右)。
配对的视角。ODE 给出了噪声和数据之间的一个确定性配对 。和流匹配训练用的独立配对( 和 独立抽)比,它”省路”得多:搬运代价 从 18.46 降到 8.66——每个噪声点被送到离它近的那个峰,而不是随机一个峰。这个观察是 §2 的出发点。
2. 把轨迹拉直:Rectified Flow · Straightening the flow
2.1 为什么独立配对的流是弯的
第 2 讲 §3 里见过:独立配对下,每一条条件轨迹是从 到 的直线,但不同配对的直线会交叉。ODE 的轨迹不能交叉(同一点只有一个速度),所以边缘向量场在交叉点取了各条直线方向的平均,边缘轨迹因此是弯的。
Rectified Flow(Liu, Gong & Liu 2023)的想法很直接:换一个不交叉的配对。用第一个流模型(“1-rectified flow”,就是普通的 CondOT 流匹配)的 ODE 生成配对 ;这些配对来自不相交的 ODE 轨迹,它们之间的直线 基本不交叉。在这些配对上重新做流匹配:
Algorithm  Reflow(2-rectified flow)
1. 抽 N 个噪声 x_0 ~ N(0, I),用当前的流模型解 ODE 得到 x_1 = Φ(x_0)      (造配对)
2. for 每一步:
       从配对里抽一批 (x_0, x_1),t ~ U[0, 1]
       x_t = (1 − t) x_0 + t x_1
       loss = ‖u^θ_t(x_t) − (x_1 − x_0)‖²                                 (和第 2 讲完全一样的损失)
       梯度下降一步
唯一的区别是配对方式。Liu et al. 证明了:新流的边缘分布和原来一样(仍然从 送到 ),任何凸代价下的搬运代价不增加,轨迹变得更直。可以反复做(3-rectified flow……),但每一轮都要重新造配对,误差会累积。
2.2 实验:拉直了,但还有 5%
02 号脚本:10 万个配对(精确流映射),4 层 × 128 宽的 MLP,6000 步、批大小 512,每个网络约 5 秒。
| 模型 | 不直度 | 欧拉 1 步 | 2 步 | 4 步 | 8 步 |
|---|---|---|---|---|---|
| 精确场(1-RF 的理想情况) | 2.784 | 2.79 / 100% | 0.593 / 25.9% | 0.098 / 2.8% | 0.026 / 0.9% |
| 流匹配网络(1-RF) | 2.716 | 2.57 / 100% | 0.5025 / 32.4% | 0.087 / 6.6% | 0.023 / 2.1% |
| reflow,老师 = 精确流映射(2-RF) | 0.003 | 0.0016 / 5.1% | 0.0014 / 4.8% | 0.0014 / 3.6% | 0.0014 / 2.3% |
| reflow,老师 = 流匹配网络 | 0.002 | 0.0017 / 4.8% | 0.0014 / 4.6% | 0.0013 / 3.9% | 0.0012 / 2.3% |
(能量距离 / 落在峰之间。)不直度降了约 1000 倍,一步的能量距离 0.0016,已经接近真样本的噪声地板。
但仍有 5% 的样本落在峰之间,加到 8 步也还有 2.3%。按起点的局部拉伸分组(02 号脚本第 3 部分):
| 起点 | 占全部起点 | 一步结果离 的距离(中位数) | 其中落在峰之间 | 占全部”峰之间”样本 |
|---|---|---|---|---|
| 拉伸 > 10(紧贴分界线) | 2.9% | 1.102 | 94.0% | 54% |
| 拉伸 3–10(分界线两侧) | 9.2% | 0.418 | 24.9% | 45% |
| 拉伸 ≤ 3(远离分界线) | 87.8% | 0.038 | 0.1% | 1% |
只占 12% 的”分界线附近”的起点贡献了 99% 的错误。reflow 让轨迹变直,但变不出不连续的映射:2-RF 的向量场在 附近必须在分界线两侧指向不同的峰,MLP 把这个跳变抹平了。练习 3 看更大的网络、更长的训练能把这个”斜坡”压窄多少。
用训练出来的流匹配网络(Heun 32 步)当老师,结果和完美老师几乎一样——这里老师本身已经很准。真实系统里老师的误差会被学生继承。InstaFlow(Liu et al. 2024)把 reflow 用在 Stable Diffusion 上:先 reflow 把轨迹拉直,再蒸馏成一步生成器——拉直之后,蒸馏要学的映射更简单。
3. 学流映射(一):蒸馏与一致性模型 · Distillation and consistency models
3.1 直接蒸馏
最直接的办法(Luhman & Luhman 2021):用老师跑完整的 ODE 造配对 ,训练一个没有时间输入的网络 去回归:
03 号脚本:一步,能量距离 0.0012、峰之间 1.7%——比 reflow 一步(5.1%)还少。它直接回归 ,没有”沿一条近似直线走”这一层近似;在分界线附近(拉伸 > 3)也只错 13%(一致性蒸馏 43%)。代价是造配对:每个训练样本都要老师跑完整的 ODE。在图像上,这意味着几百万次多步采样,而且配对是固定的有限集合,学生可能只学会这些配对。
3.2 渐进式蒸馏
渐进式蒸馏(Salimans & Ho 2022)把”一次蒸馏到底”拆成很多轮:第一轮,学生用 1 步模仿老师的 2 步;下一轮,这个学生当老师,新学生再用 1 步模仿它的 2 步……每一轮步数减半, 轮后从 步降到 1 步。每一轮的任务都很简单(只要把两小步合成一步),不需要预先造完整的配对。论文报告能把采样步数从上千步一路减半到 4 步左右而质量损失很小;Meng et al.(2023)把它推广到带 CFG 的模型。本讲没有实现它(练习 6 是一个思考题)。
3.3 一致性模型
一致性函数(Song et al. 2023):,从时刻 的任何一点直接预测轨迹的终点。它的两个性质:
- 一致性:同一条轨迹上的点预测同一个终点,。
- 边界条件:(已经在数据端,原地不动)。
翻译成本课的方向。论文里数据在 、噪声在 ,边界条件是 ,参数化 且 、。本课数据在 ,取最简单的一组系数:
边界条件自动满足; 的含义正是”从 到 1 的平均速度”——和 §4 的 MeanFlow 是同一个东西。
一致性蒸馏(CD)。把 分成 段 :
Algorithm  一致性蒸馏(本课方向)
for 每一步:
    z ~ p_data,ε ~ N(0, I),随机选 k;x_{t_k} = (1 − t_k) ε + t_k z               (落到路径上)
    老师走一小步:x̂_{t_{k+1}} = x_{t_k} + (t_{k+1} − t_k) u_{t_k}(x_{t_k})          (边缘 ODE 的欧拉一步)
    loss = ‖ f_θ(x_{t_k}, t_k) − f_{θ⁻}(x̂_{t_{k+1}}, t_{k+1}) ‖²
    梯度下降一步;θ⁻ ← μ θ⁻ + (1 − μ) θ                                              (目标网络:EMA,不求梯度)
直觉:相邻两点应该预测同一个终点。 时 是已知的,于是”正确的终点”从数据端一段一段地传回噪声端。目标网络用 EMA 而不是 本身,是为了让这个”传递”稳定(用 本身做目标容易让网络找到”处处输出常数”之类的平凡解)。
一致性训练(CT):不要老师。把老师的一步换成条件路径上的一步:,用同一对 。条件速度 代替边缘速度——和流匹配用条件向量场代替边缘向量场是同一个道理,只在期望意义下成立。
多步采样。一步:。两步:先 ,再重新加噪到某个中间时刻 :,再 。步数可以在 1 和多步之间自由选择。
3.4 实验
03 号脚本(老师是精确的边缘向量场,,EMA 0.99,各 6000 步):
| 方法 | 需要什么 | 前向次数 | 能量距离 | TV | 峰之间 |
|---|---|---|---|---|---|
| 直接蒸馏 | 10 万个完整 ODE 配对 | 1 | 0.0012 | 0.021 | 1.7% |
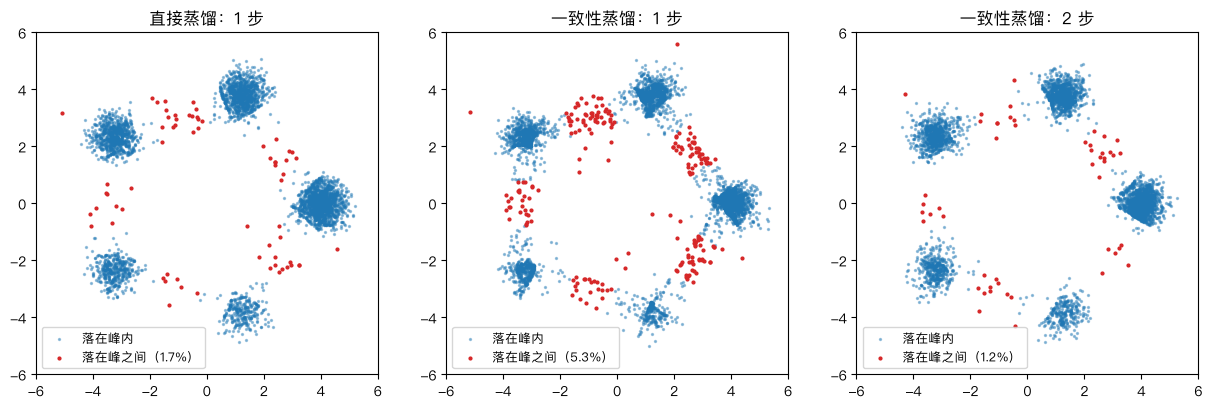
| 一致性蒸馏 CD | 老师的向量场(每步一次) | 1 / 2 / 3 | 0.0045 / 0.0041 / 0.0053 | 0.018 / 0.018 / 0.022 | 5.3% / 1.2% / 0.2% |
| 一致性训练 CT | 只要数据 | 1 / 2 / 3 | 0.0782 / 0.0143 / 0.0069 | 0.021 / 0.024 / 0.021 | 28.3% / 7.8% / 2.9% |
几点观察:
- 多步采样修正了分界线附近的错误。CD 一步 5.3%,两步 1.2%,三步 0.2%。第二步从 出发,样本已经远离分界线,再预测一次终点就不容易错。注意多步采样得到的不再是 (远离分界线的起点上,离它的中位距离从 0.09 变成 0.49),而是”另一个”合理的样本;能量距离在 0.004–0.005 之间基本不变。
- 一步错误的位置。按起点分组,直接蒸馏和 CD 在远离分界线的起点上只错 0.1%,错误几乎全在分界线附近(拉伸 > 3 的起点,直接蒸馏错 13%、CD 错 43%)——又是 §1.3 的那个跳变。
- 一致性训练差一大截。一步 28% 落在峰之间,远离分界线的起点也有 18% 出错。没有老师时目标嘈杂得多。Song et al. 的 CT 要配合逐渐加密离散化等技巧,后续工作(Song & Dhariwal 2024 的 iCT,Lu & Song 2025 的连续时间一致性模型 sCM)主要就是在让 CT 稳定、可扩展;这里只实现了最基本的版本。
- 离散段数 :太小时老师的欧拉一步误差大;太大时每一步只传一点点信息,收敛慢。练习 5 有作者机器上的结果。
4. 学流映射(二):平均速度与 MeanFlow · Mean flows
4.1 平均速度和 MeanFlow 恒等式
一致性模型学 ,终点固定在 。能不能学任意两个时刻之间的映射 ?MeanFlow(Geng et al. 2025)用平均速度来表示它:
其中 是瞬时(边缘)速度, 沿 ODE 轨迹。 时平均速度就是瞬时速度:。一步生成:。
问题是定义里有积分,没法直接当回归目标。把定义写成 ,两边对 求导( 沿轨迹移动, 固定):
这就是 MeanFlow 恒等式。全导数 ——沿轨迹的变化率。
翻译成本课的方向。论文里数据在 、噪声在 ,写成 (),恒等式是 。本课方向相反,“当前时刻 、目标时刻 “,符号相应变化,推导如上。
4.2 训练目标
把恒等式右边当成回归目标,用两个替换让它可算:
- 边缘速度 换成 CondOT 的条件速度 (和流匹配一样,期望不变);
- 用网络自己算:,再停止梯度。
是 沿方向 (对 )的方向导数,一次雅可比–向量积(JVP,torch.func.jvp)就能算出,代价约是一次额外的前向。训练时一部分样本取 :那时目标就是 ,退化成普通的流匹配。代码见 fewstep_lib.train_meanflow。
MeanFlow 不需要老师、不需要配对、不需要 EMA 目标网络,从零开始训练。论文报告在 ImageNet 256×256 上一步生成的 FID 为 3.43。
4.3 实验
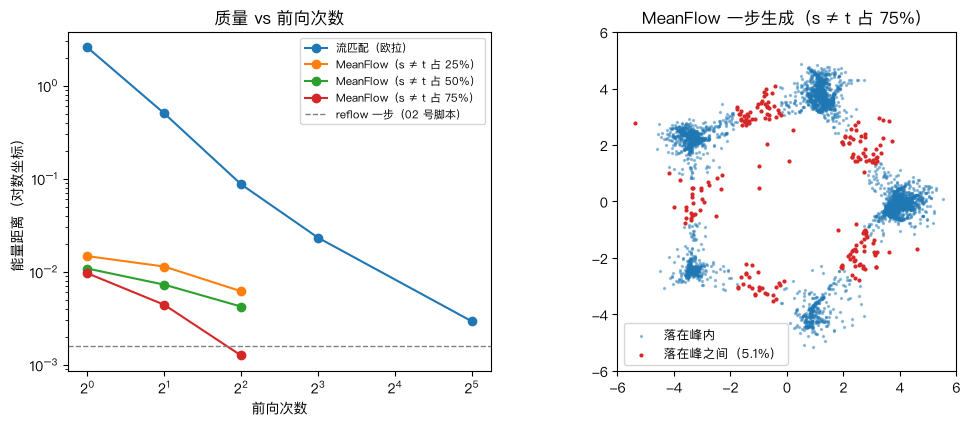
04 号脚本:同样的 MLP(多一个时间输入 ),6000 步;对照是同样训练步数的流匹配网络。“s ≠ t 占 x%“是训练时 的样本比例(论文在 ImageNet 上用 25%)。
| 方法 | 1 步 | 2 步 | 4 步 |
|---|---|---|---|
| 流匹配网络 + 欧拉 | 2.565 / 100% | 0.5025 / 32.4% | 0.087 / 6.6% |
| MeanFlow(s ≠ t 占 25%) | 0.0147 / 6.3% | 0.0114 / 2.2% | 0.0062 / 0.6% |
| MeanFlow(s ≠ t 占 50%) | 0.0108 / 6.0% | 0.0073 / 2.0% | 0.0042 / 0.6% |
| MeanFlow(s ≠ t 占 75%) | 0.0096 / 5.1% | 0.0044 / 1.7% | 0.0013 / 0.4% |
(能量距离 / 峰之间;流匹配网络欧拉 32 步是 0.0029 / 0.3%。)
- 一步可用,四步很好。一步能量距离 0.010–0.015,比流匹配一步好几个数量级;s ≠ t 占 75% 时四步 0.0013,超过了流匹配欧拉 32 步。一步的能量距离不如有完美老师的方法(reflow 0.0016、一致性蒸馏 0.0045),落在峰之间的比例相近(约 5%)——同一个跳变问题。
- 比例与论文不同。这里 s ≠ t 的比例越大越好。s = t 的样本只是在学瞬时速度,二维问题上这太容易了,把训练预算花在平均速度上更划算。超参数的最优值依赖于问题。(我还试了论文里的自适应损失加权,在这里明显变差,没有采用,见代码 README。)
- 一个网络,两种速度,都有代价。 是网络里”附带”的流匹配模型,但它比单独训练的流匹配网络差得多(相对误差,:12.3% vs 2.7%)——网络要装下所有 的平均速度, 只是其中一条”对角线”。一步映射 离精确的 也不近(中位数 0.17,直接蒸馏约 0.01),但送出去的分布大致正确。MeanFlow 的目标是自举的,它学到的是”一个”合理的一步映射,不一定是 ODE 的那一个。分布对了不等于映射对了。
4.4 Shortcut 模型
Shortcut 模型(Frans et al. 2025)是同一思路的离散版本:网络 学”步长为 的一步”,用自一致性构造目标——走一个 的大步,应该等于连走两个 的小步:
时是普通的流匹配。MeanFlow 可以看成它的连续极限:用导数(恒等式)代替”两个小步”。
5. 另一条路线:分布层面的蒸馏 · Distribution-level distillation
前面的方法都在逼近轨迹或映射,学生和老师逐点比较。另一类方法只要求学生生成的分布对:
- 分布匹配蒸馏(DMD,Yin et al. 2024):最小化 。它对学生参数的梯度只需要两个得分函数之差:老师(“真”分布的得分)减去一个在学生样本上在线训练的扩散模型(“假”分布的得分),都在加噪后的时刻上计算。再加一个回归损失防止模式坍塌。
- 对抗蒸馏(ADD,Sauer et al. 2023,SDXL-Turbo):加一个判别器,让学生的一步样本”像真的”,再配合老师的蒸馏损失。
这类方法不受”必须复现 ODE 的那个映射”的约束(§4.3 已经看到,分布对了不等于映射对了),在大模型的一步、两步生成上效果很好;代价是训练更复杂(多个网络、对抗训练的不稳定),而且 KL 的方向使它倾向于丢掉一些模式。本讲没有实现它们。
6. 全景 · The big picture
把本讲的结果放在一起(五峰分布,4 层 × 128 的 MLP,6000 步;能量距离 / 峰之间):
| 方法 | 需要老师? | 额外代价 | 1 次前向 | 2 次前向 | 4 次前向 |
|---|---|---|---|---|---|
| 流匹配 + 欧拉(基线) | 否 | — | 2.565 / 100% | 0.5025 / 32.4% | 0.087 / 6.6% |
| reflow(2-RF) | 是(造配对) | 老师跑 10 万次完整 ODE | 0.0016 / 5.1% | 0.0014 / 4.8% | 0.0014 / 3.6% |
| 直接蒸馏 | 是(造配对) | 同上 | 0.0012 / 1.7% | — | — |
| 一致性蒸馏 | 是(向量场) | 每步一次老师 + EMA | 0.0045 / 5.3% | 0.0041 / 1.2% | — |
| 一致性训练 | 否 | EMA | 0.0782 / 28.3% | 0.0143 / 7.8% | — |
| MeanFlow(75%) | 否 | 每步一次 JVP | 0.0096 / 5.1% | 0.0044 / 1.7% | 0.0013 / 0.4% |
(一致性模型的 3 次前向:CD 0.0053 / 0.2%,CT 0.0069 / 2.9%。真样本 −0.0015 / 0.1%。)
读这张表要记住:老师在这里是完美的(精确的边缘向量场),这让依赖老师的方法占了便宜;真实系统里老师有误差,而且造配对的代价是天文数字。不需要老师的方法里,MeanFlow 明显好于基本版的一致性训练。所有一步方法都有约 2–6% 的样本落在峰之间——这是用光滑网络表示跳变映射的代价,在这个”峰分得很开”的玩具问题上被放大了。
7. 小结 · Summary
- 少步为什么错:欧拉一步沿切线走,CondOT 的一步塌缩到数据均值;高阶求解器在步数极少时反而更差;轨迹的弯曲集中在开头(60% 在前 20% 的时间)。
- 流映射 是所有少步方法的目标。在多峰数据上它是分片的,分界线上拉伸极大;光滑的网络在那里必然出错。
- reflow:在 ODE 配对上重新做流匹配,配对之间的直线不交叉,轨迹被拉直(不直度降约 1000 倍),一步的能量距离接近噪声地板,但变不出不连续的映射。
- 蒸馏:直接蒸馏回归 (要造配对);渐进式蒸馏每轮步数减半;一致性模型学 ,相邻两点预测同一终点(CD 用老师,CT 不用),可以多步采样修正错误。
- MeanFlow:学平均速度 ,用恒等式 和一次 JVP 构造目标,不要老师;Shortcut 模型是它的离散版本。
- 分布层面的蒸馏(DMD、对抗蒸馏)只要求分布对,不要求映射对。
8. 常见误区 · Common pitfalls
- “向量场学得完美,少步采样就没问题。” 精确的向量场一步欧拉也塌缩到数据均值(§1.1)。
- “换高阶求解器就能少走几步。” 只在步数够多时成立;2–4 次前向时 Heun 比欧拉还差(§1.2)。
- “CondOT 的轨迹是直线。” 条件轨迹是直线,边缘轨迹不是(不直度 2.8,§1.4;第 2 讲 §6.2)。reflow 才让边缘轨迹变直。
- “一步生成器学到的就是 ODE 的流映射。” MeanFlow 的一步映射离 中位距离 0.17,分布却大致正确;DMD 等方法根本不要求映射一致(§4.3、§5)。
- “一致性模型多走几步一定更好。” 每次重新加噪都引入新的随机性和误差;本讲里 3 步的能量距离比 2 步略高(§3.4)。
- “不需要老师的方法一定更差。” 基本版的一致性训练确实差很多,但 MeanFlow 四步就超过了流匹配 32 步(§4.3)。
- “玩具实验的排序能直接推广到图像。” 这里的老师是完美的,数据是分得很开的五个峰;论文在大规模数据上的排序可能不同。
9. 练习 · Exercises
练习 1(一步塌缩)。对一般的高斯路径 (、),一步欧拉 的结果是什么?
参考答案
时 与 独立,。一步:。CondOT 的 、,于是 。其他调度一步得到”缩放后的噪声 + 平移”,仍然是一个高斯,和多峰的数据分布相去甚远。
练习 2(MeanFlow 恒等式)。从 推导恒等式,并验证 时它退化为 。为什么训练目标里的 可以用条件速度 代替 来计算?
参考答案
推导见 §4.1(对 求导,左边用乘积法则,右边是 )。 时 项为 0。用 代替:目标 对 是线性的,给定 时对 取条件期望, 变成边缘速度 ,于是目标的条件期望等于用 算的目标。均方误差的最优解是条件期望,所以最优解不变——和条件流匹配是同一个论证。
练习 3(编程:网络容量与”斜坡”)。在 02_reflow.py 里把 reflow 网络加宽到 256,或者训练 4 倍步数(24000 步)。一步生成落在峰之间的比例怎样变化?
参考答案(作者机器上的结果)
| 设置 | 训练用时 | 一步:能量距离 / TV / 峰之间 |
|---|---|---|
| 128 宽,6000 步(脚本默认) | 5 秒 | 0.0016 / 0.015 / 5.1% |
| 256 宽,6000 步 | 11 秒 | 0.0014 / 0.019 / 3.8% |
| 128 宽,24000 步 | 22 秒 | 0.0014 / 0.020 / 2.5% |
容量和训练都能把”斜坡”压窄,落在峰之间的比例下降,但下降得很慢:要表示一个跳变,光滑网络需要越来越陡的过渡,而陡的过渡需要更多参数和更多训练。这和”一步生成器要更大的模型、更长的训练”的实践经验一致。
练习 4(编程:再 reflow 一次)。用 2-RF 的 ODE(Heun 32 步)重新造配对,训练 3-RF。不直度和一步质量还会改善吗?
参考答案(作者机器上的结果)
3-RF 的不直度从 0.003 降到 0.0013,一步质量却没有改善:能量距离 0.0020、峰之间 5.3%(2-RF:0.0016、5.1%)。轨迹已经足够直,剩下的误差来自分界线附近的跳变,再拉直也无济于事;而且每多一轮,配对就多一层学生的误差。这也是实践中一般只做 1–2 轮 reflow 的原因。
练习 5(编程:一致性蒸馏的离散段数)。在 train_consistency 里把 从 32 改成 8 和 128。一步、两步的质量怎样变化?
参考答案(作者机器上的结果)
| 一步:能量距离 / 峰之间 | 两步:能量距离 / 峰之间 | |
|---|---|---|
| 8 | 0.0265 / 2.9% | 0.0202 / 0.7% |
| 32(默认) | 0.0045 / 5.3% | 0.0041 / 1.2% |
| 128 | 1.0226 / 87.3% | 0.2533 / 21.3% |
:老师的一步欧拉跨度 1/8,误差大,学到的终点有偏(能量距离差了 6 倍),不过落在峰之间的反而少。:每一步只把”正确终点”往噪声端传 1/128,6000 步远远不够把信息从 传到 ,一步生成基本失败。两头都不好——这正是 Song & Dhariwal(iCT)让 随训练逐渐增大的原因。
练习 6(思考:渐进式蒸馏的误差累积)。渐进式蒸馏从 步降到 1 步要 10 轮。如果每一轮学生相对老师的误差是 ,最后的误差大约是多少?这和”直接蒸馏一次到底”相比有什么取舍?
参考答案
误差大致逐轮累加,约 (每一轮的学生把上一轮的误差当作”真值”继承下来)。直接蒸馏只有一轮误差,但它的任务是一步学会整个跳变的 (§1.3),难得多,而且要先造完整的配对;渐进式蒸馏每一轮的任务都很简单(把两小步合成一步),而且只在最后几轮才需要学”大步”。实践中渐进式蒸馏在 4–8 步时质量很好,到 1–2 步时误差累积和任务难度都会显现。
练习 7(思考:一致性模型与 MeanFlow 的关系)。本讲的一致性函数参数化 。说明 应该等于 MeanFlow 的 。MeanFlow 比一致性模型多学了什么?
参考答案
,对比可知 。一致性模型只学终点固定在 的那一族平均速度;MeanFlow 学所有 ,所以可以直接用确定性的多步采样(),不需要重新加噪。两者的训练也不同:一致性模型用”相邻两点一致”(差分形式),MeanFlow 用恒等式(微分形式)——sCM(Lu & Song 2025)的连续时间一致性模型用的也是微分形式。
10. 延伸阅读 · Further reading
- Liu, Gong & Liu, Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow(ICLR 2023);Liu et al., InstaFlow(ICLR 2024):reflow + 蒸馏用在 Stable Diffusion 上。
- Luhman & Luhman, Knowledge Distillation in Iterative Generative Models for Improved Sampling Speed(2021)。
- Salimans & Ho, Progressive Distillation for Fast Sampling of Diffusion Models(ICLR 2022);Meng et al., On Distillation of Guided Diffusion Models(CVPR 2023)。
- Song, Dhariwal, Chen & Sutskever, Consistency Models(ICML 2023);Song & Dhariwal, Improved Techniques for Training Consistency Models(ICLR 2024);Kim et al., Consistency Trajectory Models(ICLR 2024);Lu & Song, Simplifying, Stabilizing and Scaling Continuous-Time Consistency Models(ICLR 2025)。
- Frans, Hafner, Levine & Abbeel, One Step Diffusion via Shortcut Models(ICLR 2025)。
- Geng, Deng, Bai, Kolter & He, Mean Flows for One-step Generative Modeling(2025)。
- Boffi, Albergo & Vanden-Eijnden, Flow Map Matching(2025):把各种少步方法统一成”学流映射”。
- Yin et al., One-step Diffusion with Distribution Matching Distillation(CVPR 2024)及 DMD2;Sauer et al., Adversarial Diffusion Distillation(2023)。
- Lu et al., DPM-Solver(NeurIPS 2022):不改变模型、只改进 ODE 求解器的路线。
11. 下一讲预告 · Next lecture
到这里,“怎样生成”的问题已经讲完了:图像(第 1–5 讲)、文本(第 6 讲)、以及怎样生成得快(本讲)。第 8 讲换一个应用:机器人。机器人学”模仿人类示范”时,为什么要用扩散 / 流模型,而不是普通的回归?
- 示范是多峰的:同一个情形下,有人从左边绕过障碍,有人从右边绕。均方误差回归会把它们平均成”直接撞上去”。
- Diffusion Policy:把”动作”当成要生成的数据,以观测为条件,用第 4 讲的条件生成来做。
- 动作块与闭环执行:一次生成未来一段动作,执行一部分再重新规划。本讲的”步数”问题在这里也很重要——机器人要实时决策。