对应 Maps to:MIT 6.S184 Generative AI with Stochastic Differential Equations(IAP 2026),Lecture 4 · 28-Jan-2026 · Latent Spaces and Neural Network Architectures;Lab 3 中 Diffusion Transformer、VAE 与潜空间扩散的部分(原课用 MNIST,这里换成代码画出来的”像素数字”)。 阅读材料:原课讲义 Holderrieth & Erives, An Introduction to Flow Matching and Diffusion Models(2026 版,arXiv:2506.02070)第 6 章与附录 D;Lecture 4 slides;原始论文 Ronneberger et al. (2015) U-Net、Peebles & Xie (2023) DiT、Kingma & Welling (2014) VAE、Rombach et al. (2022) Latent Diffusion Models、Esser et al. (2024) SD3、Polyak et al. (2024) Movie Gen。 依据说明:本讲以原课讲义第 6 章为主线:网络的输入输出与条件注入、U-Net、DiT、为什么要潜空间、自编码器与 VAE、潜空间扩散的配方、SD3 与 Movie Gen 的案例。“直接输入 t vs 傅里叶嵌入""参数量 vs 计算量""注意力的 token 数""adaLN-Zero 的恒等初始化""同样步数下 MLP / U-Net / DiT 的比较""β 扫描""三种潜空间上的流匹配”等实验是本讲义补充的。其中”普通自编码器的潜空间反而最好生成”一条与常见的直觉不一致,§3.5 如实报告并解释。案例部分的数字来自论文本身,写成”某某报告”。 配套代码 Code:
code/lecture05/(5 个脚本 + 2 个模块;PyTorch + matplotlib;每个脚本 4–112 秒,都完整运行过) 预计阅读时间:5 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说清一个流 / 扩散模型的网络要吃什么、吐什么,以及时间 和提示 有哪几种喂法(傅里叶时间嵌入、类别嵌入、文本编码器;加到特征上、adaLN、交叉注意力)。
- 画出 U-Net 和 Diffusion Transformer(DiT)的结构,追踪一张图在其中的形状变化,估算参数量和计算量,理解”参数少不等于算得快”、注意力的代价随 token 数平方增长。
- 解释为什么几乎所有大模型都在潜空间里生成,写出 VAE 的损失(重建 + KL)并推导两个高斯之间的 KL。
- 理解 VAE 的两难:KL 让潜空间”规整”、代价是重建变差;知道潜空间扩散的配方,以及”潜空间要多规整”在实践中怎样取舍。
- 读懂 Stable Diffusion 3、Meta Movie Gen 的系统设计,把它们拆回前五讲的组件。
0.2 先修与本讲范围
| 需要的背景 | 在哪里 |
|---|---|
| 流匹配训练(Algorithm 3)、调度与数据尺度 | 第 2 讲 §4、练习 7 |
| 四种参数化、换算公式 | 第 3 讲 §2 |
| 无分类器引导(Algorithm 5)、像素数字、Fréchet 距离 | 第 4 讲 §3–§4 |
nn.Module、buffer、训练循环 | 前置讲 P2 §3 |
| 高斯的重参数化、KL 散度的定义 | 前置讲 P1 §2.1 |
本讲不详细讲卷积网络和 Transformer 的一般原理(自注意力、多头、LayerNorm),只讲它们在生成模型里怎样用;需要补课可以看本仓库 CMU10-423 的相关讲次。
0.3 本讲地图 Map
§1  网络的输入与输出:时间嵌入、提示嵌入                         ← 代码 01
§2  网络架构:U-Net、DiT、条件怎样注入;形状与代价;同步数比较   ← 代码 02、03
§3  潜空间:为什么;自编码器与 VAE;β 的两难;潜空间流匹配        ← 代码 04、05
§4  案例:Stable Diffusion 3、Meta Movie Gen
§5  小结   §6  常见误区   §7  练习   §8  延伸阅读   §9  下一讲预告
0.4 记号 Notation(新增的部分)
| 记号 | 意思 |
|---|---|
| 时间嵌入: | |
| 条件向量(时间嵌入 + 提示嵌入),由它调制网络 | |
| patch(小块)边长; 是 token 数 | |
| , | 编码器、解码器; 是潜变量, 是重建 |
| VAE 的编码器分布 | |
| VAE 损失里 KL 的权重(和调度 无关,沿用 β-VAE 的习惯写法) | |
| 潜变量维数 |
1. 网络的输入与输出 · Inputs and outputs
1.1 网络要做什么
不管用流匹配还是得分匹配、预测速度还是噪声,网络的”合同”都一样:
- :一张(带噪的)图,或者它的潜变量;
- :一个数;
- :提示(类别、一段文字……),或者空提示 ;
- 输出:速度(或噪声、或去噪结果),形状和 完全相同。
原课讲义把网络设计归结为三个问题:怎样处理 的空间结构(§2),怎样让网络感知 (本节),怎样注入 (本节和 §2.3)。前四讲一直用”把 、、 拼起来喂给 MLP”,在二维玩具上够用;在图像上,三个问题都要认真对待。
1.2 时间:傅里叶嵌入
只是一个数。直接把它拼到输入里,网络第一层看到的 和 几乎一样,而理想的向量场在这两个时刻可能差别很大(第 2 讲: 时每个峰都在迅速收紧)。标准做法是先把 映射成一个高维向量:
频率 按几何级数排开(nets.FourierTimeEmbedding;原课 Lab 用随机的高斯频率,效果类似)。这和 Transformer 的位置编码是同一个想法。01 号脚本第 1 部分(16 维,频率 0.5–50):
| 时间差 | 0.001 | 0.01 | 0.05 | 0.1 | 0.3 | 0.5 |
|---|---|---|---|---|---|---|
| 嵌入之间的欧氏距离 | 0.366 | 2.653 | 3.776 | 3.796 | 3.079 | 3.765 |
| 相对于 的放大倍数 | 366 | 265 | 76 | 38 | 10 | 8 |
| 嵌入的余弦相似度 | 0.992 | 0.560 | 0.109 | 0.100 | 0.407 | 0.114 |
三点:时间差 0.01 时,嵌入之间的距离被放大了两百多倍,网络第一层”看到”的差别大得多;距离只依赖于时间差(三角函数的平移性质), 在哪里都一样敏感;余弦相似度并不随 单调下降(各频率分量此起彼伏),保证”远的时刻嵌入不同”的是所有分量合在一起,最低频率 0.5 让整个 上的嵌入不会重复。
它真的有用吗? 01 号脚本第 2 部分在第 2 讲的五峰数据上,用同样大小的 MLP(4×64)、同样的训练(5000 步),比较”直接输入 “和”输入 “,各两个随机种子(速度的相对误差):
| 模型 | 0.3 | 0.6 | 0.9 | 0.97 | 0.99 | 样本能量距离 | 落在峰之间 | |
|---|---|---|---|---|---|---|---|---|
| 直接输入 (种子 0) | 3.91% | 0.98% | 0.35% | 0.19% | 0.60% | 0.86% | 0.0100 | 0.4% |
| 直接输入 (种子 1) | 2.66% | 0.50% | 0.36% | 0.46% | 1.00% | 1.25% | 0.0010 | 0.4% |
| 傅里叶嵌入(种子 0) | 3.44% | 0.45% | 0.40% | 0.19% | 0.25% | 0.35% | 0.0026 | 0.8% |
| 傅里叶嵌入(种子 1) | 2.69% | 0.35% | 0.31% | 0.09% | 0.20% | 0.28% | 0.0000 | 0.7% |
向量场的精度上,傅里叶嵌入在 附近明显更好(:0.28–0.35% vs 0.86–1.25%),正是”理想场随 变化很快”的地方; 附近两者差不多(那里的误差来自目标的噪声,第 2 讲 §5.3)。但样本质量没有一致的差别:两个种子之间的差距和两种做法之间的差距一样大。在这个二维小问题上,直接输入 已经够用;时间嵌入在大模型里是标准做法,因为那里的网络要在很宽的噪声水平范围内表现出截然不同的行为(几乎纯噪声时要”画出大致构图”,几乎干净时要”修细节”)。
📌 代码 01:
python3 01_time_embedding.py(约 20 秒;--quick是冒烟测试)。
1.3 提示:从类别到文字
第 4 讲的提示是类别,用独热编码;本讲的网络改用 nn.Embedding(一张可训练的查找表,第 行就是类别 的向量,等价于”独热编码乘一个矩阵”),再加上一行给空提示 。
真实的提示是一段文字。原课讲义的说法是:用一个预训练的文本编码器把文字变成向量,生成模型本身不从头学语言。常见的两类:
- CLIP(Radford et al. 2021):图像编码器和文本编码器在 4 亿个图文对上做对比学习,使”配对的图和文”嵌入相近。它的文本嵌入天然是”和图像对齐”的,擅长描述视觉内容。通常取一个汇总向量(pooled embedding)。
- T5 等语言模型的编码器:只在文本上训练,理解长句、复杂的组合关系(“左边红色的球,右边蓝色的方块”)更好。输出一串 token 嵌入(每个词一个向量)。
两种嵌入的用法不同:一个汇总向量可以像 一样并进条件向量 (§2.3 的 adaLN);一串 token 嵌入则要用注意力(交叉注意力或联合注意力)让图像的每个位置去”查阅”文字的每个词。SD3 同时用了三个文本编码器(两个 CLIP、一个 T5),把两种用法都用上(§4.1)。
2. 网络架构 · Architectures
2.1 U-Net
U-Net 最早是为医学图像分割设计的(Ronneberger et al. 2015),DDPM 把它用作去噪网络,Stable Diffusion 1/2 用的也是它。nets.TinyUNet 是一个缩小版:
输入 1×12×12 → 卷积 → [ResBlock] 12×12 ──────────────────────── 跳连 ─┐
                       ↓ 下采样(步长 2 的卷积)                          │
                     [ResBlock] 6×6 ─────────────── 跳连 ─┐               │
                       ↓ 下采样                            │               │
                     [ResBlock] 3×3(中间层)               │               │
                       ↑ 上采样 ×2 + 拼接 ←────────────────┘               │
                     [ResBlock] 6×6                                       │
                       ↑ 上采样 ×2 + 拼接 ←───────────────────────────────┘
[ResBlock] 12×12 → 卷积 → 输出 1×12×12- 编码器(下行):卷积提取局部特征,下采样让深层特征”看到”大范围的结构(这个数字整体是什么形状)。
- 解码器(上行):上采样回到原尺寸。
- 跳连(skip connection):把同尺寸的浅层特征直接拼到解码器上,保留细节(笔画的精确位置)。
- 条件注入:每个残差块里,条件向量 经过一个线性层变成”每个通道一个数”,加到特征图的每个像素上。真实的 U-Net 还会在低分辨率层加自注意力和对文本的交叉注意力。
卷积的两个”先验”——局部性(相邻像素一起看)和平移等变性(同一个卷积核到处用)——正适合图像,这是 U-Net 参数少却效果好的原因(§2.5)。
2.2 Diffusion Transformer(DiT)
DiT(Peebles & Xie 2023)把图像当成一串 token:
- Patchify:把图切成不重叠的 小块,每块展平成一个向量(12×12 的图、:16 个 9 维的 token)。
- 嵌入:线性层映射到 维,加上位置嵌入(告诉注意力每个 token 在图上的哪个位置;这里用固定的二维正弦编码)。
- Transformer 块:自注意力 + MLP,每块都用条件向量 调制(§2.3 的 adaLN-Zero)。所有块的形状都是 ,token 的个数不变,只有内容在变。
- 输出:每个 token 线性地变回一个 的小块,再拼回整张图(depatchify)。
02 号脚本第 1 部分追踪了一批 4 张图的形状:U-Net 是一个”U”(通道 16 → 16 → 32 → 32,空间 12 → 12 → 6 → 3,再对称地回来;上行块的输入通道是”深层 + 浅层”之和);DiT 是 。
原课讲义和 slides 指出,近年的大模型(SD3、FLUX、Sora、Movie Gen)几乎都转向了 Transformer:它对不同的模态(图像、视频、文字)一视同仁,并且 Peebles & Xie 发现,DiT 的样本质量随计算量(Gflops)平稳地提升,扩展性很好。
2.3 条件怎样注入
| 方式 | 做法 | 例子 |
|---|---|---|
| 加到特征上 | 经线性层变成每个通道一个数,加到特征图上 | DDPM、本讲的 U-Net |
| adaLN(自适应层归一化) | 由 算出 LayerNorm 之后的平移 shift 和缩放 scale | DiT |
| adaLN-Zero | 在 adaLN 的基础上,再由 算出残差分支的门控 gate;产生这些参数的线性层初始化为 0 | DiT(效果最好) |
| 交叉注意力 | 图像 token 做 query,文本 token 做 key / value | SD 1/2 的 U-Net |
| 联合注意力(MM-DiT) | 图像 token 和文本 token 拼成一串,一起做自注意力;两种模态各有一套权重 | SD3 |
adaLN-Zero 的一个块是这样的(nets.DiTBlock):
“Zero”指那个线性层初始化为 0:一开始 gate = 0,每个块都是恒等映射,深层网络训练从”什么都不做”开始,更稳定。02 号脚本第 4 部分验证:未训练的 DiT 块 ,整个 DiT 的输出恒为 0;对照的 U-Net 输出非零(最大 1.25),而且换一个类别标签输出就变(最大变化 0.99)——条件嵌入在初始化时就在”乱说话”。Peebles & Xie 比较了”拼接 token""交叉注意力""adaLN""adaLN-Zero”四种方式,adaLN-Zero 的效果最好、计算也最省。
2.4 形状与代价
02 号脚本第 2 部分用 PyTorch 的 FlopCounterMode 数每张图一次前向的浮点运算:
| 模型 | 参数量 | 每张图的前向 MFLOPs | FLOPs / 参数 |
|---|---|---|---|
| MLP(第 4 讲,512×3) | 679,568 | 1.36 | 2.0 |
| U-Net(ch = 16) | 128,561 | 8.19 | 63.7 |
| U-Net(ch = 32) | 412,129 | 32.42 | 78.7 |
| DiT(patch 3,16 个 token) | 436,937 | 6.80 | 15.6 |
| DiT(patch 2,36 个 token) | 436,292 | 14.66 | 33.6 |
| DiT(patch 1,144 个 token) | 435,905 | 57.13 | 131.1 |
- 参数少 ≠ 算得快。MLP 的每个参数在一次前向里只用一次(FLOPs/参数 = 2,一次乘加);卷积核在每个像素上都用一次,U-Net(ch = 16)的参数只有 MLP 的五分之一,计算量却是它的 6 倍。
- DiT 的计算量由 token 数决定。patch 从 3 缩到 1,参数几乎不变,计算量涨了 8 倍多。
自注意力还有一个按 token 数平方增长的部分(第 3 部分):
| 输入 | token 数 | 注意力矩阵的元素(每个头、每层) |
|---|---|---|
| 12×12,patch 3 | 16 | 256 |
| 12×12,patch 1 | 144 | 20,736 |
| 1024×1024 RGB 像素空间,patch 2 | 262,144 | |
| 1024×1024 RGB 像素空间,patch 16 | 4,096 | |
| VAE 潜空间 128×128×16,patch 2 | 4,096 |
在像素空间里,1024×1024 的图用 patch 2 会有 26 万个 token,注意力矩阵根本放不下。用很大的 patch(16)也能把 token 降到 4096,但每个 token 要装 个数,网络要直接生成所有像素级的细节;在 8 倍下采样的潜空间里用 patch 2,同样 4096 个 token,每个只有 个数。这是 §3 的伏笔。
📌 代码 02:
python3 02_architectures.py(约 4 秒;耗时那一列每次运行都不同)。
2.5 同样的训练步数:MLP vs U-Net vs DiT
03 号脚本在像素数字上用同样的 CFG 训练(1500 步、批大小 64、)比较三种网络(每个设置生成 500 张、欧拉 30 步;两批真实图像之间的 Fréchet 距离 0.58,样本少时 Fréchet 距离偏大,只适合在同样的样本数下比较):
| 网络 | 参数量 | 训练用时 | 判对 | 风格多样性 | Fréchet | 判对 | 风格多样性 | Fréchet |
|---|---|---|---|---|---|---|---|---|
| MLP(512×3) | 679,568 | 3 秒 | 79.0% | 0.70 | 5.0 | 97.8% | 0.61 | 21.3 |
| U-Net(ch = 16) | 128,561 | 58 秒 | 85.8% | 0.89 | 1.3 | 99.0% | 0.73 | 3.3 |
| DiT(patch 3) | 436,937 | 19 秒 | 85.2% | 0.91 | 1.3 | 98.2% | 0.74 | 3.8 |
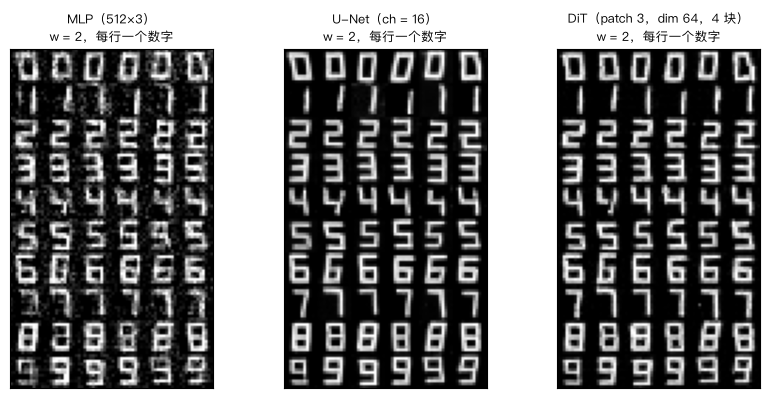
同样的训练步数,U-Net 和 DiT 明显好于 MLP:Fréchet 距离 1.3 vs 5.0,风格多样性 0.9 vs 0.7;图上 MLP 的背景满是噪点、笔画边缘发虚,U-Net 和 DiT 的数字干净整齐。U-Net 的参数只有 MLP 的五分之一,靠的是卷积的先验;DiT 没有卷积,靠 patch + 位置嵌入 + 注意力达到差不多的效果。
代价是计算:在 CPU 上 U-Net 的训练用时是 MLP 的约 20 倍,DiT 约 6 倍。同样的”用时”,MLP 可以训练多得多的步数(第 4 讲的 MLP 看过 8 倍的样本,Fréchet 距离 2.4,生成条件不同,只能粗略对比)。在 GPU 上卷积和注意力都高度优化,大规模时 U-Net、DiT 的优势更明显。U-Net 与 DiT 在这个小问题上难分高下;“Transformer 扩展得更好”需要大得多的模型和数据才能看出来。
📌 代码 03:
python3 03_train_image_flow.py(约 100 秒;--quick是冒烟测试)。
3. 潜空间 · Latent spaces
3.1 为什么要在潜空间里生成
一张 1024×1024 的彩色图是 300 万个数。直接在这个空间里做流匹配,有三个问题:
- 计算:§2.4 的注意力表。
- 显存:每一步训练都要在这个空间里存激活值。
- 大部分比特人眼不在乎。Rombach et al.(2022,LDM)的观察:一张图的信息量里,绝大部分是”感知上不重要的高频细节”(纹理的精确噪点),真正决定”这是一张什么图”的语义信息只占很小一部分。在像素空间里训练生成模型,大量的容量花在了建模这些不重要的细节上。
解决办法是分工(原课讲义附录 D 的视角):先训练一个自编码器,编码器 把图像压成小得多的潜变量 ,解码器 负责还原所有细节;生成模型只在 的空间里工作,专心建模”语义”。SD 1.x 把 512×512×3 的图压成 64×64×4(缩小 48 倍),SD3 把 1024×1024×3 的图压成 128×128×16(缩小 12 倍,通道更多、保留更多细节)。
3.2 普通自编码器的问题
最简单的自编码器:最小化重建误差 。它能把图压得很好,但对潜变量长什么样没有任何约束:可能尺度很大、可能挤在奇怪的低维曲面上、可能有大片空洞。原课讲义的担心是:这样的潜分布可能很难学——流模型要从 出发搬运到它。
04 号脚本把 12×12 的数字压成 维:普通自编码器的潜变量标准差约 3.0,与 的能量距离 3.68;直接从 采样再解码,得到的是一团乱麻(Fréchet 距离 112.5),因为 的大部分地方根本不是它的潜变量会出现的地方。
3.3 变分自编码器(VAE)
VAE(Kingma & Welling 2014)做两处修改:
- 编码器输出一个分布:,训练时从中采样 (重参数化,P1 §2.1:采样变成了可以求导的确定性运算加一个独立的噪声)。
- KL 正则:让每个 都靠近先验 。
两个对角高斯之间的 KL 有闭式(练习 1):
这个损失从哪来(原课讲义附录 D 给出了更多视角,这里只写最常见的一个):把解码器看成高斯 ,对数似然的证据下界(ELBO)是
乘以 ,就是上面的 ,其中 。所以 就是”假设解码器有多少噪声”: 相当于假设每个像素有标准差 的噪声——对 的像素来说,这是很大的噪声,解码器就”有理由”输出模糊的图(练习 4)。 的版本叫 β-VAE(Higgins et al. 2017)。
3.4 的两难
04 号脚本训练 5 个 VAE(144 → 256 → 256 → 8 → 256 → 256 → 144,各 3000 步):
| 模型 | 每像素均方误差 | 重建图被认对 | KL(nats / 图) | 在用的维度 | 潜变量标准差 | 潜变量 vs | 解码 :Fréchet |
|---|---|---|---|---|---|---|---|
| (普通自编码器) | 0.0057 | 89.5% | 88.1 | 8 | 3.00 | 3.678 | 112.5 |
| 0.0067 | 89.3% | 32.6 | 8 | 1.57 | 0.402 | 42.1 | |
| 0.0082 | 89.0% | 18.9 | 8 | 1.08 | 0.026 | 8.4 | |
| 0.0210 | 88.5% | 8.6 | 8 | 1.01 | 0.002 | 4.3 | |
| 0.2167 | 14.2% | 0.2 | 1 | 1.00 | −0.001 | 89.8 |
(“在用的维度”= 平均 KL > 0.05 nats 的维度;真实图像被分类器认对的比例本来就只有约 89%。)
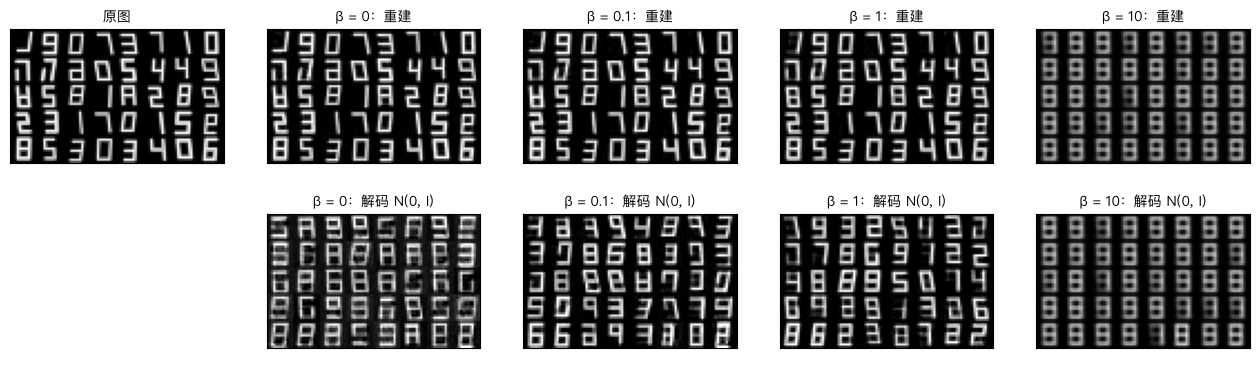
- 越大,潜变量越接近 (能量距离 3.7 → 0.002),直接解码 也越像样: 时 Fréchet 距离 4.3,VAE 自己就是一个(偏模糊的)生成模型。
- 越大,重建越差: 的每像素误差是普通自编码器的 3.7 倍,不过数字仍然认得出来。
- 太大会后验坍塌: 时 8 个维度只剩 1 个在用,所有重建都成了同一个模糊的”8”。KL 的代价太高,编码器干脆不传递信息。
3.5 潜空间流匹配
潜空间扩散的配方(Rombach et al. 2022):
- 训练自编码器(VAE),然后冻结它;
- 把数据编码成潜变量,缩放到单位方差左右(SD 1.x 的”缩放因子”0.18215 就是做这件事),在潜变量上训练流 / 扩散模型——前四讲的一切原样照搬,包括 CFG;
- 生成时在潜空间里从 模拟 ODE,再解码。
05 号脚本照做:三个自编码器(、0.1、1)的 8 维潜空间上各训练一个带 CFG 的条件 MLP 流模型,和第 4 讲的像素空间 MLP 比较(同样 3000 步、批大小 256;每个设置生成 1000 张,欧拉 50 步):
| 生成方式 | 流模型参数量 | 判对 | 风格多样性 | Fréchet | 判对 | Fréchet |
|---|---|---|---|---|---|---|
| 像素空间 MLP | 679,568 | 90.2% | 0.78 | 2.44 | 99.2% | 13.26 |
| 潜空间(普通自编码器) | 139,016 | 88.6% | 0.90 | 0.54 | 99.7% | 2.36 |
| 潜空间(VAE ) | 139,016 | 88.0% | 0.88 | 0.83 | 99.7% | 1.28 |
| 潜空间(VAE ) | 139,016 | 82.3% | 0.84 | 1.79 | 99.1% | 1.99 |
| 对照: 的 VAE 直接解码 | — | — | 1.17 | 4.79 | — | — |
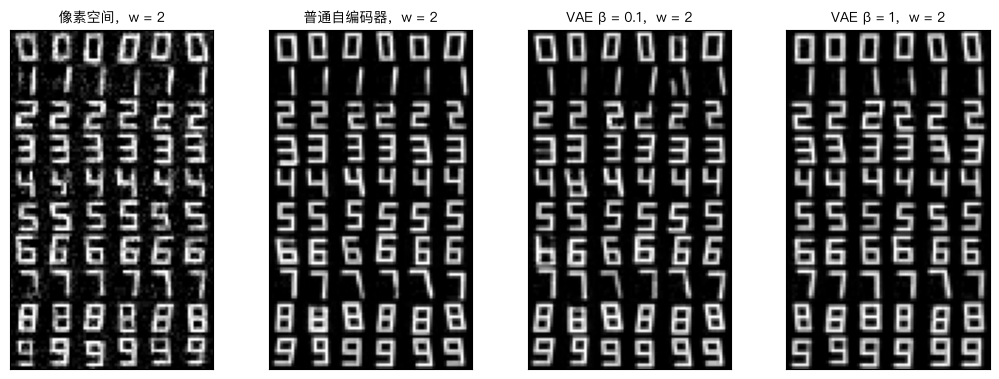
- 潜空间全面好于像素空间:Fréchet 距离 0.54–1.79 vs 2.44,风格多样性 0.84–0.90 vs 0.78; 时差距更大(1.3–2.4 vs 13.3)。图上像素空间的背景满是噪点,潜空间的数字干净——解码器只会画”像数字的图”,噪点被它过滤掉了。流模型只需建模 8 个数,参数也只有五分之一。
- 出乎意料:普通自编码器的潜空间反而最好生成( 时 0.54), 的 VAE 最差(1.79)。 的解码器更模糊,生成的数字也更模糊、更难认(判对 82%)。在 8 维这么低的维度里,MLP 流模型完全学得会自编码器那个”形状奇怪”的潜分布,KL 正则没有带来好处;§3.2 担心的”潜分布难学”在这里并没有发生。
- 这和大模型的实践其实一致:Stable Diffusion 的 VAE 的 KL 权重非常小(LDM 的配置里约 ),几乎就是自编码器。KL 项只是防止潜变量的尺度和形状失控;“把潜分布变成 “这件事交给扩散 / 流模型去做。原课讲义说的”重建质量与生成质量的权衡”是真实存在的,但最优点通常在”很小的 “那一端。
- VAE 先验的缝隙: 的 VAE 直接解码 的 Fréchet 距离 4.79,加上潜空间流模型后降到 1.79。VAE 的”汇总后验” 和先验 之间总有缝隙(“先验空洞”),流模型把它补上了。
- 训练用时没有体现出潜空间的优势(14 秒 vs 20 秒),因为这里每一步都要现画数字、过一遍编码器。真实系统会预先把整个数据集编码好存起来,之后训练流模型的代价只取决于潜空间的大小。
(缩放重要吗?把普通自编码器的潜变量不缩放、直接训练, 时 Fréchet 距离 0.615,和缩放后的 0.54 相差不大,练习 5。这里潜变量的标准差只有 3;第 2 讲练习 7 说明,尺度差得更多时调度的表现会明显变化。)
📌 代码 04、05:
python3 04_vae.py(约 80 秒);python3 05_latent_flow.py(约 110 秒)。两者都有--quick。
4. 案例 · Case studies
原课的最后一部分用两个真实系统把前五讲串起来。下面的数字都来自论文本身。
4.1 Stable Diffusion 3(Esser et al. 2024)
| 组件 | SD3 的选择 | 对应本课 |
|---|---|---|
| 概率路径与参数化 | Rectified Flow:CondOT 路径 ,预测速度 | 第 2 讲、第 3 讲 §2.3 |
| 训练时 的分布 | 不是均匀的:logit-normal 分布,在中间的时刻多采样 | 第 2 讲 §5.3(中段最关键) |
| 潜空间 | 自编码器,8 倍下采样,16 个通道(SD 1/2 只有 4 个) | 本讲 §3 |
| 网络 | MM-DiT:图像 token 和文本 token 拼在一起做联合注意力,两种模态各有一套权重;时间和汇总的文本向量用 adaLN 注入;最大约 80 亿参数 | 本讲 §2 |
| 文本编码器 | 两个 CLIP(汇总向量 + token 序列)和 T5-XXL(token 序列) | 本讲 §1.3 |
| 引导 | 训练时随机丢弃文本,采样时用 CFG | 第 4 讲 |
| 采样 | 欧拉法(或类似的 ODE 求解器),几十步 | 第 1 讲 |
SD3 论文做了大规模的对比实验:比较了包括 CondOT、VP 在内的多种路径与时间采样方式,发现 rectified flow 配合 logit-normal 时间采样表现最好;比较了潜空间的通道数,发现通道越多重建越好,而在模型足够大时生成质量也随之提高(练习 7)。
4.2 Meta Movie Gen(Polyak et al. 2024)
视频生成把同样的配方推到了更大的规模:
- 流匹配(CondOT 路径)训练,和 SD3 一样预测速度;
- 时空自编码器(TAE):在时间、高、宽三个方向上各压缩 8 倍,视频在潜空间里变成一串”时空 token”;
- 约 300 亿参数的 Transformer(结构接近 Llama 这样的语言模型),用多个文本编码器的输出作为条件;
- 生成十几秒的高清视频,再用单独的模型做超分辨率。
原课 slides 强调的一点是:从 MNIST 到 Movie Gen,算法完全一样——条件概率路径、流匹配损失、CFG、ODE 采样。差别全在规模、数据和工程:潜空间、网络架构、分布式训练。
5. 小结 · Summary
- 网络的合同: 与 同形状的输出。时间用傅里叶嵌入(对 的小变化更敏感,在 附近向量场更准);提示用嵌入表或预训练的文本编码器(CLIP、T5)。
- U-Net:卷积编码器 / 解码器 + 跳连,局部性与平移等变性适合图像,参数少但计算量大。DiT:patchify + 位置嵌入 + Transformer 块 + depatchify,计算量由 token 数决定,注意力按 token 数平方增长,扩展性好。
- 条件注入:加到特征上、adaLN、adaLN-Zero(恒等初始化,DiT 中效果最好)、交叉注意力、联合注意力(MM-DiT)。
- 潜空间:生成模型只建模语义,解码器负责细节;token 数和计算量都大幅下降。像素数字上,潜空间流匹配全面好于像素空间。
- VAE:编码器输出分布、重参数化、KL 正则; 是”假设的解码器噪声”。 越大潜空间越规整、重建越差,太大会后验坍塌。实践中 取很小的值,把”变成 “交给流模型。
- 案例:SD3 = CondOT 流匹配 + logit-normal 时间采样 + 16 通道潜空间 + MM-DiT + 三个文本编码器 + CFG;Movie Gen = 同样的算法 + 时空自编码器 + 300 亿参数的 Transformer。
6. 常见误区 · Common pitfalls
- “参数越少,训练越快。” 卷积核和注意力在每个位置都要算一遍,U-Net 参数只有 MLP 的五分之一,计算量却是 6 倍(§2.4)。
- “DiT 的 patch 越小越好。” patch 越小,token 越多,计算量线性增长、注意力平方增长;在本讲的小问题上,patch 2 比 patch 3 慢一倍、也没有更好(练习 6)。
- “VAE 的 KL 越大越好,潜空间越接近 越好生成。” 本讲的实验里恰恰相反,普通自编码器的潜空间最好生成(§3.5);大模型的 KL 权重也非常小。
- “潜空间扩散要把 VAE 和生成模型一起训练。” 先训练、冻结 VAE,再在固定的潜空间里训练生成模型(§3.5)。
- ” 才是’正确’的 VAE。” 只对应”解码器噪声标准差 0.71”这个具体的假设( 的像素),没有特殊地位(§3.3)。
- “潜变量不用缩放。” 本讲的例子里影响不大(练习 5),但尺度差得多时会影响调度的表现(第 2 讲练习 7),SD 系列都有一个缩放因子。
- “大模型用的是和本课不同的算法。” SD3、Movie Gen 用的就是 CondOT 流匹配 + CFG + ODE 采样(§4)。
7. 练习 · Exercises
练习 1(两个高斯的 KL)。推导 (一维;对角高斯对各维求和)。
参考答案
。,。在 下 ,。所以 。它在 、 时为 0; 项把均值拉向 0, 项把方差拉向 1。
练习 2(patchify = 步长为 的卷积)。证明”把图切成 的小块、每块展平后乘同一个矩阵 “等价于一个卷积核大小 、步长 、输出 个通道的卷积。
参考答案
步长 、核大小 的卷积在每个不重叠的 窗口上计算 ,对每个输出通道 都用同一个核。把核 展平成 的第 行,窗口展平成 token,两者逐项相同。DiT 的官方实现正是用一个 Conv2d(kernel_size=p, stride=p) 来做 patch 嵌入。
练习 3(数 FLOPs)。U-Net(ch = 16)里,12×12 分辨率上一个 16 → 16 通道的 3×3 卷积,每张图需要多少次浮点运算?占整个网络(8.19 MFLOPs)的多少?
参考答案
每个输出位置、每个输出通道要做 次乘加,共 次乘加,即约 0.66 MFLOPs(乘加算 2 次),占 8%。网络里有好几个这样的 12×12 卷积(下行块 1 两个、上行块 1 两个且输入通道是 48),12×12 分辨率的层占了大部分计算——这也是为什么真实的 U-Net 只在低分辨率层做注意力。
练习 4( 与解码器噪声)。由 §3.3,。、0.1、1 分别对应多大的解码器噪声标准差 ?和 §3.4 表里的重建误差对照。
参考答案
:0.071、0.22、0.71。表里的每像素均方误差是 0.0067、0.0082、0.021,即均方根误差 0.082、0.091、0.145。 小时,假设的噪声(0.07)和实际的重建误差(0.08)相当,模型”相信”自己应该重建得很准; 时假设的噪声(0.71)远大于实际误差,KL 的分量相对很重,编码器宁可少传一些信息。
练习 5(编程:不缩放潜变量)。在 05_latent_flow.py 里,对普通自编码器用 LatentEncoder(vae, sample=False, scale=1.0)(潜变量标准差约 3.3)。生成质量变化大吗?
参考答案(作者机器上的结果)
:判对 87.6%、风格多样性 0.91、Fréchet 距离 0.615(缩放后:88.6%、0.90、0.54);:Fréchet 距离 2.10(缩放后 2.36)。差别不大。8 维、尺度 3 的潜分布对 CondOT 路径来说还在”可以接受”的范围;第 2 讲练习 7 里尺度从 1 变到 8 时调度的排序就变了。实践中缩放是一个便宜的保险。
练习 6(编程:DiT 的 patch 大小)。在 03_train_image_flow.py 里把 DiT 的 patch 从 3 改成 2(36 个 token)。训练时间和质量怎样变化?
参考答案(作者机器上的结果)
训练用时约 40 秒(patch 3:19 秒)。:判对 93.4%、风格多样性 0.85、Fréchet 距离 1.76(patch 3:85.2%、0.91、1.3);:Fréchet 距离 5.68(patch 3:3.8)。计算量翻倍,样本却没有更好(判对率更高但多样性更低、离真实分布更远)。在 12×12 的小图上 patch 3 已经足够细;patch 大小的收益要在大图上才明显(DiT 论文里 patch 越小越好,代价是计算量)。
练习 7(思考:潜空间的通道数)。SD3 把潜空间的通道数从 4 增加到 16。用 §3 的”分工”解释:通道多有什么好处、什么坏处?为什么 SD3 论文发现”模型足够大时”通道多才更好?
参考答案
通道多,潜空间装得下更多信息,解码器的重建更好(细节、文字、小物体);但生成模型要建模的东西也更多、更”细碎”(更接近像素空间的困难)。小模型容量不够,学不好这些额外的信息,生成质量反而可能下降;大模型有余力,就能把更好的重建转化为更好的生成。这和本讲 §3.5 是同一个权衡的另一面:潜空间越”信息丰富”越难学,越”规整简单”重建越差。
8. 延伸阅读 · Further reading
- 原课讲义第 6 章、附录 D 和 Lab 3(https://github.com/eje24/iap-diffusion-labs ,2026 分支:DiT + VAE + 潜空间扩散)。
- Ronneberger, Fischer & Brox, U-Net(MICCAI 2015);Ho et al., DDPM(2020)的 U-Net;Dhariwal & Nichol(2021)的 U-Net 改进。
- Peebles & Xie, Scalable Diffusion Models with Transformers(DiT,ICCV 2023)。
- Kingma & Welling, Auto-Encoding Variational Bayes(ICLR 2014);Higgins et al., β-VAE(ICLR 2017)。
- Rombach et al., High-Resolution Image Synthesis with Latent Diffusion Models(CVPR 2022):潜空间扩散、交叉注意力。
- Radford et al., CLIP(ICML 2021);Raffel et al., T5(JMLR 2020)。
- Esser et al., Scaling Rectified Flow Transformers for High-Resolution Image Synthesis(SD3,ICML 2024)。
- Polyak et al., Movie Gen: A Cast of Media Foundation Models(2024)。
- 本仓库 CMU10-423 第 12、14 讲从另一个角度讲了 VAE、潜空间扩散和 DiT。
9. 下一讲预告 · Next lecture
到现在为止,数据都是连续的向量:图像、潜变量、二维点。文字却是离散的:一串 token,每个 token 是词表里的一个编号。离散空间里没有”沿向量场走一小步”这回事。第 6 讲要回答:
- 离散空间里,ODE / SDE 的对应物是什么?——连续时间马尔可夫链(CTMC)和它的速率矩阵。
- 流匹配的四步(条件路径、条件”向量场”、边缘化技巧、条件损失)能不能原样搬过来?——能,连续性方程变成 Kolmogorov 前向方程。
- 用 [MASK] 作为”噪声”,就得到掩码扩散语言模型。它和自回归语言模型各有什么优劣?