对应 Maps to:Stanford CS230 Fall 2025 Lecture 10(12/2:What’s Going On Inside My Model?、Class Wrap),以及 Lecture 6(10/28)、Lecture 9(11/18)里的 Career Advice、Reading Research Papers 部分;Autumn 2018 Lecture 7 “Interpretability of Neural Networks”(Kian Katanforoosh)和 Lecture 8 “Career Advice / Reading Research Papers”(Andrew Ng),两讲都有 YouTube 公开录像;Coursera C4M4 “What are deep ConvNets learning?”(第 14 讲 §11.1 已经讲过”找出最大激活的图块”)。 依据说明:Fall 2025 的课堂 slides 和录像只对选课学生开放;2018 年这两讲只有公开录像,没有公开的 slides 或讲稿。2018 年 Lecture 7 讲到的方法包括 saliency map、occlusion sensitivity、class activation map、class model visualization、dataset search、deconvolution、DeepDream 等,本讲覆盖了它们,但技术内容以原始论文为准(§14 列出),课上的具体例子和数字可能和录像有出入,本讲不引用录像里的具体数字。读论文和职业建议两节(§8、§9)写的是 Ng 在公开讲座里多次讲过的建议的大意,不是逐字引用。 配套代码 Code:
code/lecture21/(PyTorch;3 个脚本 + 1 个工具模块,每个脚本 30–50 秒)。只有可解释性部分配了代码;读论文、职业和课程总结用文字和表格讲。 预计阅读时间:3 小时(含运行代码)
0. 本讲导航 · How to read this lecture
0.1 学习目标 Learning goals
学完这一讲,你应该能够:
- 说清楚”可解释性”至少有四种不同的用途(调试、信任与问责、科学理解、安全),以及为什么动手之前要先问”解释给谁、用来做什么”。
- 写出并实现五种输入归因方法:vanilla gradient(saliency map)、gradient × input、occlusion、CAM / Grad-CAM、Integrated Gradients;说出每种方法回答的问题、代价和失效的方式;理解 IG 的完整性和基线。
- 会检验一个解释方法:在知道答案的数据上量化(pointing game)、和”不看模型”的对照比、做 sanity check(把模型换成随机数);分清”看起来合理”(plausibility)和”忠实于模型”(faithfulness)。
- 会用归因图做误差分析:在数据集层面找出模型偷偷用的捷径(Clever Hans),用干预确认,用改数据修复。
- 会用线性探针和类别可视化看网络内部,并知道它们的陷阱:探针要配对照(随机网络、对照任务),“能读出”不等于”在使用”;可视化要加先验,而先验本身会改变答案。
- 对机制可解释性有一个准确的初步印象:circuits、superposition(叠加)、稀疏自编码器各自想解决什么问题。
- 会用多遍读法高效地读论文,给自己规划下一步的学习和职业方向,并能把整门课 21 讲串成一张图。
0.2 先修与本讲范围 Prerequisites & scope
| 默认你已经会 Assumed | 本讲只给直觉、不展开 Previewed only |
|---|---|
| 对输入求梯度、优化输入本身(第 5 讲 §4.5:风格迁移、特征可视化、对抗样本) | 对抗样本为什么存在、怎样防御(第 18 讲) |
| CNN、池化、全局池化让网络平移不变(第 12 讲 §9.5) | LRP、DeepLIFT、SHAP 等方法的推导(§2.6 一句话带过) |
BatchNorm 的训练 / 测试模式(第 9 讲 §2),PyTorch 训练循环(第 9 讲 torch_utils) | Transformer 里的机制可解释性细节(§7 只讲直觉) |
| 误差分析(第 10 讲 §6)、捷径与换医院(第 11 讲 §3.3、§9.4) | 公平性、隐私等”可信 AI”的其他方面 |
| 注意力权重的可视化(第 16 讲 §8.3、第 17 讲 §9.4) |
这是最后一讲,分成三块:可解释性(§1–§7,主体,配代码)、读论文与职业(§8–§9)、全课总结(§10)。
0.3 本讲地图 Map
§1  为什么要打开黑盒:四种用途;解释给谁;几组区分;本讲的玩具世界        ← 代码 01 演示 1
§2  输入归因:gradient、grad×input、occlusion、CAM / Grad-CAM、IG        ← 代码 01 演示 2
§3  怎样检验一个解释:完整性与基线;sanity check;注意力算不算解释       ← 代码 01 演示 3、4
§4  用可解释性抓"聪明的汉斯":平均归因图、干预、修复                   ← 代码 02
§5  看网络内部:最大激活、类别可视化、DeepDream                        ← 代码 03 演示 1
§6  表示里有什么:线性探针与对照任务                                   ← 代码 03 演示 2
§7  机制可解释性入门:circuits、叠加、稀疏自编码器                     ← 代码 03 演示 3
§8  怎样读论文:多遍读法、读时问什么、复现
§9  怎样规划学习与职业:T 形、项目与作品集、选团队、之后学什么
§10 全课总结:21 讲一张图;四个反复出现的想法;一份"诚实的意外"清单
§11–15  小结、常见误区、练习、延伸阅读、课程之后
0.4 记号 Notation(沿用第 1 讲 §0.4,本讲新增)
| 符号 | 含义 |
|---|---|
| 输入 时第 类的 logit(softmax 之前的分数)。归因一般解释 logit 而不是概率:概率接近 1 时饱和,梯度几乎为 0 | |
| 输入的第 个分量(一个像素的一个通道);图像是 个分量 | |
| 第 个分量的归因(attribution):它对 有多重要。画成图就是”重要性图 / 显著图” | |
| 基线(baseline):一张代表”什么都没有”的图(全黑、平均色、模糊图……) | |
| 输入相对于基线让分数变了多少 | |
| 最后一层卷积的第 个特征图(本讲 ,) | |
| GAP 之后的线性层里,“第 个通道 → 第 类”的权重 |
0.5 关于数字 · About the numbers
讲义里的实验数字都来自配套代码的实际输出(固定随机种子,同一台机器上重复运行逐字相同)。世界是合成的:类别只由目标物体的形状决定,所以”重要性应该在哪里”有标准答案——真实数据集里通常没有这个奢侈。数字只说明机制,不代表这些方法在 ImageNet 级别的模型上的具体表现。有好几处结果和我写代码前的预想不一样(最意外的一处:灰色的遮挡块自己就像一个”方块”),讲义按实际结果来写,这些情况列在代码 README 的”关于实验结果”里。
1. 为什么要打开黑盒 · Why look inside the model?
1.1 一个思想实验:两个准确率一样的模型
假设你训练了两个图像分类器,在 dev 集上准确率都是 97.5%。一个看的是物体的形状;另一个看的是照片角落里的一个”来源水印”,因为你的训练集里某一类照片恰好大多来自同一个网站。**只看准确率,你分不出它们。**部署以后,第二个模型会在第一张没有水印的照片上出错。
这不是虚构的担心。第 11 讲 §9.4 讲过:胸片模型能以很高的准确率认出片子来自哪家医院,而且会利用这一点(Zech et al. 2018);§4 会讲一个更有名的例子:一个”马”的分类器,看的其实是马照片左下角的版权水印(Lapuschkin et al. 2019)。本讲的代码 02 会造出这样一个模型:它在同分布的 dev 集上得 0.975,看起来一切正常。
所以第一个用途很实际:可解释性是误差分析的工具。第 10 讲 §6 教你”数一数错例属于哪一类”;可解释性让你还能问”模型对对的样本,是因为对的理由才对的吗”。
1.2 四种用途,先问”解释给谁”
| 用途 | 谁要这个解释 | 例子 | 本讲哪里 |
|---|---|---|---|
| 调试、发现捷径 | 做模型的工程师 | 模型在看水印、看医院标记、看背景的雪 | §2–§4 |
| 信任与问责 | 医生、被拒贷的人、监管者 | “为什么判我高风险?""这个读片建议靠不靠谱?” | §1.3 |
| 科学理解 | 研究者 | 网络学到了什么特征?它用什么算法完成任务? | §5–§7 |
| 安全 | 部署大模型的机构 | 在模型内部监测危险的行为倾向,而不只看输出 | §7.4 |
这几种用途要的东西很不一样。工程师要的是忠实(faithful):解释必须真实反映模型的计算,哪怕很难看。一个被拒贷的人要的是可操作:我改变什么,结果会不同?一个监管者要的是可审计:同样的输入总给出同样的解释,而且有记录。所以动手之前先问两件事:解释给谁看?他拿这个解释去做什么决定? 这和第 10 讲”先定单一数字指标再优化”是同一种纪律:先定义”好的解释”,再去找方法。
1.3 几个常用的区分
- 局部 vs 全局(local vs global):解释一个预测(“这张图为什么判成三角”),还是解释模型整体的行为(“这个模型一般靠什么判三角”)。§2 的方法是局部的;§4 把很多局部解释平均起来得到全局的线索;§5–§7 直接研究全局。
- 事后解释 vs 本身可解释(post-hoc vs intrinsically interpretable):先训练一个黑盒、再去解释它;还是一开始就用人能读懂的模型(线性模型、小决策树、规则列表)。Rudin (2019) 有一篇很有影响的文章主张:在高风险决策里,如果一个可解释的模型就能做得差不多好,就不要用黑盒加事后解释。这对表格数据常常成立;对图像、语音、语言,深度网络通常没有可比的可解释替代品,所以本讲主要讲事后方法。
- 忠实 vs 看起来合理(faithfulness vs plausibility):一个解释”看起来对”(人觉得合理),和它”真的反映模型怎么算”是两回事。§3 会看到这两者能分得很开。
1.4 本讲的玩具世界与模型
为了能量化一个解释对不对,代码用了一个知道答案的世界(interp_tools.py):
- 32×32 的彩色图。类别 = 目标物体的形状:三角、十字、圆环、方块,4 类;目标的位置、大小、±25° 的旋转、颜色全是随机的(颜色和类别无关)。
- 周围有 2 个小的干扰物(圆点、横条、竖条),和类别无关。背景是随机底色 + 渐变 + 像素噪声。
- 每张图都带着目标物体的掩码和外接框。目标平均占 6.3% 的像素,外接框(四边各放宽 1 像素)占 15.9%。
模型 GapCNN 是四个”卷积 → BN → ReLU”块(前两块后面有池化),最后一层特征图 是 48 × 8 × 8,接**全局平均池化(GAP)**和一个线性层。为什么非要 GAP?因为 §2.4 的 CAM 需要这种结构。共 24,196 个参数,训练 10 个 epoch(单线程 CPU 约 12 秒),代码 01 演示 1:训练准确率 0.998,测试准确率 0.975。
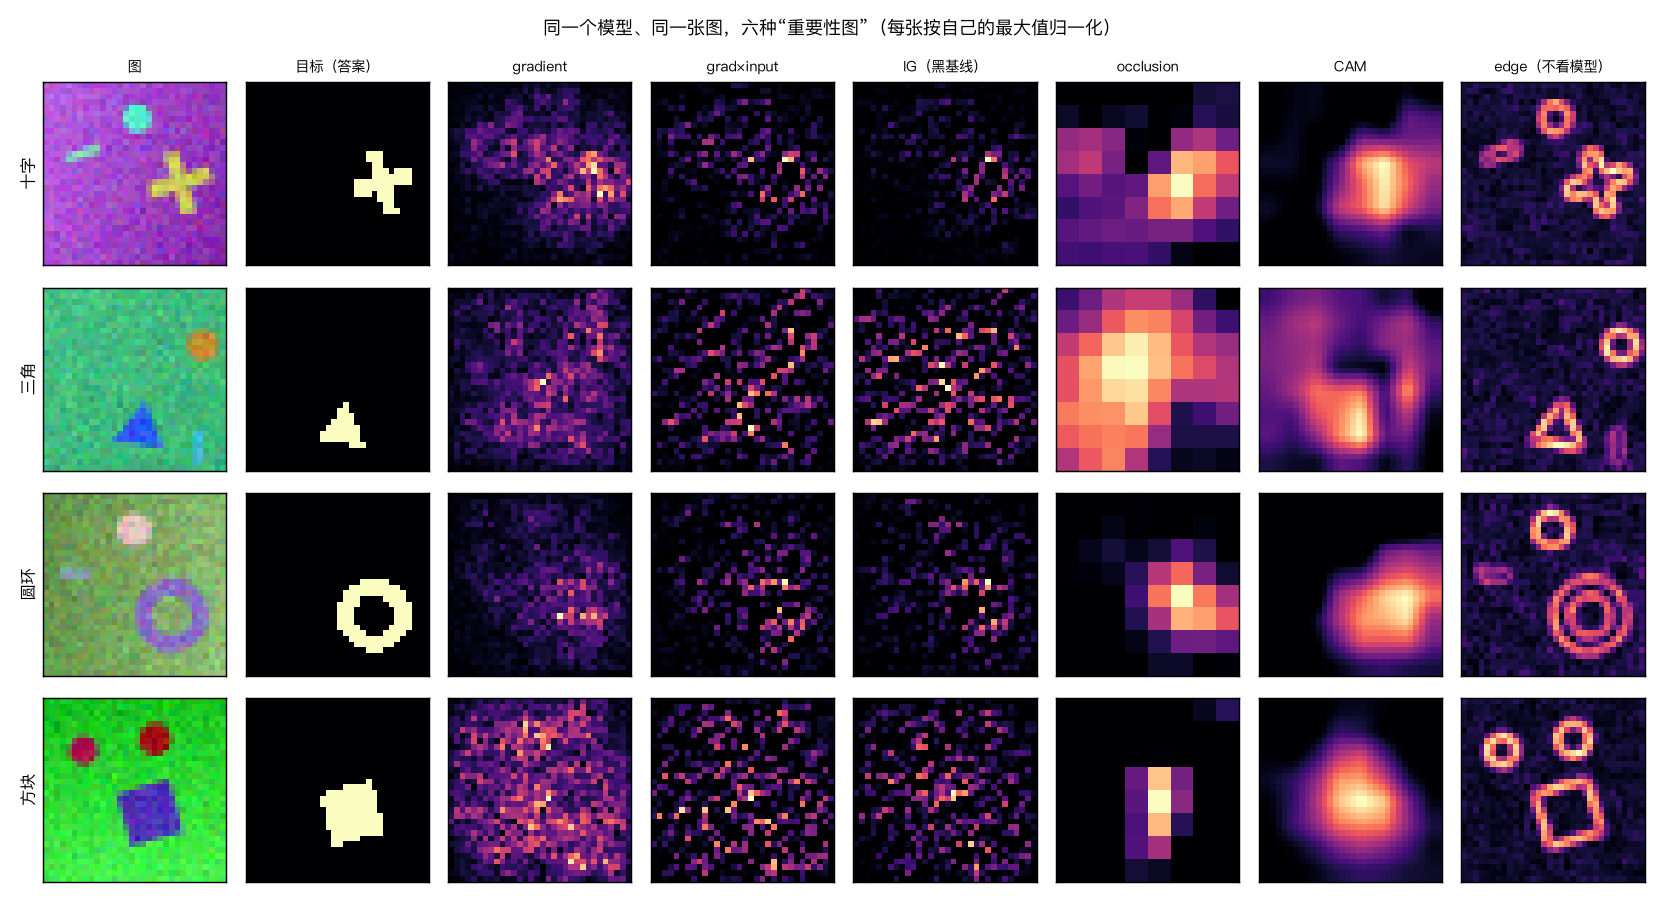
上图是 4 张测试图和六种方法的重要性图(第 2 行的三角形那一行先记住,§3.1 会回来解释 occlusion 为什么在那里”亮错了地方”)。只看图,你大概会觉得 CAM 和 occlusion 最”好看”,gradient 一类满是散点,edge 图(只是 Sobel 边缘,根本不看模型)也挺像那么回事。看图就下结论是这一讲最想让你戒掉的习惯——下面每个判断都用数字说话。
2. 输入归因:哪些像素让模型这样判 · Input attribution
问题:给定一张图 和一个类别 ,给每个像素一个分数 ,表示它对 有多重要。五种经典的回答,代表了三种思路:看梯度(局部敏感度)、拿掉一块看看(扰动)、利用网络结构(CAM)。
2.1 Vanilla gradient:saliency map
最直接的想法来自一阶泰勒展开:
大,说明”这个像素稍微变一点,分数就变很多”。Simonyan, Vedaldi & Zisserman (2014) 把它画成图,叫 saliency map:对每个像素位置,取 3 个通道里 的最大值。
算它只要一次前向、一次反向——和训练时一样,只是反向传播多走一步,走到输入为止(第 5 讲 §4.5 的风格迁移和对抗样本用的是同一个梯度)。代码是 interp_tools.gradient_map。
为什么取绝对值?单个像素的梯度是正还是负意义不大:变亮可能让分数涨,变暗也可能。它的局限也在这里:梯度回答的是”局部敏感度”,不是”贡献”。一个模型已经”确信无疑”的特征,周围的梯度可能很小(饱和),saliency 反而把它画得很暗(§2.5 的例子)。
2.2 Gradient × input
把梯度乘上像素值本身:
( 表示只保留正的部分,即”支持类别 的证据”;§3.2 会看到”只取正”还是”取绝对值”会改变结论。)直觉:对一个线性模型 , 正好是第 个输入相对于”全 0 输入”的贡献,加起来就是 。对非线性网络,这只是一个一阶近似。
2.3 Occlusion:拿掉一块看看
Zeiler & Fergus (2014) 的做法完全不用梯度:用一个灰色方块遮住图的一部分,看类别分数掉了多少;把方块在图上滑一遍,得到一张”遮哪里分数掉得最多”的图。本讲的实现(occlusion_map)用 8×8 的方块、步长 4,每个像素的分数是所有盖住它的方块的”分数下降”的平均:
优点:只要能做前向传播就能用,不需要梯度、不需要知道网络内部——任何黑盒模型都行,而且”拿掉”比”无穷小的扰动”更符合人对”重要”的理解。代价:每张图要做 次前向;分辨率受方块大小限制;还有一个更隐蔽的问题——灰色方块本身也是一种输入,模型对它的反应不一定等于”这块信息没了”(§3.1 会看到一个活生生的例子)。
2.4 CAM 与 Grad-CAM:利用 GAP 的结构
Zhou et al. (2016) 注意到,在”最后一层卷积 → GAP → 线性层”的网络里,logit 可以按位置拆开:
就是 class activation map(CAM):它是一张 的图,平均值加上 正好等于 logit。哪些位置的 大,logit 就主要来自那里。实现只要一行 np.einsum(cam_map),再双线性插值放大到 32×32。CAM 是严格对应模型计算的,这是它的大优点;代价是网络必须是这种结构,而且分辨率只有最后一层特征图那么粗(这里 8×8)。
Grad-CAM(Selvaraju et al. 2017)把 CAM 推广到任何 CNN:用”logit 对特征图的梯度的空间平均”代替权重 :
先想一想:在我们的 GAP 网络上,Grad-CAM 和 CAM 是什么关系?由上面的拆分式,,所以 ,Grad-CAM 恰好是 CAM(的正部分)除以 64。代码 01 演示 2 数值验证:50 张图上 Grad-CAM / CAM 的比值全部是 0.015625(= 1/64),各自归一化后最大差 1.5e-07。
2.5 Integrated Gradients:把”分数的变化”不多不少地分下去
先看一个梯度失灵的例子。设 ,在 处。两个输入显然都很重要(都拿掉,输出从 1 变成 0),但在 附近 已经饱和在 1,梯度是 (0, 0):saliency 和 gradient × input 都说”什么都不重要”(练习 1)。
Sundararajan, Taly & Yan (2017) 的 Integrated Gradients(IG) 的想法是:别只看终点的梯度,沿着从”什么都没有”的基线 走到 的直线,一路把梯度积起来:
上面的例子里,路径 上,前一半梯度是 1、后一半是 0,所以 。
IG 有一个漂亮的性质,完整性(completeness):
这就是微积分基本定理在路径积分上的版本。它说:IG 把”输入比基线多拿的分数”不多不少地分给了每个分量。论文从几条”公理”出发论证 IG:除了完整性,还有敏感性(如果只改一个输入就改变了输出,这个输入的归因不能是 0——梯度在饱和处就违反了它)和实现无关性(两个网络只要输入输出完全相同,归因就应该相同)。
实际计算时,积分用 步的黎曼和近似(integrated_gradients 用中点法则,),代价是 次前向 + 反向。完整性同时给了你一个免费的自检:算完先看 和 对不对得上,对不上就加步数(或者代码有 bug)。
IG 的弱点也很明确:结果依赖基线。“什么都没有”到底是全黑、全灰、还是一张模糊图?基线里已经有的东西(比如全黑基线下的黑色像素)拿不到任何归因。§3.1 会量化这个影响。
2.6 其他常见方法(一句话)
- SmoothGrad(Smilkov et al. 2017):给输入加很多次小噪声,把梯度平均起来,图更干净。
- Guided Backprop(Springenberg et al. 2015)、LRP(Bach et al. 2015)、DeepLIFT(Shrikumar et al. 2017):修改反向传播的规则,得到更”清楚”的图。注意:§3.2 的 sanity check 发现,其中一些方法的图几乎不依赖模型。
- LIME(Ribeiro, Singh & Guestrin 2016):在一个样本附近随机扰动,用一个简单的线性模型去拟合黑盒的输出,读线性模型的系数。论文里有个著名的演示:作者故意用狼的照片都带雪、哈士奇的照片都不带雪的数据训练了一个”哈士奇 / 狼”分类器,LIME 显示它看的是背景里的雪。
- SHAP(Lundberg & Lee 2017):把合作博弈论里的 Shapley 值用到特征归因上,满足一组公理;和 IG 在思想上是近亲(IG 可以看作一种连续版本的路径归因)。
2.7 实验:谁找对了区域?
有了”答案在哪里”,就能给每种方法打分。代码 01 演示 2 在前 200 张测试图上(模型在其中 97.0% 上预测正确),解释每张图的真实类别:
- pointing game(Zhang et al. 2016):重要性最大的那个像素,是否落在目标物体的框里;
- 目标框里 / 目标像素上 / 干扰物上:重要性总量有多大比例落在这些区域;
- 和 edge 图的秩相关:这张图和一张纯粹的边缘检测图有多像。
| 方法 | pointing 命中 | 目标框里 | 目标像素上 | 干扰物上 | 和 edge 图的秩相关 |
|---|---|---|---|---|---|
| gradient | 0.710 | 0.306 | 0.127 | 0.031 | 0.20 |
| grad×input | 0.740 | 0.324 | 0.139 | 0.029 | 0.04 |
| IG(黑基线) | 0.805 | 0.377 | 0.169 | 0.028 | 0.05 |
| occlusion | 0.810 | 0.456 | 0.243 | 0.013 | 0.18 |
| CAM | 0.905 | 0.476 | 0.220 | 0.011 | 0.19 |
| edge(不看模型) | 0.455 | 0.325 | 0.147 | 0.062 | 1.00 |
| 随机图(对照) | 0.155 | 0.161 | 0.065 | 0.024 | −0.00 |
| (面积占比) | — | 0.160 | 0.065 | 0.024 |
先停下来想:随机图的 pointing 命中率应该是多少? 答案是目标框的面积占比——随机挑一个像素,落在框里的概率就是框占全图的比例(0.160;实测 0.155,200 张图的抽样误差约 0.026,练习 5)。这是”什么都没学到”的水平。
几个观察:
- 所有基于模型的方法都远高于随机。CAM 最好(0.905),vanilla gradient 最差(0.710)。
- 一个不看模型的边缘检测器也有 0.455 的命中率,“目标框里”的比例 0.325,和 gradient(0.306)差不多。原因很简单:目标是图里最大、边缘最多的东西。所以”显著图亮在物体上”本身证明不了什么——必须和这种”不看模型”的对照比。
- 真正区分”解释模型”和”描述图像”的地方,是干扰物:edge 图把 0.062 的重要性给了干扰物(比干扰物的面积 0.024 还多),CAM 和 occlusion 只给了 0.011、0.013,低于面积。模型学会了忽略干扰物,忠实的解释也跟着忽略它。
- 所有方法和 edge 图的秩相关都不高(最高是 gradient 的 0.20):它们都不只是边缘检测器。但光凭命中率看不出这一点,下一节的 sanity check 会给出更硬的证据。
3. 怎样检验一个解释 · Evaluating explanations
3.1 “什么都没有”该怎么选:完整性与基线
代码 01 演示 3 (a) 先检验 IG 的完整性(全黑基线,100 张图, 平均 4.845):
| 积分步数 | 平均 | 相对误差中位数 | 误差 < 5% 的图 |
|---|---|---|---|
| 4 | 0.3191 | 0.0673 | 0.39 |
| 16 | 0.0709 | 0.0144 | 0.85 |
| 64 | 0.0198 | 0.0044 | 0.95 |
| 256 | 0.0041 | 0.0007 | 0.99 |
| 对照:grad×input | — | 0.8296 | 0.06 |
步数越多,近似越准;几十步就让绝大多数图的误差落在 5% 以内(论文的经验也是几十到几百步)。grad×input 的”总和”和 差得很远(相对误差中位数 0.83):一步的梯度只描述 附近,而网络从基线到 这一路是高度非线性的。
(b) 换”什么都没有”的定义。同一个模型、同样 200 张图,只换 IG 的基线和 occlusion 的填充:
| 方法 | pointing 命中 | 目标框里 | 三角形的命中 |
|---|---|---|---|
| IG,全黑基线 | 0.805 | 0.377 | 0.523 |
| IG,全白基线 | 0.870 | 0.386 | 0.614 |
| IG,平均色基线 | 0.905 | 0.431 | 0.773 |
| IG,模糊图基线 | 0.890 | 0.602 | 0.795 |
| occlusion,平均色(灰)块 | 0.810 | 0.456 | 0.409 |
| occlusion,黑块 | 0.595 | 0.315 | 0.136 |
| occlusion,填模糊图 | 0.905 | 0.529 | 0.727 |
基线不是细节:IG 的命中率从 0.805(黑)到 0.905(平均色),模糊图基线让 0.602 的重要性落在目标框里(黑基线 0.377)。IG 回答的问题是”相对于基线,什么让分数变高了”——换了基线,就换了问题。模糊图基线保留了整体的颜色和明暗、只抹掉形状,所以它问的是”形状贡献了多少”,正好是这个任务的关键。
最后一列是我写代码时没想到的。occlusion 在三角形上只有 0.409 的命中率,黑块更差(0.136)。(c) 挑出 151 张”左上角不碰目标物体”的图,往左上角放一个 8×8 的平均色方块:
- 各类 logit 的平均变化:三角 −0.51,十字 −0.54,圆环 −0.71,方块 +1.85;
- 12.6% 的图预测改变,其中绝大部分(占全部的 10.6%)是从别的类变成了”方块”——而灰块根本没碰到目标物体。
灰色的遮挡块本身就是一个”方块”。遮住背景,“方块”的分数涨了,“三角”的分数相对就掉了,于是背景也被算成了”重要”,重要性被抹到了整张图上(回去看 §1.4 的图,三角形那一行的 occlusion)。换成填模糊图,三角形的命中率升到 0.727。
这个意外背后是一个普遍的教训:所有”拿掉一部分、看分数怎么变”的方法,都要回答”拿掉”是什么意思。灰块、黑图、全零向量都可能是模型从没见过的输入(分布外),模型对它们的反应未必等于”信息没了”。Hooker et al. (2019) 的 ROAR 为此提出”拿掉之后重新训练再比较”,代价是要训练很多次;也有人用模糊、修补(inpainting)来代替灰块(Fong & Vedaldi 2017)。
3.2 Sanity check:把模型换成随机数,解释还变不变?
Adebayo et al. (2018) 提出了两个简单得近乎粗暴的检验:
- 模型参数随机化:从输出层开始,一层层把训练好的权重换成随机数。如果解释图几乎不变,这个方法就没有在解释模型——它最多在描述输入图像。
- 数据随机化:把训练标签打乱后重新训练(模型只能死记硬背),解释图应该和正常模型的很不一样。
他们发现一些很流行、图也很好看的方法(如 Guided Backprop)在模型随机化之后几乎不变,并且做了一个类比:这样的方法和边缘检测器差不多——边缘检测器既不需要模型,也不需要训练数据。
代码 01 演示 4 做了第一个检验(randomize_from_top:fc → conv4 → … → conv1 逐层换成随机权重,并重新统计被换掉的层的 BN 均值方差)。表中是原模型的图和随机化之后的图的 Spearman 秩相关(100 张图的平均),以及 pointing 命中率:
| 方法 | 只换 fc | + conv4 | + conv3 | + conv2 | 全部随机 | 命中:训练过 | 命中:全部随机 |
|---|---|---|---|---|---|---|---|
| gradient | 0.57 | 0.44 | 0.33 | 0.29 | 0.29 | 0.710 | 0.460 |
| grad×input | 0.04 | 0.10 | 0.05 | 0.02 | 0.02 | 0.770 | 0.390 |
| IG(黑基线) | 0.10 | 0.11 | 0.08 | 0.02 | 0.02 | 0.830 | 0.450 |
| occlusion | 0.05 | 0.09 | 0.16 | 0.09 | 0.10 | 0.800 | 0.210 |
| CAM | −0.00 | 0.20 | 0.14 | 0.12 | 0.09 | 0.920 | 0.320 |
| edge(不看模型) | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 | 0.450 | 0.450 |
| grad×input,取绝对值 | 0.38 | 0.28 | 0.18 | 0.15 | 0.14 | 0.700 | 0.480 |
| IG,取绝对值 | 0.33 | 0.27 | 0.16 | 0.15 | 0.10 | 0.830 | 0.460 |
(完全随机的模型准确率 0.23,瞎猜是 0.25。这张表用前 100 张图,所以”训练过”一列和 §2.7 的 200 张图略有不同。)
怎么读:
- edge 图就是”不及格”的样子:相关系数永远是 1.00。
- 只换掉最后的线性层,CAM 的相关立刻掉到 −0.00,grad×input、IG、occlusion 也在 0.1 上下:它们确实依赖”模型要分哪一类”。vanilla gradient 掉得最少:只换 fc 后 0.57,整个网络随机后还有 0.29。|梯度| 里有相当一部分来自输入本身的结构(哪些 ReLU 被激活,取决于图里哪里有边缘),不随模型变。
- 画法会改变结论:同样是 grad×input,只保留正的部分时只换 fc 后相关 0.04,取绝对值时 0.38(IG:0.10 vs 0.33)。符号跟着模型变,而 里的 不跟着变——乘上输入的方法,取了绝对值就带上了输入自己的样子。原论文也讨论过取不取绝对值的影响。
- 最扎眼的是最后两列:一个完全随机的网络,gradient 的命中率还有 0.460,IG 还有 0.450。也就是说,§2.7 表里的命中率有一大块是”目标物体最大、对比最强”白送的。该比的是”训练过 − 随机”的差:CAM +0.600,occlusion +0.590,gradient 只有 +0.250。
一句话:评价一个解释方法,“看起来合理”远远不够;至少要确认它对模型(和数据)敏感,并且和一个不看模型的对照比。 其他常见的定量检验还有 deletion / insertion 曲线(按重要性从高到低逐步删掉 / 加入像素,看分数下降 / 上升得多快,Petsiuk et al. 2018)。
3.3 注意力权重算不算解释?
第 16 讲 §8.3 把日期翻译的注意力画成了热力图:输出年份时看输入末尾的年份,非常”可解释”。第 17 讲 §9.4 却看到一个反例:GRU + 注意力在反转任务上 93% 的时候看的是镜像位置的下一个编码器状态,而不是镜像位置本身——因为单向 GRU 的那个状态里也还记着要复制的词。注意力权重告诉我们”看了哪里”,不直接告诉我们”取了什么”。
文献里有过一场有名的争论。Jain & Wallace (2019) 的标题就是 “Attention is not Explanation”:他们发现注意力权重常常和梯度类的重要性度量不一致,而且能构造出很不一样、预测却几乎不变的注意力分布。Wiegreffe & Pinter (2019) 回应 “Attention is not not Explanation”:要不要算解释取决于你怎么定义解释,对抗地构造出另一组权重并不说明原来的权重没有意义,并提出了更严格的检验。比较平衡的结论是:注意力图是很好的调试线索,但要当作”解释”使用,就要像 §3.2 一样去检验它(比如改变注意力、看输出变不变)。
第 15 讲 §10.5 是同一个教训在 RNN 上的版本:直觉说”GRU 靠关上更新门来记住主语”,打开看却发现训练好的 GRU 门开着一半,靠的是吸引子动力学。直觉解释、可视化出来的”解释”和真正的机制,可能三者都不一样。
4. 用可解释性抓”聪明的汉斯” · Catching Clever Hans
4.1 一匹会算术的马
20 世纪初的德国有一匹叫汉斯(Hans)的马,据说会算算术:问它 3 + 2,它就用蹄子敲 5 下。心理学家 Oskar Pfungst 后来查明,汉斯并不会算术,它看的是提问者的身体语言——敲到正确次数时,提问者会不自觉地放松,汉斯就停下。答案是对的,理由是错的。
“Clever Hans 预测器”于是成了机器学习里”为错误的理由给出正确答案”的代名词。最有名的例子来自 Lapuschkin et al. (2019):PASCAL VOC 数据集里有一部分马的照片左下角带着版权水印(照片的来源标记),一个 Fisher vector 分类器学会了靠水印认马。归因图把重要性画在了左下角;去掉水印,它就认不出马了;给一张汽车的照片加上水印,它就说这是马。同类的例子还有 LIME 论文里”靠雪认狼”的分类器(§2.6),以及第 11 讲 §9.4 的”认医院”的胸片模型(Zech et al. 2018)。Geirhos et al. (2020) 把这类现象统称为捷径学习(shortcut learning)。
第 11 讲 §9.4 的实验里,我们事先知道标记在哪,直接去遮它。真正难的情况是:你不知道捷径是什么。代码 02 问的就是:如果不知道,可解释性工具能不能把它找出来?
4.2 一个藏着捷径的训练集
代码 02 在 §1.4 的世界里加了一个”水印”:左下角一个 4×4 的纯色方块(红、绿、蓝、黄),像图片网站盖在照片上的来源角标。训练集里水印颜色和类别的一致比例是 0.897(设定是 90%,这个比例是写代码之前定的)。另外三份评估数据:同分布的 dev 集(水印也 90% 一致)、“去相关”测试集(水印颜色随机)、没有水印的测试集。代码 02 演示 1:
| 模型 | 同分布 dev | 去相关(水印随机) | 没有水印 |
|---|---|---|---|
| 带捷径的模型 | 0.975 | 0.805 | 0.907 |
只看同分布的 dev 集,这个模型毫无可疑之处(和 §1.4 的干净模型一样是 0.975)——dev 和训练集来自同一个采集过程,带着同一个偏差(第 11 讲 §3.3”实验室的灯”)。在水印和类别冲突的 740 张去相关测试图上,模型有 0.222 的图跟着水印走,0.736 仍然判对:它两条线索都学了。真实的捷径往往就是这样”掺”在里面,所以只看总准确率很难发现。
4.3 从一张图到整个数据集:平均归因图
一张张看归因图,你会不时碰到”奇怪地指着角落”的图:IG 有 0.340 的 dev 图把最重要的像素放在水印上。但这个数要和对照一起读——边缘检测器也有 0.320 的图最亮点在水印上(一个高对比的小方块,谁画边缘都会亮)。
更好的办法是平均:目标物体的位置每张图都不同,把 200 张图的归因图平均起来,随位置变化的东西会被抹平,而”每张图都在同一个地方”的东西会留下一个亮点。这是 Lapuschkin et al. 的 SpRAy(对大量归因图做谱聚类)最简单的版本。代码 02 演示 2(水印区域占图的 0.0156):
| 方法 | 重要性落在水印上 | 是面积的几倍 | 最重要的像素在水印上 |
|---|---|---|---|
| gradient | 0.0174 | 1.1 | 0.050 |
| IG(黑基线) | 0.0508 | 3.3 | 0.340 |
| occlusion | 0.0412 | 2.6 | 0.000 |
| CAM | 0.0288 | 1.8 | 0.000 |
| edge(不看模型) | 0.0458 | 2.9 | 0.320 |
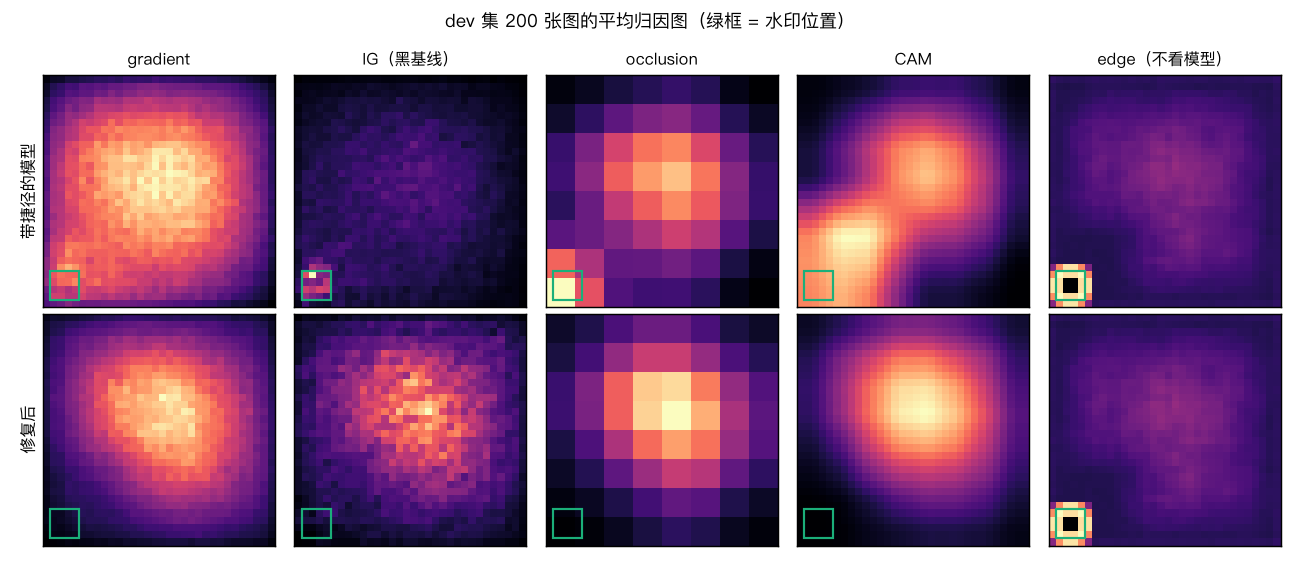
上排是带捷径的模型。IG 和 occlusion 的平均图左下角有明显的亮点;CAM 在左下方有一大片亮区(8×8 的特征图太粗,亮区比水印大得多,所以”倍数”只有 1.8)。vanilla gradient 几乎看不见水印(1.1 倍):它的平均图是一团居中的雾。一个纯色方块对微小扰动并不敏感——模型用了它,局部梯度却未必大。Adebayo et al. (2022) 在更真实的设置里也报告过,一些事后解释方法很难发现事先不知道的伪相关。所以”用哪种方法”本身会决定你能不能发现问题。
而边缘检测器也是 2.9 倍。所以”平均图里有个亮点”只是线索:它可能来自模型对水印的使用,也可能只是水印本身显眼。下面两步把这两种可能分开。
4.4 干预:线索变成证据
归因图说”模型可能在看这里”;干预(intervention)直接回答”改这里,输出变不变”。水印是事后盖上去的纯色方块,把它换成另一种颜色只改了 16 个像素,图上别的东西一个都没动——这是一个干净的反事实输入。代码 02 演示 3(dev 集 1000 张):
| 水印换成 | 预测 = 这个颜色对应的类别 | 预测 = 真实类别 |
|---|---|---|
| 红(→ 三角) | 0.481 | 0.759 |
| 绿(→ 十字) | 0.422 | 0.808 |
| 蓝(→ 圆环) | 0.306 | 0.892 |
| 黄(→ 方块) | 0.444 | 0.787 |
只换 16 个像素,45.6% 的图的预测会随水印颜色改变;预测”跟着水印走”的比例平均 0.413,远高于完全不看水印时的 0.25。这才是”模型在用水印”的证据。这和 Lapuschkin et al. 的”去掉水印 / 给汽车加上水印”、第 11 讲 §9.4 的”给阴性片子加标记”是同一类实验。
干预要求你能构造反事实的输入(同一张图、只改一处)。合成世界里很容易;真实数据里要靠图像编辑、生成模型或者重新采集。这也是归因图仍然有用的原因:它告诉你该去干预什么。
4.5 修复:改数据,再检查一遍
最直接的修法是打破相关性:训练时让水印颜色随机(同样的 4000 张图,物体逐像素相同,只有水印颜色不同),重新训练。代码 02 演示 4:
| 模型 | 同分布 dev | 去相关(水印随机) | 没有水印 |
|---|---|---|---|
| 带捷径的模型 | 0.975 | 0.805 | 0.907 |
| 修复后(训练集水印随机) | 0.969 | 0.960 | 0.966 |
- 去相关测试集从 0.805 回到 0.960。但在同分布 dev 上,修复后的模型反而低了一点(0.969 vs 0.975):在 dev 也带水印的世界里,捷径确实”有用”。只看 dev 挑模型,你会挑带捷径的那个——和第 11 讲 §9.4”遮住标记后内部 AUC 降、外部 AUC 升”是同一个现象。
- 平均归因图上的亮点消失了(上图下排):IG 落在水印上的重要性从面积的 3.3 倍降到 0.4 倍,occlusion 从 2.6 倍降到 0.3 倍。而边缘检测器还是 2.9 倍——水印照样显眼,模型不再用它。这就把 §4.3 的两种可能分开了。
- 干预:修复后的模型”跟着水印走”的比例 0.251(≈ 瞎猜),换颜色只改变了 0.008 的图的预测。
修复的办法不止一种:让捷径和标签无关(这里的做法)、把它从输入里去掉(第 11 讲遮住角落)、或者多采集”捷径不成立”的数据。共同点是:改的是数据,而不是模型结构——又一次回到”数据是深度学习项目的核心”。
4.6 可解释性在误差分析里的位置
把 §2–§4 合起来,可以加进第 10 讲的误差分析流程里:
- 先看对照:在知道答案的少量样本上(或者人工标几十张”该看哪里”),比较归因方法和一个不看模型的对照,挑一个靠谱的方法。
- 看整体,不只看单张:平均归因图、按类别 / 按数据来源分组的平均图、对归因图聚类。“总在同一个地方亮”是捷径的典型信号。
- 拿线索去干预:只改可疑的那部分输入,看预测变不变;或者构造一个”捷径不成立”的测试集。
- 改数据,再检查:修复后重新跑第 2、3 步,确认亮点消失、干预不再改变预测,并且在”捷径不成立”的数据上变好了。
5. 看网络内部:单元与类别 · Visualizing units and classes
§2–§4 问”输入的哪一部分重要”。从这一节起,我们转向网络内部:一个单元、一层、一个类别在网络眼里是什么。
5.1 找出让一个单元最兴奋的图
最简单的办法是数据集搜索(dataset search):在整个数据集里找出让某个单元激活最大的那些图块,看它们有什么共同点。第 14 讲 §11.1 做过:在第 13 讲的源模型上,conv3_2 的单元大多只对某一类形状有反应(类别纯度 0.648,随机网络约 0.19)。
Zeiler & Fergus (2014) 更进一步,用一个”反卷积网络”(deconvnet)把单元的激活投影回像素空间,看是图块里的哪些像素让它兴奋。他们在 ImageNet 上训练的大网络里看到了第 4 讲 §5.1 讲的层次:第一层是边缘和颜色斑块,第二层是纹理和简单图案,越往深越接近物体的部件和整个物体。注意这是大网络 + 大量自然图像的结果:第 12 讲 §8.4 看到,在合成手势上训练的小网络,第一层 8 个滤波器里只有 1 个像教科书的边缘检测器。“网络学出边缘检测器”不是必然的,它取决于数据和容量。
Bau et al. (2017) 的 Network Dissection 把这种分析自动化:用一个带逐像素概念标注的数据集,量化每个单元和”天空""车轮""条纹”这类概念的重合程度。
5.2 Activation maximization:直接”画出”网络想看的东西
反过来问:什么样的输入能让某个单元(或某一类的 logit)最大?这是一个优化输入的问题(Erhan et al. 2009),用的还是第 5 讲 §4.5 的那一招——固定参数、对输入求梯度、改输入。Simonyan et al. (2014) 把它用在类别上,叫 class model visualization:
第 5 讲 §4.5 不加正则做过一次:得到的”最像夜晚”的图满是亮暗相间的斑点,不像任何照片。原因是:能让 logit 变大的方向非常多,其中绝大多数是人眼看来毫无意义的高频噪声——这和对抗样本(第 18 讲)是同一个现象。所以要加先验,告诉优化”自然图像长什么样”:
- L2:别让像素跑到极端(Simonyan et al. 2014);
- 全变差(total variation):惩罚相邻像素的跳变,让图平滑(Mahendran & Vedaldi 2015);
- 变换鲁棒性:每一步把图随机平移 / 缩放 / 旋转一点再送进网络,只对某个精确位置有效的噪点图案得不到奖励(Olah, Mordvintsev & Schubert 2017 的 Feature Visualization;Yosinski et al. 2015 用的是 L2 衰减、高斯模糊、把贡献小的像素清零这一类正则)。
DeepDream(Mordvintsev, Olah & Tyka 2015)是同一个想法的”艺术版”:不是从灰图出发找某一类,而是拿一张真实照片,放大某一层已经检测到的任何东西(“你在这里看到了一点狗脸?那就让它更像狗脸”),反复几次,照片里就长满了眼睛和狗头。同一篇博客里还有一个很有教育意义的例子:可视化”哑铃”这一类时,画出来的哑铃总连着一条肌肉发达的胳膊——网络从训练照片里学到的”哑铃”包括了举着它的手臂。可视化在这里起的作用,正是 §4 说的发现数据里的偏差。
5.3 实验:怎样判断哪张可视化更”真”?
代码 03 演示 1 对 §1.4 的模型(称为模型 A)做类别可视化:从一张灰图出发,用 Adam 改像素 200 步,目标是 。正则强度 lam = 0 时什么先验都没有。
怎样判断一张可视化”真不真”?人眼不可靠;一个可以量化的办法是:拿给另一个独立训练的模型 B(同样的数据、不同的初始化种子,测试准确率 0.981)看,它认不认得出。只利用 A 自己”怪癖”的图,B 不会认。另外用”粗糙度”(相邻像素差的平均)衡量图有多不自然:
| 正则强度 lam | (自己) | (另一个模型) | 粗糙度 | :三角 / 十字 / 圆环 / 方块 |
|---|---|---|---|---|
| 0 | 1.000 | 0.250 | 0.415 | 0.00 / 1.00 / 0.00 / 0.00 |
| 1 | 1.000 | 0.497 | 0.284 | 0.00 / 1.00 / 0.99 / 0.00 |
| 3 | 1.000 | 0.500 | 0.206 | 0.00 / 1.00 / 1.00 / 0.00 |
| 10 | 0.733 | 0.732 | 0.064 | 0.91 / 1.00 / 0.01 / 1.00 |
| (真实测试图) | 0.067 |
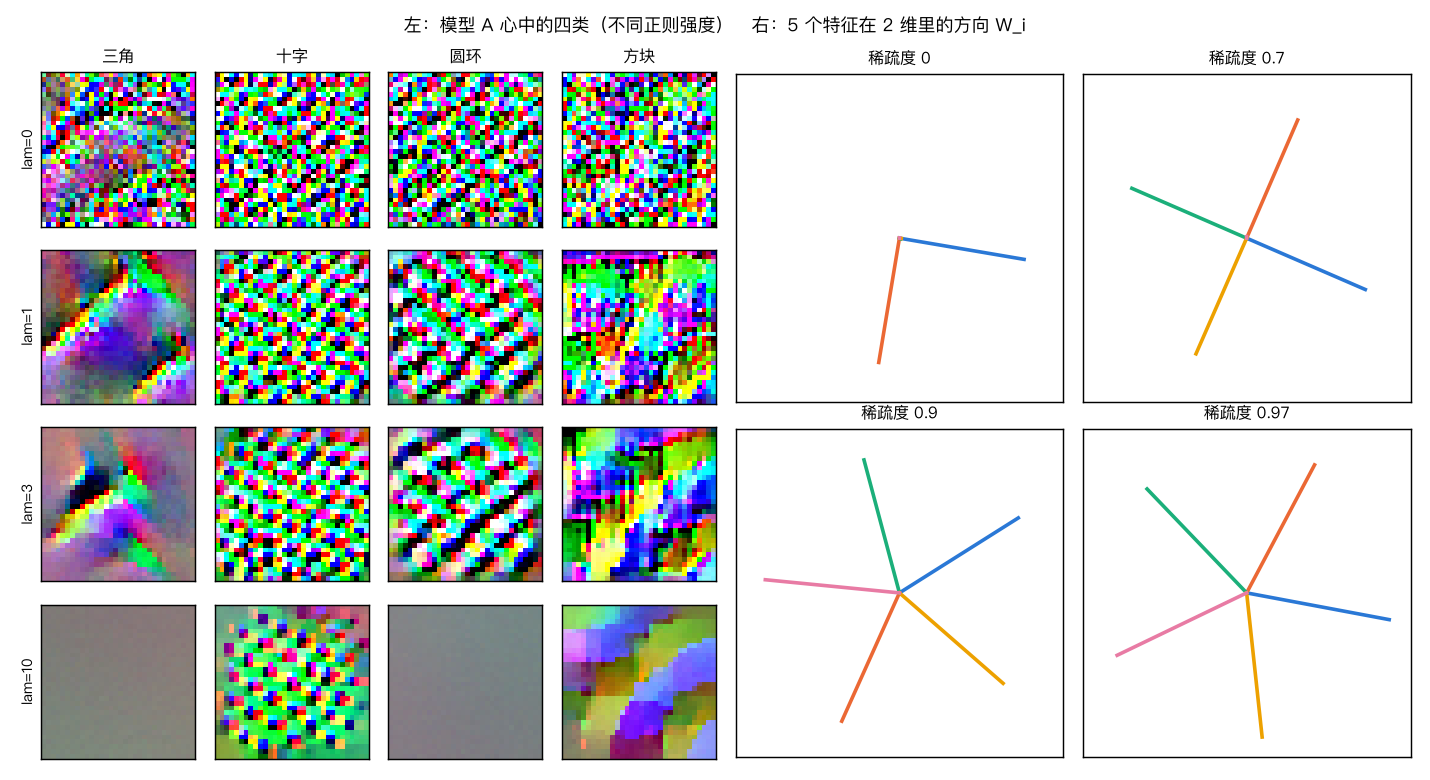
- 不加正则:A 给出 1.000 的概率,图却满屏噪点(粗糙度 0.415,真实图 0.067),B 只认得”十字”一类。
- 加正则:图变平滑,B 认得的类别从 1 类变成 2 类,A 自己仍然是 1.000——留下的更多是两个模型共有的特征。但”三角""方块”B 仍然完全不认。
- 正则太强(lam = 10):图和真实图一样平滑,A 自己的概率却掉到 0.733;“三角""圆环”的图几乎成了一片纯灰。B 给”三角”的 0.91 并不是”认出来了”:两个模型都把一张纯灰图判成”三角”(A 0.88、B 0.91)——这只是它们对”什么都没有”的默认回答。指标也会被退化的图骗过,一定要看图本身。
- 看上图左边:十字、圆环的可视化是铺满全图的重复纹理,而不是一个完整的物体。原因在结构里:GAP 网络的 logit 是各个位置的平均,“到处都是十字的局部特征”比”一个十字”得分更高。很多 ImageNet 模型的类别可视化里也能看到同一个部件在图上重复出现,道理相同。
结论:类别可视化是有用的线索——它告诉你模型对什么敏感、有没有学到奇怪的东西;但先验的选择会改变”答案”,它不保证那就是模型在真实图片上用的东西。
6. 表示里有什么:线性探针 · Probing representations
6.1 想法
第 1 讲 §2.3 第一次用了线性探针(linear probe):拿一层的输出当特征,用一个线性模型去预测某个量(比如房价例子里看不见的 walkability),看预测得多准。准,说明这一层”已经算好了”这个量,后面的层只需要一个线性组合就能用上它。Alain & Bengio (2016) 把它系统地用在网络的每一层上,作为理解中间层的工具。今天它被大量用在语言模型上(“第几层编码了词性?句法树?事实?”)。
探针要尽量简单:探针越强,越说不清”信息本来就在表示里”还是”探针自己算出来的”。代码 03 用岭回归(线性模型 + L2 正则,ridge_probe),在训练部分拟合、验证部分挑正则强度、测试部分报告;分类任务把标签写成 one-hot 当回归做,预测取 argmax。
6.2 实验:每一层能读出什么?
代码 03 演示 2 用 2400 张新的图(训练 1200、验证 400、测试 800),对模型 A 的每一层读四样东西:类别;目标的位置(中心坐标,R²);目标的颜色(和类别无关的信息,R²);以及一个对照任务(§6.3)。下面全是测试集上的分数:
| 层 | 维数 | 类别 | 目标位置 | 目标颜色 | 对照任务 | selectivity |
|---|---|---|---|---|---|---|
| 输入像素 | 3072 | 0.274 | −0.002 | 0.755 | 0.312 | −0.039 |
| block1 | 3072 | 0.405 | 0.542 | 0.621 | 0.647 | −0.242 |
| block2 | 1536 | 0.640 | 0.555 | 0.542 | 0.655 | −0.015 |
| block3 | 2048 | 0.906 | 0.604 | 0.373 | 0.696 | 0.210 |
| block4 | 3072 | 0.960 | 0.790 | 0.167 | 0.674 | 0.286 |
| GAP | 48 | 0.971 | 0.141 | 0.173 | 0.359 | 0.612 |
| logits | 4 | 0.964 | 0.001 | −0.000 | 0.311 | 0.652 |
同样结构、随机初始化、没训练过的网络(对照模型):
| 层 | 类别 | 目标位置 | 目标颜色 | 对照任务 |
|---|---|---|---|---|
| block1 | 0.315 | 0.410 | 0.693 | 0.570 |
| block2 | 0.365 | 0.475 | 0.607 | 0.549 |
| block4 | 0.390 | 0.087 | 0.467 | 0.545 |
| GAP | 0.365 | 0.089 | 0.234 | 0.328 |
读这两张表:
- 类别越往深越好读:输入像素 0.274(≈ 瞎猜:一个线性模型在像素上根本分不出位置随机、颜色随机的形状)→ block2 0.640 → block4 0.960。随机网络各层只有 0.32–0.39:随机的卷积 + ReLU 也是一种非线性特征,能给一点(第 1 讲 §2.3 里随机隐藏层读出 0.40 的 walkability 是同一个现象),但”把类别变成线性可读”主要是训练的功劳。
- 位置:卷积特征图保留了”在哪里”(block4 R² 0.790),GAP 一平均就几乎没了(0.141),logits 里完全没有(0.001)。这正是第 12 讲 §9.5 全局池化让 CNN 平移不变的原因,也是 CAM 必须在 GAP 之前的特征图上算的原因。
- 颜色:训练过的网络一层层把它扔掉(像素 0.755 → block4 0.167),随机网络扔得少得多(block4 0.467)。网络只保留”对任务有用”的信息——和第 1 讲 §2.3 里 family_size 从隐藏层读反而略低是同一个道理。
6.3 三个陷阱:对照模型、对照任务、“能读出 ≠ 在使用”
(1) 一定在留出的数据上报告。 每张图独立抽一个完全随机的标签,在 block4(3072 维,比训练样本还多)上用几乎不加正则的线性探针:训练准确率 1.000,测试 0.261。维数比样本多时,线性模型能记住任何标签。探针的训练集分数测的是探针的容量,不是表示里的信息。
(2) 要有对照。 对照可以是对照模型(上面的随机网络),也可以是对照任务。Hewitt & Liang (2019) 在语言模型上提出:给每个词型(word type)随机指定一个假标签,让探针去学”词 → 假标签”。这个任务没有任何语言学意义,探针要做好只能靠”认出是哪个词 + 记住一张表”。真任务和对照任务的准确率之差叫 selectivity:一个好的探针应该真任务高、对照任务低。他们发现线性探针比多层的 MLP 探针 selectivity 更高。
代码里的对照任务是这个想法在图像上的类比:按目标中心落在 4×4 的哪个格子把图分成 16”型”,每型随机指定一个假标签(每个假标签恰好 4 个格子,瞎猜约 0.25)。结果出乎我的意料:在 block1 上,探针做这个毫无道理的任务做到了 0.647,比真正的类别(0.405)还高。卷积特征图保留了位置,线性探针就能”认格子再查表”。所以”block1 上类别是 0.405”这个数要和 0.647 一起读;selectivity 从 block1 的 −0.242 升到 GAP 的 +0.612。
(3) 能读出,不等于在使用。 GAP 里还能读出一点颜色(0.173),但 logits 里是 −0.000:最后的线性层根本没去读它。探针只能说明信息在那里,不能说明模型用了它。要回答”用没用”,还是要回到干预:把表示里的这个信息抹掉(比如 Elazar et al. 2021 的 amnesic probing)或者改掉,看输出变不变——和 §4.4 是同一个逻辑。TCAV(Kim et al. 2018)沿着这个方向更进一步:用探针找到”条纹”这类人定义的概念在表示空间里的方向,再测模型的输出对这个方向有多敏感。
7. 机制可解释性入门 · A first look at mechanistic interpretability
7.1 从”哪里重要”到”怎么算的”:circuits
§2–§6 的方法都在回答”什么和什么有关”。机制可解释性(mechanistic interpretability)想要的更多:像逆向工程一个编译好的程序一样,把网络的计算还原成人能读懂的算法。
Olah et al. (2020) 的 “Zoom In: An Introduction to Circuits” 是这个方向的宣言。它在 InceptionV1 上提出了三个(作者自己也说是推测性的)论断:
- 特征(features)是网络的基本单位,它们可以被理解:早期层有曲线检测器、边缘检测器,后面的层有”车轮""松软的耳朵”这样的检测器;
- 特征通过权重连成电路(circuits),电路实现的是有意义的算法:比如由几个方向的曲线检测器拼出圆的检测器,由车窗、车身、车轮检测器拼出汽车检测器——你可以直接读权重,看到”上面要有车窗、下面要有车轮”;
- 普遍性(universality):类似的特征和电路会在不同的网络里反复出现。
但他们也遇到了一个大麻烦:多义神经元(polysemantic neurons)。比如一个单元同时对猫脸、汽车的前脸和猫腿有反应。一个单元对应好几个不相干的概念,“读懂每个神经元”这条路就走不通了。为什么会这样?
Transformer 上也有类似的发现。Olsson et al. (2022) 找到了一类归纳头(induction heads):两个注意力头配合实现”前面出现过 A 后面跟着 B,现在又看到 A,就预测 B”的复制算法,并论证它和上下文学习(in-context learning)的出现密切相关。这是”把注意力模式读成算法”的一个成功例子——和 §3.3 的警告并不矛盾:他们靠的不只是看注意力图,还有对权重的分析和干预实验。
7.2 叠加:特征比维数多的时候
Elhage et al. (2022) 用一个小得不能再小的玩具模型回答了”为什么会多义”:
把 个特征压进 维的隐藏层,再还原;损失是加权的还原误差 ,越靠前的特征越重要()。每个特征以概率 出现(取 0–1 之间的随机值),否则为 0, 叫稀疏度。 的第 列 就是特征 在隐藏空间里的方向: 表示它被表示了, 表示被放弃了。
先想一想:2 维里最多只有 2 个方向能两两正交。如果网络非要表示 5 个特征,会怎样?代码 03 演示 3(,,每个设置训练 3 个初始化取损失最低的):
| 稀疏度 | 被表示的特征 | 各特征的 | 相邻方向的夹角(度) | 最大正串扰 | 偏置 的平均 |
|---|---|---|---|---|---|
| 0 | 2 | 1.00 1.00 0.01 0.02 0.00 | 90 270 | 0.00 | 0.29 |
| 0.7 | 4 | 1.03 1.02 0.99 1.00 0.01 | 90 90 90 90 | 0.00 | 0.04 |
| 0.9 | 5 | 1.11 1.12 1.09 1.09 1.07 | 73 73 73 69 71 | 0.41 | −0.20 |
| 0.97 | 5 | 1.15 1.15 1.14 1.15 1.14 | 70 73 73 72 72 | 0.44 | −0.26 |
| 0.9,去掉 ReLU | 2 | 1.00 1.00 0.02 0.01 0.03 |
- 特征不稀疏():只放最重要的 2 个,两两正交,其余的放弃——这是 PCA 式的”一个维度一个特征”。
- 越稀疏,挤进去的越多: 时 4 个(两对方向相反的特征,彼此 90°), 起 5 个特征排成正五边形(相邻约 72°,见 §5.3 图的右半)。这就是叠加(superposition)。
- 代价是串扰:相邻的两个特征方向夹角 72°,,表中实测最大正串扰 0.41–0.44。特征 出现时,特征 的输出会被”串”进一点。为什么网络愿意付这个代价?因为特征稀疏,两个特征很少同时出现;而偶尔的小串扰被负的偏置 + ReLU 滤掉(稀疏时偏置平均 −0.20、−0.26;练习 8 算一算能滤掉多少)。去掉 ReLU,同样的稀疏度下只剩 2 个特征:叠加需要非线性。
这个玩具模型解释了多义神经元:如果真实世界的特征远比神经元多、而且大多稀疏(一张图里绝大多数概念都不出现),网络就会把它们叠加起来存放,每个神经元同时参与好几个特征,单看一个神经元当然是”多义”的。这也呼应了第 1 讲 §2.3 的分布式表示:没有哪个隐藏单元单独等于 walkability。
7.3 稀疏自编码器:把叠加的特征拆开
如果特征是叠加存放的,那就换一组”基”:学一个过完备的字典(字典里的方向比神经元多得多),让每个激活向量都能写成少数几个字典方向的组合。这就是字典学习,用神经网络来做就是稀疏自编码器(sparse autoencoder,SAE):
是模型某一层的激活, 的维数远大于 ,L1 惩罚让每个输入只激活少数几个 。希望每个 对应一个单义的特征。
- Bricken et al. (2023) 在一个单层 Transformer(MLP 层有 512 个神经元)上训练 SAE,字典大小从 512 一直到 131,072。拆出来的很多特征比原来的神经元单义得多,比如只在 DNA 序列上、或只在阿拉伯文字上激活的特征。
- Templeton et al. (2024) 把这个方法放大到一个生产级的大语言模型(Claude 3 Sonnet),拆出了数以百万计的特征,其中有对应具体实体的(比如”金门大桥”)、也有对应抽象概念的。把”金门大桥”特征人为调高,模型就会在各种话题里都扯到金门大桥——这又是一次干预,说明这个特征不只是”能读出”,还真的影响模型的行为。
7.4 现状与局限
- 机制可解释性进展很快,但离”完全读懂一个大模型”还很远:SAE 拆出来的特征不一定都单义,重建也不完美,大量计算仍然没有被解释。
- 验证是最难的部分:一个漂亮的故事很容易讲,证明它是模型真正的计算方式很难。§3 的教训在这里同样适用——要有对照、要有干预、要能被证伪。
- 它和安全的关系:如果能在模型内部可靠地识别出某些行为倾向(比如欺骗、危险的计划),就可以在输出之前发现问题。这是很多研究者投入这个方向的动机,但目前还是一个研究目标,不是成熟的工具。
8. 怎样读论文 · How to read research papers
本讲义每一讲的末尾都有”延伸阅读”,本讲 §2–§7 的每个方法也都来自一篇具体的论文。课程只是一个快照:你学完的时候,这个领域又往前走了。所以”会读论文”是一项比任何具体模型都更持久的能力。这一节写的是 Andrew Ng 在公开讲座里多次讲过的读论文方法的大意,再加上 S. Keshav 那篇被广泛引用的短文 How to Read a Paper(2007)。
8.1 进入一个新方向:先列清单,并行地读
Ng 的建议是,想了解一个新方向(比如”语音识别”或者”可解释性”)时,不要拿起一篇论文从头读到尾、读完再找下一篇:
- 先列一个清单:搜索结果、综述、博客文章、GitHub 仓库的 README、课程的阅读列表、你已经读过的论文引用的论文——全放进去。
- 并行地读:清单上的每一篇都先只读一小部分,判断它值不值得细读;值得的再读深,不值得的就放下;读的过程中发现重要的新引用,加进清单。
- 读得越多,理解越深:读过少数几篇,你对这个方向有一个基本的认识,大概能开始动手;读过几十篇,你会对这个方向的主要想法、常见做法和争论有相当扎实的把握。
这和第 10 讲”并行评估多个想法”是同一种思路:先用很小的代价筛一遍,再把精力集中到最有希望的地方。
8.2 读一篇:多遍读法
读单篇论文时,Ng 和 Keshav 都反对”从第一个字读到最后一个字”。两种多遍读法大同小异:
| 遍数 | Ng 的建议(大意) | Keshav 的三遍法 |
|---|---|---|
| 第 1 遍 | 只读标题、摘要和图(深度学习论文里,网络结构图和主要结果图往往就说清了核心想法) | 5–10 分钟:标题、摘要、引言;各节标题;结论;扫一眼参考文献 |
| 第 2 遍 | 读引言、结论,再仔细看图;其余部分略读。相关工作一节可以先跳过——不熟悉这个领域时它很难读懂 | 最多约一小时:仔细看图表,跳过证明等细节,记下没读过的重要参考文献 |
| 第 3 遍 | 读全文,但可以跳过数学 | 在脑子里把论文”重做一遍”:假设自己是作者,从同样的前提出发,你会怎么做?时间以小时计 |
| 第 4 遍 | 读全文,跳过实在读不懂的部分(很多被大量引用的论文里,也有后来被证明不重要的部分,作者当时自己也分不清) | — |
Keshav 建议第一遍之后回答五个问题(“five Cs”):Category(这是哪一类论文:新方法、测量、分析、系统?)、Context(它和哪些论文有关、建立在什么理论上?)、Correctness(它的假设看起来合理吗?)、Contributions(主要贡献是什么?)、Clarity(写得清楚吗?)。答不上来,或者发现这篇和你无关,就可以停在第一遍——大多数论文你只需要读第一遍。
用本讲义举个例子:第 13 讲 §6 推荐的 DenseNet 论文,第一遍看摘要和图 1、图 2(dense block 的连接方式)就知道核心想法;第二遍看它和 ResNet 的对比实验;只有当你要实现它的时候,才需要第三遍去抠 transition 层、增长率这些细节。
8.3 读的时候问自己什么
Ng 建议读完一篇论文后,试着回答这几个问题(不看原文):
- 作者想解决什么问题?
- 方法的关键要素是什么?
- 有哪些东西是我自己能用上的?
- 有哪些参考文献我想接着读?
读深度学习论文时,我会再加几条本讲义反复用到的”检查”:
- 和什么比? baseline 是不是认真调过的?(第 11 讲 §4.2 的 baseline 阶梯)
- 数据怎么分的? test 集有没有被用来挑模型?(第 6 讲 §1、第 10 讲 §4)
- 差距比随机波动大吗? 换种子的波动有多大?(第 4 讲代码 05:种子波动和结构差距同一量级)
- 哪一部分真的起了作用? 有没有消融实验(ablation)把各个改动分开?
- 在我的规模上还成立吗? 第 13 讲看到,MobileNet 的 separable 卷积在小任务上掉点比论文报告的明显;论文的结论有它的适用范围。
- 解释图配了对照吗? 本讲 §3:一张好看的显著图本身不是证据。
8.4 数学和代码:自己推一遍,自己实现一遍
Ng 的建议:想真正懂一篇论文的数学,就读完以后合上论文,从头自己推一遍;想真正懂它的方法,就先跑作者开源的代码,再自己从零实现一遍。这是整门讲义的做法:
- 第 4 讲的
deep_nn和第 1 讲的tiny_nn逐数字一致;第 9 讲手写反向传播和 autograd 的梯度差约 1e−16; - 第 12 讲 numpy 卷积和 PyTorch 差 ≤ 2e−14;第 15 讲 BPTT 和 autograd 差 8.9e−16;第 17 讲 numpy 注意力和 PyTorch 内置层差约 1e−15;
- 第 13 讲 VGG-16、ResNet-50、MobileNet v2 的参数个数和 torchvision 逐一相同。
“逐数字一致”是复现的金标准:它让你确信自己理解的就是论文写的。复现不出来的时候也别急着怀疑自己——第 15 讲发现 nn.GRU 的门的写法和 Ng 讲的差一个 ,第 17 讲发现不同的框架、甚至同一个框架的不同函数,掩码的约定(True 表示”可以看”还是”遮住”)可能正好相反;论文和代码之间、不同的实现之间,常常有这种不写在正文里的细节。
8.5 从哪里找论文
- arXiv(cs.LG、cs.CV、cs.CL 等分类):几乎所有深度学习论文都会先挂在这里。注意 arXiv 不审稿。
- 会议:NeurIPS、ICML、ICLR(机器学习);CVPR、ICCV、ECCV(视觉);ACL、EMNLP、NAACL(语言)。它们的论文集都公开。
- 好的解释性文章:Distill 期刊(2016–2021 年间发表了大量可解释性和可视化的文章,现在已停刊,但文章仍在线)、作者自己的博客、课程笔记(CS231n、CS224n 的 notes)。
- 顺藤摸瓜:一篇好论文的参考文献(往回找)和 Google Scholar 的”被引用”(往后找)。
- 社交媒体和新闻能帮你知道”最近有什么”,但它们放大的往往是最惊人的结果;用 §8.3 的问题过一遍再相信。
8.6 建议的第一批论文
如果你想从这门课出发开始读论文,下面这些都是各讲里讲过机制、配了代码的,读起来会有”原来如此”的感觉:
| 论文 | 为什么读 | 本讲义 |
|---|---|---|
| LeCun, Bengio & Hinton (2015). Deep learning. Nature | 三位图灵奖得主写的综述,第一篇读它 | 第 1 讲 |
| Krizhevsky, Sutskever & Hinton (2012). ImageNet classification with deep CNNs(AlexNet) | 深度学习”起飞”的那一刻;ReLU、dropout、GPU 都在里面 | 第 1、13 讲 |
| Srivastava et al. (2014). Dropout | 正则化的经典;写得很清楚 | 第 6、13 讲 |
| Kingma & Ba (2015). Adam | 你几乎每次训练都在用的优化器 | 第 8 讲 |
| Ioffe & Szegedy (2015). Batch Normalization | 读完再看第 9 讲关于”为什么有用”的争论 | 第 9 讲 |
| He et al. (2016). Deep residual learning(ResNet) | 退化问题和残差连接;图 1 就是一个实验 | 第 13 讲 |
| Zeiler & Fergus (2014). Visualizing and understanding convolutional networks | 逐层可视化、occlusion | 第 4、12、21 讲 |
| Redmon et al. (2016). You only look once(YOLO) | 把检测写成一次回归 | 第 14 讲 |
| Mikolov et al. (2013). Distributed representations of words and phrases(word2vec、负采样) | 词向量与类比 | 第 16 讲 |
| Bahdanau, Cho & Bengio (2015). Neural machine translation by jointly learning to align and translate | 注意力的起点 | 第 16 讲 |
| Vaswani et al. (2017). Attention is all you need | Transformer | 第 17 讲 |
| Goodfellow, Shlens & Szegedy (2015). Explaining and harnessing adversarial examples | 对抗样本与 FGSM,很短 | 第 5、18 讲 |
| Sundararajan, Taly & Yan (2017). Axiomatic attribution for deep networks(IG) | 公理化地讲归因 | 第 21 讲 |
| Adebayo et al. (2018). Sanity checks for saliency maps | 教你怀疑漂亮的图 | 第 21 讲 |
| Geirhos et al. (2020). Shortcut learning in deep neural networks | 捷径学习的综述 | 第 11、21 讲 |
9. 怎样规划学习与职业 · Planning your learning and career
这一节同样写 Ng 在公开讲座里讲过的职业建议的大意,再加上本讲义的一些具体对应。
9.1 T 形的知识结构
Ng 用字母 T 描述一个 AI 从业者理想的知识结构:
- 横的一笔:广泛的基础。机器学习的基本概念、深度学习的主要模型(全连接、CNN、序列模型、Transformer)、做项目的方法(偏差 / 方差、误差分析、数据)、必要的数学和软件工程能力。这门课的 21 讲就是在画这一横。
- 竖的一笔:在一两个方向上的深度。某个应用领域(医疗影像、语音、推荐、科学计算……)或者某类技术(生成模型、强化学习、可解释性……)。深度来自做项目、读这个方向的论文、写代码、参与开源。
只有横没有竖,你知道很多名词,却没有做成过一件有分量的事;只有竖没有横,你可能在一个工具上很熟练,换一个问题就不知道从何下手。课程帮你画横,竖要靠项目。
9.2 项目与作品集
招聘的人最想知道的是”你做成过什么”,而不只是”你上过什么课”。几条建议:
- 从复现开始:选一篇 §8.6 里的论文,在一个小数据集上复现它的核心实验。复现本身就是一个好项目,而且它逼你把 §8.2 的第三、四遍读完。
- 然后做你自己的问题:一个你真正关心的领域里的 。第 5 讲的”五问”、第 11 讲的全周期就是为这个准备的。
- 由小到大:一个能在一周内跑通的小项目,比一个永远做不完的宏大计划有用得多(第 1 讲 §4.5:迭代速度本身就是能力)。
- 写下来:README、技术博客、课程报告。写清楚问题、数据、baseline、结果、失败的尝试和误差分析。本讲义每个代码 README 里的”关于实验结果”就是一种示范:诚实地写”原以为……实际……”。
- 可复现:固定种子、记录配置、别人能一条命令跑出你的数字。这比再多几个百分点的准确率更能说明你是一个可靠的工程师。
9.3 选工作:看团队和具体的人
Ng 反复提醒过一点:选工作时,比公司名气更重要的,是你会加入哪个团队、每天和谁一起工作。你的成长速度很大程度上取决于直接带你的人和身边的同事——他们怎样做事、怎样给反馈、在做什么问题。他讲过这样的情况(大意):有人冲着一家很有名的公司的 AI 光环去了,进去以后被分到一个和 AI 毫无关系的团队。所以拿到机会时,值得问清楚:具体是哪个团队?做什么项目?我的经理是谁?能不能先和未来的同事聊一聊?
9.4 持续地学
深度学习变化太快:本讲义第 1 讲列的 2023–25 年的那几行,几年后也会变成”历史”。Ng 常强调的是持续:每周固定花一些时间读论文、动手实现,比偶尔的突击有用得多;学习的效果是累积的,短期内看不出来,几年后差别很大。一个可执行的小习惯:每读完一篇值得细读的论文,就用一页纸写下 §8.3 的四个问题的答案,必要时用几十行代码复现它的一个核心实验。
9.5 你的 CS230 项目:一张检查清单
把第 10、11 讲和本讲合起来(时间线和更多细节见第 11 讲 §10):
- 选题:数据能不能拿到? 和 是什么?用什么指标、和什么比(baseline、人类水平)?
- 先快后精:先用很少的数据把整条流水线跑通(第 11 讲 §3),在一个小 batch 上过拟合(第 11 讲 §4.3),再搭 baseline 阶梯。
- 诊断:train / dev 误差 → 偏差还是方差(第 6 讲);数据不匹配时加 train-dev 集(第 10 讲 §8)。
- 误差分析:数 100 个错例,按类别排优先级(第 10 讲 §6)。
- 新加一条:检查对的样本是不是”为对的理由对的”。画一张平均归因图,看有没有”总在同一个地方亮”的东西;如果能构造一个”捷径不成立”的测试集,就构造一个(本讲 §4.6)。
- 报告:主结果表 + 消融 + 学习曲线 + 误差分析 + 几张解释图(配上对照)+ 局限;数字附上种子之间的波动;test 集只用一次。
9.6 之后学什么
课程(都是 Stanford 的公开课程,大多有公开的讲义或录像):
| 课程 | 内容 | 和本讲义的关系 |
|---|---|---|
| CS229 Machine Learning | 经典机器学习的系统推导:广义线性模型、生成模型、核方法、无监督学习 | 补”横”的那一笔;第 2 讲逻辑回归的上游 |
| CS231n Deep Learning for Computer Vision | 视觉方向的深入 | 第 12–14 讲 + 本讲 §2、§5 的展开 |
| CS224n Natural Language Processing with Deep Learning | 语言方向的深入 | 第 15–17 讲的展开 |
| CS234 Reinforcement Learning | 强化学习 | 第 19 讲的展开 |
| CS236 Deep Generative Models | VAE、GAN、流模型、扩散模型 | 第 18 讲的展开 |
| CS336 Language Modeling from Scratch | 从零训练一个语言模型 | 第 17、20 讲的展开 |
书:
- Goodfellow, Bengio & Courville (2016). Deep Learning. MIT Press(免费在线)——理论最系统的一本经典教材。
- Zhang, Lipton, Li & Smola. Dive into Deep Learning(d2l.ai,免费在线)——每一节都配可运行的代码,适合”边读边实现”。
- Prince (2023). Understanding Deep Learning. MIT Press(免费在线 PDF)——图非常多,覆盖到 Transformer、扩散模型。
- Sutton & Barto (2018). Reinforcement Learning: An Introduction, 2nd ed.(免费在线)——强化学习的标准教材。
- Andrew Ng. Machine Learning Yearning(免费)——第 10、11 讲的展开版。
- Molnar. Interpretable Machine Learning(免费在线)——本讲 §1–§4 的一本很好的延伸读物,也覆盖 LIME、SHAP 等表格数据上的方法。
10. 全课总结 · Course wrap-up
10.1 21 讲,一张图
| 部分 | 讲次 | 一句话 | 一个值得记住的实验 |
|---|---|---|---|
| I 神经网络基础 | 1 导论 | 隐藏层自动学出中间特征;规模驱动起飞 | 逻辑回归停在 0.834,大网络在 100,000 个样本时 0.909 且仍在上升 |
| 2 逻辑回归 | 计算图、交叉熵、向量化 | 学到的权重是一个”橙色十字”模板,位置一抖就失效 | |
| 3 浅层网络 | 非线性、反向传播、不能零初始化 | 花朵数据上逻辑回归 0.501,4 个 tanh 单元 0.906 | |
| 4 深层网络 | L 层的积木;为什么要深 | 能表示 ≠ 能学到:存在精确解的网络 0/5 次学会 parity | |
| 5 深度学习直觉 | 五问;编码;损失函数定义任务 | 人脸验证:比像素 0.668,triplet 编码 0.965 | |
| II 改进深度网络 | 6 偏差 / 方差、正则化 | 四象限诊断与 basic recipe | L2、dropout、数据增强”救”过拟合的 32×32 网络 |
| 7 归一化、初始化、梯度检验 | 让信号和梯度保持尺度 | 输入标准化:条件数 1.6e5 → 3.6,梯度下降 444,615 步 → 14 步 | |
| 8 优化算法 | mini-batch、动量、Adam、学习率调度 | 同一个学习率下动量不比 GD 快,它的好处是允许大得多的学习率 | |
| 9 调参、BN、框架 | 随机搜索;BN;autograd | 手写反向传播和 autograd 差约 1e−16 | |
| III 项目方法 | 10 ML 策略 | 正交化、单一指标、误差分析、数据不匹配 | 只有 30 张图时迁移学习把错误率从 39.4% 降到 25.8% |
| 11 项目全周期 | 先快后精、调试、部署、监控 | 9 个注入的 bug,检查清单抓住 8 个;快队第 3 天、慢队第 41 天发现采集偏差 | |
| IV CNN | 12 卷积基础 | 局部性 + 参数共享 | 位置抖动 ±4:MLP 0.780,CNN 0.927 / 0.983 |
| 13 经典架构与迁移 | ResNet、Inception、MobileNet、迁移学习 | 每类 10 张:从零 0.280,只训练头 0.840 | |
| 14 视觉应用 | 检测、分割、人脸、风格迁移 | TinyYOLO [email protected] 0.794,加 anchor 后 0.846 | |
| V 序列模型 | 15 RNN / LSTM | 参数共享、BPTT、门控 | 训练好的 GRU 靠吸引子而不是”关门”来记忆 |
| 16 词嵌入与注意力 | 嵌入、seq2seq、注意力、beam search | 多个日期的翻译:无注意力 0.000,有注意力 0.967 | |
| 17 Transformer | 自注意力、多头、位置编码 | 去掉位置编码,反转任务只剩 0.202 | |
| VI 前沿专题 | 18 对抗样本与生成模型 | FGSM / PGD、对抗训练、GAN、扩散模型 | ε = 0.1 的随机噪声后还有 0.917,同样大小的 FGSM 扰动后只剩 0.042 |
| 19 深度强化学习 | Q-learning、DQN、policy gradient、RLHF | 玩具 RLHF:代理奖励一路涨,真实质量先升到 3.368、再跌到 2.112 | |
| 20 增强 LLM 应用 | prompting、RAG、agents、评估与误差分析 | RAG 把正确率从 0.389 提到 0.854,但模型本来记得的题从 0.964 降到 0.839 | |
| 21 可解释性与总结 | 归因、检验、捷径、探针、叠加 | 灰色遮挡块本身像”方块”;完全随机的网络上 gradient 仍有 0.460 的命中率 |
10.2 回到四个反复出现的想法
课程大纲开头写了四个贯穿全课的想法。21 讲之后,每个都有具体的实验撑着:
① 深度学习 = 用梯度下降拟合一个很大的、可微的函数。 从第 1 讲一个 ReLU 神经元的”前向 → 损失 → 反向 → 更新”四步,到第 4 讲 L 层的积木、第 9 讲的 autograd,再到第 17 讲的 Transformer,骨架没有变。而且”可微”这件事的用处远不止训练参数:第 5 讲对输入求梯度做风格迁移和对抗样本,本讲用同一个梯度做 saliency map、IG 和类别可视化。
② 规模是主要驱动力。 第 1 讲的规模曲线(逻辑回归饱和、大网络一路上升);第 13 讲在大数据上预训练、再迁移到只有几张图的小任务;第 17、20 讲的预训练大模型。但规模不是万能的:小数据区间里先验和特征工程更重要(第 1 讲 §4.3),而且规模不会自动消除捷径——数据里有水印,大模型一样会学(本讲 §4)。
③ 结构要匹配数据。 第 12 讲:只靠加隐藏层解决不了位置抖动,卷积 + 池化才行;只有全局池化的 CNN 能泛化到没见过的位置。第 15–17 讲:序列需要循环或注意力,位置编码不能丢。本讲又从另一面看到了它:探针显示 GAP 把位置信息平均掉了(R² 0.790 → 0.141),这既是平移不变性的来源,也是 CAM 必须在 GAP 之前算的原因;类别可视化铺满全图的纹理,同样是 GAP 结构的指纹。
④ 做深度学习是一个快速迭代的经验过程,下一步要靠系统的方法决定。 第 6 讲的偏差 / 方差诊断、第 10 讲的误差分析和正交化、第 11 讲的调试清单和监控,以及本讲把可解释性加进这个工具箱:归因图给线索,干预给证据,改数据来修复,然后再检查一遍。
10.3 一份”诚实的意外”清单
这门讲义的每个代码 README 都有一节”关于实验结果”,记录”原以为……实际……”。把其中最有教益的几条放在一起,它们本身就是想法 ④ 最好的注脚——预想经常是错的,所以要做实验,并且按实验结果说话:
| 讲次 | 原以为 | 实际 |
|---|---|---|
| 1 | 2 个隐藏单元就能超过线性回归 | [5, 2, 1] 卡在了线性解上,和线性回归一模一样 |
| 2 | 学习率太大就会发散 | 逻辑回归上大学习率先震荡、后恢复,并不发散 |
| 4 | parity 函数说明浅网络需要指数多的单元 | 这只对逻辑门电路严格成立;n 个 ReLU 就够,锯齿函数才是 ReLU 网络上的例子 |
| 10 | 多任务学习会帮忙 | 几乎没有收益 |
| 12 | 加隐藏层就能对付位置变化 | MLP 0.780,远不如 CNN;只有全局池化的 CNN 能泛化到没见过的位置 |
| 13 | 残差连接消除退化问题 | 在有限的训练预算里只是缓解 |
| 15 | GRU 靠关上更新门来记忆 | 门开着一半,靠的是吸引子 |
| 16 | 平均词向量够做情感分类 | 它在原理上学不会否定(0.330 vs LSTM 1.000) |
| 17 | 嵌入乘 是无害的惯例 | 在小 Transformer 里它淹没了位置编码 |
| 18 | 扩散模型的样本会比 GAN 更好 | 二维玩具上 GAN 最后的样本质量更高(0.932–0.973 vs 0.731–0.907);扩散模型赢在训练过程稳定 |
| 19 | 去掉目标网络,DQN 会明显变差 | 在 Catch 上看不出影响(1.000 vs 1.000);去掉经验回放才掉到 0.472 |
| 20 | 给了检索资料,答案只会更好 | 模型本来记得的题,RAG 反而从 0.964 降到 0.839 |
| 21 | 灰色遮挡块是”中性”的 | 它本身像一个”方块”,让 occlusion 在三角形上只有 0.409 的命中率 |
10.4 最后的话
Ng 在课上常说 AI 是新的电力。电力的价值不在发电机,而在无数把它用起来的应用;深度学习也一样。你现在有了一套完整的工具:知道网络怎样计算和学习(Part I–II),知道怎样把一个项目一步步做成(Part III),知道图像和序列的主要架构(Part IV–V),知道前沿在发生什么、以及怎样打开模型看一看(Part VI)。剩下的,是去找一个你真正关心的 ,然后开始 Idea → Code → Experiment 的第一圈。
11. 小结 · Summary
- 先问解释给谁、用来做什么。 工程师要忠实,受影响的人要可操作,监管者要可审计。局部 vs 全局、事后 vs 本身可解释、忠实 vs 看起来合理,是三组最基本的区分。
- 五种输入归因:vanilla gradient(局部敏感度,一次反向)、gradient × input(一阶贡献)、occlusion(拿掉一块看看,任何黑盒都能用)、CAM / Grad-CAM(利用 GAP 结构,把 logit 按位置拆开;GAP 网络上 Grad-CAM = CAM / 64)、Integrated Gradients(沿基线到输入的路径积分,满足完整性 )。
- 量化 + 对照:在知道答案的世界里,pointing game 从随机的 0.155 到 CAM 的 0.905;但一个不看模型的边缘检测器也有 0.455,一个完全随机的网络上 gradient 也有 0.460。该看的是”训练过 − 随机”的差,以及重要性有没有被分给干扰物。
- “什么都没有”不中性:IG 的基线(黑 0.805、平均色 0.905)和 occlusion 的填充都会改变答案;灰色遮挡块本身像”方块”,让三角形上的命中率只有 0.409。拿掉一部分输入,往往制造了分布外的输入。
- Sanity check:把模型逐层换成随机数,解释图要跟着变。edge 图永远不变(不及格的样子);gradient 变得最少;乘上输入的方法取了绝对值就带上了输入的结构。
- 注意力图不等于解释:它说”看了哪里”,不说”取了什么”(第 17 讲 §9.4);要当解释用,就要像检验归因方法一样检验它。
- 抓捷径:同分布 dev 0.975 的模型,在水印随机的测试集上只有 0.805。平均归因图给线索(IG 3.3 倍、occlusion 2.6 倍,gradient 只有 1.1 倍),干预给证据(只换水印颜色,45.6% 的预测改变),改数据来修复(0.805 → 0.960),再检查一遍(亮点消失,而边缘检测器照样 2.9 倍)。
- 看网络内部:类别可视化要加先验,先验会改变答案;不加正则的图只骗得过模型自己。线性探针要在留出数据上报告、配对照模型和对照任务;能读出不等于在使用(颜色在 GAP 里还能读出 0.173,logits 里是 0)。
- 机制可解释性:circuits 想把网络读成算法;叠加解释了多义神经元——特征稀疏时,5 个特征可以排成五边形挤进 2 维,代价是串扰,靠负偏置 + ReLU 过滤;稀疏自编码器试图把叠加的特征拆开。
- 读论文:先列清单、并行地读一部分;单篇用多遍读法,大多数论文只需要第一遍;读完问四个问题;想真懂就自己推、自己实现,追求”逐数字一致”。
- 职业:T 形——课程画横,项目画竖;作品集里写清楚失败和误差分析;选团队和人,而不只是公司名气;持续地学。
12. 常见误区 · Common pitfalls
- “显著图亮在物体上,说明模型看的是物体。” 不看模型的边缘检测器也亮在物体上(命中 0.455),完全随机的网络的 gradient 也是(0.460)。要和这种对照比(§2.7、§3.2)。
- “选一个看起来最清楚的解释方法就行。” 看起来清楚和忠实于模型是两回事;有些方法图很好看,模型换成随机数也几乎不变(Adebayo et al. 2018)。
- “基线 / 遮挡填充只是实现细节。” 它定义了”什么都没有”,换一个就换了问题(IG 的命中率 0.805 ↔ 0.905;灰块本身像”方块”)。
- “gradient × input 和 IG 差不多。” 只有 IG 满足完整性;grad×input 的总和和 的相对误差中位数是 0.83。在饱和处,梯度类方法会说”什么都不重要”(练习 1)。
- “注意力权重就是解释。” 它只说明”看了哪里”(第 17 讲 §9.4 的 GRU 看的是镜像位置的下一个状态);要当解释用,需要额外的检验。
- “单张图看起来正常,模型就没问题。” 捷径往往要在数据集层面才看得出来(平均归因图);有的方法(这里的 vanilla gradient)甚至在平均图里也看不见它。
- “归因图指向了水印,就证明模型在用水印。” 归因图只是线索,水印本身也很显眼(边缘检测器 2.9 倍)。证据来自干预和对照模型。
- “去掉捷径会让模型在 dev 上变好。” 如果 dev 也带着同样的偏差,去掉捷径反而可能在 dev 上略差(0.975 → 0.969)。要在”捷径不成立”的数据上评估。
- “探针能读出某个信息,说明模型用了它。” 不一定:GAP 里能读出颜色,logits 里没有;探针的分数还要和对照任务一起看(block1 上对照任务 0.647 比类别 0.405 还高)。训练集上的探针分数更说明不了什么(随机标签训练集 1.000)。
- “一个神经元对应一个概念。” 特征比神经元多、又稀疏时,网络会把它们叠加存放,单个神经元是多义的(§7.2,以及第 1 讲 §2.3 的分布式表示)。
13. 练习 · Exercises
练习 1(梯度在饱和处失灵,手算 IG)。,输入 ,基线 。 (a) 算出 处的梯度、gradient × input。(b) 算出 、,检验完整性。(c) 哪种方法违反了 §2.5 的”敏感性”公理?
参考答案
(a) 在 附近 ,,梯度是 ,gradient × input 也是 。
(b) 路径 ,。 时 , 时为 0。所以 。,满足完整性。(可以用 integrated_gradients 的思路写十几行 numpy 验证:中点法则 1000 步得到 0.5、0.5。)
(c) 梯度和 gradient × input。 和 的输出不同(1 vs 0),而且它们只在 上不同,两个输入却都得到 0 归因。这正是模型”确信无疑”时 saliency 反而变暗的原因。
练习 2(CAM 手算)。最后一层有 2 个 2×2 的特征图 ,,类别 的权重 ,偏置 。 (a) 用 GAP + 线性层算 logit 。(b) 算 CAM ,验证 。(c) 哪个位置对 贡献最大?哪些位置在”拉低”它?
参考答案
(a) GAP:,;。 (b) ,平均 ,加上 得 1.0 ✓。 (c) 左下角(4)贡献最大;右边一列(−1、−3)在拉低它。只画 ReLU 之后的 CAM 时,这两个负的位置都显示为 0——“反对这一类的证据”被丢掉了,这也是 Grad-CAM 加 ReLU 时的取舍。
练习 3(推导:GAP 网络上 Grad-CAM = CAM / hw)。设 。(a) 求 。(b) 由此写出 Grad-CAM 的 ,证明 。(c) 代码 01 演示 2 打印的比值是 0.015625,和你的结论一致吗?如果最后一层特征图是 7×7,比值是多少?
参考答案
(a) ,和位置 无关。 (b) ,所以 ;正数乘进 ReLU 里不变,得证。 (c) ,,一致。7×7 时比值是 。注意:CAM 和 Grad-CAM 在这里只差常数,所以”哪种更好”这类比较在 GAP 网络上没有意义;差别出现在不是 GAP 结构的网络上(那时 CAM 根本没法算)。
练习 4(代价)。一张 224×224 的图,分别估算下面几种方法要做多少次前向 / 反向传播:(a) vanilla gradient;(b) IG,50 步;(c) occlusion,16×16 的方块、步长 8;(d) occlusion,8×8 的方块、步长 2。对一个前向要 10 毫秒的模型,(c)(d) 各要多久?
参考答案
(a) 1 次前向 + 1 次反向。(b) 50 次前向 + 50 次反向(再加 2 次前向算 、 做完整性检查)。(c) 次前向,约 7.3 秒。(d) 次前向,约 2 分钟。occlusion 的分辨率越高越贵,这是它在大图上常被 IG、Grad-CAM 代替的原因之一;好处是它不需要梯度,任何黑盒都能用。
练习 5(pointing game 的随机基线)。§2.7 的表里,随机图的命中率是 0.155,而目标框的面积占比是 0.160。(a) 为什么随机图的期望命中率等于框的面积占比?(b) 200 张图时,命中率的标准误差大约是多少?0.155 和 0.160 的差异说明什么?(c) 如果目标物体平均占图的一半,pointing game 还是一个好指标吗?
参考答案
(a) 随机图的最大值落在任何一个像素上的概率相同,落在框里的概率就是框里像素的比例(逐图算再平均)。 (b) 。0.155 和 0.160 只差 0.005,远小于一个标准误差,完全是抽样波动。 (c) 不是。物体占一半时,瞎指也有约 50% 的命中率,区分度很低。这时更该看”重要性有多少落在物体上”这类连续指标,或者 deletion / insertion 曲线(§3.2)。这也是本讲的世界里让目标只占约 6% 像素的原因。
练习 6(改代码,先预测再运行)。把 02_shortcut_detection.py 的 make_splits 里训练集和 dev 集的 marker_agree=0.9 改成 0.99,再改成 0.6(两处都改)。先预测:带捷径的模型在”去相关”测试集上的准确率、干预时”跟着水印走”的比例、IG 落在水印上的倍数,各会怎样变化?然后运行验证。
参考答案
预期趋势(具体数字以你运行的结果为准):
- 0.99:水印几乎总是对的,而且比形状容易学,模型会更依赖它——去相关测试集的准确率比 0.805 更低,“跟着水印走”的比例比 0.413 更高,平均归因图上的水印亮点更强。同分布 dev 可能反而更高。
- 0.6:水印只比瞎猜(0.25)强一些,形状才是可靠的线索,模型对水印的依赖应该明显减弱;三个数都向”修复后的模型”靠近,但可能不会完全消失——只要水印有一点预测力,交叉熵就有动机用它。 这个练习说明:捷径的危害和它在训练数据里的”可靠程度”有关,而这个程度在真实数据里通常是未知的。
练习 7(改代码,先预测再运行)。§3.1 的意外来自”灰色遮挡块像方块”。把 interp_tools.py 里的 CLASSES 中的 "square" 换成 "hexagon"(CLASS_CN 相应改成”六边形”),重新运行 01_attribution_maps.py。先预测:演示 3 (c) 里灰块让哪一类的 logit 上升?occlusion 在三角形上的命中率会怎样变?
参考答案
预期趋势(具体数字以你运行的结果为准):一个 8×8 的灰色方块不再是任何一类的形状,它对各类 logit 的影响应该小得多、也更均匀;occlusion 在三角形上的命中率应该明显回升,和其他类别更接近。但”灰块是分布外输入”这个问题本身并没有消失:它可能仍然会被模型当成某种”物体”,只是不再那么像某一个类别。注意改了 CLASSES 以后,代码 02、03 的结果也会变(它们共用这个模块)——改共享模块之前要知道谁在用它。
练习 8(叠加的串扰,计算)。§7.2 的表里,稀疏度 0.97 时 5 个特征的 ,相邻方向约 72°,偏置约 −0.26。 (a) 相邻两个特征的 大约是多少?隔一个的呢(144°)?(b) 只有特征 出现、取值 1 时,特征 (相邻)的输出 是多少?取值 0.5 时呢?(c) 为什么隔一个的特征不会造成串扰?
参考答案
(a) 相邻:(表中实测最大正串扰 0.44);隔一个:。 (b) 取值 1:,漏过去约 0.15 的”假信号”;取值 0.5:,被 ReLU 截成 0。所以负偏置能滤掉小的串扰,大的还会漏一点——这是网络为了多存 3 个特征付出的代价,特征越稀疏(越少同时出现),这个代价越划算。 (c) 负的点积加上负的偏置,ReLU 之后一定是 0:方向相反的串扰被完全滤掉。这也是为什么代码只报告”正”的串扰。
练习 9(探针的解读)。§6.2 的表里,block1 上”对照任务”0.647 比”类别”0.405 还高。(a) 这说明 block1 的特征里有什么、没有什么?(b) 如果把线性探针换成一个两层的 MLP 探针,你预计 block1 上类别和对照任务的分数会怎样变?selectivity 呢?(c) 要让你相信”block2 已经编码了类别”,你还想看哪些证据?
参考答案
(a) block1 是 16×16 的特征图,保留了大量位置信息(位置 R² 0.542),所以”认格子再查表”可以用一个线性函数做到;而”形状是三角还是十字”需要把局部的边缘组合起来,block1 上还不是线性可读的。 (b) MLP 探针更强:两个分数都会上升,但对照任务往往升得更多(它更擅长”记住一张没道理的表”),selectivity 可能下降——这正是 Hewitt & Liang (2019) 发现线性探针 selectivity 更高的原因。 (c) 例如:随机网络的同一层分数低得多(这里 block2 是 0.640 vs 随机 0.365 ✓);对照任务的分数要低(这里 0.655,并不低 ✗);干预证据——在 block2 上抹掉 / 改变探针找到的方向,模型的输出跟着变。目前的证据只够说”block2 里类别信息比随机网络多”。
练习 10(读论文与规划)。(a) 对 Adebayo et al. (2018) Sanity checks for saliency maps 做一次 Keshav 的第一遍(不超过 10 分钟),写下五个 C。(b) 画出你自己的”T”:横的一笔列出你已经有的基础(可以用本讲 §10.1 的表打勾),竖的一笔选一个方向,写下接下来 12 周的三件事(一篇要复现的论文、一个要做的小项目、一个要读的论文清单)。
参考答案
(a) 一种可能的答案:Category——提出评估方法 + 实验分析的论文;Context——saliency map 一族方法(gradient、Guided Backprop、IG、Grad-CAM、SmoothGrad……)和”用人眼评价解释”的做法;Correctness——“解释图在模型随机化后不变 ⇒ 不能用来解释模型”这个前提很合理;Contributions——模型参数随机化和数据随机化两个检验,发现部分方法几乎不依赖模型,和边缘检测器的类比;Clarity——图非常直观,第一遍看图就能抓住结论。 (b) 没有标准答案。一个检查标准:竖的一笔要具体到”能在 12 周内做出一个可以给别人看的东西”,并且用上第 10、11 讲的方法(baseline、误差分析)和本讲的方法(检查捷径)。
14. 延伸阅读 · Further reading
课程材料
- CS230 Autumn 2018 Lecture 7 “Interpretability of Neural Networks”(Kian Katanforoosh)、Lecture 8 “Career Advice / Reading Research Papers”(Andrew Ng)——YouTube,Stanford Online 频道。
- Coursera C4M4 “What are deep ConvNets learning?”(第 14 讲 §11.1)。
- S. Keshav (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review 37(3)。只有两页。
- Molnar. Interpretable Machine Learning(免费在线书)。
输入归因
- Simonyan, Vedaldi & Zisserman (2014). Deep inside convolutional networks: Visualising image classification models and saliency maps. ICLR Workshop。——saliency map 与 class model visualization。
- Zeiler & Fergus (2014). Visualizing and understanding convolutional networks. ECCV。——deconvnet 可视化与 occlusion。
- Zhou, Khosla, Lapedriza, Oliva & Torralba (2016). Learning deep features for discriminative localization. CVPR。——CAM。
- Selvaraju et al. (2017). Grad-CAM: Visual explanations from deep networks via gradient-based localization. ICCV。
- Sundararajan, Taly & Yan (2017). Axiomatic attribution for deep networks. ICML。——Integrated Gradients。
- Smilkov et al. (2017). SmoothGrad: removing noise by adding noise.
- Springenberg et al. (2015). Striving for simplicity: The all convolutional net. ICLR Workshop。——Guided Backprop。
- Ribeiro, Singh & Guestrin (2016). “Why should I trust you?”: Explaining the predictions of any classifier. KDD。——LIME。
- Lundberg & Lee (2017). A unified approach to interpreting model predictions. NeurIPS。——SHAP。
怎样评价解释
- Adebayo et al. (2018). Sanity checks for saliency maps. NeurIPS。
- Adebayo, Muelly, Abelson & Kim (2022). Post hoc explanations may be ineffective for detecting unknown spurious correlation. ICLR。
- Zhang et al. (2016). Top-down neural attention by excitation backprop. ECCV。——pointing game。
- Petsiuk, Das & Saenko (2018). RISE: Randomized input sampling for explanation of black-box models. BMVC。——deletion / insertion。
- Hooker, Erhan, Kindermans & Kim (2019). A benchmark for interpretability methods in deep neural networks. NeurIPS。——ROAR。
- Fong & Vedaldi (2017). Interpretable explanations of black boxes by meaningful perturbation. ICCV。
- Jain & Wallace (2019). Attention is not explanation. NAACL;Wiegreffe & Pinter (2019). Attention is not not explanation. EMNLP。
- Rudin (2019). Stop explaining black box machine learning models for high stakes decisions and use interpretable models instead. Nature Machine Intelligence。
捷径
- Lapuschkin et al. (2019). Unmasking Clever Hans predictors and assessing what machines really learn. Nature Communications。
- Geirhos et al. (2020). Shortcut learning in deep neural networks. Nature Machine Intelligence。
- Zech et al. (2018). Variable generalization performance of a deep learning model to detect pneumonia in chest radiographs. PLOS Medicine(第 11 讲 §9.4)。
可视化与探针
- Erhan, Bengio, Courville & Vincent (2009). Visualizing higher-layer features of a deep network. 技术报告。
- Mahendran & Vedaldi (2015). Understanding deep image representations by inverting them. CVPR。
- Yosinski, Clune, Nguyen, Fuchs & Lipson (2015). Understanding neural networks through deep visualization. ICML Deep Learning Workshop。
- Mordvintsev, Olah & Tyka (2015). Inceptionism: Going deeper into neural networks. Google Research Blog。——DeepDream。
- Olah, Mordvintsev & Schubert (2017). Feature visualization. Distill。
- Bau et al. (2017). Network dissection: Quantifying interpretability of deep visual representations. CVPR。
- Alain & Bengio (2016). Understanding intermediate layers using linear classifier probes. arXiv(ICLR 2017 Workshop)。
- Hewitt & Liang (2019). Designing and interpreting probes with control tasks. EMNLP。
- Elazar, Ravfogel, Jacovi & Goldberg (2021). Amnesic probing: Behavioral explanation with amnesic counterfactuals. TACL。
- Kim et al. (2018). Interpretability beyond feature attribution: Quantitative testing with concept activation vectors (TCAV). ICML。
- Karpathy, Johnson & Fei-Fei (2015). Visualizing and understanding recurrent networks.(第 15 讲 §10.5)
机制可解释性
- Olah et al. (2020). Zoom in: An introduction to circuits. Distill。
- Elhage et al. (2022). Toy models of superposition. Transformer Circuits Thread。
- Olsson et al. (2022). In-context learning and induction heads. Transformer Circuits Thread。
- Bricken et al. (2023). Towards monosemanticity: Decomposing language models with dictionary learning. Transformer Circuits Thread。
- Templeton et al. (2024). Scaling monosemanticity: Extracting interpretable features from Claude 3 Sonnet. Transformer Circuits Thread。
读论文与职业:§8.6 的论文清单、§9.6 的课程和书。
15. 课程之后 · Where to go next
这是最后一讲,没有”下一讲”了。几条可以马上开始的路:
- 把本讲义的代码当成起点:每一讲的代码都可以改。练习里”先预测再运行”的题,是养成实验直觉最快的办法;做完之后,试着给某一讲加一个你自己设计的实验,并像 README 里那样写下”原以为……实际……”。
- 选一个方向画”竖”的那一笔:视觉 → CS231n;语言 → CS224n、CS336;强化学习 → CS234、Sutton & Barto;生成模型 → CS236;理论基础 → CS229、Goodfellow et al.;可解释性 → 本讲 §14 的论文 + Molnar 的书。
- 做一个项目:用 §9.5 的清单,从一个你关心的 开始。第一周的目标不是好结果,而是一条从数据到评估跑通的流水线。
- 读论文:从 §8.6 的清单里挑一篇你在本讲义里已经实现过机制的,做一次完整的多遍阅读,然后复现它的一个核心实验。
- 回头翻:有些东西第一次读时只是”知道了”,做过项目以后再读,才会变成”懂了”。第 10、11 讲尤其如此。
祝你 Idea → Code → Experiment 的每一圈都转得比上一圈快。